我在LinkedIn 上偶然看到 Michaela Eichinger(來自 Quantum Machines)發布的一篇文章,她提出了一個關於 QPU 含義的非常好的相關問題,總結如下:
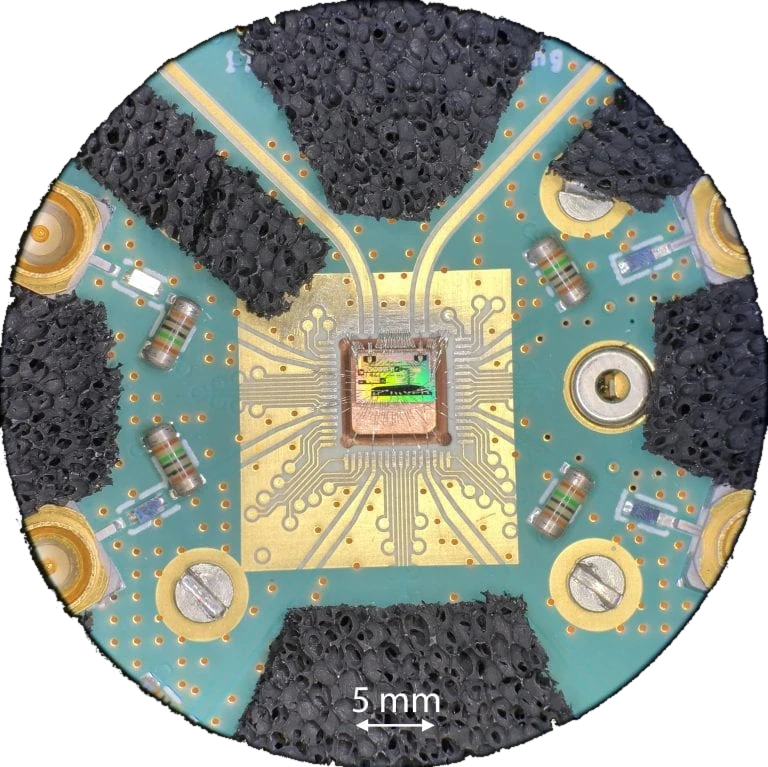 量子晶片連接至電路板 - 圖片來源:QUtech
量子處理單元(QPU)並非只是裸晶片:在傳統半導體中,CPU在流片完成後不僅僅是裸露的矽晶片。如果沒有封裝、時脈分配、記憶體層次結構和微程式碼,那顆晶片就只是一團經過高度工程化的沙子。
量子處理單元(QPU)同樣需要嚴謹的系統工程設計。量子晶片本身無法獨立工作。它需要合適的封裝和環境(例如稀釋冷凍機或真空室),以及控制電路和基礎設施才能真正執行邏輯閘運算。
術語 Link to heading
在所有針對該問題的評論中,奧利維爾·埃茲拉蒂的評論尤其實用。他建議定義兩個關鍵術語來澄清概念:「量子電腦」和「量子計算系統」。
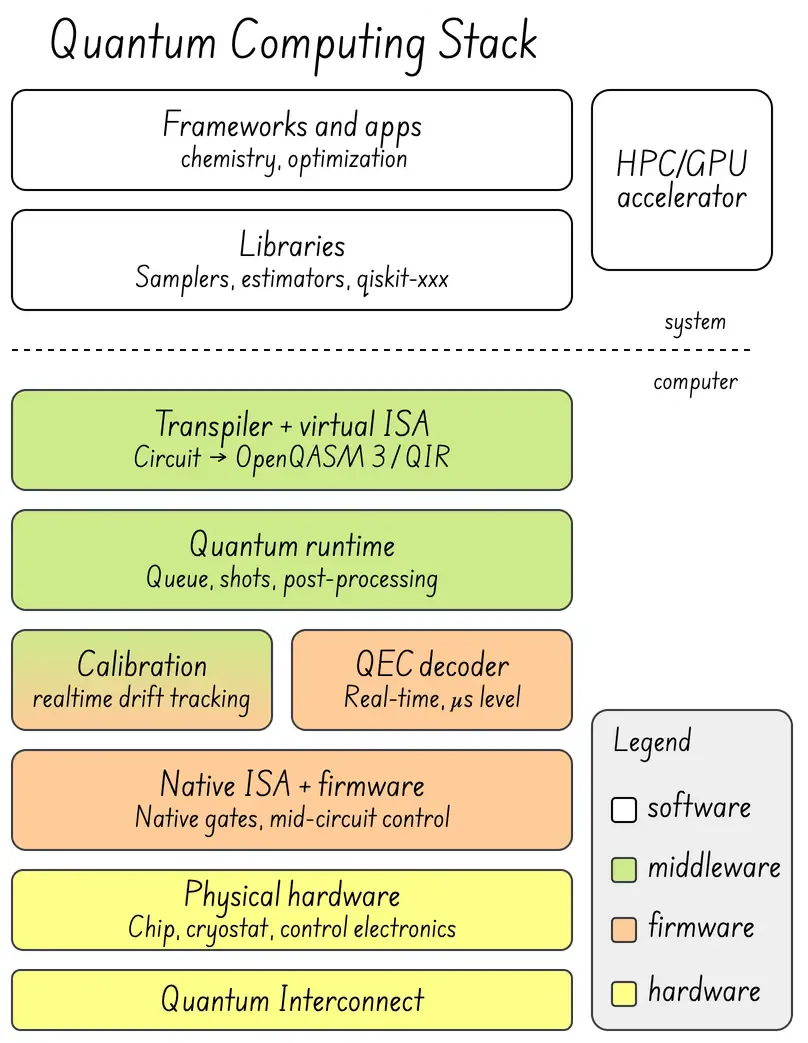
量子電腦:運行預先定義的量子電路,通常多次運行,並提供有用的結果。因此,它包括編譯、最佳化、QEC/FTQC 實現(如有)、所有經典系統驅動(電子學、光子學)、電路中間測量、經典優化器(用於 NISQ 變分電路)和後處理。以及所有使能技術,包括低溫技術。
- 量子計算系統:利用量子電腦解決使用者問題。它應包含量子電路產生過程中涉及的所有經典資源,必要時還包括高效能運算資源。以及所使用的量子計算機。
右側的圖表展示了這兩個定義。
系統視角:[ QPU || GPU ] Link to heading
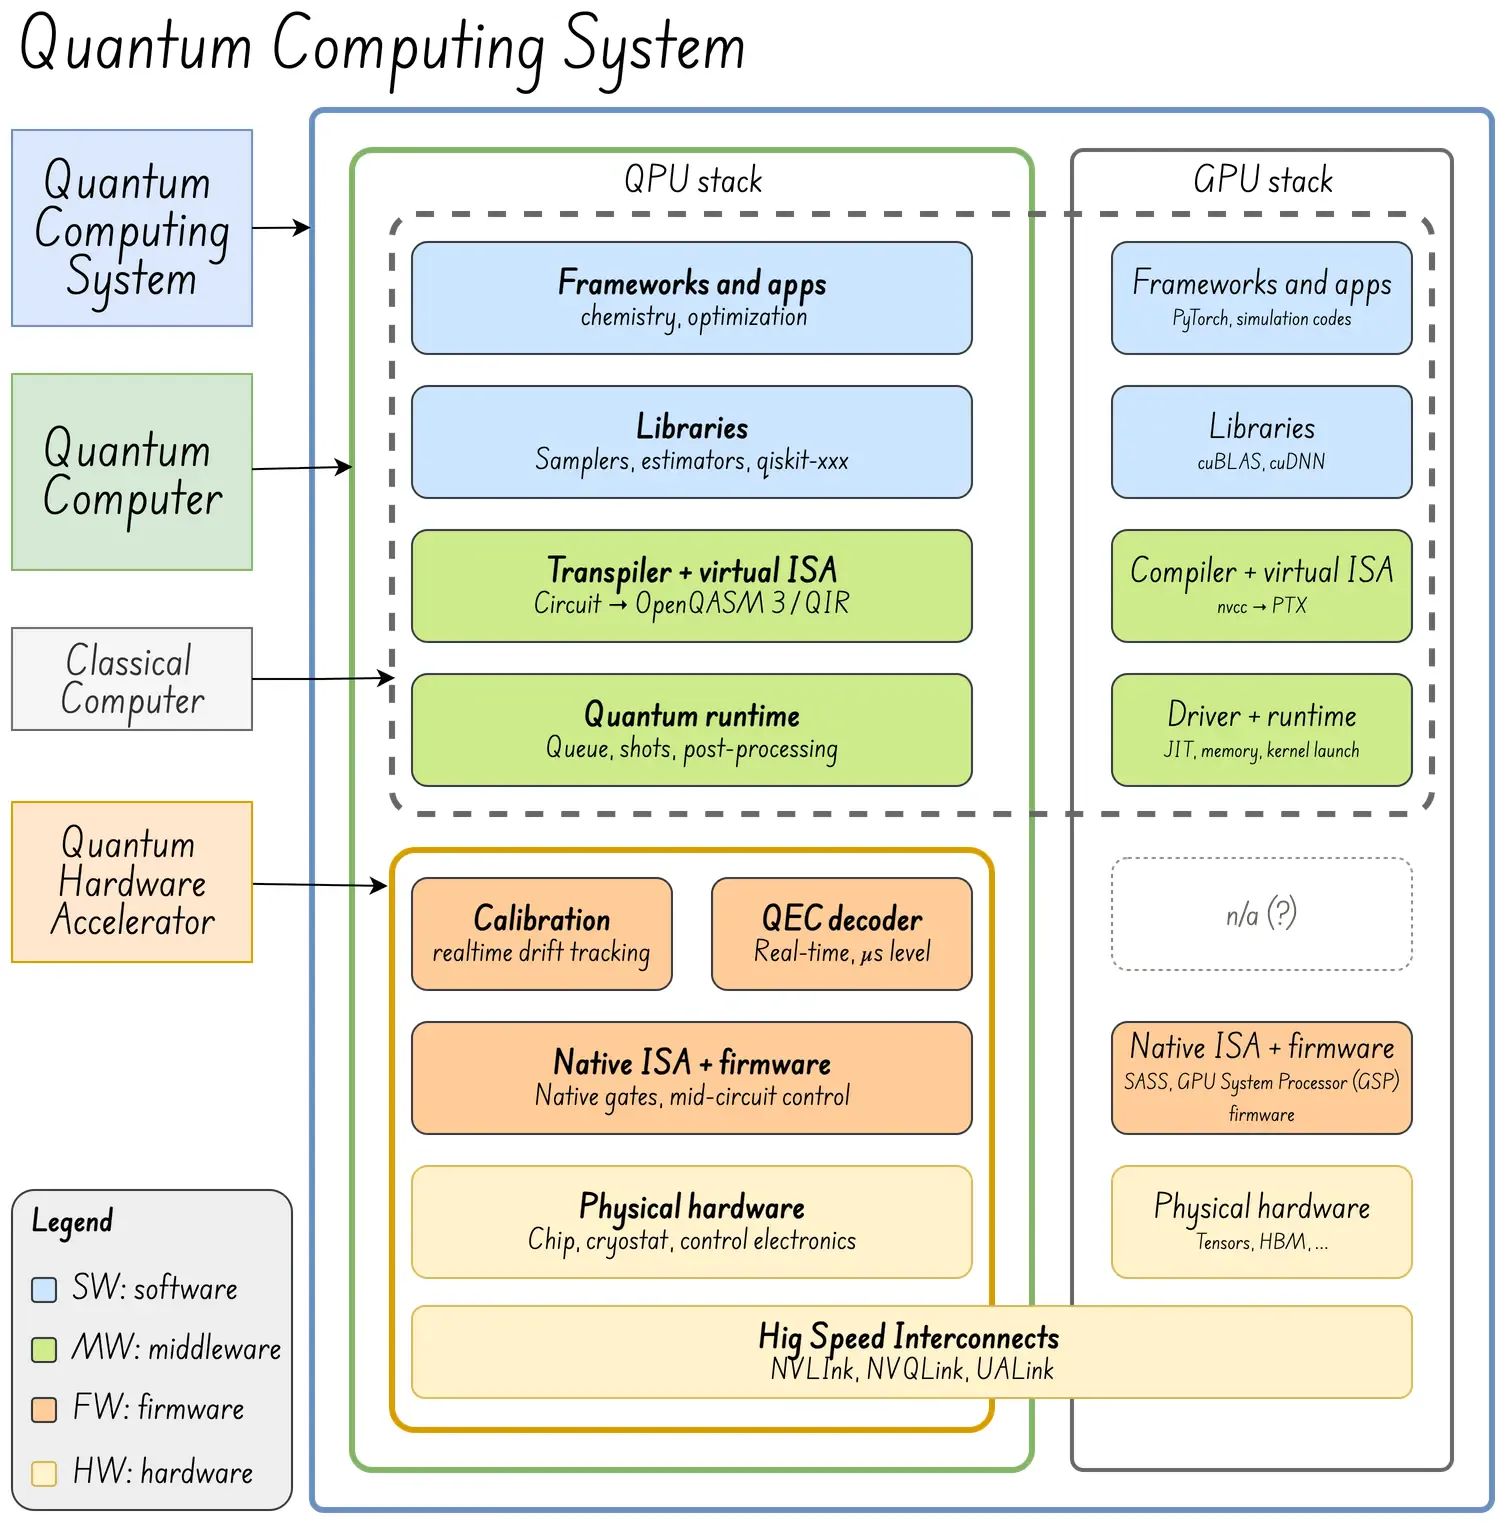
最有趣的部分是量子計算系統。我喜歡將量子運算單元(QPU)和圖形處理器(GPU)架構進行類比,如下圖所示:
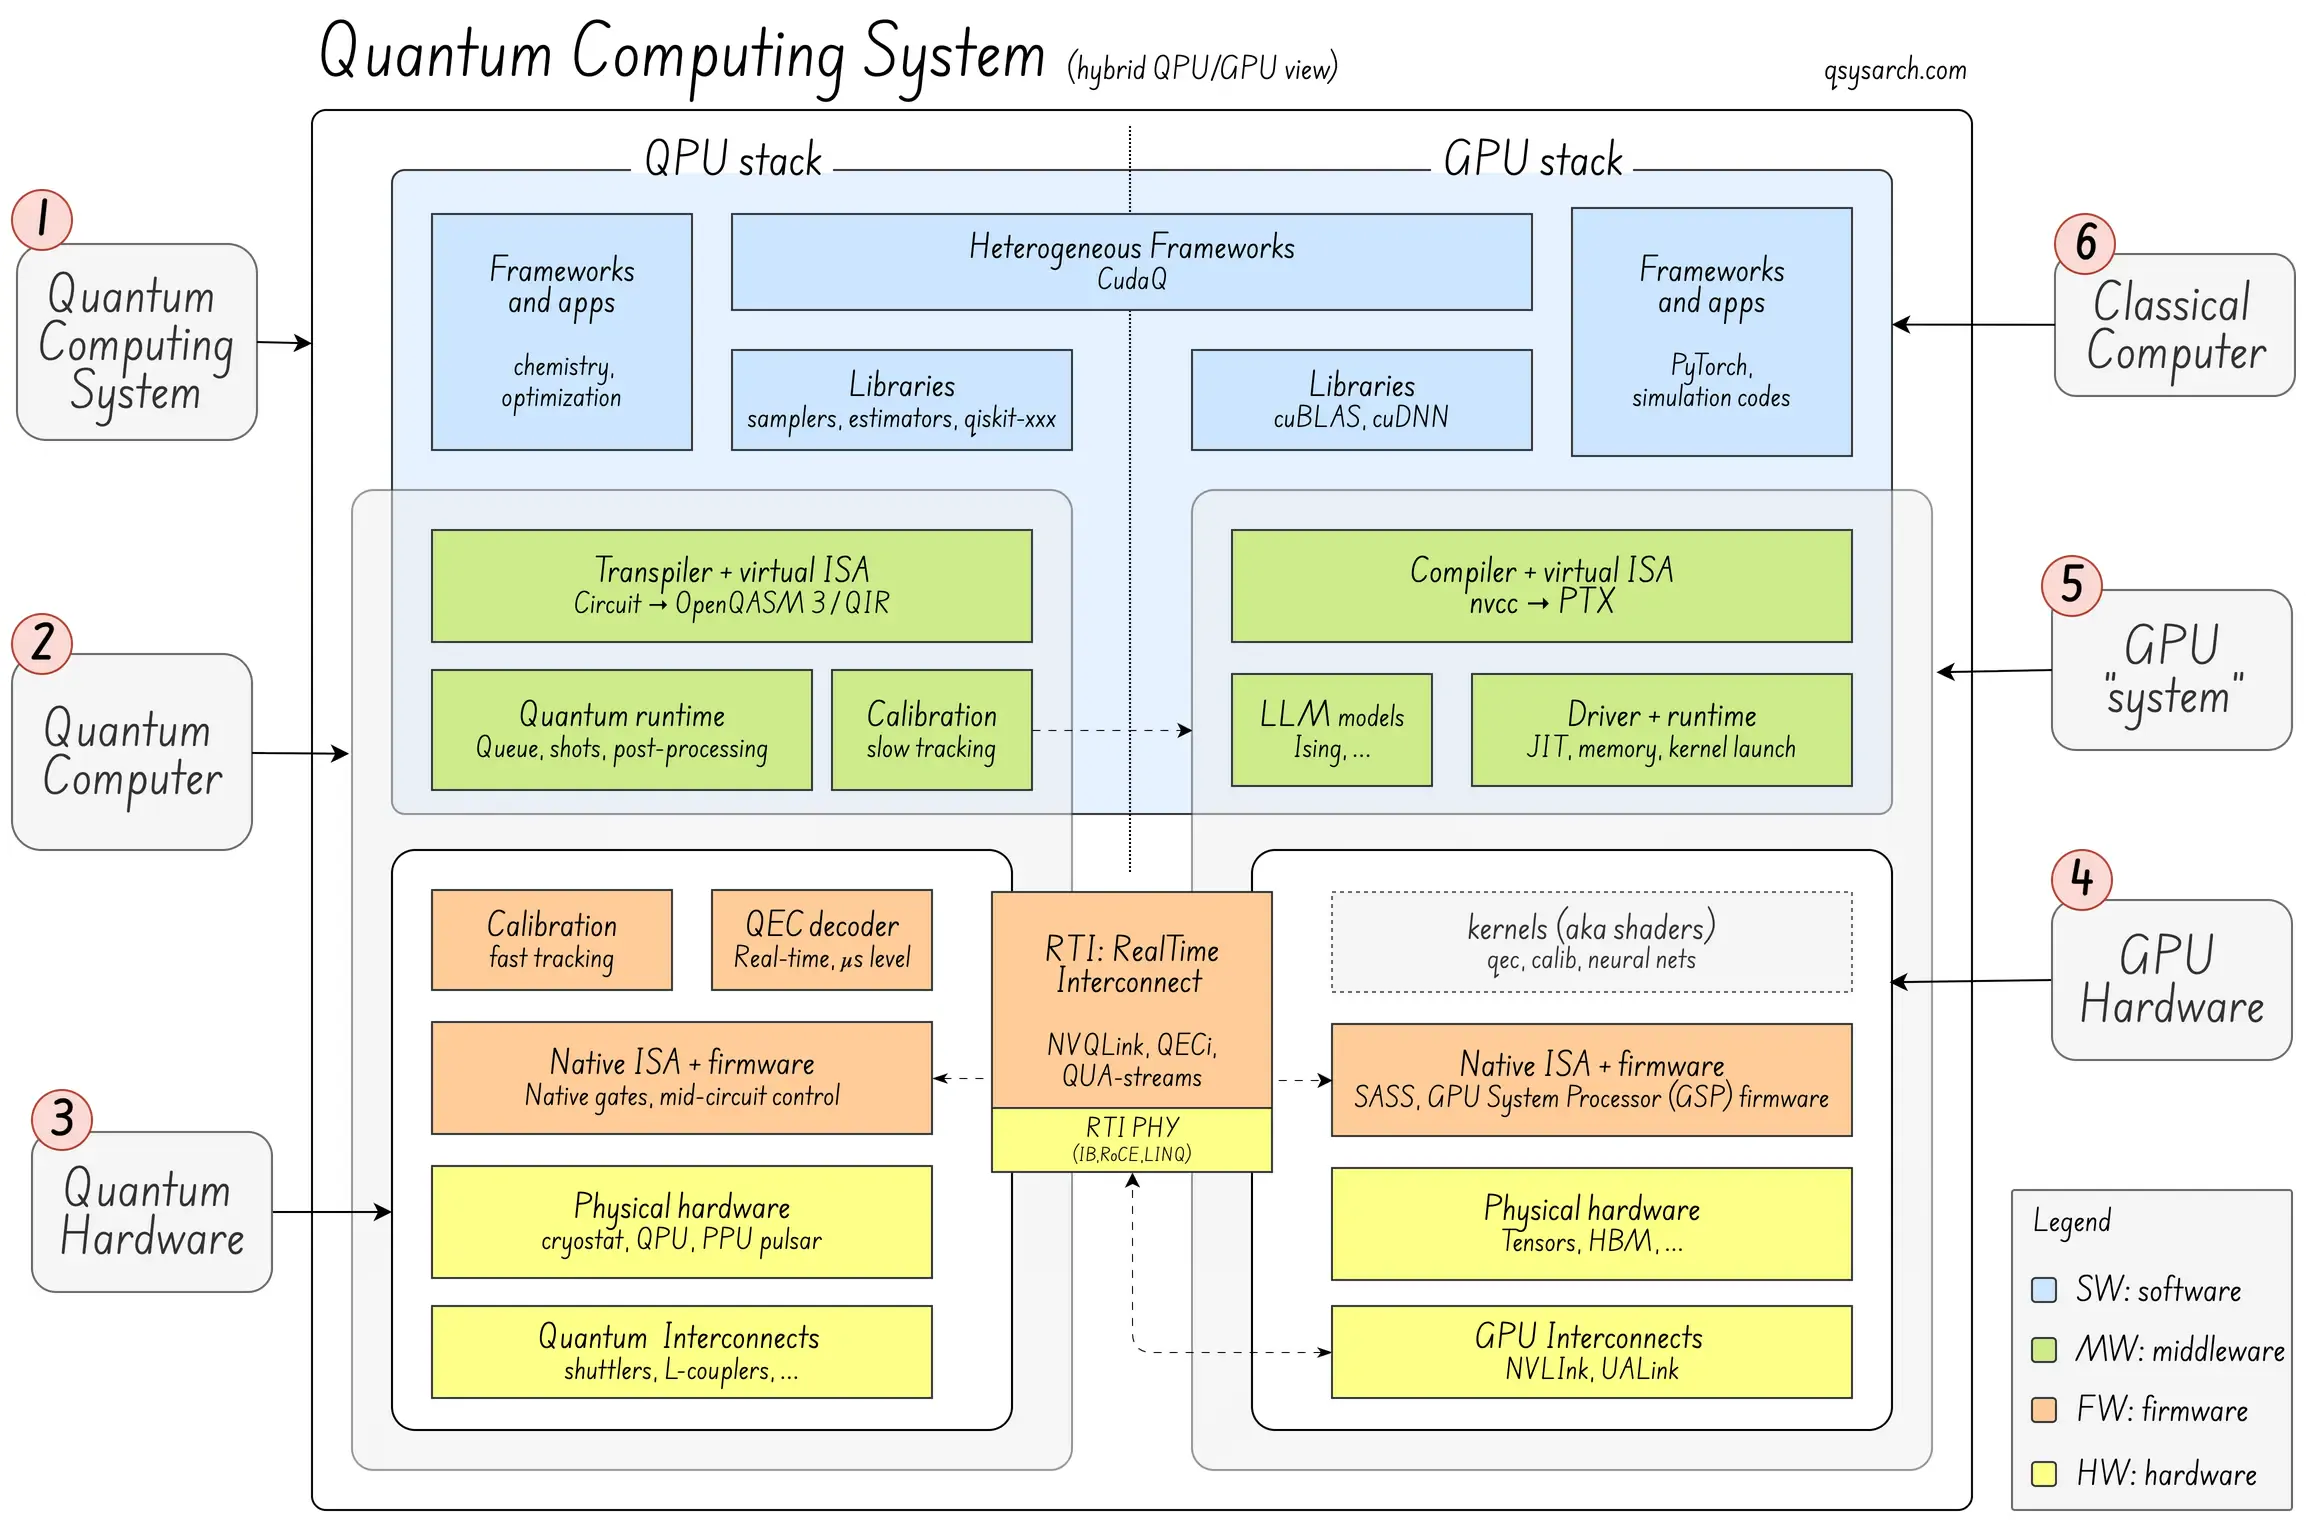
從系統角度來看,QPU 與 GPU 並沒有太大差別。 QPU 和 GPU 堆疊的不同層之間存在相似之處,在系統切片方面無需重新發明輪子:最好是利用英偉達和其他公司在過去 20 年中創建的成熟系統。
確定哪些部分在量子硬體上運行,哪些邏輯組件在經典硬體(即 CPU)上運行也很有幫助,即使兩者都是量子電腦的一部分(即量子電腦 = 經典硬體 + 量子硬體)。
Olivier Erzaty 對最初發佈在 LinkedIn 上的原始圖表提出了有益的回饋意見:
互連:至少存在兩條互連線。量子互連線用於傳輸糾纏的量子實體。另一條互連線是即時經典互連線,在 NVQLink 中稱為即時互連線 (RTI)。此外,還有一個標準的經典網路連接各個 CPU,但圖中未顯示。
校準:理想情況下,校準應該是即時的,但目前大多數情況下還無法實現。目前有兩種校準方式:即時校準,它利用量子硬體內部的NPU和讀出或伴隨式數據運行;以及較慢的校準,它利用CPU或GPU,使用諸如伊辛模型等高級vLLM模型運行。這兩種方法最終可能會融合,但這可能需要幾年時間。
加速:第一張圖使用了「量子硬體加速」一詞,旨在強調即使沒有量子處理器(QPU),量子電路也可以在GPU加速的哈密頓量模擬器上運行,儘管其量子位元數量有限。然而,正如Olivier所指出的,一些量子領域(例如量子機器學習)使用量子解決方案來提升結果,但並非一定是為了提高速度。為避免混淆,量子硬體特有的元件(序列器、控制器、脈衝星、低溫記憶體和量子晶片)統稱為「量子硬體」。
系統層級 Link to heading
這就形成如下層級結構,與奧利維爾所提出的結構類似:
量子系統:一種異構混合系統,可將 GPU、CPU 和 QPU 一起運作。
量子電腦:執行量子電路並產生機率讀出的系統。
量子硬體:量子處理器所在的實體部分,以及低溫處理器和實體處理器。
以下幾點要注意:
xPUs:我提到了“GPU、CPU 和 QPU”,但我本可以使用“ xPU ”作為任何處理單元的通用術語,因為該系統也可能使用 TPU 和 NPU。
PPU:PPU 代表「脈衝處理單元」。它是韌體運作的元件,負責控制和讀取脈衝星、(電路中)排序、QEC 和 RTI 網路。
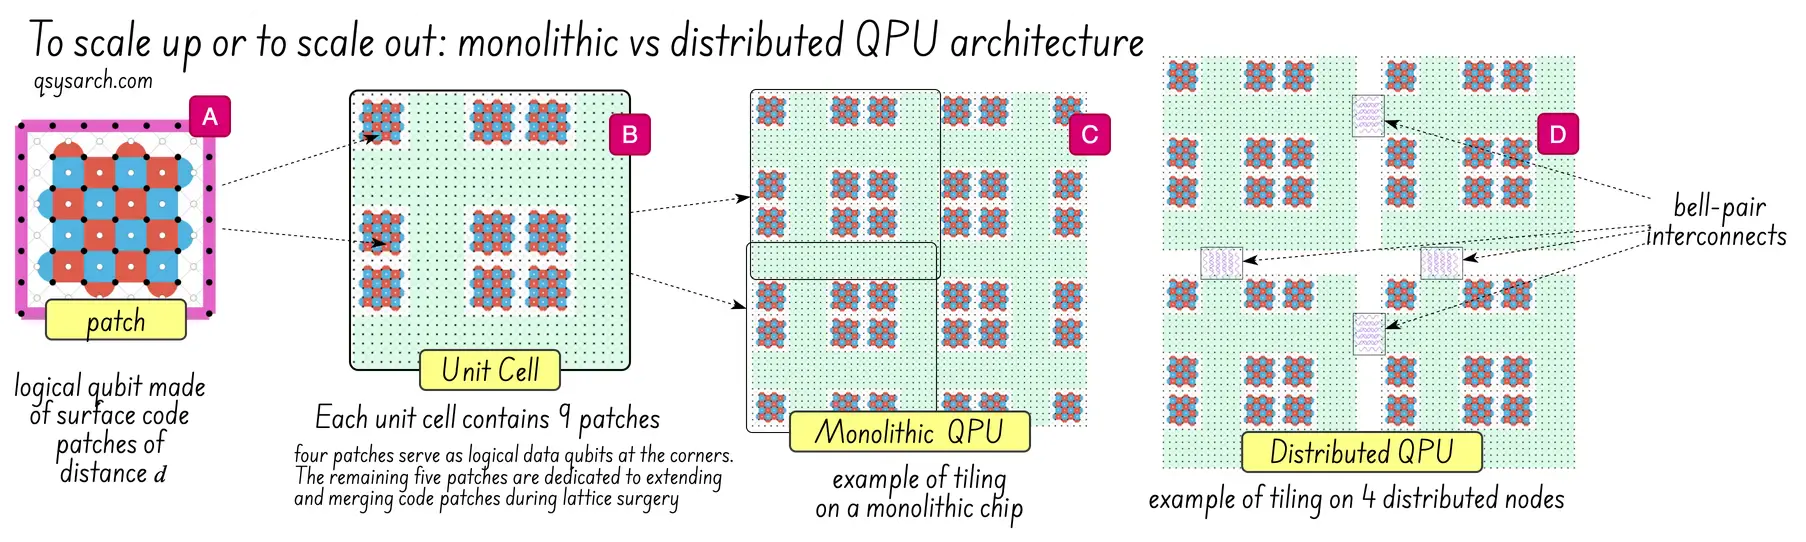
GPU 與 PPU:在 GPU 或 PPU 上運行核心需要在資訊傳輸成本和運算能力之間進行權衡,尤其是在將 PPU 放置在低溫恆溫器內部時。
對最後一點(性能權衡)感興趣的讀者可以查看 Nikoforos Paraskevopoulos 等人的文章“向上擴展還是向外擴展”,該文章從量子互連的角度回答了這個問題。類似的方法也可以量化經典的 RTI。
# 結論
這份簡短的備忘錄幫助我釐清了運行量子運算單元(QPU)的量子運算系統中各個元件之間的關係。我借用了GPU的類比,讓圍繞QPU「積體電路」的各個元件更容易理解。
當然,這只是一個簡化的視圖,我特意省略了很多細節。我會在以後的備忘錄中詳細介紹。同時,如果您有興趣,可以了解英偉達的CUDA Q ,它已經解決了圖中上半部所示的許多設計難題。
我還要感謝 Oliver Erzaty 的回饋,以及 Michaela Eichinger 一貫富有洞察力的問題和貼文。
References:
- NVQLink: Real-time accelerated computing for every quantum processor
- CudaQ: NVIDIA’s open platform for quantum computing and the foundation for accelerated quantum supercomputing
- PPU: Real-Time Quantum Control at the Pulse Level
- NVIDIA Ising: Accelerating Quantum Computing Breakthroughs with AI
- To Scale Up or To Scale Out: Evaluating Space-Time Costs of Compiled Logical Circuits on Modular Superconducting Quantum Processors
- Quantum Compiler Design for Fault-Tolerant Quantum Computing
For reference, this is the initial diagram posted on LinkedIn:
DrawIO diagrams used in this memo:


