使用人工智慧,更準確地說是神經網路(NN),不僅是顯而易見的,而且幾乎是2025年任何系統的必備組成部分。毫不奇怪,關於這主題的研究論文層出不窮。然而,最新的研究透過將神經網路高效整合到量子控制系統中,將這一領域推向了新的高度。
本文以新加坡量子技術中心 CQT/NUS 的工作為基礎,更具體地說是以 Arthur Strauss 的研究為基礎。我有幸在上一次 SQA 活動中與他進行了討論和交流。
他們的想法非常吸引人:利用強化學習方法,基於旨在最大化控制效率的獎勵機制,幫助量子控制系統調整量子位元的控制(即量子閘)。你可能會問,這有什麼意義呢?如前文(link)所述,量子位元是非常敏感的“實體”,需要格外注意。而神經網路的作用就在於此,它能夠幫助量化這種關注的質量,也就是我們常說的保真度。
這是如何工作的?強化學習基於觀察/動作的循環,透過迭代的環境 -> 智能體獎勵系統(下圖中的“a”)進行學習,通常使用 GPU 運行,然後,一旦學習完成,就在緊密耦合的矩陣乘法器(或不!
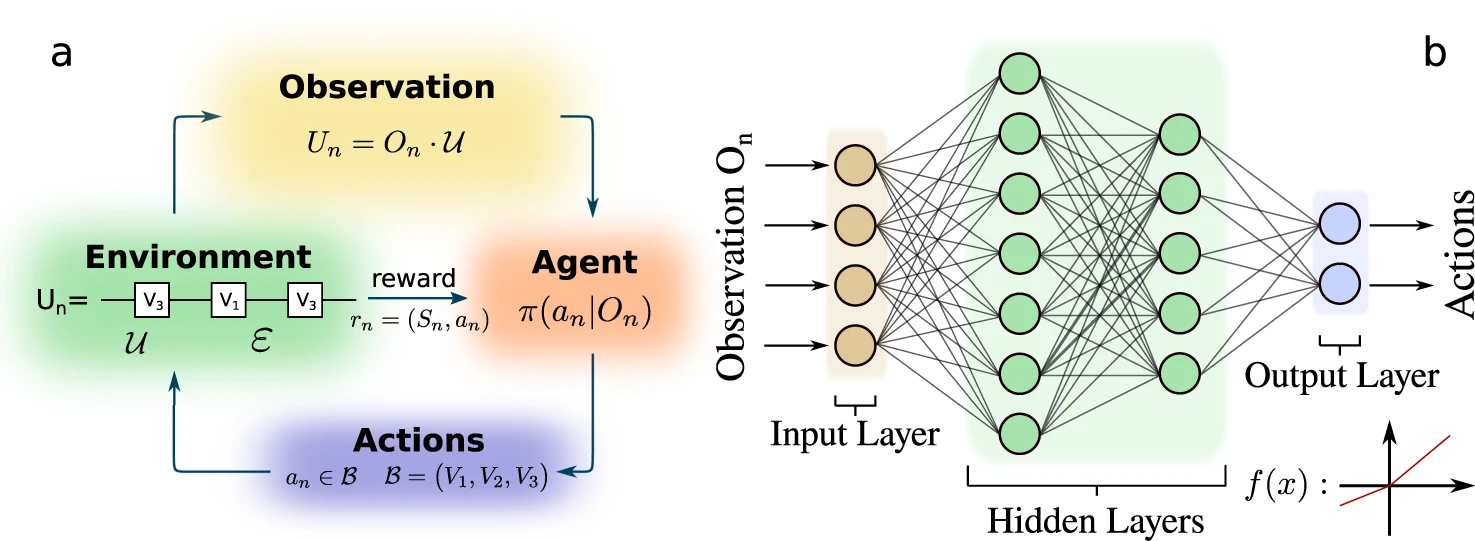 圖片來源:Nature
請注意,由於觀測(也稱為量子位元讀出)會破壞量子態,因此學習週期首先重置量子位元狀態,執行控制閘,讀出量子位元狀態,並將資訊回饋給代理。
讓我們詳細了解強化學習的 4 個組成部分:
*環境即量子控制器和量子位元本身。
- 這些操作是調整射頻產生器引擎的不同“旋鈕”或脈衝參數。
*觀察結果是量子位元在受到環境操縱後的特性。
- 代理* 學習對觀察到的量子位元特徵做出反應的策略,並相應地調整脈衝參數。
強化學習方法通常可以分為兩大類:基於價值的方法和基於策略梯度的方法。
基於價值的方法著重於估計價值函數並從中匯出策略。 基於策略梯度的方法透過梯度上升最大化預期累積獎勵來直接優化策略。
策略迭代的優點在於其收斂速度遠快於基於值的策略,儘管計算成本更高。而策略梯度演算法正是透過降低計算複雜度來發揮作用。策略梯度演算法範例,包括 reinforce 演算法:
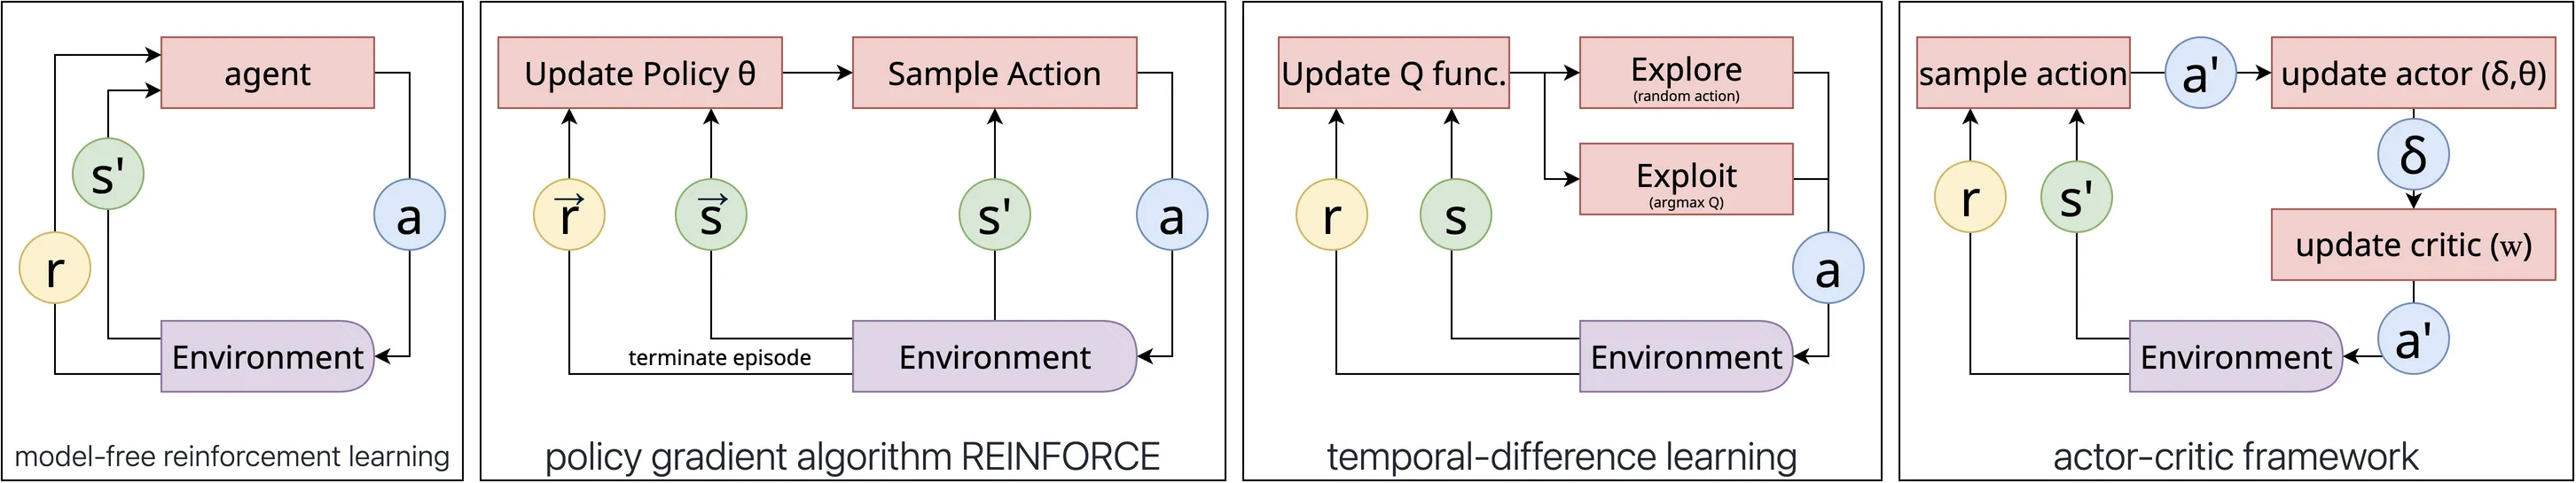
在上圖中,「s」代表狀態,「a」代表動作,「r」代表獎勵。
在強化學習中,回合和迭代是不同的概念:
集數:
一個事件是智能體與環境之間一系列完整的交互,從初始狀態開始,到終止狀態結束(或達到最大時間範圍後)。
例如:在西洋棋比賽中,一集就是一局完整的比賽-從棋盤開始到將死、和棋或認輸為止。
迭代:
在某些論文/代碼中,一次迭代可能意味著智能體與環境互動的一個時間步(狀態→動作→獎勵→下一個狀態)。
在最佳化上下文中,一次迭代可能意味著學習演算法的一次更新步驟(例如,一次梯度下降步驟,該步驟可能基於多個回合或轉換)。
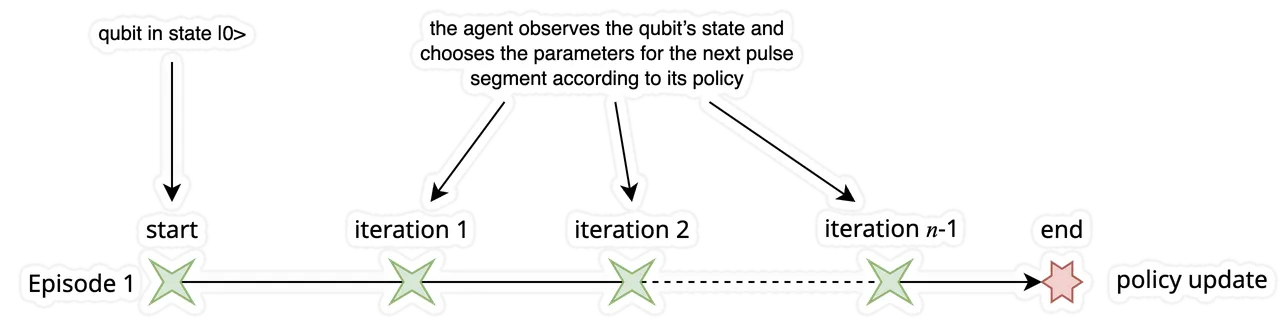
讓我們逐一實現這些想法,先從劇集抽樣開始。
在策略梯度強化學習中,得分和獎勵共同驅動學習更新:
待完成
# 結論
抱歉,原本想寫一篇輕鬆的博客,結果卻變得複雜得多。或許我還需要繼續「簡化問題」。無論如何,我們從中學到了什麼?優化量子位元品質的過程涉及的維度太多——不出所料,神經網路非常擅長應對這一挑戰。這篇部落格我們主要關注的是單量子位元的保真度優化。但如果是兩個或更多量子位元呢?那就需要考慮串擾的影響。這其中有許多問題和挑戰,尤其是在如何學習方面:是在多量子位元層面進行全局學習,還是在量子位元對層面進行局部學習?甚至可能是在邏輯量子位元層面進行分層學習。這些問題我將在下一篇關於量子糾錯的部落格中探討。
延伸閱讀及連結: