在人工智慧能耗巨大的今天,張量處理單元(TPU)的出現改變了遊戲規則。它是谷歌專門為機器學習任務定制設計的晶片。
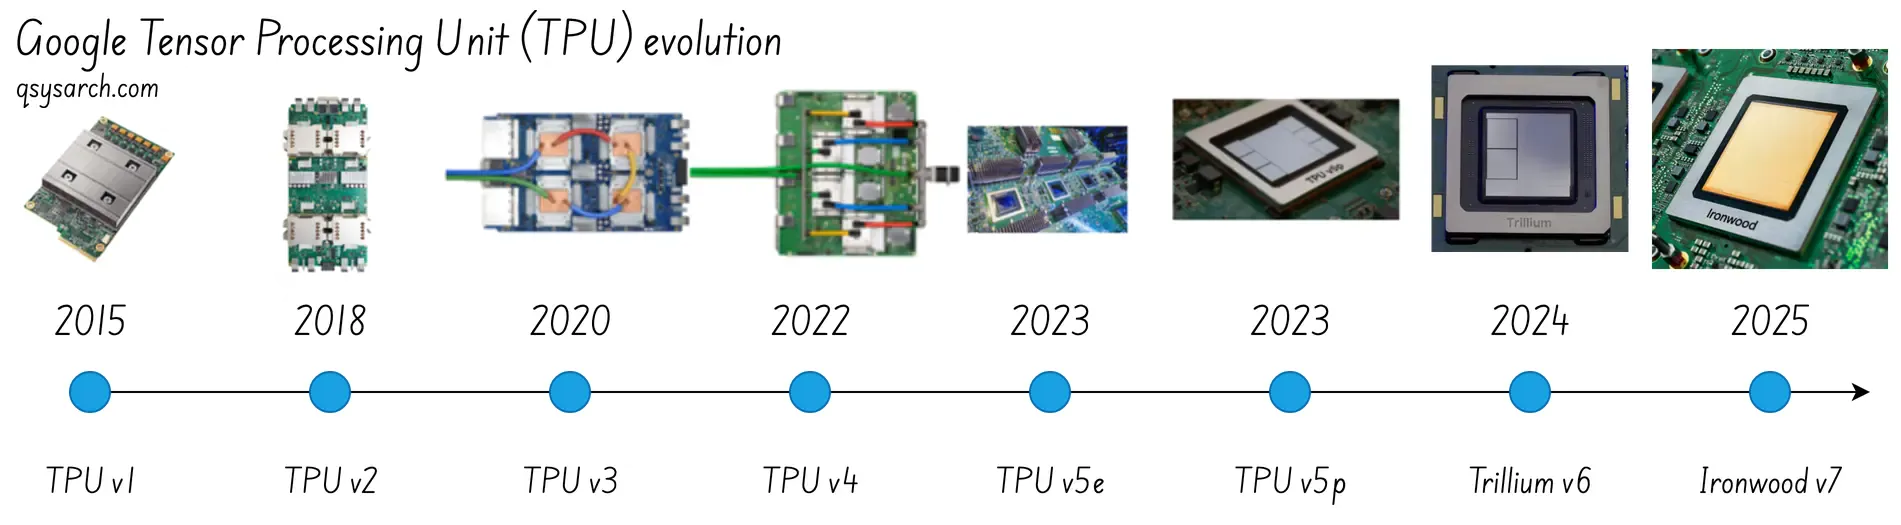
這份簡短的備忘錄旨在提供 TPU 架構的高階系統視圖,以及自 2016 年誕生以來 TPU 的發展演進。
我還會嘗試回答這個關鍵問題:既然我們已經有了GPU,為什麼還需要TPU? TPU有哪些GPU所不具備的優勢?它們與神經形態積體電路相比如何?除了TPU和GPU之外,還有其他架構可供選擇嗎?
 (來源:Google Cloud)
TPU 與 GPU 有著相同的目標:透過實現大規模並行性來克服摩爾定律減緩帶來的限制:與可用於處理通用運算的傳統 CPU 不同,傳統 CPU 在一定程度上透過多核心概念實現了一定程度的並行性(這要歸功於丹納德縮放定律),TPU 和 GPU 是專門設計的硬體,用於處理簡單且特定的任務,但遠高於 CPU。
從宏觀層面來說,可以說它們透過「犧牲通用性來換取效能」的方式,提供了比通用 CPU 或 GPU 更優異的效能和效率。
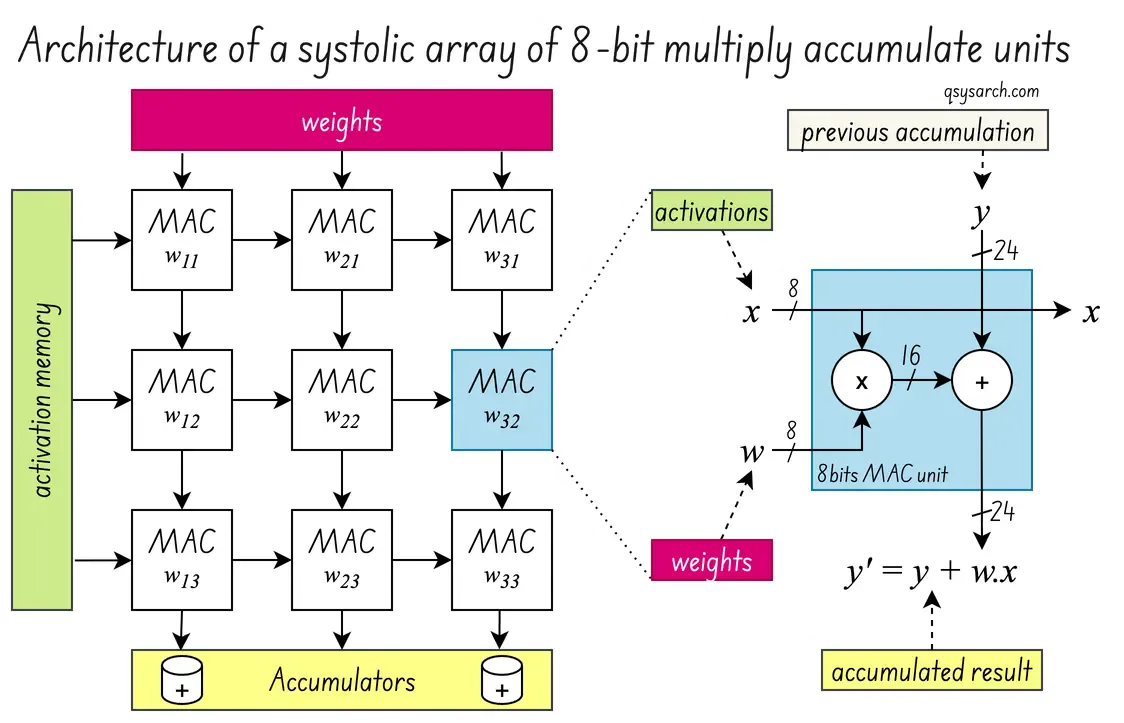
TPU 從根本上來說是為神經網路使用的繁重線性代數任務而設計的,例如矩陣乘法和張量運算。
TPU 的核心是脈動陣列,它是一個處理單元矩陣(通常稱為 PE,在右圖中表示為 MAC),可以執行平行計算。
以 TPU 為例,這個處理單元(或稱為 MAC)是一個簡單的 8 位元乘法器,它將活化值(嵌入向量)與神經網路的權重相乘並累積。只有透過大規模並行執行此操作,TPU 才能實現比 CPU 高得多的吞吐量。 GPU 也是如此!但首先,讓我們回顧一下 TPU 的發展歷程。
TPUv1只花了15個月就開發完成,其主要目標是提升神經網路的推理能力(並非學習能力,而僅僅是推理能力)。為此,Google需要矩陣乘法器,並且不僅要確保高速運行,還要降低功耗。降低功耗的關鍵在於提高記憶體局部性,例如減少外部記憶體和TPU記憶體之間不必要的資料傳輸。這將提高單位控制時間的運算強度,即減少TPU等待資料的空閒時間。
從硬體角度來看,TPU v1 的設計簡潔明了,卻又十分有效:
複雜性轉移到了軟體調度程序,它主要負責兩項任務:
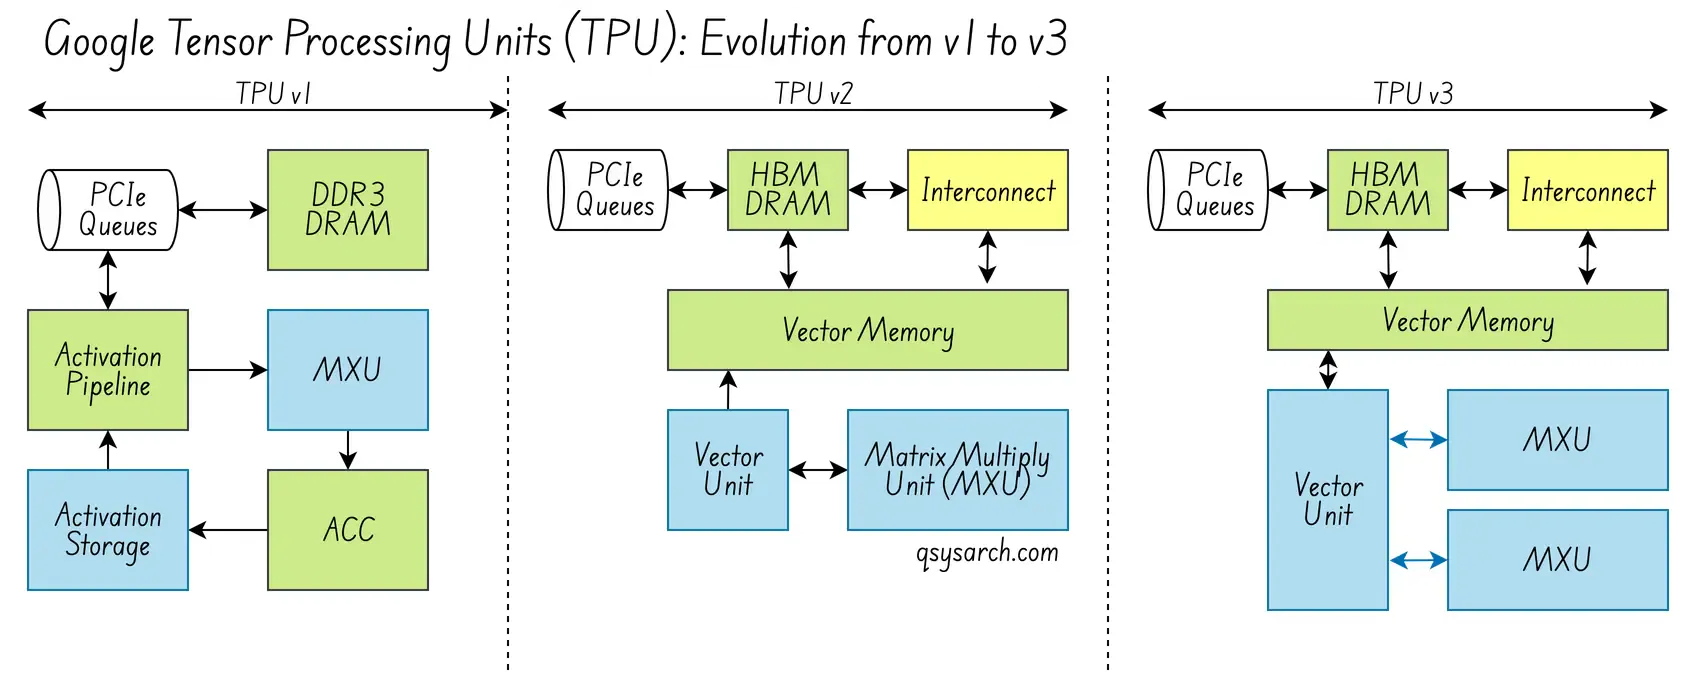
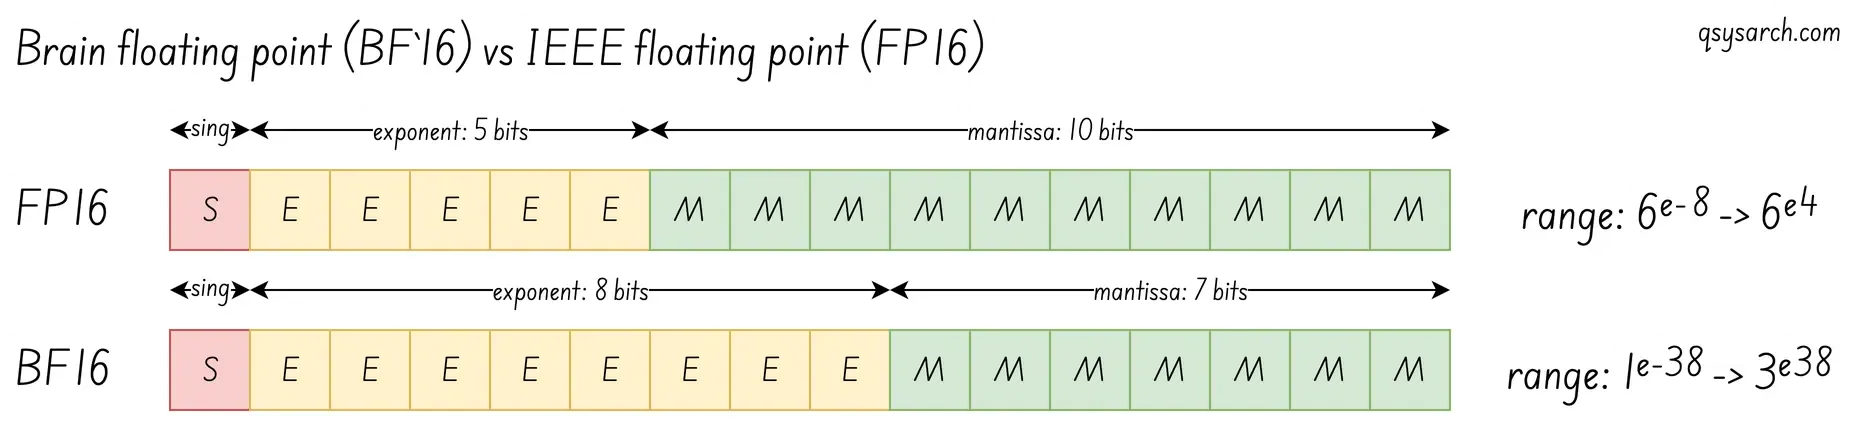
v2 和 v3 的關鍵概念是訓練下一代模型,這些模型需要反向傳播、更高的精度和更多分佈式、互連的 TPU。
從硬體核心處理的角度來看,他們引入了一些相當不錯的概念:
- 雙核心晶片,例如一個__TPUv2__由兩個TPU組成
每個 TPU 都有一個大四倍的收縮期陣列,由 128*128 MXU 組成。
從硬體連接的角度來看,
- 核心間互連 (ICI),即高頻寬結構,可透過 16x16 2D 環形網路(環網)實現擴展 - 256 個晶片的超級電腦組。
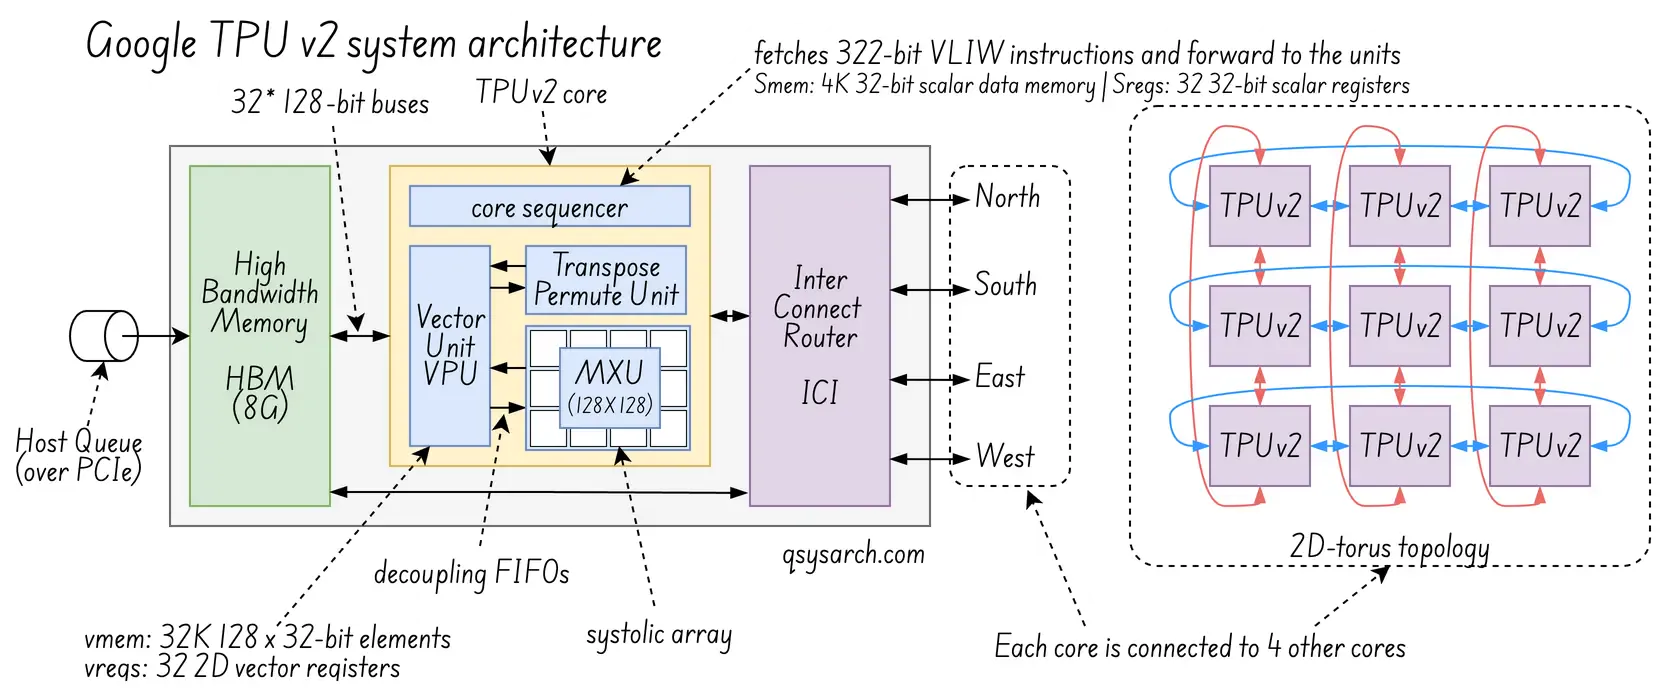
從軟體角度來看,一個強大的編譯器:
- XLA 編譯器: 產生核心序列器 (TCS) 使用的 VLIW 指令的大腦。
TPUv4:超大規模人工智慧
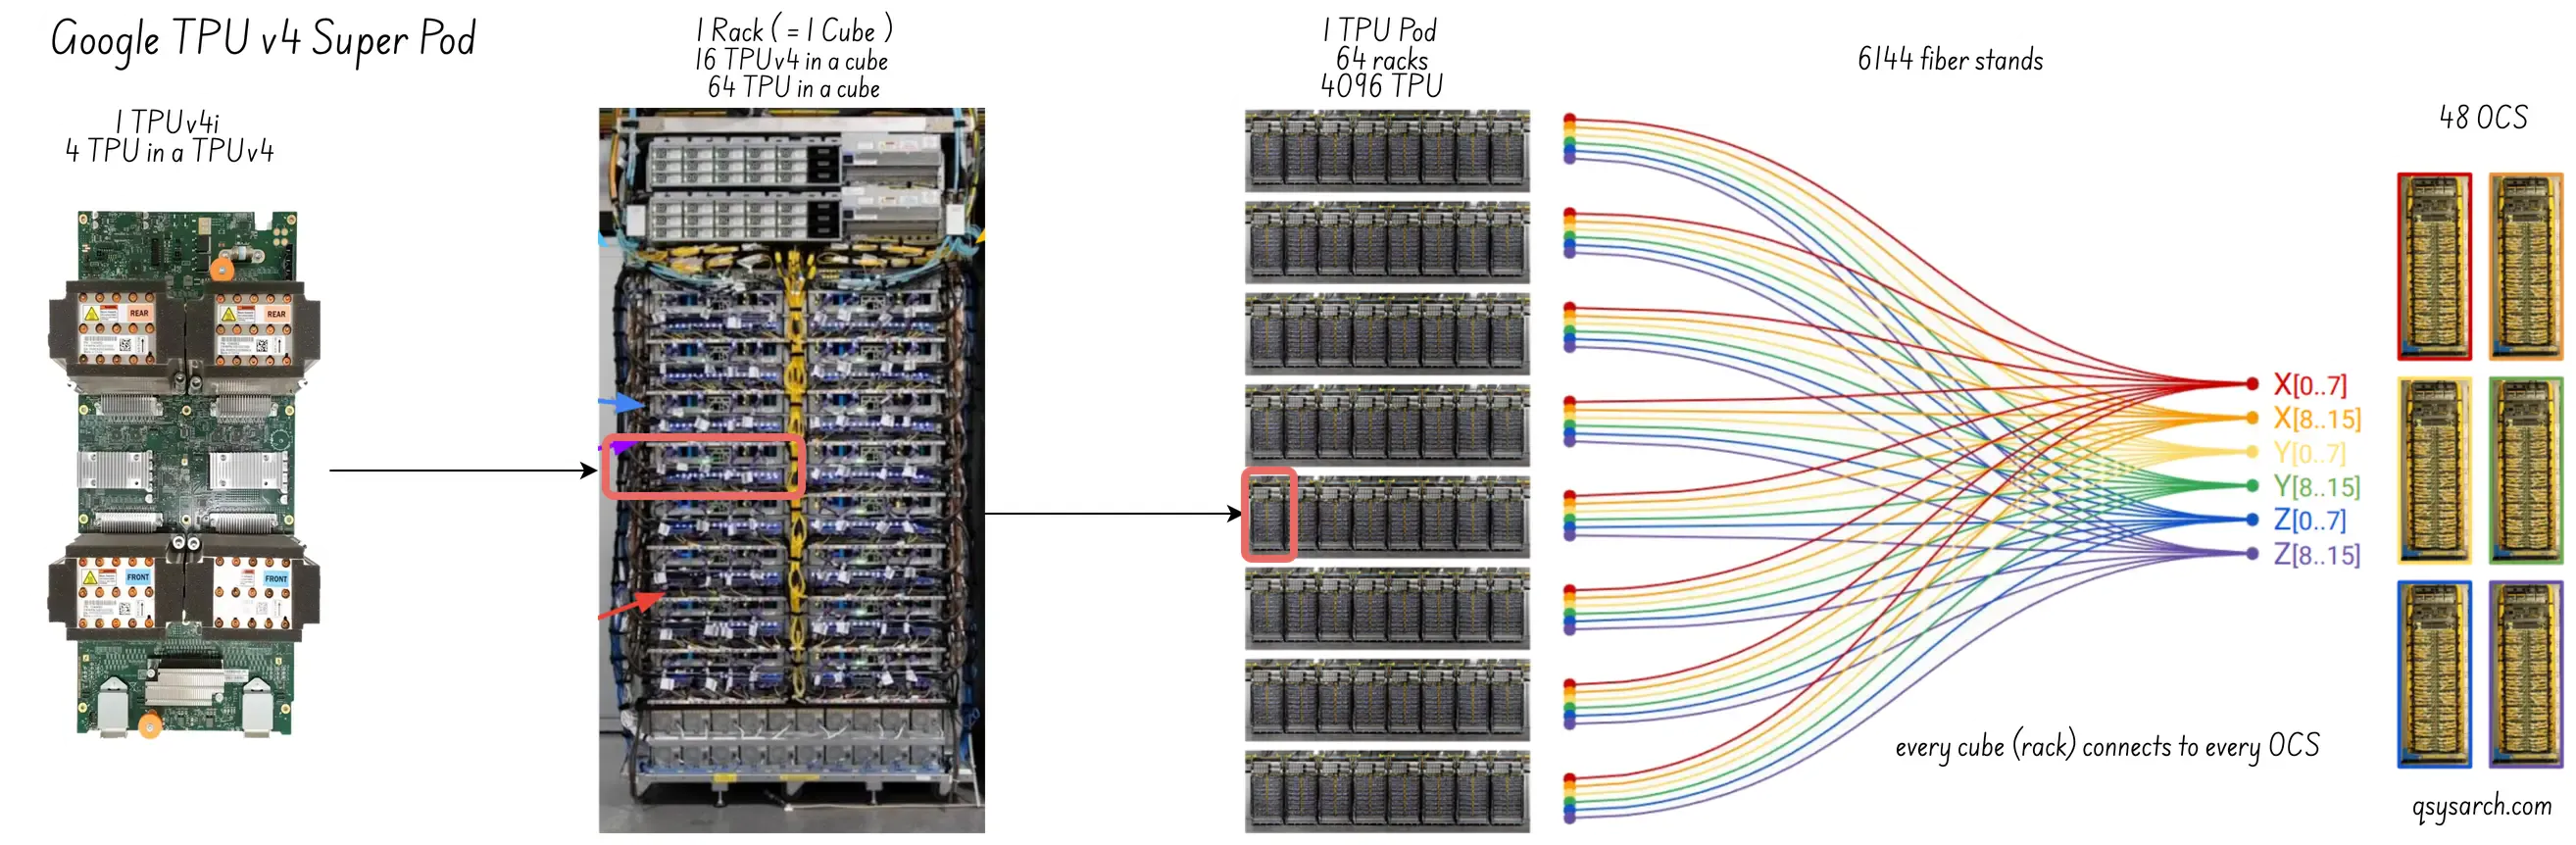
v4 版本的核心概念是能夠以超大規模運行 AI 模型。這意味著關鍵的驅動指標是總擁有成本 (TCO)。
最新一代的超級電腦專為大規模訓練而設計。晶片以機架或晶片組的形式連接,配備先進的儲存系統和互連技術。它們支援大型張量運算、分散式訓練、同步以及跨多個晶片的高效資料共享。
從硬體核心處理的角度來看,他們引入了一些相當不錯的概念:
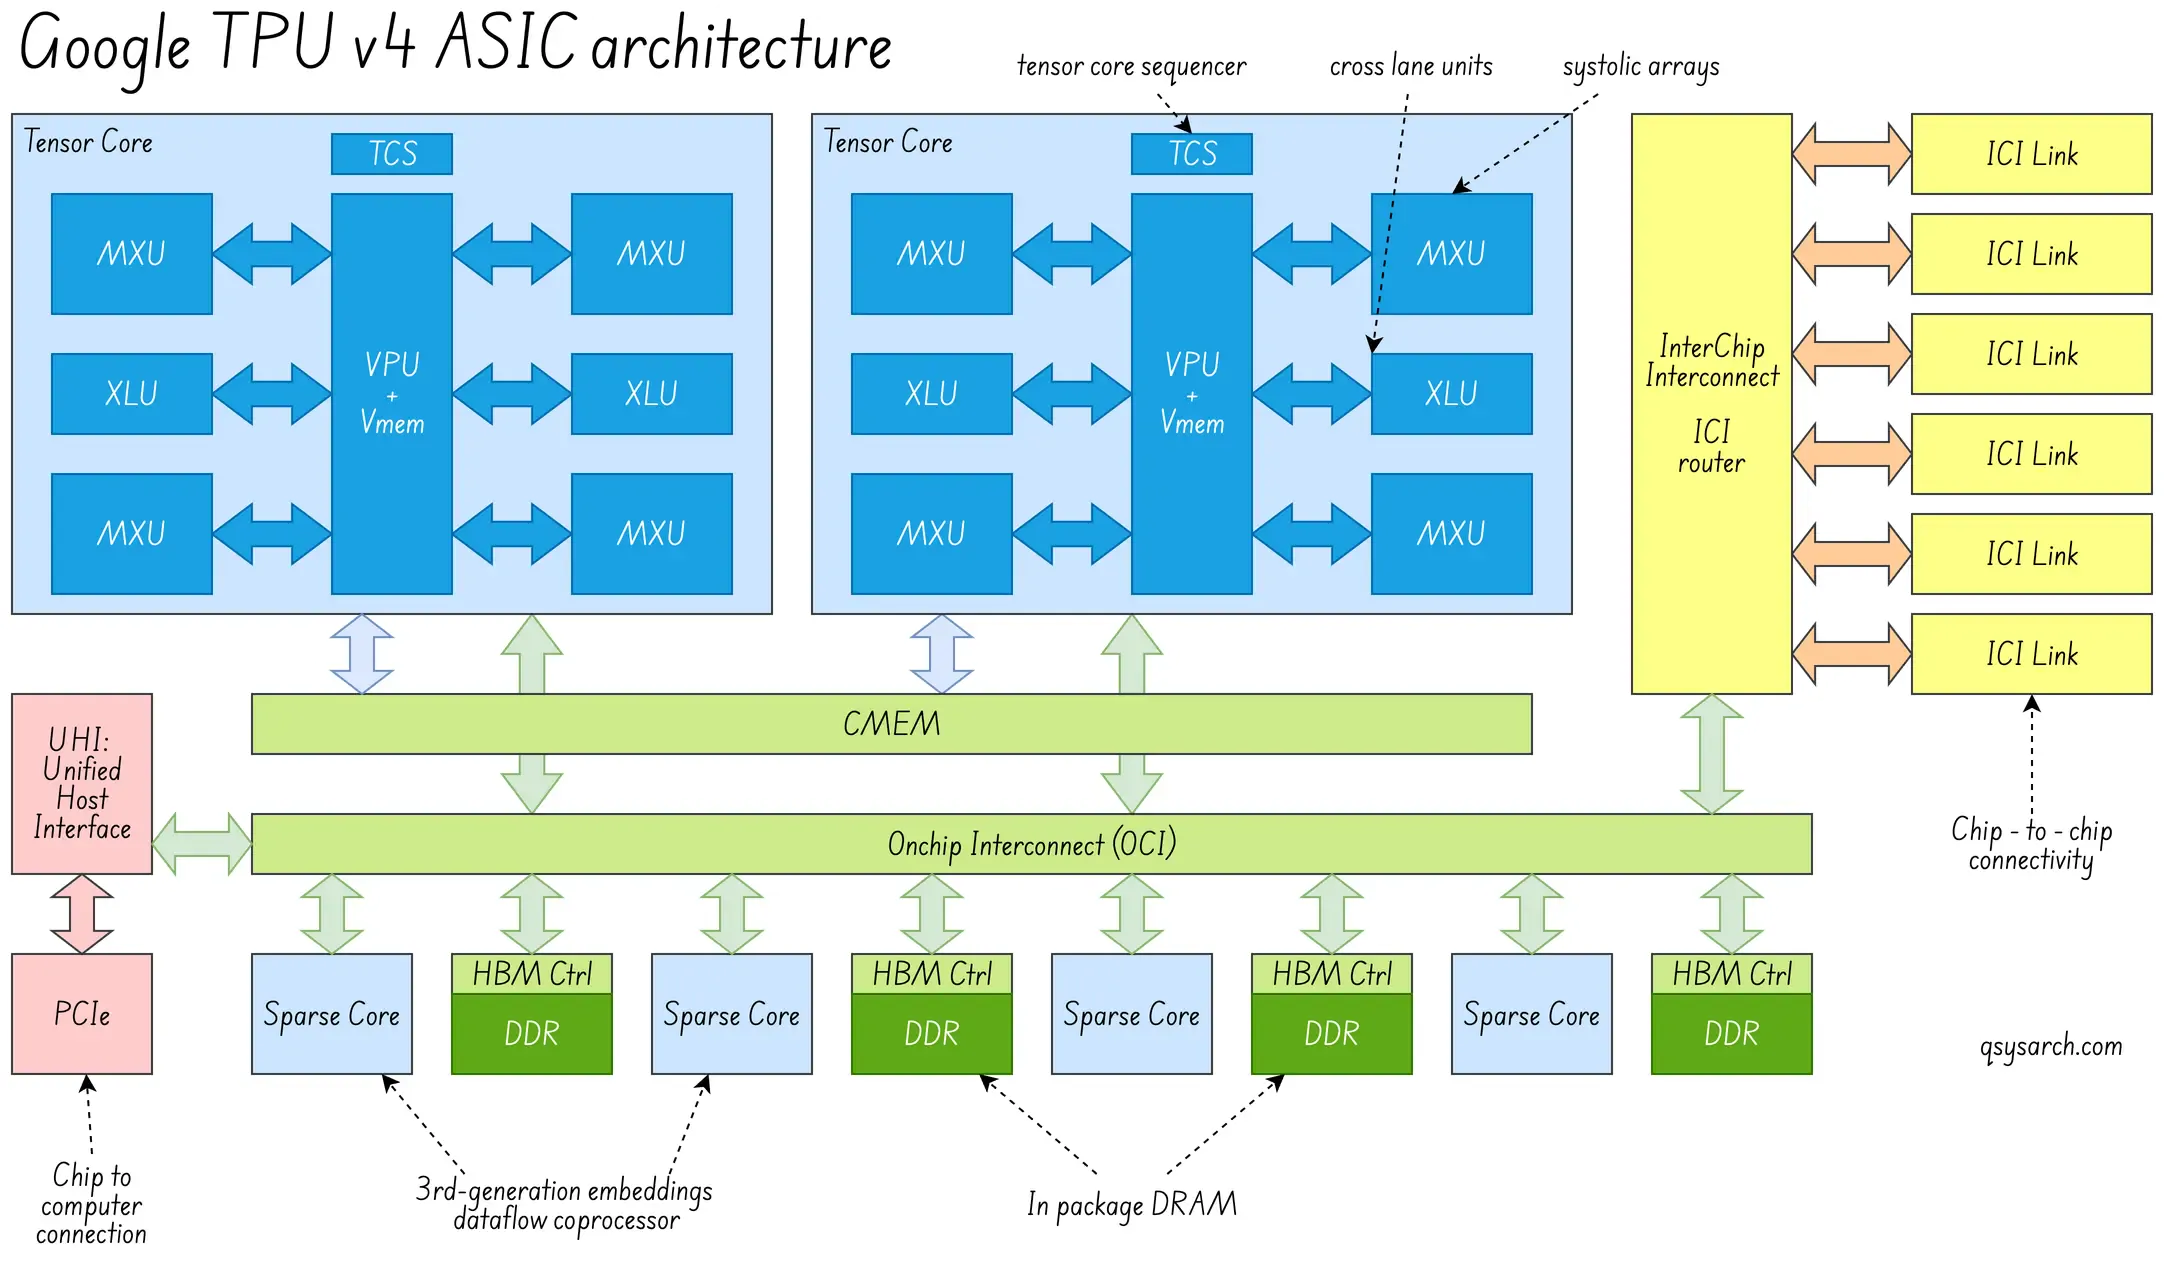
從硬體連接的角度來看,
最後,也是最重要的一點,透過實現三維環面,路由現在變成了三維的,這具有不可忽視的優勢,可以比二維環面更好地擴展通訊效率。
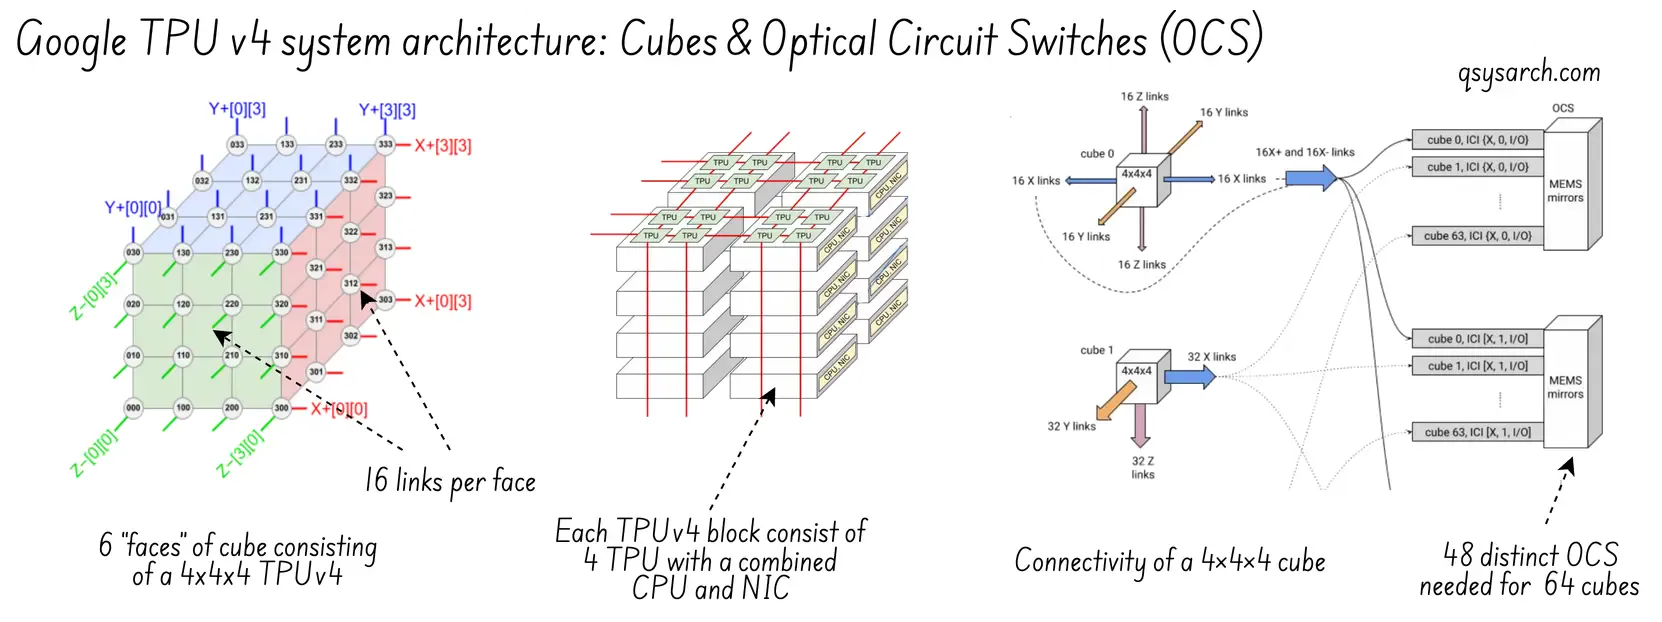
從軟體工程師的角度來看:
引入新工具:Borg 作為叢集管理器;pod 管理器用於配置 OCS;Libpunet 用於設定 ICI 路由表並處理容錯問題。
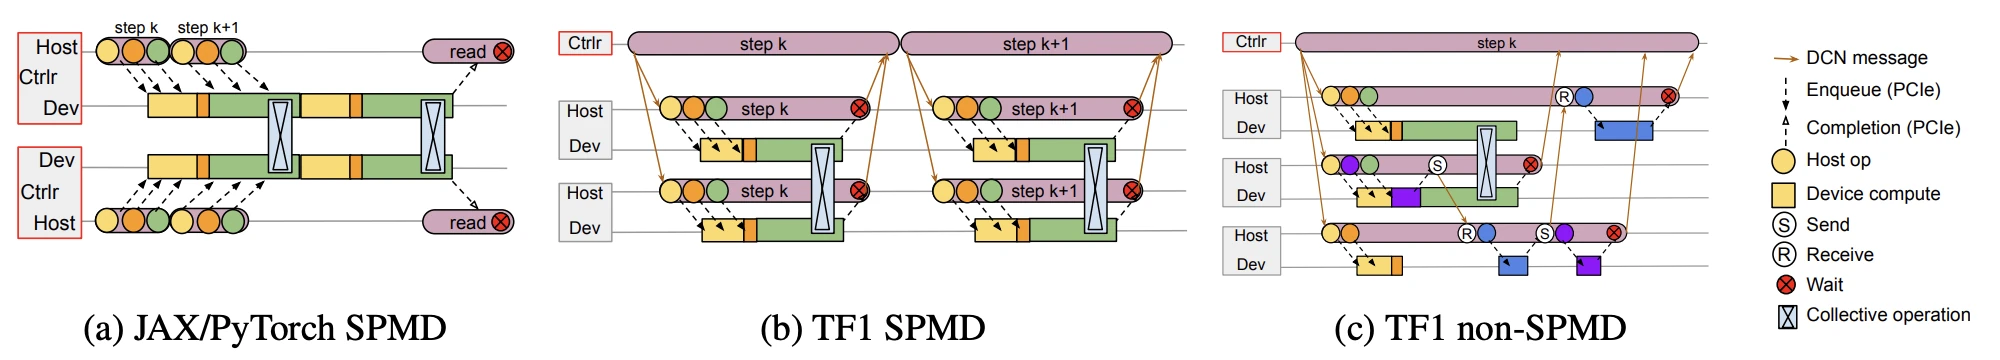
高階單程式多重資料 (SPMD) 編譯器:可以將其視為一種產生多個執行緒的編譯器,其中每個執行緒都是一個程序,可以運行在同一機架內的不同 TPU 上,也可以運行在不同的 TPU 上。它與 GPU 的 SIMT 概念有些類似,後者為 GPU warp 內的執行緒產生程式碼。
由於許多 TPU 運作的是同一個程序,Borg 協調器需要確保所有 TPU 都是同步的——這就是 Gang Scheduler 的作用。
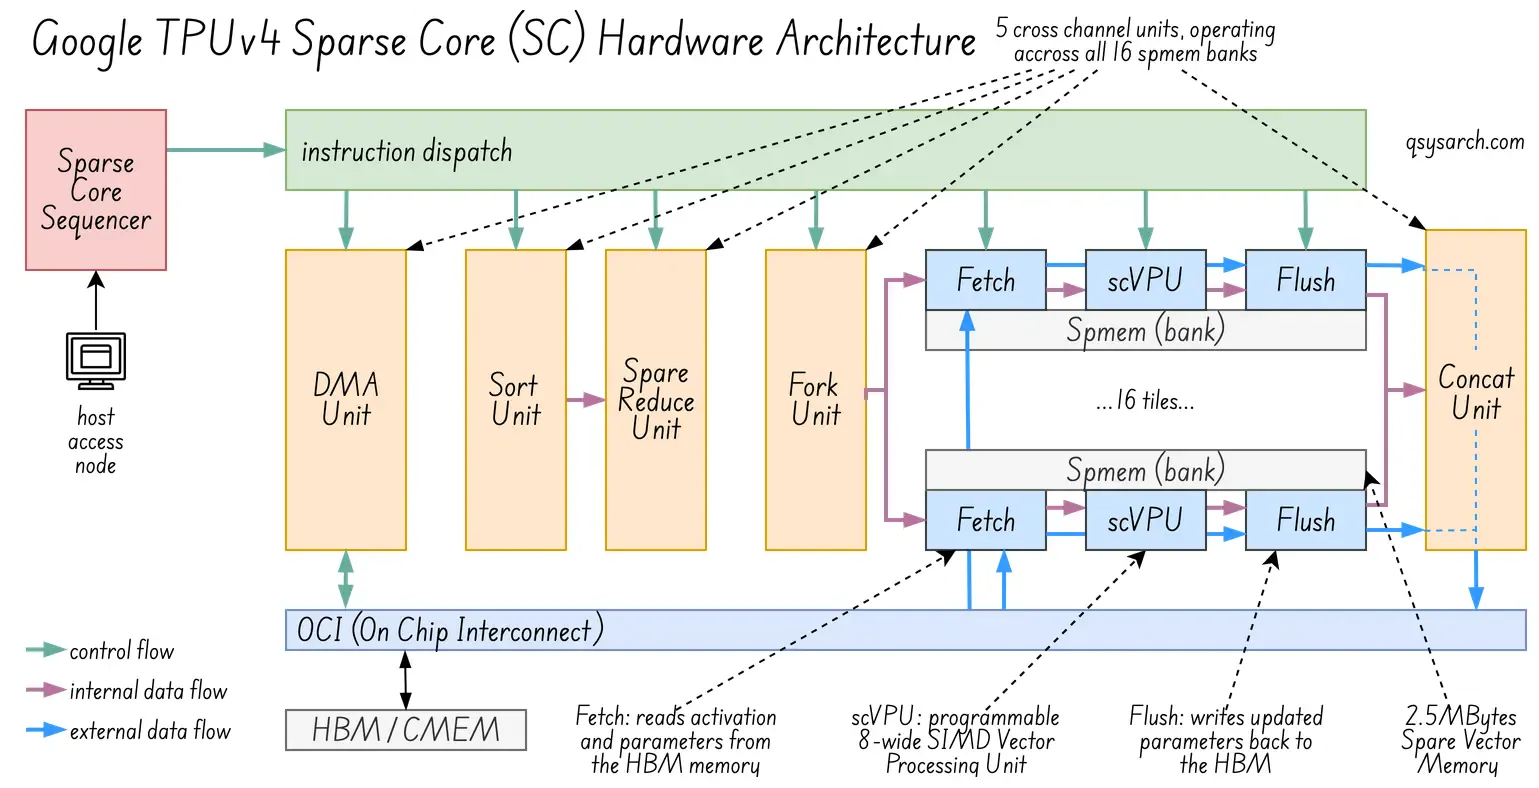
TPUv4 中的 SparseCore(簡稱 SC)負責加速稀疏矩陣工作負載,其中大部分值都是零或冗餘值(例如 LLM 中的嵌入)。它被描述為「嵌入查找」優化器,每個 TPUv4 都包含四個 SparseCore 處理器。
 (圖片改編自原始圖片來源)
稀疏核心序列器(左上角紅色部分)負責將指令分發給 5 個跨通道單元(橘色部分)以及 3 個「取指/處理/刷新」SIMD 單元(藍色部分)。每個 SIMD 單元都在其自身的 2.5MB 緊密耦合記憶體暫存區(灰色部分)上運作。
鑑於每個取指/處理/刷新 SIMD 單元一次操作 8 條資料通道 (SIMD=8),而一個稀疏核心處理器中有 16 個這樣的 SIMD 單元,這使得它成為一個非常強大的處理單元,幾乎就像 GPU 內部的一個微型 GPU!或者更準確地說,一個 TPU 內部有 4 個微型 GPU!
如果能了解一下用於對這款強大的 SparseCore 處理單元進行程式設計的指令集架構 (ISA) 就太好了,但我在網路上找不到任何相關資訊。這可能是因為它更像是一台功能強大的“同步 SIMD ALU 型 DMA 計算機”,其指令非常具體,因此只有提供更高層次的抽象層(例如 JAX 庫)才有意義。
實際上,使用者編寫高級功能程式碼,XLA(加速線性代數)編譯器識別與 SparseCore 硬體功能相符的模式。
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
@nn.compact
def __call__(self, indices):
embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
底層發生了什麼事? model.apply 方法呼叫 XLA 編譯器,將程式碼降級為 SparseCore。為此,它會匹配 nn.Embed(一個_gather_ 操作),並產生以下「偽指令」:
去重:XLA 注意到輸入中出現了兩次數字 42 和 105。它會產生 SparseCore 指令,在提取資料之前對這兩個數字進行去重。
DMA:產生 SC 標量指令,以計算 ID 105、42 和 28 的記憶體偏移量。
Push:將產生的 5*128 張量移回公共記憶體 (CMEM)。
XLA 編譯器也需要處理資料放置問題。特別是,由於稀疏核心需要存取 nn.Embed 索引,因此這些索引必須放置在稀疏核心可存取的記憶體中。它可以將資料放置在 CMEM 中,但 CMEM 容量很小(128MB),因此通常會將嵌入資料放置在較大的 HBM 中(TPUv4 為 32GB)。然而,稀疏核心處理的輸出結果會放回 CMEM 中,因為它只是資料的一部分。
值得注意的是,SparseCore 架構在接下來的 v6+ 世代中得到了發展。
教育部專家混合模式與途徑
與傳統方法不同,混合專家組(MoE)…
pathways 概念指的是令牌在分佈於不同 TPU 晶片上的專家之間進行分片時所採取的實體和邏輯路徑。
 (圖片來源)
2023 年及以後:v5、v6(Trillum)和 v7(Ironwood)
Link to heading
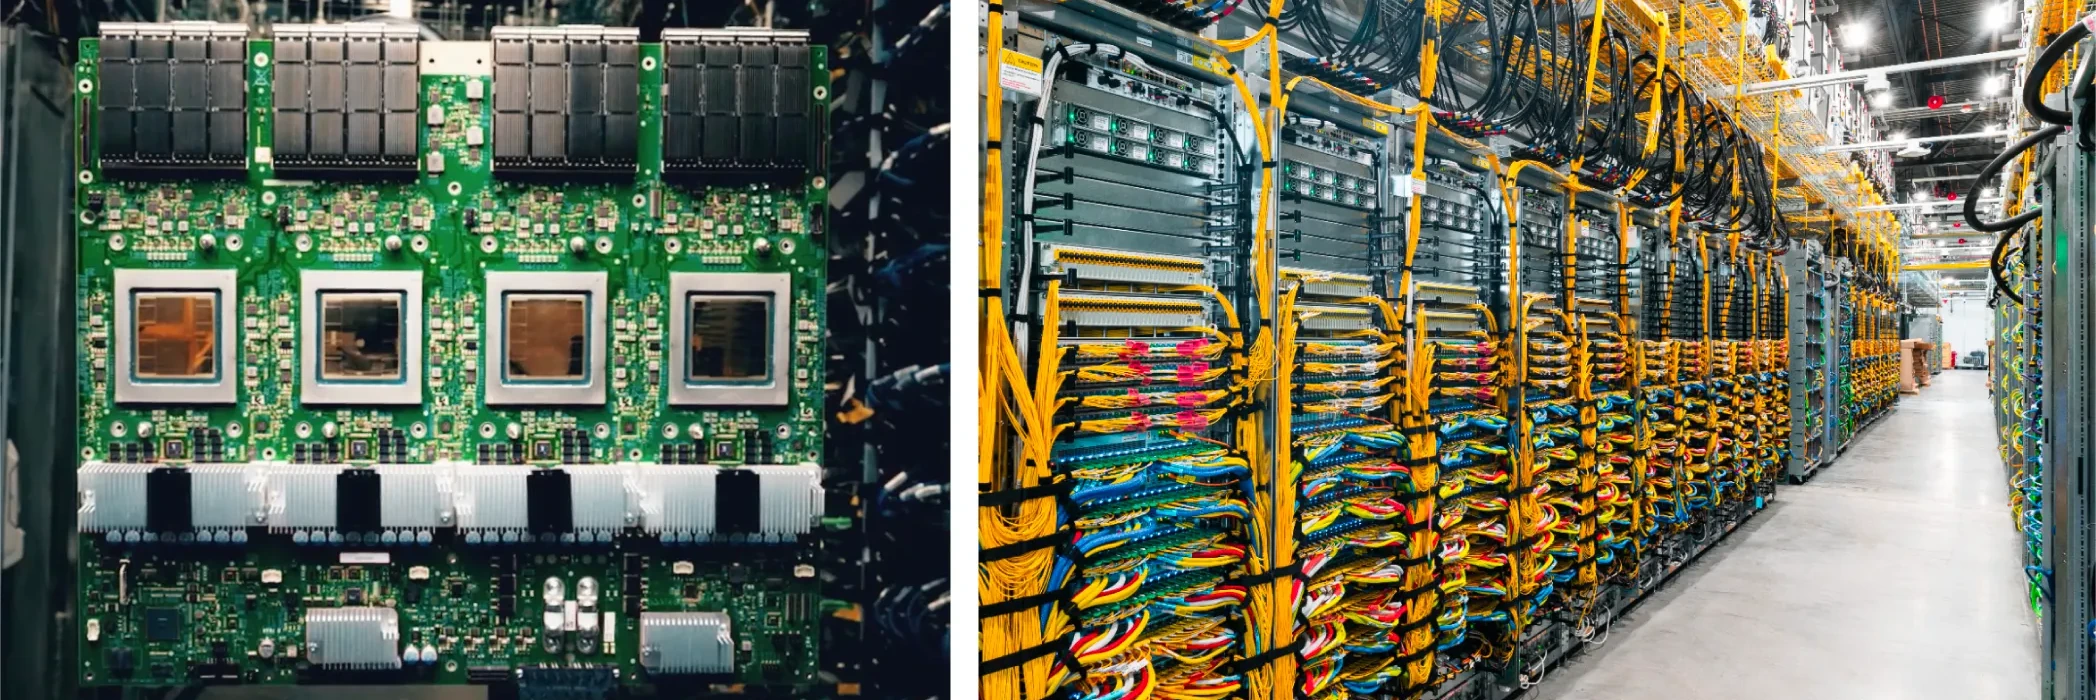
關於新一代車型的資訊不多,所以這裡只展示大尺寸頭燈:
Ironwood v7 的超級煙彈由約 9000 個 TPU 組成。
那麼,既然我們已經有了TPU,為什麼還需要GPU呢?
TPU 的設計兼顧了內存、運算能力、能耗和數據通信,這表明大規模構建高性能 AI 系統不僅需要速度快的晶片,還需要硬體、軟體、系統和網路連接之間的協調配合。
儘管如今人工智慧工作負載更加多樣化,涵蓋推理、訓練、稀疏模型和推薦系統,但 TPU 並非設計用於處理像素。然而,GPU 目前並不流行,因為英偉達公開了一種程式化模型和開發者體驗,使 GPU 能夠像 TPU 一樣運作。
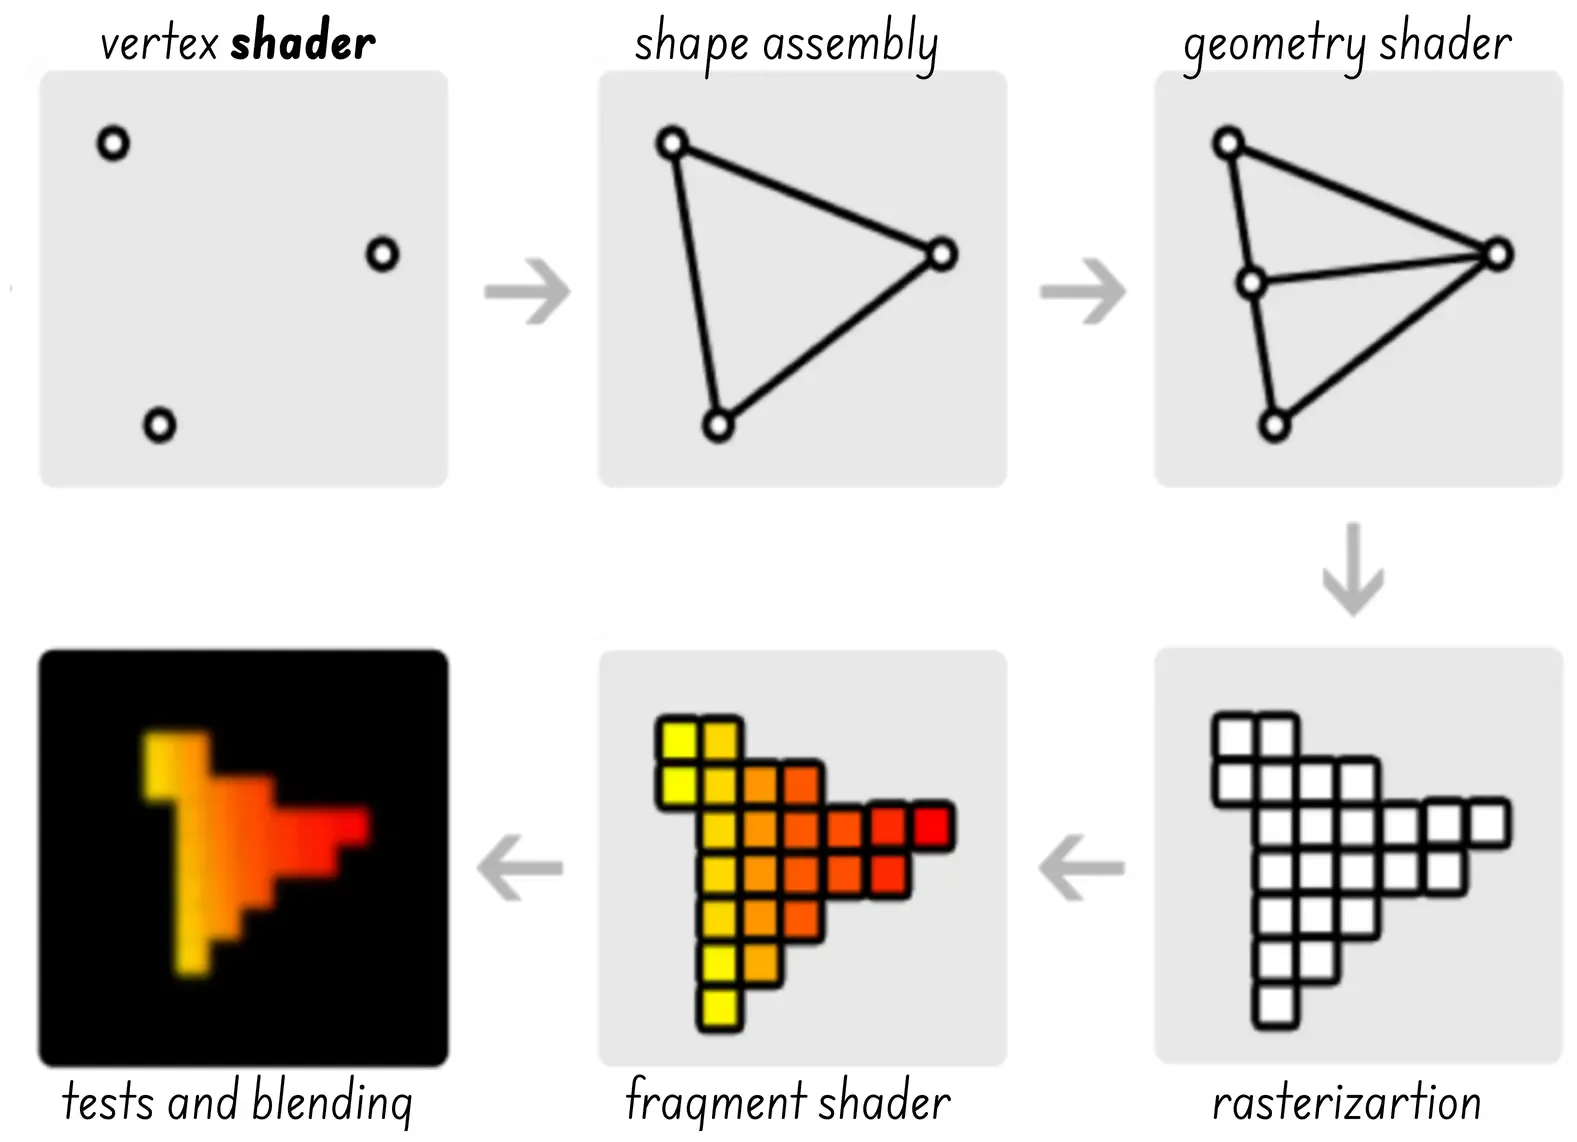
這是否意味著GPU更勝一籌?未必如此——在某些特定工作負載下,TPU的效率可能高於GPU,尤其是在功耗和每瓦效能方面。在我們如今這個AI資料中心能耗日益增長的世界裡,TPU或許能發揮至關重要的作用。
模擬神經形態積體電路怎麼樣?
那麼神經形態積體電路呢?與TPU相比,它們旨在透過使用類比運算和低頻事件驅動處理來進一步降低功耗。神經形態積體電路需要具備哪些條件才能成為主流並達到與TPUv7超級晶片相同的規模?
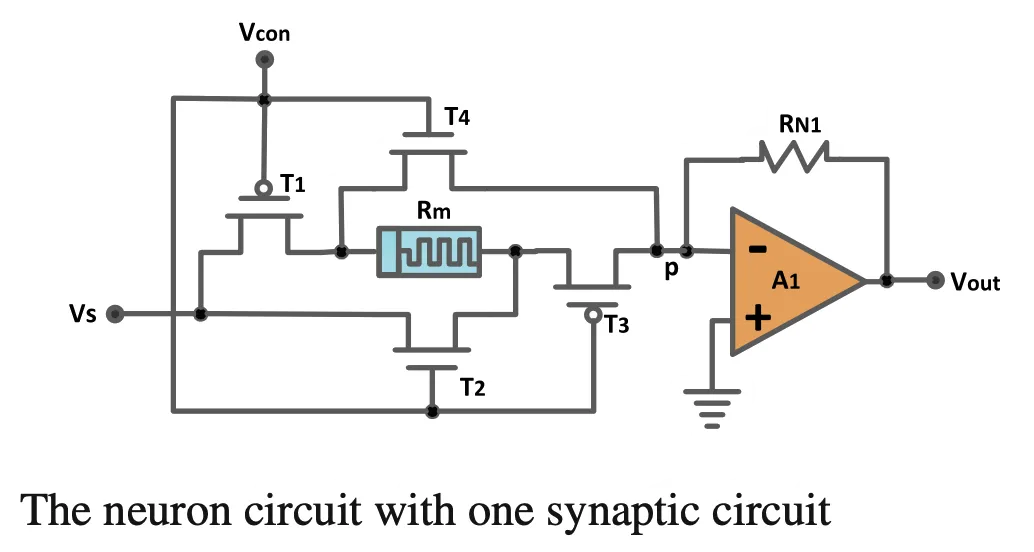
我仍然面臨的挑戰之一是更好地理解收縮陣列(MXU + 備用核心)與 TPU 其餘部分(包括 ICI、OCI、TCS)的相對功耗,以及該比率與神經形態脈衝神經網路 (SNN) 與控制邏輯(RiscV 和 Spike copro)的比較情況。
此外,如果神經形態積體電路要達到 TPUv7 的規模,很可能需要在軟體、系統和網路連接方面投入類似的資金。否則,可以考慮將 SNN 整合到 TPU 中,並利用 TPU 的「控制邏輯」來處理 SNN 與 TPU/機架/焊盤其餘部分之間的通訊。但這樣做有必要嗎?我們究竟要解決什麼問題?或許我們需要換個角度思考。
如果沒有提及語言處理單元,這份備忘錄就不完整。語言處理單元是一種新型處理器,旨在優化大型語言模型的推理。
我需要專門為這個主題撰寫一份備忘錄,所以目前這只是一個高層次的比較,試圖了解LPU是否僅僅是對TPUv1的重新設計,而TPUv1只專注於推理,並不關注訓練。
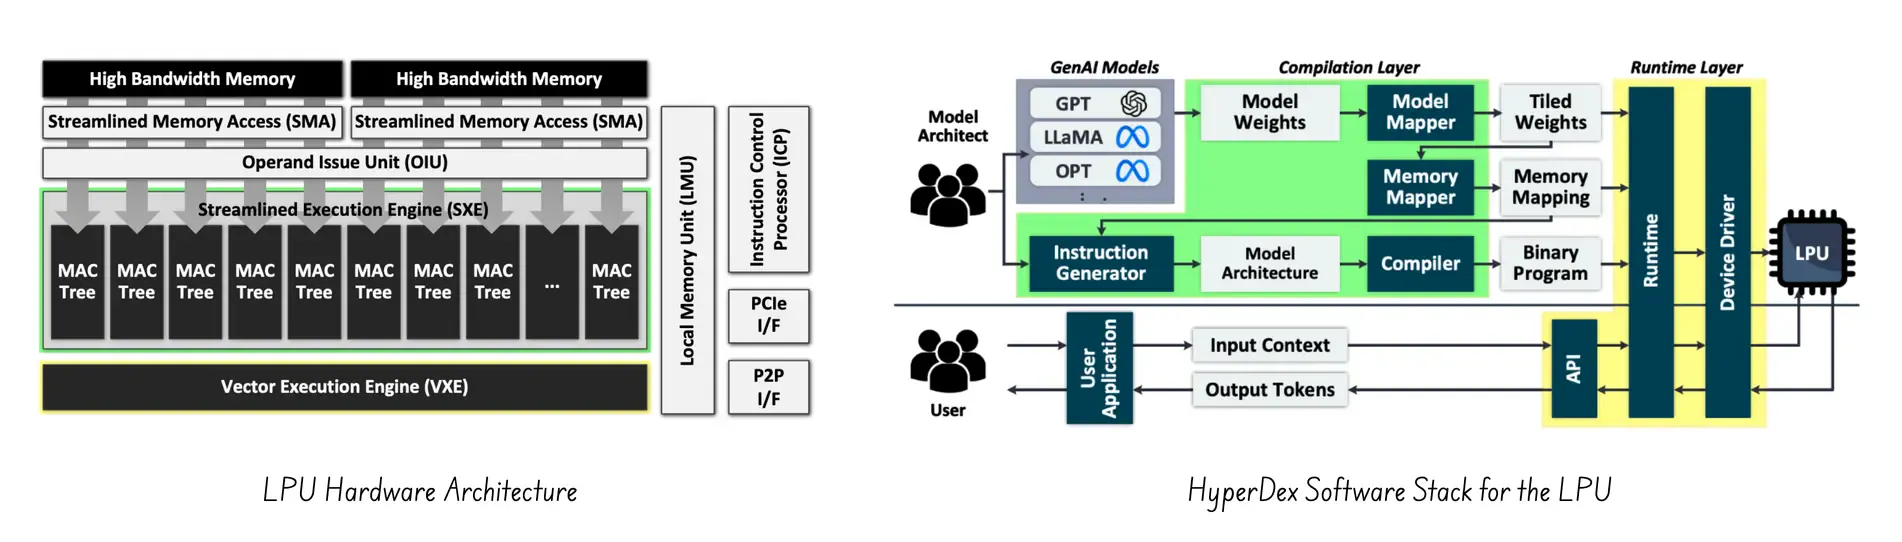
從宏觀層面來看,TPU 和 LPU 的確都需要有效率且大規模地完成一些任務,它們都採用了領域特定架構 (DSA)。但具體到實作和最佳化方面,LPU 則截然不同,它關注的重點也不同。
主要區別在於,TPUv1 的設計早於 LLM 的出現(請記住,ChatGPT 的初始版本發佈於 2022 年),並專注於通用深度神經網路 (DNN) 推理。這意味著要確保大規模、高容量操作的吞吐量和每瓦性能,而這由底層 MXU 脈動陣列實現。
另一方面,LPU 的設計目標是優化大型語言模型 (LLM) 的推理。其重點在於降低每個詞元的延遲。為此,它們需要一個支援完全確定性、靜態調度、基於 VLIW 的多管線架構的指令集架構 (ISA)。當然,有人可能會說 TPUv4 為 TCS 引入了類似的 VLIW ISA。但主要區別在於,LPU ISA 是一個完全確定性的 VLIW 機器,其中每個載入、運算和儲存操作都是逐週期調度的。而對於 TPU 來說,MXU 則是一個「自驅動」的脈動陣列。
# 結論
瞧,這是一份簡短的備忘錄,但和以往一樣,耗時更長。透過這次深入分析,我們可以清楚地看到,TPU架構的演進表明,設計AI加速器是一項複雜的任務,需要權衡許多因素。
TPU 的設計兼顧了內存、運算能力、能耗和數據通信,這表明大規模構建高性能 AI 系統不僅需要速度快的晶片,還需要硬體、軟體、系統和網路連接之間的協調配合。
這感覺有點像是似曾相識。量子處理單元(QPU)會不會是人工智慧加速器發展的下一步呢?
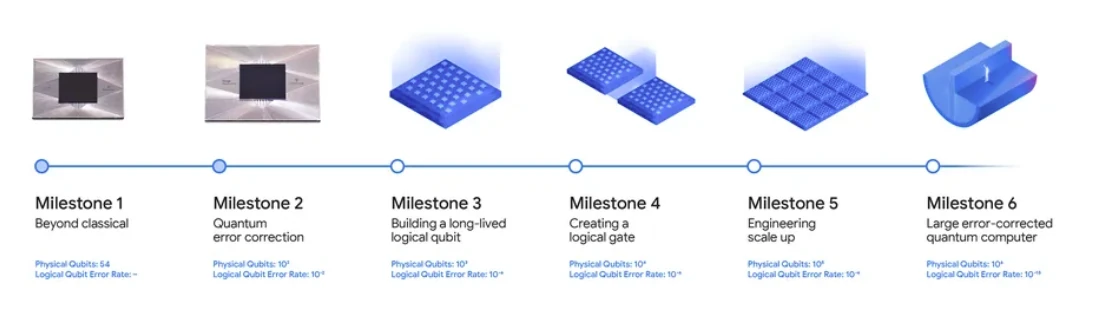 (圖片來源:Google Willow)
# 參考
本備忘錄使用的DrawIO圖表: