我曾在Spirent公司工作,這是一家測試測量公司,專門開發高效能網路測試系統。我們的產品名為Test Center,當時我們與一支才華橫溢的團隊一起開發用於測試RoCEv2系統的系統。我的工作重點是優先權流控制(PFC),以及如何將其應用於基於800Gbps FPGA的「資料包分析器和產生器」(也稱為PGA)。
然而,我從未真正了解過第 4 層,這份備忘錄試圖透過闡述 InfiniBand 傳輸層 (L4) 的關鍵要素並用一些圖表將其視覺化來彌合這一差距。
讓我們從實際的 RoCEv2 幀開始:
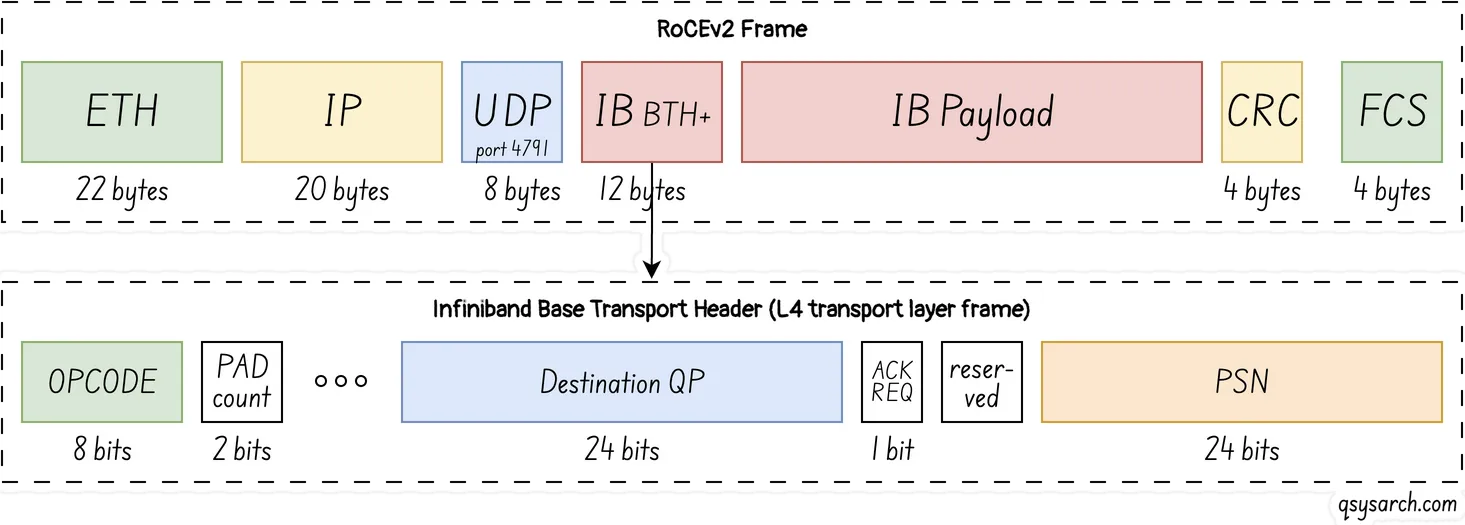
BTH 標頭中包含的關鍵字段:
操作碼:用於指定 RDMA 操作的類型,例如 RDMA_WRITE、RDMA_READ 等。
目標佇列對:用於區分資料包的不同目標佇列對。
確認請求:指示接收端是否需要對此資料包傳回 ACK。
資料包序號 (PSN):用於資料包序列跟踪,以確保可靠交付。
由於UDP協定不可靠,訊框可能會遺失、亂序或重複,因此使用PSN來確保訊框的正確傳輸。然而,這也意味著IBTL需要有一種方法來請求幀重傳。這可以透過AETH頭部來實現,具體內容將在下文中描述。
InfiniBand傳輸層包含多個擴展頭部,用於特定功能。對於RDMA而言,最值得關注的兩個擴充頭部是RETH和AETH。
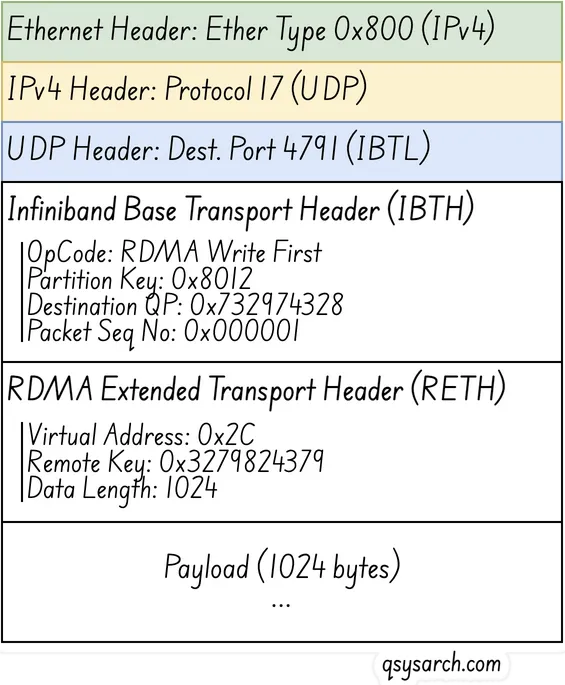
RDMA_WRITE 操作需要多個元素,這些元素在 RETH 擴充標頭的各個欄位中表示。此報頭會將寫入操作的詳細資訊告知接收硬件,包括:
如前所述,IBTL 需要在傳輸不可靠時通知發送方。這是透過 EATH 擴充功能實現的,該擴充包含以下欄位:
IBTL 規格(請參閱第 9 章)確實包含相當多的擴展,其中一些引起了我的注意:
我也一直在思考如何知道標頭包含哪些副檔名。答案很簡單:對於每個操作碼,都有一個待解析的擴展名列表——該列表是靜態定義的,是規範的一部分。
正如 Toni Pasanen 在其部落格 The Network Times 中所述:
GPU 之間的通訊會產生大量的資料流,支援 RDMA 的網路卡會以線速傳輸這些資料流。這些資料流很容易導致後端網路擁塞。
RDMA 能夠以線速產生流量,這令人驚訝。但這同時也帶來了一個問題,即流單元大小(兩個連續非活動時間段之間的流量大小)會受到影響,在使用 RDMA 大流量時,訪問「非活動間隙」的機率會顯著降低。
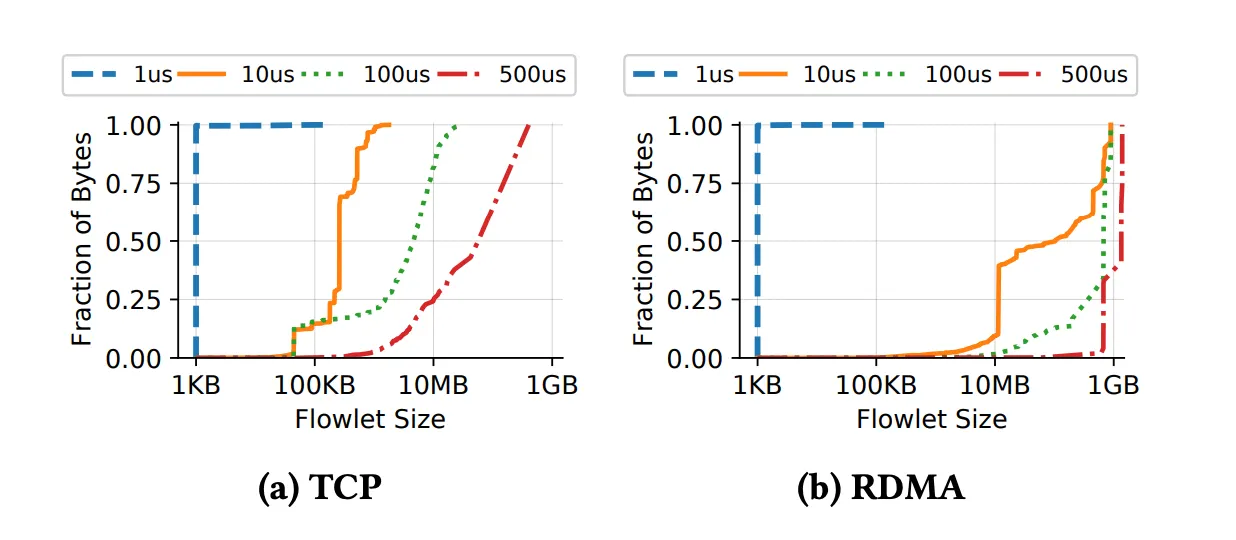 圖片來自:支援網路內重排序的 RDMA 網路負載平衡
另一個複雜之處在於脊葉拓撲結構的負載平衡,當使用「資料包噴射」負載平衡時,單一佇列對上的資料包可能會亂序接收。這造成了一定的複雜性,而英偉達透過引入一種名為「RDMA 只寫」的新型 RDMA 操作解決了這個問題。
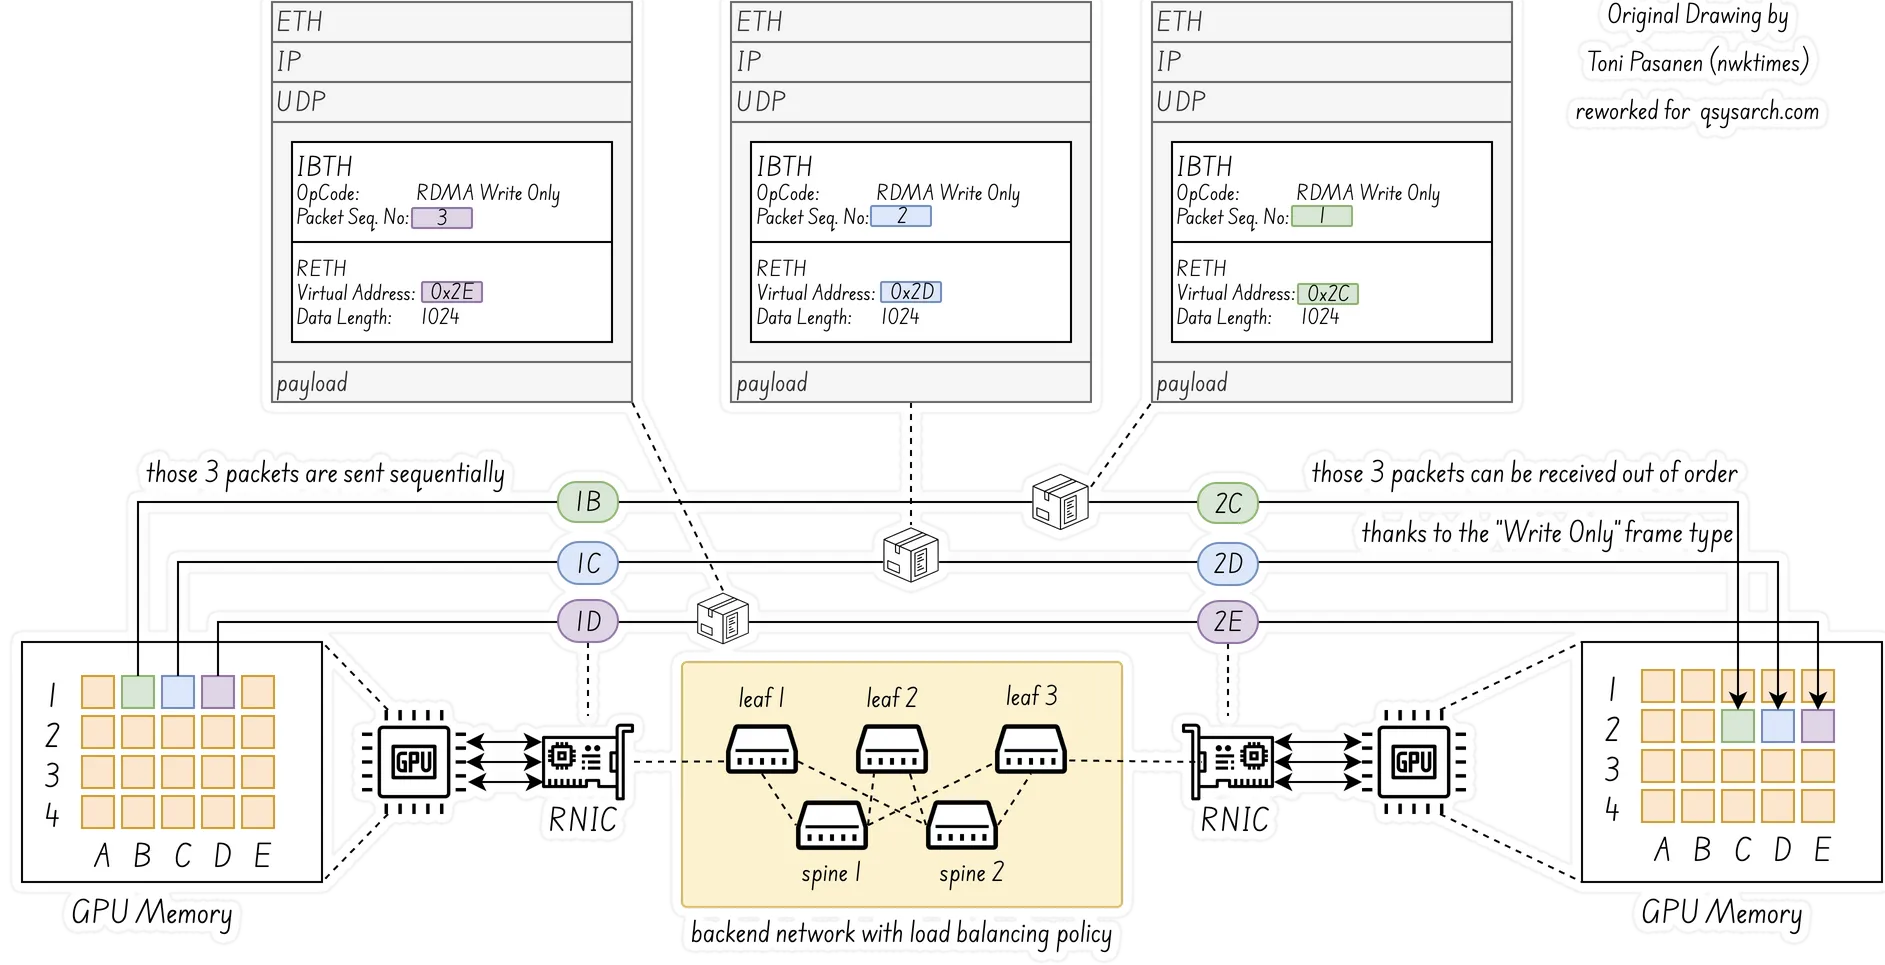 原圖來自:網路時報
# 結論
這是一份「動態」備忘錄,我會隨著找到更多關於 IBTL 的資訊而不斷更新。
目前還沒有定論,但可以肯定的是,RDMA 是一種非常優雅的解決網路效率挑戰的方法,同時也帶來了一系列新的挑戰。
References: