
在GPU領域,與RDMA相關的術語層出不窮:GPU-direct、NvLink、NVLink Fusion、InfiniBand、Quantum InfiniBand、GPUNetIO和DOCA。這令人眼花撩亂,但或許不必如此?
本文以個人備忘錄的形式寫成,試圖闡述各種技術,並用一些圖表將其視覺化。
讓我們從官方 Nvidia 文件中令人困惑的 GPUNetIO 頁面開始:
請注意,RDMA 是遠端直接記憶體存取協定的縮寫,該協定允許從一台電腦的記憶體向另一台電腦的記憶體進行遠端直接記憶體訪問,而無需任何一台電腦的作業系統參與。 ……請勿將其與 GPUDirect RDMA 混淆,後者與 RDMA 協定無關。
明白了,GPUDirect RDMA 和 RDMA 協定並不相同!但是,GPUDirect RDMA 至少是否使用了 RDMA 協定呢?我希望如此;否則,那就太令人困惑了。
GPUDirect RDMA 是 NVIDIA GPUDirect 技術家族中的一項技術。它使網卡能夠直接存取 GPU 內存,繞過 CPU 內存複製和作業系統例程,從而實現資料的收發。任何支援乙太網路、InfiniBand 或 RoCE 的網路框架都可以啟用 GPUDirect RDMA。
好的,至少有一點很明確:GPUDirect RDMA 可以實現在任何傳輸層上,無論是乙太網路 (ETH) 還是 InfiniBand (IB)。但是,GPUNetIO 是什麼?它與 RDMA 又有什麼關係呢?答案很簡單。顧名思義,GPUNetIO 是基於網路的 GPU Direct RDMA 實現,透過網路卡實現。這並不意味著 GPU Direct 必須由網路卡驅動,而只是說 GPUNetIO 是針對特定網路卡類型的專用版本。
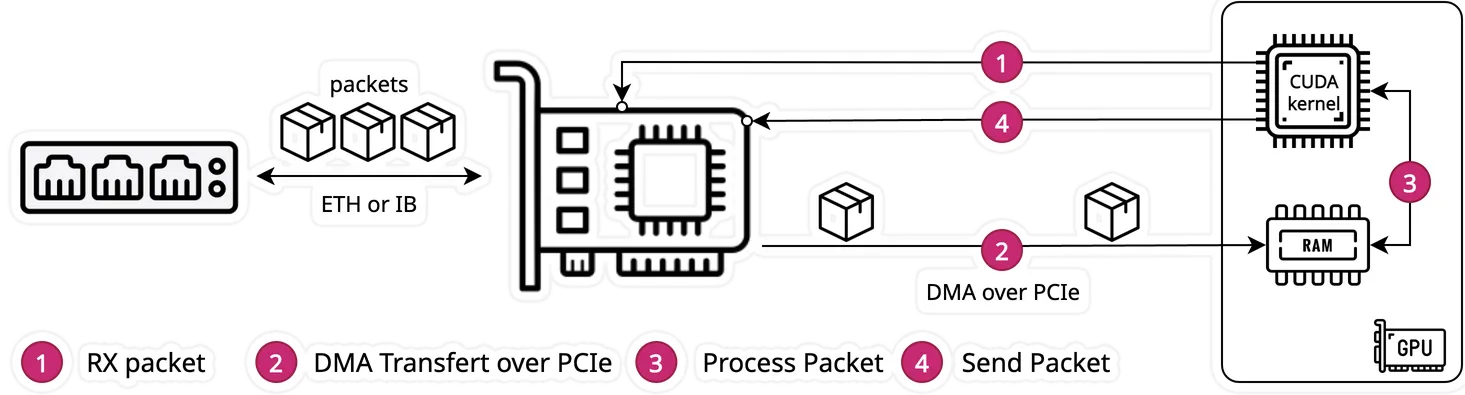
在GPUNetIO文件的上圖中,「CUDA」框有點令人困惑。我猜它指的是運行在GPU上的內核,但我們來看看文件是怎麼說的:
傳統方法通常依賴以 CPU 為中心的模型,其中 CPU 與網路卡協調,使用 GPUDirect RDMA 將封包接收到 GPU 記憶體中。之後,CPU 通知 GPU 上的 CUDA 核心處理這些封包。 ……DOCA GPUNetIO 透過提供以 GPU 為中心的解決方案來應對這項挑戰,該方案將 CPU 從關鍵路徑中移除。
對我來說,這一點仍然不太清楚——它指出關鍵路徑“以GPU為中心”,但關鍵路徑究竟是什麼?是指圖中提到的步驟(1)到(4)嗎? CPU還需要做什麼?要找到答案,我們需要查看「非同步核心啟動」模式,該模式被描述為「GPU CUDA核心控製網路通訊以發送或接收資料」的可能性。 GPUDirect IKA 啟用了以下功能:
所以,這一點百分之百清楚:
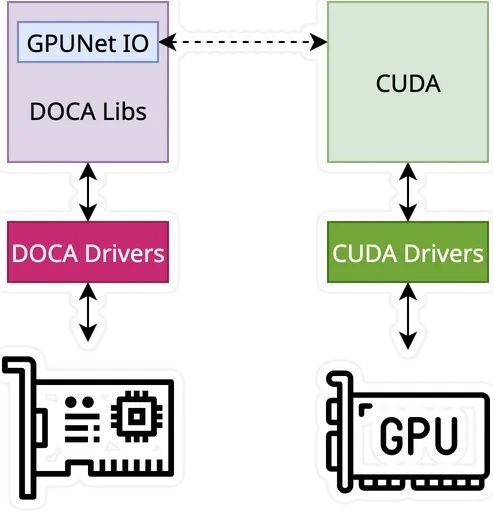
GPU Direct RDMA「允許直接向/從GPU記憶體傳輸數據,而無需CPU暫存副本。
GPU Direct AKI 使 GPU 能夠「控制」網路卡。
GPUNetIO 是一個軟體元件,它同時處理 GPU Direct RDMA 和 AKI 技術。
DOCA 是 Nvidia 提供的用於對支援 GPUNetIO 的硬體(以及其他裝置)進行程式設計的 SDK。
我認為造成混淆的原因在於,“AKI”應該被描述為“GPU Direct RDMA + AKI”,因為它補充了 RDMA 功能,允許繞過 CPU。
我們現在了解到,NVIDIA 以 GPUNetIO 的名義推廣的 GPU Direct RDMA 是一種基於網路卡 (NIC) 的解決方案,它透過 PCIe 連接將 GPU 連接到網路卡。接下來,我們將深入探討這種 PCIe 連接,忽略 GPUNetIO 部分,並專注於 RDMA 部分:
CUDA GPUDirect RDMA 的官方文件中指出,唯一的要求是 PCIe 根複合體:
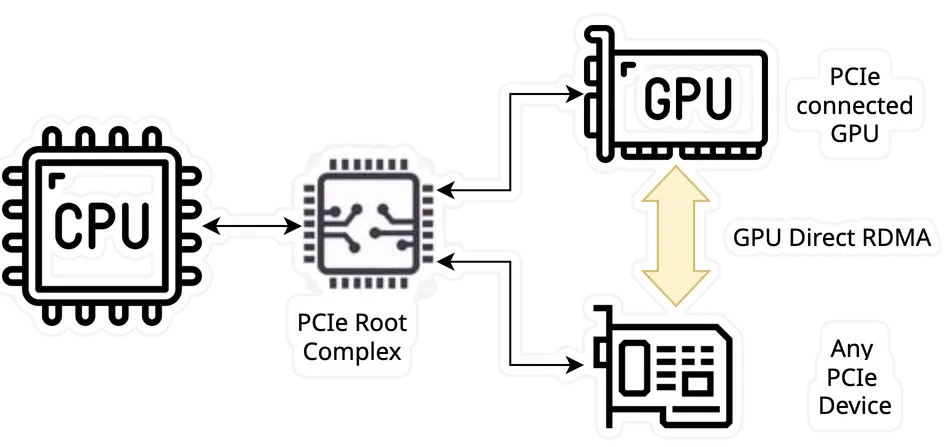
GPUDirect RDMA 是 Kepler 系列 GPU 和 CUDA 5.0 中引入的技術,它利用 PCI Express 的標準功能,實現了 GPU 與第三方對等設備之間的直接資料交換。 ……但這項技術有一些限制,其中最重要的是兩個設備必須共用同一個上游 PCI Express 根複合體。
GPUDirect RDMA 是一種解決方案,它允許任何 PCIe 裝置直接與 GPU 通信,前提是它們位於同一根複合體下。因此,儘管英偉達主要將其作為網卡解決方案進行推廣和銷售,但它可以是任何 PCIe 卡,例如高速攝影機 PCIe 卡。這很棒,但讓我們試著了解它是如何運作的。
在兩個對等設備之間建立 GPUDirect RDMA 通訊時,從 PCI Express 設備的角度來看,所有實體位址都是相同的。在這個實體位址空間內,存在稱為 PCI BAR 的線性視窗。每個裝置最多有六個 BAR 暫存器,因此最多可以有六個活動的 32 位元 BAR 區域。 64 位元 BAR 佔用兩個 BAR 暫存器。 PCI Express 裝置對對等裝置的 BAR 位址進行讀寫作業的方式與對系統記憶體進行讀寫作業的方式相同。
傳統上,BAR視窗等資源會使用CPU的記憶體管理單元(MMU)作為記憶體映射I/O(MMIO)位址映射到使用者或核心位址空間。然而,由於目前作業系統缺乏足夠的機制在驅動程式之間交換MMIO區域,NVIDIA核心驅動程式匯出了用於執行必要位址轉換和映射的函數。
這裡容易讓人困惑的是,在考慮連接異質設備的PCIe內部系統時,「DMA」這個詞似乎比「RDMA」更合適。但關鍵就在這裡。 DMA是資料傳輸的解決方案,而RDMA則是用來賦予傳輸資料語意的協議,它使用動詞來實現。因此,DMA實際上只對應於下圖中的步驟(4)和(5),而接收端硬體中的RDMA協定僅對應步驟(3)。
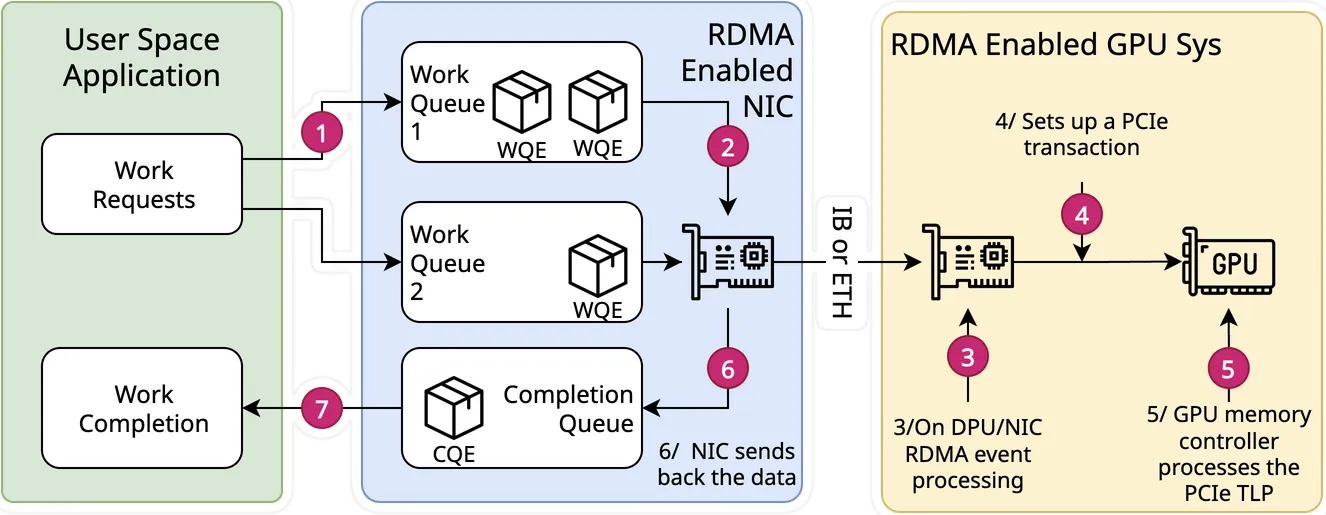
需要注意的是,英偉達明確表示這不是一件簡單的事情,因此,為了獲得最佳性能,最好使用已知的測試平台:
儘管 GPUDirect RDMA 在第三方設備和 NVIDIA GPU 之間工作的唯一理論要求是它們共享同一個根複合體,但存在一些錯誤(主要在晶片組中),導致它在某些設置中性能不佳,或者根本無法工作。
目前術語方面仍然存在明顯的混淆,尤其是在乙太網路、InfiniBand 和 RoCE 之間:事實上,RoCE 是基於乙太網路的。

InfiniBand 產業協會將其描述為一種演進,如上圖所示。請注意,我特意使用了「100G + PFC」這個名稱,而不是最初提到的「DCB」(即資料中心橋接)。如果我理解正確,DCB 是 PFC(即優先級流控制)的超集,其含義是,要使 DCB/PFC 正常工作,需要相應的網路基礎設施(包括交換器)來實現這些技術。否則,就只能使用乙太網路了。
NVLink怎麼樣?
如果沒有提及NVLink,這份備忘錄就不完整。擺在我們面前的問題是,NVLink和InfiniBand是同一回事,還是兩者之間有某種關聯。簡而言之,它們是互補的,而非競爭關係。

從右側的示意圖可以看出,綠色箭頭用來連接各個GPU。而網卡之間的連接則採用InfiniBand技術。
值得注意的是,NVLink 介面位於 Nvidia 硬體內部,不像 InfiniBand 連接器那樣暴露在外,如下圖所示。需要注意的是,Quantum InfiniBand X800 是一款性能強勁的產品,支援 800Gb/s 鏈路,並整合了矽光子器件,但它與量子計算無關。
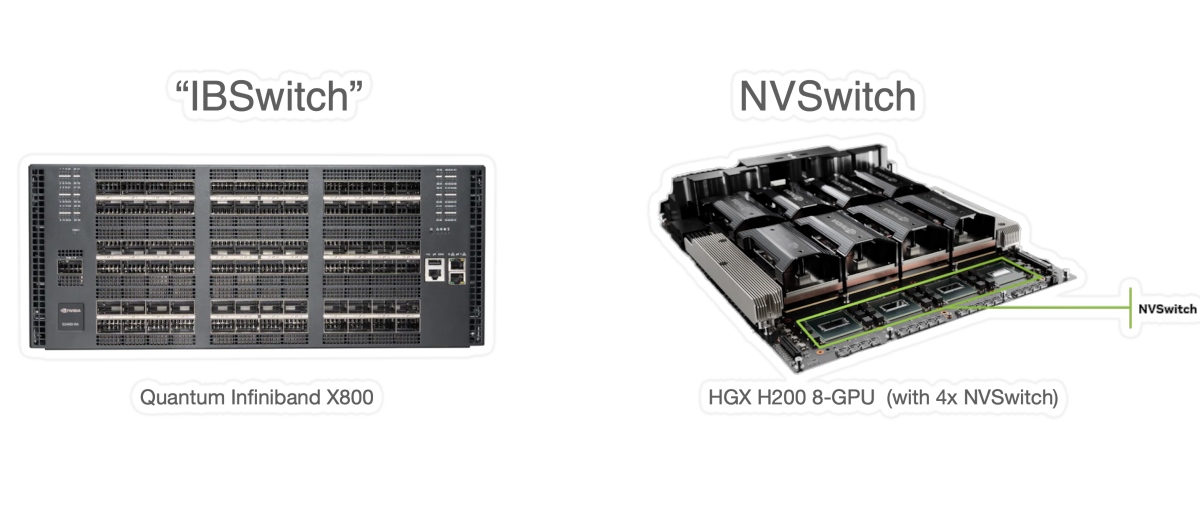
最後還有一點值得一提:Nvidia 推出了 NVLink Fusion,旨在開放 NVLink 標準。因此,我們明天很可能會看到一些客製化整合方案,或許仍然需要一塊 PCB 作為「開關」(而不是電纜),但使用的是 SoC,而這塊 SoC 可能並非 Nvidia 的產品。此外,AMD 也推出了 UALink 來回應 Nvidia 的標準。
# 概括
簡而言之,RDMA 並不複雜:
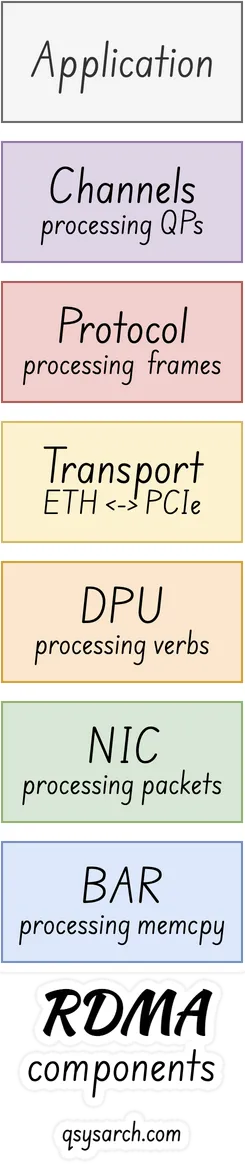
RDMA BAR:作為 PCIe BAR 映射:在物理層,有一個 PCIe 裝置透過同一個 PCIe 根複合體連接到 GPU,並映射所有裝置的記憶體 BAR。
RDMA 網路卡:作為硬體網路卡 (NIC):這種 PCIe 卡通常是網路卡,但並非必須如此。然而,目前市面上似乎只有一款網路卡具備 RDMA 功能。
RMDA DPU:作為硬體內動詞處理器:為了使 PCIe 卡符合 RDMA 規範,硬體必須能夠直接在硬體中處理 RDMA 動詞,通常使用稱為 DPU 的處理器。
RDMA 傳輸:作為網路鏈路的傳輸層:PCIe 裝置在網路側作為傳輸層暴露出來,可以是乙太網路、更好的乙太網路 (RoCev2) 和 Infiniband。
RDMA 協議:作為幀格式:用於通過網絡鏈路進行通信的協議也稱為 RDMA - 我沒有查看幀格式的詳細信息,但它在 RFC5040 中有描述。
RDMA 通道:作為透過 QP 進行通訊的方式:主機上用於與 RDMA 裝置通訊的軟體/驅動程式/SDK 也稱為 RDMA,但定義為佇列通道。
瞧!我現在對RDMA的理解似乎更透徹了。
# 結論
回到量子運算的挑戰——問題是,我們為什麼要關心 RDMA?嗯,那是因為英偉達把他們的 InfiniBand 交換器命名為「量子 InfiniBand」!
然而,儘管他們最新的Quantum-X800性能強勁,但它與量子計算卻毫無關係。不過,它或許能在將量子控制器與GPU連接起來方面發揮關鍵作用,從而助力強化學習挑戰?
# 參考: