乍一看,量子糾錯似乎很簡單:將實體量子位元分組為邏輯量子位元,應用一種方法來保持它們之間的一致性,然後使用這些邏輯量子位元來操作量子電路。
但實際上,這第一步遠非顯而易見。如何創建和維護這些邏輯量子位元?例如,從量子控制系統(QCS)的角度來看(例如 QM OPX1000、ZI 的 [ZQCS](https://www.zhinst.com/europe/en/products/zqcs-quantum-conptro-quant Cluster](https://qblox.com/products/cluster)),「操作」或「協調」邏輯量子位元需要什麼?一旦這個邏輯量子位元“準備就緒”,又該如何透過由單量子位元閘和雙量子位元閘組成的量子電路來使用它進行量子計算?這個問題看似簡單,但實際上卻關乎硬體控制系統,以及軟體棧,尤其是編譯器:我們現在是否擁有多個編譯器,一個用於物理量子位元,一個用於邏輯量子位元?此外,在由混合GPU/QPU和QCS組成的異質環境中,當需要處理10,000個實體量子位元時,編譯器需要付出怎樣的努力才能應對這種擴展複雜性?這些問題看似簡單,答案卻不簡單!
本備忘錄是量子控制系統視角下關於量子糾錯系列備忘錄的第一篇。這篇簡短的備忘錄介紹了在物理層「創建」一致邏輯量子位元所需的基本概念。
什麼是「邏輯量子位元」?創建邏輯量子位元首先要將實體量子位元分組,每個量子位元都被賦予特定的角色。有些量子位元用作輔助量子位元,而有些則用作資料量子位元或主量子位元。
這種分組通常以右側的圖表表示,圖中顯示的是「基於距離 3 的表面代碼 17」(圖片來源:Irréversible Inc)。
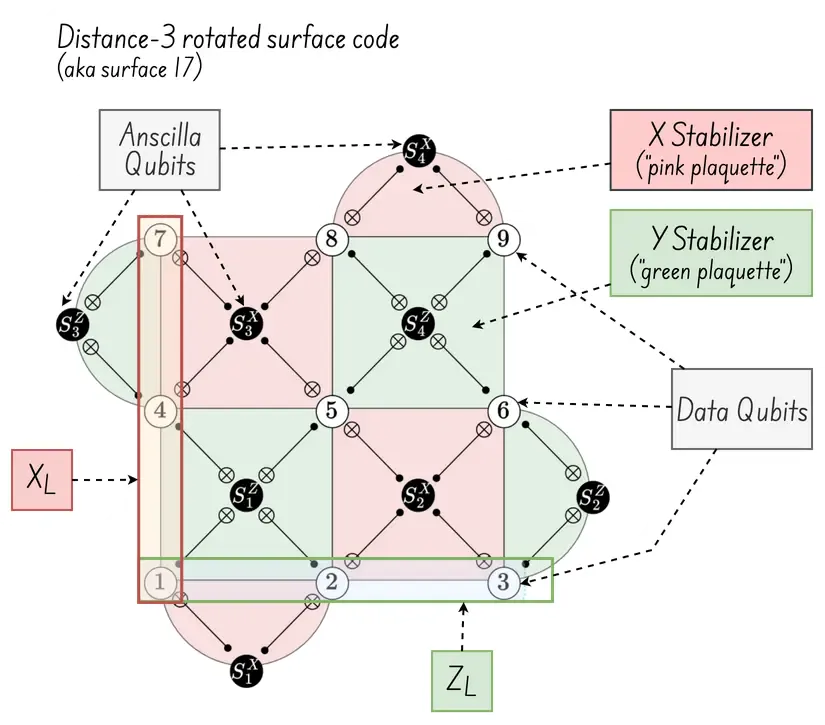
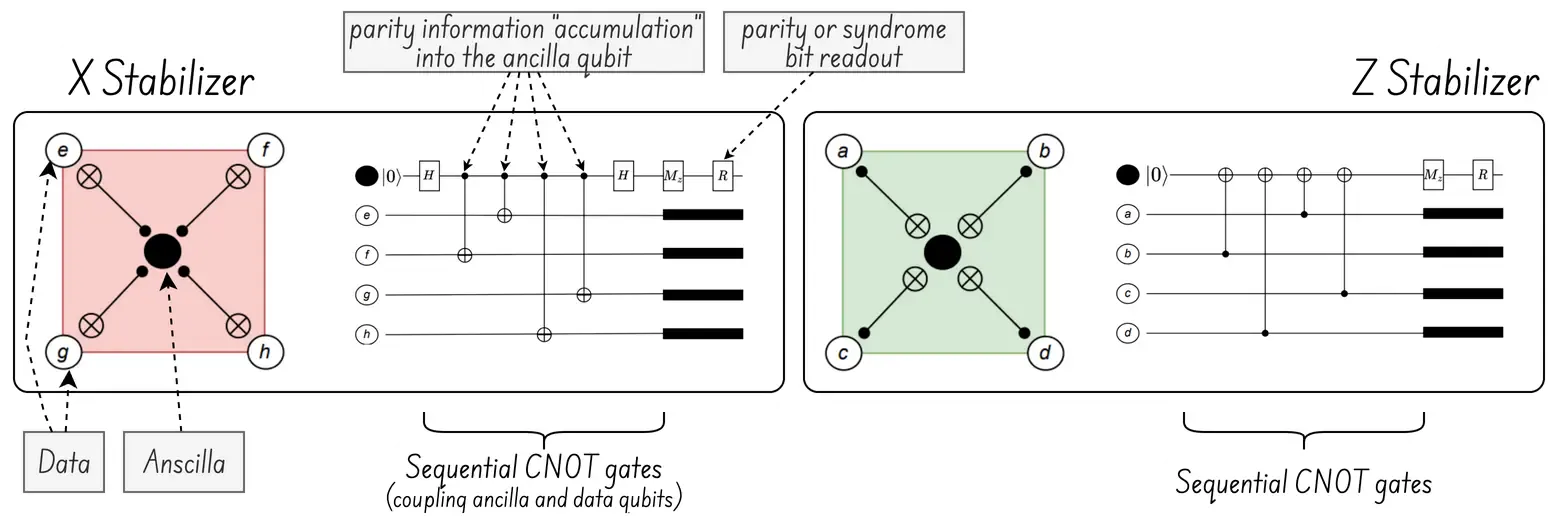
以下是適用於表面程式碼的基本結構:
數據與輔助量子位元之間的相互作用因「微片」而異:
小牌(綠色和粉紅色面)定義了中間的輔助量子位元與其相鄰資料量子位元之間的錯誤檢查類型關係。
穩定器:每個輔助量子位元用於測量一個泡利算符,或穩定器:表面碼有兩個穩定器:Z 型偵測位元翻轉 (X) 錯誤,而 X 型偵測相位翻轉 (Z) 錯誤。
穩定器測量 是對單一穩定器的測量,其實現方式是將輔助量子位元依序耦合到相鄰的資料量子位元,然後測量輔助量子位元。
在此背景下,請參考下圖(圖片來源:[Laurent Prost ] (https://www.linkedin.com/posts/laurent-prost-product-manager_just-because-ai-generated-content-looks-good-activity-7459167604172083200-good-E . (https://alice-bob.com/platform/))。 Z1Z2 和Z2Z3分別代表量子位元 1 和量子位元 2 之間以及量子位元 2 和量子位元 3 之間的聯合奇偶校驗(穩定器)測量。與先前的二維平面圖不同,該圖假設每個物理量子位元僅與其他一個量子位元相連,這表明這是一個一維重複碼。
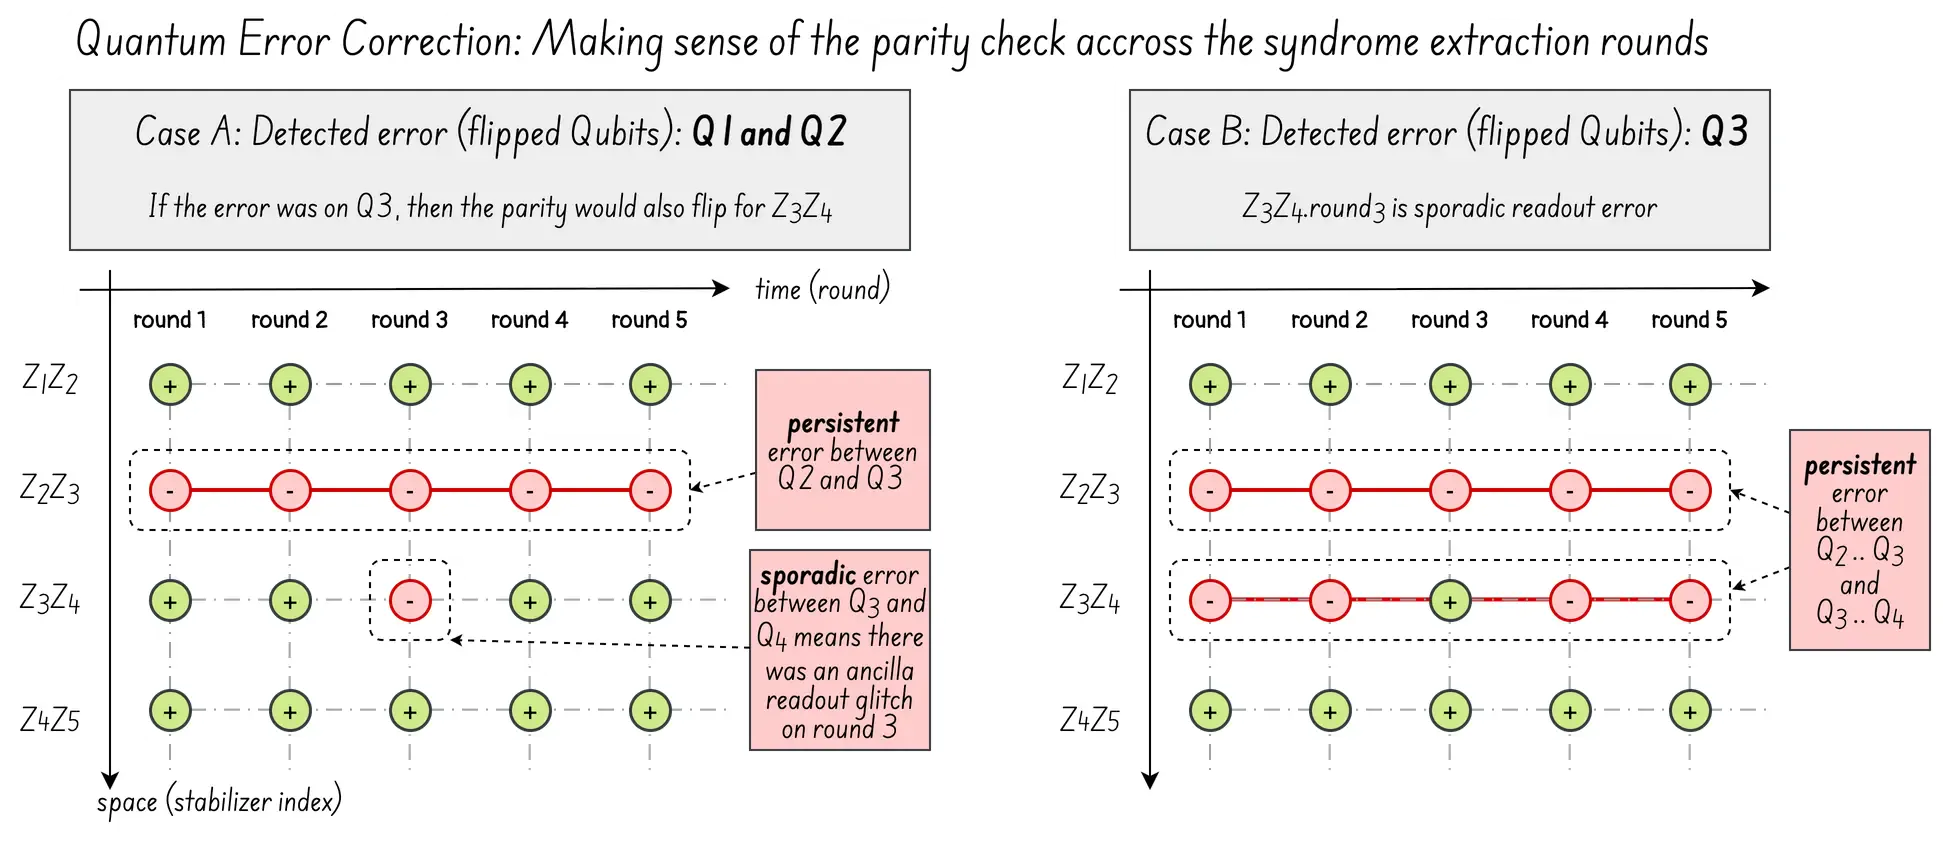
左側圖示(情況 A)中,錯誤似乎出現在資料量子位元 3 上,但實際上錯誤也出現在資料量子位元 1 和 2 上。紅色水平線表示錯誤僅發生在Z₂Z₃ 。如果錯誤出現在量子位元3上,則Z₃Z₄也會翻轉。因此, Z₁Z₂代表拜占庭錯誤,意味著 Q1 和 Q2 都發生了翻轉。右側圖示(情況 B)顯示如果錯誤出現在量子位元 3 上的預期結果。
幕後揭秘:QEC的“魔力”
第二部分內容稍顯晦澀,但對於理解後續關於邏輯群中實體量子位元編排的備忘錄至關重要。我盡量用淺顯易懂的方式闡述,避免涉及那些我量子電子工程系的同事們更擅長解釋的複雜數學細節!
Q1 + Q2拜占庭錯誤實際上是一種常見的挑戰,稱為退化錯誤。具體來說,它指的是兩個或多個物理上不同的錯誤產生完全相同的伴隨式位元的情況,在這種情況下,錯誤之間將無法區分。
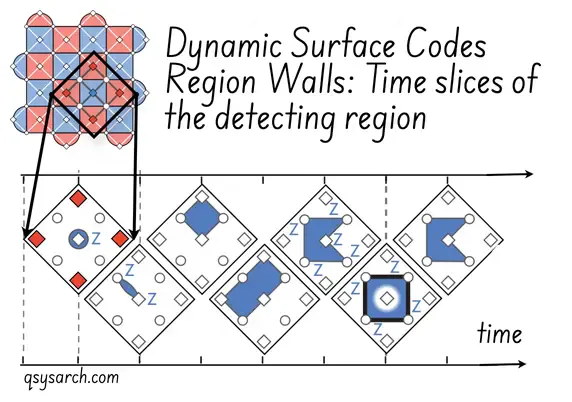 但這在量子糾錯(QEC)中並非問題:穩定器並非直接用於檢測錯誤。相反,穩定器用於識別物理量子位元邊界(即域壁),錯誤綜合徵會在此處發生反應。然後,透過增加冗餘度以重疊邊界,可以精確定位單一錯誤(或者,也可以使用GoogleAI的時間動態表面碼,如右圖所示)。
在量子系統中實現這種冗餘機製本質上非常複雜,需要深厚的數學基礎。為了理解這個高層次的概念,我們需要回歸基礎:奇偶校驗究竟是如何運作的?
起初,奇偶校驗的工作原理似乎並不清晰,因為確定奇偶性需要知道預期伴隨式位元,而這又取決於資料量子位元的狀態。然而,預先知道資料量子位元的狀態就違背了量子計算的初衷。換句話說:
“如果我們不知道量子態,又如何判斷它是否發生了變化?”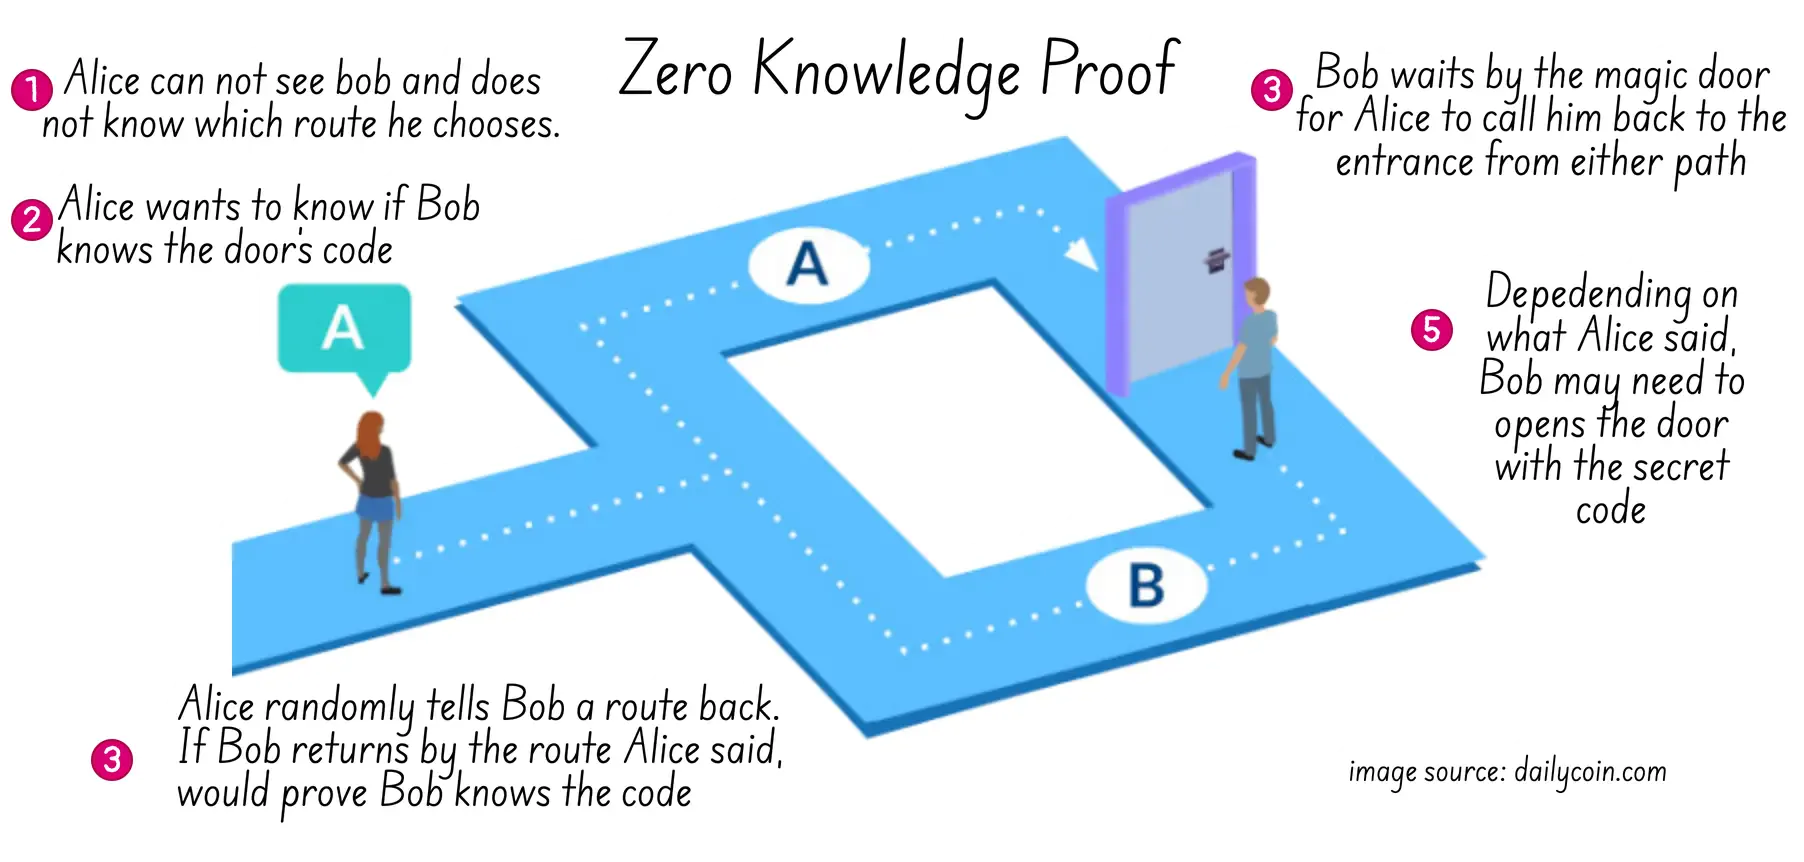 要解決這個挑戰,關鍵在於藉用阿里巴巴洞穴實驗中使用的零知識證明的技巧:只需提出一些特定的問題,而這些問題的答案是已知的,與編碼的量子資訊是什麼無關(圖片來源:dailycoin)。
這些具體問題對應於泡利穩定器算符。伴隨式位元(或測量結果)可以看作是路徑 A 或 B。在量子糾錯(QEC)中,路徑 A 代表有效狀態,而路徑 B 表示錯誤。 QEC「引擎」需要建構的量子電路能夠以一種保持這種約束(也稱為「受保護狀態」)的方式作用於邏輯量子位元。
工程設計在此變得至關重要。為了確保在沒有錯誤時,綜合徵測量結果始終返迴路徑 A,否則返迴路徑 B,多量子比特奇偶校驗資訊必須以某種方式編碼,使得每個有效的編碼狀態下量子位元之間的關係都是固定的。
這就是編碼電路的功能。它的目的是將一個簡單的、未受損的輸入狀態(例如具有空白輔助量子位元的單一物理量子位元\(|ψ> = α|0> + β|1>\) \(|00...0>\) 映射到一個高度糾纏的邏輯量子位元狀態\(|ψ_L>\),該狀態受到量子糾錯的保護。
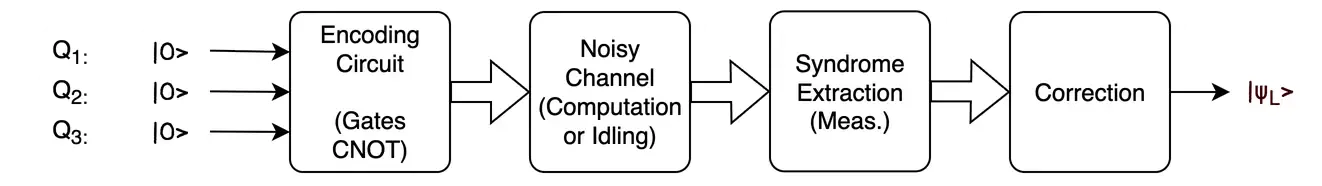
我將在後續備忘錄中更詳細地討論編碼電路。目前,我們可以將編碼電路視為一種經過精心設計和專門設計的量子電路,用於初始化或引導邏輯量子位元進入受保護狀態。
為了修復退化錯誤(即「拜占庭」 Q1 + Q2症候群),可以透過增加所謂的碼距\(d\)來提高冗餘度。乍一看,碼距\(d\)可以定義錯誤保護的穩健性。
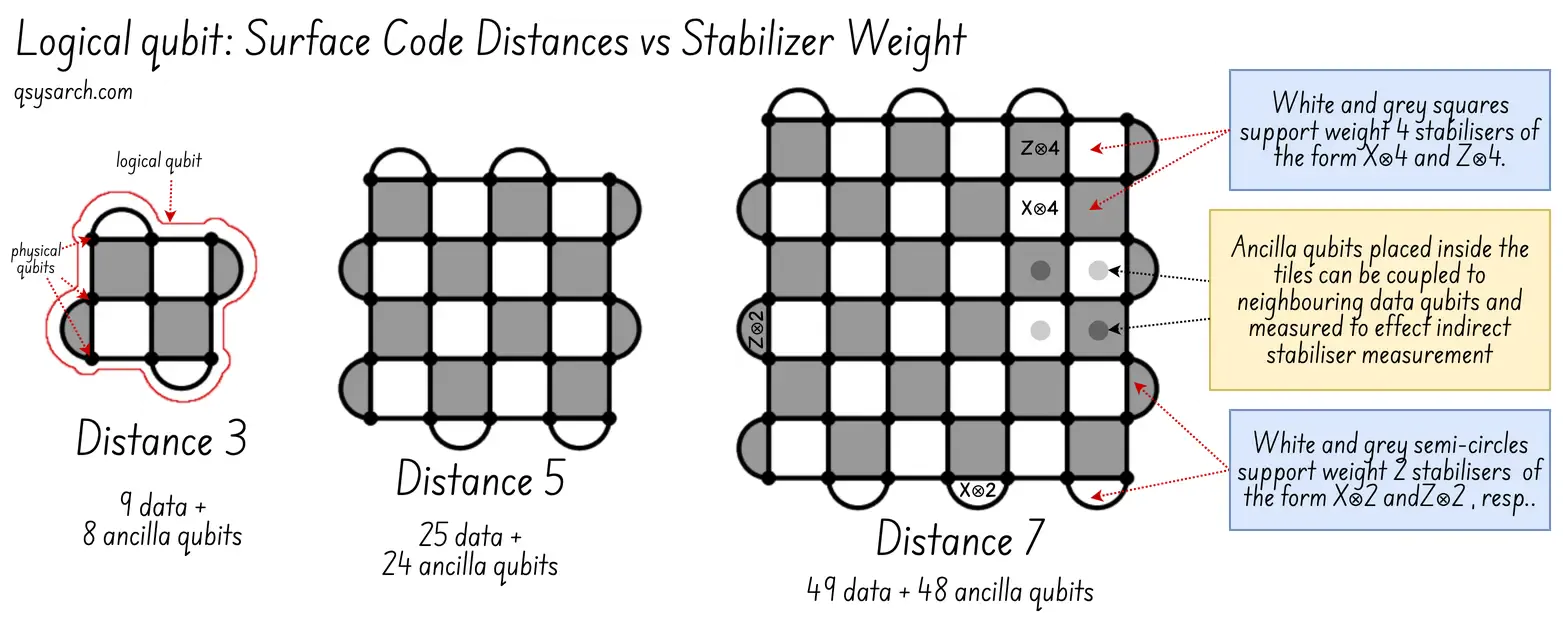
如果碼距為 \( d=3 \),翻轉兩個相鄰的量子位元會破壞訊息,量子糾錯 (QEC) 無法修正邏輯量子位元,也就是無法將邏輯量子位元維持在受保護狀態。當碼距增大時,例如 \( d=5 \),QEC 解碼器可以確保即使Q1和Q2翻轉並相互掩蓋,從而避免Z1Z2校驗失敗,增加穩定器測量也能為解碼器提供足夠的上下文信息,從而識別出Q1和Q2 的雙重故障。從數學角度來看,這可以表示為:
距離為 \( d \) 的碼最多可以偵測\( (d-1) \) 個錯誤,並修正\( \lfloor (d - 1)/2 \rfloor \) 個錯誤。
如果冗餘可以解決問題,為什麼不直接使用更高維度的表面碼呢?問題在於,每增加一個實體量子位元(以提高冗餘度),就需要測量更多的穩定器。而更多的測量意味著更多的風險(發生物理錯誤的可能性)。
這就引出了所謂的**閾值定理**
一個大小為 \(N\) 的量子電路可以透過一個雜訊量子電路高精度地實現,前提是雜訊電路中每個位置的錯誤機率低於一個固定的閾值 \(p_{th}>0\)。雜訊電路的大小與 \( O(N.log^c(N)) \) 成正比,其中 \(c\) 為正的常數。
簡單來說,閾值定理意味著,只要物理量子位元的錯誤率 \(p\) 低於閾值 \(p_{th}\),就可以添加更多物理量子位元來改善糾錯,並且增加的量子位元數量的複雜度為 \(N.log(N)\) 。
為什麼這很重要?因為它表明,即使量子比特並非總是“表現正常”,只要這種情況發生的頻率不高,就有可能使一組更大的量子比特表現得比單個量子比特的總和更好,從而為後NISQ時代,即FTQC(容錯量子計算)時代打開大門。
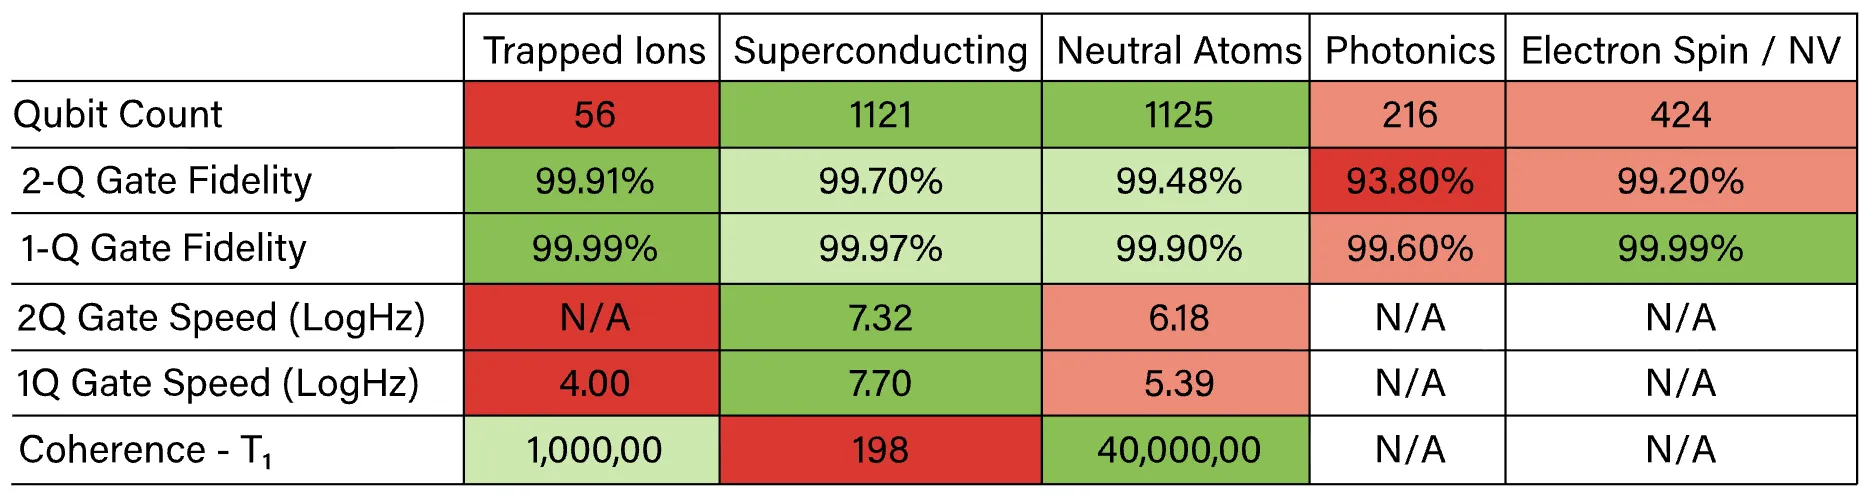
當然,這裡最關鍵的問題是這個閾值 \ (p _ {th} ) 是多少。它們的量級在 0.1% 到 1% 之間,雖然看起來很低,但這並不是問題,因為現代量子位元已經可以實現 99.9% 的保真度(對於單量子位元閘)。
# 結論
瞧,這份簡短的備忘錄奠定了量子糾錯概念的基礎。
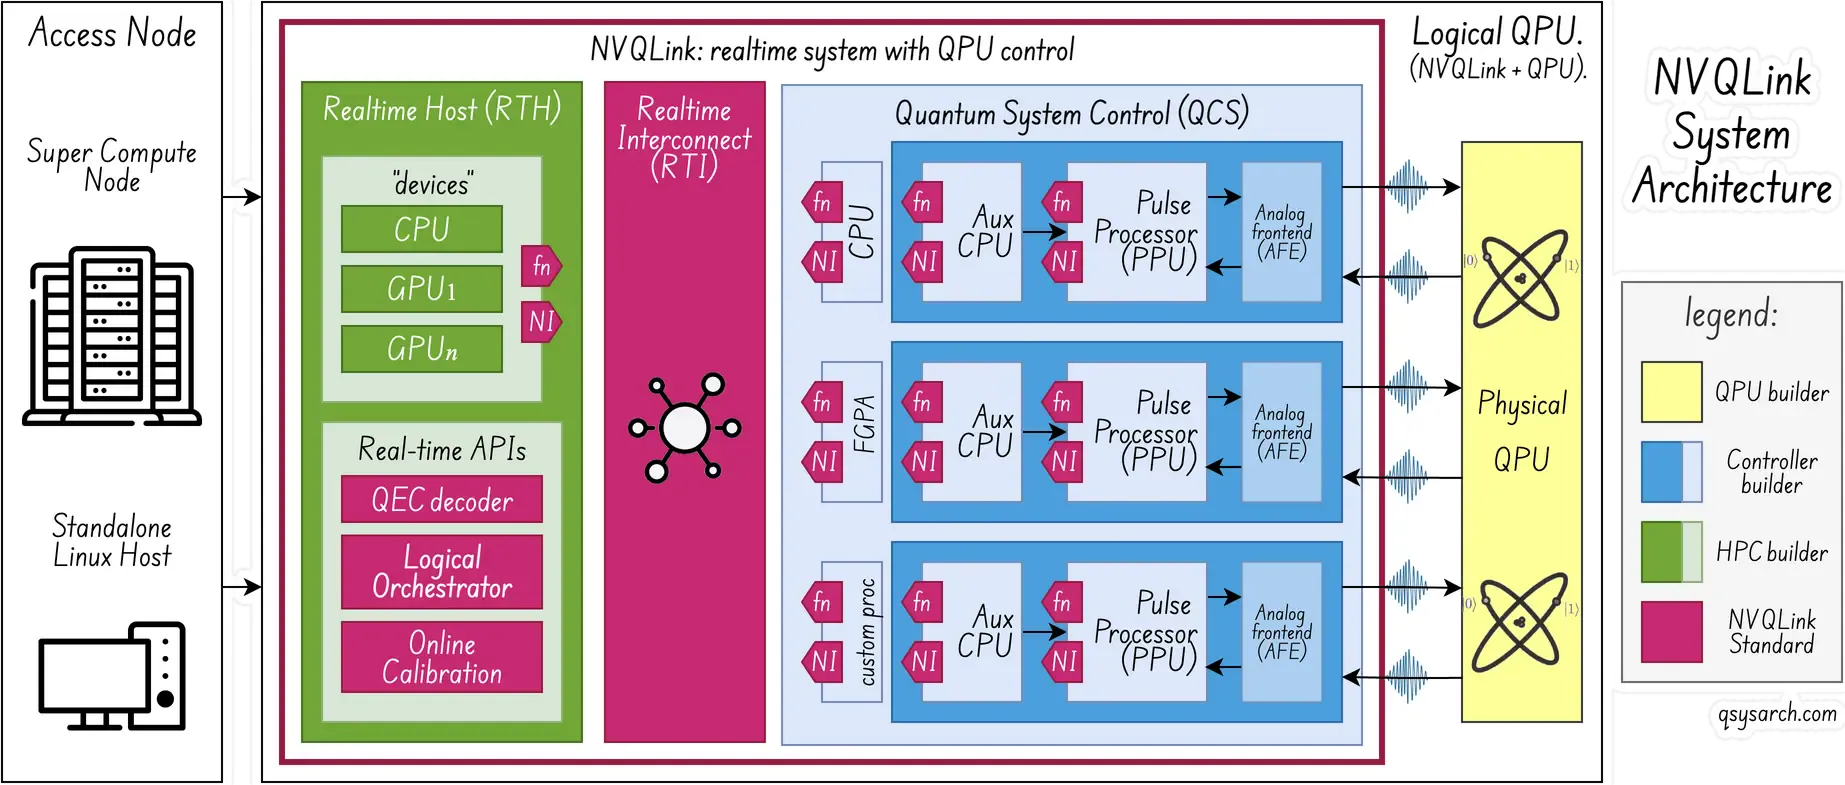
接下來的兩份備忘錄將更側重於實作操作。第二份備忘錄將從控制、讀出和排序等方面分析量子控制系統(以及糾錯解碼器)將實體量子位元轉換為邏輯量子位元的具體含義。第三份備忘錄將重點放在解碼系統,以及解碼器和控制系統之間低延遲和即時通訊。
這份備忘錄其實是系列備忘錄的第一份。接下來的幾份QEC備忘錄將重點放在以下主題:
從量子控制系統的角度協調綜合症提取
即時錯誤解碼:超低延遲 ASIC、GPU 和神經網路。
協同設計的智慧量子位元:以 Alice 和 Bob 的防錯量子位元為例
大規模表面程式碼編譯器:最大程度地提高數十億次物理操作的容錯能力
分層解碼架構:局部性原理與多層處理
邏輯量子比特編排:晶格手術與編織
超越表面碼:向 qLDPC 碼的轉變
魔幻狀態蒸餾與模擬旋轉
看來接下來六個月我都要忙這個了!
References:
DrawIO diagrams used in this memo: