我非常高興能成為 Qblox 團隊的一員,該團隊一直以來都在積極與 [Nvidia](https://www.nvidia.com/en-us/solutions/quantus/sum-link NVQLink 標準,以此作為連接在 GPU、CPU 和 QPU(量子處理器,包括 Qblox 正在開發的前端量子控制器)上計算的異質系統的一種方式。
NVQLink 不是連接 GPU 和量子處理器的另一個“電纜”,而是一個完整的框架,允許互連從網路到軟體堆疊的異質設備:
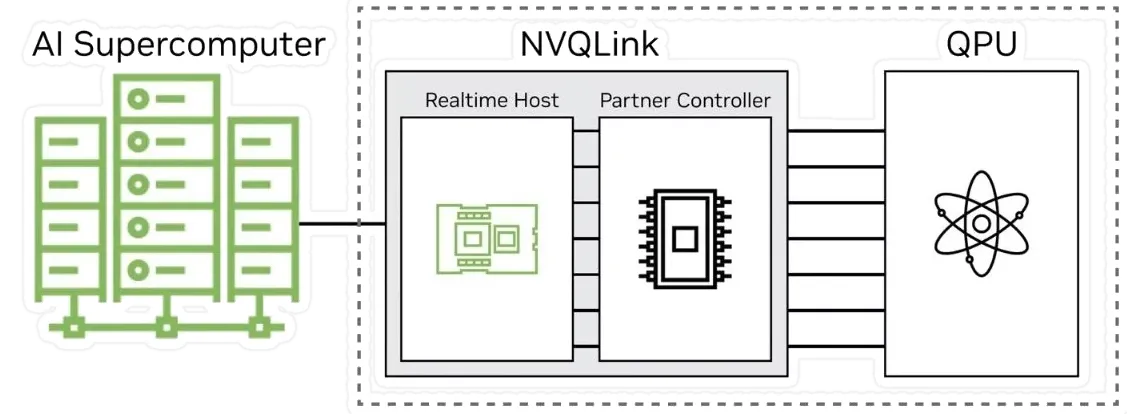 圖片來源:[Nandod](https://www.naddod.com/blog/nvidia-nvqlink-introduction-connecting-quantum
關鍵的「硬體」規格著重於網路和運算資源的效能:
網路吞吐量:從 GPU 到 QPU 最高可達 400 Gb/s。
網路延遲:往返延遲(FPGA → GPU → FPGA)小於 4.0 微秒。
GPU 硬體:基於 NVIDIA GB200 Grace Blackwell 超級晶片構建的即時主機,具有大量的 TFLOPS。
你可能會問:“這為什麼重要?”
它創建了一個開放標準,將量子硬體與加速的 GPU 計算緊密整合。
它支援混合工作流程:神經網路校準、量子糾錯(QEC)等。
它提供了一個將軟體和硬體整合在一起的開放平台,使任何人都能與量子電腦進行交互,而無需淹沒在浩瀚的知識海洋中,這要歸功於Cuda-Q。
NVQLink 白皮書現已發佈在 https://arxiv.org/abs/2510.25213,讓我們深入了解所提出的架構的細節:
系統架構
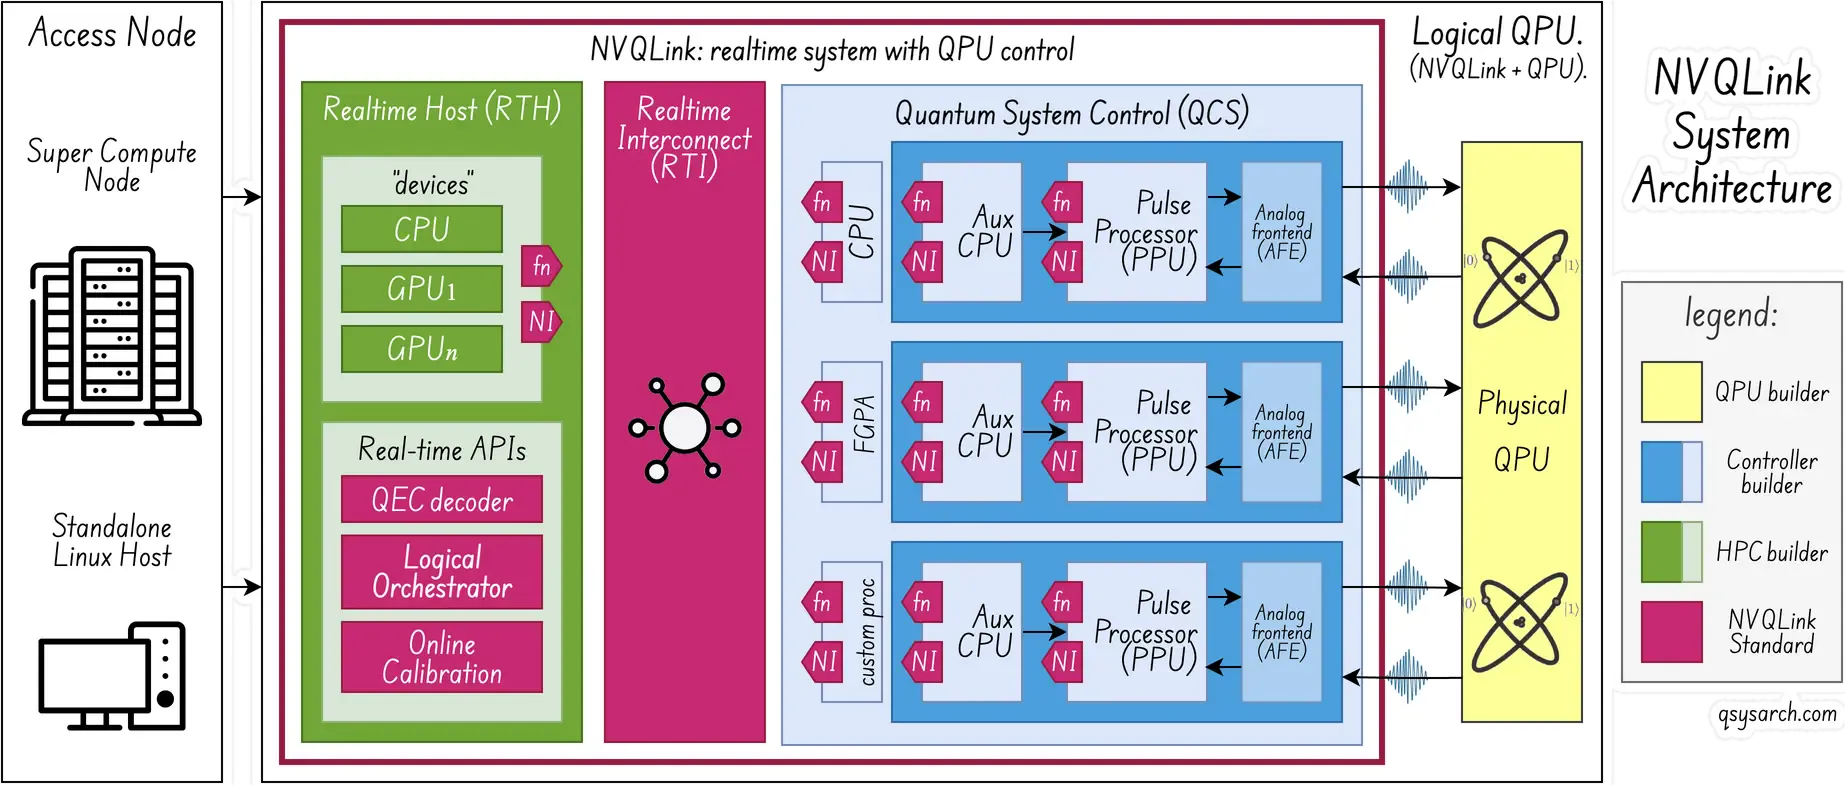 (系統圖改編自白皮書中的原始圖)
如預期,細節與Nannod提供的概要相符。從元件角度來看,NVQLink架構包含即時主機(RTH)和QPU控制系統(QSC)。這兩個組件透過低延遲、可擴展的即時互連(RTI)連接。 RTH擁有傳統的高效能運算(HPC)資源,例如CPU和GPU。而QSC通常包含控制QPU的脈衝處理單元(PPU)。
此圖引入了兩個重要的關鍵字:fn 和 NI。在 NVQLink 的思維模型(“程式模型”)中,每個 CPU、GPU、PPU(或其他專用 IC/FPGA)都被稱為“設備”,NVQLink 允許對任何這些設備進行遠端過程呼叫(“回調”或 fn)。這是一個功能強大的解決方案,NVQLink 充當了異構系統的黏合劑。 fn 運作時的實際實作經過高度最佳化,甚至連編組都已處理完畢。這樣一來,就能確保幾微秒的延遲。至於 NI,它代表網路接口,其概念是所有參與方都可以使用的“小型”可選網路卡/接口/電纜,從而構建一個統一的互連系統。
NVQLink 也引入了非常重要的時間域概念:這是必要的,因為系統中涉及的「處理單元」並非都期望遵循「同一時鐘」。
時脈或時間域分為 4 個類別,從最快到最慢:

物理時域(PTD):通常指 QPU 時鐘。
確定性時域 (DTD):通常是 QSC/FPGA 時鐘,能夠以量子相干時間尺度運作。
實時域(RTD):通常在經典的CPU或GPU中。可以在量子相干時間範圍內,也可以在兩個量子相干實驗之間。
應用時域 (ATD):通常指執行 jupyter notebook 的筆記型電腦!
網路架構
不出所料,NVQLink 利用 RDMA 和 GPUDirect 技術來繞過任何不必要的 CPU 處理,從而確保最佳延遲。如規格所述,「受益於這兩項技術,在處理進出 QSC 的資料包時,只有網卡和 GPU 參與,主機無需參與」。
該規範還建議使用「不可靠連接」RDMA 模式,因為與精心設計的網路相比,為可靠連接 (RC) 付出的延遲代價可能過高。
該規範為網路架構提供了一個“概念驗證”,以此來驗證可能達到的延遲。它使用了 Holoscan Sensor Bridge 模組,該模組能夠使用基於融合乙太網路的 RDMA (RoCE) 協定在 FPGA 和網路卡之間發送數據,並處理枚舉步驟和控制訊號。該規格表明,使用此架構,對於 32 位元組的 RDMA 有效載荷(相當於 92 位元組的乙太網路幀),可以實現低於 4 微秒的往返延遲。
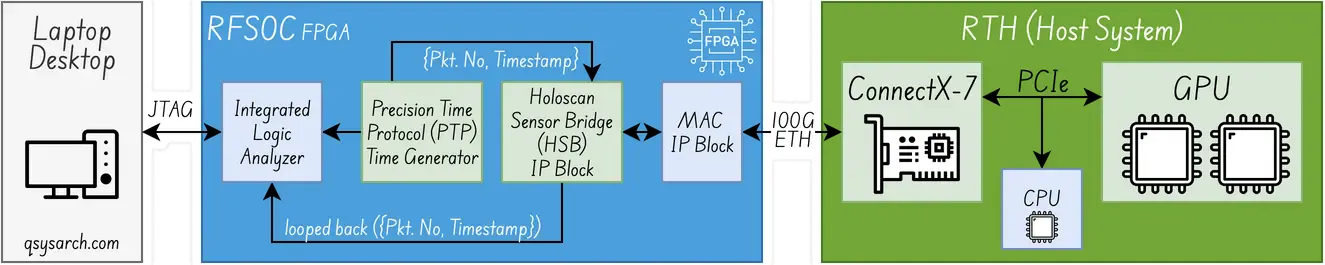 (圖表改編自白皮書中的原始圖片)
NVQLink區分了慢速模態和快速模態,本節將重點放在快速模態架構的影響(即所謂的「高延遲敏感度」)。與慢速模態的主要區別在於,此架構支援即時編譯(JIT)以及在執行過程中進行RTH(返回目標)調解。
為了使 CudaQ + NVQLink 能夠支援快速模式,規範規定_完整的指令集架構 (ISA) 程式必須預先上傳到 FPGA,並以原子方式觸發,執行期間與即時主機 (RTH) 的交互通信量要盡可能少_。 JIT 確實是一項很棒的技術,可惜它不能用於快速模式。不過,規範明確指出,只要指令佇列在程式終止前保持非空狀態,FPGA 就可以「接收」來自 RTH 的動態更新(「透過_指令佇列_」)。這聽起來像是「即時」調度。
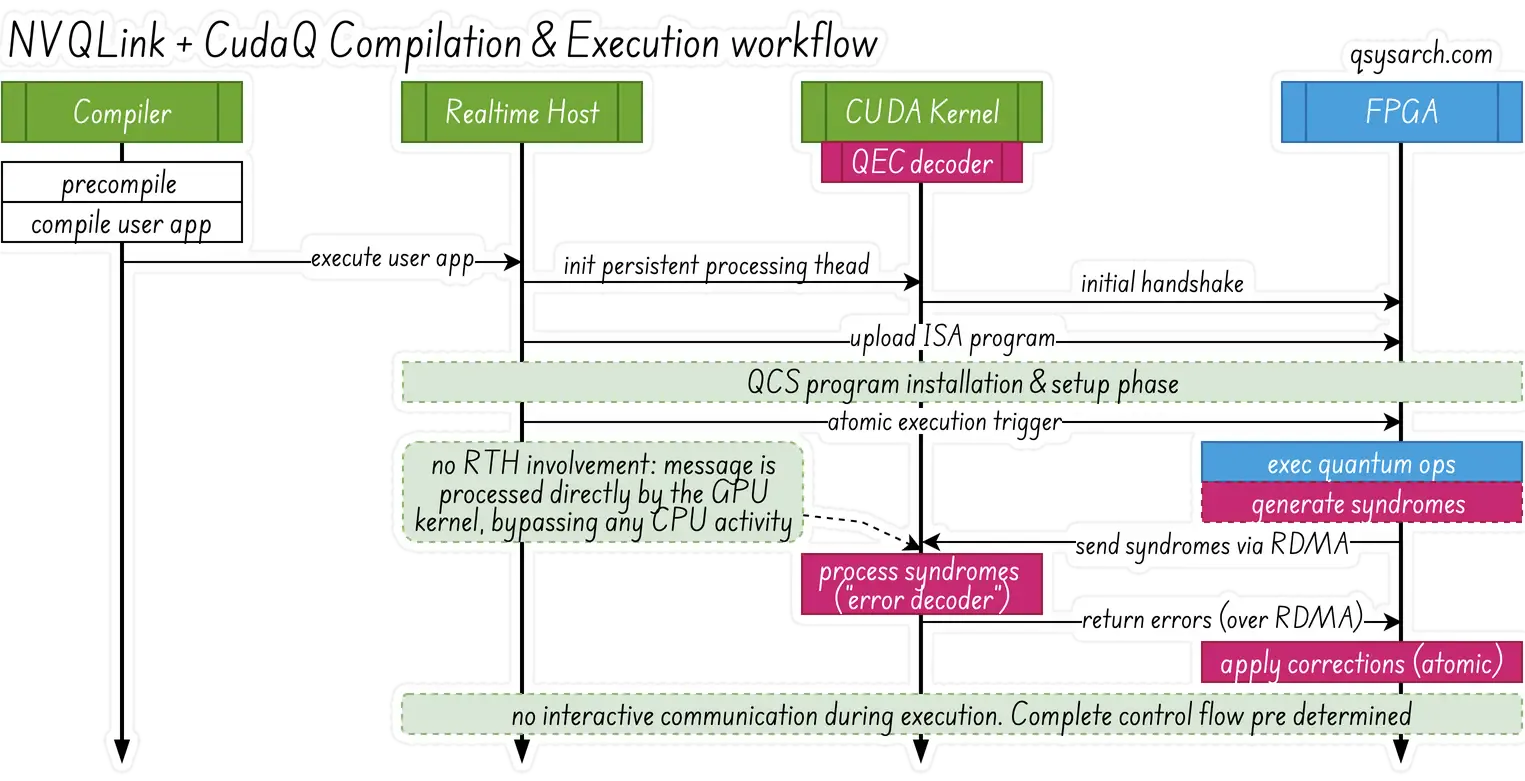
不出所料,規格明確指出編譯過程必須進行積極的預先最佳化——這無疑是所有量子控制協議堆疊供應商的核心做法。規格也提到,如果需要在GPU中執行任何回調,則GPU中的CUDA核心必須預先初始化並主動等待事件-這沒什麼特別的,這是標準的DOCA GPUNetIO工作流程。
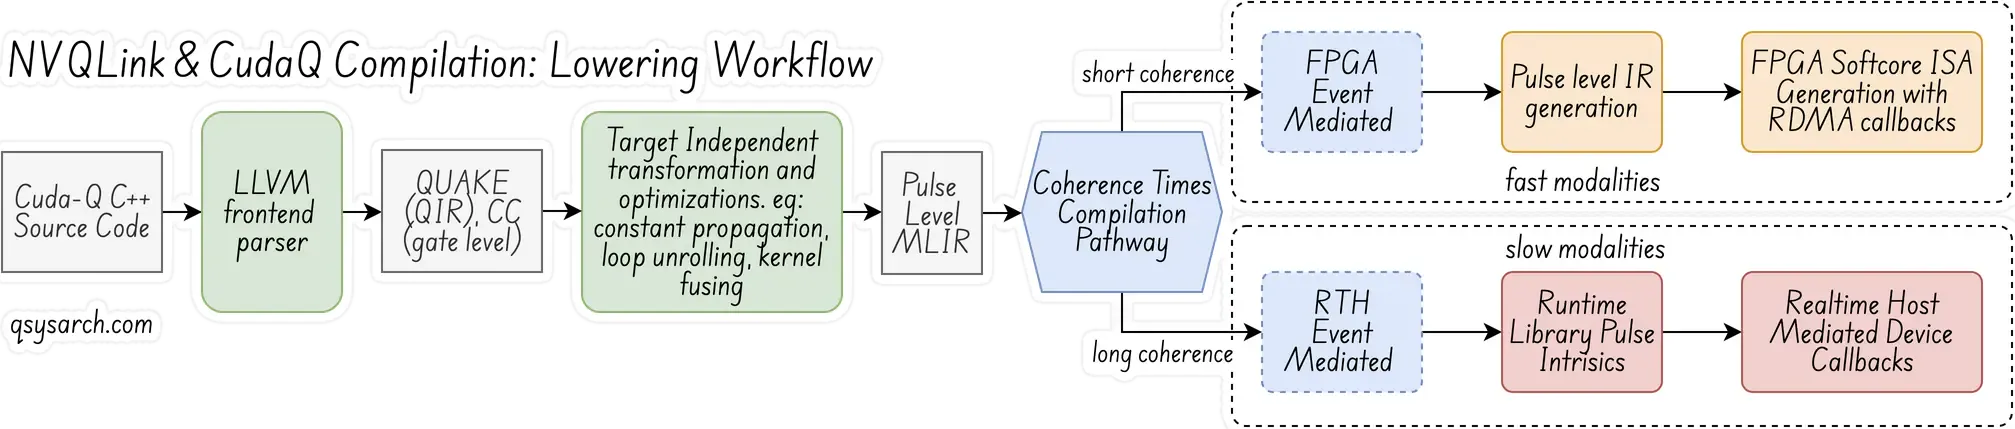
CUDA=Q 編譯和降維到 NVQLink 架構的工作流程是基於標準的 LLVM MLIR 架構(請參閱上圖)。第一步是解析 CUDA 內核,並產生 Quantum IR(也稱為 QIR 或 QUAKE)和 CC(經典計算)中間 IR,這些中間 IR 在閘級進行抽象化。後續階段引入必要的最佳化和內核融合,產生脈衝級方言。然後,根據模態類型,下一個降維階段使用 RTH 或 FPGA 中介。
「量子核心」以「qpu」前綴標識。
int gpu_adder(int, int);  // This function is executed on GPU
__qpu__ int simple_quantum_kernel(int i) { // This function (kernel) is executed on the QCU
cudaq::qubit q;
h(q); // Operate an H gate on qubit q
auto readout = mz(q); // Read the Z axis of qubit q
return cudaq::device_call(2, gpu_adder, i, readout); // This is tail function call
}
在編譯階段,它首先被轉換(「降級」)為 QUAKE(量子方言)和 CC(經典計算方言)中間表示(IR)或方言的混合:
func.func @simple_quantum_kernel(%arg0: i32) -> i32 {
%0 = quake.null_wire
%1 = quake.h %0 : (!quake.wire) -> !quake.wire
%measOut, %wires = quake.mz %1 : (!quake.wire) -> (!quake.measure, !quake.wire)
%2 = quake.discriminate %measOut : (!quake.measure) -> i1
%3 = cc.cast unsigned %2 : (i1) -> i32
%4 = cc.device_call @gpu_adder on 2 (%arg0, %3) : (i32, i32) -> i32
return %4 : i32
}
與 RDMA 中根深蒂固的零拷貝概念一致,NVQLINK 運行時也提倡高效能和零開銷抽象,這是透過兩個關鍵的基本概念實現的:
它具備4個基本特質:
explicit_data_marshalling_trait:表示在系統中指派和傳輸資料。
device_callback_trait:表示呼叫裝置函數(「RPC」)
quantum_control_trait:指在量子控制系統上傳並啟動程式。
rdma_trait:表示從原始記憶體緩衝區有效地初始化結構。
實際上,這些特性將 C++ 語言運用到了非常高階的程度。例如,資料封送特性就是如此。
template <typename Derived> class explicit_data_marshaling_trait {
public:
void *resolve_pointer(device_ptr &devPtr);
device_ptr malloc(size_t size) const;

template <typename... Sizes, enable_if_t<(conjunction_v<is_integral<Sizes>...>),int> = 0>
auto malloc(Sizes... szs) { return make_tuple(static_cast<Derived *>(this)->malloc(szs)...); }

void free(device_ptr &d);

template <typename... Ptrs, typename = enable_if_t<(conjunction_v<is_same< remove_cv_t<remove_reference_t<Ptrs>>, device_ptr>...>)>>
void free(Ptrs &&...d) { (free(d), ...);
}
void send(device_ptr &dest, const void *src);
void recv(void *dest, const device_ptr &src);
};
這種語法蘊含著許多值得探討的內容,在我看來,它甚至比 Rust 的語法(例如 cow)更強大。這種語法也被稱為元編程,在 NVQLINQ 的脈絡中,它指的是編譯時或靜態多型。讓我們來看一下 _template 這行程式碼。 <typename… Sizes, enable_if_t<(conjunction_v<is_integral …>),int> = 0>_ 更詳細的資訊:
is_integral<Sizes> as α: 如果 Sizes 是 整型,即 int、float、bool 等,則為 true
conjunction_v<α...> as β: 如果 α... 中的所有值都為真,則傳回 true
enable_if_t<(β),int> 作為 δ: 一個 組 2 條件語句,如果 β-to-use-it-fd76d3abbabe) 條件語句,如果 β 語句應該是假,則該條件失敗語句。
模板<typename... Sizes, δ = 0>: 一個 SFINAE 構造,防止 δ 失敗。
使用這種語法,可以一次對多個記憶體區塊進行專門的 malloc 分配:
class gemm_device : public explicit_data_marshalling_trait {  ... }
gemm_device gpu_gemm; // "gemm" stands for general matrix multiply
auto [column, row, matrix] = device.malloc(1024, 1024, 1024*1024);
你可能會問,這有什麼意義?很簡單,它允許在編譯時進行最優的特化。在這種情況下,malloc 的實作可以將記憶體緩衝區連續地捆綁在一起,使其適用於 RDMA 交換和多個資料的原子編組。很棒,不是嗎?
NVQLink 提供了一套用於編譯、上傳和執行(觸發)量子核心的標準介面。正所謂一圖勝千言,我將用這張圖來總結本節內容:
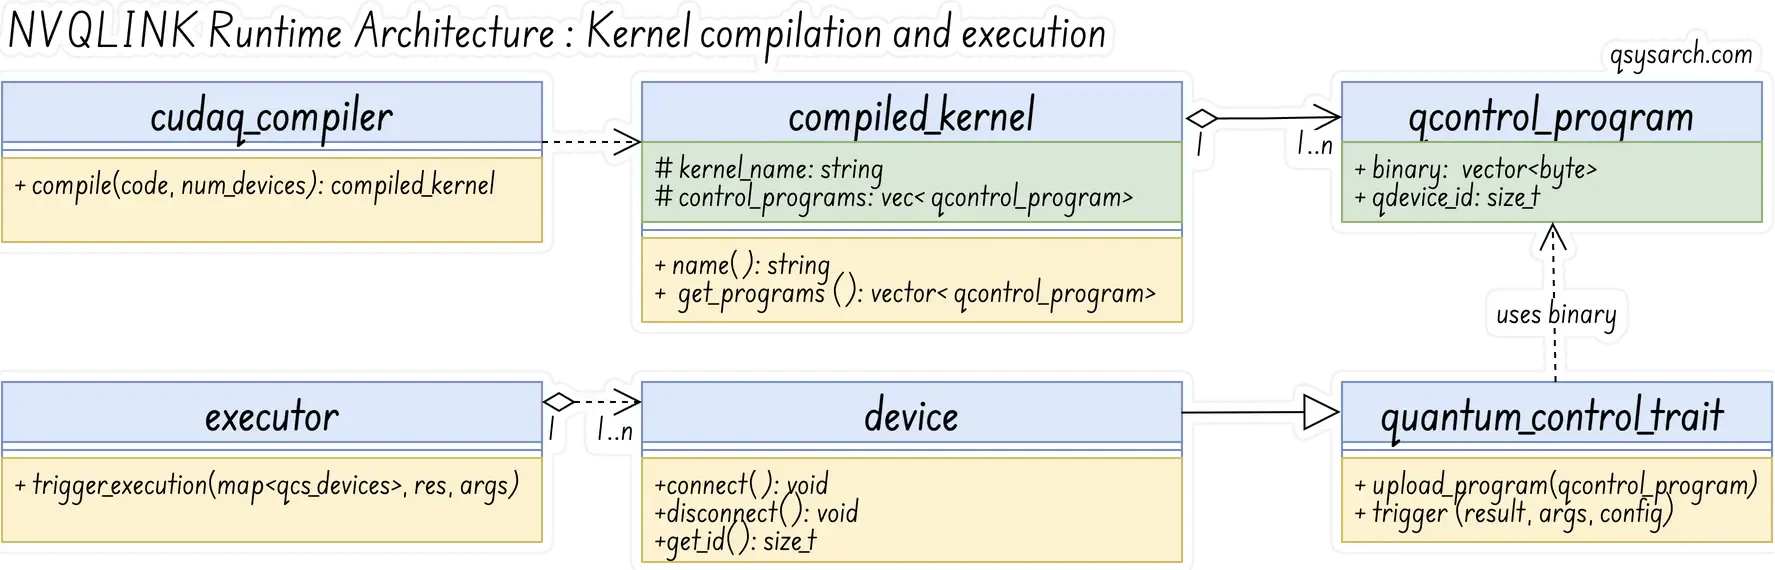
需要注意的是,量子控制系統 (QCS) 由多個脈衝處理器單元 (PPU) 組成。因此,編譯核心時,可能需要在多個 PPU 上同步執行。 (請注意,NVQLink 對同步性沒有要求,但每個 QCS 供應商都有自己的解決方案,例如 Qblox 的 SYNQ)。
在 NVQLINK 介面中,PPU 的概念被抽象化,並被 QCS 所取代,QCS 代表通用量子設備。因此,在編譯核心時,NVQLINK 會為每個 QCS 產生多個程式。
由於上一節中解釋的程式碼可能相當複雜,難以理解和擴展,因此 NVQLINK 提供了一組更高層級的 API,以函數的形式呈現:
該庫包含用於處理基本初始化和關閉功能的函數,用於處理設備特定的數據修改 API(例如 memcpy),用於在邏輯 QPU 之間傳輸數據,以及用於處理上傳和執行的函數。以下是這些函數的簡化版本:
void initialize(DeviceTypes &&...in_devices);
void shutdown();

device_ptr malloc(size_t size, size_t devId);
void free(device_ptr &d);

void memcpy_to_qpu(device_ptr &arg, const void *src);
void memcpy_from_qpu(void *dest, const device_ptr &src);

handle load_kernel(const string &code, const string &kernel_name);
void launch_kernel(handle kernelHandle, device_ptr &result, const vector<device_ptr> &args);
待完成
# 結論
NVQLink 是一個強大的系統層級抽象層,它能夠實現異質系統的互連,並提供高效且最佳化的執行環境。與其他框架相比,NVQLink 更具吸引力之處在於,它由標準協定堆疊構成,包括用於網路的 RDMA、用於編譯器的 LLVM,以及用於執行時間的 trait 和標準化 API。
透過 NVQLINK,開發人員和整合商無需再為互連而煩惱。他們可以專注於建立異質系統,並在單一框架內編譯多設備內核,然後讓 NVQLINK 運行時協調不同「設備」的執行,就像它們是一個整體系統一樣。 NVQLINK 運行時會處理網路、編組和設備間調用,讓您無需操心這些細節。
這是一次巨大的飛躍——它將與 CUDAQ 結合,使量子工程師能夠創建強大的應用程序,就像英偉達 CUDA 賦能強大的神經網路應用程式一樣。可以把它想像成具有量子特性的 LLM…
提示:繪製一個「大量子位元模型」的影像,該模型在透過 NVQLINK 系統連接的相鄰 GPU 上進行計算。 ChatGPT 沒能理解 NVLINK 不是 NVQLINK。
提示:請繪製一幅卡通風格的NVQLINK系統圖,該系統將一個「大型量子位元模型」與相鄰的GPU連接起來。 ChatGPT 仍然不明白 NVQLINK 不是一條“電纜”,而是一個系統級框架,它使得在多個異構設備上執行核心成為可能。而且,就目前而言,這條「電纜」預計是 RDMA(因為它是一個標準),但五年後很可能會變成 NVLink。
References
DrawIO diagrams used in this memo: