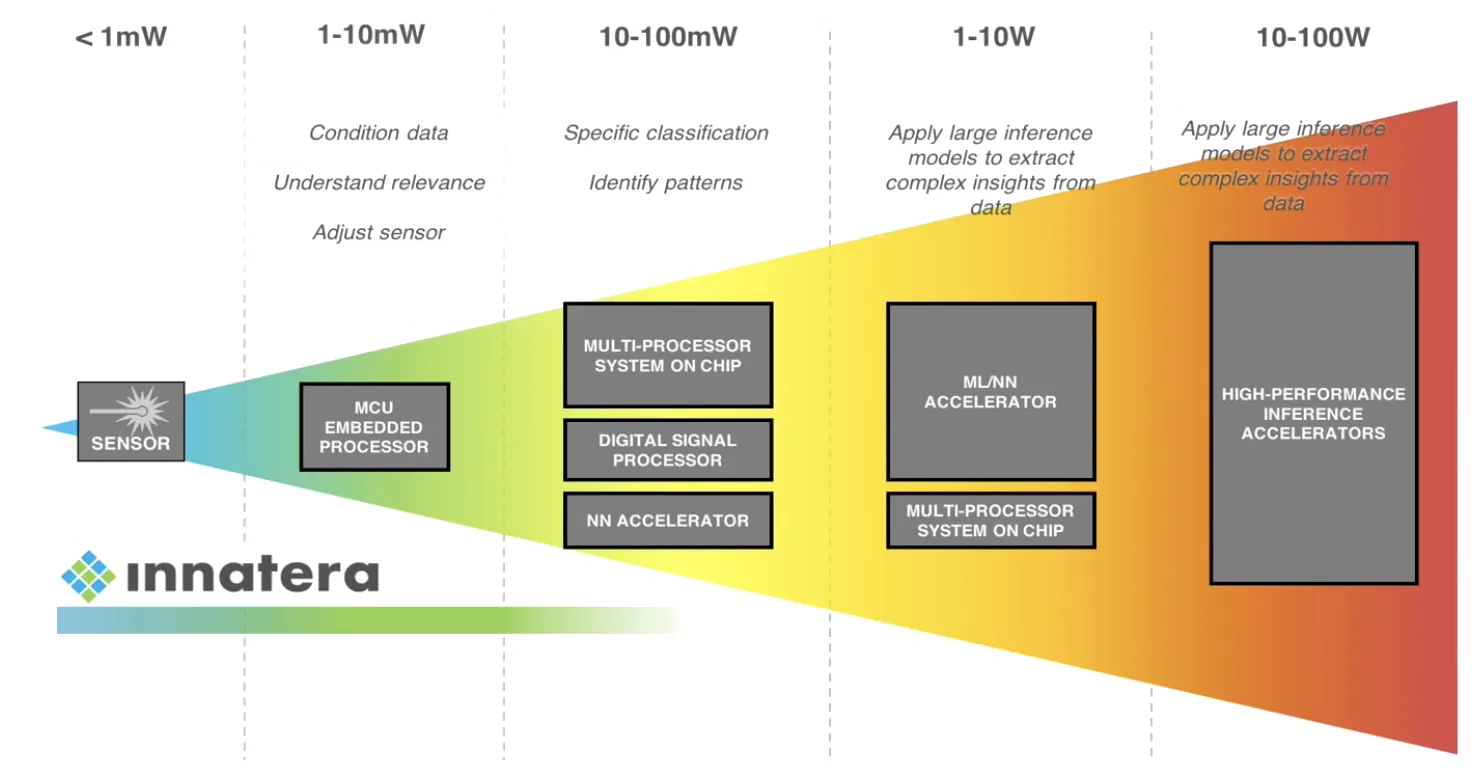
最近在討論Neuralink公司時,我聽說了神經形態處理單元(NPU)。 Innatera Pulsar晶片(見右圖)雖然與量子運算無關,但我認為花點時間了解這種新的處理架構會很有趣。事實上,該領域領先的積體電路供應商之一是一家名為Innatera的荷蘭公司。 Innatera最新的晶片Pulsar是基於低功耗脈衝神經網路(見右圖)。
在本備忘錄中,我將嘗試逆向工程盡可能多的信息,以了解這些神經形態積體電路的架構、脈衝神經網路的設計以及用於對這些設備進行程式設計的軟體堆疊。
這是對 Pulsar IC 架構圖的重新繪製嘗試(原始圖像,並補充了[白皮書](https://innatera.com/storage/app/media/Resources/見解)
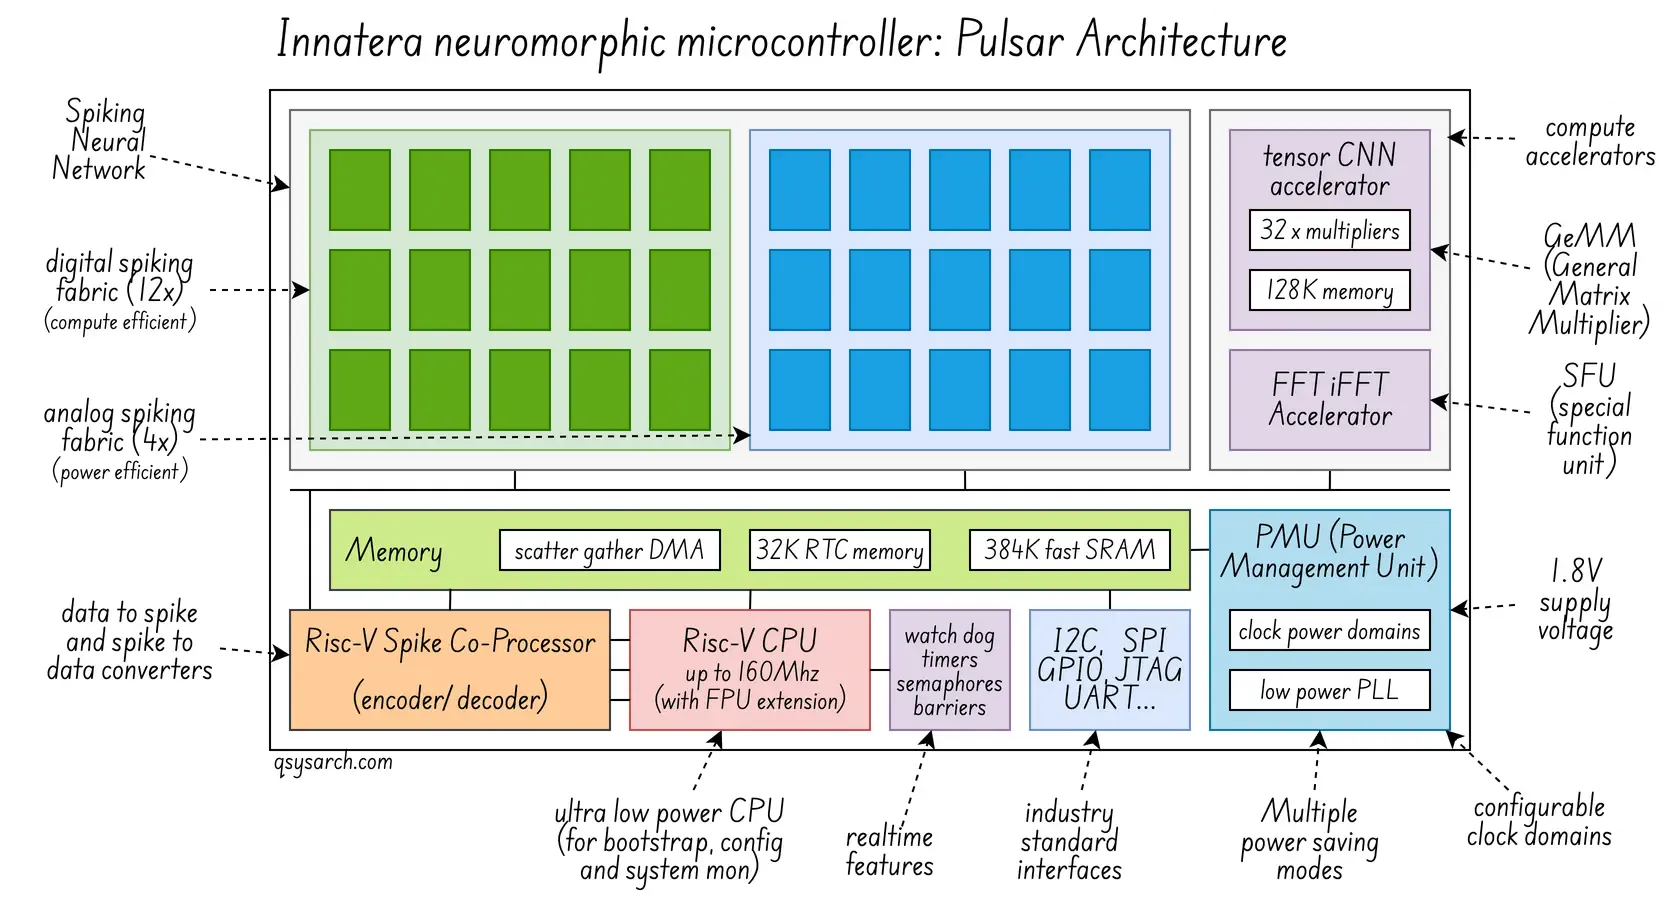
我確實很喜歡使用 RISC-V CPU 的想法——這清楚地表明 Innatera 團隊從一開始就做出了正確的架構決策。在 Innatera 早期的 T1 晶片的一張示意圖中,RISC-V CPU 與 F 擴充(捆綁在一起運作)。
此積體電路整合了多種標準介面(SPI、I2C 等)和一個電源管理單元 (PMU),用於在進入「睡眠模式」或「省電模式」時開啟或關閉積體電路的某些部分。遺憾的是,除了一個球形電池組顯示“小於 1mW”之外,我找不到任何關於實際功耗的數據。假設供電電壓為 1.8V,則電流將小於 500 µA(I=W/V)。我還想知道「每個週期」的功耗指標是否相關:在這種情況下,假設頻率為 100Hz(突觸更新週期),則平均每次突觸更新的電流為 5 µA。
Pulsar 最新發布的架構圖顯示了兩個加速器:一個 CNN 和一個 FFT。我認為更廣義的描述應該是 GEMM(通用矩陣乘法器,神經網路運算的關鍵)和 SFU(特殊功能單元,用於加速 FFT 計算)。更多資訊請查看關於 GPU 架構的帖子。此外,還有一個脈衝編碼器-解碼器,它似乎是作為 RISC-V 的協處理器開發的,但我沒有找到更多細節。
剩下的問題是關於脈衝神經網路(Spiking Neural Network,簡稱 SNN):它是如何運作的?
我請 Gemini 用比喻向 8 歲的孩子解釋脈衝神經網路。以下是他們給的比喻:
把大腦想像成一個巨大的郵局,「神經元」就是傳遞訊息的信使。
- 信使和筆記:
在普通的電腦程式中,每個通訊節點都在不停地傳遞和發送數字。而在脈衝神經網路中,通訊節點則非常安靜且節能:它們只在發生重要事件(例如微小的電脈衝)時才發送一條簡短的「嘿!」訊息。
- 火花表:
每個信差都有一個能量槽,當他們聽到其他人喊「嘿!」時,能量槽就會充滿:當能量槽充滿到一定程度(達到閾值)時,該信使也會興奮起來,喊出「嘿!」。喊完之後,能量槽會重置,所以他們不能立即再次喊叫(不應期)。
- 時機至關重要:
如果信使快速聽到很多聲“嘿!”,說明訊息非常重要(例如“著火了!”)。如果某個信使比其他人稍早喊一聲“嘿!”,這可能是一個秘密信號,預示著有特殊的事情發生(例如“老虎來了!”)。所以,信差需要掌握時間。
- 學習是關鍵:
信差們跟你一樣會學習:如果信差 A 在信差 B 喊出「嘿!」之前喊出「嘿!」(因為有什麼事讓他們兩個都興奮起來),他們的友誼就會更加牢固,信差 A 的訊息也會幫助信差 B 下次更快地填滿能量槽。
脈衝神經網路(SNN)之所以特別,是因為它們的設計目標是極快且有效率。它們不會一直浪費能量進行通訊;只有在需要共享大量資訊時才會啟動!它們有助於電腦理解時間、識別模式,而且功耗極低。
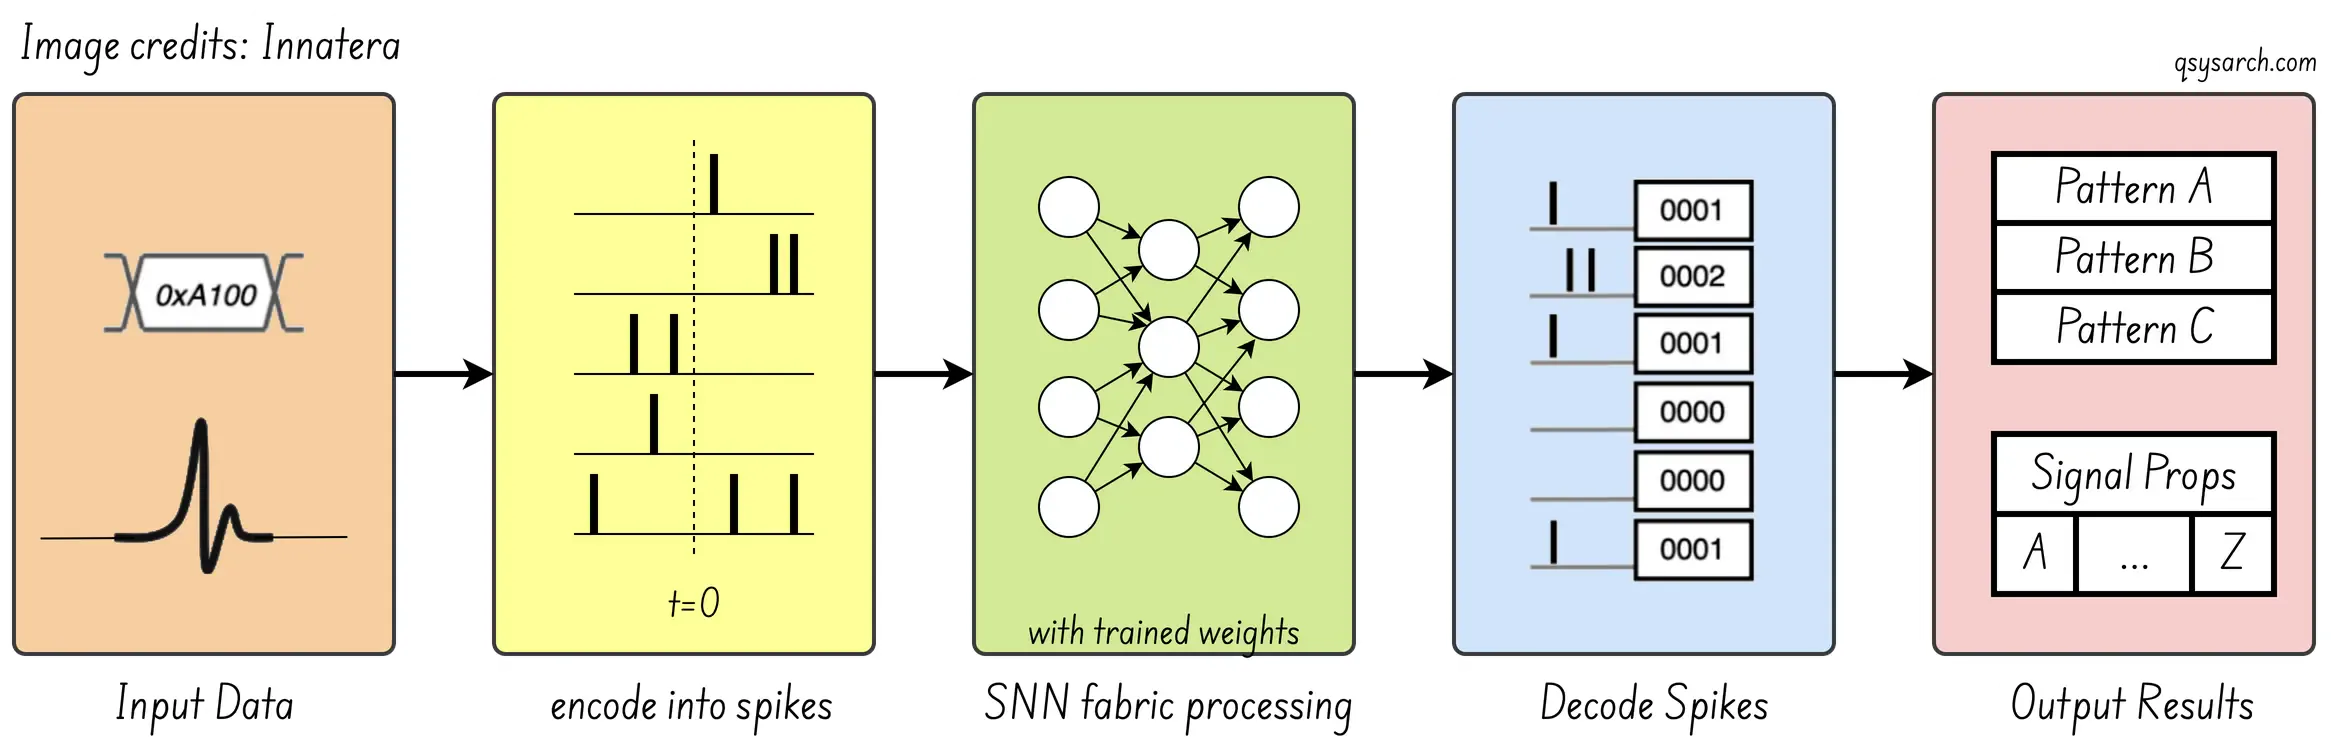
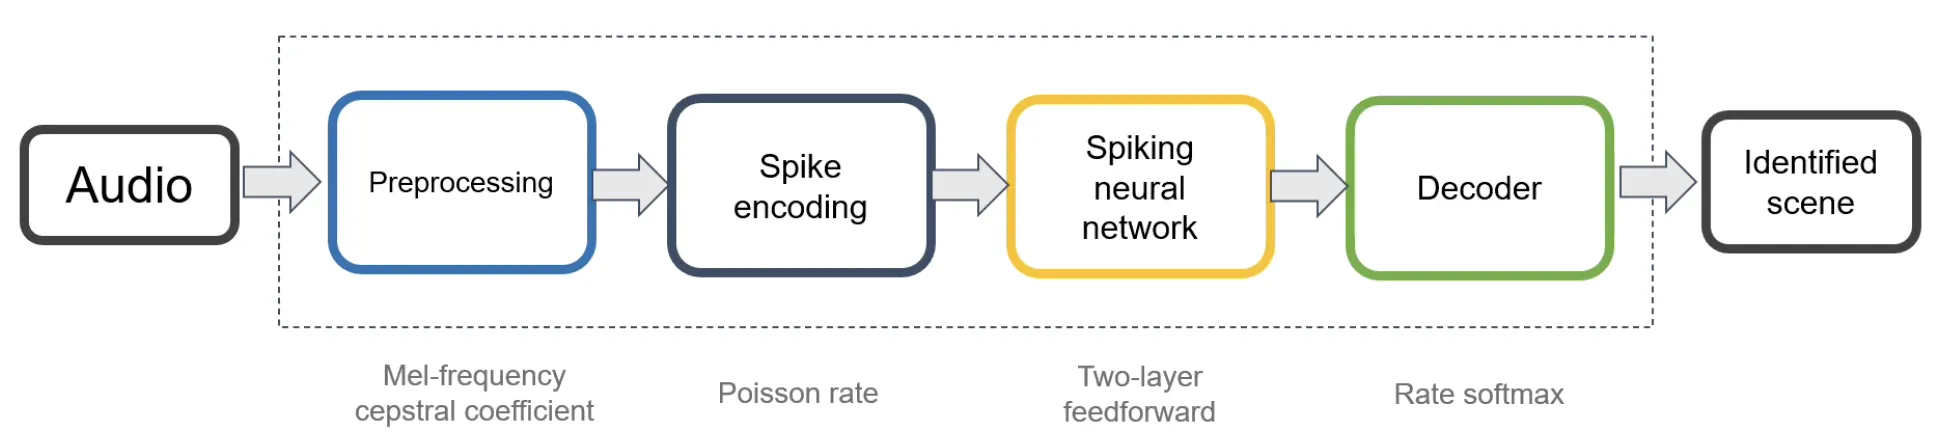
Innatera 的部落格「脈衝思維」(Thinking in Pulses)很好地概述瞭如何在硬體中實現這一功能。將“嘿”聲編碼成二進制值,輸入神經網絡,然後提取特徵。到目前為止,沒什麼特別的;這是一個標準的神經網路處理過程。
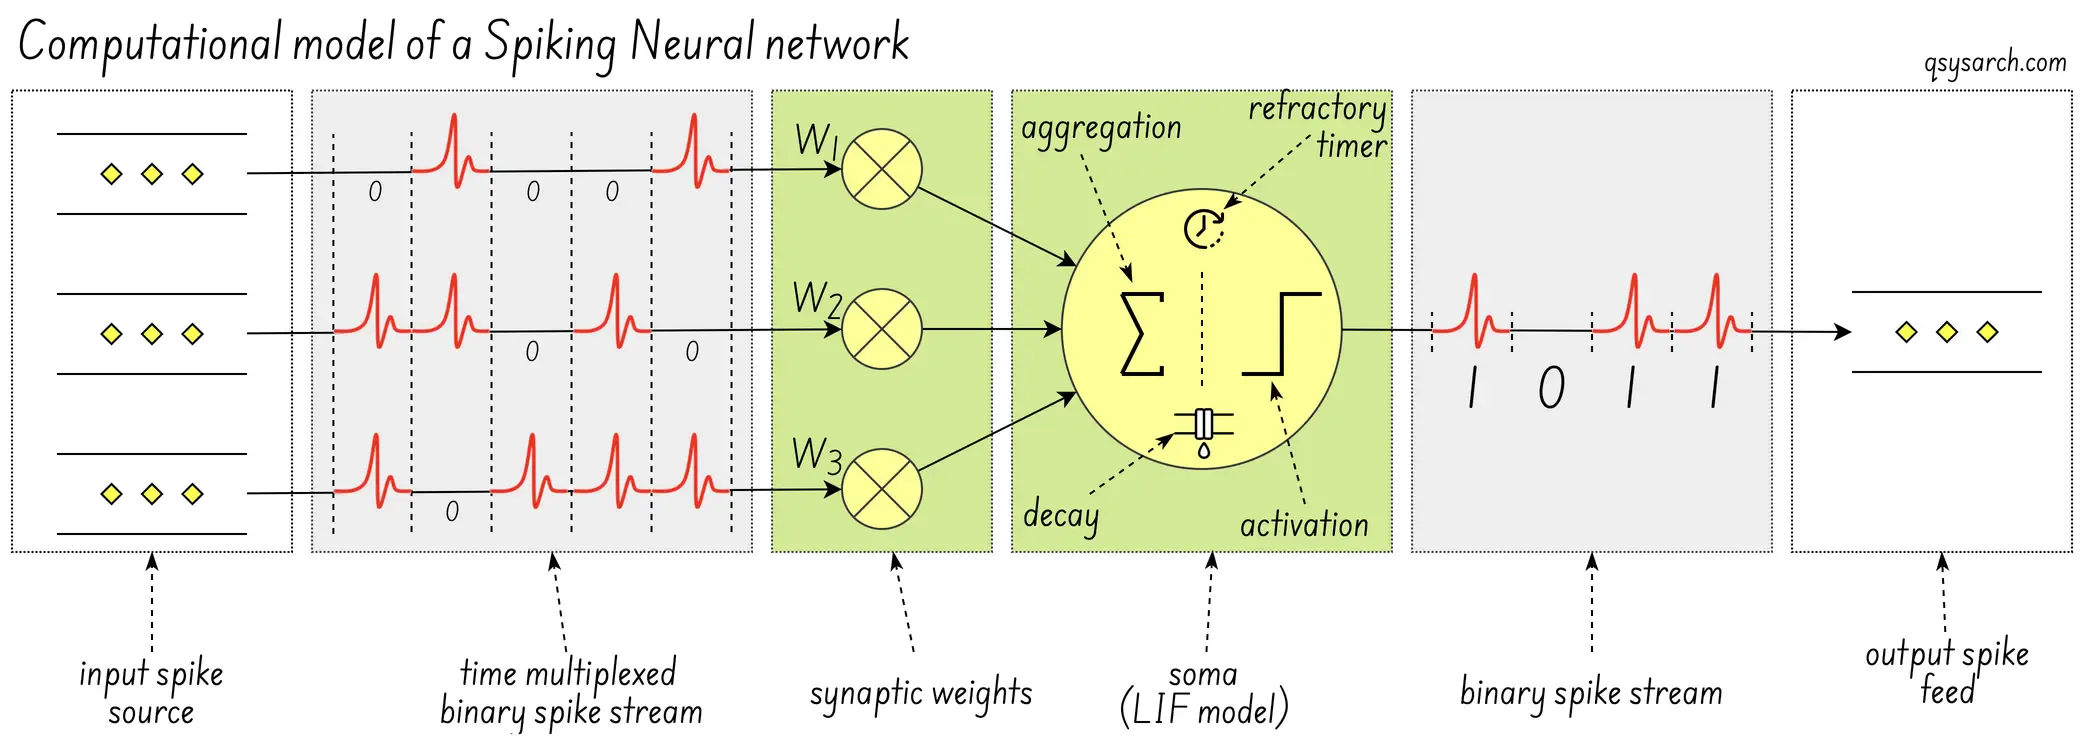
更有趣的問題是這個SNN是如何實現的。下圖似乎是一個傳統的數位神經元「計算模型」(圖像來源)——其中我在SOMA中明確添加了「漏積分-觸發」([LIF](https://ieeexplore.ee.org/abstract/document/10225
待補充:需要解釋
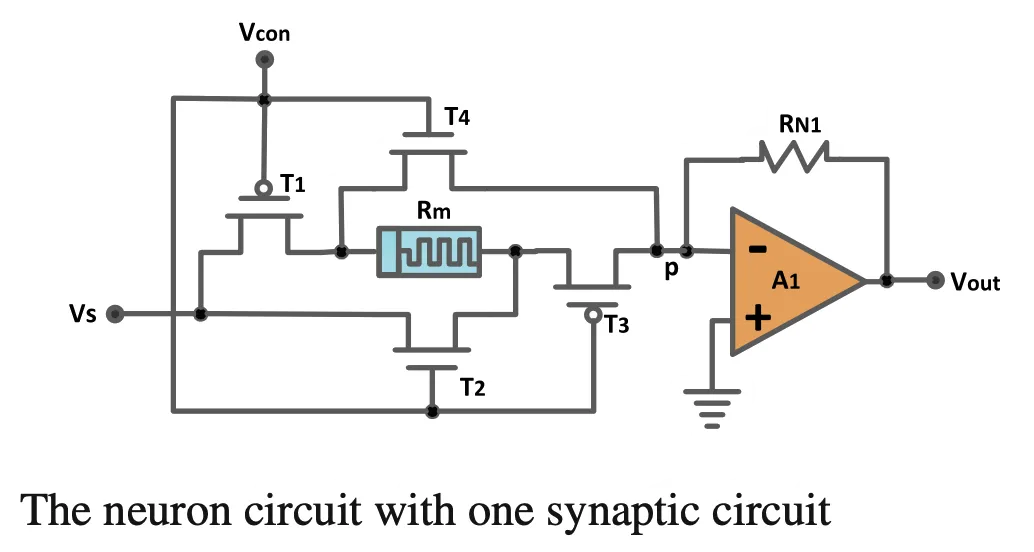
效能提升幅度(10倍、1000倍,還是更高?)
可達到的神經網路傳播延遲
權衡取捨和限制
類比電路與數位電路設計性能比較。
相對於 GPU/TPU 的功耗
Pulsar 設計中的一個問題是:為什麼有兩個 SNN?答案是,Innatera 的模擬(專有的類比混合訊號)SNN 架構針對最大能源效率和超快、超低功耗的事件處理進行了最佳化。而數位 SNN 架構則是更可編程、更靈活的設計,支援更多可配置的網絡,但功耗略高。 (資料來源)
Innatera 的網站上沒有太多關於其脈衝神經網路內部架構的信息,但幸運的是,他們有一些專利,我們可以嘗試進行逆向工程!
對於一家新創公司來說,這專利數量相當多!由於時間關係,我只查看了清單中的第一個和最後一個專利。
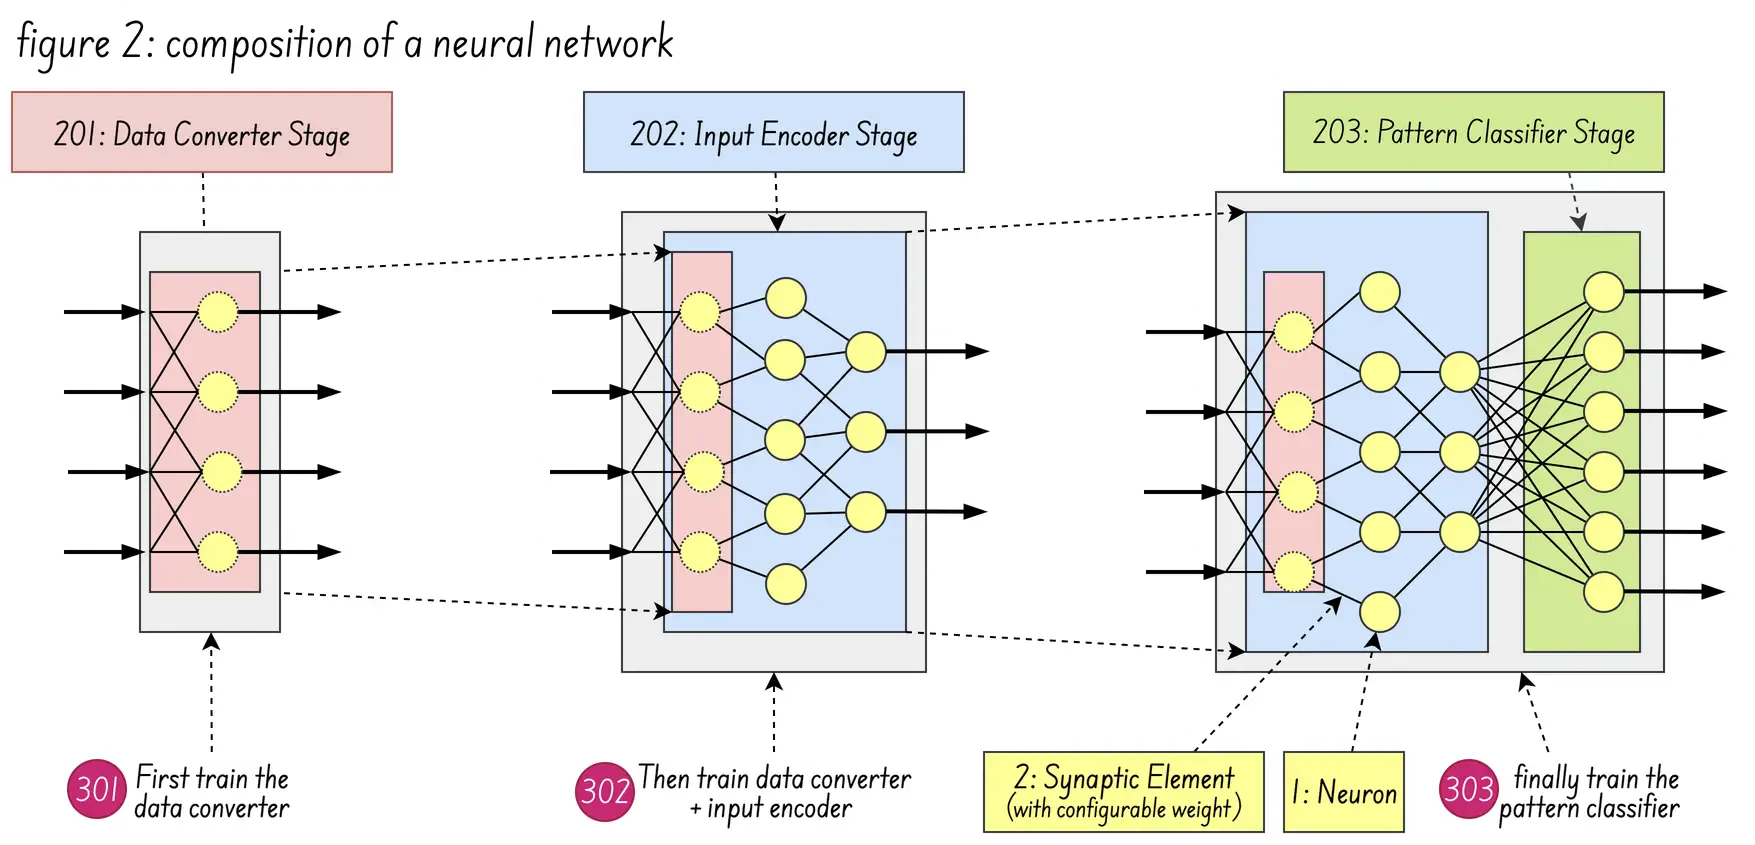
讓我們從第一項專利US20220230051A1開始,它似乎是最接近描述SNN實際硬體實現的專利:該專利的核心是一種組合方法,用於使用「唯一響應」原則,從專門的網路、單元(SNN」)建立原則,從「預訓練」的原則
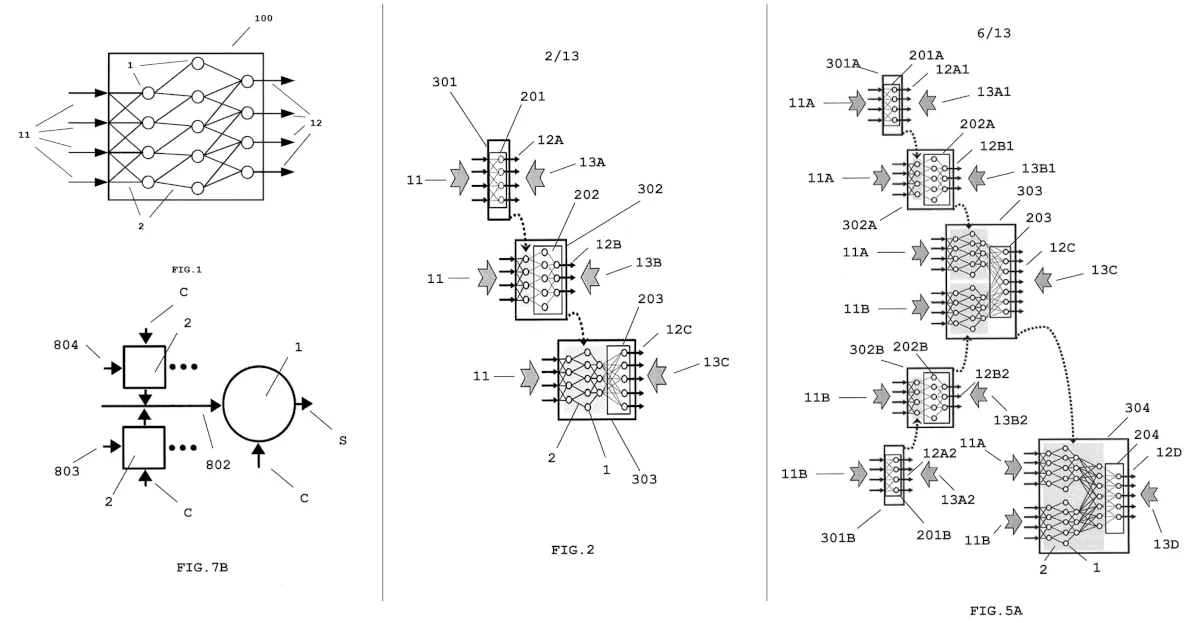
圖 2(下方)展示了由資料轉換器階段 201、輸入編碼器階段 202 和模式分類器階段 203 整合而成的神經網路的組成。圖 5B(上方)則展示如何將多個時間脈衝序列融合為單一的融合脈衝序列。
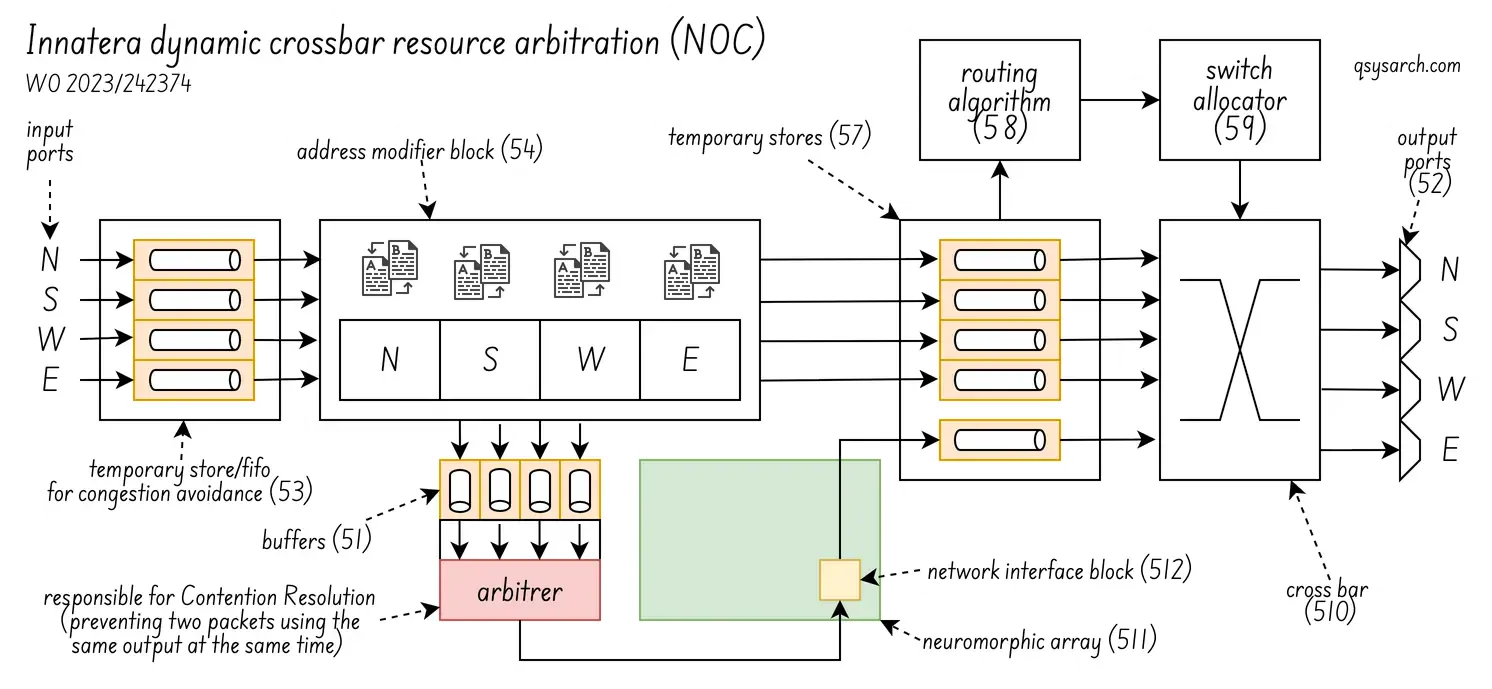
至於最後一項專利WO2023242374A1,它公開了Innatera公司的“脈衝神經網路架構”,該架構用於高效地利用片上網路實現單包組播。其目標是減少多核心/眾核系統中組播通訊的重複資料、延遲和開銷。
下圖(專利中的圖 5)展示了 NOC 仲裁的工作原理。其核心思想是防止兩個(或多個)脈衝同時發送到同一個輸出埠。這是一種高效率的脈衝路由方式,可確保每個週期都能有效率地處理脈衝。不過,我很好奇實際硬體中 FIFO 的深度。
我不清楚的是核心網路和脈衝網路是如何協同工作的:核心網路有多少個神經元?核心網路之間是相互連結的還是協同工作的?還是它們是能夠並行處理獨立分類任務的獨立單元?
我沒有關於Innera核心架構的確切答案,但有許多研究論文詳細介紹了可能的實現方式。其中一篇題為「神經形態電腦處理器的系統設計視角」的論文尤其值得關注,因為它比較了幾種不同的架構。
其中一種架構是“可重構且非常高效的神經形態系統”,或稱為 RAVENS,如下圖所示:
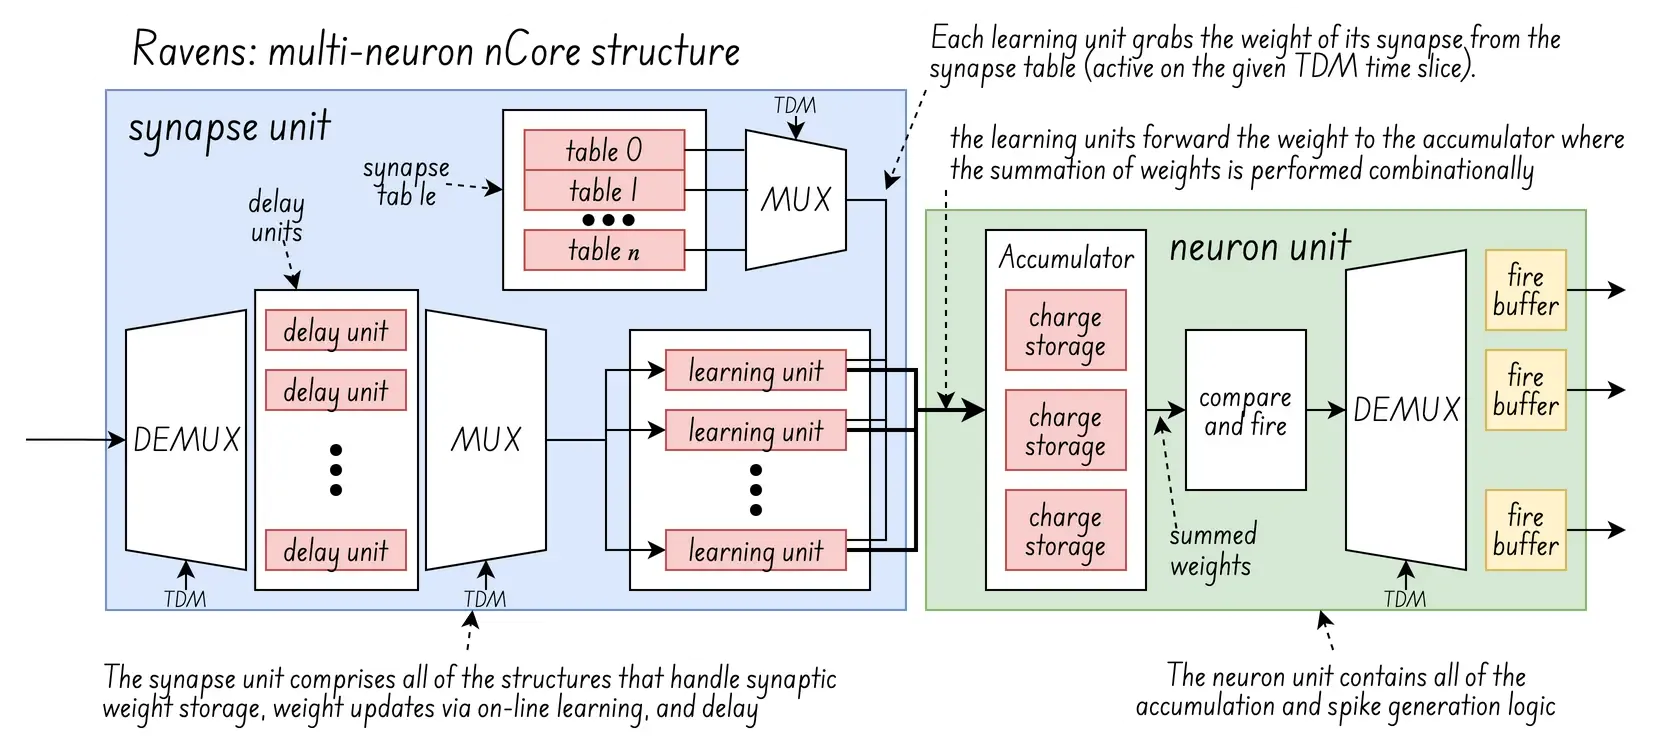 (圖表根據原始圖像更新:)
RAVENS 的核心思想是利用時分複用 (TDM) 技術,將多個「虛擬神經元」串聯起來,分兩個階段進行處理,包括累積和更新。
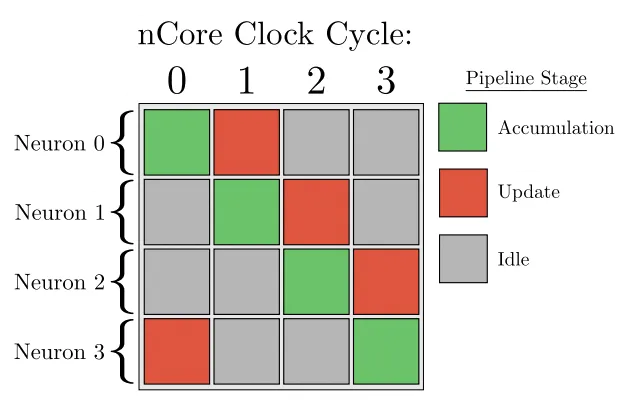
積累階段:神經元從與其相連的輸入突觸累積電荷,並根據其預設閾值和不反應期狀態決定是否發生放電事件。
更新階段:包括線上學習引起的突觸權重變化、電荷洩漏、不應期計數器增量、以及由於退出不應期而導致的累積電荷變化
這裡有趣的部分是線上學習:在神經形態積體電路中,線上學習透過使用諸如赫布學習或強化學習之類的演算法來改變突觸權重,從而根據突觸前和突觸後神經元的輸入即時調整突觸強度。
對於模擬內核,這種調整是透過憶阻器或磁隧道結(MTJ)等裝置實現的,這些元件的電阻或電導狀態會受到神經活動的調節,從而直接表示和儲存突觸權重。而對於數位內核,至少在RAVENS系統中,這種調整是透過突觸表來實現的。
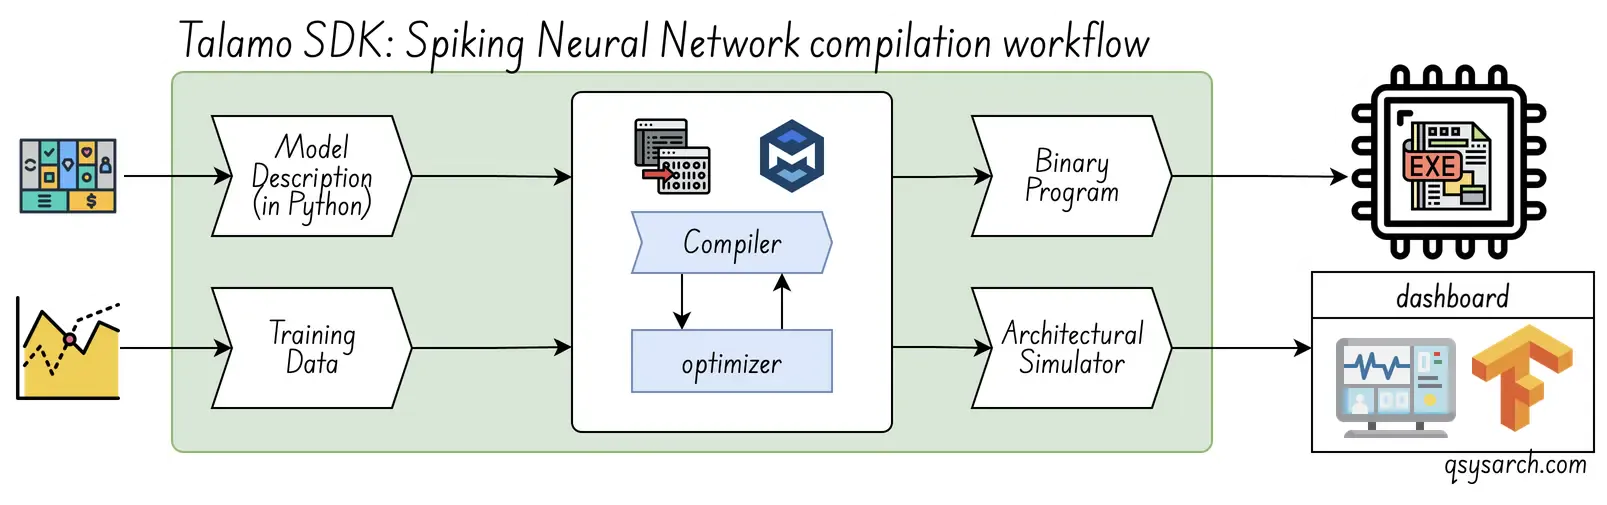
Innatera 的產品包含一個捆綁的 Talamo SDK,它無需 SNN 專業知識,支援端到端應用程序,並使用標準的深度學習工作流程。 Talamo 工具包可協助開發人員在基於 PyTorch 的環境中從頭開始建立脈衝神經網路模型。它就像一個 內建電池。
編譯工作流程非常標準。下圖是 Innatera 原始 資料的略微更新版本,假設工作流程的核心部分是編譯器。我還想知道模擬器是否以二進位執行檔作為輸入,如果是這樣,它應該被稱為模擬器。如果能獲得更多關於最佳化過程的資訊就太好了,以及是否有使用者可以調整的參數(例如將權重降低到1.58位元)。
一旦產生二進位程序,即可使用此執行工作流程,該工作流程或多或少遵循專利 WO2023242374A1 中定義的流程。
Innatera 的硬體包括強大的 RISC-V 處理器、功能強大的 GEM 處理器和 SFU 運算加速器。對於一些高級用戶來說,能夠直接存取這些硬體可能比僅僅將權重加載到針對 Innatera 架構的 C 庫中更具吸引力。
或許提供某種形式的開源韌體 SDK 會很有幫助。或者,可以考慮 CudaNN,它提供通用神經處理器單元 (GPNPU) 的使用體驗,就像量子計算行業使用的 Cuda-Q 一樣。此外,還可以考慮 NVNLink,類似於 NVQLink,以支援大規模 NPU 網路和混合架構?
也許這就是《神經形態技術的商業成功之路》 中所說的:「直到簡單的程式模型和工具出現,以及對硬體的直接API訪問,張量處理器才得以廣泛應用。」只需將「張量處理器」替換為神經形態單元即可處理單元(NPU)單元(NPU)即可處理單元(NPU)即可處理單元(NPU)單元?
在我看來,這歸根結底就是使用者體驗 (UX) 和開發者體驗 (DX)。我堅信,易用性和開發者體驗是打造真正卓越產品體驗的關鍵推動因素或策略支柱。
 (圖片來源:archi monarch)
# 結論
以上就是關於神經形態積體電路高層架構的簡要概述。毫無疑問,這種硬體架構是一種極具潛力的強大替代技術。然而,有人可能會認為神經形態積體電路缺乏殺手級應用。但這不正是神經形態積體電路的魅力所在嗎?難道這意味著我們需要創造與之配對的應用世界嗎?
我相信Innetera團隊屬於「以不同視角看待世界的人」。鑑於人們對人工智慧資料中心龐大的能耗需求感到擔憂,神經形態積體電路難道不是解決「如何用更少的能源創造更大的價值」這一關鍵問題的一種方案嗎?如果是這樣,那麼要如何擴展神經形態積體電路,使其運算能力達到人工智慧資料中心所需的水平呢?
另外,我想知道在脈衝神經網路(SNN)中加入一些矽光子學技術是否會有幫助?這既有利於神經運算,也有利於在SNN的各個獨立成分(IC)之間建構大規模互連網路。
# 參考
本備忘錄使用的DrawIO圖表: