
本備忘錄旨在了解 RDMA 的內部原理,特別是創建與 PCIe 子系統互連的「符合 RDMA 標準的網卡」所需的技術,例如與 DGX Spark 整合的 2000-2000-000000033)圖。
讓我們先概述一下 RDMA 協定。
設定 RDMA 資料通道時,需要先將記憶體緩衝區註冊到網路卡才能使用。註冊過程包括以下步驟:
RDMA 通訊基於一組三個隊列。
RDMA 佇列對,或稱 QP,指的是發送佇列 + 接收佇列。
應用程式使用工作請求(也稱為工作佇列元素 (WQE))來發出作業。工作請求是一個包含指向緩衝區指標的小型結構體:
在發送佇列中-它是指向要傳送的訊息的指標。
在接收佇列中-它顯示了傳入訊息應該放置的位置。
工作請求完成後,適配器會建立一個完成佇列元素,並將其加入完成佇列。
發送方(左)和接收方(右)實體已建立各自的佇列對和完成佇列,並在記憶體中註冊了用於 RDMA 操作的區域。發送方實體指定了一個要移動到接收方實體的緩衝區。接收方實體已分配了一個空緩衝區用於存放待處理的資料。
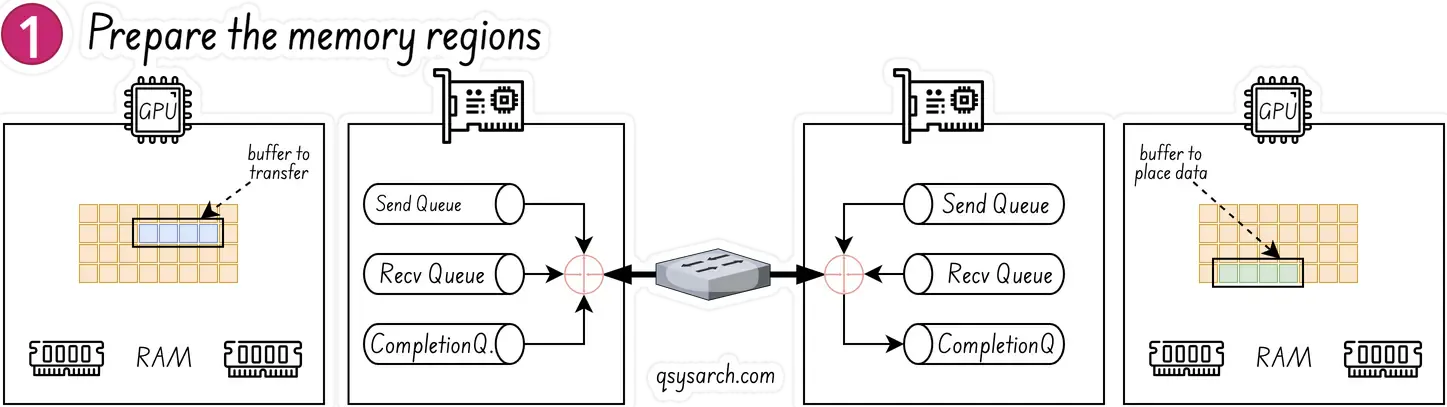
右側的接收實體會建立一個名為 WQE WOOKIE 的工作佇列元素,並將其放入接收佇列。此 WQE 包含一個指向記憶體緩衝區的指針,資料將儲存在該緩衝區中。左側的傳送實體也會建立一個 WQE,該 WQE 指向其記憶體中待傳送資料的緩衝區。
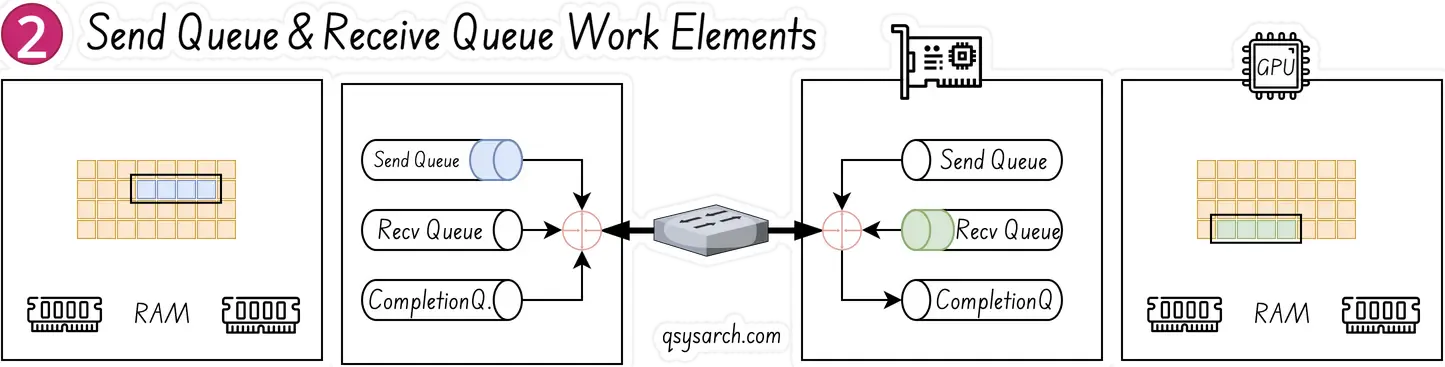
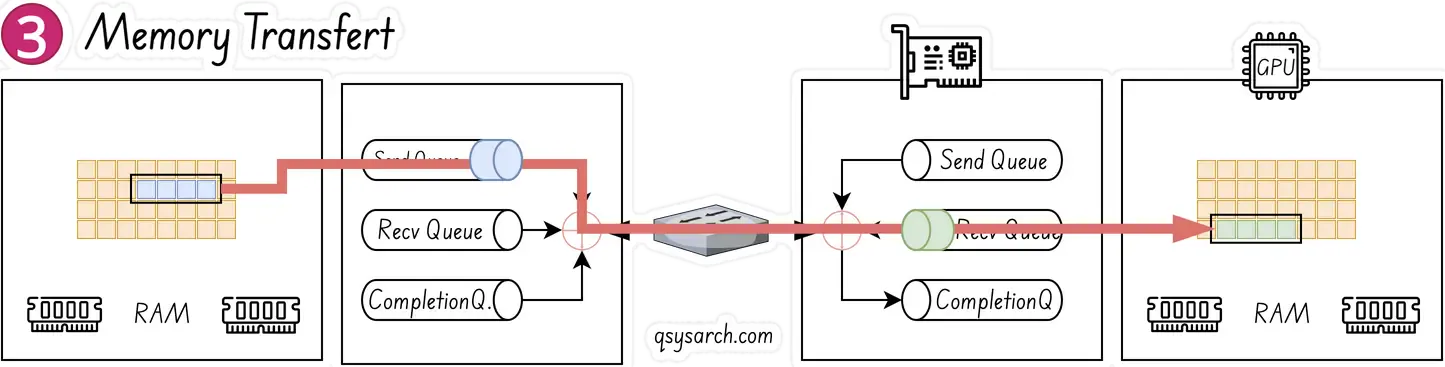
網路卡(這裡指的是支援 RDMA 的硬體網路卡,簡稱 RNIC)會持續輪詢傳送佇列中的 WQE(工作佇列請求),此流程無需 GPU 和 CPU 參與,僅影響 RNIC。一旦 CPU 推送 WQE,RNIC 就會在發送端將其消耗,並開始將資料從記憶體區域串流傳輸到接收端。當資料開始到達接收端時,RNIC 會從接收佇列中取得 WQE,以確定資料應該放置在何處。
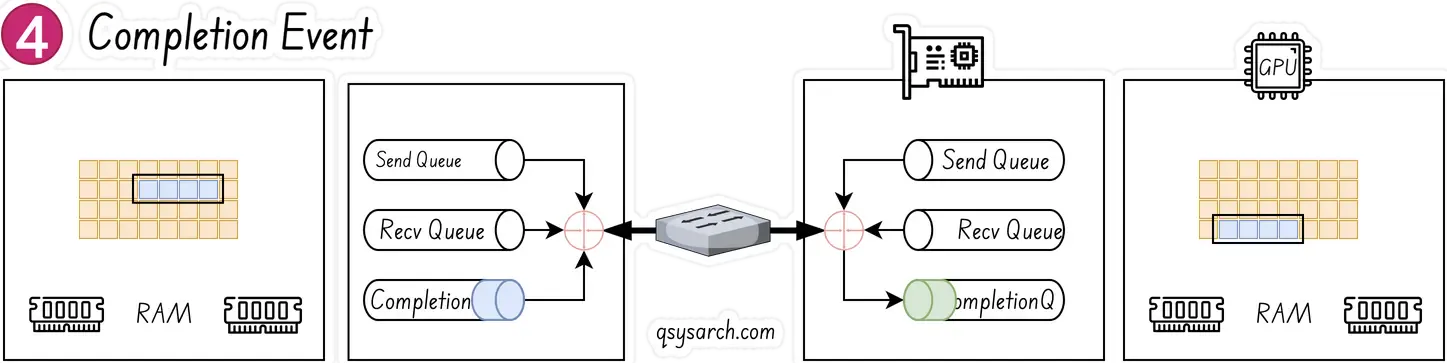
最後一步,當資料傳輸完成後,RNIC 會建立一個完成事件 CQE“COOKIE”,並將其放入完成佇列中。該事件表明事務已完成。每消耗一個 WQE,就會產生一個 CQE。
圖片來源
需要注意的是,只有發送方是主動的;接收方是被動的;被動方不發出任何操作,不使用 CPU 週期,也不會收到「讀取」或「寫入」的指示。
若要發出 RDMA 讀取或寫入請求,工作請求必須包含:
這意味著主動方必須事先取得被動方的位址和金鑰。
這部分內容是根據 Toni Pasanen 的 Network Times 的優秀作品。
客戶端計算節點(又稱「CCN」)上的應用程式透過向伺服器計算節點(又稱「SCN」)上的應用程式發送通訊請求(又稱「REQ」)訊息來建立連線。
REQ 訊息包含用於識別實體 RNIC 和連接埠的方法:
- 本機通訊識別碼(
LID)和通道適配器的全域唯一識別碼(本機 CA GUID)。本機 CA GUID 用於識別 RNIC,而本機通訊 ID 用於識別網路卡上的連接埠。
REQ 訊息還包含有關佇列對的所有元資訊。
本地 QP 編號 (0x1234 5678)
QP 服務類型(連線不穩定)
起始資料包序號 (PSN: 0x1882)
分區鍵值 (0x8012)
有效載荷大小(1024)。
REP 訊息確認 QP 元資料。最後,客戶端發送 Ready to Use (RTU) 訊息,向伺服器確認 QP 已建立。會話建立後,CCN 上的應用程式即可啟動 RDMA 寫入過程。

術語:
稍後會補充完整——WR 訊息沒有什麼特別值得一提的地方——如果您想了解更多詳情,請查看 Toni Pasanen 的 Network Times 和 [InfiniBandaiml-networking-part-i-rdma-basics.html) 和 [InfiniBandaiml-networking-part-i-rdma-basics.html) 和 [InfiniBandaiml-networking-part-i-rdma-basics.html) 和 [InfiniBandaiml-networking-part-i-rdma-basics.html) 和 [InfiniBandaiml-networking-part-i-rdma-basics.html) 和 [InfiniBandaiml-networking-part-i-rdma-basics.html) 和 [InfiniBandaiml-networking-part-i-rdma-basics.html) 和 InfiniBandaiml-networking-part-i-rdma-basics.html)傳輸協定。
RDMA UC(不可靠連線)不會執行重傳;相反,它依賴應用程式來管理可靠性並處理遺失的資料包,因為 UC 是一種無連線的不可靠資料封包服務。網路介面卡 (NIC) 會丟棄封包而不嘗試重傳,應用程式負責追蹤並重新要求遺失的資料。這與可靠連接 (RC) QP 不同,在 RC 中,網路硬體會處理重傳。那麼,RDMA UC 應用程式如何知道資料包是否遺失?
如果接收方偵測到序列中遺失了一個資料包,它需要通知發送方重新傳送該資料包。而如果用於通知發送方的資料包也遺失了,那麼情況就可能變得非常複雜。
- 逾時:發送方期望接收方確認已收到的資料包。如果接收方未確認,發送方將主動重新發送尚未收到確認的資料包。
我們是否總是需要在 RDMA QP 之上建立一個獨立的可靠性模組?不一定。在某些情況下,將遺失的資料包視為整個會話失敗的原因,而不是僅僅重發遺失的資料包,也是可以接受的。這種方法之所以有效,是因為底層網路通常足夠可靠,能夠提供極高的可靠性,例如萬億分之一的資料包才會出現一個錯誤。
RDMA UC 本身並不具備丟包偵測功能,因為它是一種不可靠的協議,所以丟包處理由應用層或更高層負責。 RDMA 的「無損」保證是透過優先權流控制 (PFC) 和明確壅塞通知 (ECN) 等底層網路技術實現的,這些技術從源頭上防止了丟包的發生。
此協定將RDMA資料段封裝到UDP資料段中,然後依序新增UDP頭部、IP頭部和乙太網路頭部,形成一個三層資料包。它可以透過乙太網路VLAN中的PCP欄位或IP頭部中的DSCP欄位進行分類。
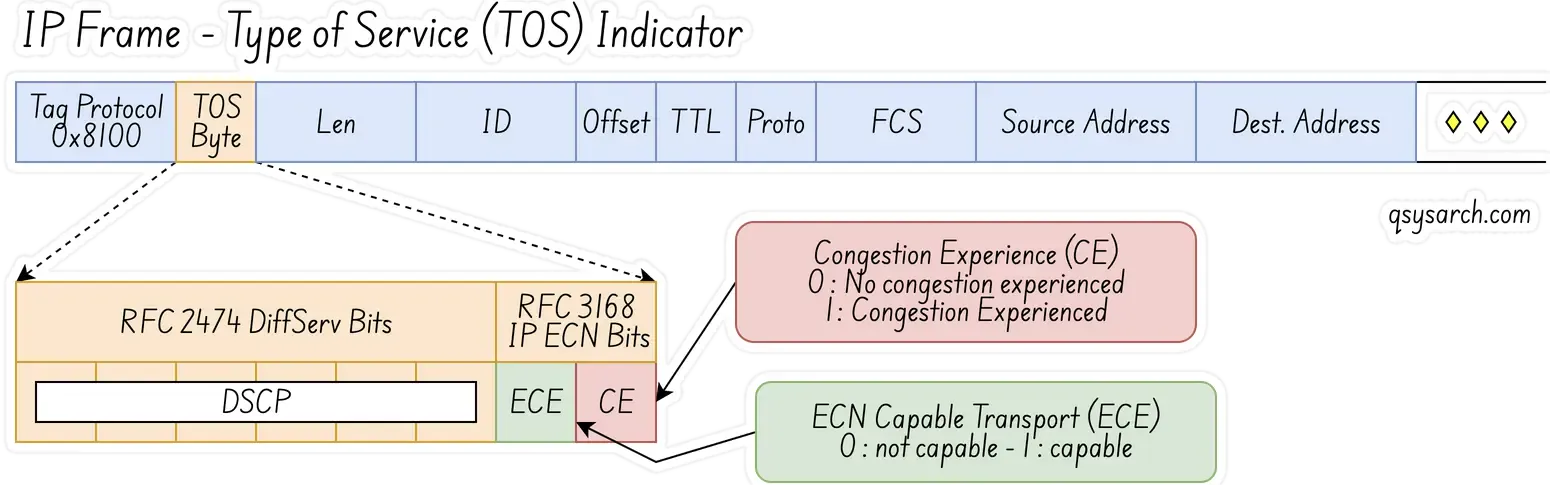
簡單來說,在二層網路中,PFC 使用 VLAN 中的 PCP 位元來區分資料流。在三層網路中,PFC 可以同時使用 PCP 和 DSCP,從而使不同的資料流能夠享受獨立的流量控制。目前大多數資料中心都使用三層網絡,因此使用 DSCP 比 PCP 更具優勢。
圖片來源
 PCIe 分析基於 Dolphin 的優秀論文:[SmartIO:透過 PCIe#right)PCIe 分析基於 Dolphin 的優秀論文:SmartIO:透過 PCIe網路實現零開銷設備共享(https://dl.acm.org/doi/pdf/10.1145/3462545)(https://www.dolphinics.com/)。
PCIe 的核心特性在於,它將裝置對應到與 CPU 和系統記憶體相同的位址空間,如右圖所示。由於這種映射關係的存在,CPU 可以像存取系統記憶體一樣讀寫設備記憶體。這通常被稱為記憶體映射 I/O (MMIO)。
初始化時,系統檢查 PCIe 樹時,會為每個裝置的記憶體區域預留一個記憶體位址範圍(由 BIOS 或核心分配)。然後,該預留位址會被寫入裝置的基址暫存器 (BAR)。一個設備最多可以有六個 BAR。
PCIe 使用訊息訊號中斷 (MSI) 而非實體中斷線。支援 MSI 的裝置會向 CPU 發送記憶體寫入請求,該請求使用系統提供的特定位址和有效載荷。 CPU 讀取此記憶體寫入請求,並使用該資訊觸發中斷。
MSI-X 是 MSI 的擴展,它最多支援 2048 個不同的中斷向量。其優點之一是,在多核心系統中,MSI-X 中斷可以針對特定的 CPU 核心。此外,不同的 MSI-X 向量可以指示不同類型的事件。
[1] 跨兩個 CPU 插槽的 GPU 間通訊:在傳統設計中,此路徑可能會遇到主機 CPU 和插槽間瓶頸,根據 CPU 間連結利用率的不同,速度可能限制在 25 GB/s 或更低。相較之下,基於 CX8 的最佳化設計可為叢集內所有 GPU 間通訊提供高達 50 GB/s 的 I/O 頻寬,因為 NCCL 會將所有流量直接路由到網路。
[2] GPU 與網路卡通訊:最佳化的架構在 2:1 GPU 與網路卡配置中為每個 GPU 提供 50 GB/s 的頻寬,無論 GPU 或主機系統是否支援 PCIe Gen5 或 Gen6。
[3] 透過同一 PCIe 交換器進行 GPU 到 GPU 的傳輸:配備 PCIe Gen6 的系統相比 Gen5 的頻寬提高了一倍,顯著加快了透過同一 PCIe 交換器進行的點對點 GPU 傳輸。
;
if (!pd) { /* error handling… */ }
struct ibv_cq_init_attr_ex cq_attr = {
.cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
分配一個緩衝區來保存數據,並將其註冊到 libibverbs:
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
類似套接字,具有非同步事件驅動介面。 (並非絕對必要,但提供了涵蓋多種傳輸方式的抽象層)首先創建一個「事件通道」:
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
雙方都解析到了伺服器位址:
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
被動端(SCN)建立並綁定監聽「ID」並監聽:
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
活動端建立ID並解析伺服器位址:
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
用於處理連線事件的事件循環:
struct rdma_cm_event *event;
while (true) {
err = rdma_get_cm_event(test.channel, &event);
switch (event->event) {
case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
}
rdma_ack_cm_event(event);
}
需要處理的重要事件:
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
填寫分散清單並將工作請求排隊到接收佇列:
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
填寫收集清單並將工作請求排隊傳送到佇列:
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
對完成佇列條目進行非阻塞檢查
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
end_flag = true;
/* consume cq->status, cq->wr_id, etc */
err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
事情開始變得……非常……令人困惑。 「GPUDirect RDMA」和RDMA之間有什麼關係?如同先前貼文中所提到的,Nvidia的官方文件明確指出兩者之間沒有任何關係!要理解其中的原因,我們需要追溯到它的起源,也就是它還是Mellanox的技術時期,大約在2016年。以下是當時的規範原文:
GPU-GPU 通訊領域的最新進展是 GPUDirect RDMA。這項新技術在 GPU 記憶體和 NVIDIA HCA/NIC 設備之間建立了一條直接的 P2P(點對點)資料路徑。這顯著降低了 GPU-GPU 通訊延遲,並完全卸載了 CPU,使其不再參與網路上的所有 GPU-GPU 通訊。
根據 GPUNetIO 規範,啟用網卡-GPU內存交互需要執行以下操作:
若要使網路卡能夠使用 GPU 記憶體傳送和接收資料包,請載入 NVIDIA 核心模組 nvidia-peermem,該模組通常包含在 CUDA 工具包安裝包中。
GPU封包處理網路應用可分為兩個基本階段:
在 CPU 的安裝設定階段,應用程式必須:
因此,DOCA GPUNetIO 由兩個函式庫組成:
這是接收和分析資料包頭的最通用用例。為了回應 100Gb/s 的傳入網路流量,負責 UDP 流量的 CUDA 核心將一個包含 512 個 CUDA 執行緒的 CUDA 區塊(文件[gpu_kernels/receive_udp.cu](https://github.com/NVIDIA-DOCA/doca-samples/blob/eaee12419fab0b60baea613940 21a762440dd762/applications/gpu_packet_processing/gpu_kernels/receive_udp.cu#L41C17-L41C40))專門分配給一個不同的乙太網路UDP 接收隊列。
資料路徑循環是:
- 使用名為
doca_gpu_dev_eth_rxq_receive_block 的 GPUNetIO 函式接收資料包。
每個 CUDA 執行緒處理接收到的資料包的一個子集。
取得包含資料包的 DOCA 緩衝區。
分析封包有效載荷,以區分 DNS 封包與其他通用 UDP 封包。
清除資料包有效載荷,確保舊資料包不會再次分析。
每個 CUDA 區塊使用 DOCA GPUNetIO 信號量向 CPU 執行緒傳送統計資訊。
CPU 執行緒檢查信號量以取得統計資料並將其列印到控制台。
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
struct doca_gpu_eth_rxq *rxq0,
struct doca_gpu_eth_rxq *rxq1,
struct doca_gpu_eth_rxq *rxq2,
struct doca_gpu_eth_rxq *rxq3,
int sem_num,
struct doca_gpu_semaphore_gpu *sem0,
struct doca_gpu_semaphore_gpu *sem1,
struct doca_gpu_semaphore_gpu *sem2,
struct doca_gpu_semaphore_gpu *sem3)
{
__shared__ uint32_t rx_pkt_num;
__shared__ uint64_t rx_buf_idx;
__shared__ struct stats_udp stats_sh;

doca_error_t ret;
struct doca_gpu_eth_rxq *rxq = NULL;
struct doca_gpu_semaphore_gpu *sem = NULL;
struct doca_gpu_buf *buf_ptr;
struct stats_udp stats_thread;
struct stats_udp *stats_global;
struct eth_ip_udp_hdr *hdr;
uintptr_t buf_addr;
uint64_t buf_idx = 0;
uint32_t lane_id = threadIdx.x % WARP_SIZE;
uint8_t *payload;
uint32_t sem_idx = 0;

if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

if (threadIdx.x == 0) {
DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}
__syncthreads();

while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
stats_thread.dns = 0;

/* No need to impose packet limit here as we want the max number of packets every time */
ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
/* If any thread returns receive error, the whole execution stops */
if (ret != DOCA_SUCCESS) { ... }

if (rx_pkt_num == 0) continue;

buf_idx = threadIdx.x;
while (buf_idx < rx_pkt_num) {
doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
raw_to_udp(buf_addr, &hdr, &payload);

if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

/* Double-proof it's not reading old packets */
wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
buf_idx += blockDim.x;
}
__syncthreads();

for (int offset = 16; offset > 0; offset /= 2) {
stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
__syncwarp();
}

if (lane_id == 0) {
atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
}

__syncthreads();

if (threadIdx.x == 0 && rx_pkt_num > 0) {
ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
if (ret != DOCA_SUCCESS) { ... }

DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
__threadfence_system();

sem_idx = (sem_idx + 1) % sem_num;

DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}

__syncthreads();
}
}
RDMA 在哪裡?
在上面的例子中,實際上並沒有用到 RDMA。 GPUNetIO 只是讓 GPU 直接處理封包。它與 RDMA 的唯一相似之處在於,資料包透過直接 DMA 傳輸從網卡傳輸到 GPU,跳過了 CPU 記憶體。
在結束之前,還有一個令人困惑的地方:DOCA RDMA。在上一節中,我們了解了 DOCA GPUNetIO。但是 DOCA RDMA 是什麼?它與我們之前了解的「ibv」API 有何不同?
答案很簡單:DOCA RDMA 是 NVIDIA 的軟體框架,用於使用 CPU 或 GPU 執行 RDMA 操作。 IBV 是傳統的底層 InfiniBand Verbs 函式庫,它是用於對 InfiniBand 和 RoCE 硬體進行程式設計的標準 API 的一部分。關鍵區別在於,DOCA RDMA 是一個更高層級、更全面的 SDK,它基於 Verbs 介面的基本功能,實現了 GPU 加速,並將 RDMA 任務從 CPU 卸載到 GPU。
例如,這是發送 RDMA 封包的[代碼](https://github.com/NVIDIA-DOCA/doca-samples/blob/eaee12419fab0b60baea61394021a762440dd762/samples/doca_rdma/rdma_sendma/rdma_send/rdma/rdmadoca_rdma/rdma_send
doca_error_t rdma_send(struct rdma_config *cfg)
{
struct rdma_resources resources = {0};
union doca_data ctx_user_data = {0};
const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
doca_error_t result, tmp_result;

/* Allocating resources */
result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
doca_rdma_cap_task_send_is_supported,  &resources);

result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
rdma_send_error_callback, NUM_RDMA_TASKS);

result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

/* Include the program's resources in user data of context to be used in callbacks */
ctx_user_data.ptr = &(resources);
result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

/* Create DOCA buffer inventory */
result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

/* Start DOCA buffer inventory */
result = doca_buf_inventory_start(resources.buf_inventory);

/* Start RDMA context */
result = doca_ctx_start(resources.rdma_ctx);

/*
* Run the progress engine which will run the state machine defined in
* rdma_send_state_change_callback(). When the context moves to idle, the context change
* callback call will signal to stop running the progress engine. */
while (resources.run_pe_progress) {
if (doca_pe_progress(resources.pe) == 0)
nanosleep(&ts, &ts);
}

// ... cleanup
}
我們在上一節中探討了RDMA的各個面向。 RDMA的最終目標是在CPU、GPU和量子控制堆疊之間實現資料傳輸,延遲僅為幾微秒。需要傳輸的資訊量很大,包括I/Q軟讀出資料、控制脈衝樣本(「波」),以及脈衝的參數配置(通常在神經網路的上下文中)。此外,還需要傳輸一些更簡單的訊息,例如邏輯量子位元的伴隨式,以及遠端呼叫計算單元中的QEC解碼器。在後一種情況下,我們可以簡單地稱之為「遠端過程呼叫」(RPC)。
好消息是,關於基於 RDMA 的 RPC 的文獻資料非常豐富,例如 mRPC,該文獻基於 100 Gbps Mellanox Connect-X5 RoCE 網路卡,給出了非常有趣的延遲數據。論文中存在一些矛盾之處,例如它指出“在 RDMA 下,mRPC 在中位數延遲和尾部延遲方面分別比 eRPC 快 1.3 倍和 1.4 倍”,而表格卻顯示 eRPC 比 mRPC 更快。但目前,我們可以假設這些延遲數據在實驗上是合理的。
 更有趣的是,mRPC 的後續論文[https://www.usenix.org/system/files/atc24-ma.pdf](https://www.usenix.org/system/files/atc24-ma.pdf](https://www.usenix.org/system/files/XLc24-ma.pdf](https://www.usenix.org/system/files/XLc24-ma. RPC,他們稱之為「HydraRPC」。數據本身就說明了一切,請參見右側表格。這裡需要提出的問題是,五年後情況會如何?在我看來,NVLink 也是一個非常有吸引力的機會…
# 結論
瞧,我花了更長時間才完成這份備忘錄,不過我覺得這有助於我更能理解。我認為 RDMA 和 GPUDirect 之間的混淆源於這樣一個事實:RDMA 最初是由 Mellanox 開發的,純粹是為了改善網路。 Mellanox 被 Nvidia 收購後,RDMA 擴展到可以「連接」到 GPU,但這種擴展並非最初的設計理念,最終成為了 DOCA 生態系統的附加組件。

References:
DrawIO diagrams used in this memo: