在為 NVIDIA GPU 編譯程式時,CUDA 通常被視為參考編譯框架。但編譯器究竟是如何運作的呢?編譯器在為 GPU 建立「執行檔」時需要產生哪種指令集架構 (ISA)?編譯器究竟是如何運作的?它使用哪種架構來產生可以從 CPU 啟動並在 GPU 上執行的程式碼?
這份週日早晨備忘錄旨在對NVIDIA GPU編譯器架構進行高階概述。內容涵蓋GPU指令集、CUDA框架中的NVCC編譯器,以及最終面向GPU指令集的其他架構。
當針對 GPU 等裝置進行程式設計時,我們需要一套指令集。以 NVIDIA 為例,該裝置是串流多處理器 (SM),如右圖所示。圖中值得注意的是,它包含許多並發單元,例如 IN32 加法器、特殊功能單元、GEMM+++ 張量核心等,編譯器需要確保以最高效的方式(管線式)使用這些單元(效率定義為最小化空閒時間)。
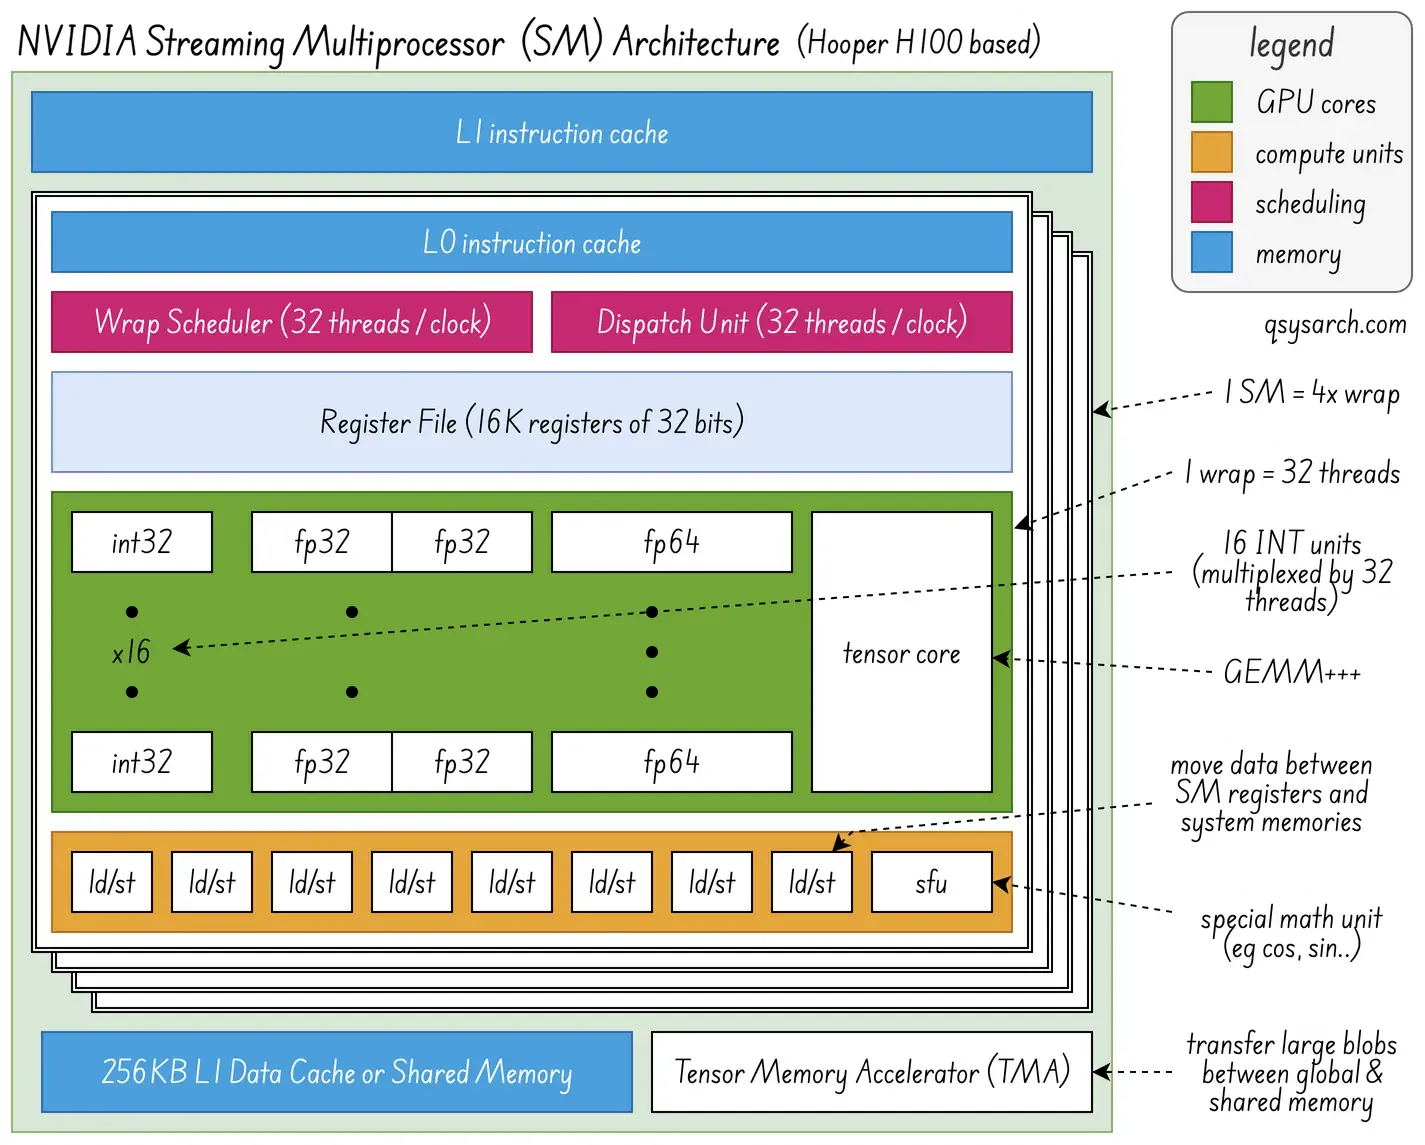
以下是所使用的術語:
機器代碼:指令的緊湊二進位表示。
NVIDIA GPU 有兩種指令集架構 (ISA):
假設我們要編譯這個內核:
__global__ void normalizeVector(float* x, float* y, float* z, int n)
{
int i = blockIdx.x * blockDim.x + threadIdx.x;

float vx = x[i], vy = y[i];
float len2 = vx*vx + vy*vy;
float invLen = rsqrtf(len2);  // Use SFU fast reciprocal square root
z[i] = invLen; // Normalized length
}
這裡的神奇之處在於,rsqrtf 應該被分發到 SFU 管道。它是如何運作的呢? _float invLen = rsqrtf(len2);_ 這行程式碼會被轉換成 PTX 格式的 rsqrt.approx.ftz.f32,然後轉換成 SASS 格式的 MUFU.RSQ,如下圖所示(來自[godbolt](https://godbolt.org/#g:!((g:!((g:!((h:codeEditor,i:(filename:'1',fontScale:14,fontUsePx:'0',j:1,lang:cuda, selection:(endColumn:2,endLineNumber:15,positionColumn:2,positionLineNumber:15,selectionStartColumn:2,selectionStartL ineNumber:15,startColumn:2,startLineNumber:15),source:’global+void+normalizeVector(float*+x,+float*+y,+float*+z,+ int+n)%0A%7B%0A++++int+i+%3D+blockIdx.x++blockDim.x+%2B+threadIdx.x%3B%0A%0A++++float+vx+%3D+x%5Bi%5D%3B%0A++++float+vx+%3D+x%5Bi%5D%3B%0A++++float +vy+%3D+y%5Bi%5D%3B%0A++++float+len2+%3D+vxvx+%2B+vyvy%3B%0A%0A++++//+使用+SFU+快速+倒數+平方+根%0A++++flo at+invLen+%3D+rsqrtf(len2)%3B+%0A%0A++++//+標準化+向量%0A++++x%5Bi%5D+%3D+vx++invLen%3B%0A++++y%5Bi%5D+%3D+ vy+*+invLen%3B%0A%7D’),l:‘5’,n:‘0’,o:‘CUDA+C%2B%2B+source+%231’,t:‘0’)),k:33.333333333333336,l:‘4’,n’’n,’’,0:0:’,’’,0:0’,’n,’’,0:’,0:’,0:’,0:’,0:’,0:’,0:’,0:’,0:’,0:’,0:’,0:’,0:’,0:’s 0’),(g:!((h:compiler,i:(compiler:nvcc130u2,filters:(b:‘0’,binary:‘1’,binaryObject:‘1’,commentOnly:‘0’,debugCalls:‘1’, demangle:‘0’,directives:‘0’,execute:‘1’,intel:‘0’,libraryCode:‘0’,trim:‘1’,verboseDemangling:‘0’),flagsViewOpen:‘1’,f ontScale:14,fontUsePx:‘0’,j:1,lang:cuda,libs:!(),options:’-arch+sm_90+-use_fast_math+-O3’,overrides:!(),selection:(en dColumn:1,endLineNumber:1,positionColumn:1,positionLineNumber:1,selectionStartColumn:1,selectionStartLineNumber:1,sta rtColumn:1,startLineNumber:1),source:1),l:‘5’,n:‘0’,o:’+NVCC+13.0.2+(Editor+%231)’,t:‘0’)),k:33.333333333333336,l:’ ,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:device,i:(compilerName:‘NVCC+13.0.2’,device:‘SASS+(sm_90)’,editorid:1,fontScale:14,fon tUsePx:‘0’,j:1,selection:(endColumn:6,endLineNumber:21,positionColumn:1,positionLineNumber:1,selectionStartColumn:6,s electionStartLineNumber:21,startColumn:1,startLineNumber:1),treeid:0),l:‘5’,n:‘0’,o:‘Device+Viewer+NVCC+13.0.2+(Edito r+%231,+Compiler+%231)’,t:‘0’)),k:33.33333333333333,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’)),l:‘2’,n:‘0’,0:’’,‘’t.
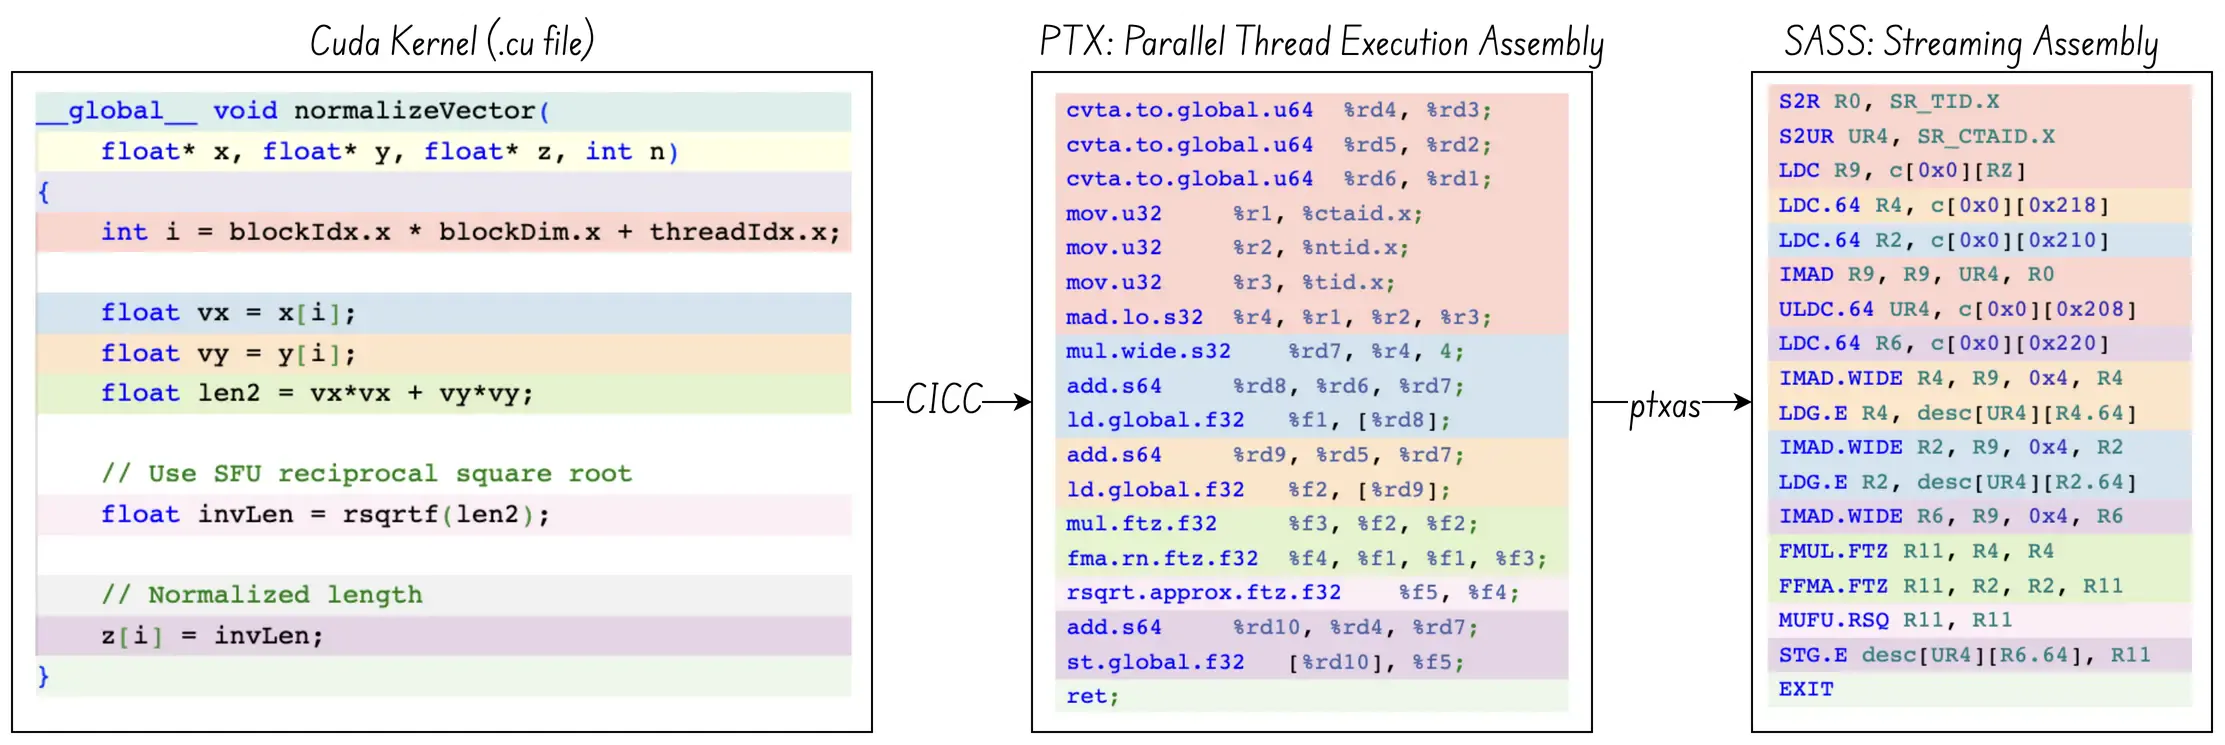
MUFU 代表多功能單元,也稱為 SFU,即特殊功能單元。 MUFU.RSQ 將暫存器傳送到 SFU 單元的平方根「管線」。 SASS 彙編中還有許多其他指令,例如 FMUL(融合乘法)或 FFMA(融合乘加法),這些指令會被分派到張量核心單元。分派單元負責將指令傳送到正確的管線單元。
有三點值得注意:
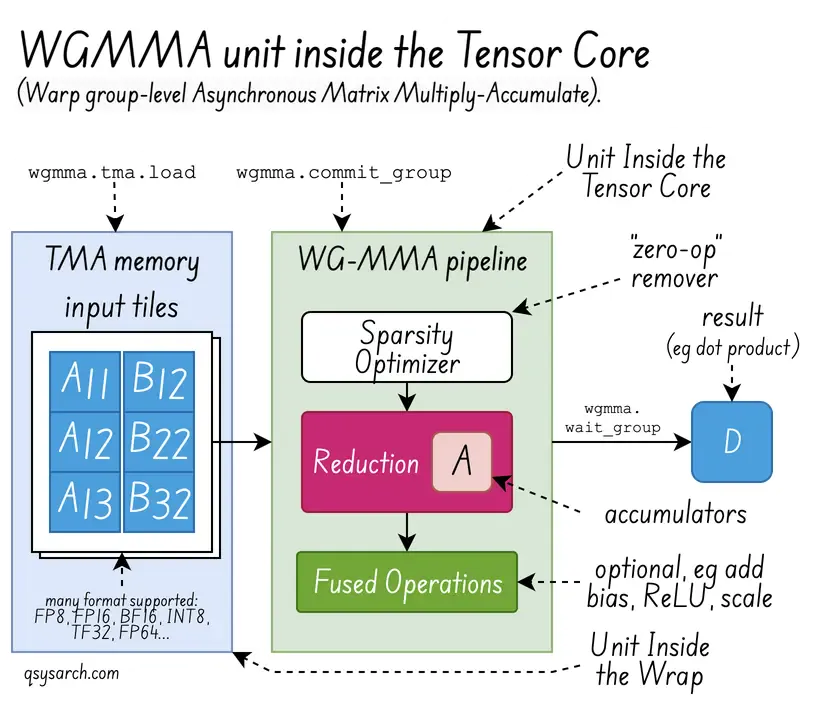
非同步 Warpgroup 等級矩陣乘加指令 (WGMMA) 非常強大。您可以閱讀 NVIDIA 文件 以及 Aleksa Gordić 的了解更多內容 博客/www.
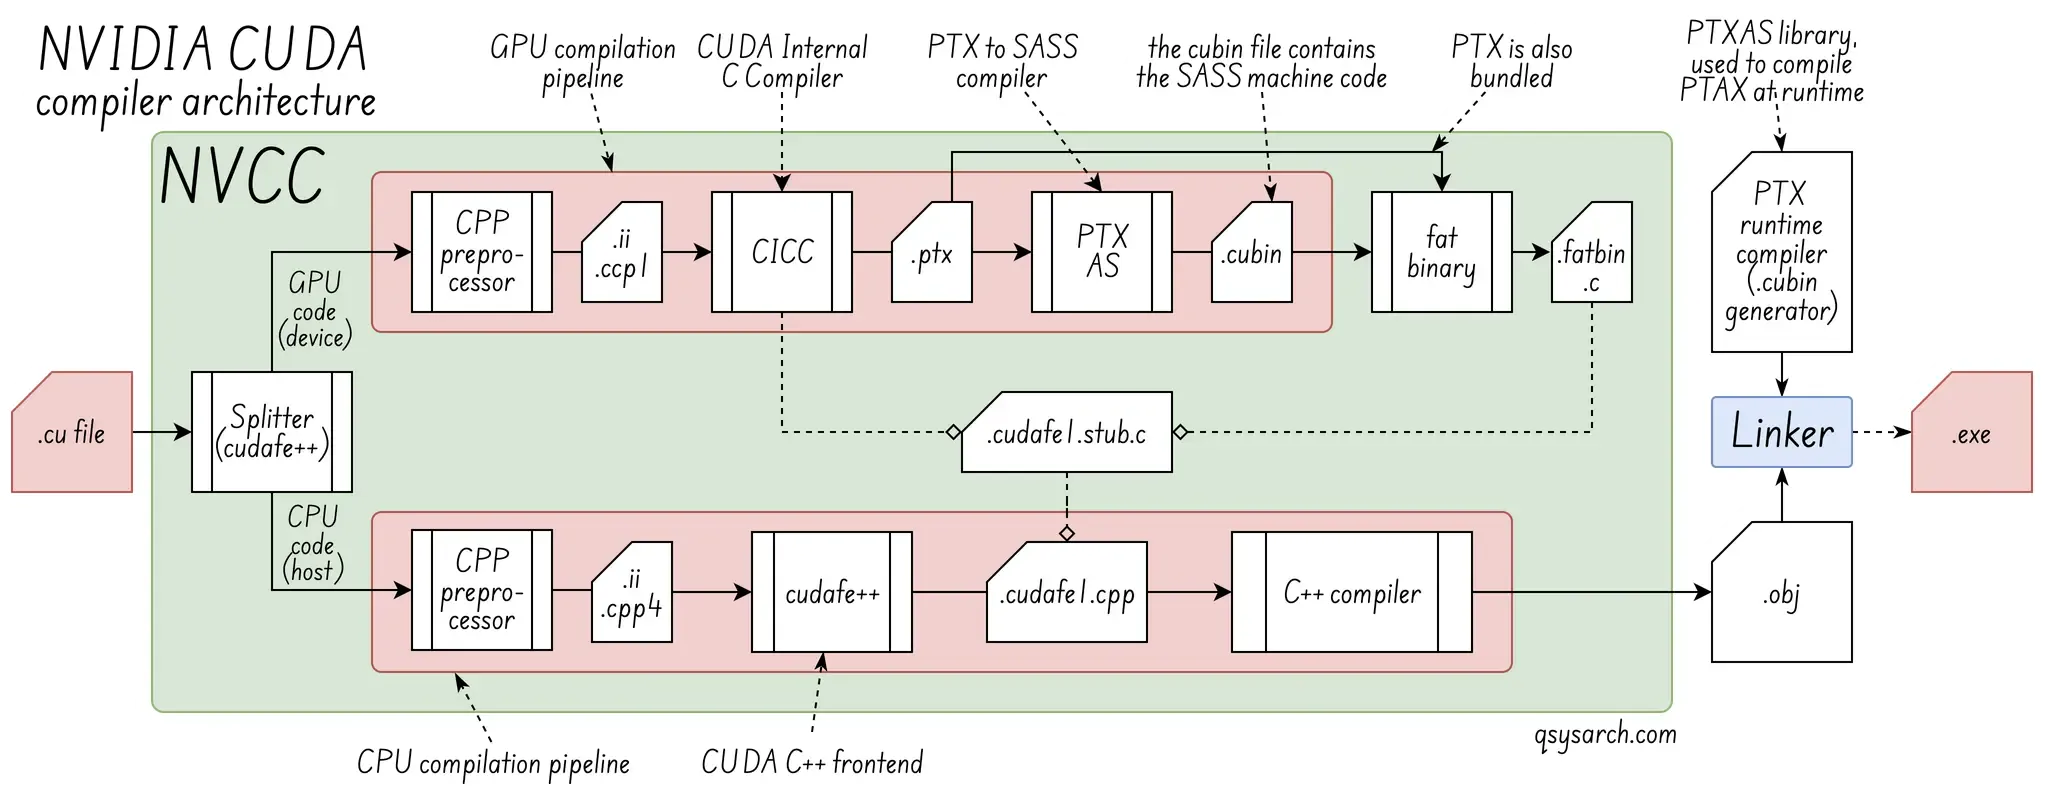
現在我們對GPU底層指令集架構(ISA)有了更多了解,接下來讓我們看看如何將高階C++核心編譯成SASS。我們知道,用來將CUDA核心(.cu檔)轉換為PTX的編譯器叫做NVCC。
那麼,NVCC 和 LLVM 有什麼區別呢? NVCC 是一個專用的編譯器驅動程序,它使用開源的 LLVM 編譯器基礎架構作為後端。相較之下,LLVM 是一個靈活的編譯器框架,而不是像 NVCC 那樣即插即用的編譯器。
驅動程式:NVCC 是一個驅動程序,用於管理 CUDA C/C++ 程式碼的編譯過程。它將主機(CPU)代碼與設備(GPU)代碼分離。
工具鏈:NVCC 是一個工具鏈,它使用主機 C++ 編譯器(例如 Linux 上的 GCC/Clang)來編譯 CPU 程式碼,並使用 NVIDIA 專用的內部編譯器(例如 CICC)來編譯 GPU 程式碼(PTX 和 SASS)。
胖二進位檔案:NVCC 通常會產生“胖二進位檔案”,其中包含主機可執行檔和編譯後的 GPU 程式碼,並且通常會有多個版本以適應不同的 GPU 架構。
框架:LLVM 是一套免費、開放、模組化和可重複使用的編譯器技術、函式庫和工具的集合,旨在建立各種編譯器和語言工具鏈。
中間表示 (IR):LLVM IR 是一個與機器無關的“中間層”,它充當前端(C++、Go…)和 ISA 後端(x86、ARM…)之間的通用連接。
最佳化:LLVM 最佳化器會對 IR 應用各種效能增強(如循環展開和死程式碼消除),而不管原始語言或目標架構如何。
值得注意的是,LLVM 可以編譯 CUDA:Clang 前端(LLVM 專案的一部分)可以使用 LLVM PTX 後端 處理 CUDA 程式碼,而無需 nvcc 驅動程式。
Triton 語言是一種功能強大的基於 Python 的領域特定語言 (DSL),旨在幫助創建高級的_向量化_演算法,這些演算法可以編譯成高效的_並行化_程式碼,以用於 GPU 目標。
這是一個最簡單的核心範例,它從一個記憶體區塊載入資料並將其寫入另一個記憶體區塊。 offsets 的值為 [pid*BLOCK_SIZE….(pid+1)*BLOCK_SIZE-1]。此程式碼片段中未顯示的「魔法」在於,Triton 可以有效率地操作向量 v,例如執行數學運算。
import triton.language as tl

@triton.jit
def move_kernel(in_ptr, out_ptr, BLOCK_SIZE: tl.constexpr):
pid = tl.program_id(axis=0)
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
v = tl.load(x_ptr + offsets)
tl.store(output_ptr + offsets, v)
Triton 不僅限於一維向量,它還可以使用張量處理更高維度的資料。例如:
import triton.language as tl

@triton.jit
def load_2d_tensor( input_ptr, output_ptr,
stride_row, stride_col,  # Stride of the input tensor (elements per row, elements per column)
M , N , # Number of rows and columns
BLOCK_SIZE_M,BLOCK_SIZE_N, # Block size for rows and columns
):
# X and Y tile position
pid_m, pid_n = tl.program_id(axis=0), tl.program_id(axis=1)
# Ptr in memory based on the stride
base_ptr = input_ptr + (pid_m * BLOCK_SIZE_M * stride_row) + (pid_n * BLOCK_SIZE_N * stride_col)
# Offsets for X and Y indices
offs_m, offs_n = tl.arange(0, BLOCK_SIZE_M), tl.arange(0, BLOCK_SIZE_N)
offsets_2d = (offs_m[:, None] * stride_row) + (offs_n[None, :] * stride_col)
# 2D loading ...that's magic!
loaded_2d_tensor = tl.load(base_ptr + offsets_2d)
return loaded_2d_tensor
與 CUDA 相比,Triton 可以被視為更高層次的抽象,專門用於建立神經網路核心(得益於張量塊方法),並且可以產生高效的向量化並行 GPU 程式碼。 Triton 也支援多個後端 GPU:
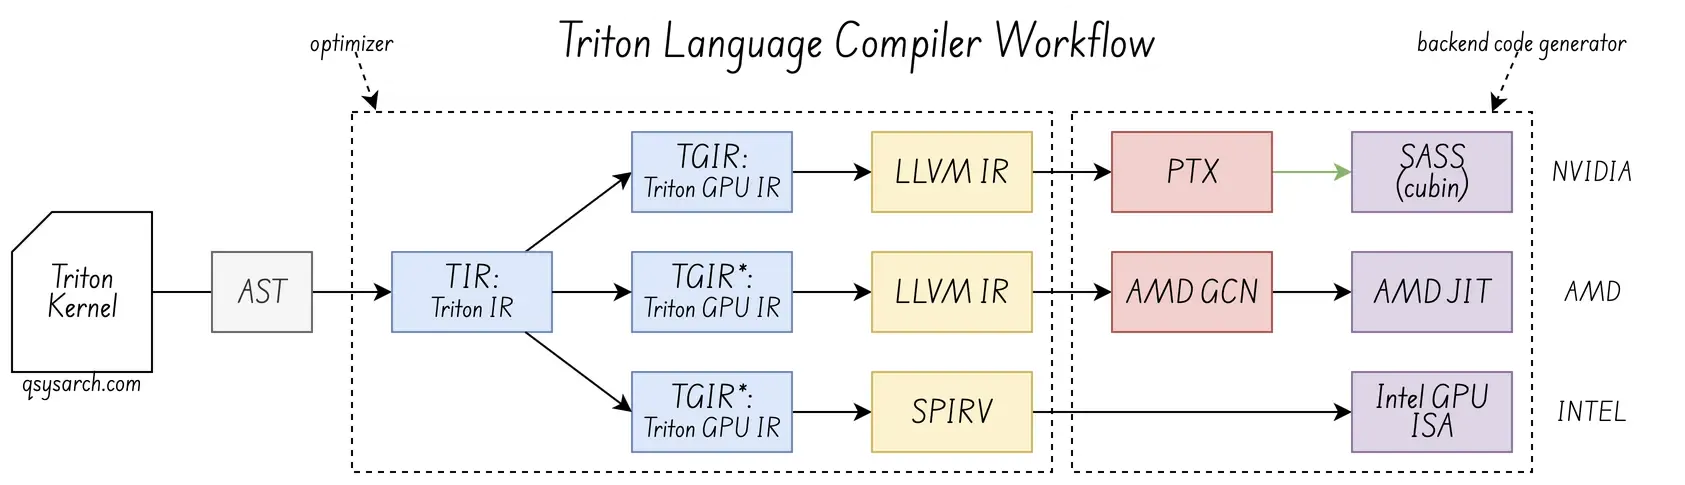
Triton 不會使用自己的語言解析器。相反,它依賴 Python 的運行時和抽象語法樹 (AST),然後將該 AST 轉換為其自身的中間表示形式 TIR 和 TGIR,最後產生 GPU 程式碼。 CUDA 後端編譯器和 Triton 前端編譯器之間的連接是通用的 LLVMIR,對於 Intel GPU,它基於 SPIRV(儘管我不確定到 SIR 是否直接降維
我寫的是“向量化演算法”,儘管其核心概念更側重於分塊的、區塊級模型:
 分塊是主要機制。 Triton 的思考模型圍繞著對小型、靜態形狀的多維子數組(或稱為「瓦片」)進行程式設計操作展開,編譯器會自動將這些操作並行化到 GPU 核心上。
向量化,即在一條指令中載入/儲存多個資料元素,是一種最佳化:編譯器將其作為一項關鍵的內部最佳化策略,以在底層硬體上高效地實現這些資料區塊。這個概念與嵌套分塊策略(見右圖)一致,後者旨在將資料塊分解為微塊,最終分解為奈米塊,以盡可能緊密地適應機器的計算能力和記憶體層次結構。
讓我們來看看 Triton 語言的高階指令 tt.load 是如何被降級為 SASS 的。 (註:以下程式碼為偽代碼,實際運作效果可能有所不同。)
在解析 Python AST 之後,初始階段是機器無關的 Triton IR(TIR,一種 MLIR 方言)。在這個階段,對 tile 定義了一個 tt.load 操作。 tt.load 操作是一個進階的、未經最佳化的指令,用於將整個 tile 載入到記憶體中。 tile 可以是單一數組,也可以是二維數組,甚至是任意維度的數組。
// simplified, illustrative TTIR fragment for 2 dimensionnal array
// load of 32 bits floating point values (without masks)
%ptrs = ...              : tt.tensor<MxN, ptr<global f32>>
%vals = "tt.load"(%ptrs) : (tt.tensor<MxN, ptr<global f32>>) -> tt.tensor<MxN, f32>
對張量指標和資料區塊(瓦片)執行進階 tt.load 操作。第一個輸入參數 %ptrs 是由 tensor 表示的 n 維張量陣列。 <MxN, ptr它傳回一個相同維度的張量,但傳回的是值而不是指向值的指標。
實際上,tt.load 還接受一個遮罩和一個預設值參數,這是從記憶體邊界讀取資料所必需的(以防向量維度未按步長對齊)。
%ptrs = ... : tensor<MxN, ptr<global f32>>
%mask = ... : tensor<MxN, i1>         // in-bounds mask (optional)
%fallback = constant 0.0 : f32
%vals = "tt.load"(%ptrs, %mask, %fallback) : (tensor<MxN, ptr<global f32>>, tensor<MxN, i1>, f32) -> tensor<MxN, f32>
在下一階段,Triton-GPU IR 用於將通用張量佈局轉換為特定於硬體的佈局,尤其是在記憶體佈局以及跨線程和線程束的分配方面。換句話說,TGIT 將 n 維加載拆分為更易於降維到 LLVM 的每個執行緒向量載入操作。
// TGIR (illustrative)
%vec_ptr = tt.get_contiguous_vector_ptr %ptrs, vec_len=4
%vec_vals = ttg.load.global.v4f32 %vec_ptr  // a vectorized 4-wide global load
%vec_vals_cast = f32x4 -> f32  // unpack to tensor<MxN, f32> shape
Triton-GPU IR 隨後被轉換為以 LLVM IR 表示的執行緒級指令。這種底層 IR 能夠很好地表示最終的機器指令,並使用標準的 LLVM 操作,例如指標運算、記憶體載入和同步原語。張量抽象基本上被移除,取而代之的是每個執行緒的獨立記憶體存取操作。
// Example LLVM IR snippet (conceptual)
%thread_ptr = getelementptr inbounds float, ptr %base_ptr, i64 %thread_offset
%value = load float, ptr %thread_ptr, align 4
表示:圖塊載入被分解成一系列單獨的載入指令,每個執行緒的特定資料元素都使用指標運算,如果使用共享記憶體作為暫存區,則可能還會進行共享記憶體操作。
當 LLVM 後端面向 NVIDIA GPU 時,下一步是將目標平台降低到 PTX。 LLVM 載入指令直接對應到對應的 PTX 載入指令。
// Example PTX snippet
ld.global.f32 %r1, [%thread_ptr]; // Load from global memory
// Or if staged via shared memory:
ld.shared.f32 %r1, [%shared_ptr];
最後,NVIDIA 驅動程式編譯器 (ptxas) 將 PTX 組譯程式碼轉換為 SASS(串流彙編),即 GPU 核心實際執行的本機機器碼。如前所述,此步驟通常以即時編譯 (JIT) 方式完成。
// Example SASS snippet (conceptual, might involve specific opcodes)
MOV R1, ...
LDG.E.32 R1, [R0]; // Load from global memory
值得注意的是,CUDA 是為 NVIDIA GPU 產生機器碼的一種非常便捷的方式。 Triton 將 PTX 降級為 SASS 時會使用 CUDA。降級到 PTX 的過程是透過 LLVM IR 完成的,但需要 CUDA 工具包提供的程式庫(例如 libdevice.bc)。
DeepSeek 與 Triton:手寫程式碼 vs 自動產生程式碼。 DeepSeek 採用了另一種方法,選擇手動優化 PTX:它手工編寫了自訂的 PTX 核心輔助程序,將 PTX 視為 GPU 的彙編語言。 DeepSeek 沒有依賴通用編譯器來產生這種高度非標準的專用程式碼。相反,Triton 作為一種通用語言,使用標準的 LLVM 編譯器後端和 NVPTX 目標,自動將其中間表示(Triton-IR/MLIR)轉換為最佳化的 PTX 組譯程式碼。
 DeepSeek 封裝器位於csrc/kernels/utils.cuh,使用了mbarrier.try_wait 指令
這為什麼重要?引用DeepSeek技術報告中的一段話:「具體來說,我們(DeepSeek)採用了定制的PTX(並行線程執行)指令,並自動調整通信塊大小,這顯著降低了L2緩存的使用率以及對其他優端幹擾的效率。在我看來,這意味著還有進一步優化的空間,不僅在LLVM層面,而且在更好地利用裸機ISA方面也是如此!這絕對是雙贏!
# 結論
瞧,這份備忘錄又一次比預期花了更多時間。但這就是介紹 Cuda-Q 架構之前非常必要的前期研究工作。完成後我會更新這篇文章。
 (圖片來源:LLVM MOS)
# 參考
本備忘錄使用的DrawIO圖表: