我最近接觸到了容量與效率工程的概念,這是一門旨在以最優方式設計和運行系統的學科。它是系統架構的關鍵支柱,在規模至關重要的領域(例如量子運算系統)尤其重要。
簡言之,產能與效率工程是一門優化生產的科學或學科。它透過平衡最大產量(產能)與資源消耗(效率)來實現這一目標。
容量與效率工程(CEE)的優點在於它是一個定義明確的領域,文獻資料豐富,並有完善的工程實務體系支撐。本備忘錄旨在提煉CEE中使用的一些關鍵概念。
容量與效率工程建立在三大核心支柱之上:可觀測性、建模和規劃。
可觀測性
造型
規劃
最終目標是製定一個能夠透過模型有效模擬的計劃。該模型應透過實證觀察進行驗證。透過模擬成長、識別瓶頸並進行策略性資源分配,該計劃可以防止資源過載或利用不足,從而確保系統最佳運作。
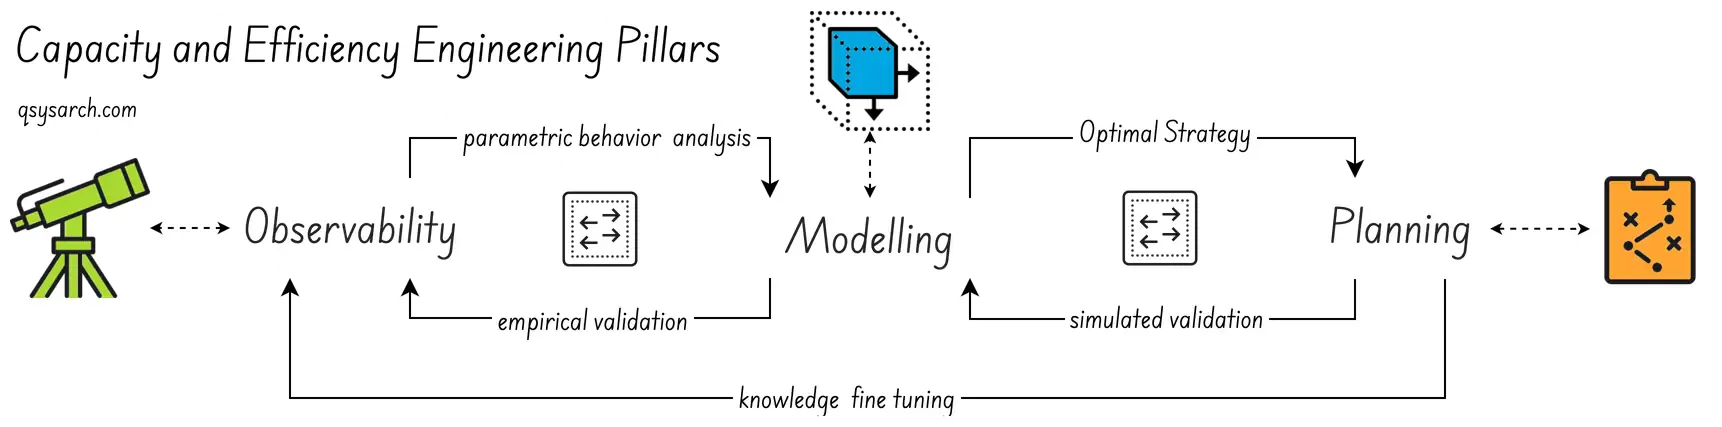
要注意的是,系統資源可以是任何事物,包括CPU、記憶體等IT資源,也可以是人員或設備。事實上,CEE可以應用於各個領域。例如,它可以幫助優化專案管理中的人員配置,或降低基礎架構管理中的雲端託管成本。
可觀測性是對系統進行實證分析。在電腦系統中,日誌經常與可觀測性混淆,但它們只是其中的一部分。例如,OpenTelemetry標準涵蓋了多種可觀測的「訊號」:日誌、指標、追蹤和冗餘資訊。對於電腦工程和工程(CEE)而言,有效的可觀測性應提供:
關鍵在於能夠對系統進行事後分析,無論在高負載、維護或空閒期間,都必須進行分析。詳細了解發生了什麼、何時發生以及為什麼發生至關重要。如果沒有這些可觀察的數據,就無法確定係統故障的根本原因。
當然,要收集完整系統的全部觀測資料並非易事:觀測成本可能非常高昂,甚至可能具有破壞性(例如在量子運算中,測量系統會改變其狀態-這種現象稱為觀測者效應)。這意味著,僅僅是觀測系統這一行為本身就可能改變其行為並降低其性能。解決這個問題的方法是採樣(僅收集部分事件的數據,而非全部事件)。其核心思想是將取樣率(資料收集頻率)作為可調的系統參數,如下圖所示(圖片來源:OpenTelemetry)。

對於非計算系統而言,有效的可觀測性能夠解釋專案延期的原因。可觀測資料很可能是 ISO9001 標準規定的技術和非技術文檔,這些文檔解釋了專案每個階段所做的可追蹤決策。
在可觀測性建立之後,就可以開始理解系統的分析參數行為。這種行為構成了下一個支柱的基礎:它可以被描述並轉換為參數模型。下一步是明確在給定一組參數或條件的情況下,這樣的模型需要提供什麼:
關鍵在於模擬系統行為並觀察其在不同運行條件下的性能。由於模型包含了資源成本,因此可以展現這些條件下的成本權衡。這些資訊對於規劃階段至關重要。
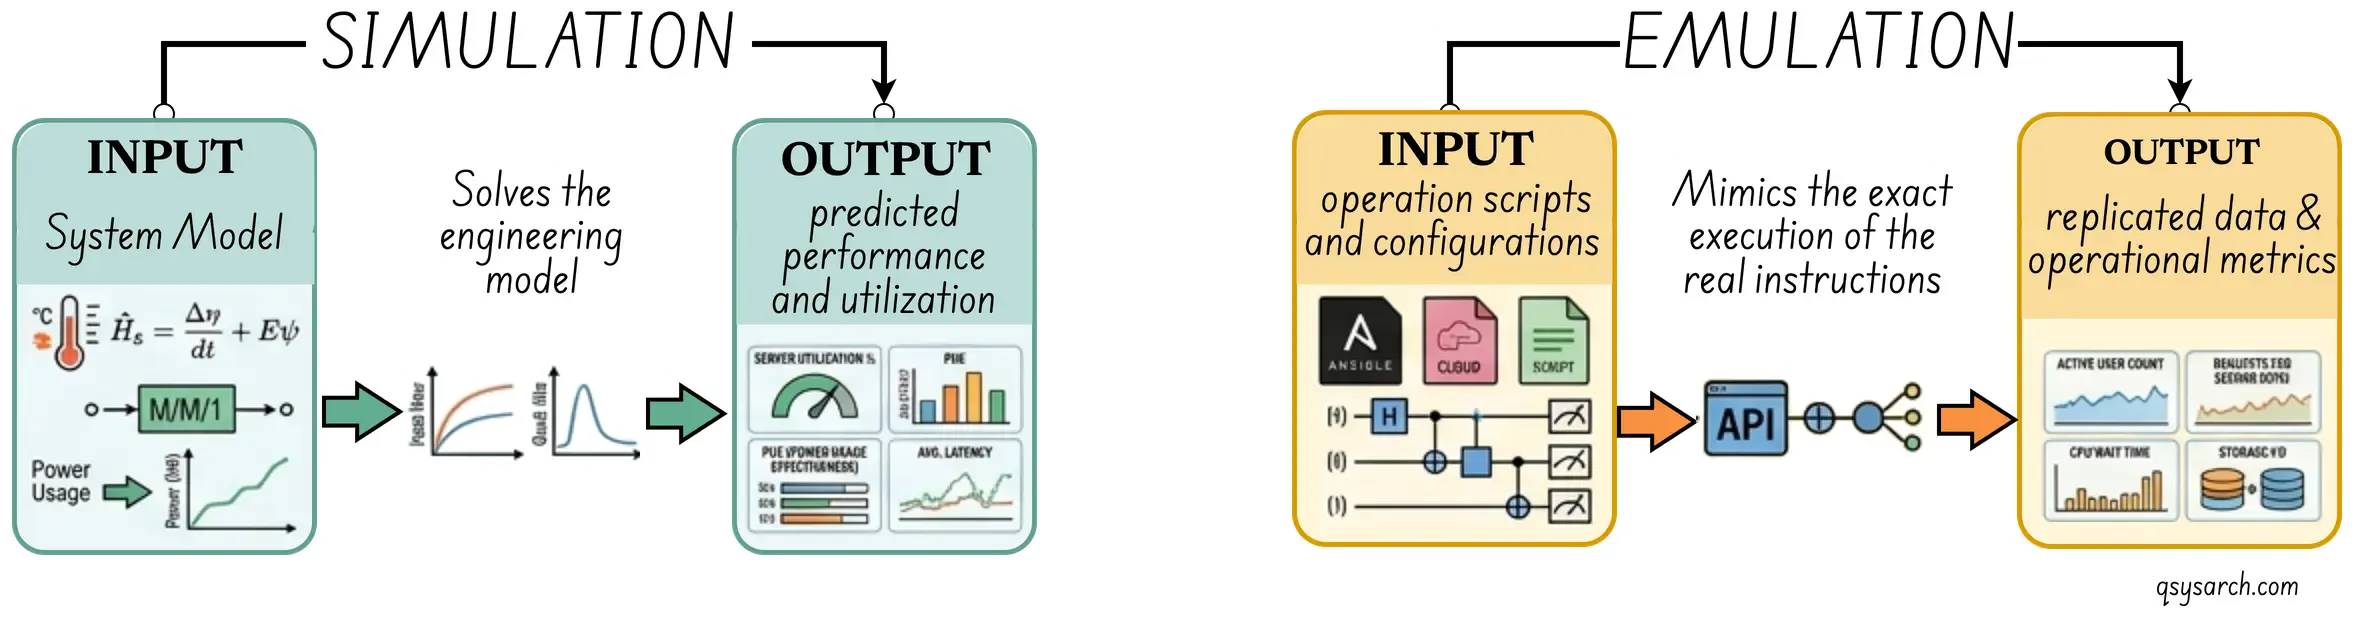
這裡值得一提的是_模擬_和_模擬_的差別。從宏觀層面來說,模擬創建了一個系統的模擬版本,而模擬則是基於系統的抽像模型進行操作。使用模擬,由於輸入相同,因此可以將模擬性能與實際性能進行比較。我認為在CEE的脈絡下,模型主要指的是模擬器。
一個好的非計算系統模型可以預測在專案中添加更多資源的影響。事實上,有時添加資源反而會降低系統效能。這種違反直覺的結果稱為布魯克斯定律。
有了模型,就可以開始規劃系統運作了。利用模型模擬各種情況,找出最優方案。根據這些結果,策略性地分配資源以滿足需求。一個好的計畫應該包含需求預測、成本管理和故障保護措施。預測用於預測未來的使用情況、流量或需求。成本控制用於控制資源過度配置,同時確保尖峰時段的容量。故障保護措施則提供緩衝,以應對意外需求。
關鍵在於高效可靠地運行系統,應對尖峰負載而不發生故障,確保成本效益,透過預測容量實現主動重新配置,並提供足夠的緩衝來應對意外事件。
該計劃結合了最佳情況(需求符合預期)和最壞情況(需求高於或低於預期)。這種方法實現了產能的成本效益最適配置。
先有雞還是先有蛋的問題
建立一個好的模型是先有雞還是先有蛋的問題。除非你知道在系統中應該觀察什麼以及如何觀察,否則很難建立一個高效且準確的模型。而沒有準確的模型,計劃就不太可能產生好的結果。
當模擬計畫與實際行為有差異時,你需要找出缺少的參數。這通常是透過事後分析被觀測系統的日誌來實現的。目標是識別需要觀察的新參數。
上圖中,這種學習循環被表示為_知識微調_。
工程平台
如果沒有一個自動化平台來支援其整個工作流程,CEE本身將無法獨立運作。下圖展示了這個工程平台。
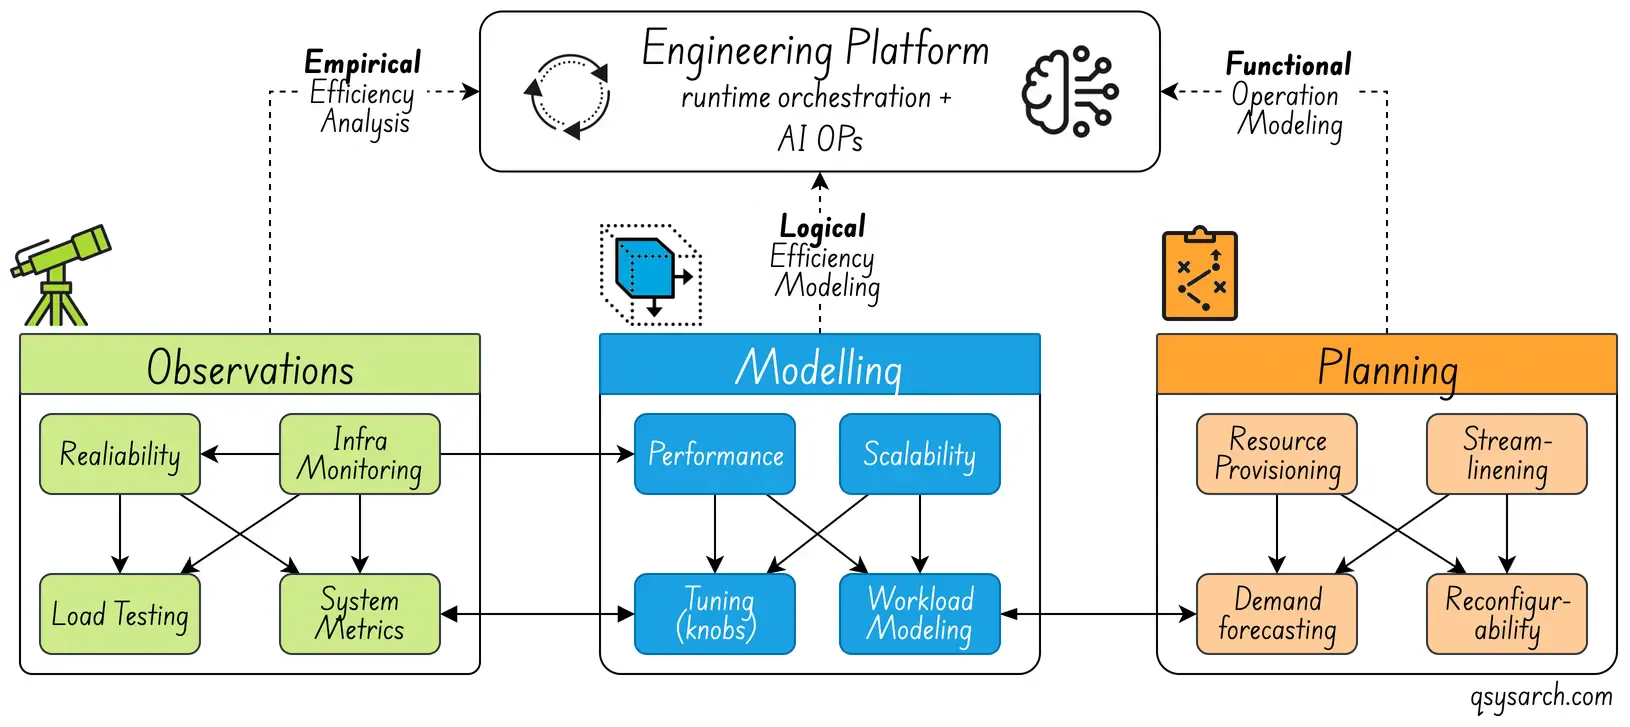
此工程平台的概念不僅在於自動化系統擴展和縮減的過程(該過程可委託給 AI 運維代理),還在於持續驗證模擬模型與經驗觀察結果的匹配度,並將差異反饋給機器學習代理以進行模型微調。該代理很可能是基於強化學習的代理,如果用於即時應用,則需要對其進行治理。
為了確保系統的穩定性和可靠性,性能應該限制在穩定的水平,而不是最大值。一般來說,穩定的性能約為最大性能的三分之二。超過這個閾值,系統效能就會下降。此時,停機成本會迅速(通常是指數級地)超過過度配置的成本。
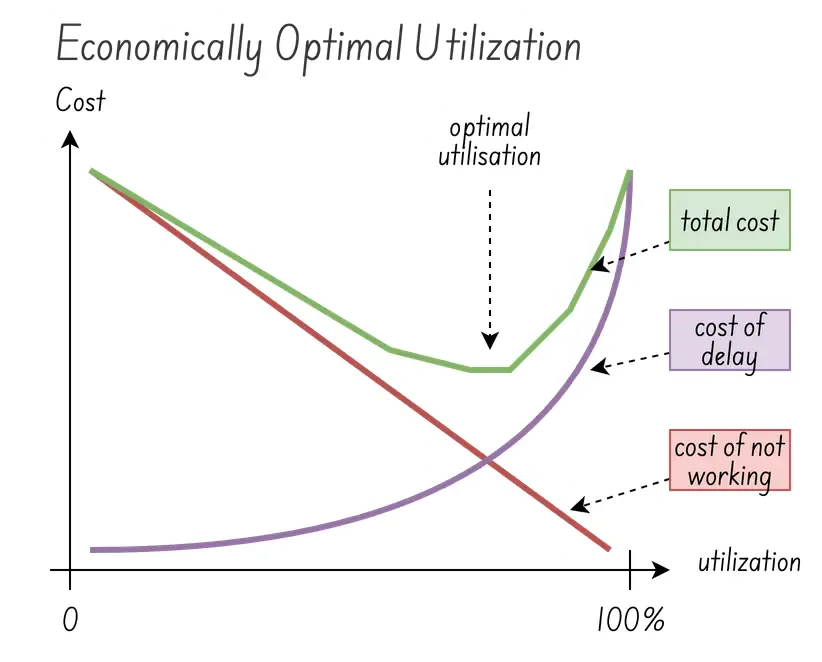
右圖中,延遲成本可以理解為在系統(即時)擴展時無法滿足需求所造成的經濟損失。這是一種暫時性成本。當利用率較低時,延遲只會影響少數需求。但當利用率較高時,延遲會影響大量需求,延遲成本也會呈指數級成長。
最佳利用率是指能夠同時最小化延遲成本和故障成本(過度配置)的資源利用率。綠色曲線表示總成本,即這兩個因素總和。這條曲線的局部最小值,通常在最大性能的 2/3 左右,標誌著最佳利用率。關於最佳利用率,其實還有很多值得探討的地方,我相信有些人會認為最佳利用率應該在 80% 左右。關鍵在於認識到,透過最佳化系統來降低延遲成本,可以提高最佳利用率(圖片來源:show me the data)。
改進的成本
如果降低系統故障成本意味著最大限度地縮短擴展時間,那麼試想一下,如果一個系統能夠在幾毫秒甚至幾微秒內進行自我調整,以擴展規模並滿足需求,那該有多好。當然,開發這樣的系統成本可能非常高昂(想想高頻交易)。但是,如果開發這樣一個系統的成本低於系統更高利用率所帶來的效益呢?
這項挑戰也是CEE(核心經濟環境)的一部分。透過對系統改進成本進行建模,可以製定一個平衡改進成本與效益的計畫。這與其說是一項營運挑戰,不如說是一項策略性投資。然而,它仍然遵循CEE的相同原則,並將這些原則應用於企業的營運策略,將其視為一個系統。
在產能和效率工程的背景下,價值流圖(VSM)通常被用作診斷工具,以確定產能消耗在哪裡,從而識別浪費和瓶頸的根本原因。
價值流是指系統交付服務過程中工作流程中的每一個步驟或活動,而價值流程圖則是對此端到端流程的視覺化呈現。價值流程圖區分三種類型的活動:
增值(VA):直接有助於客戶獲得所需輸出的步驟(例如實際計算)。
非增值但必要的步驟(NNVA):系統所需的步驟,但沒有直接的客戶價值(例如握手)。
浪費(Muda,或無駄,日文術語意為「浪費」):消耗產能而不增加任何價值的步驟。
目標是消除浪費步驟,而價值流程圖 (VSM) 正好擅長識別這些步驟。 VSM 的強大之處在於它能夠找到可以減少在製品 (WIP) 的正確最佳化方案。這點至關重要,因為利特爾定律指出,平均交付週期(或週期時間)等於平均在製品 (WIP) 除以平均吞吐量:
交付週期 = 在製品 / 吞吐量這意味著,即使吞吐量保持不變,如果在製品數量翻倍,交貨週期也會翻倍。因此,控制在製品數量是改善交付延遲(即「延遲」)從而提高系統效率的最直接手段之一。
# 結論
瞧,這份週日早晨關於容量和效率工程 (CEE) 的簡短備忘錄幫助我更了解這個主題。現在,我想記住的是,當一個系統的效率非常低時,很可能表示該系統或其工作流程充斥著大量的浪費 (Muda)。應對這項挑戰的答案是:與其過度配置資源,不如投資降低延遲成本?
References:
DrawIO diagrams used in this memo:
Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
Key
methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
Unique
angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
Metrics
emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |