xPU:它是專用處理單元 (PU) 的一個統稱,其中「x」可以代表任何針對特定工作負載定制的運算架構。常見的變體包括 GPU(圖形)、TPU(張量/AI)、NPU(神經)、DPU(資料)或 PPU(脈衝,主要用於量子控制堆疊)。
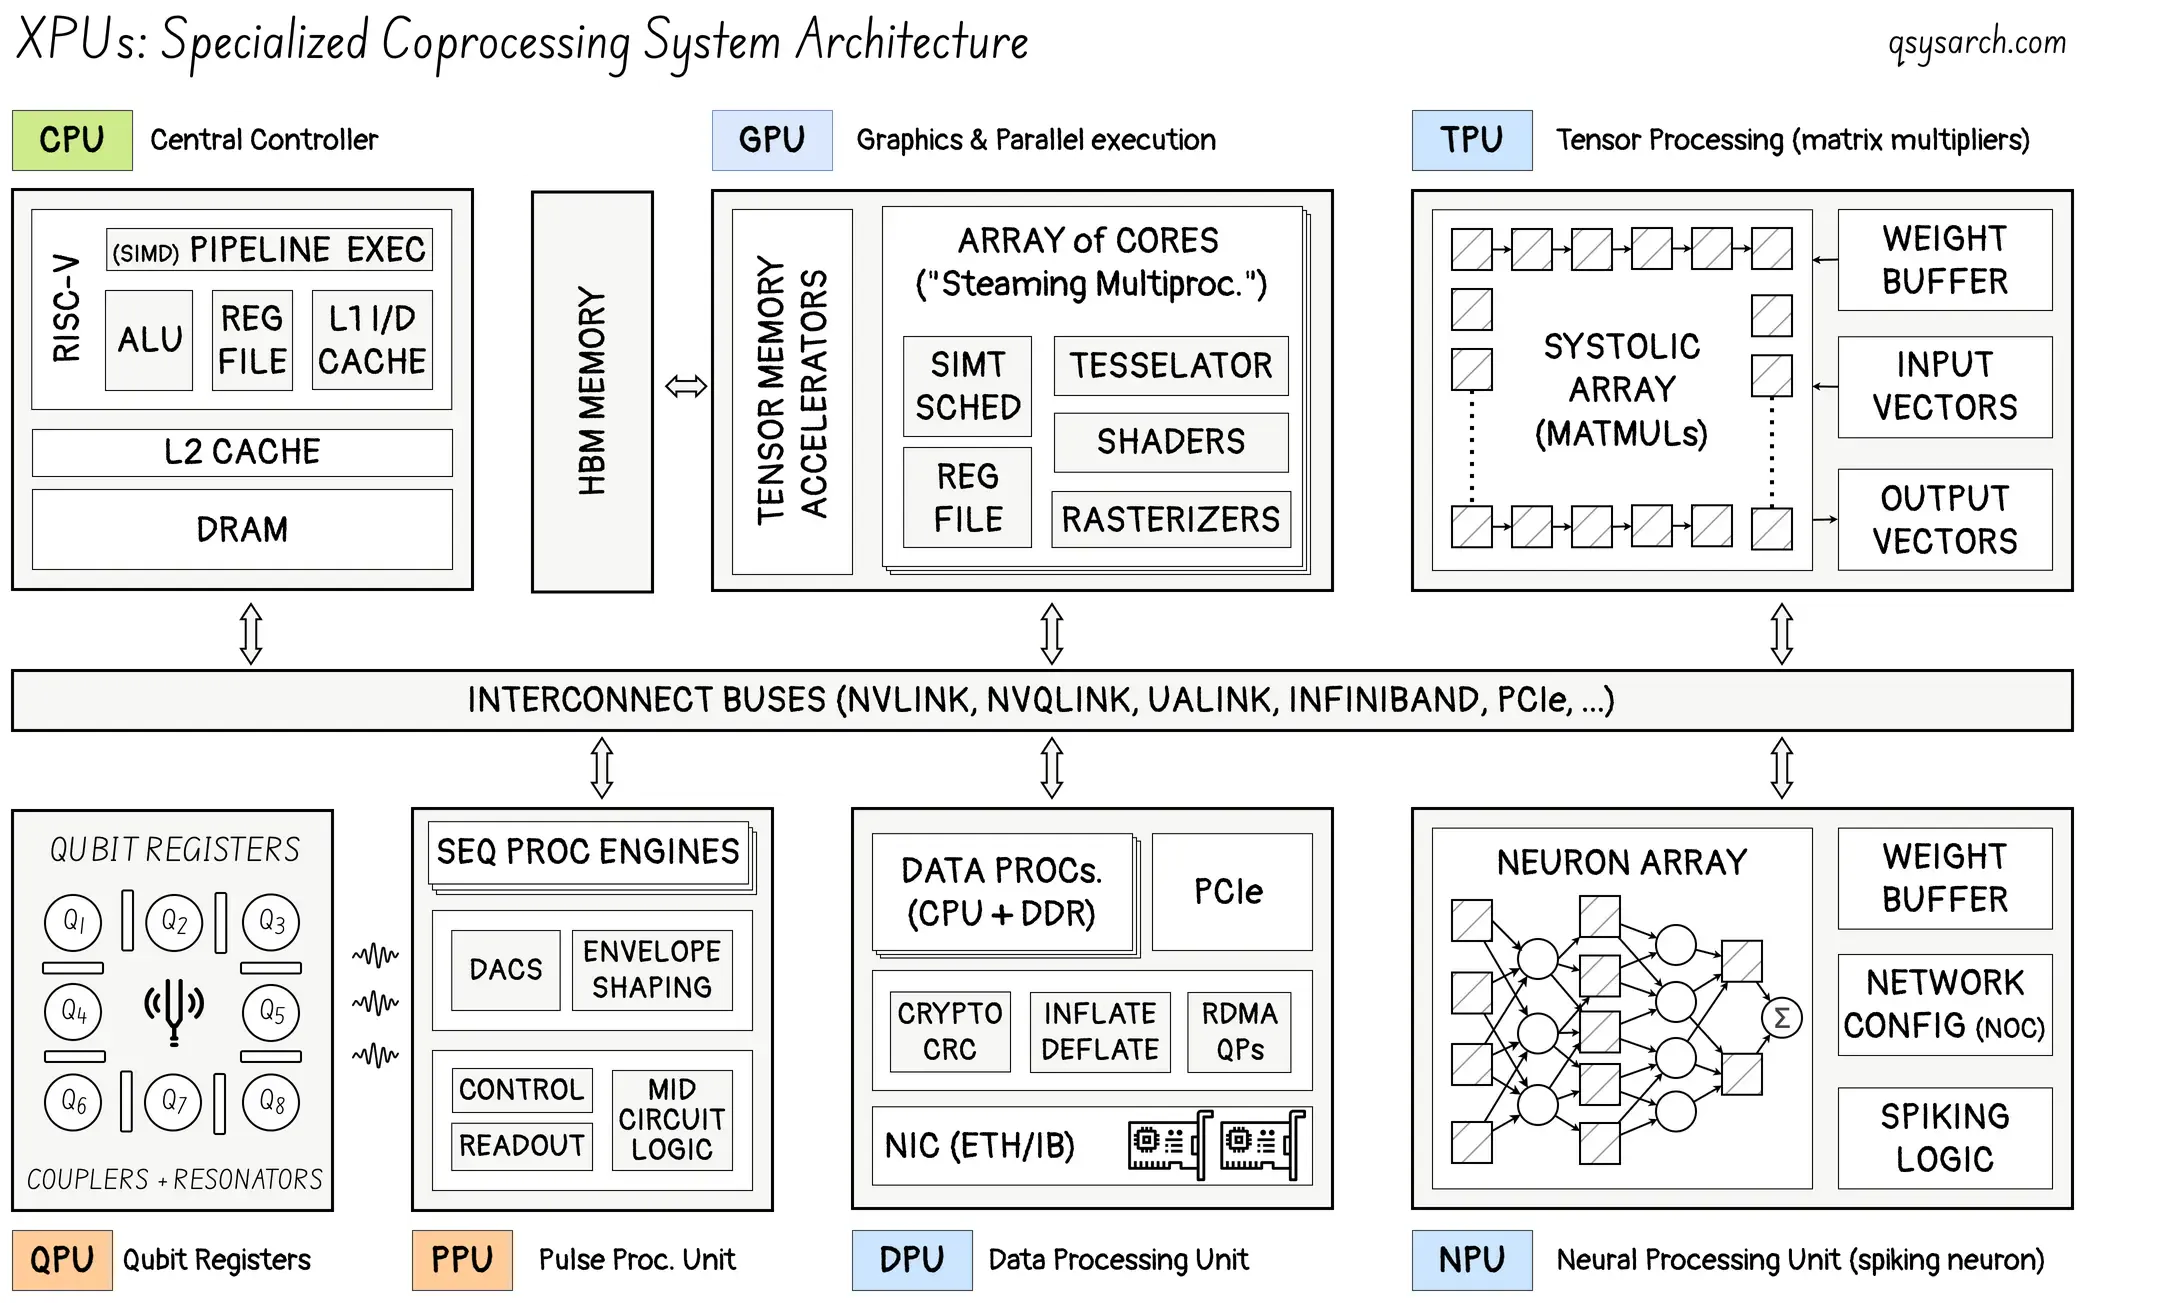
這份超短備忘錄旨在深入分析應用於人工智慧推理的 xPU 市場格局。
在檢視人工智慧推理ASIC的市場格局時,最有價值的指標或許並非原始效能,而是供應商的差異化優勢能否在未來3-5年內保持競爭力。從這個角度來看,可以歸納出三個集群:
通用平台:NVIDIA 與 垂直整合商:AMD、Google
當前挑戰者 Groq、Cerebras、FuriosaAI、Positron、SambaNova、Axelera AI。
未來挑戰:Extropic、Normal Computing、Unconvential、Mottronix、Akhetonics! 部分 xPU 製造商
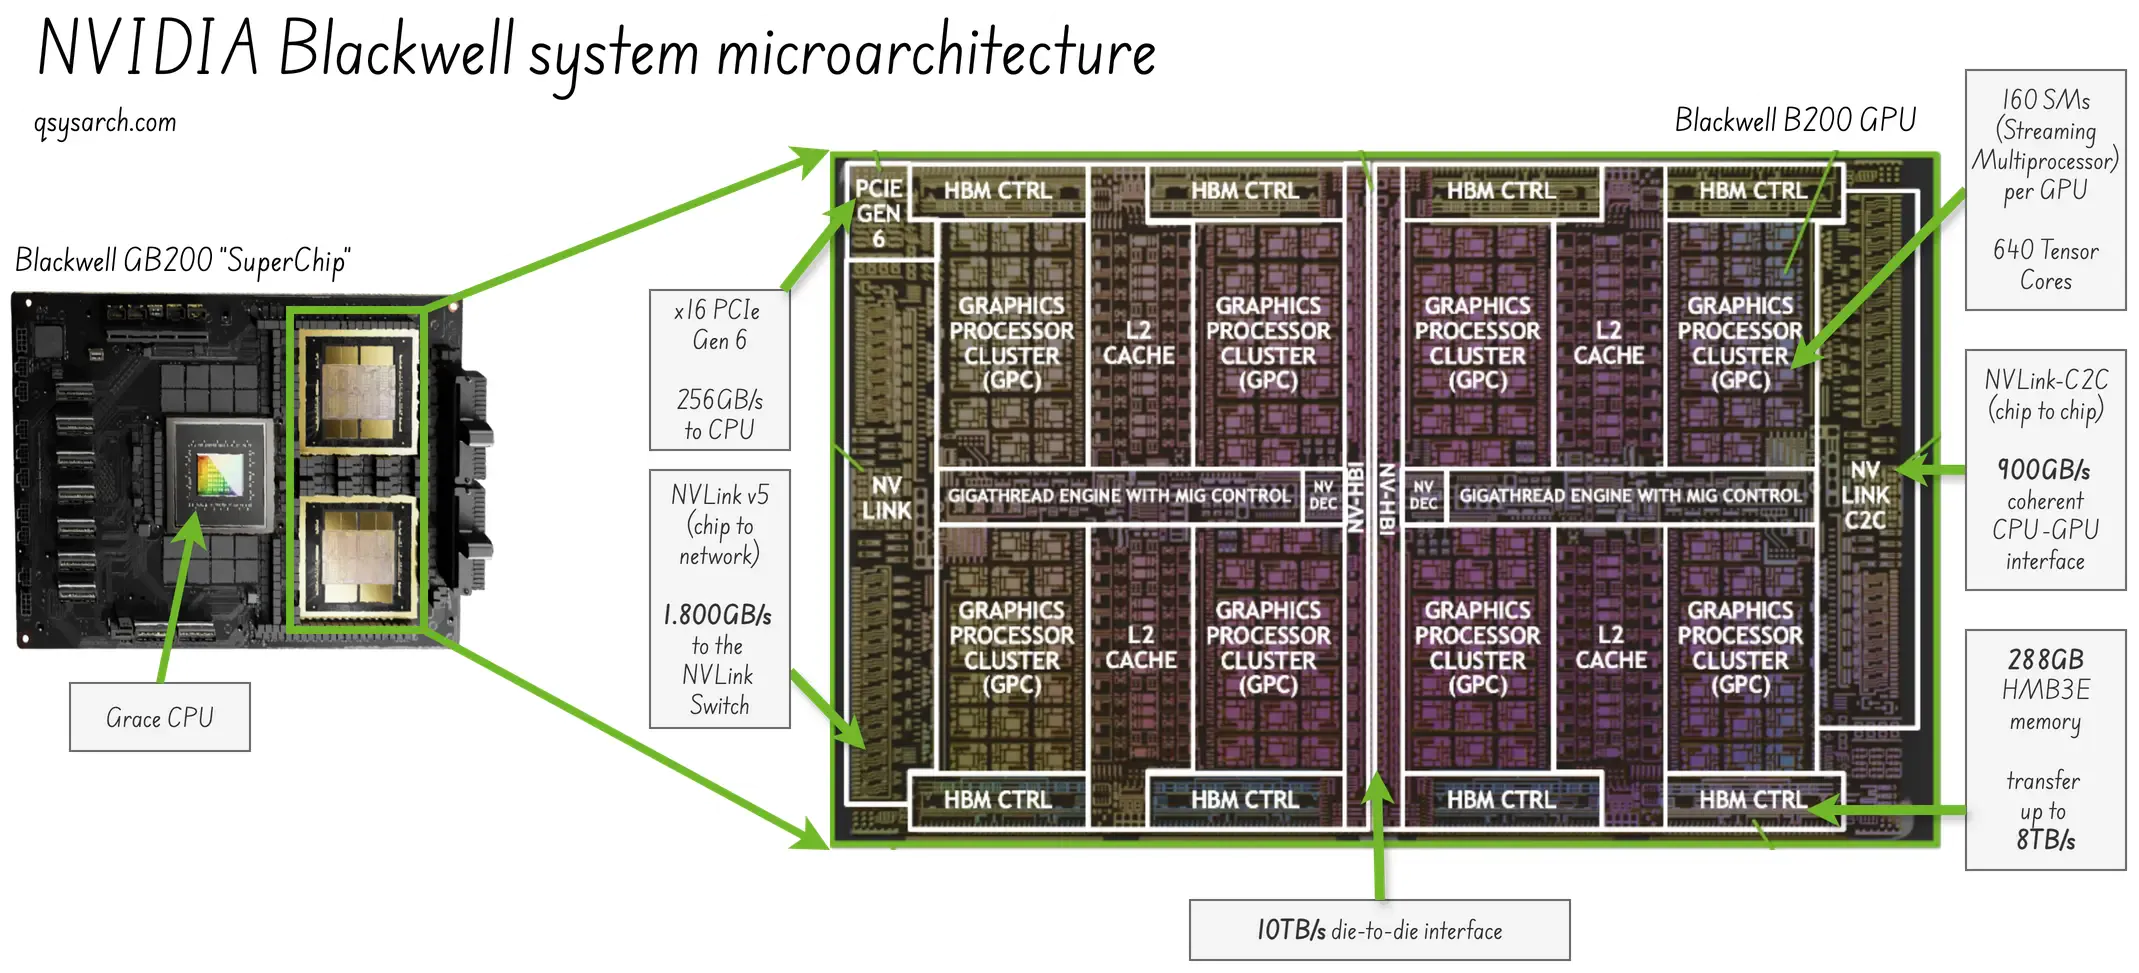
NVIDIA
架構:GPU(2024 年採用 Blackwell 架構)
核心優勢:生態系鎖定、軟體堆疊深度、完整的系統集成
目標工作負載:通用 — 大規模 LLM 訓練與推理 - 圖形著色器
缺點:成本高、功耗高;未針對稀疏計算進行最佳化
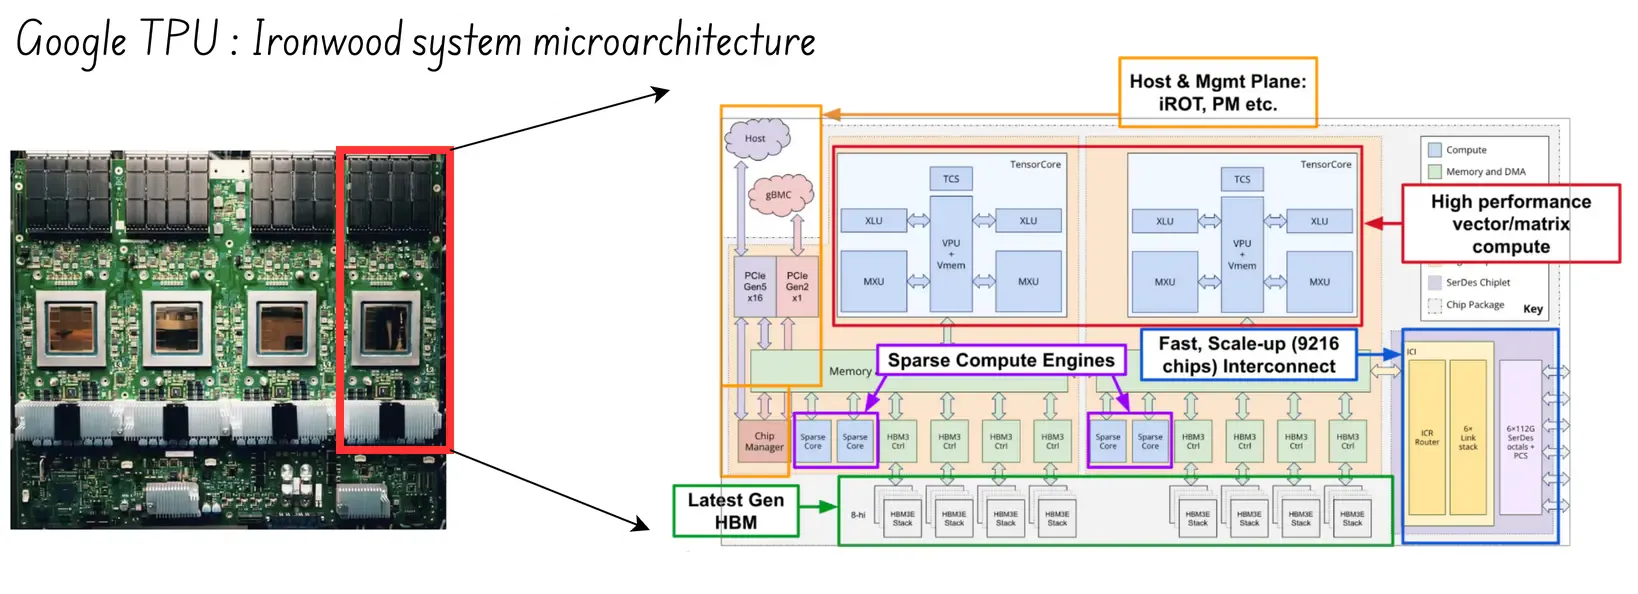
Google
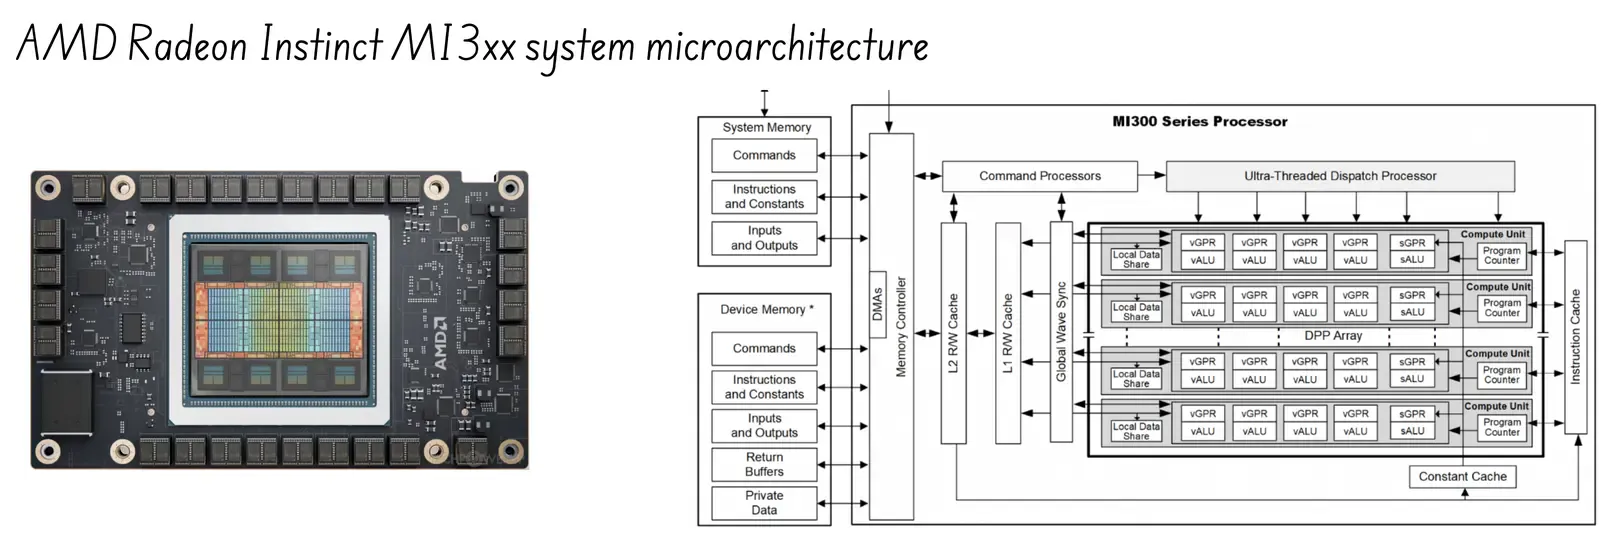
AMD
架構:MI300 Instinct + ROCm(AMD 自研 CUDA)
核心優勢:CUDA 定價方案;熟悉的 GPU 模型;
目標工作負載:對雲端成本敏感的高效能運算和推理
漏洞:軟體與 CUDA 的差距;缺乏前沿生態系(例如 NVQLINK)
Groq(已被 NVIDIA 收購)
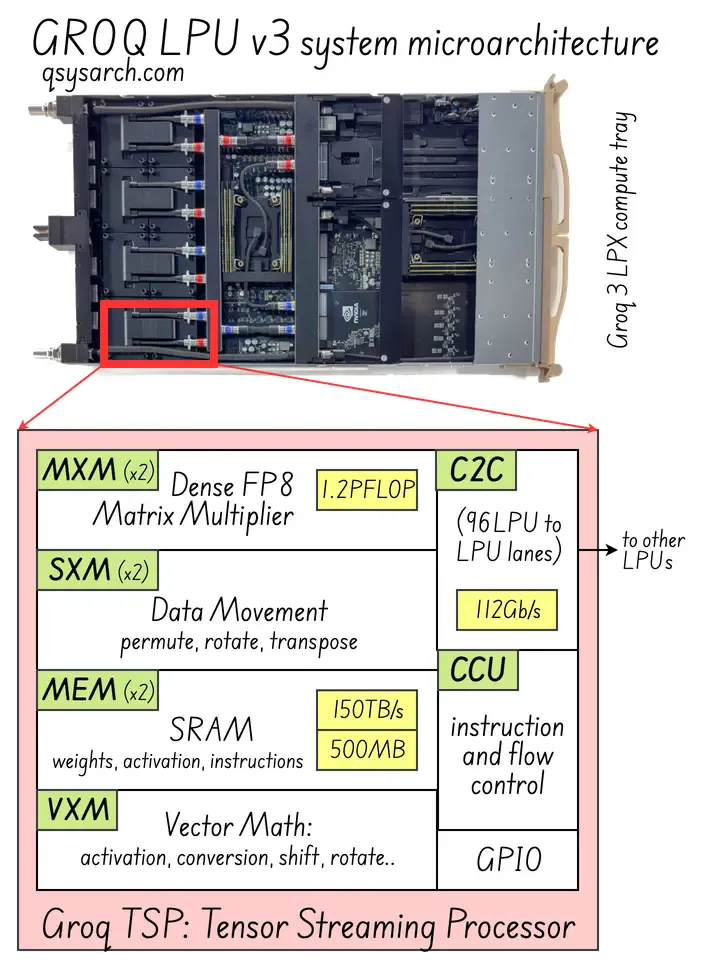
架構:LPU(語言處理單元)
工作原理:基於核心張量流處理器 (TSP) 架構,執行時間完全可預測,精確到時脈週期。
核心優勢:確定性的超低延遲;無記憶體瓶頸;所有操作都由編譯器預先「規範」。
目標工作負載:即時推理
弱點:以速度換取空間:沒有大容量 HBM(高頻寬記憶體),只有小容量嵌入式超高速 SRAM(儘管這使其成為 NVIDIA 收購後 NVIDIA Blackwell 生態系統的良好補充!)
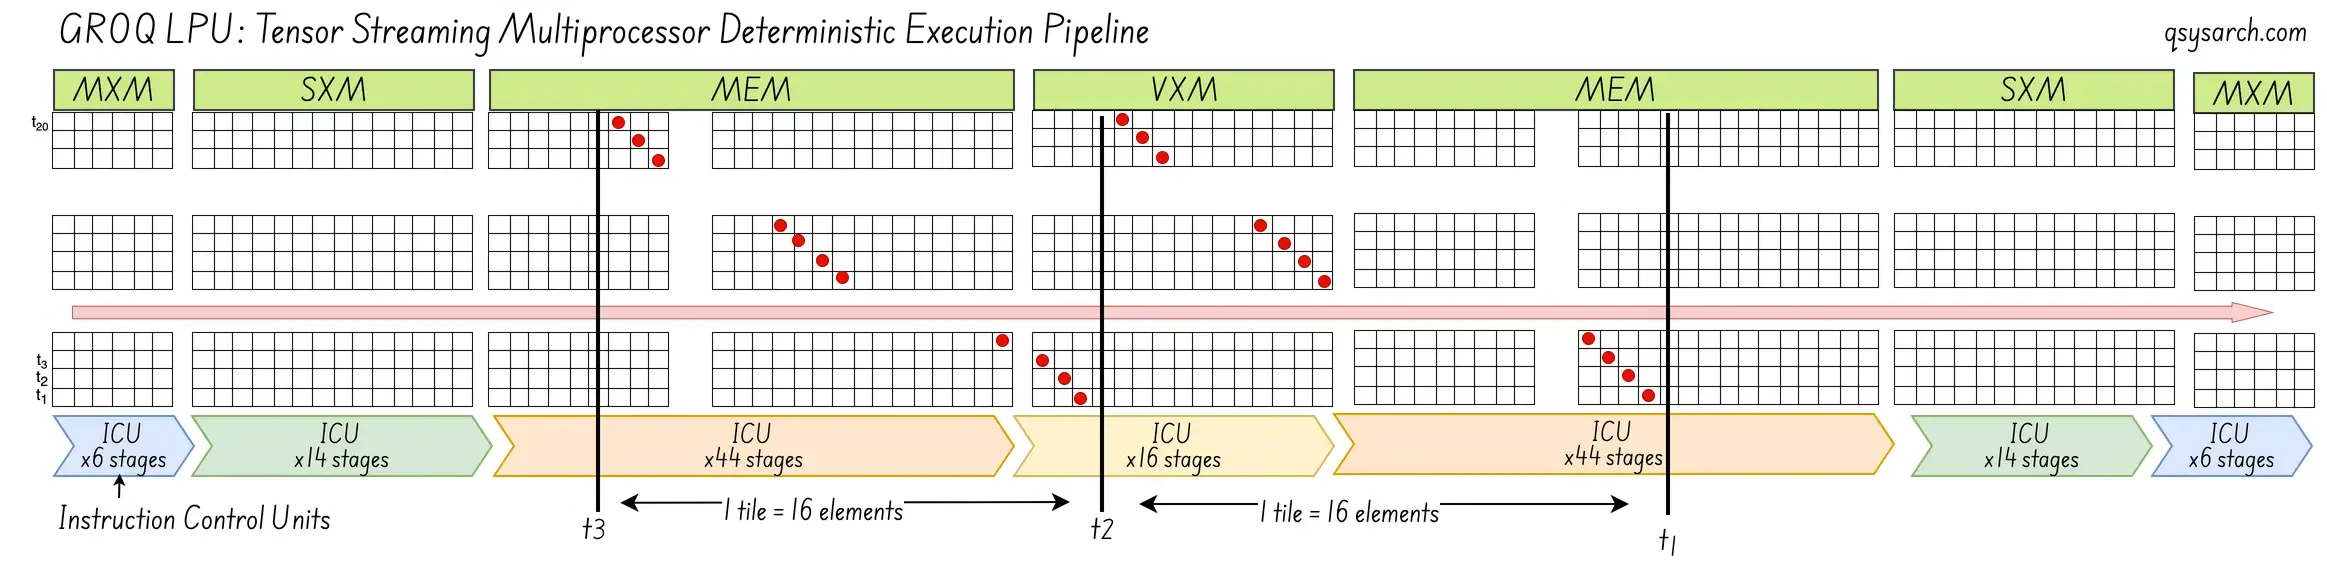
請注意,Groq LPU 架構於 2020 年發布,2024 年商業化推出,並於 2026 年收購。這為那些渴望成為獨角獸的公司提供了一個不錯的時間表:4 年的開發時間,2 年的市場認可時間,如果更大的競爭對手感受到競爭壓力,就能獲得巨額收益!
認真研究以下每個供應商的解決方案可能需要幾天時間;而我寫這份備忘錄時並沒有那麼多時間——因此,請對以下描述持保留態度,因為它可能不完整和/或主觀。
SambaNova [差點被英特爾收購]
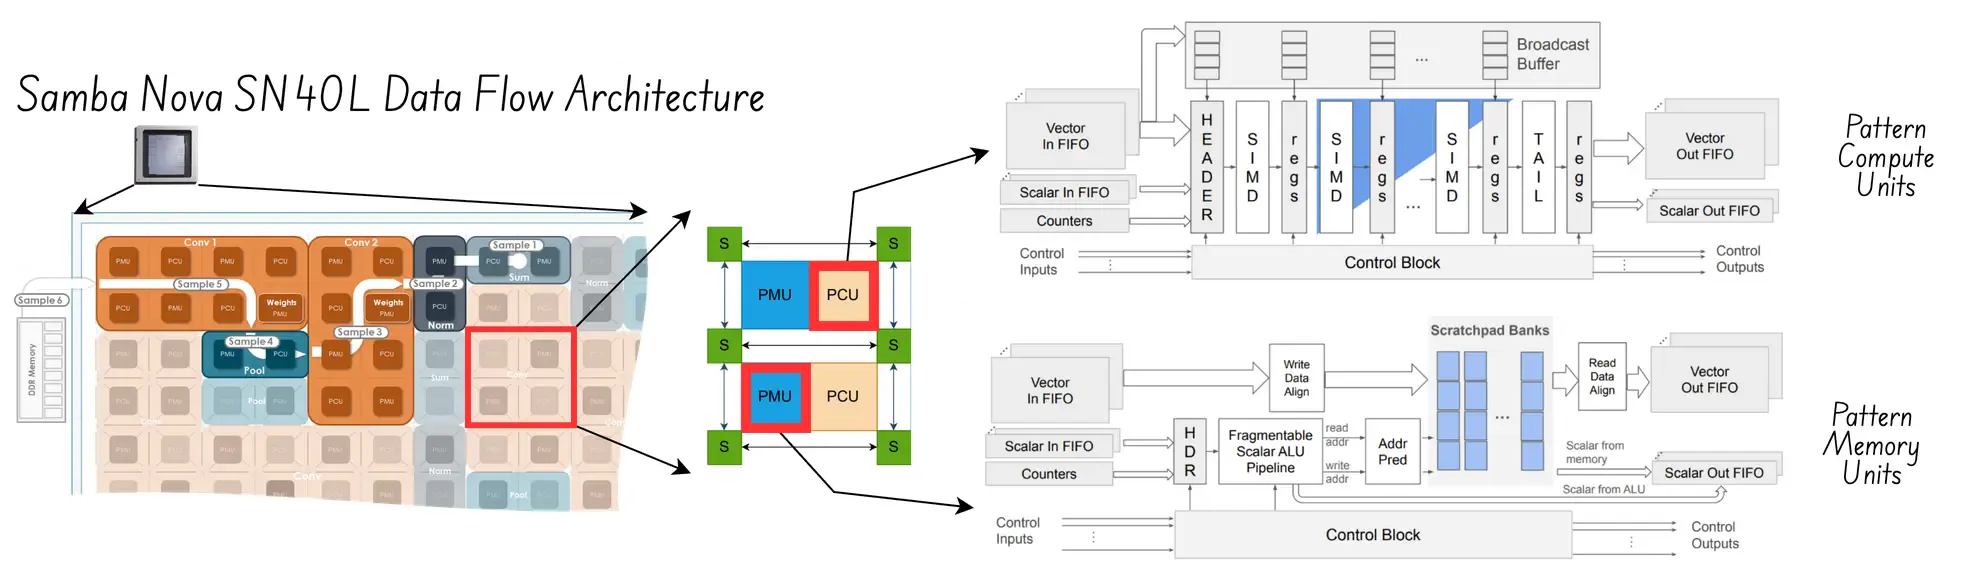
- 架構:RDU(可重構資料流單元);支援為整個運算圖建立自訂整合資料+處理管線,最大限度地減少資料移動,從而實現高硬體利用率。下圖展示了其SN40L中使用的PCU(模式計算單元)和PMU(模式儲存單元)的詳細架構:
Cerebras
架構:晶圓級引擎 (WSE) 可作為巨型管線矩陣乘法器。
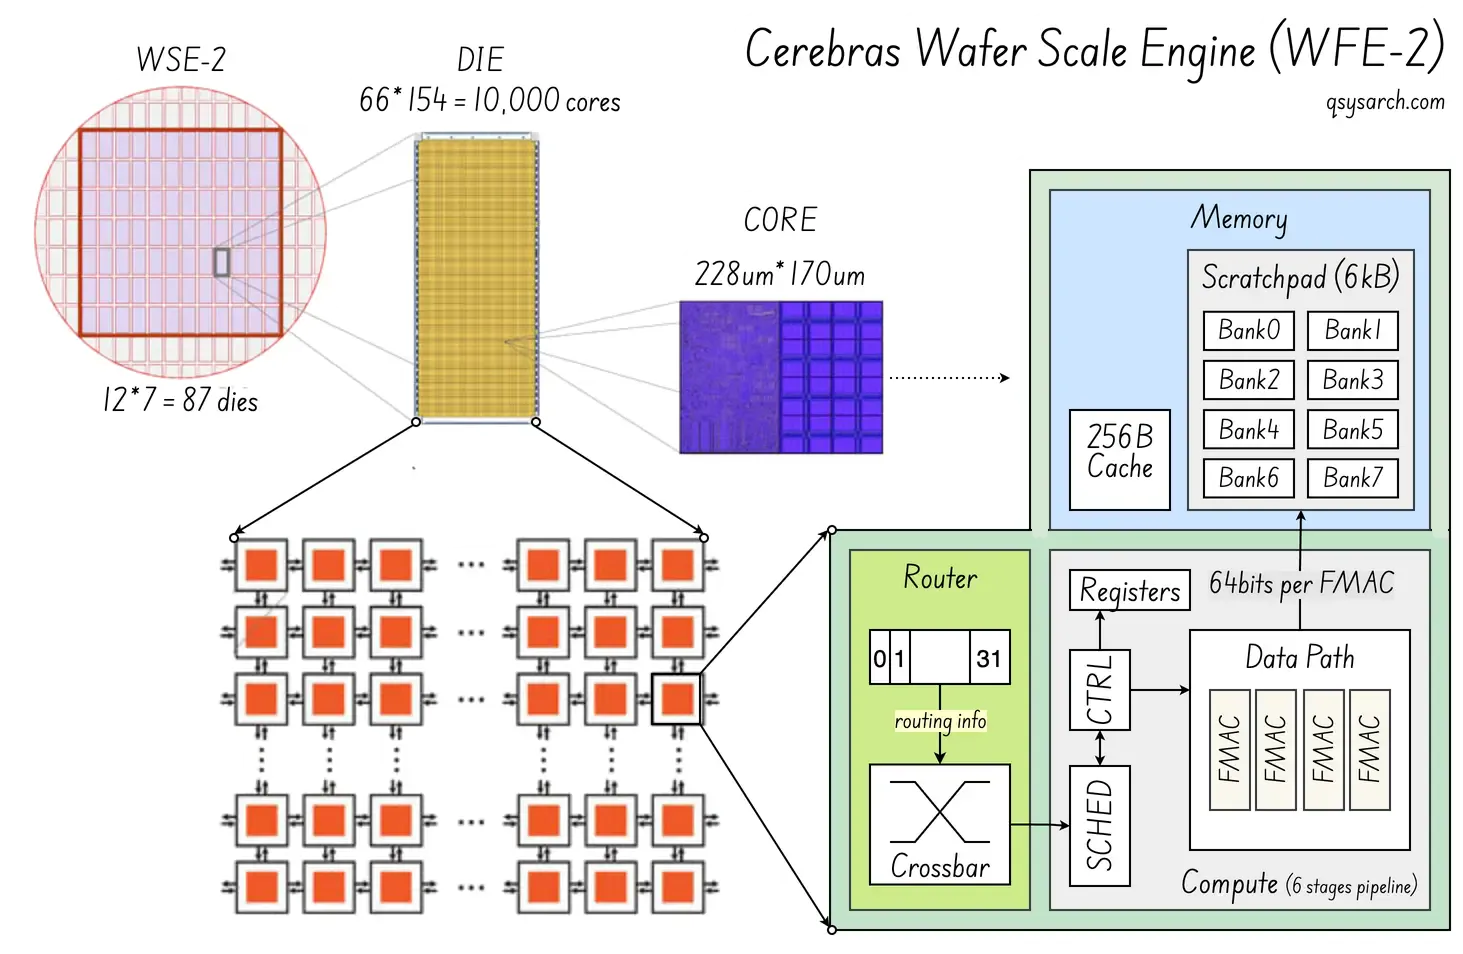
核心優勢:海量片上SRAM,消除HBM瓶頸。高密度獨立內核(WSE-2高達85萬個),可進行「記憶體張量計算」。晶圓上各節點間單一時脈延遲架構路由。
目標工作負載:大型 LLM 推斷,特別是稀疏模型。
漏洞:需要一流的軟體堆疊才能充分利用其大規模優勢(就像所有「PIM」或記憶體處理微架構一樣)。
FuriosaAI
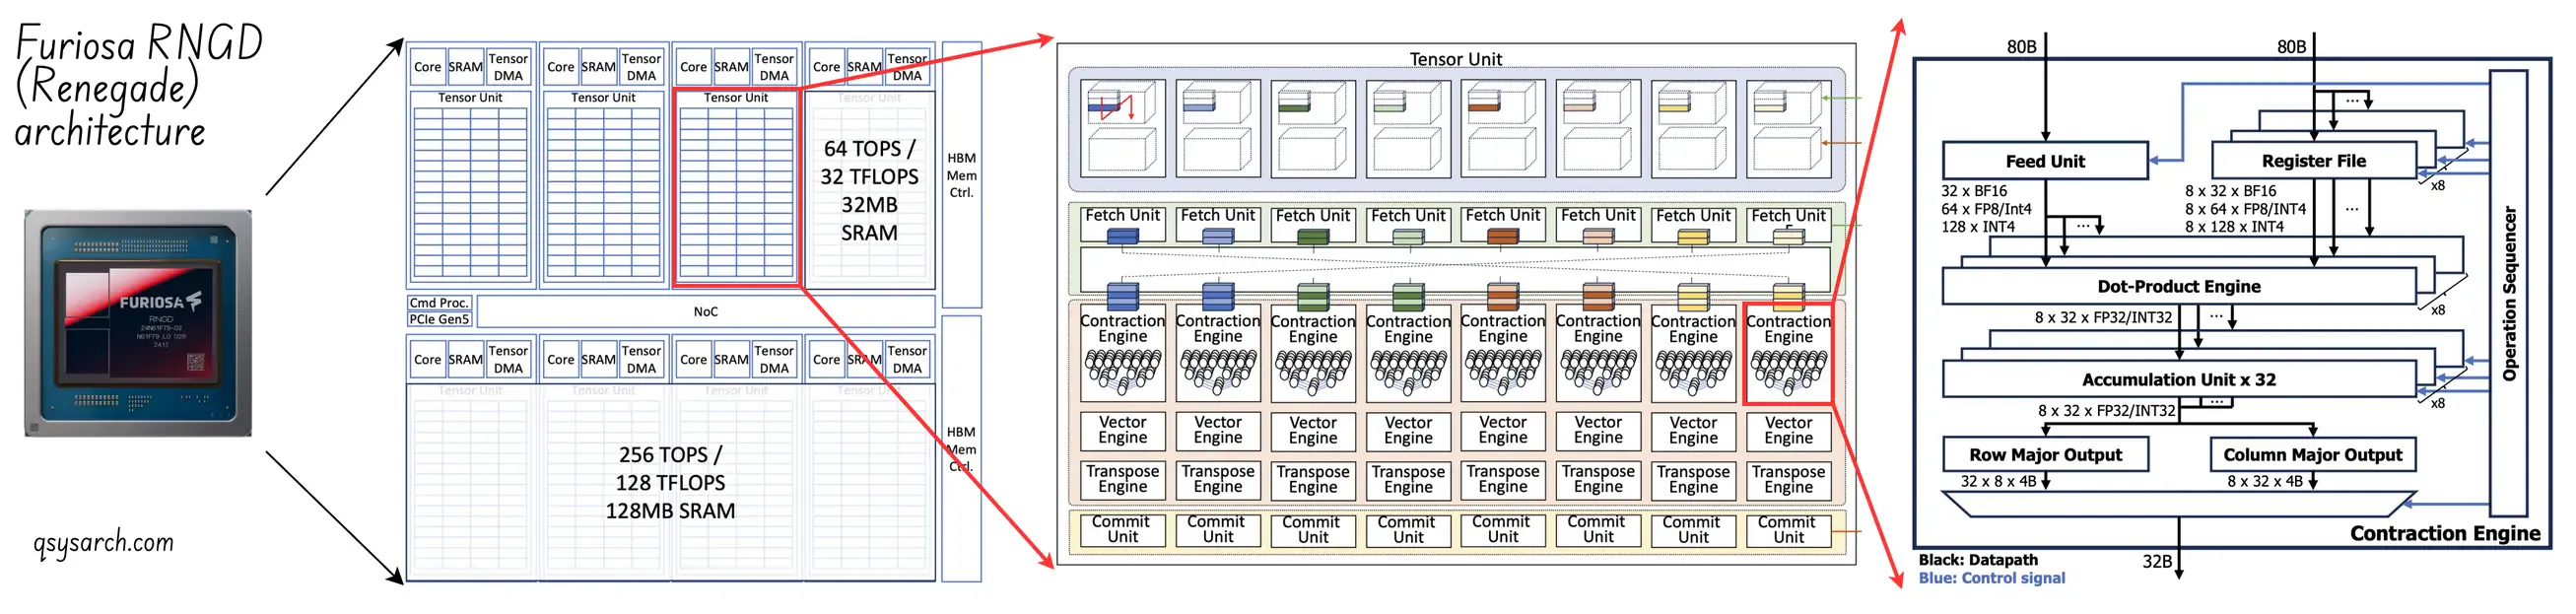
- 架構:張量收縮處理器(TCP),以 Renegade (RGND) Asic 的名義出售。與具有固定網格的 TPU 脈動陣列相比,Furiosa 的 TCP 架構使用小型、可配置的運算單元,這些運算單元可以動態地重新排列(就像一個超級智慧的網路營運中心)。
Positron
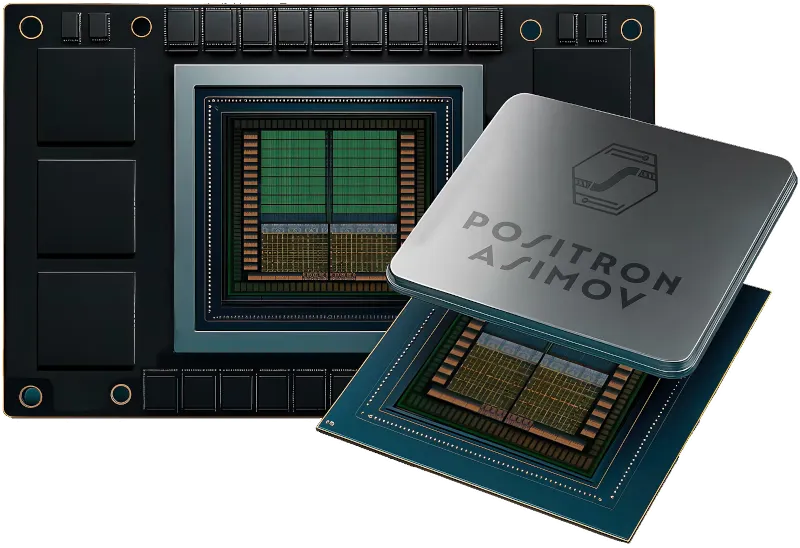
- 架構:Asimov ASIC - 目前可用的資訊不多,但 Positron 傳達的關鍵訊息是記憶體為王:因此,如果他們能夠使用晶片堆疊技術將更多標準的 DDR5 記憶體嵌入到他們的 ASIC 中,那麼與記憶體容量較低的 NVIDIA Blackwell 相比,他們就能提供極具吸引力的產品。
核心優勢:專注於高記憶體頻寬利用率 (MBU) 而非標準高記憶體頻寬 (HBM)。這意味著他們可以提高記憶體匯流排的佔空比或利用率,從而提供同等甚至更高的記憶體效能(頻寬乘以佔空比,類似於電力的 V*I = 瓦特),進而超越那些仍在為昂貴記憶體而苦苦掙扎的競爭對手。
Axelera AI:
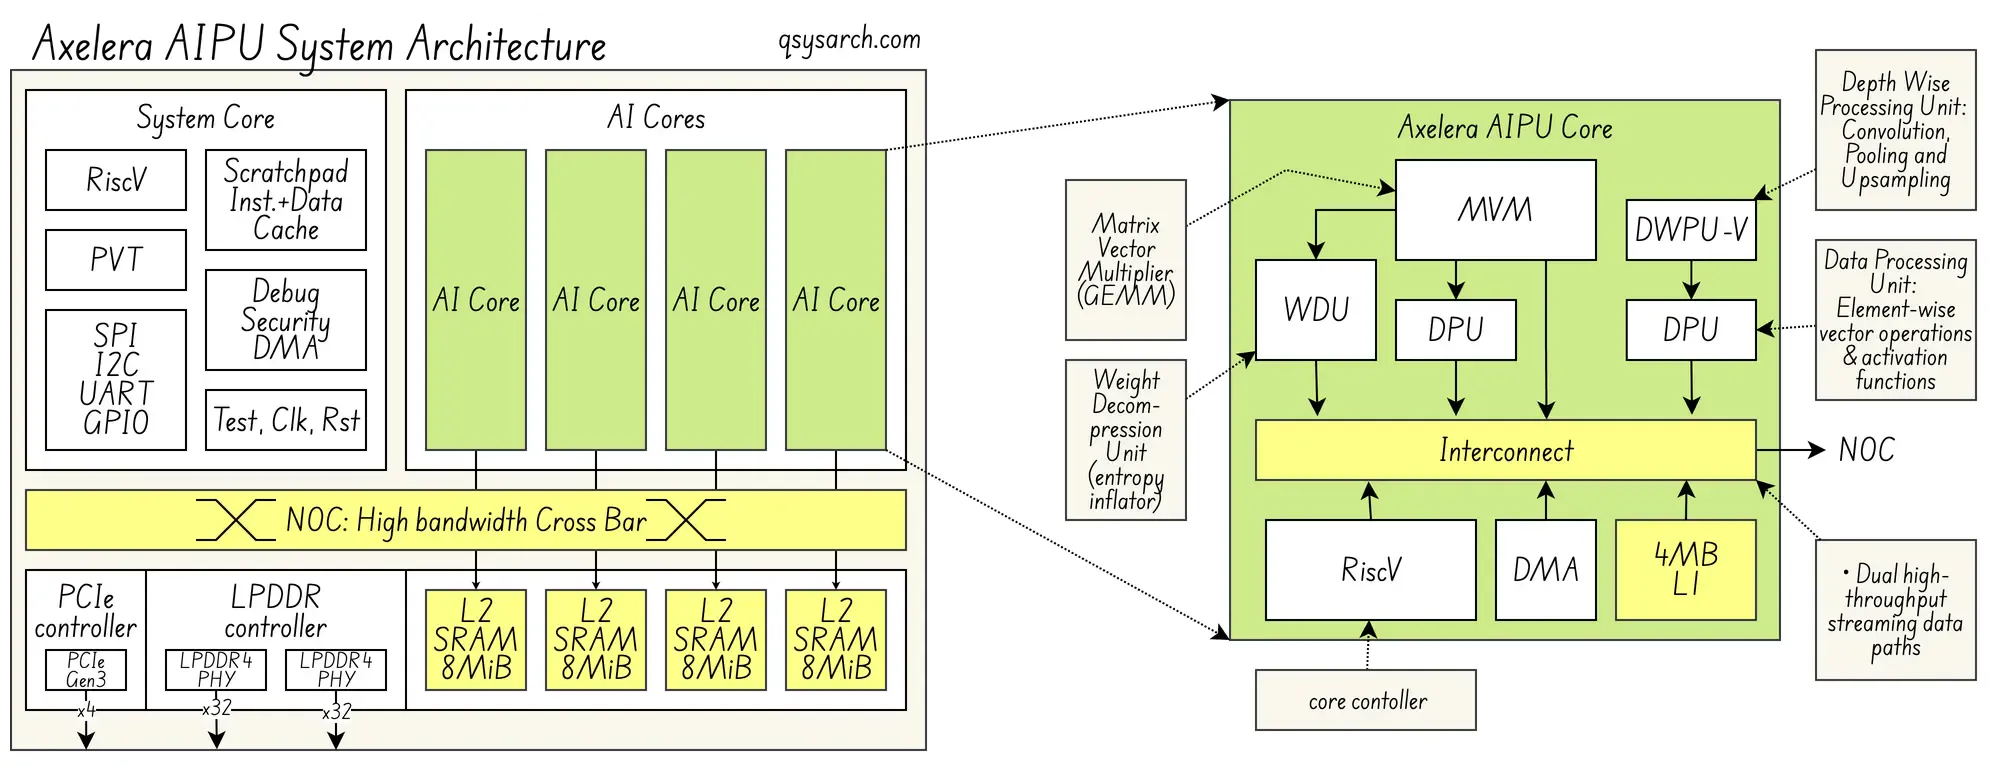
核心優勢:利用記憶體運算,它可以直接在數位儲存單元內部執行複雜的矩陣乘法運算,從而消除資料移動;這使得其能源效率達到 15 TOPS/瓦(相比之下,NVIDIA Blackwell 的能源效率約為 3 TOPS/瓦)。此外,它還是完全由歐洲設計的 IP,使其成為一項自主解決方案。
目標工作負載:第一代產品專注於電腦視覺/多流視訊分析;新一代產品(M2 整合)也可用於邊緣 LLM 和 vLM 工作負載。
弱點:Axelera 的弱點不在於其工程技術—他們的技術是世界一流的。他們真正的弱點在於市場摩擦:他們能否在不分散注意力的情況下打入市場?
在尋找上述公司資訊的過程中,我偶然發現了一些製造業挑戰者和顛覆者,它們可能在未來幾年發揮重要作用。其中最後一家公司——Unconventional AI——絕對不容忽視,這要歸功於其領導者過去的成功和遠見。

Extropic 與 Normal Computing
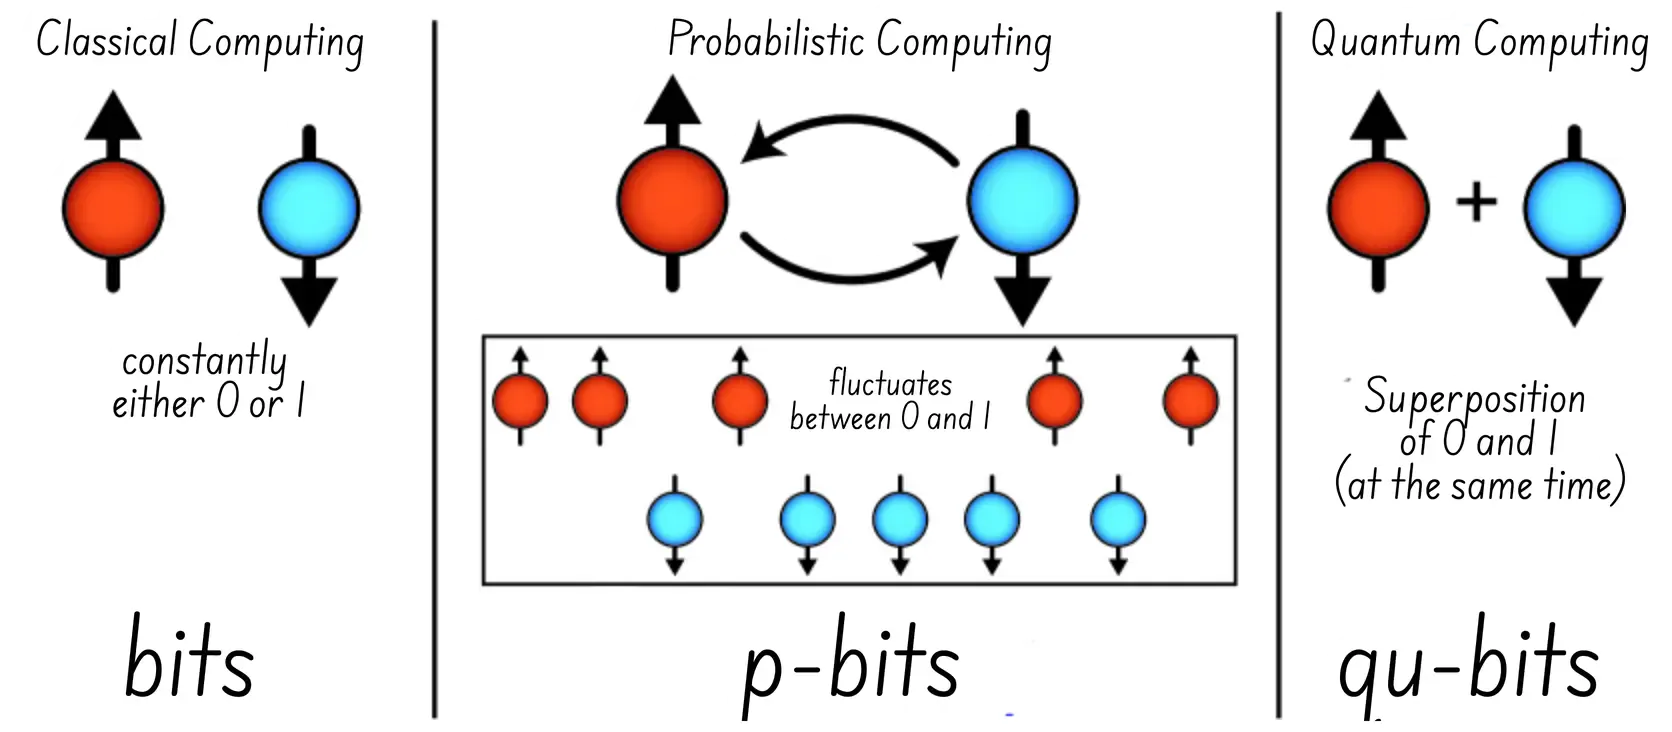
- 架構:TSU(熱力學採樣單元)/ SPU(隨機處理單元),用於操作「p 位元」(又稱機率位)
Mottronix
架構:使用莫特記憶體(Mott-RAM)的 SPU(脈衝神經網路)。
為什麼這很重要:我們需要有遠見的人來研究替代記憶體,例如電阻式記憶體(ReRAM),或像 Mottronix 的 Mott RAM。
弱點:必須證明它可以從研究成果轉化為產品化的積體電路。
Akhetonics
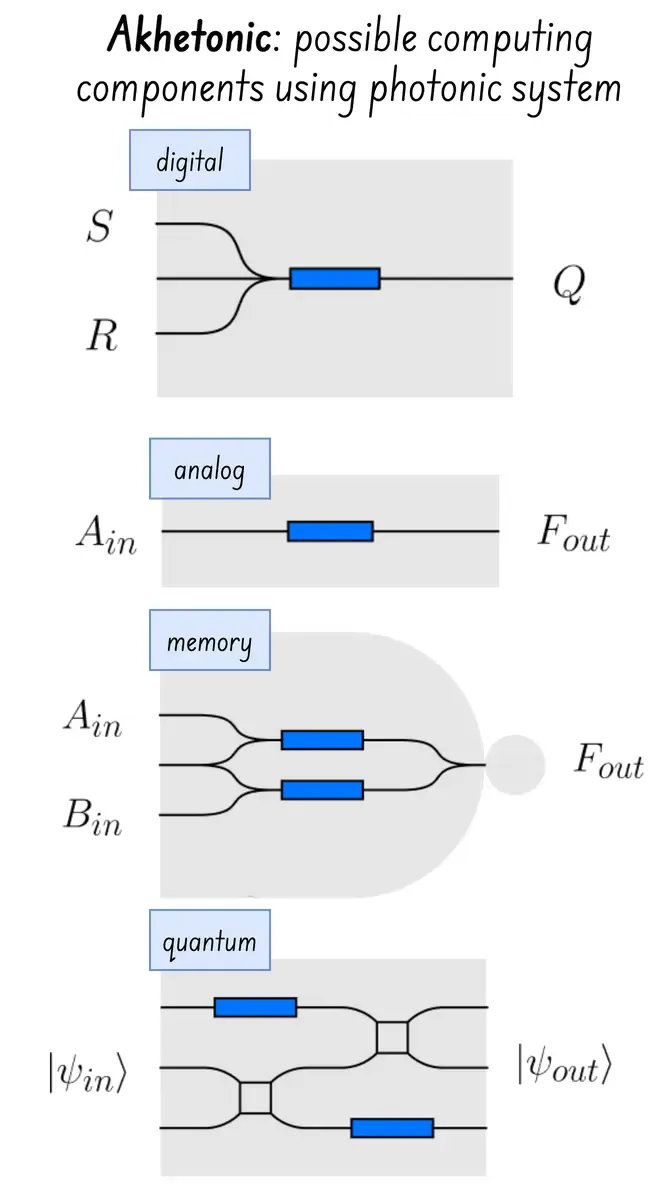
架構:採用全光數位處理器的推理處理單元 (RPU)
重要性:過去十年,光子積體電路的良率取得了巨大的提升——例如,NVIDIA 現在已經能夠商業化生產矽光子網路交換器——將其應用於計算工作負載是順理成章的下一步! (這也使得光定址量子運算成為可能!)
漏洞:OAQ 量子計算和 RPU 推理計算之間的區別尚不明確,而且在擴展到商業解決方案之前,都需要仔細的校準和調整。
Arago
- 架構:「JEF」作為光子AI加速器,能夠降低10倍至30倍的能耗——關於Arago的公開資訊非常有限,但它似乎是一種混合確定性/經典+光子加速器集成解決方案,並結合了全棧和PyTorch兼容的軟體SDK。
 非常規人工智慧
架構:採用倉本振盪器的[UN]CPU([非]常規處理單元)
為什麼這很重要:我非常喜歡這個想法,而要實現它,執行力至關重要:敢於另闢蹊徑只是成功的一半;真正改變世界的人需要日復一日地努力。為此,他們擁有一位經驗豐富的領導者。
漏洞:他們仍處於第 0 到 1 天,因此執行力是關鍵。
當前可能改變市場格局的真正戰場在哪裡?
- 英偉達的結構性優勢不在於GPU,而在於過去十年間建立的CUDA生態系。贏得這場競爭需要贏得軟體,而不僅僅是晶片——而這正是許多以硬體為中心的創新公司失敗的原因。
AMD是NVIDIA近期最被低估的威脅:它無需超越CUDA,因為他們擁有自己的工具,只需滿足對成本敏感的雲端服務買家的需求即可。 ROCm 6.x正在以超乎預期的速度縮小差距。
大多數創新者都在嘗試一種時空折衷方案;要么增加更多超高速的局部記憶體;要么允許動態可配置的資料流(管道);目前,瓶頸在於 RAM;
- 也許最終的贏家是那些能夠同時解決這兩個問題的演算法,這對於稀疏矩陣計算(包含大量「零」)來說尤其重要,因為在稀疏矩陣計算中,人們既要避免記憶體傳輸零值,又要避免計算零值! Renegade 能否成為致勝關鍵?
以下概述是對一級到三級市場格局的個人見解。下一個週期將由三個轉變主導,它們按影響程度排序。
LLM(層級邏輯模型)越來越受記憶體頻寬限制,而非計算限制。隨著模型規模擴大,上下文視窗擴展到100萬個以上的令牌,權重在HBM(高動態範圍模型)內外遷移的成本和延遲成為主要因素。權衡的關鍵在於利用片上SRAM進行近記憶體運算並使用具有足夠頻寬的大容量記憶體:關鍵KPI可能成為記憶體功耗,定義為頻寬乘以佔空比。
僅啟動每個標記部分參數(使用稀疏矩陣)的混合專家模型也屬於此類:大多數加速器尚未針對稀疏激活模式進行最佳化,因此 NVIDIA 推出了 Tensor Core。它可能並非最終解決方案,而只是在等待更穩定可靠的方案出現期間的一個「硬體補丁」。
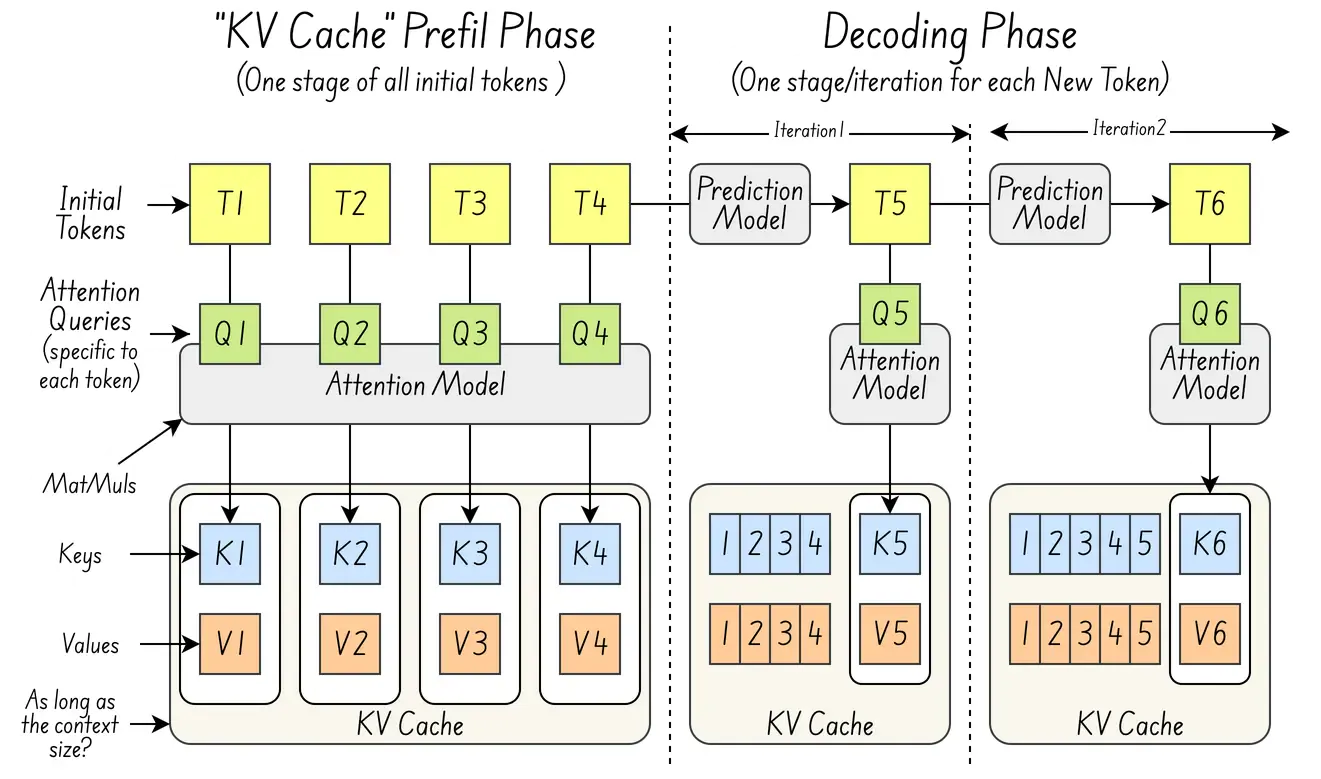 例如,現在通常採用預填/解碼 (PD) 分離來分離 LLM 的預填階段(從多個詞元建構初始鍵值快取)和* 一個字元*(一次產生一個字元*快取階段)。這為專用推理協處理器打開了大門,因為預填充需要更強的運算能力,而解碼需要更強的記憶體能力(需要為每個詞元載入新的鍵值快取)。
NVIDIA Tensor Core 用於稀疏混合專家模型,也屬於這一類。
推理定價在兩年內下降了約 10 倍。企業級 AI 的普及不再受模型品質的限制,而是受推理成本的限制。這意味著:通用推理硬體的價格已經低於高階硬體(NVIDIA H100/B200),無法滿足標準 LLM 服務的需求。這正是挑戰者們最有機會大展身手的地方。試想一下,如果能夠使用 Positron Asimov 處理器在通用硬體上運行 GLM5.2,那該有多棒!
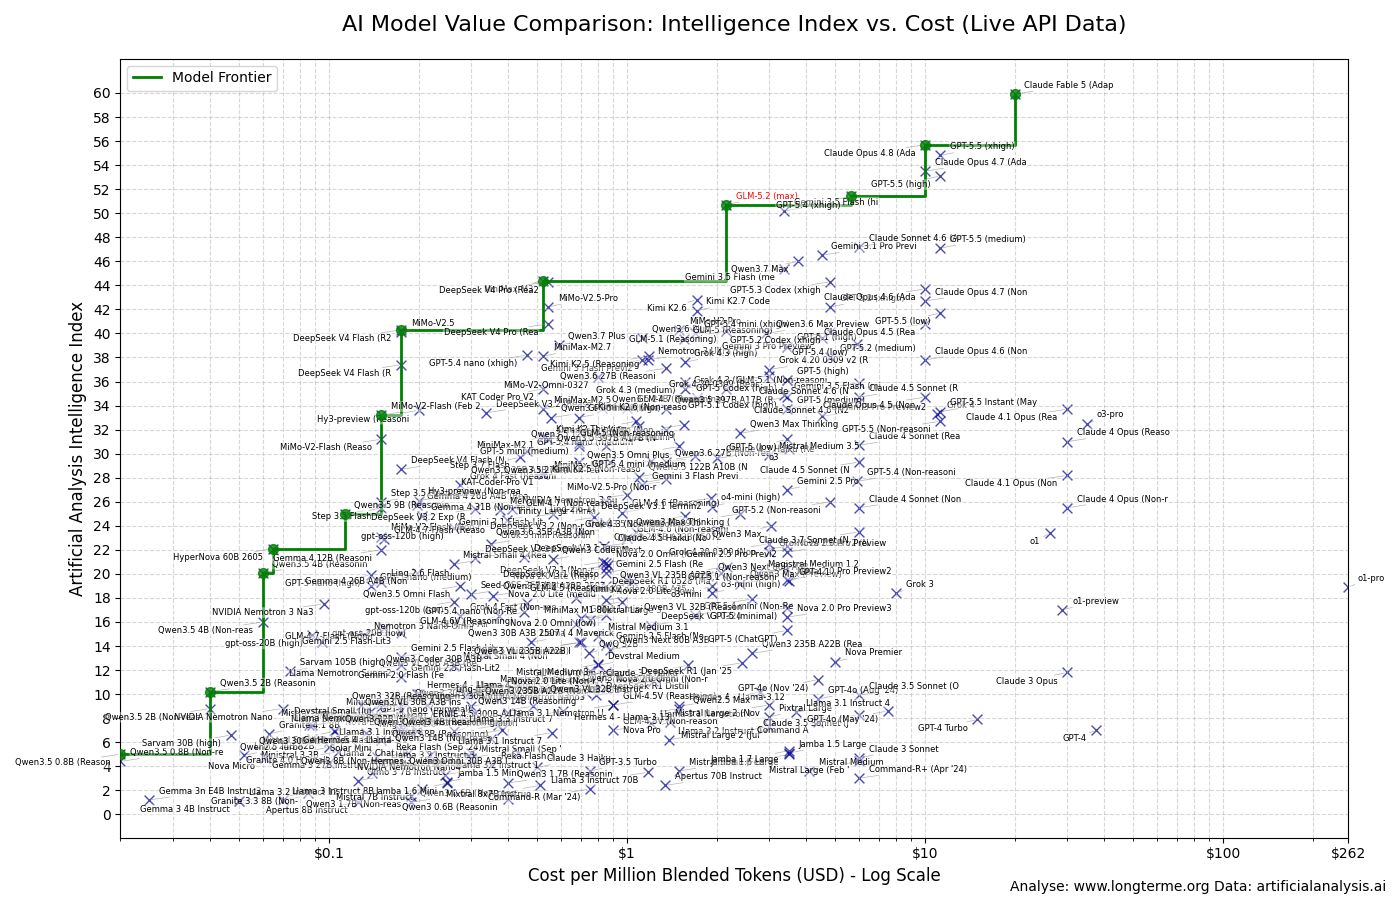 (圖片來源:L’Observatoire du Long Terme - Z AI GLM5.2 在智能/成本方面顯然是局外人 - 但需要接近 200GB 的內存)
企業往往低估了營運的複雜性。那些提供「盒裝推理」和零配置運行時環境(而不僅僅是晶片)的供應商將贏得企業錢包中不成比例的份額。
由於歐盟和亞太地區的監管壓力,對本地推斷的需求將會加劇這種情況,因為,是的,許多企業不希望將其專有知識推斷到外國系統中。
2024-2026 年的推理市場與 2000-2003 年的網路市場相當相似。 NVIDIA 就像當年的思科:佔據主導地位,產品設計過度,價格也高得離譜。問題不在於是否要在 NVIDIA 最擅長的工作負載上挑戰它,而在於 NVIDIA 在哪些方面過度服務於市場,以及在哪些方面,一款專用的替代方案能夠以 40% 的成本提供 80% 的性能。
同時,NVIDIA 也在大力投資生態系統,並將 CudaQ 和 NVQLink 等優秀的完全開源貢獻免費提供給社區,這將使任何 NVIDIA 的競爭對手更難贏得這些社區的支持。
瞧,這就是一份簡短而膚淺的周日早晨備忘錄。我還需要深入研究未來挑戰者的架構細節,幸運的是,今年夏天我至少可以就其中兩位挑戰者撰寫備忘錄。同時,下一份備忘錄將探討大家期待已久的話題(不少讀者都要求我談談):量子糾錯簡述!
# 參考
https://api-docs.deepseek.com/news/news260424
在多核異構神經形態平台 SpiNNaker2 上進行 SNN 推理](https://arxiv.org/pdf/2406.17049)
本備忘錄使用的DrawIO圖表: