Ralf Levien 以其高效實現的全球最快字形渲染引擎而聞名,該引擎採用了非常巧妙的基於 Rust 的 SIMD 設計。 2023 年我在 Bestechnics 設計 SIMD GPU 時,他的工作給了我很大的啟發。後來,Ralf Levien 也開發了該字形渲染引擎的 GPU 版本。
所以,當我偶然看到他關於「Rust 如何獲勝:追求高效能、高可靠性軟體」的最新演講時,我決定花一個小時觀看演講,並從中汲取任何值得學習的見解。
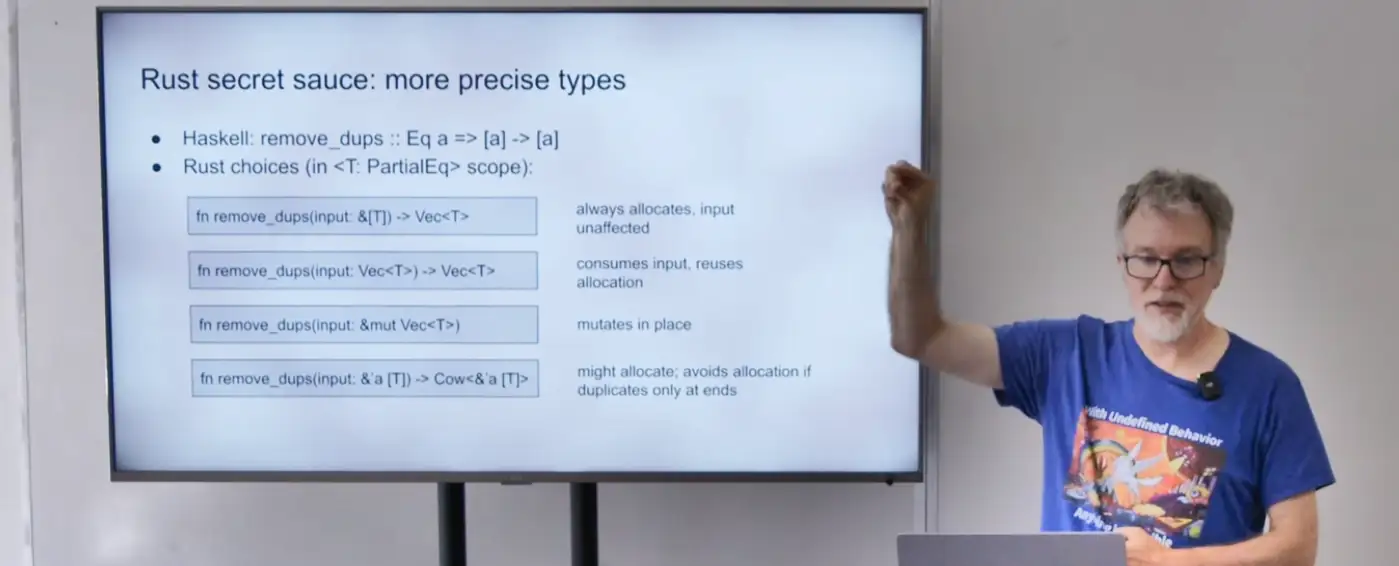
緊張的部分(也稱為溺水區)大約從 55:00 開始,幻燈片標題為「Rust 秘方:更精確的字體」。
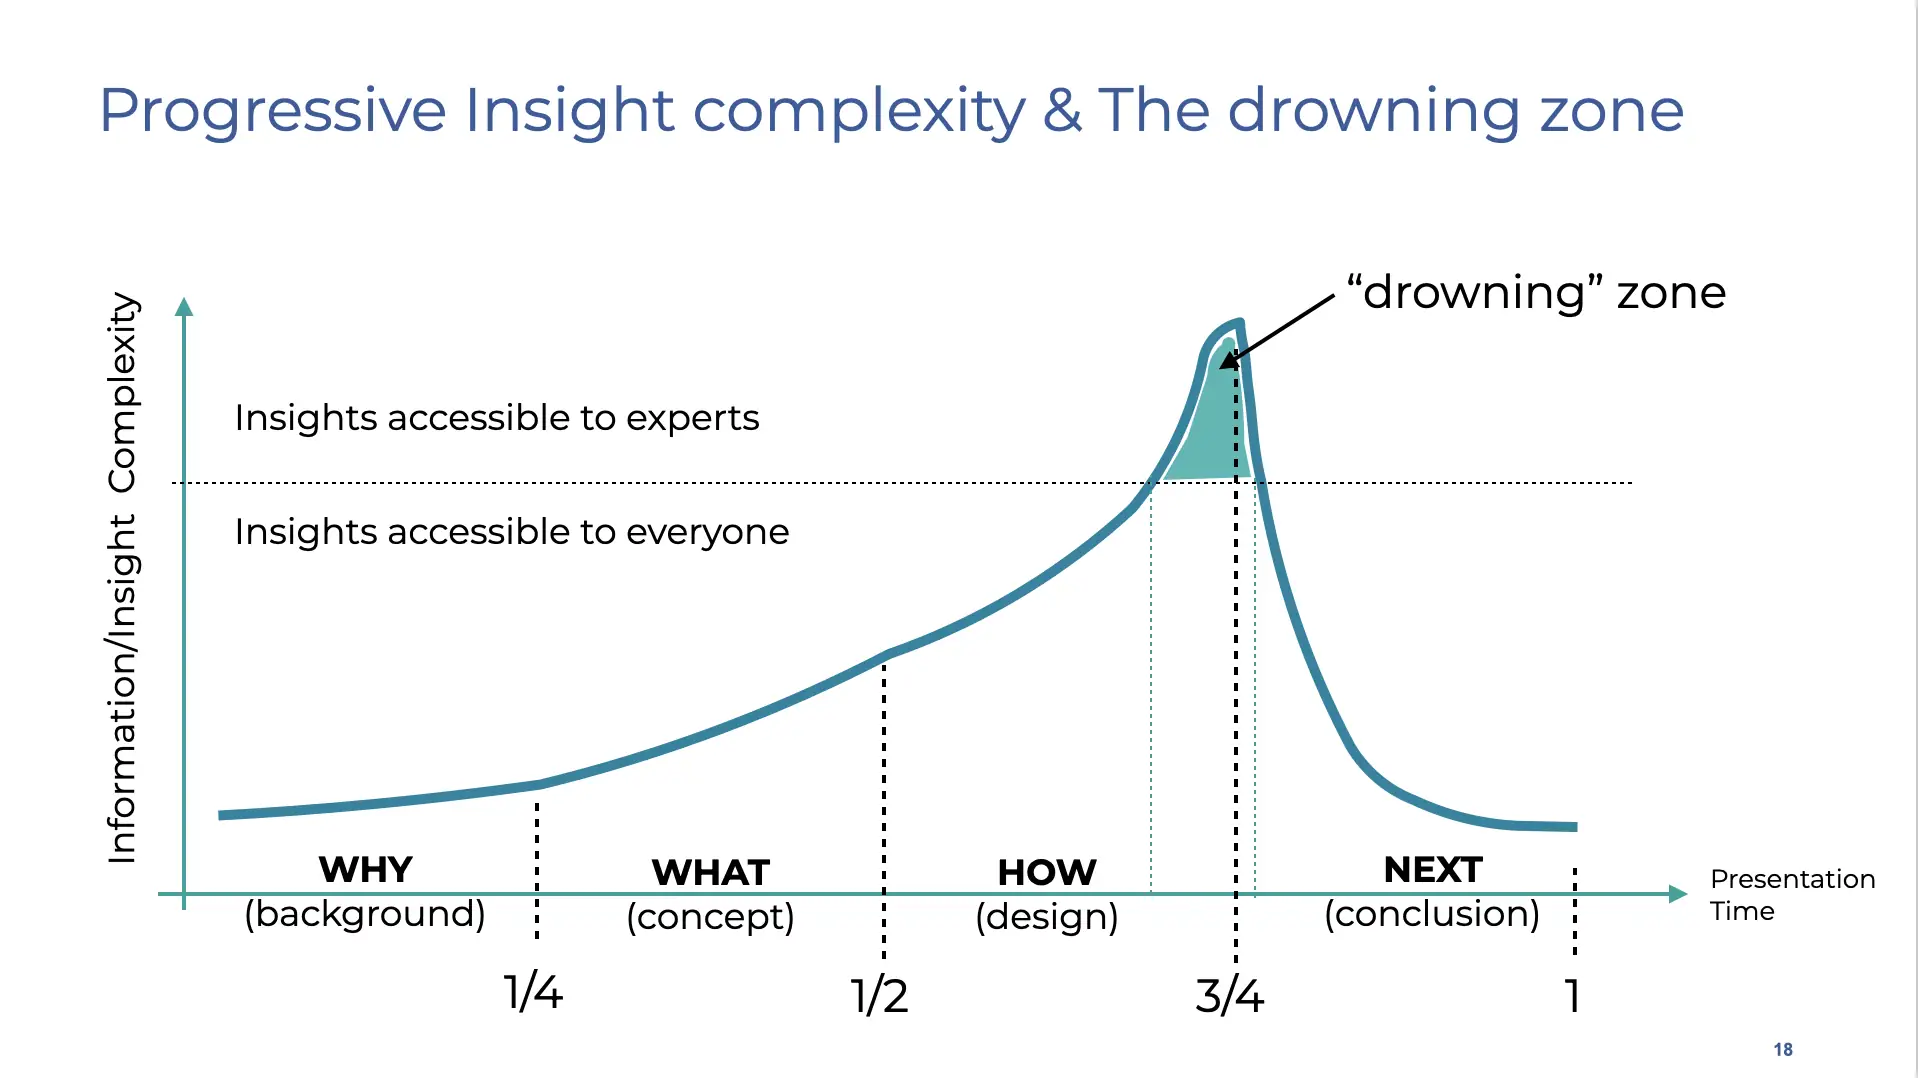
在 56 分 50 秒,Raph 說:“這就是仿射類型發揮作用的地方;你想把(可克隆性)建模為‘存在一個實例’;而這種類型允許你在函數簽名中仔細指定如何處理所有權;最後一個例子我就略過了,不過挺有意思的,對吧……”
我絕對不敢自稱是 Rust 專家,而且我承認自己更偏愛 Go——所以,問題是,我能理解 affine type 的真正意義嗎?能否用簡單易懂的語言解釋一下,而不用讓我淹沒在浩瀚的知識海洋中?
YouTube評論裡也提到了一個問題:最後一個函數的回傳類型應該是Cow<'a, [T]>,而不是Cow<&'a [T]>。說實話,這看起來比量子演算法還要複雜。但也許並非如此!
那麼,讓我們仔細看看這些「更精準的類型秘訣」的例子:
fn α( l: &[T] ) → Vec<T> : 始終分配內存,輸入不受影響
fn β( l: Vec<T> ) → Vec<T> : 消耗輸入並重複使用分配的記憶體。
fn δ( l: &mut Vec<T> ): 不進行記憶體分配,只是修改輸入向量
fn ω( l: &'a [T]) → Cow<'a,[T]>: 可能需要分配記憶體;如果重複項只出現在兩端,則避免分配記憶體。
通用模板 T 中首先要檢查的問題是:它真的能正常運作嗎?這些函數可以這樣編譯嗎?讓我們用最簡單的函數版本來試試看:
// fails with: error cannot find type T in this scope
fn α( l: &[T] ) -> Vec<T> { vec![] }
這顯然行不通,並會報錯「在此作用域中找不到類型 T」。如果您熟悉 C++,您就會知道類型 T 必須與函數名稱一起聲明,因此需要聲明 α。而不是 α。
// all right with the T declaration
fn α<T>( l: &[T] ) -> Vec<T> { vec![] }
這樣可以正常運作!但是,當新增一個基本實作(僅轉換為 vec,而不刪除重複項)時,編譯器會報錯,提示「trait bound T: Clone 未滿足」。
// fails with: the trait bound `T: Clone` is not satisfied
fn α<T>( l: &[T] ) -> Vec<T> { l.to_vec() }
幸運的是,Rust 對泛型和 traits 有非常好的文檔,閱讀 10 分鐘後,我們就能清楚地意識到需要修改 α。到 `α<T: Clone>作為表達T型性狀界限的一種手段。
// all right with the trait bound
fn α<T: Clone>( l: &[T] ) -> Vec<T> { l.to_vec() }
下一步是實現去除重複項的解決方案。為此,一種方法是使用 HashSet。首先,將陣列轉換為迭代器(let iterator: std::slice::Iter)。 = l.iter();),然後我們從該迭代器建立一個哈希集(HashSet::from_iter(iterator)),最後將哈希集轉換為向量set.into_iter().collect()`。
//Fails with: the trait bound `T: Eq` is not satisfied
use std::collections::HashSet;
fn α<T: Clone>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
不出所料,這失敗了!這很正常,因為如果你花了十分鐘閱讀 Rust 的 trait 文檔,就會知道 HashSet 可能需要某種能夠「比較」類型 T 的元素的方法。這就是 Eq trait 的作用——所以,我們只需將其添加到 trait 的邊界中(從 α 開始)。<T: Clone>到 α<T: Clone + Eq> ):
//Fails with: the trait bound `T: Hash` is not satisfied
use std::collections::HashSet;
fn α<T: Clone + Eq>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
它仍然失敗,原因是我們忘記提及類型 T 需要能夠轉換為雜湊值。這就是 Hash trait 的作用。所以,讓我們從 α 改為 T。<T: Clone + Eq>到 α<T: Clone + Eq + Hash>
//Fails with: a value of type `Vec<T>` cannot be built from an iterator over elements of type `&T`
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
這就是可克隆性樂趣所在:哈希集是一個結構體,其中包含指向列表中初始元素的指針,這些元素是按值傳遞的(準確來說,數組是通過指針傳遞的,而數組中的元素也是按值引用的)。因此,我們需要告訴哈希集複製這些元素,這可以透過在最後一個 collect 方法之前添加 cloned() 來實現(collect 方法用於將迭代器轉換為向量集合)。
// all right!
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().cloned().collect()
}
瞧,第一個函數範例就準備好了:
fn main() {
println!("{:?}", α(&["A","A","B","D"]));
println!("{:?}", α(&[1,1,2,4]));
}
說實話,這既複雜又不複雜。說它複雜,是因為編譯器強制執行嚴格的規則,這些規則必須明確聲明,而不能隱式推導,因此學習曲線陡峭。說它不複雜,是因為一旦你花了「10分鐘」閱讀文檔,事情應該就會變得容易一些。也許問題不在於閱讀文件需要10分鐘,而是要理解文件的內容需要10小時。這感覺似曾相識…
第二項挑戰:仿射類型
關於可克隆性,我還有一個問題。我們能否傳回一個只包含對數組中傳入元素的引用的向量?乍一看,似乎只需要修改 Vec 即可。將 Vec<&T> 轉換為 Vec<&T>…並正確處理仿射型約束?讓我們試試看:
// All right - works fine
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<&T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
嗯,這樣可以!而且沒有關於生命週期的問題?我的意思是,我們是不是在藉用元素,所以我們應該檢查生命週期才對?是不是我們的 main 函數太簡單了?那麼,讓我們來試試更複雜的情況:
// fails with expected named lifetime parameter
fn limited_lifetime() -> vec<&str> {
let l = ["A","A","B","D"];
α(&l)
}

fn main() {
let v = limited_lifetime();
println!("{:?}",v);
}
這次失敗了:編譯器報錯說缺少生命週期參數,所以我們不妨花這額外的 10 分鐘閱讀一下 Rust 文件中關於「使用生命週期驗證引用」的部分(https://doc.rust-lang.org/book/ch10-03-lifetime-syntax.html)。乍一看,我們似乎只需要添加一個“a”?
//  fais with: mismatched types; expected `&[str]`, found `&[&str; 4]`
fn limited_lifetime<'a>() -> Vec<&'a str> { ... }
但是不行,這樣做行不通。我們來嘗試將“不可變字串”轉換為動態字串:
// fails with: cannot return value referencing local variable `l`
fn limited_lifetime<'a>() -> Vec<&'a String> {
let l = ["A".into(),"A".into(),"B".into(),"D".into()];
α(&l)
}
好的,這確實是我們預期的錯誤——借用檢查器確實在工作。但是,我們該如何告訴編譯器,我們希望轉移這些局部分配變數的所有權呢?要實現這一點,我們需要告知編譯器,我們希望將陣列 l 分配到堆上。為此,我們需要使用 vec 而不是陣列。
// this works
fn β<T: Clone + Eq + std::hash::Hash>( l: Vec<T> )  -> Vec<T> {
let hash_set: HashSet<_> = l.into_iter().collect();
hash_set.into_iter().collect()
}

fn limited_lifetime<'a>() -> Vec<&'a str> {
let l2 = vec!["A","B","B","D"];
β(l2)
}

fn main() {
println!("{:?}",limited_lifetime());
}
這個版本之所以有效,是因為新的 β 函數接受一個元素向量,並傳迴向量中的元素本身,而不是指向這些元素的指標。因此,元素被克隆了。但如果我們希望 β 函數傳回指向輸入元素的指標呢?
第三項挑戰:寫入時克隆
還記得最後一個 omega 函數中的「Cow」嗎?
fn ω( l: &’a [T]) → Cow<&’a [T]>
Cow 實際上是一個列舉型別。它可以保存一個不可變的(借用的)引用,也可以保存同一個物件的可變克隆。例如:
use std::borrow::Cow;
fn trim_input(input: &str) -> Cow<str> {
if input.ends_with(' ') {
Cow::Owned(input.trim_end().to_string())
}
else  Cow::Borrowed(input)
}
那麼,我們應該寫 Cow<'a [T]> 還是 Cow<&'a [T]> 呢?乍一看,由於輸入是指向類型為 [T] 的物件的指標 &,其生命週期為 'a,因此輸出也是指向相同類型物件的指標。差別在於 Cow<> 本身也表示指標。所以,正確答案應該是 Cow<'a, [T]>。
fn ω<'a, T>( l: &'a [T]) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
有趣的是,在 Rust 中,陣列的長度在編譯時就已經確定了。那麼,我們如何在運行時分配一個動態大小的新陣列呢?顯然,根據這篇 stackoverflow 評論 的說法,這是不可能的。也許 Ralf 原本想用的是 vec 型?
fn ωx<'a, T: Clone + Eq + std::hash::Hash>( l: &'a Vec<T>) -> Cow<'a, Vec<T>> {
let hash_set: HashSet<_> = l.into_iter().collect();
if hash_set.len()==l.len() {
return Cow::Borrowed(l);
}
let own_copy = hash_set.into_iter().cloned().collect();
return Cow::Owned(own_copy);
}
說實話,我必須承認,我被語法“fn ω<‘a, T>( l: &‘a [T]) -> Cow<‘a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }”難住了,它本應只是表示“同一個的克隆”。
如果我們認為 &'a T 可以改寫為 Ptr<'a,T>,那麼我們也可以將函數改寫為:
fn ω<'a, T>( l: Ptr<'a, [T]>) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
如果我們忽略 T 是一個陣列這一事實,上面的程式碼可以重寫為:
fn ω<'a, T: ToOwned>( l: Ptr<'a, T>) -> Cow<'a, T> { Cow::Borrowed(l) }
那麼,如果將類型重寫為基於巨集的表達式而不是語法呢?
fn ω<'a, T>( l: Ptr<'a, T> ) -> !Cow(l) { Cow::Borrowed(l) }
透過允許重寫,!Cow(l) 巨集可以隱式地表示類型 T 必須綁定到 trait ToOwned。這樣看來,我們可以預見 'a 和 T 是泛型類型,在使用 Ptr trait 時無需明確指定。
fn ω( l: Ptr ) -> !Cow(l) { Cow::Borrowed(l) }
那麼令人困惑的是,我們同時指定了編譯時類型和運行時實現,卻沒有任何區別。但也許這正是 Rust 的本質所在?
# 結論
我認為拉爾夫的「秘訣」需要花一個小時才能解釋清楚,而且應該專門做一套幻燈片——而不是僅僅在一小時的演講中用三分鐘就講完。對它進行批判性的審視也很有價值;也許它並非處處都那麼有趣?也許其中存在一些過度設計,導致不少開發者望而卻步?而這或許正是它所謂的「樂趣」所在?總之,我會在接下來的幾週內嘗試準備一些投影片,以便進行一個小時的演講。
回到量子運算的挑戰——問題在於,我們是否需要類似的複雜度才能讓量子運算系統運作?這或許才是當今的挑戰?儘管量子演算法看似複雜,但與這種原始的Rust語法相比,它們其實相當簡單。或許我們需要更進一步,才能解決量子運算的「實用性」挑戰?而如果沒有這種額外的複雜性,我們或許還是只能進行一些基本的計算?
假設這一切都與我們想要操縱的物件語義有關,那麼或許我們需要意識到,在量子位元之上存在著一個邏輯抽象層,而這個抽象層目前還不明顯,因為業界仍在努力使量子位元正常運作。