使用人工智能,更准确地说是神经网络(NN),不仅是显而易见的,而且几乎是2025年任何系统的必备组成部分。毫不奇怪,关于这一主题的研究论文层出不穷。然而,最新的研究通过将神经网络高效集成到量子控制系统中,将这一领域推向了新的高度。
本文以新加坡量子技术中心 CQT/NUS 的工作为基础,更具体地说是以 Arthur Strauss 的研究为基础。我有幸在上一次 SQA 活动中与他进行了讨论和交流。
他们的想法非常吸引人:利用强化学习方法,基于旨在最大化控制效率的奖励机制,帮助量子控制系统调整量子比特的控制(即量子门)。你可能会问,这有什么意义呢?正如前文(link)所述,量子比特是非常敏感的“实体”,需要格外关注。而神经网络的作用就在于此,它能够帮助量化这种关注的质量,也就是我们常说的保真度。
这是如何工作的?强化学习基于观察/动作的循环,通过迭代的环境 -> 智能体奖励系统(下图中的“a”)进行学习,通常使用 GPU 运行,然后,一旦学习完成,就在紧密耦合的矩阵乘法器(或不!)上执行,在量子控制系统(下图中的“b”)上执行。
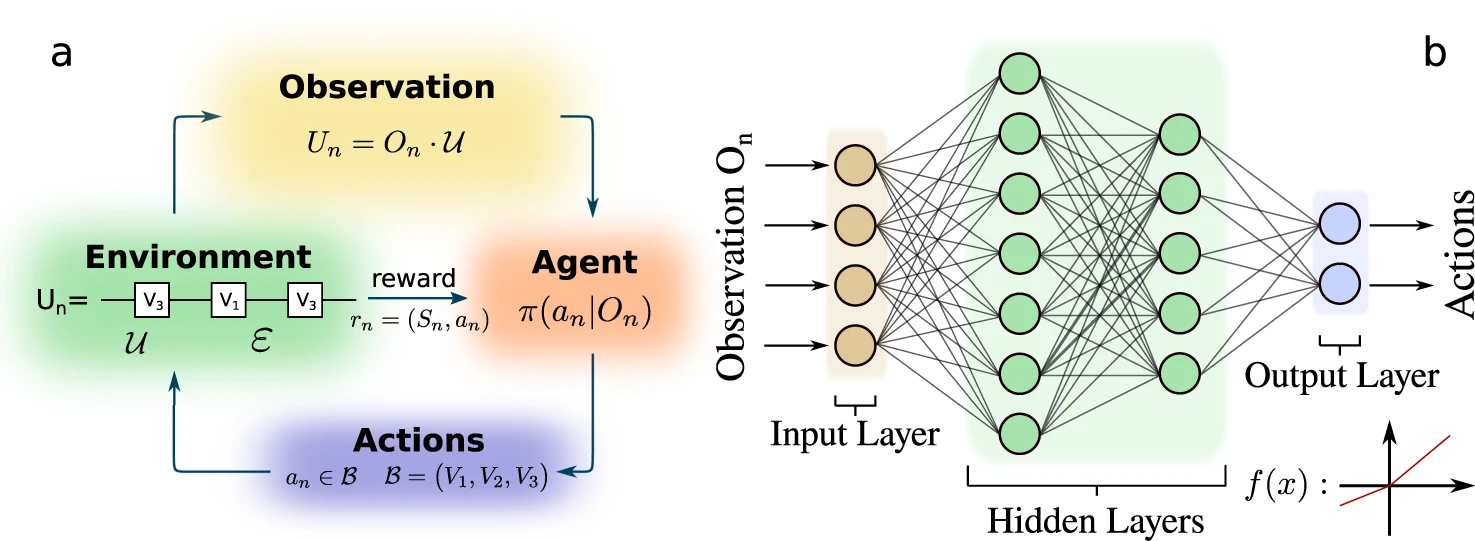 图片来源:Nature
请注意,由于观测(也称为量子比特读出)会破坏量子态,因此学习周期首先重置量子比特状态,执行控制门,读出量子比特状态,并将信息反馈给代理。
强化学习系统:关键组件
链接到标题
让我们详细了解一下强化学习的 4 个组成部分:
*环境即量子控制器和量子比特本身。
- 这些操作是调整射频发生器引擎的不同“旋钮”或脉冲参数。
*观察结果是量子比特在受到环境操纵后的特性。
- 代理* 学习对观察到的量子比特特征做出反应的策略,并相应地调整脉冲参数。
强化学习系统:学习方法
链接到标题
强化学习方法通常可以分为两大类:基于价值的方法和基于策略梯度的方法。
基于价值的方法侧重于估计价值函数并从中导出策略。基于策略梯度的方法通过梯度上升最大化预期累积奖励来直接优化策略。
策略迭代的优势在于其收敛速度远快于基于值的策略,尽管计算成本更高。而策略梯度算法正是通过降低计算复杂度来发挥作用。策略梯度算法示例,包括 reinforce 算法:
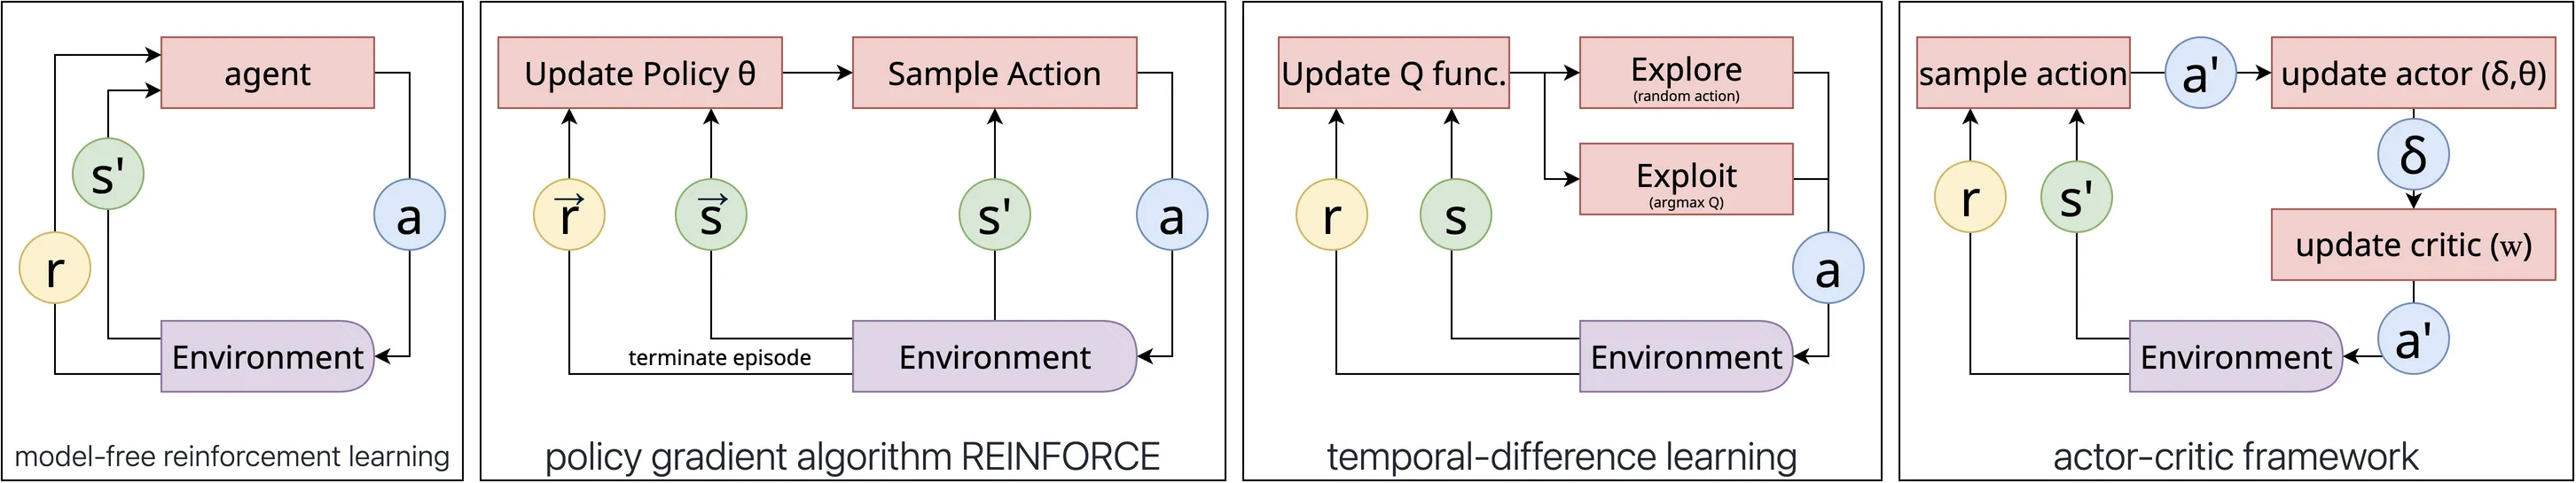
在上图中,“s”代表状态,“a”代表动作,“r”代表奖励。
强化学习系统:迭代与回合
链接到标题
在强化学习中,回合和迭代是不同的概念:
集数:
一个事件是智能体与环境之间一系列完整的交互,从初始状态开始,到终止状态结束(或达到最大时间范围后)。
例如:在国际象棋比赛中,一集就是一局完整的比赛——从棋盘开始到将死、和棋或认输为止。
迭代:
在某些论文/代码中,一次迭代可能意味着智能体与环境交互的一个时间步(状态→动作→奖励→下一个状态)。
在优化上下文中,一次迭代可能意味着学习算法的一次更新步骤(例如,一次梯度下降步骤,该步骤可能基于多个回合或转换)。
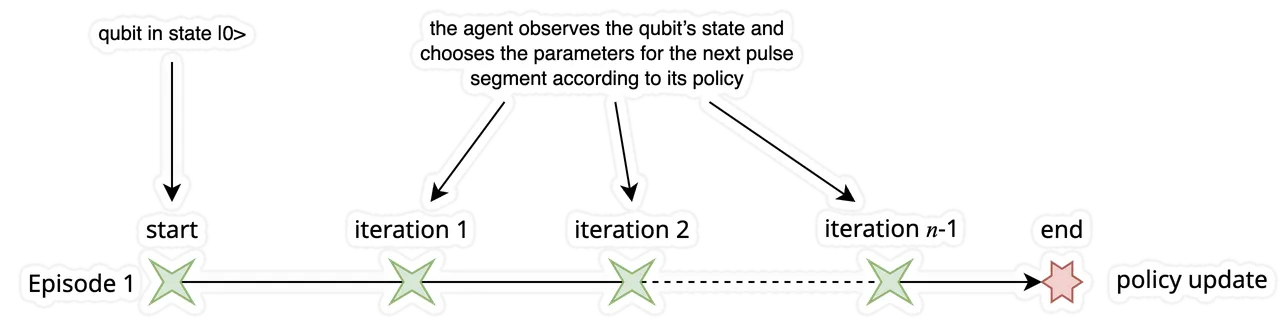
让我们逐一实现这些想法,首先从剧集抽样开始。
在策略梯度强化学习中,得分和奖励共同驱动学习更新:
深入体验:Flax 和 Jax
链接到标题
待完成
# 结论
抱歉,原本想写一篇轻松的博客,结果却变得复杂得多。或许我还需要继续“简化问题”。无论如何,我们从中学到了什么呢?优化量子比特质量的过程涉及的维度太多——不出所料,神经网络非常擅长应对这一挑战。这篇博客我们主要关注的是单量子比特的保真度优化。但如果是两个或更多量子比特呢?那就需要考虑串扰的影响。这其中有很多问题和挑战,尤其是在如何学习方面:是在多量子比特层面进行全局学习,还是在量子比特对层面进行局部学习?甚至可能是在逻辑量子比特层面进行分层学习。这些问题我将在下一篇关于量子纠错的博客中探讨。
延伸阅读及链接: