在人工智能能耗巨大的今天,张量处理单元(TPU)的出现改变了游戏规则。它是谷歌专门为机器学习任务定制设计的芯片。
这份简短的备忘录旨在提供 TPU 架构的高级系统视图,以及自 2016 年诞生以来 TPU 的发展演变。
我还会尝试回答这个关键问题:既然我们已经有了GPU,为什么还需要TPU?TPU有哪些GPU所不具备的优势?它们与神经形态集成电路相比如何?除了TPU和GPU之外,还有其他架构可供选择吗?
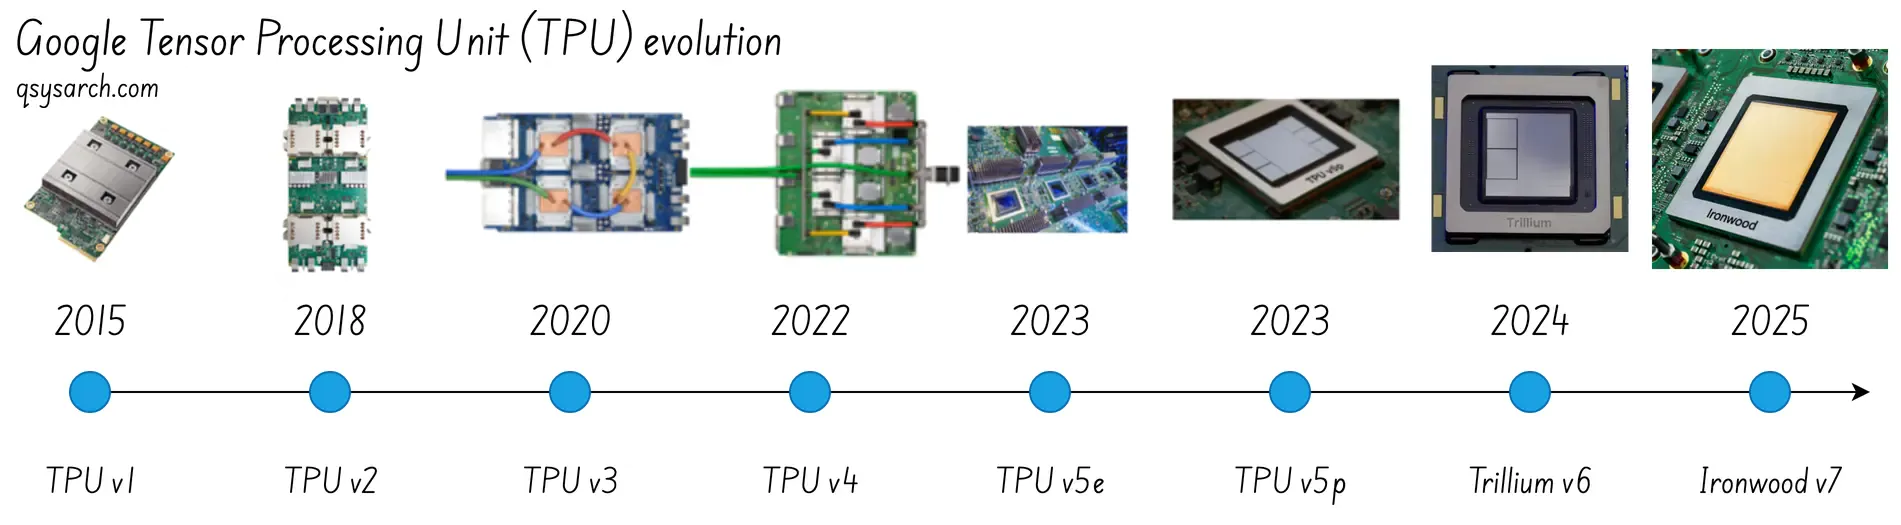 (来源:Google Cloud)
TPU存在的意义——以及它解决了哪些问题
链接到标题
TPU 与 GPU 有着相同的目标:通过实现大规模并行性来克服摩尔定律减缓带来的限制:与可用于处理通用计算的传统 CPU 不同,传统 CPU 在一定程度上通过多核概念实现了一定程度的并行性(这要归功于丹纳德缩放定律),TPU 和 GPU 是专门设计的硬件,用于处理简单和特定的任务,但效率远高于任何 CPU。
从宏观层面来说,可以说它们通过“牺牲通用性来换取性能”的方式,提供了比通用 CPU 或 GPU 更优异的性能和效率。
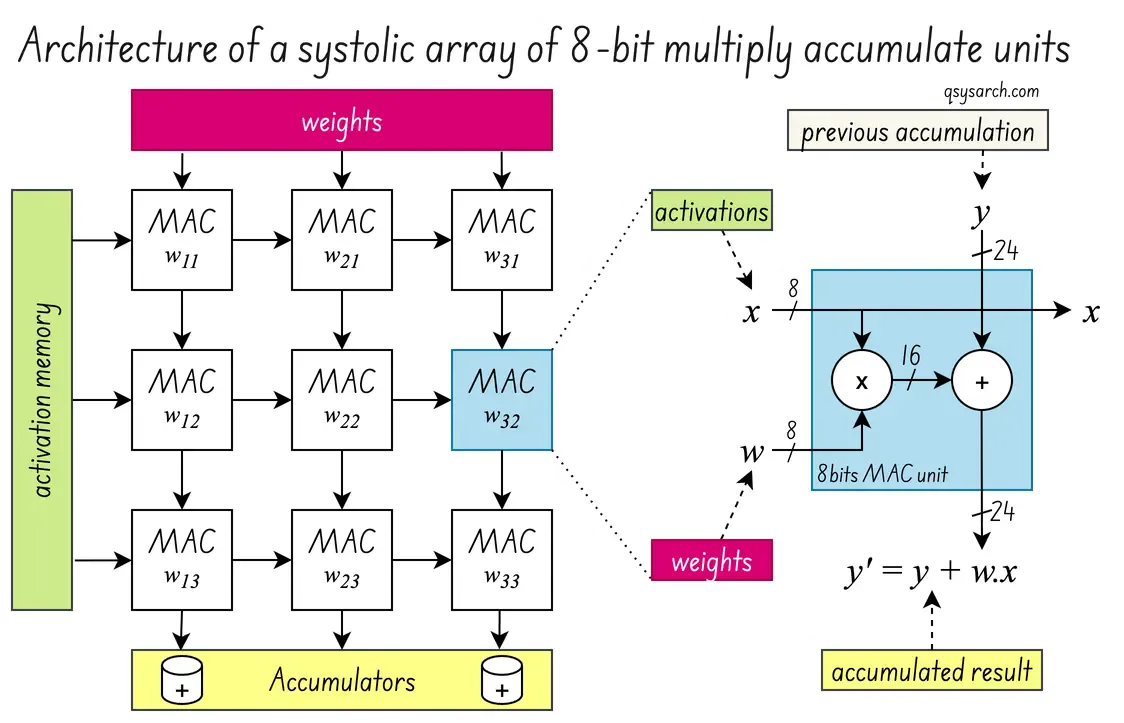
TPU 从根本上来说是为神经网络使用的繁重线性代数任务而设计的,例如矩阵乘法和张量运算。
TPU 的核心是脉动阵列,它是一个处理单元矩阵(通常称为 PE,在右图中表示为 MAC),可以执行并行计算。
以 TPU 为例,这个处理单元(或称 MAC)是一个简单的 8 位乘法器,它将激活值(嵌入向量)与神经网络的权重相乘并累加。只有通过大规模并行执行此操作,TPU 才能实现比 CPU 高得多的吞吐量。GPU 也是如此!但首先,让我们回顾一下 TPU 的发展历程。
TPUv1:第一代 TPU
链接到标题
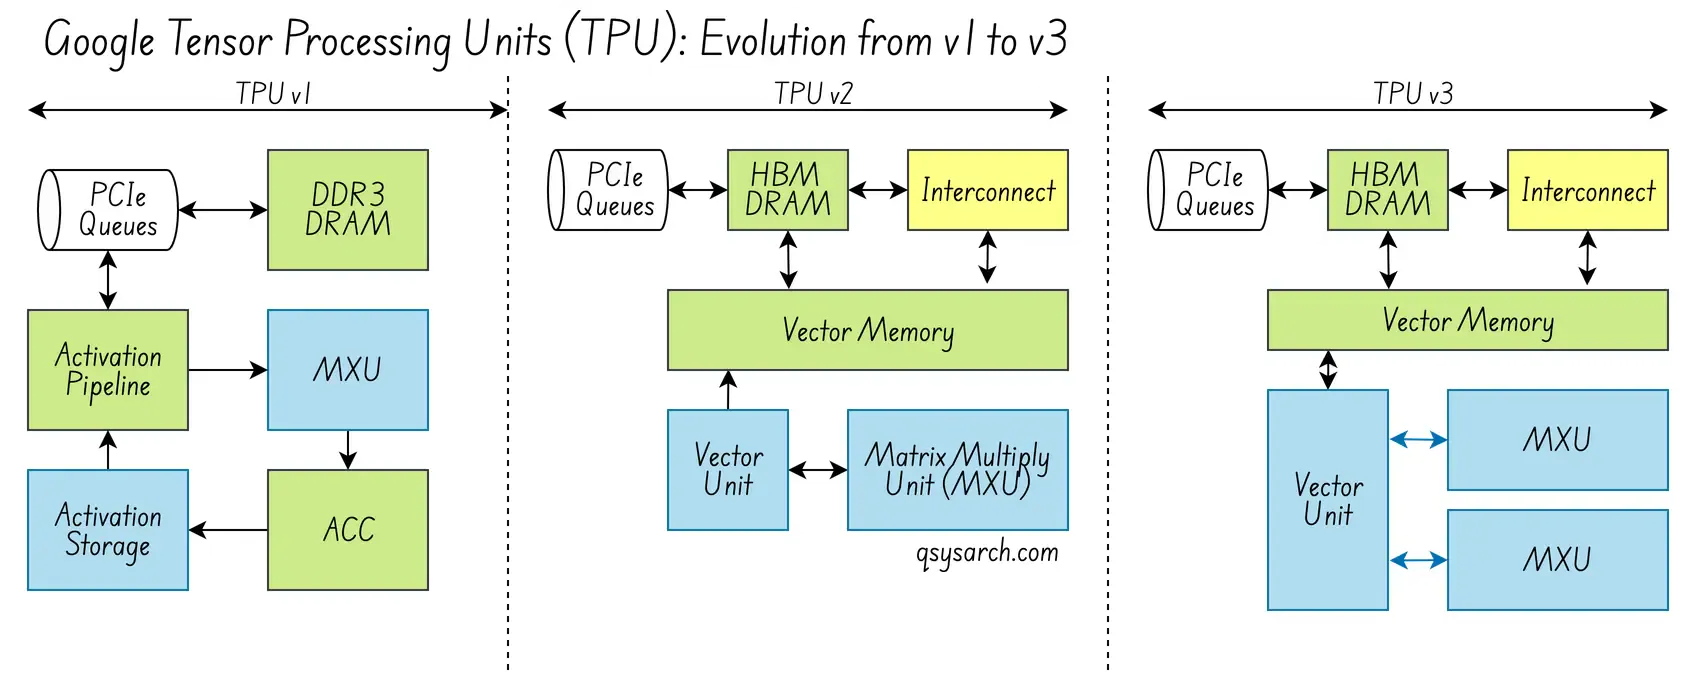
TPUv1仅用了15个月就开发完成,其主要目标是提升神经网络的推理能力(并非学习能力,而仅仅是推理能力)。为此,谷歌需要矩阵乘法器,并且不仅要保证高速运行,还要降低功耗。降低功耗的关键在于提高内存局部性,例如减少外部存储器和TPU内存之间不必要的数据传输。这将提高单位控制时间的运算强度,即减少TPU等待数据的空闲时间。
从硬件角度来看,TPU v1 的设计简洁明了,却又十分有效:
复杂性转移到了软件调度程序,它主要负责两项任务:
TPUv2 和 v3:改进内存和互连
链接到标题
v2 和 v3 的关键概念是训练下一代模型,这些模型需要反向传播、更高的精度和更多分布式、互连的 TPU。
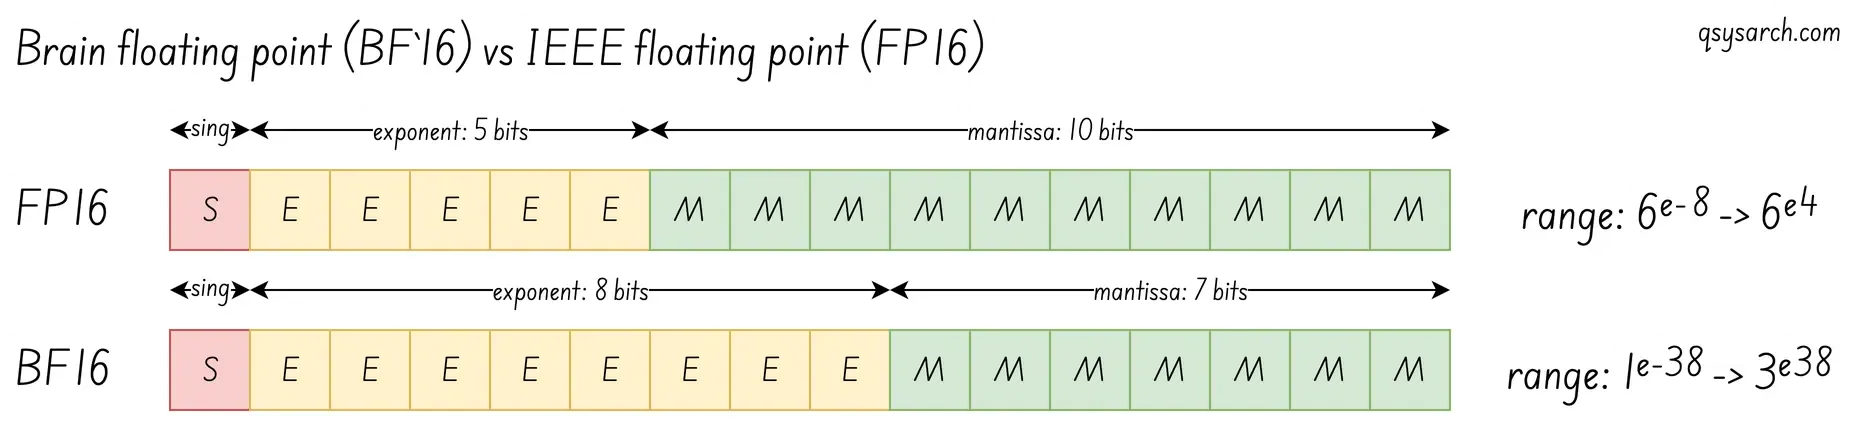
从硬件核心处理的角度来看,他们引入了一些相当不错的概念:
- 双核芯片,例如一个__TPUv2__由两个TPU组成
每个 TPU 都有一个大四倍的收缩期阵列,由 128*128 MXU 组成。
从硬件连接的角度来看,
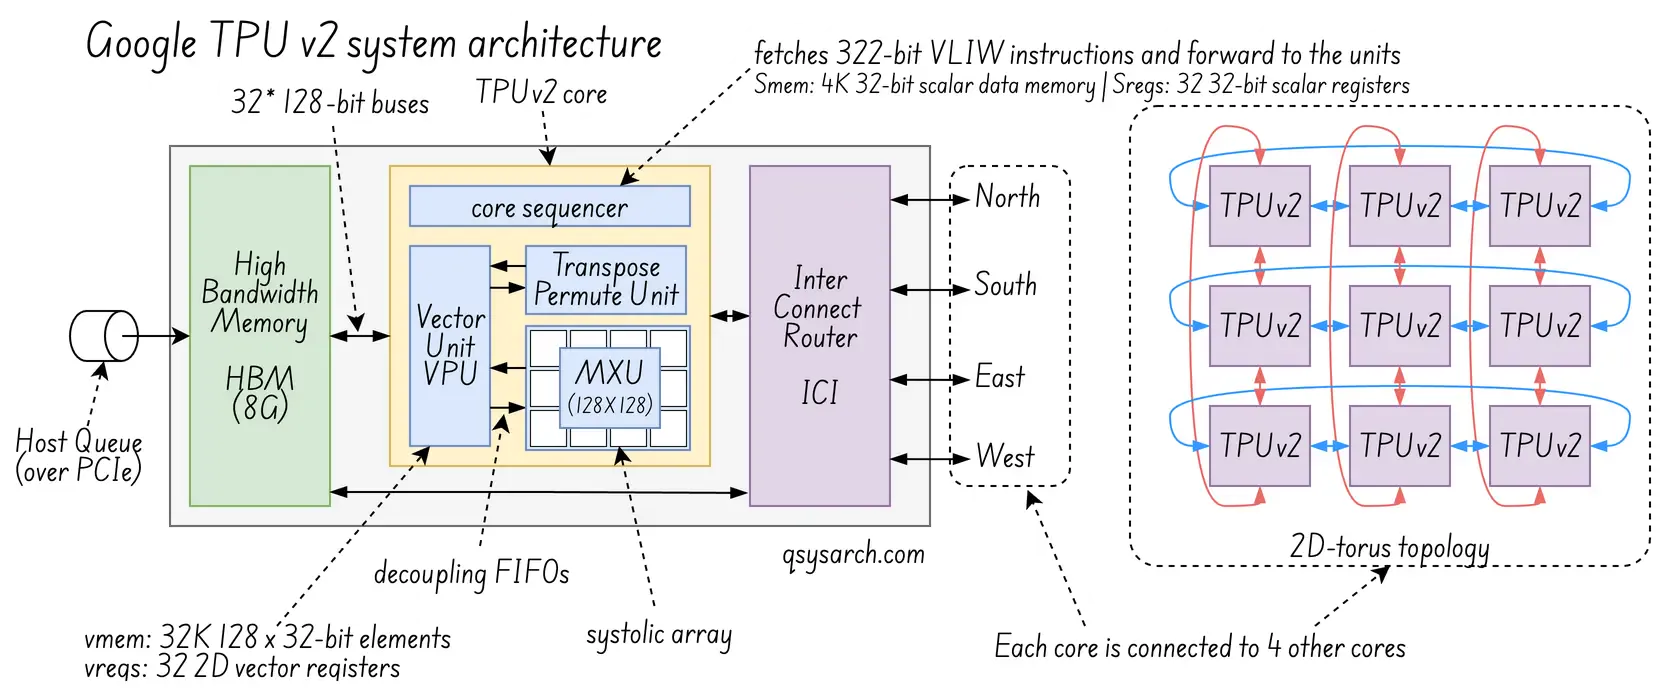
- 核心间互连 (ICI),即高带宽结构,可通过 16x16 2D 环形网络(环网)实现扩展 - 256 个芯片的超级计算机组。
从软件角度来看,一个强大的编译器:
- XLA 编译器: 生成核心序列器 (TCS) 使用的 VLIW 指令的大脑。
TPUv4:超大规模人工智能
v4 版本的核心概念是能够以超大规模运行 AI 模型。这意味着关键的驱动指标是总拥有成本 (TCO)。
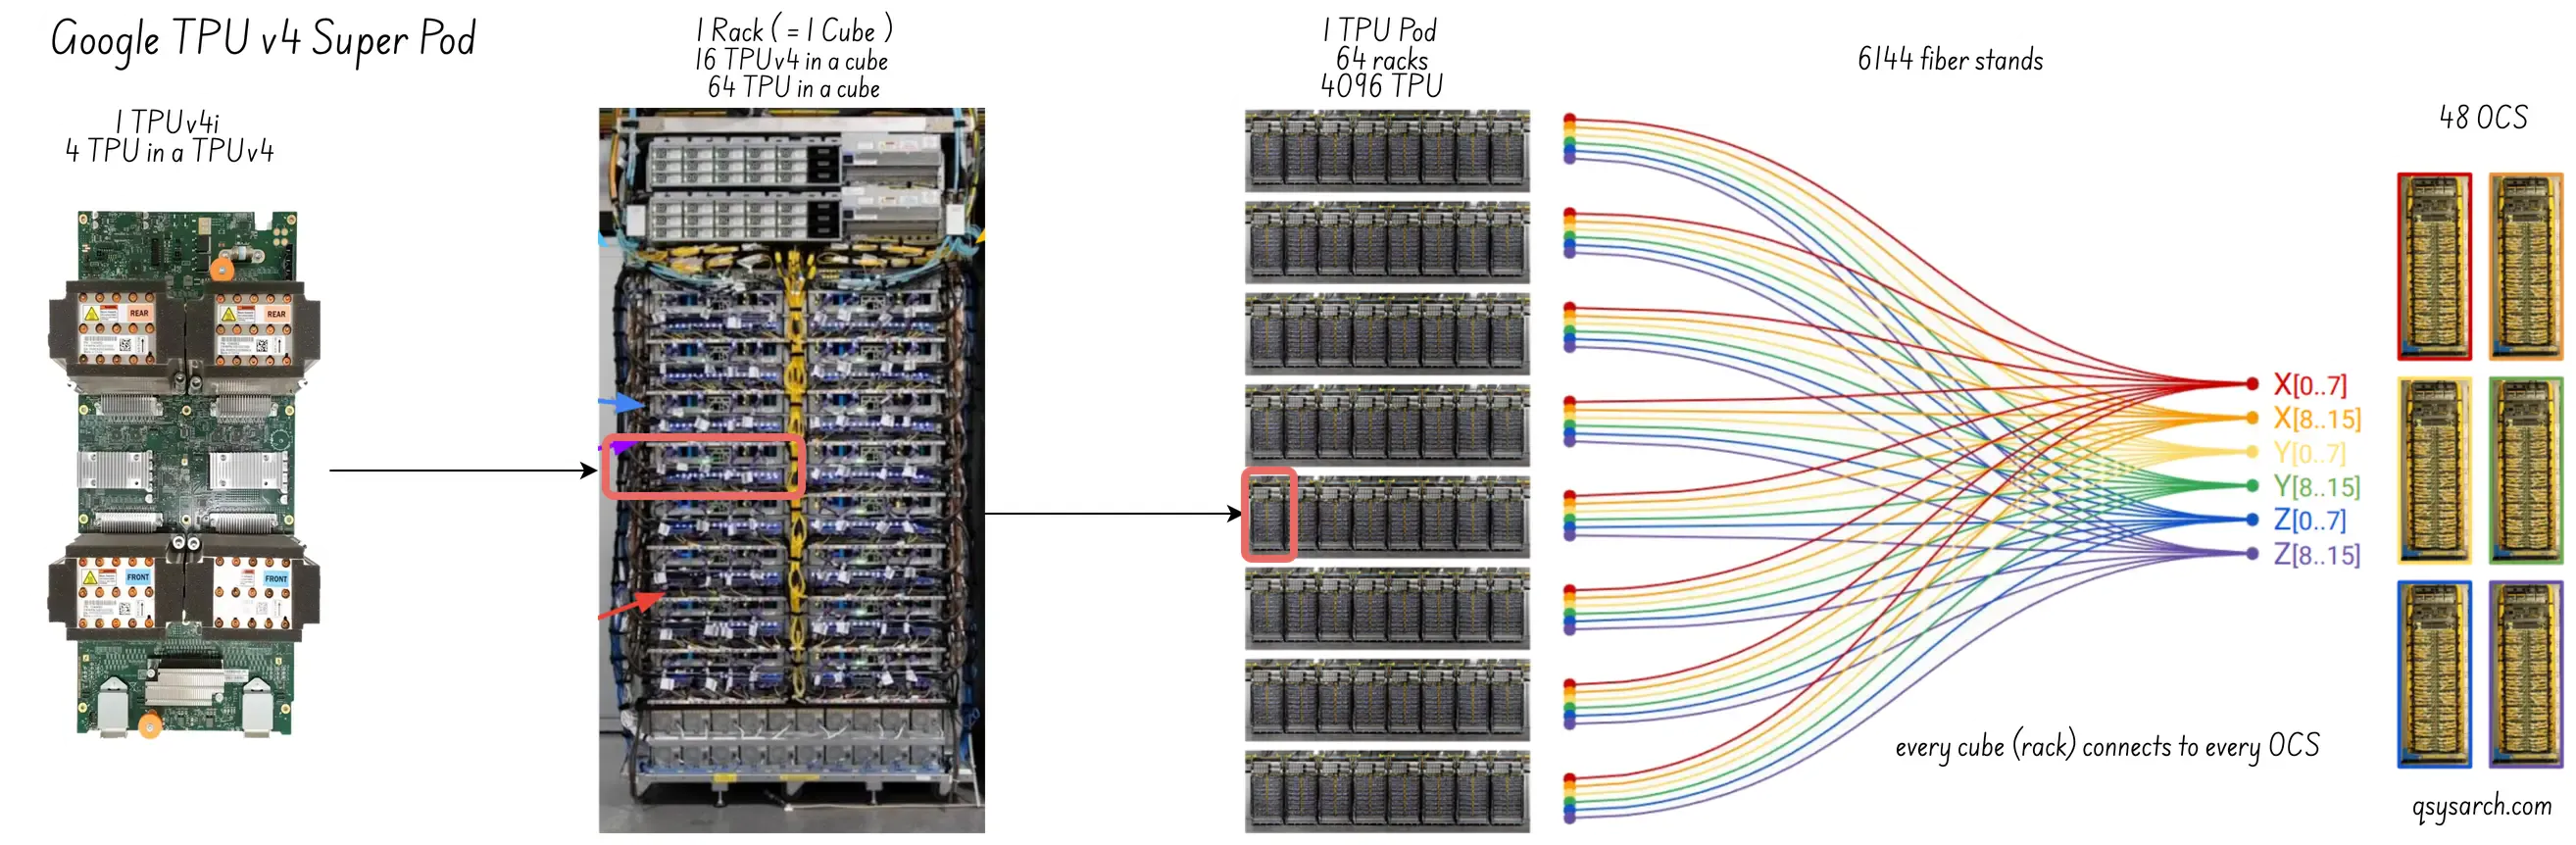
最新一代的超级计算机专为大规模训练而设计。芯片以机架或芯片组的形式连接,配备先进的存储系统和互连技术。它们支持大型张量运算、分布式训练、同步以及跨多个芯片的高效数据共享。
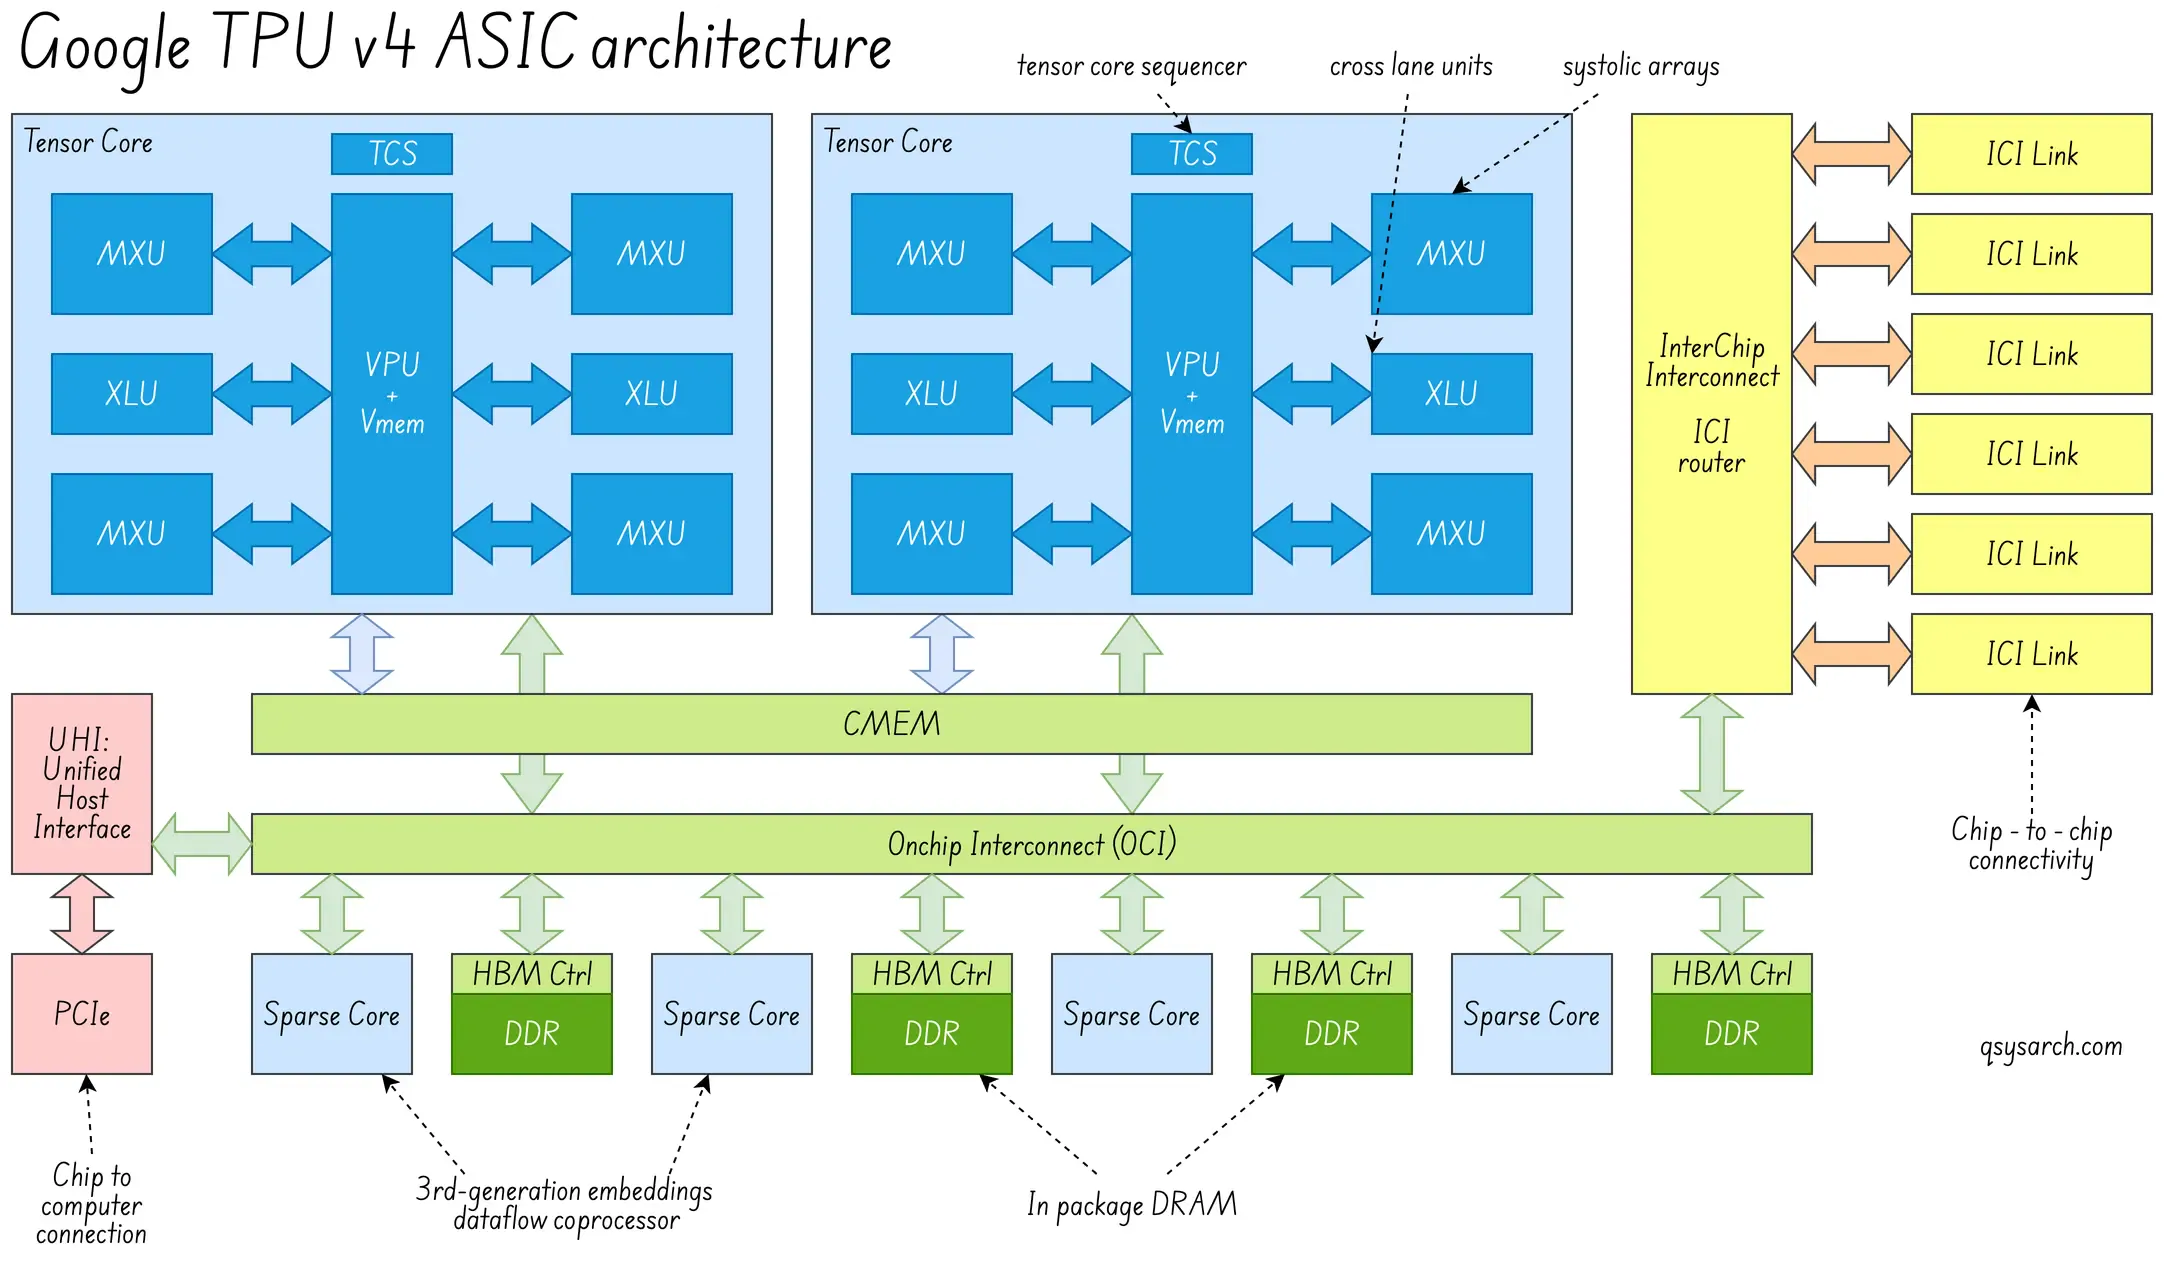
从硬件核心处理的角度来看,他们引入了一些相当不错的概念:
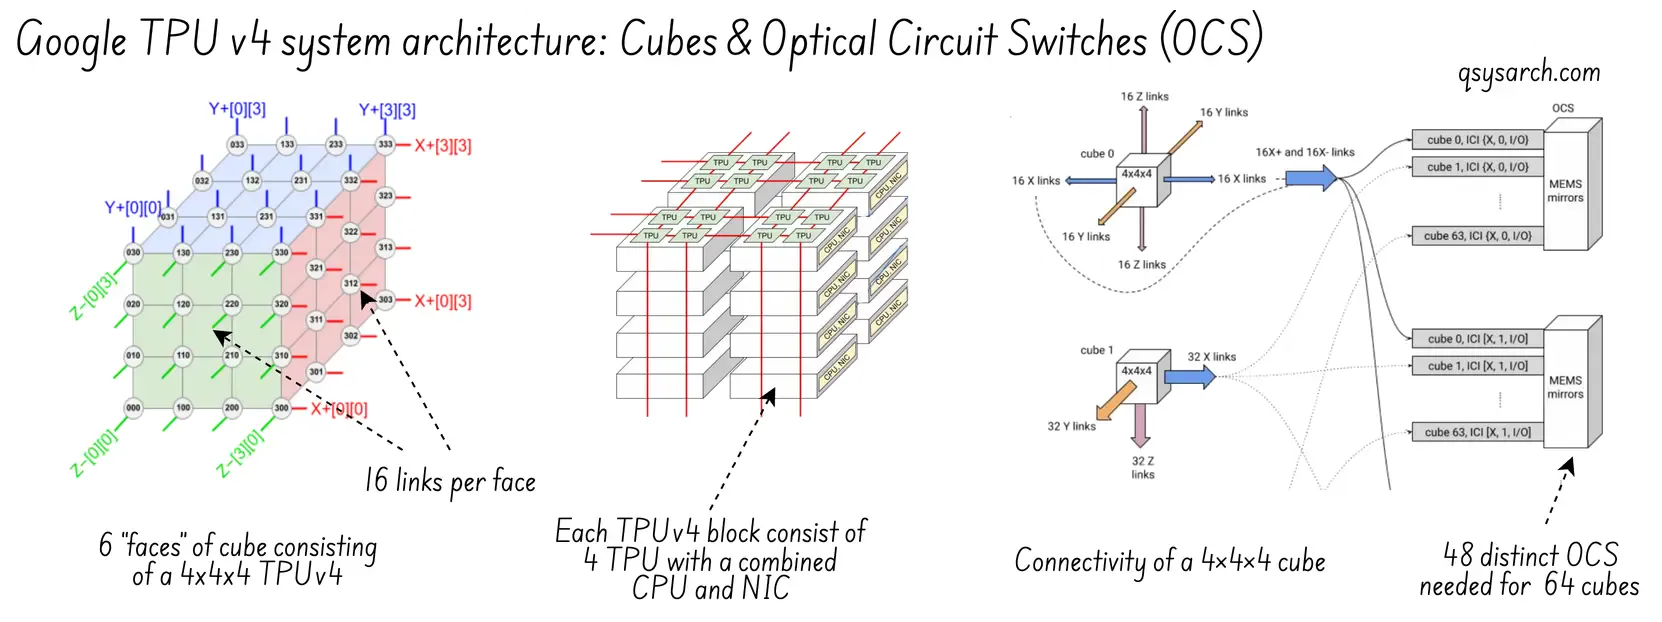
从硬件连接的角度来看,
最后,也是最重要的一点,通过实现三维环面,路由现在变成了三维的,这具有不可忽视的优势,可以比二维环面更好地扩展通信效率。
从软件工程师的角度来看:
引入新工具:Borg 作为集群管理器;pod 管理器用于配置 OCS;Libpunet 用于设置 ICI 路由表并处理容错问题。
高级单程序多数据 (SPMD) 编译器:可以将其视为一种生成多个线程的编译器,其中每个线程都是一个程序,可以运行在同一机架内的不同 TPU 上,也可以运行在不同的 TPU 上。它与 GPU 的 SIMT 概念有些类似,后者为 GPU warp 内的线程生成代码。
由于许多 TPU 运行的是同一个程序,Borg 协调器需要确保所有 TPU 都是同步的——这就是 Gang Scheduler 的作用。
TPUv4 中的 SparseCore(简称 SC)负责加速稀疏矩阵工作负载,其中大部分值都是零或冗余值(例如 LLM 中的嵌入)。它被描述为“嵌入查找”优化器,每个 TPUv4 都包含四个 SparseCore 处理器。
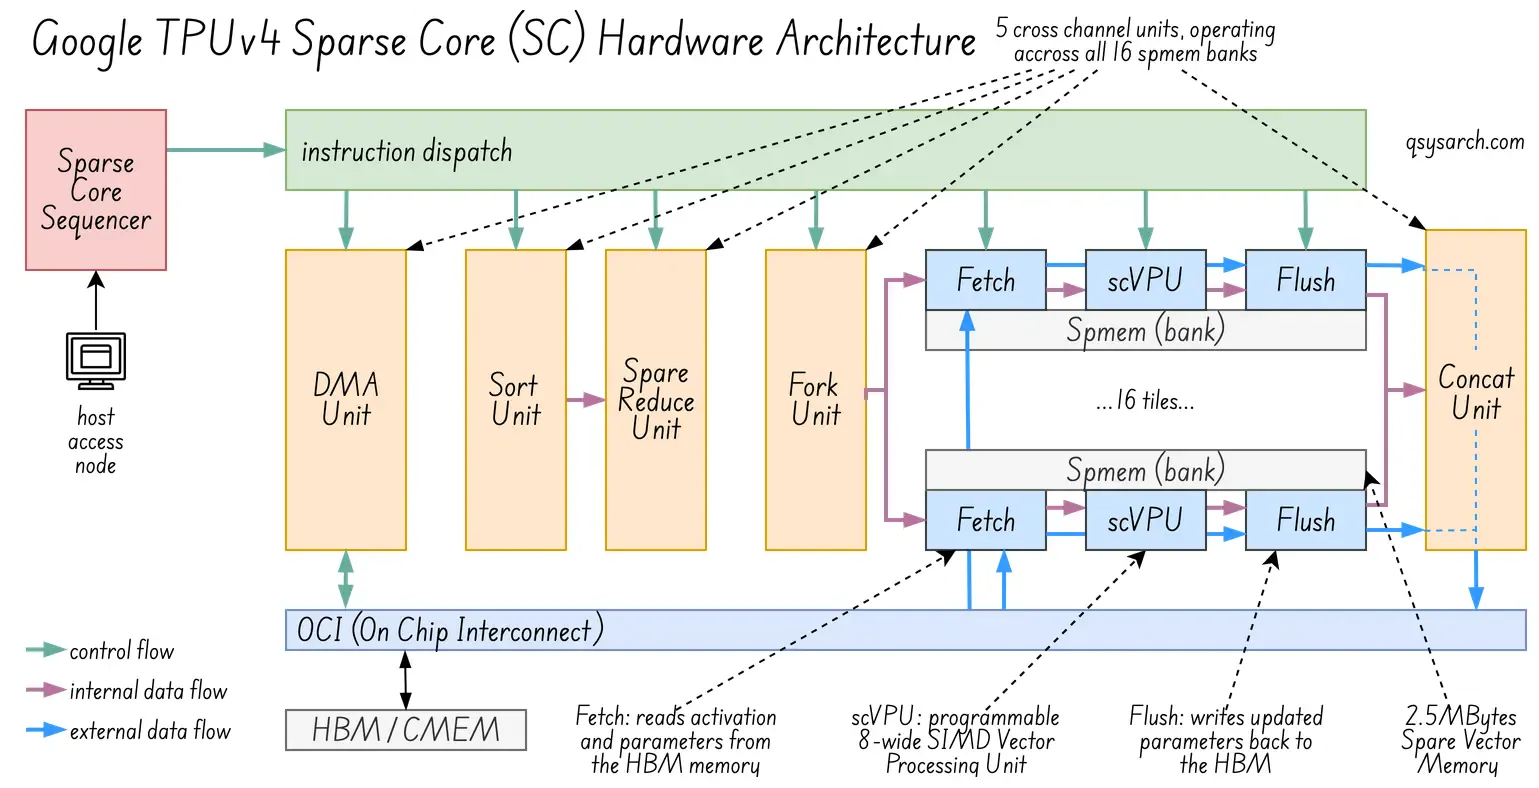 (图片改编自原始图片来源)
稀疏核心序列器(左上角红色部分)负责将指令分发给 5 个跨通道单元(橙色部分)以及 3 个“取指/处理/刷新”SIMD 单元(蓝色部分)。每个 SIMD 单元都在其自身的 2.5MB 紧密耦合内存暂存区(灰色部分)上运行。
鉴于每个取指/处理/刷新 SIMD 单元一次操作 8 条数据通道 (SIMD=8),而一个稀疏核心处理器中有 16 个这样的 SIMD 单元,这使得它成为一个非常强大的处理单元,几乎就像 GPU 内部的一个微型 GPU!或者更准确地说,一个 TPU 内部有 4 个微型 GPU!
如果能了解一下用于对这款强大的 SparseCore 处理单元进行编程的指令集架构 (ISA) 就太好了,但我在网上找不到任何相关信息。这可能是因为它更像是一台功能强大的“同步 SIMD ALU 型 DMA 计算机”,其指令非常具体,因此只有提供更高层次的抽象层(例如 JAX 库)才有意义。
实际上,用户编写高级功能代码,XLA(加速线性代数)编译器识别与 SparseCore 硬件功能相匹配的模式。
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
@nn.compact
def __call__(self, indices):
embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
底层发生了什么?model.apply 方法调用 XLA 编译器,将代码降级为 SparseCore。为此,它匹配 nn.Embed(一个_gather_ 操作),并生成以下“伪指令”:
去重:XLA 注意到输入中出现了两次数字 42 和 105。它会生成 SparseCore 指令,在提取数据之前对这两个数字进行去重。
DMA:生成 SC 标量指令,以计算 ID 105、42 和 28 的内存偏移量。
Push:将生成的 5*128 张量移回公共内存 (CMEM)。
XLA 编译器还需要处理数据放置问题。特别是,由于稀疏核心需要访问 nn.Embed 索引,因此这些索引必须放置在稀疏核心可访问的内存中。它可以将数据放置在 CMEM 中,但 CMEM 容量很小(128MB),因此通常将嵌入数据放置在容量较大的 HBM 中(TPUv4 为 32GB)。然而,稀疏核心处理的输出结果会被放回 CMEM 中,因为它只是数据的一部分。
值得注意的是,SparseCore 架构在接下来的 v6+ 代中得到了发展。
教育部专家混合模式和途径
链接到标题
与传统方法不同,混合专家组(MoE)……
pathways 概念指的是令牌在分布于不同 TPU 芯片上的专家之间进行分片时所采取的物理和逻辑路径。
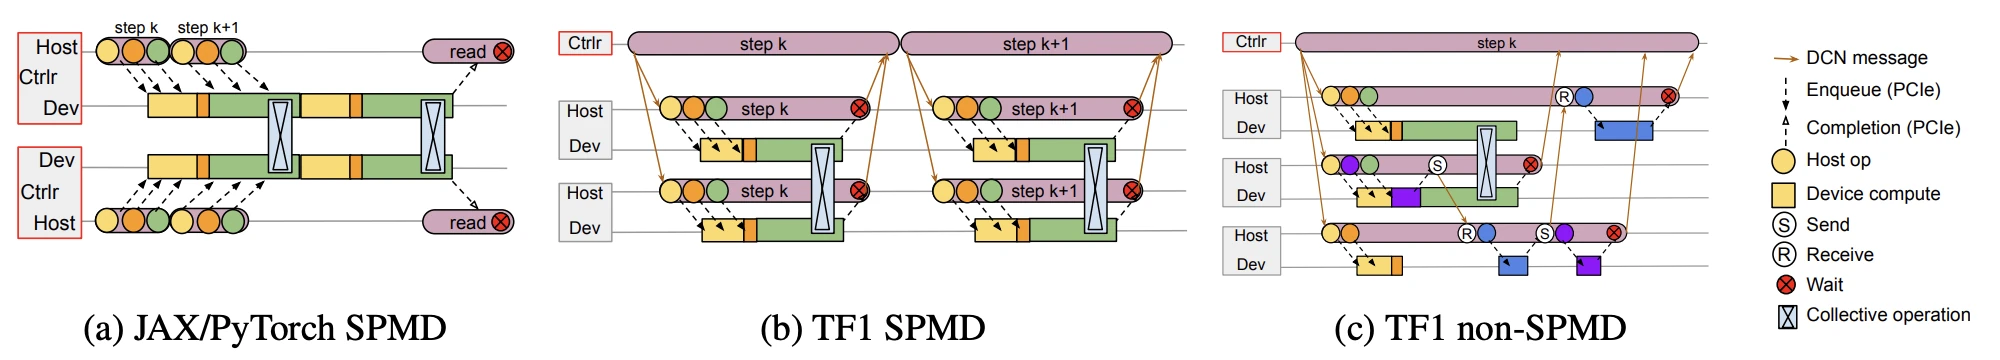 (图片来源)
2023 年及以后:v5、v6(Trillum)和 v7(Ironwood)
链接到标题
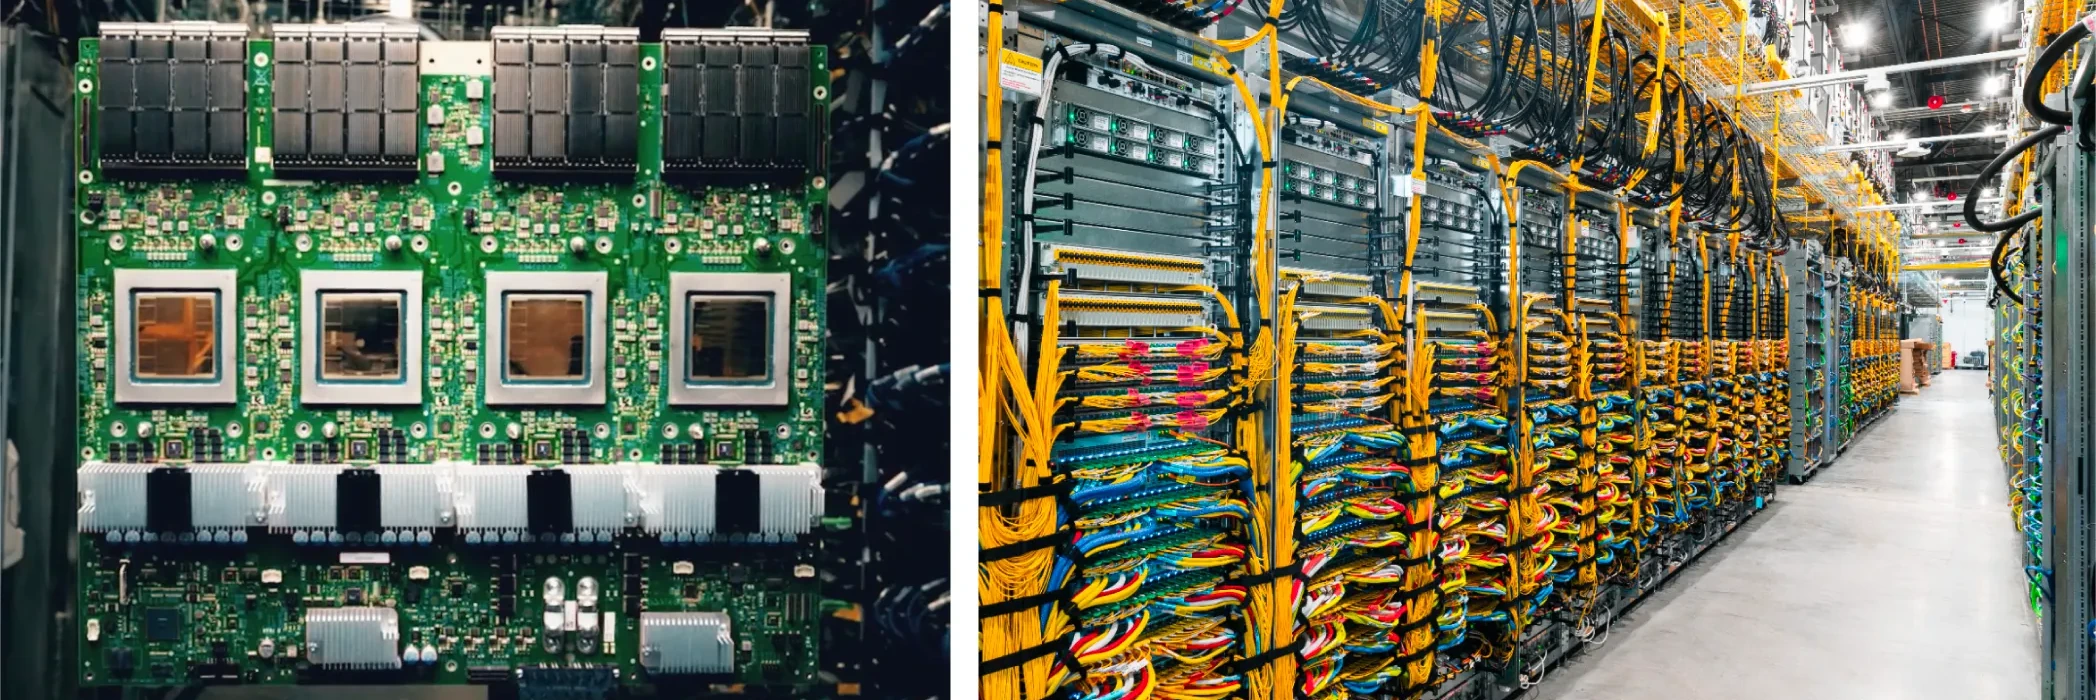
关于新一代车型的信息不多,所以这里只展示大尺寸前大灯:
Ironwood v7 的超级烟弹由约 9000 个 TPU 组成。
那么,既然我们已经有了TPU,为什么还需要GPU呢?
TPU 的设计兼顾了内存、计算能力、能耗和数据通信,这表明大规模构建高性能 AI 系统不仅仅需要速度快的芯片,还需要硬件、软件、系统和网络连接之间的协调配合。
尽管如今人工智能工作负载更加多样化,涵盖推理、训练、稀疏模型和推荐系统,但 TPU 并非设计用于处理像素。然而,GPU 目前并不流行,因为英伟达公开了一种程序化模型和开发者体验,使 GPU 能够像 TPU 一样运行。
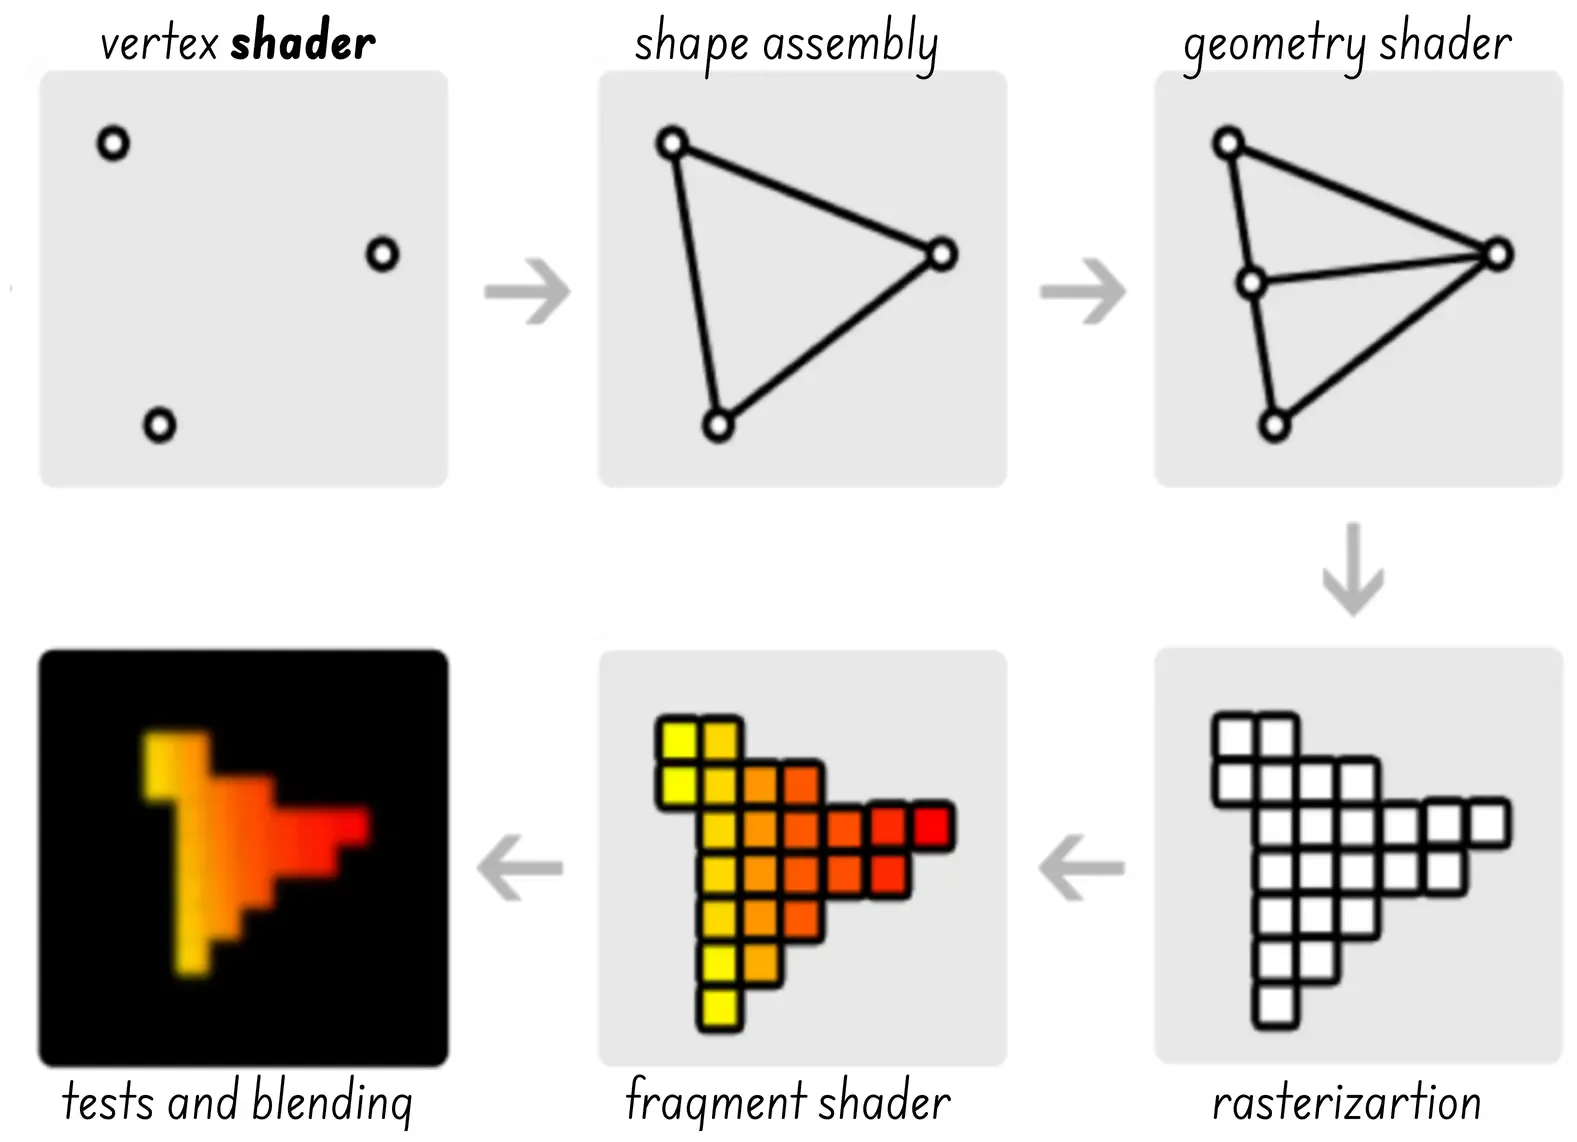
这是否意味着GPU更胜一筹?未必如此——在某些特定工作负载下,TPU的效率可能高于GPU,尤其是在功耗和每瓦性能方面。在我们如今这个AI数据中心能耗日益增长的世界里,TPU或许能发挥至关重要的作用。
模拟神经形态集成电路怎么样?
那么神经形态集成电路呢?与TPU相比,它们旨在通过使用模拟计算和低频事件驱动处理来进一步降低功耗。神经形态集成电路需要具备哪些条件才能成为主流并达到与TPUv7超级芯片相同的规模?
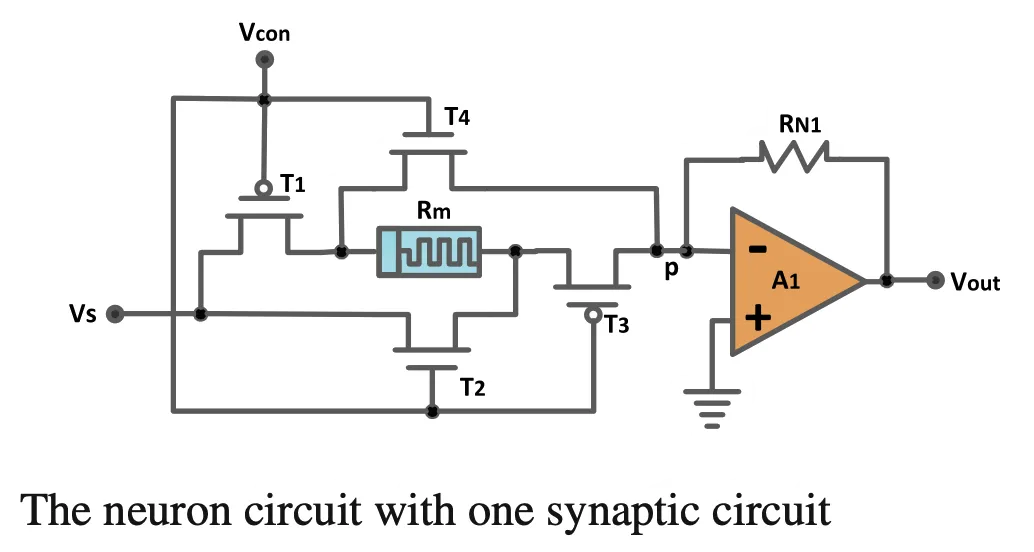
我仍然面临的挑战之一是更好地理解收缩阵列(MXU + 备用核心)与 TPU 其余部分(包括 ICI、OCI、TCS)的相对功耗,以及该比率与神经形态脉冲神经网络 (SNN) 与控制逻辑(RiscV 和 Spike copro)的比较情况。
此外,如果神经形态集成电路要达到 TPUv7 的规模,很可能需要在软件、系统和网络连接方面投入类似的资金。否则,可以考虑将 SNN 集成到 TPU 中,并利用 TPU 的“控制逻辑”来处理 SNN 与 TPU/机架/焊盘其余部分之间的通信。但这样做有必要吗?我们究竟要解决什么问题?或许我们需要换个角度思考。
回到未来:语言处理单元
链接到标题
如果没有提及语言处理单元,这份备忘录就不完整。语言处理单元是一种新型处理器,旨在优化大型语言模型的推理。
我需要专门为这个主题撰写一份备忘录,所以目前这只是一个高层次的比较,试图了解LPU是否仅仅是对TPUv1的重新设计,而TPUv1只专注于推理,并不关注训练。
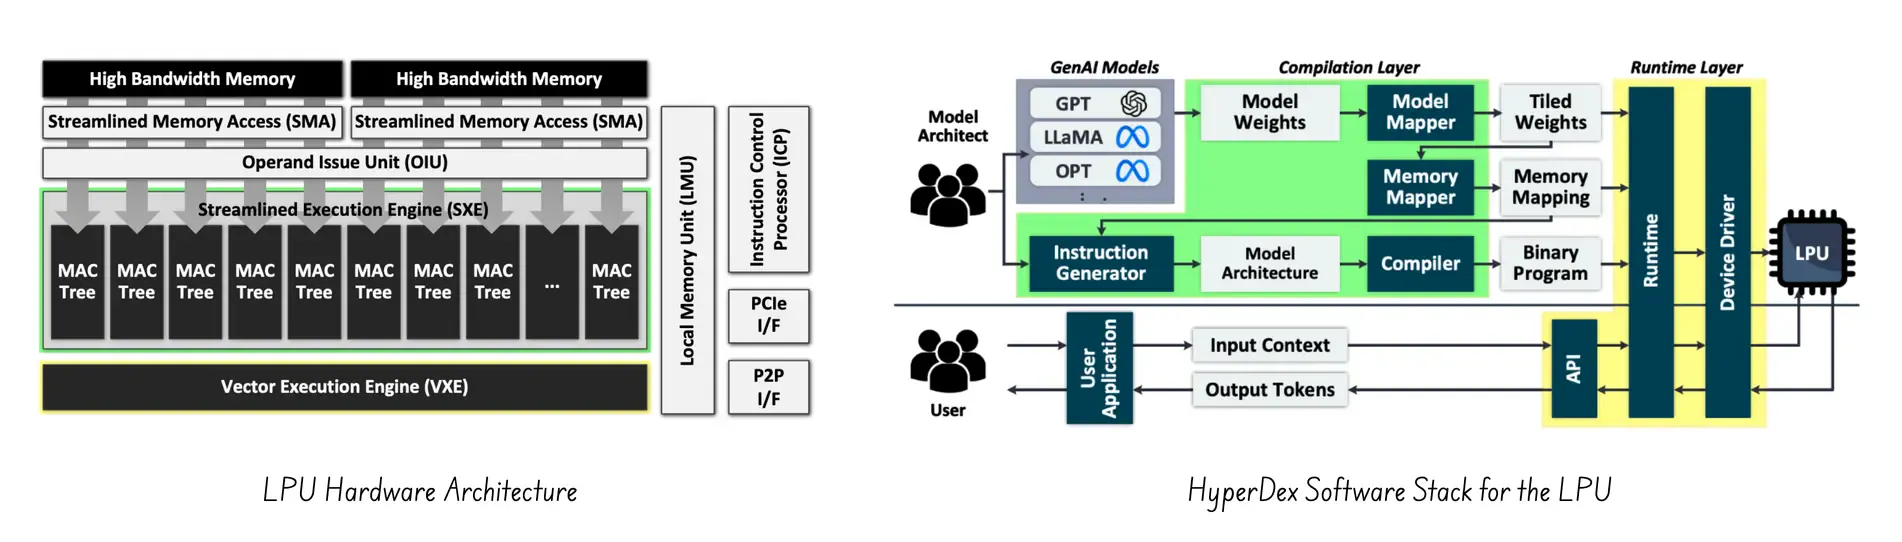
从宏观层面来看,TPU 和 LPU 的确都需要高效且大规模地完成一些任务,它们都采用了领域特定架构 (DSA)。但具体到实现和优化方面,LPU 则截然不同,它关注的重点也不同。
主要区别在于,TPUv1 的设计早于 LLM 的出现(请记住,ChatGPT 的初始版本发布于 2022 年),并且专注于通用深度神经网络 (DNN) 推理。这意味着要确保大规模、高容量操作的吞吐量和每瓦性能,而这由底层 MXU 脉动阵列实现。
另一方面,LPU 的设计目标是优化大型语言模型 (LLM) 的推理。其重点在于降低每个词元的延迟。为此,它们需要一个支持完全确定性、静态调度、基于 VLIW 的多流水线架构的指令集架构 (ISA)。当然,有人可能会说 TPUv4 为 TCS 引入了类似的 VLIW ISA。但主要区别在于,LPU ISA 是一个完全确定性的 VLIW 机器,其中每个加载、计算和存储操作都是逐周期调度的。而对于 TPU 来说,MXU 则是一个“自驱动”的脉动阵列。
# 结论
瞧,这是一份简短的备忘录,但和以往一样,耗时更长。通过这次深入分析,我们可以清楚地看到,TPU架构的演进表明,设计AI加速器是一项复杂的任务,需要权衡诸多因素。
TPU 的设计兼顾了内存、计算能力、能耗和数据通信,这表明大规模构建高性能 AI 系统不仅仅需要速度快的芯片,还需要硬件、软件、系统和网络连接之间的协调配合。
这感觉有点像似曾相识。量子处理单元(QPU)会不会是人工智能加速器发展的下一步呢?
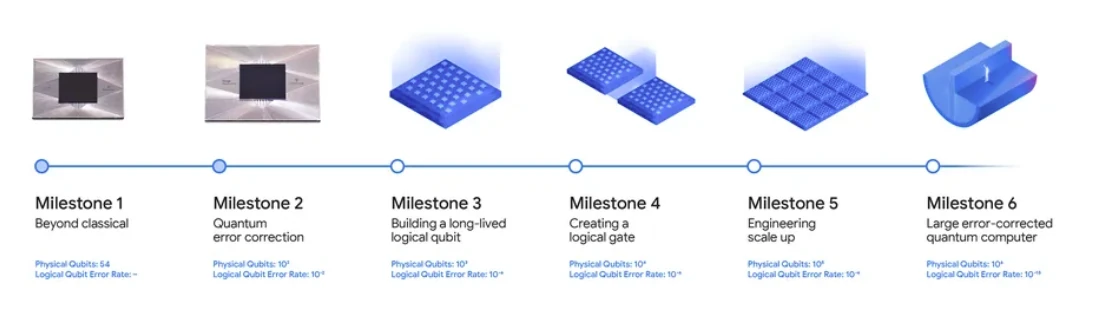 (图片来源:Google Willow)
# 参考
本备忘录中使用的DrawIO图表: