谈到提高量子比特保真度,一个间接的问题是:能否通过“整形”比简单的高斯脉冲更复杂的脉冲来提高门保真度?答案是:“让我们来看看_DRAG脉冲”!
人们对 DRAG Pulse 感兴趣的真正原因是 Joseph Bardin 在关于 Google 的 Cryo Pulse Modulator 的 视频 演示中发表的评论:
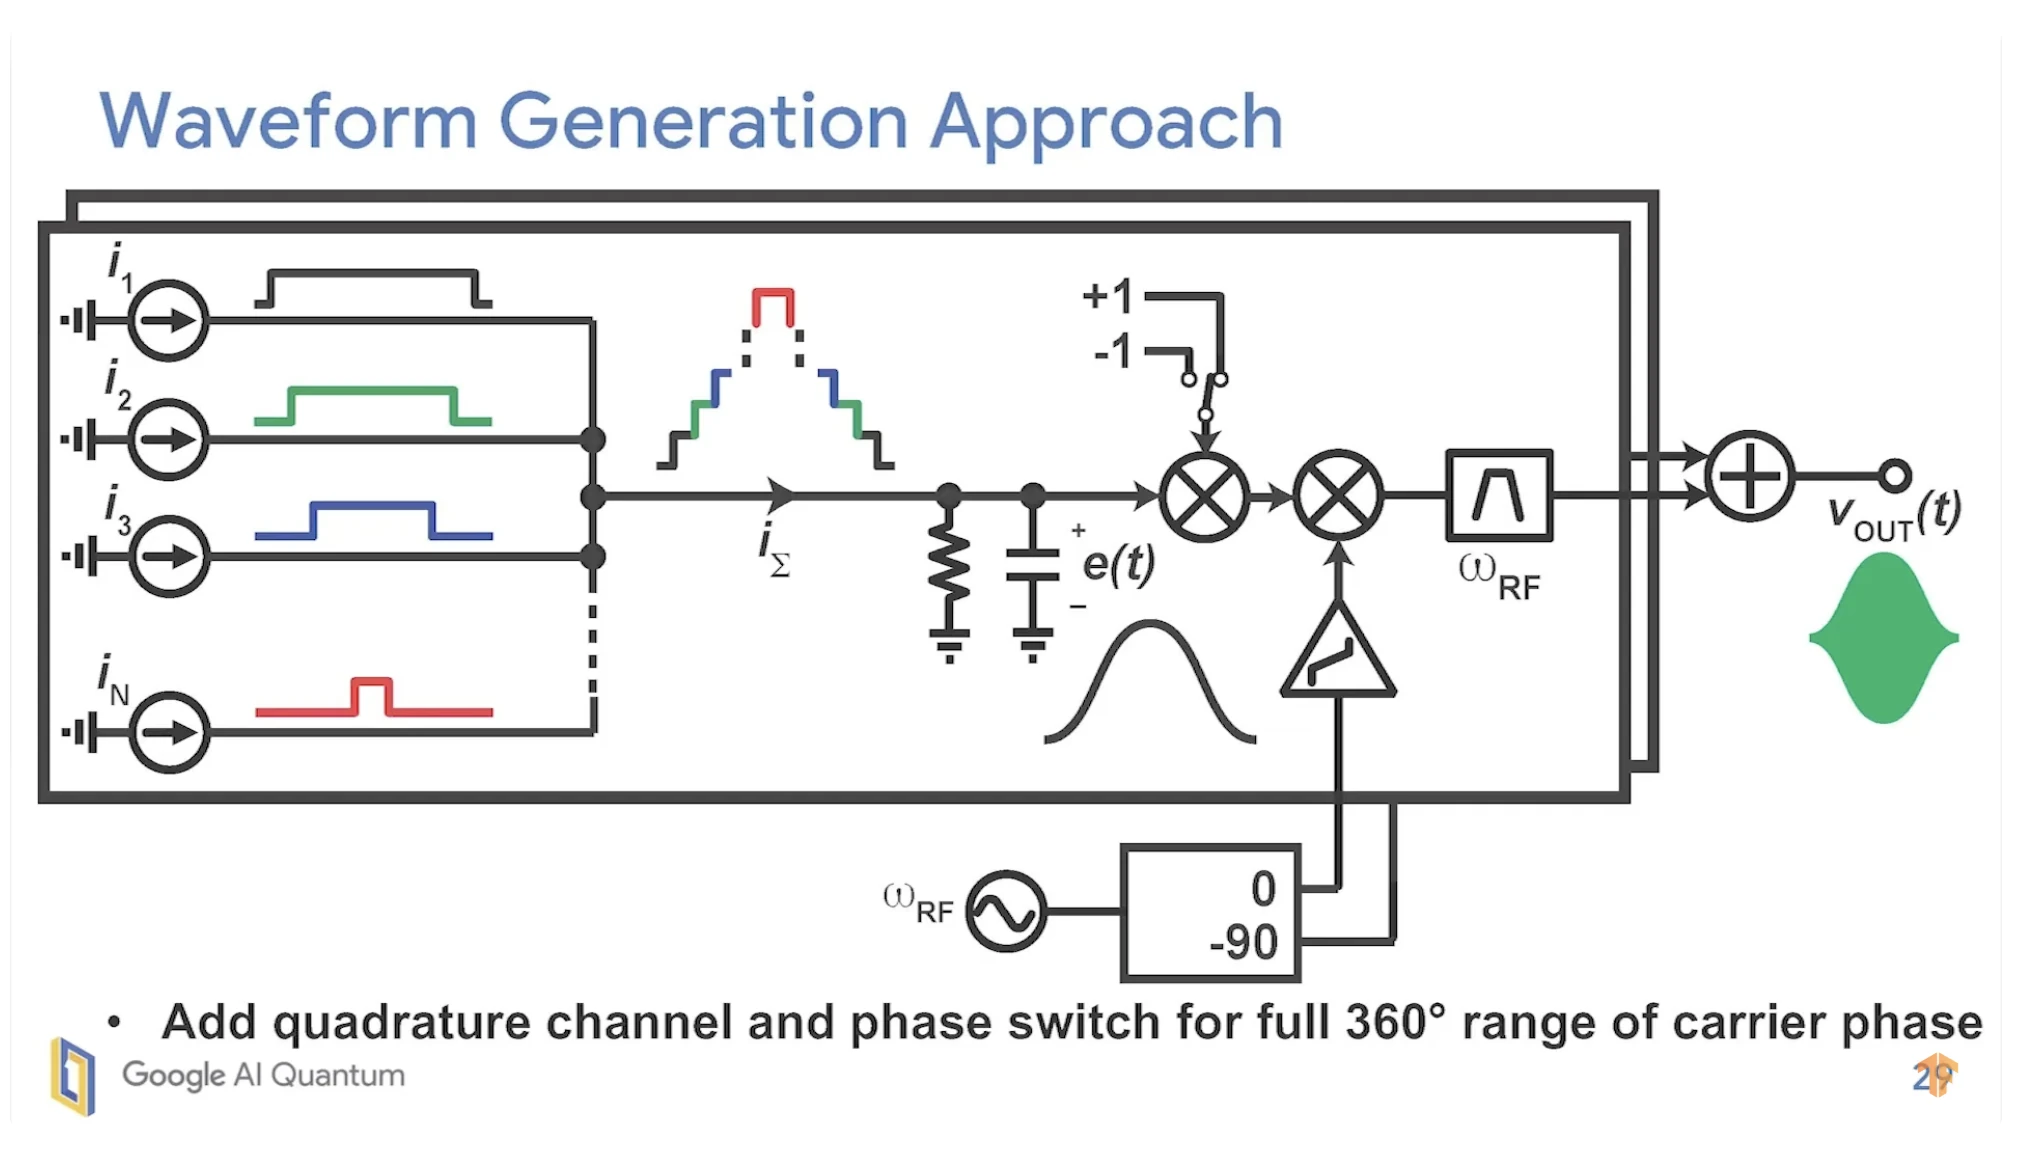
[21:08] 我们意识到,如果我们不去尝试诸如拖拽之类的操作,我们只需要一个对称的包络线。升余弦或高斯函数——它们都是对称的。所以我们构建了一个可编程电流源阵列,然后使用相应的使能函数来创建这种类似婚礼蛋糕形状的电流波形。这样我们就可以对振幅等等进行编程。
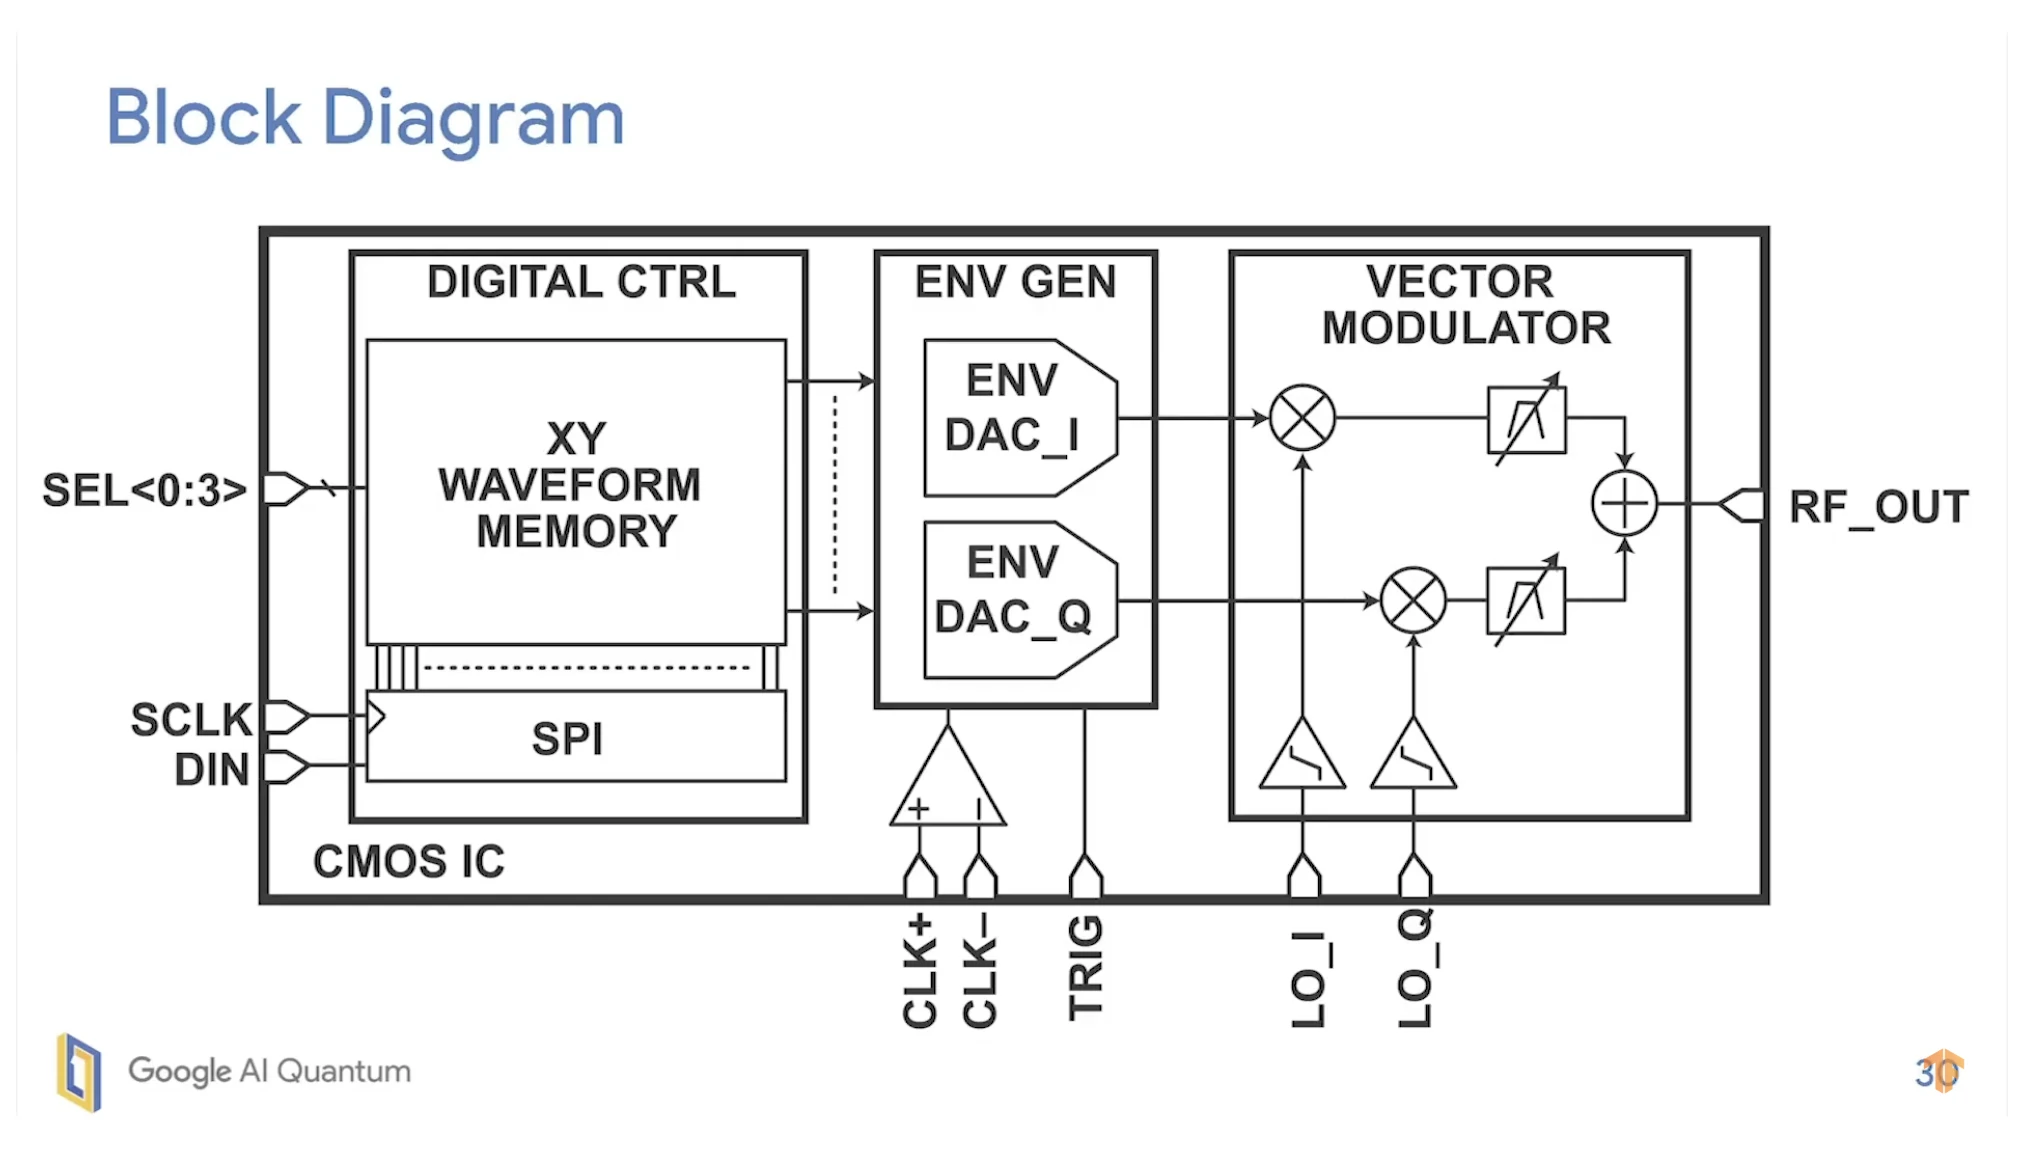
这就是谷歌的架构——它真的很巧妙:
但是,要使这种架构能够产生阻力脉冲,需要做哪些调整呢?要理解这个问题,首先需要了解什么是阻力脉冲。
DRAG(绝热门导数消除)脉冲由一个标准高斯脉冲及其正交分量加上该脉冲的缩放导数构成。这产生一个双分量脉冲,一个分量是高斯包络,另一个分量是高斯导数,这有助于减少向高能态的不必要泄漏,并校正超导量子比特中的相位误差。
DRAG脉冲的组成部分 标准高斯脉冲:
脉冲的基部是一个标准的高斯包络,它是一条平滑的钟形曲线。这是脉冲的“同相”\(i(t)\)分量。
导数由以下方程表示:
\[ DRAG(t) = v(t)=i(t)+q(t) = i(t)+ \beta \frac{d(i(t))}{dt} \]
这里没有什么花哨的东西,但我们需要注意的是,拖拽脉冲有很多种类型,而且,即使标准的拖拽脉冲是高斯拖拽脉冲,也丝毫不会阻止我们创造出更强大的组合:
 图片来源:APS
现在我们已经了解了 DRAG 脉冲的构建方式,接下来可以研究它如何通过量子控制系统实现。这里,我将重点分析 Qblox Scheduler,它作为一个高级编译器,使用户能够用量子比特和脉冲来定义实验,同时抽象化底层仪器控制的复杂性。
相关代码可在gitlab上找到。以下代码是原始代码的简化版本:
def drag( t: np.ndarray, G_amp, D_amp, duration: float, nr_sigma: float=4, phase: float=0 )
-> np.ndarray:

mu = t[0] + duration / 2
sigma = duration / (2 * nr_sigma)

# In-phase envelope
gauss_env = G_amp * np.exp(-(0.5 * ((t - mu) ** 2) / sigma**2))
# Quadrature envelope
deriv_gauss_env = -D_amp * (t - mu) / sigma * gauss_env

# generate pulses
drag_wave = gauss_env + 1j * deriv_gauss_env

# Apply phase rotation
rot_drag_wave = rotate_wave(drag_wave, phase=phase)

return rot_drag_wave
这其实很简单,而且原始代码在功能方面更加强大。更多信息请查看在线文档。
上述代码之所以有效,是因为它假设底层硬件作为任意波形发生器 (AWG) 运行,也就是说,可以基于采样缓冲区生成任意波形。但如果必须在“脉冲星”(或脉冲调制器)上生成波形呢?该脉冲星被定义为位于 4K 低温级上的某种控制逻辑。
谷歌脉冲调制器:第一代
链接到标题
我认为谷歌的架构不适用于 DRAG 脉冲的原因在于,正交分量需要同时进行缩放,幅度缩放因子为 \(\beta\),持续时间缩放因子为 \(\sigma\)。我需要进一步确认这一点,但目前我们可以假设,挑战在于脉冲星需要提供_完全灵活的 I/Q 波形整形_。
换句话说,关键不在于谷歌的低温架构无法产生DRAG脉冲;它完全可以产生I/Q脉冲并实现对量子比特的控制。然而,除非进行额外的校准/补偿,否则用于最高保真度单量子比特门的“标准DRAG”脉冲在该架构下可能并非最优。
校准脉冲调制器:第二代
链接到标题
由于谷歌发布的视频可以追溯到 2019 年,我们可以推测他们当时已经对其系统进行了改进,使其具备了 DRAG 脉冲整形能力,我们将其称为第二代低温脉冲星。然而,由于我未能在网上找到任何关于巴丁的谷歌低温脉冲星的信息,我们可以参考其他研究中心的以下两项改进:
SPulseGen 的脉冲发生器旨在调整脉冲参数(幅度、时序、波形),而不是简单地重复一个固定的粗略波形。即使波形有所简化,这种灵活性对于实现 DRAG 组件(或“导数校正”)也至关重要。

至于 DLR,它绕过了“复杂”IQ 整形的要求:它不需要连续导数正交通道,而是使用基带脉冲的时间延迟重复来产生不需要的(泄漏)频谱分量的破坏性干涉。

DLR 和 SPulseGen 都旨在解决量子比特高保真度和低泄漏控制的相同挑战,所有这些都是在超低功耗硬件和低温约束的背景下运行的,但采用了相反的方法:
# 结论
瞧,这份周六的思维导图备忘录帮我更好地理解了DRAG脉冲。从4K阶段的控制逻辑角度来看,塑造这些脉冲并不是什么需要担心的问题。
如今的挑战在于找到能够产生最高保真度的最佳校准和补偿方法。像代尔夫特理工大学提出的延迟泄漏减少这样的方法肯定会带来改变。
当需要连续进行校准时,例如基于神经网络的强化学习(RL),就会面临一个更有趣的挑战。这就引出了一个问题:神经网络是否应该/能够/将会在 4K 低温平台上运行,或许可以使用原位表征方法。
与此同时,超低功耗人工智能专用集成电路(ASIC)领域涌现出许多新的进展,例如blumind.ai,这些进展将会带来改变。但我们暂且将对其他集成电路架构的研究留待以后的备忘录中讨论。
真是激动人心的时刻,不是吗?
References