
在GPU领域,与RDMA相关的术语层出不穷:GPU-direct、NvLink、NVLink Fusion、InfiniBand、Quantum InfiniBand、GPUNetIO和DOCA。这令人眼花缭乱,但或许不必如此?
本文以个人备忘录的形式写成,试图阐述各种技术,并用一些图表将其可视化。
GPU Direct 和 RDMA:市场营销与技术。
链接到标题
让我们从官方 Nvidia 文档中令人困惑的 GPUNetIO 页面开始:
请注意,RDMA 是远程直接内存访问协议的缩写,该协议允许从一台计算机的内存向另一台计算机的内存进行远程直接内存访问,而无需任何一台计算机的操作系统参与。……请勿将其与 GPUDirect RDMA 混淆,后者与 RDMA 协议无关。
明白了,GPUDirect RDMA 和 RDMA 协议并不相同!但是,GPUDirect RDMA 至少使用了 RDMA 协议吗?我希望如此;否则,那就太令人困惑了。
GPUDirect RDMA 是 NVIDIA GPUDirect 技术家族中的一项技术。它使网卡能够直接访问 GPU 内存,绕过 CPU 内存复制和操作系统例程,从而实现数据的收发。任何支持以太网、InfiniBand 或 RoCE 的网络框架都可以启用 GPUDirect RDMA。
好的,至少有一点很明确:GPUDirect RDMA 可以实现在任何传输层上,无论是以太网 (ETH) 还是 InfiniBand (IB)。但是,GPUNetIO 是什么?它与 RDMA 又有什么关系呢?答案很简单。顾名思义,GPUNetIO 是基于网络的 GPU Direct RDMA 实现,通过网卡实现。这并不意味着 GPU Direct 必须由网卡驱动,而只是说 GPUNetIO 是针对特定网卡类型的专用版本。
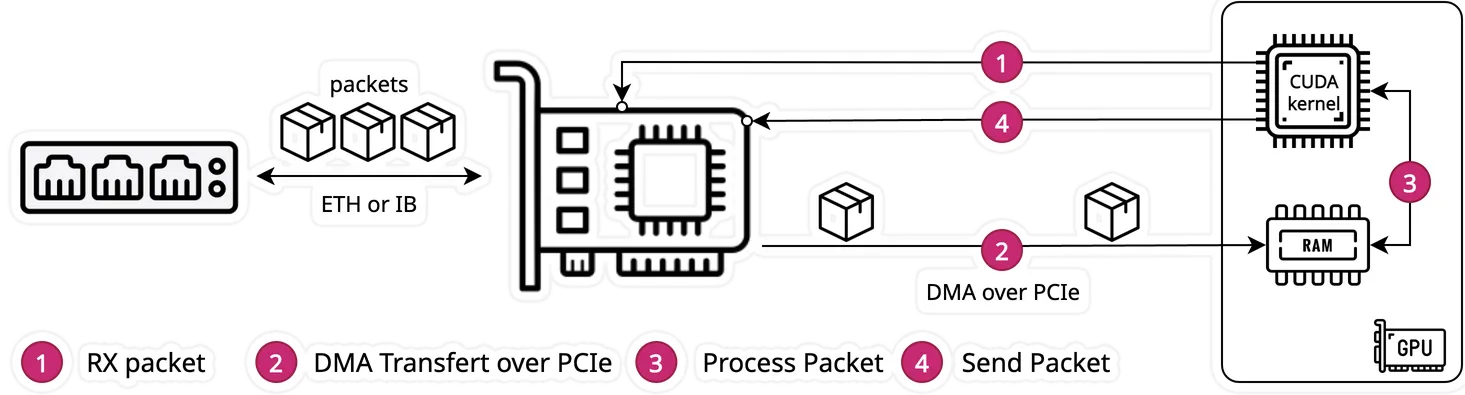
在GPUNetIO文档的上图中,“CUDA”框有点令人困惑。我猜它指的是运行在GPU上的内核,但我们来看看文档是怎么说的:
传统方法通常依赖于以 CPU 为中心的模型,其中 CPU 与网卡协调,使用 GPUDirect RDMA 将数据包接收到 GPU 内存中。之后,CPU 通知 GPU 上的 CUDA 内核处理这些数据包。……DOCA GPUNetIO 通过提供一种以 GPU 为中心的解决方案来应对这一挑战,该方案将 CPU 从关键路径中移除。
对我来说,这一点仍然不太清楚——它指出关键路径“以GPU为中心”,但关键路径究竟是什么?是指图中提到的步骤(1)到(4)吗?CPU还需要做什么?要找到答案,我们需要查看“异步内核启动”模式,该模式被描述为“GPU CUDA内核控制网络通信以发送或接收数据”的可能性。GPUDirect IKA启用了以下功能:
所以,这一点百分之百清楚:
GPU Direct RDMA“允许直接向/从GPU内存传输数据,而无需CPU暂存副本。
GPU Direct AKI 使 GPU 能够“控制”网卡。
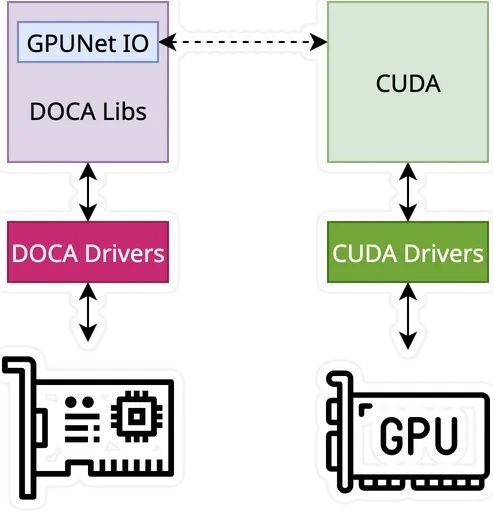
GPUNetIO 是一个软件组件,它同时处理 GPU Direct RDMA 和 AKI 技术。
DOCA 是 Nvidia 提供的用于对支持 GPUNetIO 的硬件(以及其他设备)进行编程的 SDK。
我认为造成混淆的原因在于,“AKI”应该被描述为“GPU Direct RDMA + AKI”,因为它补充了 RDMA 功能,允许绕过 CPU。
RDMA GPU互连
链接到标题
我们现在了解到,NVIDIA 以 GPUNetIO 的名义推广的 GPU Direct RDMA 是一种基于网卡 (NIC) 的解决方案,它通过 PCIe 连接将 GPU 连接到网卡。接下来,我们将深入探讨这种 PCIe 连接,忽略 GPUNetIO 部分,重点关注 RDMA 部分:
CUDA GPUDirect RDMA 的官方文档中指出,唯一的要求是 PCIe 根复合体:
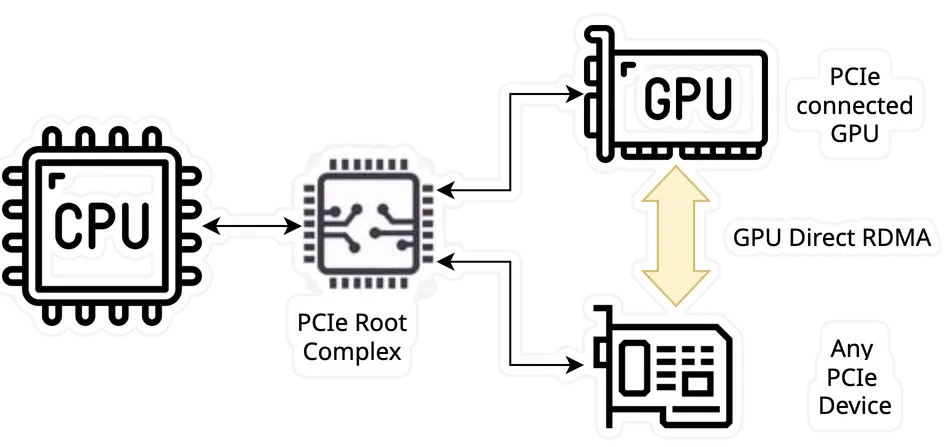
GPUDirect RDMA 是 Kepler 系列 GPU 和 CUDA 5.0 中引入的一项技术,它利用 PCI Express 的标准功能,实现了 GPU 与第三方对等设备之间的直接数据交换。……但这项技术存在一些限制,其中最重要的是两个设备必须共享同一个上游 PCI Express 根复合体。
GPUDirect RDMA 是一种解决方案,它允许任何 PCIe 设备直接与 GPU 通信,前提是它们位于同一根复合体下。因此,尽管英伟达主要将其作为网卡解决方案进行推广和销售,但它可以是任何 PCIe 卡,例如高速摄像头 PCIe 卡。这很棒,但让我们试着了解一下它是如何工作的。
在两个对等设备之间建立 GPUDirect RDMA 通信时,从 PCI Express 设备的角度来看,所有物理地址都是相同的。在这个物理地址空间内,存在称为 PCI BAR 的线性窗口。每个设备最多有六个 BAR 寄存器,因此最多可以有六个活动的 32 位 BAR 区域。64 位 BAR 占用两个 BAR 寄存器。PCI Express 设备对对等设备的 BAR 地址进行读写操作的方式与对系统内存进行读写操作的方式相同。
传统上,BAR窗口等资源会使用CPU的内存管理单元(MMU)作为内存映射I/O(MMIO)地址映射到用户或内核地址空间。然而,由于当前操作系统缺乏足够的机制在驱动程序之间交换MMIO区域,NVIDIA内核驱动程序导出了用于执行必要地址转换和映射的函数。
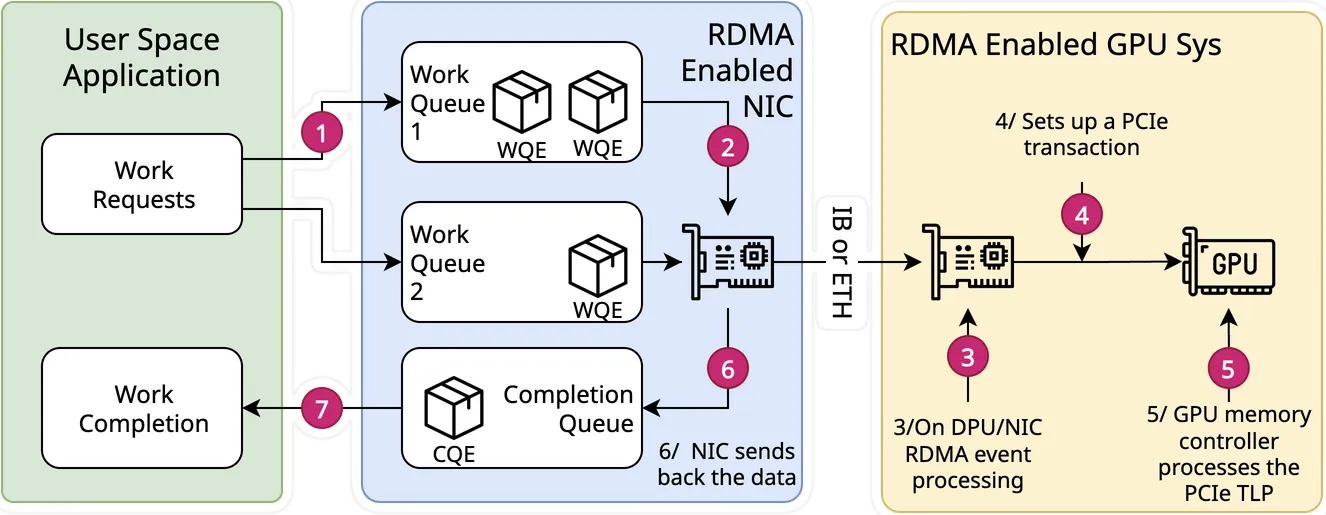
这里容易让人困惑的是,在考虑连接异构设备的PCIe内部系统时,“DMA”这个词似乎比“RDMA”更合适。但关键就在这里。DMA是数据传输的解决方案,而RDMA则是用于赋予传输数据语义的协议,它使用动词来实现。因此,DMA实际上只对应于下图中的步骤(4)和(5),而接收端硬件中的RDMA协议仅对应于步骤(3)。
需要注意的是,英伟达明确表示这不是一件简单的事情,因此,为了获得最佳性能,最好使用已知的测试平台:
尽管 GPUDirect RDMA 在第三方设备和 NVIDIA GPU 之间工作的唯一理论要求是它们共享同一个根复合体,但存在一些错误(主要在芯片组中),导致它在某些设置中性能不佳,或者根本无法工作。
目前术语方面仍然存在明显的混淆,尤其是在以太网、InfiniBand 和 RoCE 之间:事实上,RoCE 是基于以太网的。

InfiniBand 行业协会将其描述为一种演进,如上图所示。请注意,我特意使用了“100G + PFC”这个名称,而不是最初提到的“DCB”(即数据中心桥接)。如果我理解正确,DCB 是 PFC(即优先级流控制)的超集,其含义是,要使 DCB/PFC 正常工作,需要相应的网络基础设施(包括交换机)来实现这些技术。否则,就只能使用以太网了。
NVLink怎么样?
如果没有提及NVLink,这份备忘录就不完整。摆在我们面前的问题是,NVLink和InfiniBand是同一回事,还是两者之间存在某种关联。简而言之,它们是互补的,而非竞争关系。

从右侧的示意图可以看出,绿色箭头用于连接各个GPU。而网卡之间的连接则采用InfiniBand技术。
值得注意的是,NVLink 接口位于 Nvidia 硬件内部,不像 InfiniBand 连接器那样暴露在外,如下图所示。需要注意的是,Quantum InfiniBand X800 是一款性能强劲的产品,支持 800Gb/s 链路,并集成了硅光子器件,但它与量子计算无关。
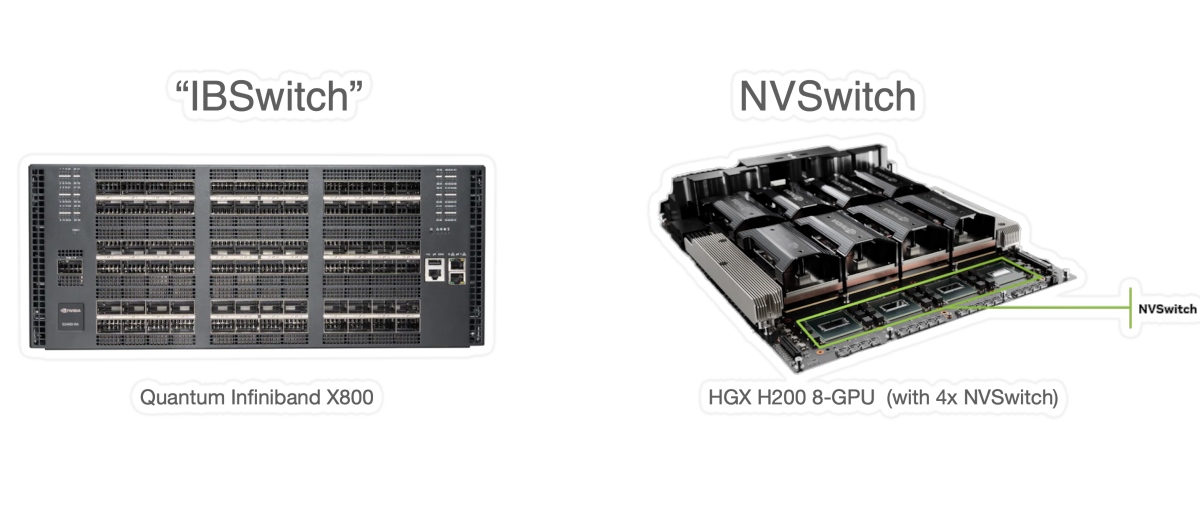
最后还有一点值得一提:Nvidia 推出了 NVLink Fusion,旨在开放 NVLink 标准。因此,我们明天很可能会看到一些定制集成方案,或许仍然需要一块 PCB 作为“开关”(而不是线缆),但使用的是 SoC,而这块 SoC 可能并非 Nvidia 的产品。此外,AMD 也推出了 UALink 来回应 Nvidia 的标准。
# 概括
简而言之,RDMA 并不复杂:
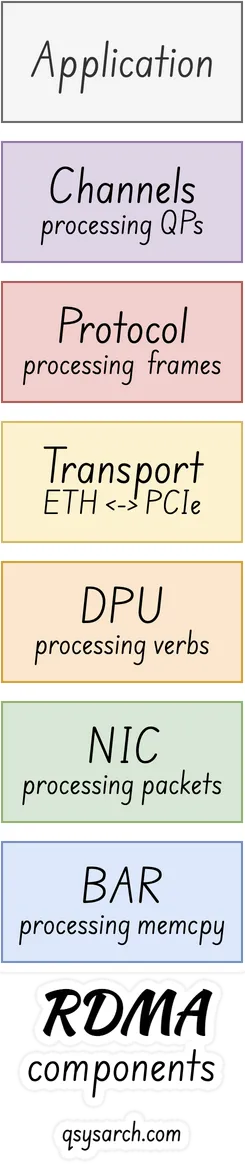
RDMA BAR:作为 PCIe BAR 映射:在物理层,有一个 PCIe 设备通过同一个 PCIe 根复合体连接到 GPU,并映射所有设备的内存 BAR。
RDMA 网卡:作为硬件网卡 (NIC):这种 PCIe 卡通常是网卡,但并非必须如此。然而,目前市面上似乎只有一款网卡具备 RDMA 功能。
RMDA DPU:作为硬件内动词处理器:为了使 PCIe 卡符合 RDMA 规范,硬件必须能够直接在硬件中处理 RDMA 动词,通常使用称为 DPU 的处理器。
RDMA 传输:作为网络链路的传输层:PCIe 设备在网络侧作为传输层暴露出来,可以是以太网、更好的以太网 (RoCev2) 和 Infiniband。
RDMA 协议:作为帧格式:用于通过网络链路进行通信的协议也称为 RDMA - 我没有查看帧格式的详细信息,但它在 RFC5040 中有描述。
RDMA 通道:作为通过 QP 进行通信的方式:主机上用于与 RDMA 设备通信的软件/驱动程序/SDK 也被称为 RDMA,但定义为队列通道。
瞧!我现在对RDMA的理解似乎更透彻了。
# 结论
回到量子计算的挑战——问题是,我们为什么要关心 RDMA?嗯,那是因为英伟达把他们的 InfiniBand 交换机命名为“量子 InfiniBand”!
然而,尽管他们最新的Quantum-X800性能强劲,但它与量子计算却毫无关系。不过,它或许能在将量子控制器与GPU连接起来方面发挥关键作用,从而助力强化学习挑战?
# 参考: