乍一看,量子纠错似乎很简单:将物理量子比特分组为逻辑量子比特,应用一种方法来保持它们之间的一致性,然后使用这些逻辑量子比特来操作量子电路。
但实际上,这第一步远非显而易见。如何创建和维护这些逻辑量子比特?例如,从量子控制系统(QCS)的角度来看(例如 QM OPX1000、ZI 的 ZQCS 或 Qblox Q1 Cluster),“操作”或“协调”逻辑量子比特需要什么?一旦这个逻辑量子比特“准备就绪”,又该如何通过由单量子比特门和双量子比特门组成的量子电路来使用它进行量子计算?这个问题看似简单,但实际上却关乎硬件控制系统,以及软件栈,尤其是编译器:我们现在是否拥有多个编译器,一个用于物理量子比特,一个用于逻辑量子比特?此外,在由混合GPU/QPU和QCS组成的异构环境中,当需要处理10000个物理量子比特时,编译器需要付出怎样的努力才能应对这种扩展复杂性?这些问题看似简单,答案却并不简单!
本备忘录是量子控制系统视角下关于量子纠错系列备忘录的第一篇。这篇简短的备忘录介绍了在物理层“创建”一个一致的逻辑量子比特所需的基本概念。
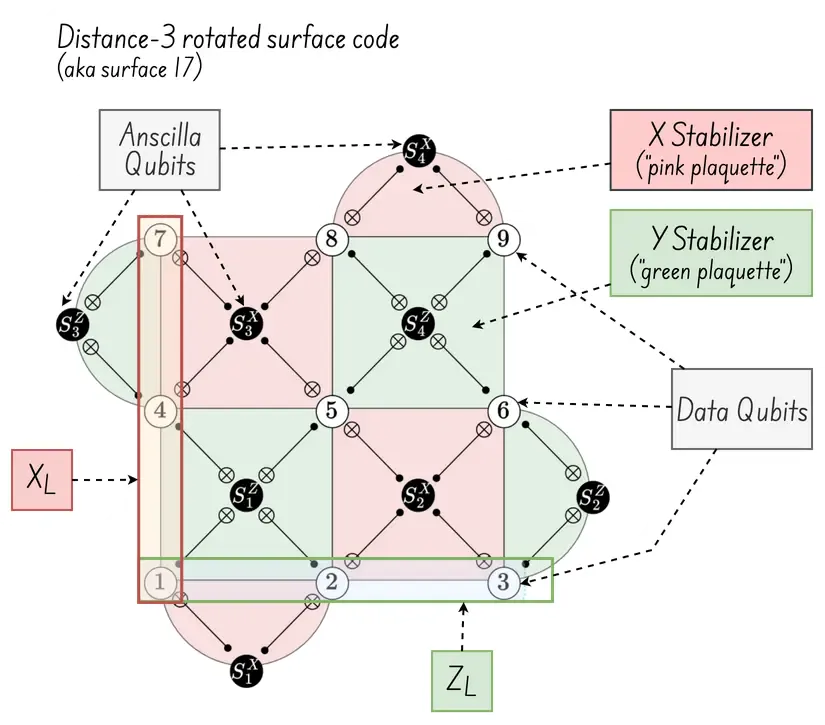
什么是“逻辑量子比特”?创建逻辑量子比特首先要将物理量子比特分组,每个量子比特都被赋予特定的角色。有些量子比特用作辅助量子比特,而另一些则用作数据量子比特或主量子比特。
这种分组通常用右侧的图表表示,图中显示的是“基于距离 3 的表面代码 17”(图片来源:Irréversible Inc)。
以下是适用于表面代码的基本结构:
QEC 作为一种协议
链接到标题
数据与辅助量子比特之间的相互作用因“微片”而异:
小牌(绿色和粉色面)定义了中间的辅助量子比特与其相邻数据量子比特之间的错误检查类型关系。
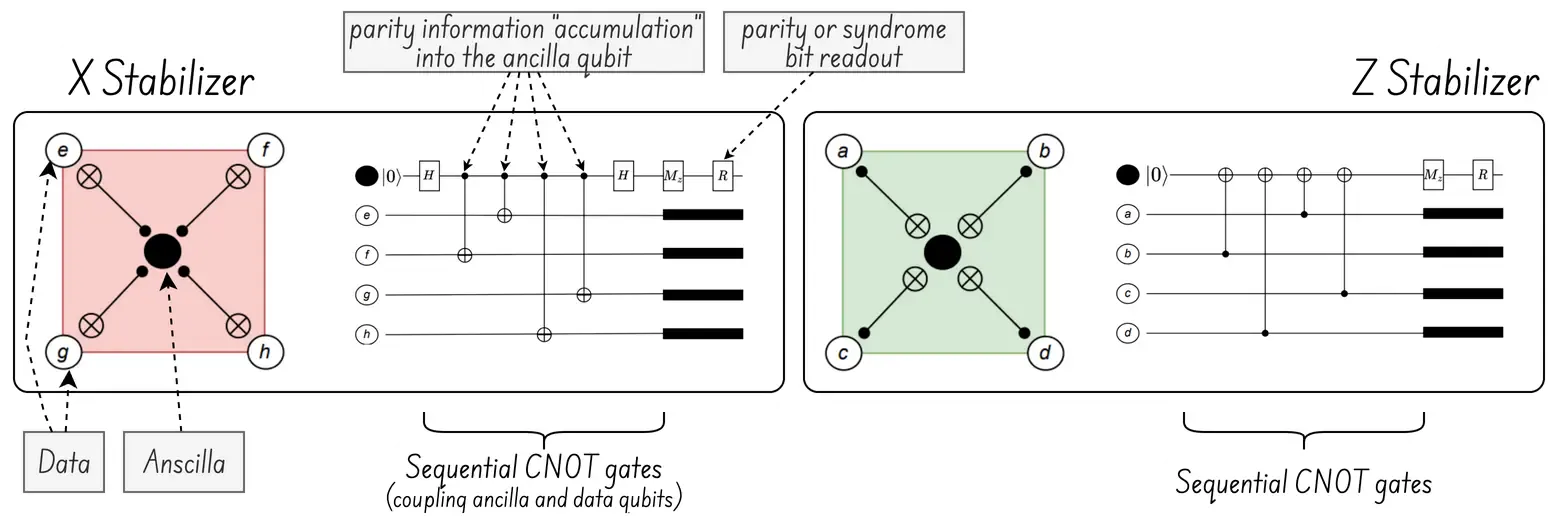
稳定器:每个辅助量子比特用于测量一个泡利算符,或稳定器:表面码有两个稳定器:Z 型检测比特翻转 (X) 错误,而 X 型检测相位翻转 (Z) 错误。
稳定器测量 是对单个稳定器的测量,其实现方式是将辅助量子比特依次耦合到相邻的数据量子比特,然后测量辅助量子比特。
小测验:谁是量子比特的罪魁祸首?
链接到标题
在此背景下,请参考下图(图片来源:Laurent Prost ,来自 [Alice & Bob ] (https://alice-bob.com/platform/))。Z1Z2 和Z2Z3分别代表量子比特 1 和量子比特 2 之间以及量子比特 2 和量子比特 3 之间的联合奇偶校验(稳定器)测量。与之前的二维平面图不同,该图假设每个物理量子比特仅与其他一个量子比特相连,这表明这是一个一维重复码。
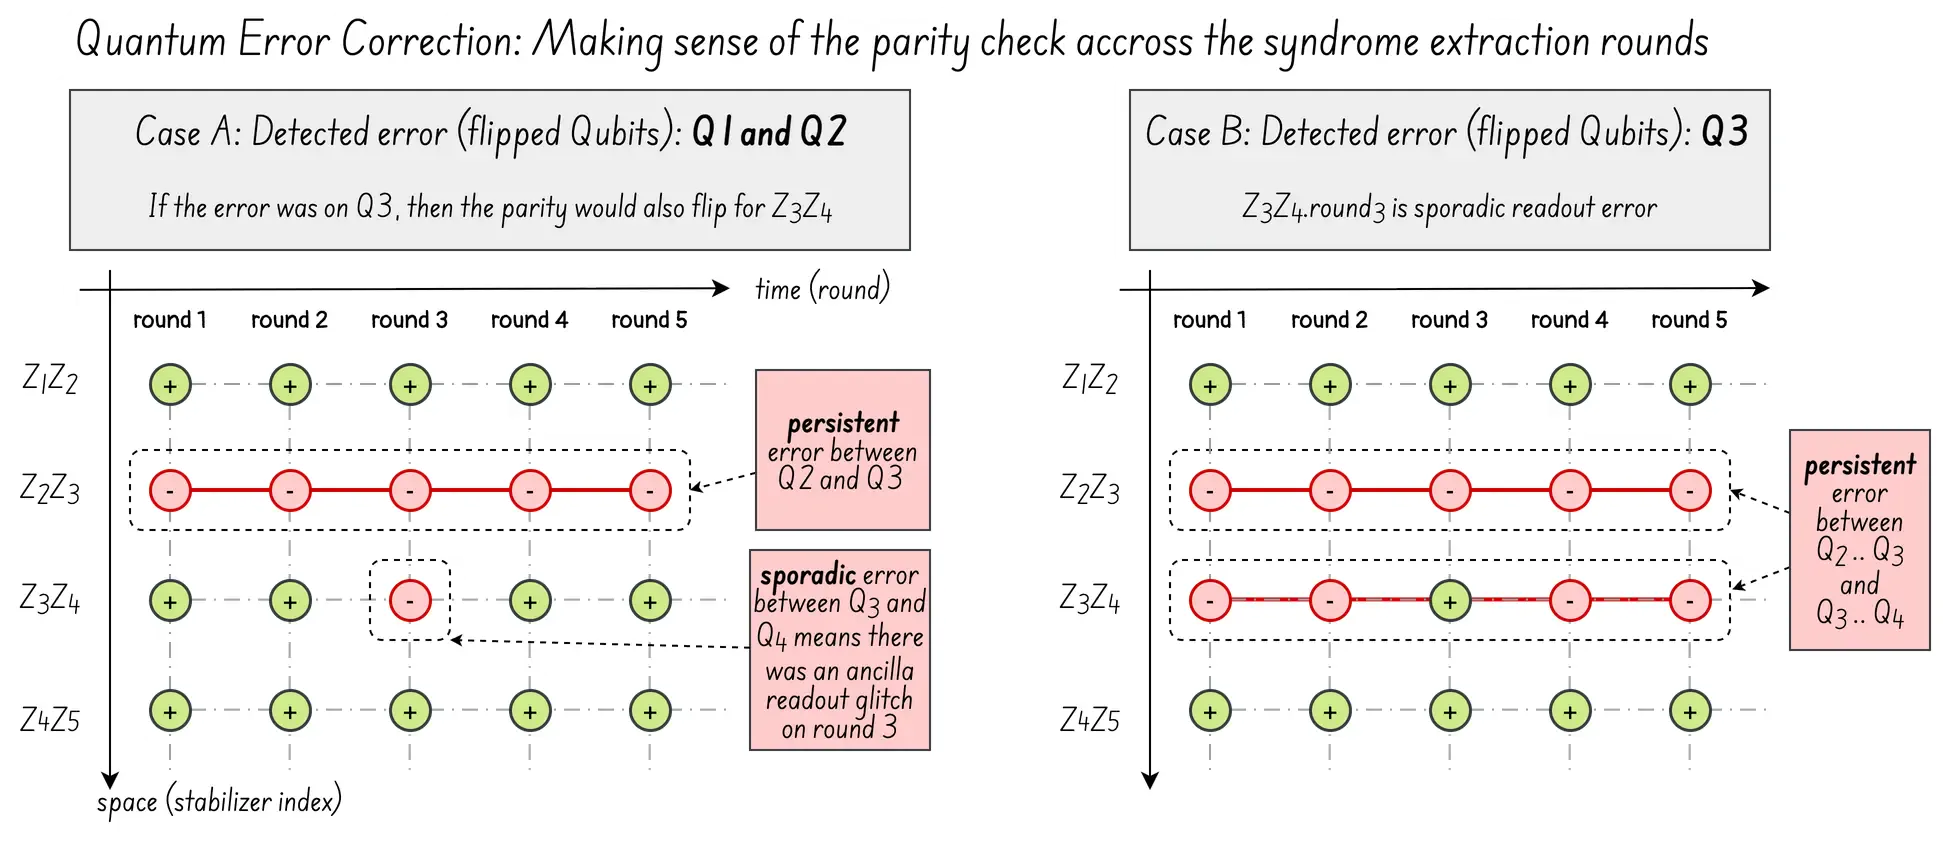
左侧图示(情况 A)中,错误似乎出现在数据量子比特 3 上,但实际上错误也出现在数据量子比特 1 和 2 上。红色水平线表示错误仅发生在Z₂Z₃中。如果错误出现在量子比特3上,则Z₃Z₄也会翻转。因此, Z₁Z₂代表拜占庭错误,意味着 Q1 和 Q2 都发生了翻转。右侧图示(情况 B)显示了如果错误出现在量子比特 3 上的预期结果。
幕后揭秘:QEC的“魔力”
第二部分内容稍显晦涩,但对于理解后续关于逻辑群中物理量子比特编排的备忘录至关重要。我尽量用浅显易懂的方式阐述,避免涉及那些我量子电子工程系的同事们更擅长解释的复杂数学细节!
Q1 + Q2拜占庭错误实际上是一种常见的挑战,称为退化错误。具体来说,它指的是两个或多个物理上不同的错误产生完全相同的伴随式比特的情况,在这种情况下,错误之间将无法区分。
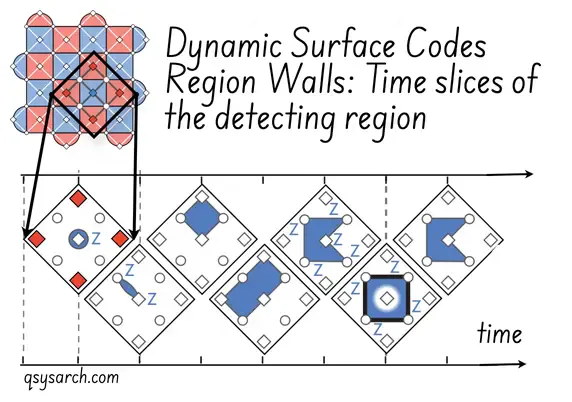 但这在量子纠错(QEC)中并非问题:稳定器并非直接用于检测错误。相反,稳定器用于识别物理量子比特边界(即域壁),错误综合征会在此处发生反应。然后,通过增加冗余度以重叠边界,可以精确定位单个错误(或者,也可以使用GoogleAI的时间动态表面码,如右图所示)。
在量子系统中实现这种冗余机制本质上非常复杂,需要深厚的数学基础。为了理解这个高层次的概念,我们需要回归基础:奇偶校验究竟是如何工作的?
奇偶校验是如何工作的?
链接到标题
乍一看,奇偶校验是如何进行的似乎并不清晰,因为确定奇偶性需要知道预期的伴随式比特,而这取决于数据量子比特的状态。然而,预先知道数据量子比特的状态就违背了量子计算的初衷。换句话说:
“如果我们不知道量子态,又如何判断它是否发生了变化呢?”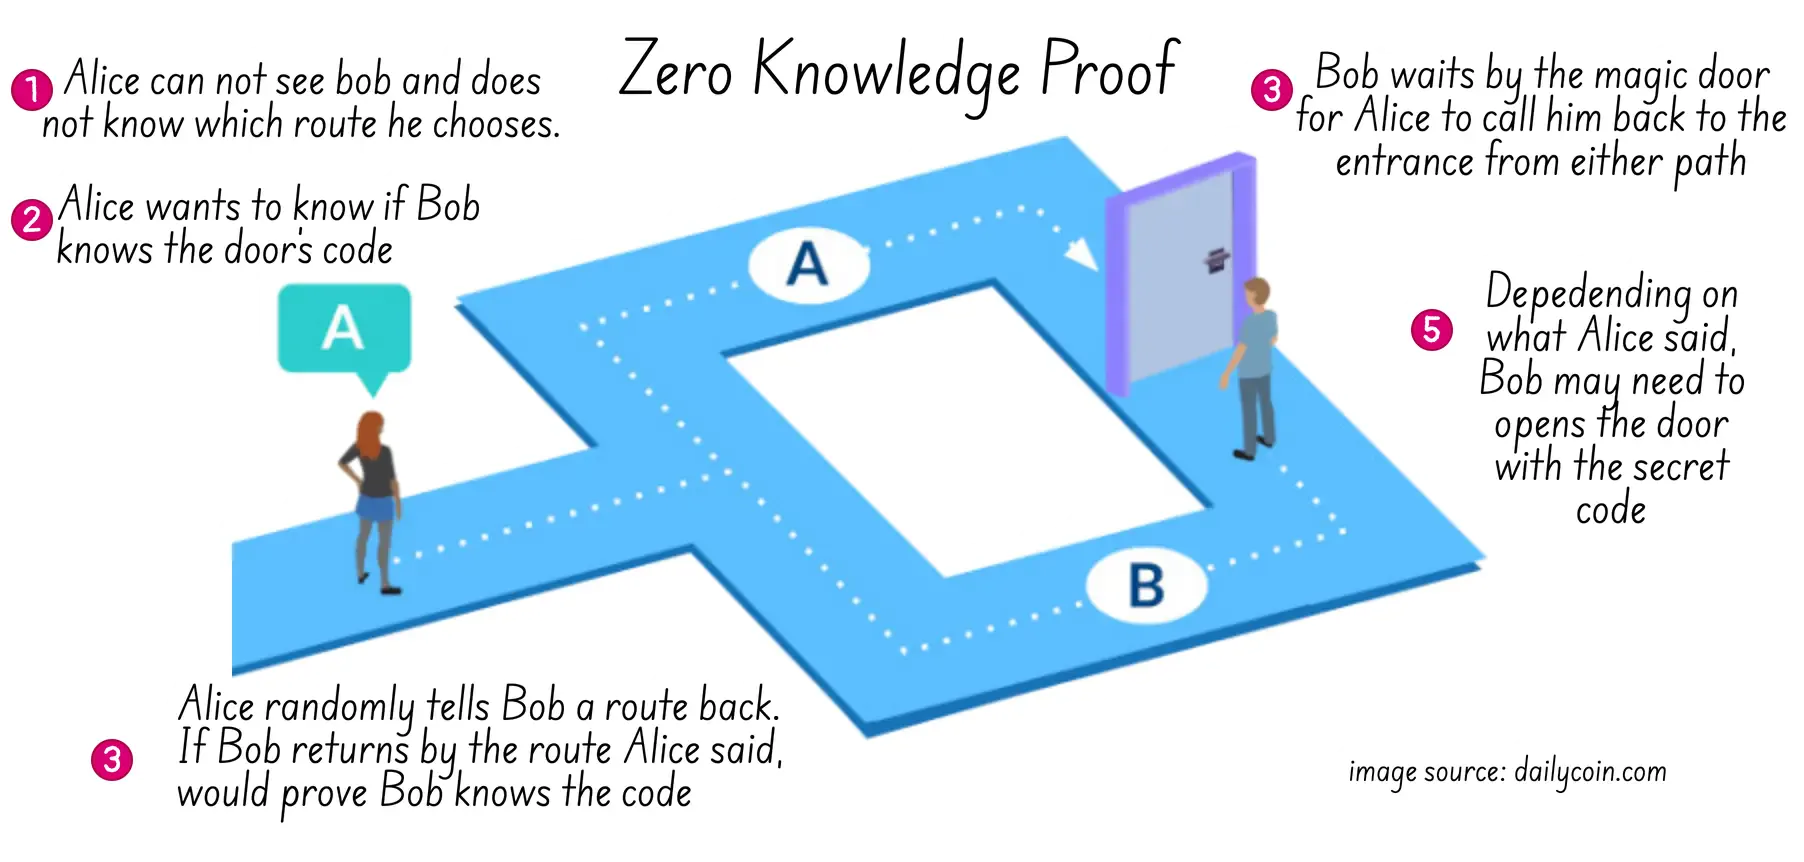 要解决这个挑战,关键在于借鉴阿里巴巴洞穴实验中使用的零知识证明 的技巧:只需提出一些特定的问题,而这些问题的答案是已知的,与编码的量子信息是什么无关(图片来源:dailycoin)。
这些具体问题对应于泡利稳定器算符。伴随式比特(或测量结果)可以看作是路径 A 或 B。在量子纠错(QEC)中,路径 A 代表有效状态,而路径 B 表示错误。QEC“引擎”需要构建的量子电路能够以一种保持这种约束(也称为“受保护状态”)的方式作用于逻辑量子比特。
工程设计在此变得至关重要。为了确保在没有错误时,综合征测量结果始终返回路径 A,否则返回路径 B,多量子比特奇偶校验信息必须以某种方式编码,使得每个有效的编码状态下量子比特之间的关系都是固定的。
这就是编码电路的功能。它的目的是将一个简单的、未受损的输入状态(例如具有空白辅助量子比特的单个物理量子比特\(|ψ> = α|0> + β|1>\) \(|00...0>\) 映射到一个高度纠缠的逻辑量子比特状态\(|ψ_L>\),该状态受到量子纠错的保护。
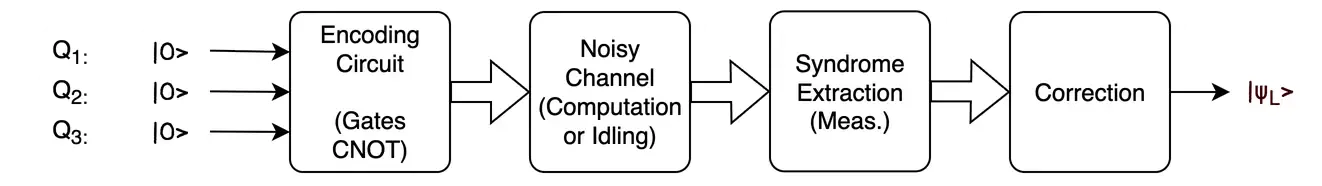
我将在后续备忘录中更详细地讨论编码电路。目前,我们可以将编码电路视为一种经过精心设计和专门设计的量子电路,用于初始化或引导逻辑量子比特进入受保护状态。
为了修复退化错误(即“拜占庭” Q1 + Q2综合征),可以通过增加所谓的码距\(d\)来提高冗余度。乍一看,码距\(d\)可以定义错误保护的鲁棒性。
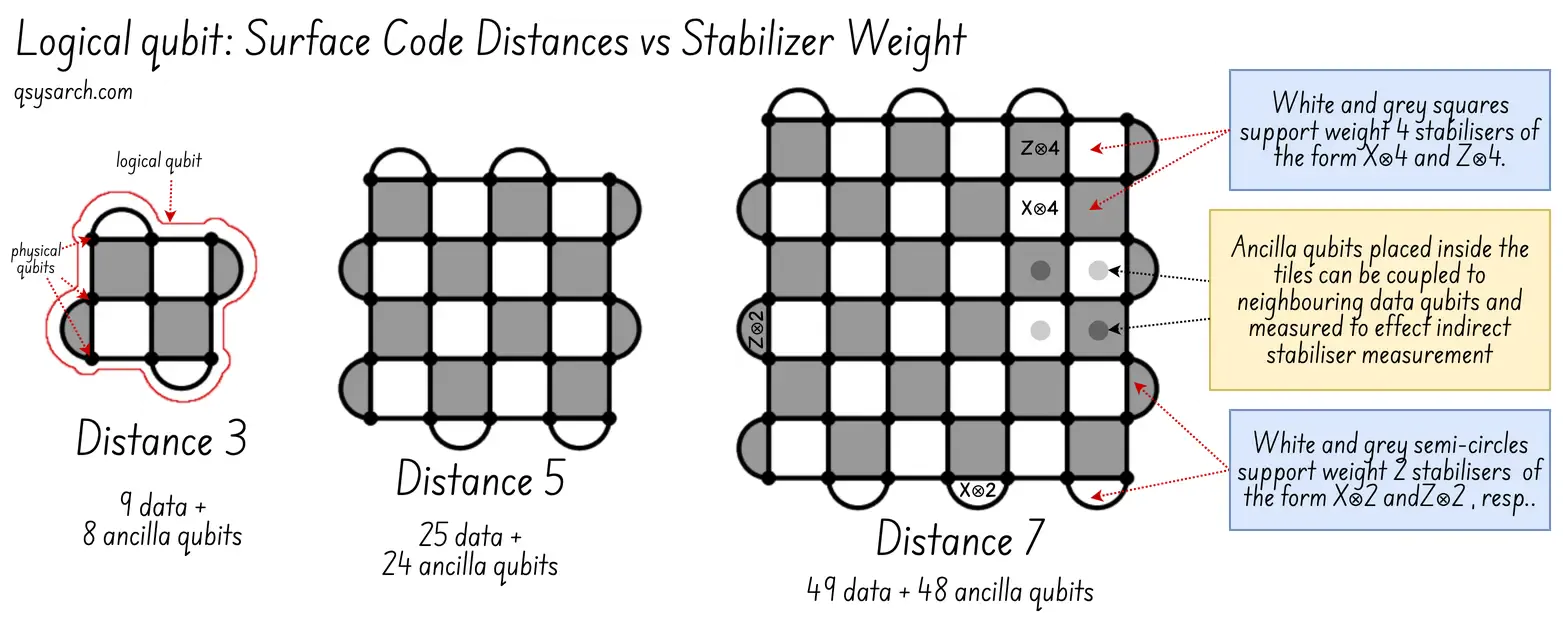
如果码距为 \( d=3 \),翻转两个相邻的量子比特会破坏信息,量子纠错 (QEC) 无法纠正逻辑量子比特,即无法将逻辑量子比特维持在受保护状态。当码距增大时,例如 \( d=5 \),QEC 解码器可以确保即使Q1和Q2翻转并相互掩盖,从而避免Z1Z2校验失败,增加稳定器测量也能为解码器提供足够的上下文信息,从而识别出Q1和Q2 的双重故障。从数学角度来看,这可以表示为:
距离为 \( d \) 的码最多可以检测\( (d-1) \) 个错误,并纠正\( \lfloor (d - 1)/2 \rfloor \) 个错误。
如果冗余可以解决问题,为什么不直接使用更高维度的表面码呢?问题在于,每增加一个物理量子比特(以提高冗余度),就需要测量更多的稳定器。而更多的测量意味着更多的风险(发生物理错误的可能性)。
这就引出了所谓的**阈值定理**
一个大小为 \(N\) 的量子电路可以通过一个噪声量子电路高精度地实现,前提是噪声电路中每个位置的错误概率低于一个固定的阈值 \(p_{th}>0\)。噪声电路的大小与 \( O(N.log^c(N)) \) 成正比,其中 \(c\) 为正的常数。
简单来说,阈值定理意味着,只要物理量子比特的错误率 \(p\) 低于阈值 \(p_{th}\),就可以添加更多物理量子比特来改进纠错,并且增加的量子比特数量的复杂度为 \(N.log(N)\) 。
为什么这很重要?因为它表明,即使量子比特并非总是“表现正常”,只要这种情况发生的频率不高,就有可能使一组更大的量子比特表现得比单个量子比特的总和更好,从而为后NISQ时代,即FTQC(容错量子计算)时代打开大门。
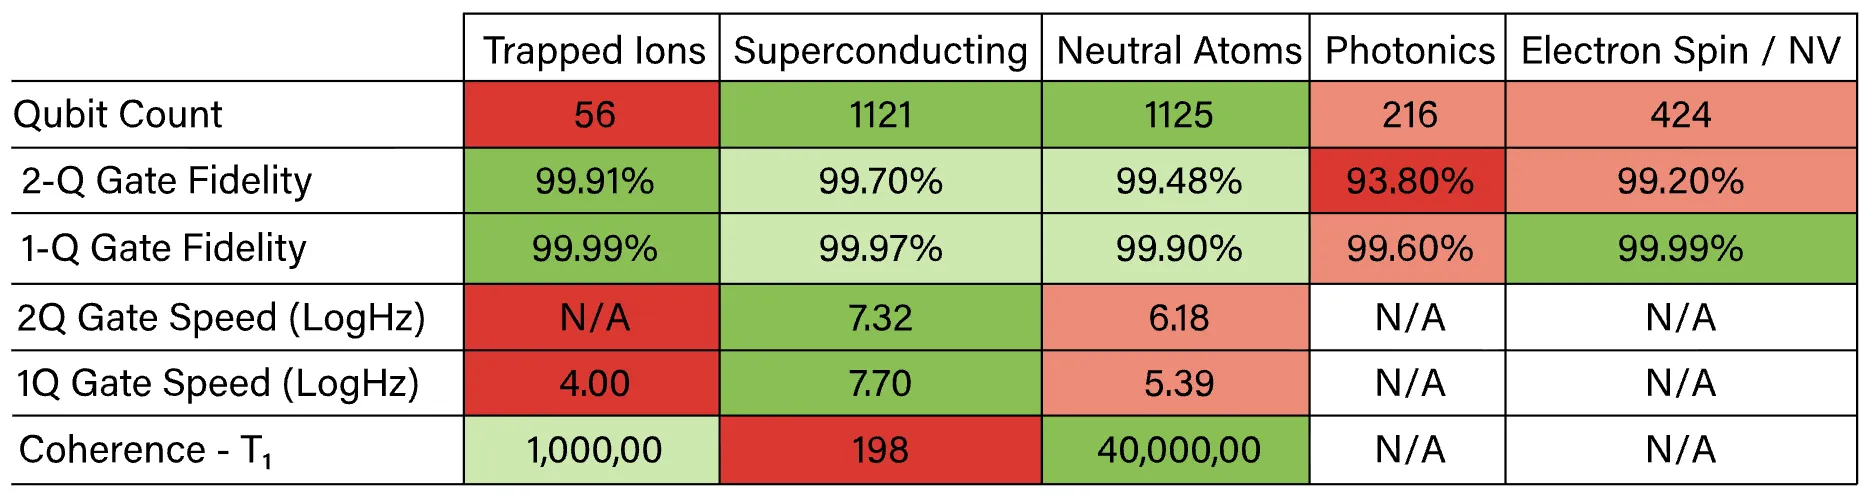
当然,这里最关键的问题是这个阈值 \ (p _ {th} ) 是多少。它们的量级在 0.1% 到 1% 之间,虽然看起来很低,但这并不是问题,因为现代量子比特已经可以实现 99.9% 的保真度(对于单量子比特门)。
# 结论
瞧,这份简短的备忘录奠定了量子纠错概念的基础。
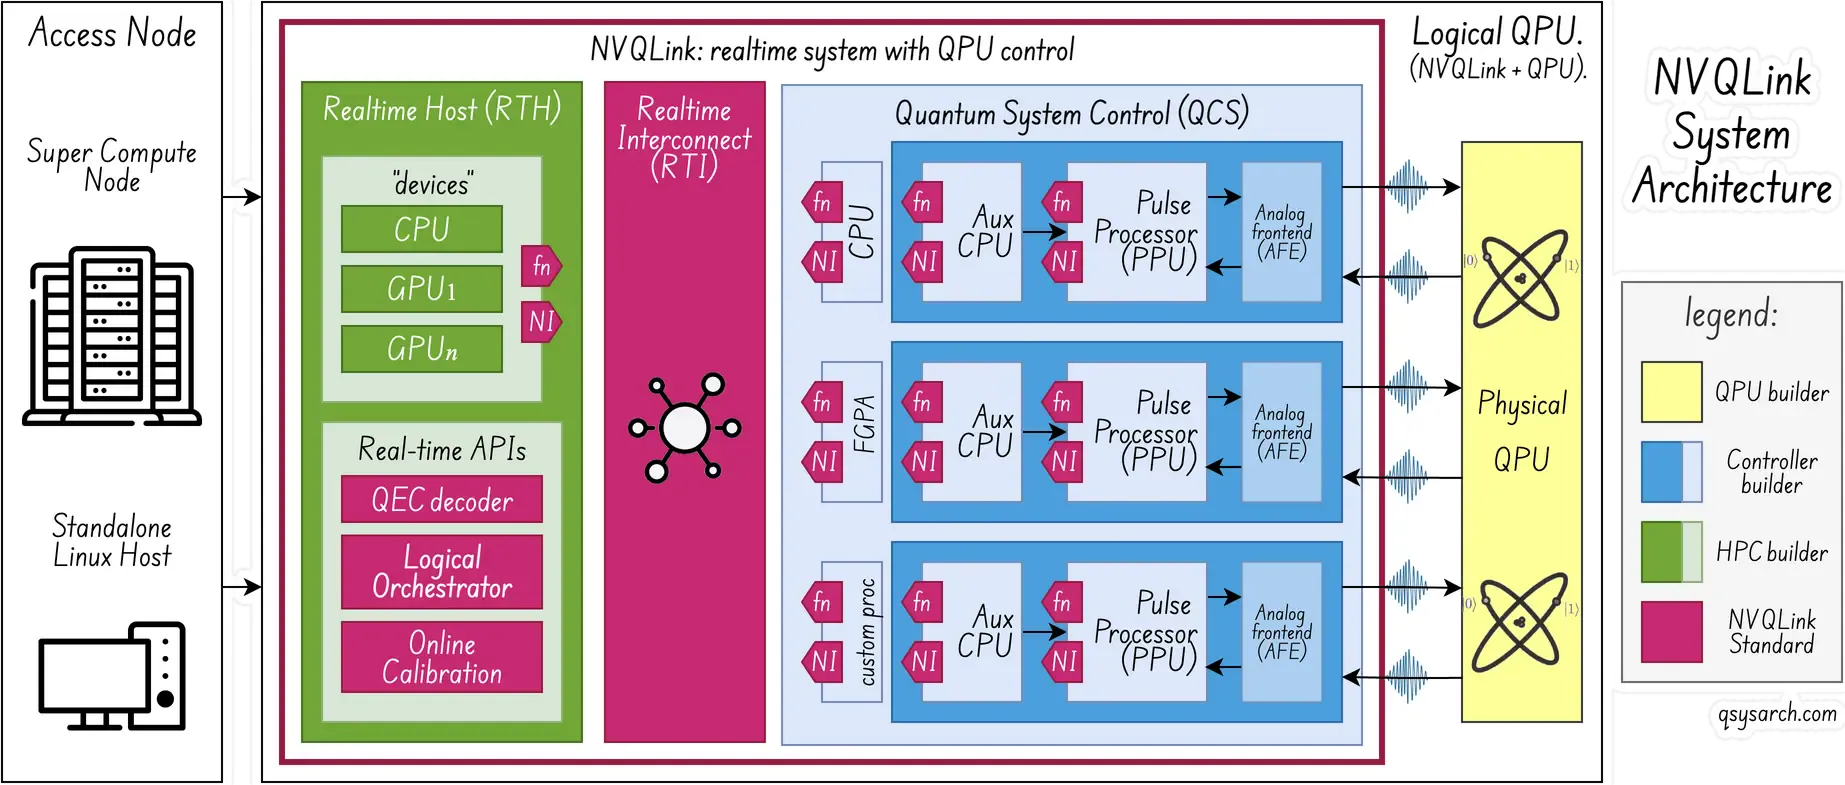
接下来的两份备忘录将更侧重于实践操作。第二份备忘录将从控制、读出和排序等方面分析量子控制系统(以及纠错解码器)将物理量子比特转换为逻辑量子比特的具体含义。第三份备忘录将重点关注解码系统,以及解码器和控制系统之间低延迟和实时通信。
这份备忘录实际上是系列备忘录的第一份。接下来的几份QEC备忘录将重点关注以下主题:
从量子控制系统的角度协调综合症提取
实时错误解码:超低延迟 ASIC、GPU 和神经网络。
协同设计的智能量子比特:以 Alice 和 Bob 的防错量子比特为例
大规模表面代码编译器:最大程度地提高数十亿次物理操作的容错能力
分层解码架构:局部性原理和多层处理
逻辑量子比特编排:晶格手术与编织
超越表面码:向 qLDPC 码的转变
魔幻状态蒸馏与模拟旋转
看来接下来六个月我都要忙这个了!
References:
DrawIO diagrams used in this memo: