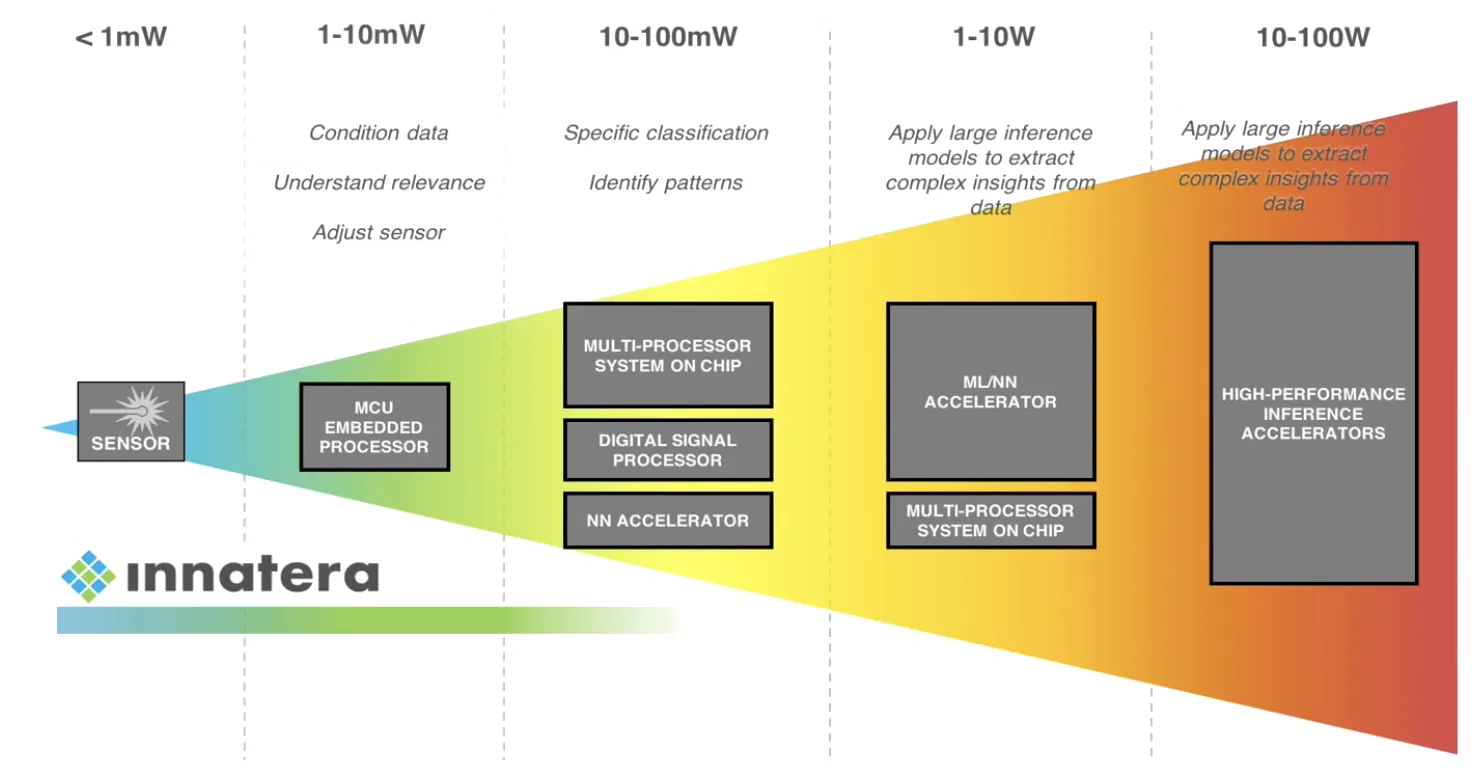
最近在讨论Neuralink公司时,我听说了神经形态处理单元(NPU)。Innatera Pulsar芯片(见右图)虽然与量子计算无关,但我认为花点时间了解一下这种新的处理架构会很有意思。事实上,该领域领先的集成电路供应商之一是一家名为Innatera的荷兰公司。Innatera最新的芯片Pulsar基于低功耗脉冲神经网络(见右图)。
在本备忘录中,我将尝试逆向工程尽可能多的信息,以了解这些神经形态集成电路的架构、脉冲神经网络的设计以及用于对这些设备进行编程的软件栈。
这是对 Pulsar IC 架构图的重新绘制尝试(原始图像,并补充了白皮书中的见解):
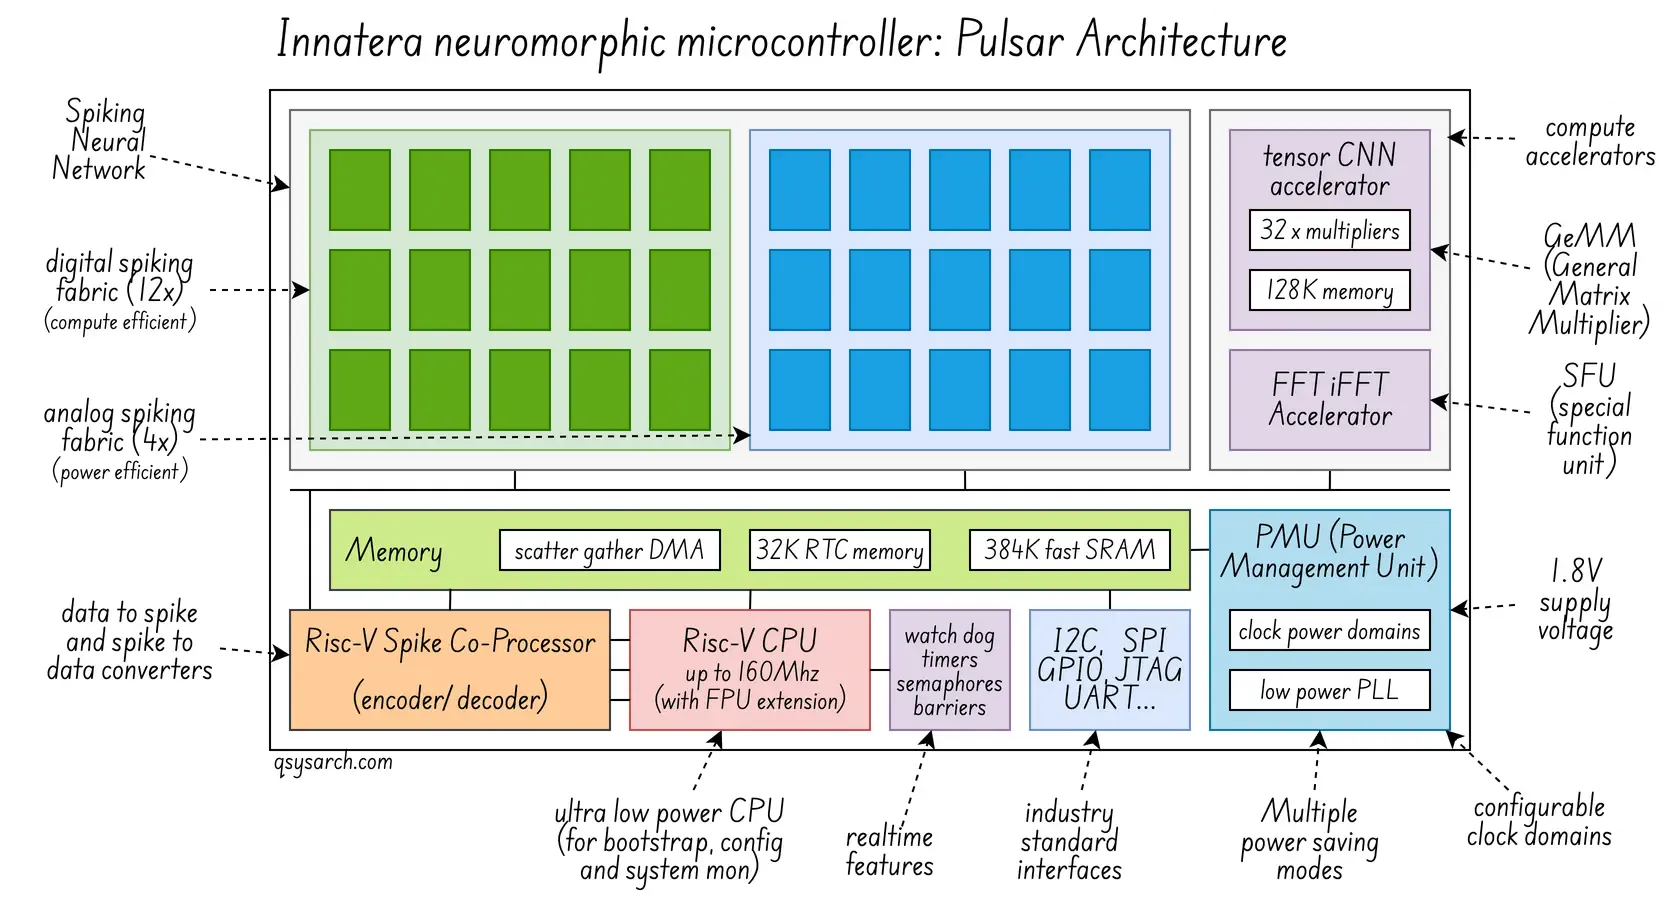
我确实很喜欢使用 RISC-V CPU 的想法——这清楚地表明 Innatera 团队从一开始就做出了正确的架构决策。在 Innatera 早期的 T1 芯片的一张示意图中,RISC-V CPU 与 F 扩展(浮点运算支持)捆绑在一起。
该集成电路集成了多种标准接口(SPI、I2C 等)和一个电源管理单元 (PMU),用于在进入“睡眠模式”或“省电模式”时开启或关闭集成电路的某些部分。遗憾的是,除了一个球形电池组显示“小于 1mW”之外,我找不到任何关于实际功耗的数据。假设供电电压为 1.8V,则电流将小于 500 µA(I=W/V)。我还想知道“每个周期”的功耗指标是否相关:在这种情况下,假设频率为 100Hz(突触更新周期),则平均每次突触更新的电流为 5 µA。
Pulsar 最新发布的架构图显示了两个加速器:一个 CNN 和一个 FFT。我认为更广义的描述应该是 GEMM(通用矩阵乘法器,神经网络计算的关键)和 SFU(特殊功能单元,用于加速 FFT 计算)。更多信息请查看关于 GPU 架构的帖子。此外,还有一个脉冲编码器-解码器,它似乎是作为 RISC-V 的协处理器开发的,但我没有找到更多细节。
剩下的问题是关于脉冲神经网络(Spiking Neural Network,简称 SNN):它是如何工作的?
我请 Gemini 用一个比喻向 8 岁的孩子解释脉冲神经网络。以下是他们给出的比喻:
把大脑想象成一个巨大的邮局,“神经元”就是传递信息的信使。
- 信使和笔记:
在普通的计算机程序中,每个通信节点都在不停地传递和发送数字。而在脉冲神经网络中,通信节点则非常安静且节能:它们只在发生重要事件(例如微小的电脉冲)时才发送一条简短的“嘿!”消息。
- 火花表:
每个信使都有一个能量槽,当他们听到其他人喊“嘿!”时,能量槽就会充满:当能量槽充满到一定程度(达到阈值)时,该信使也会兴奋起来,喊出“嘿!”。喊完之后,能量槽会重置,所以他们不能立即再次喊叫(不应期)。
- 时机至关重要:
如果信使快速听到很多声“嘿!”,说明信息非常重要(比如“着火了!”)。如果某个信使比其他人稍早喊一声“嘿!”,这可能是一个秘密信号,预示着有特殊的事情发生(比如“老虎来了!”)。所以,信使需要掌握时间。
- 学习是关键:
信使们和你一样会学习:如果信使 A 在信使 B 喊出“嘿!”之前喊出“嘿!”(因为有什么事让他们俩都兴奋起来),他们的友谊就会更加牢固,信使 A 的信息也会帮助信使 B 下次更快地填满能量槽。
脉冲神经网络(SNN)之所以特别,是因为它们的设计目标是极快且高效。它们不会一直浪费能量进行通信;只有在需要共享大量信息时才会激活!它们帮助计算机理解时间、识别模式,而且功耗极低。
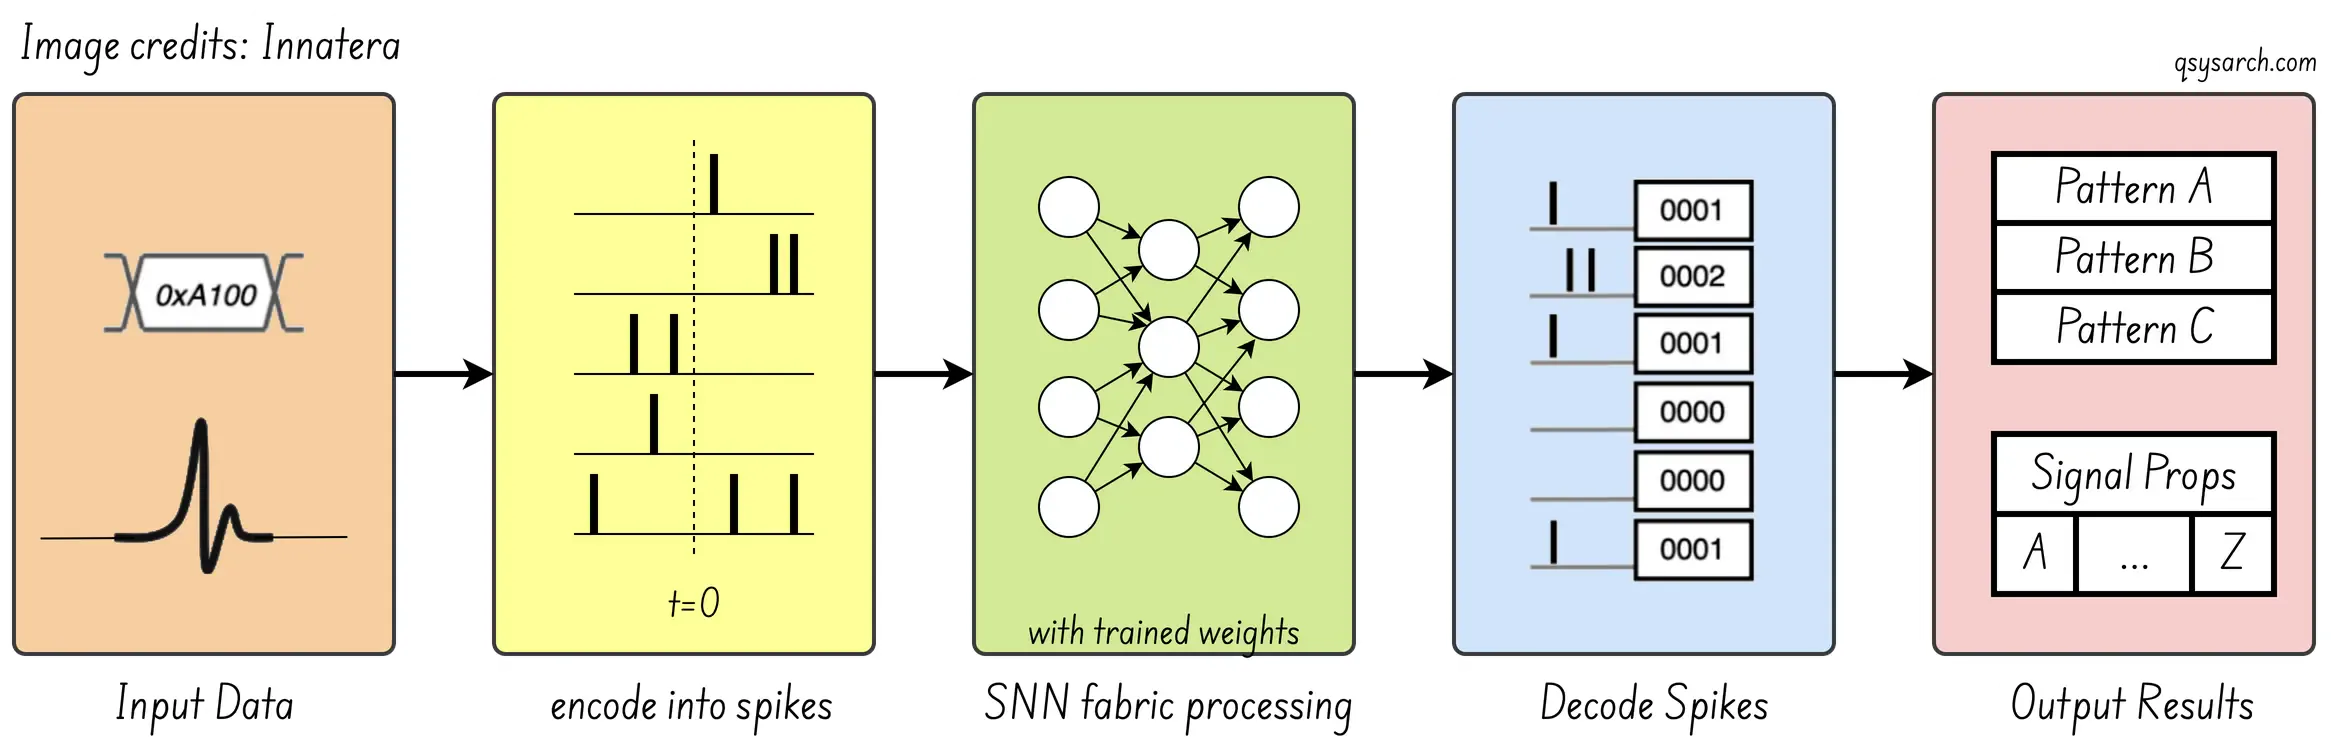
Innatera 的博客“脉冲思维”(Thinking in Pulses)很好地概述了如何在硬件中实现这一功能。将“嘿”声编码成二进制值,输入神经网络,然后提取特征。到目前为止,没什么特别的;这是一个标准的神经网络处理过程。
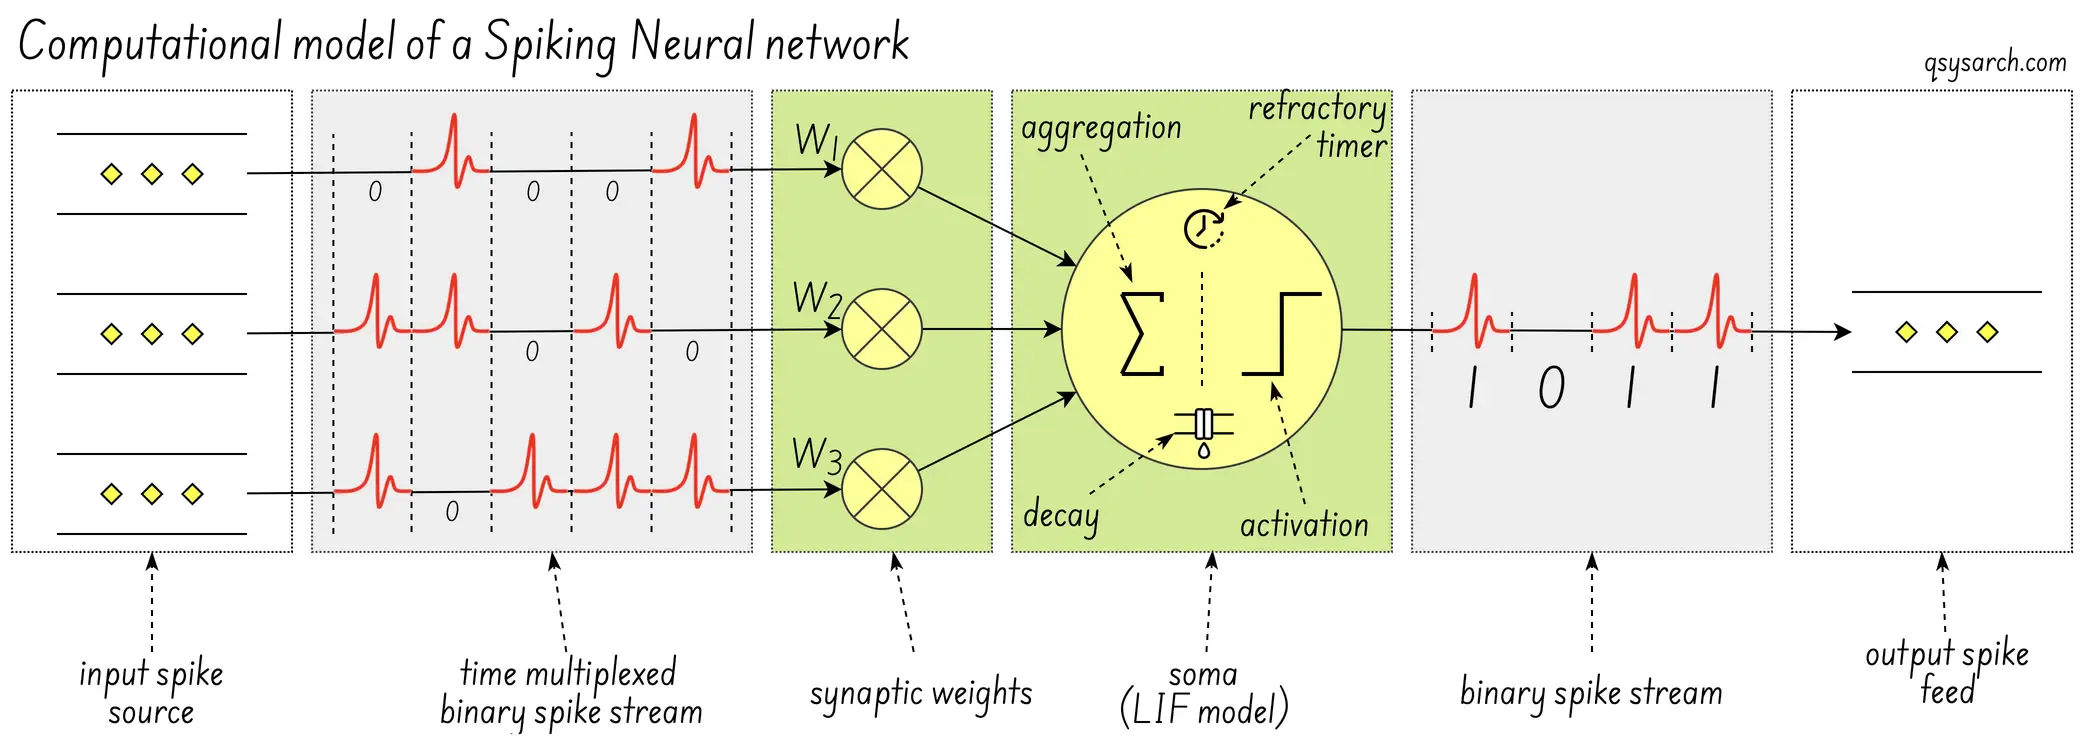
更有趣的问题是这个SNN是如何实现的。下图似乎是一个传统的数字神经元“计算模型”(图像来源)——其中我在SOMA中明确添加了“漏积分-触发”(LIF)的概念。
是什么让硬件实现低功耗
链接到标题
待补充:需要解释
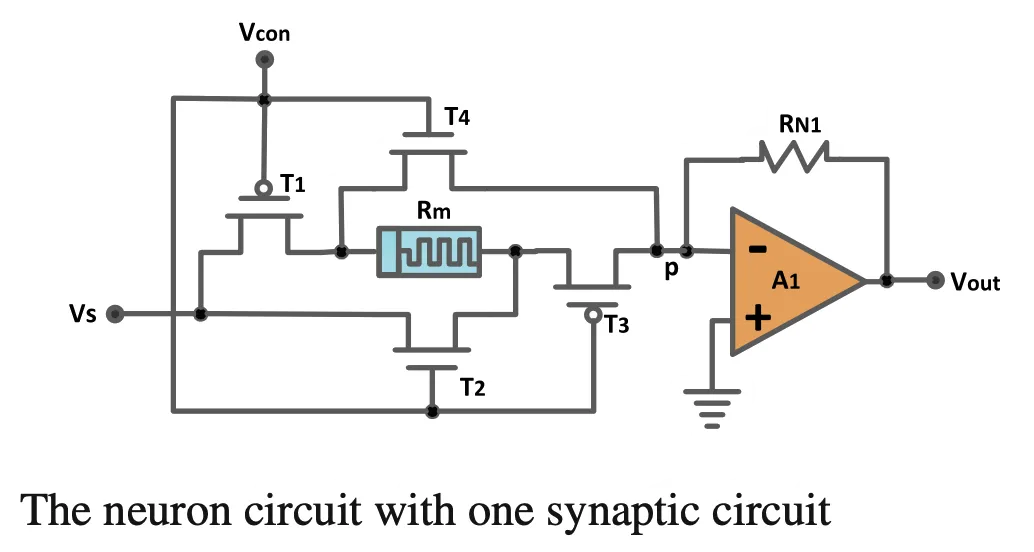
性能提升幅度(10倍、1000倍,还是更高?)
可达到的神经网络传播延迟
权衡取舍和局限性
模拟电路与数字电路设计性能对比。
相对于 GPU/TPU 的功耗
Innatera 的核心设计
链接到标题
Pulsar 设计中的一个问题是:为什么有两个 SNN?答案是,Innatera 的模拟(专有的模拟混合信号)SNN 架构针对最大能效和超快、超低功耗的事件处理进行了优化。而数字 SNN 架构则是一种更可编程、更灵活的设计,支持更多可配置的网络,但功耗略高。(来源)
Innatera 的网站上没有太多关于其脉冲神经网络内部架构的信息,但幸运的是,他们有一些专利,我们可以尝试进行逆向工程!
对于一家初创公司来说,这专利数量相当多!由于时间关系,我只查看了列表中的第一个和最后一个专利。
让我们从第一项专利US20220230051A1开始,它似乎是最接近描述SNN实际硬件实现的专利:该专利的核心是一种组合方法,用于使用“唯一响应”原则,从专门的、预训练的子网络(“单元”)构建SNN。
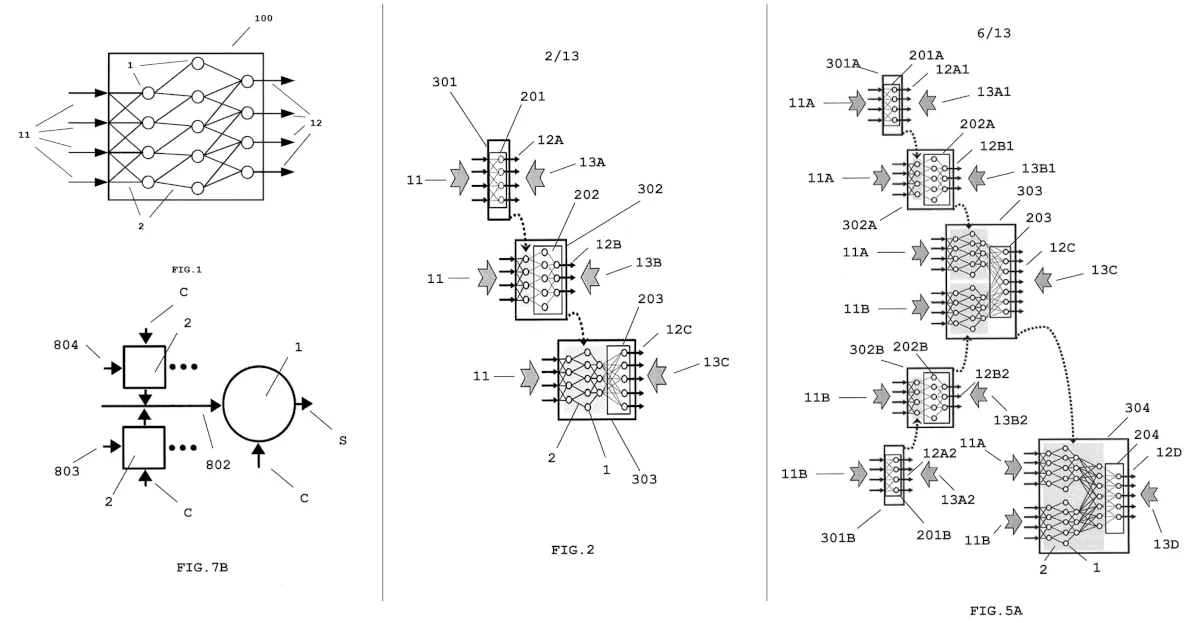
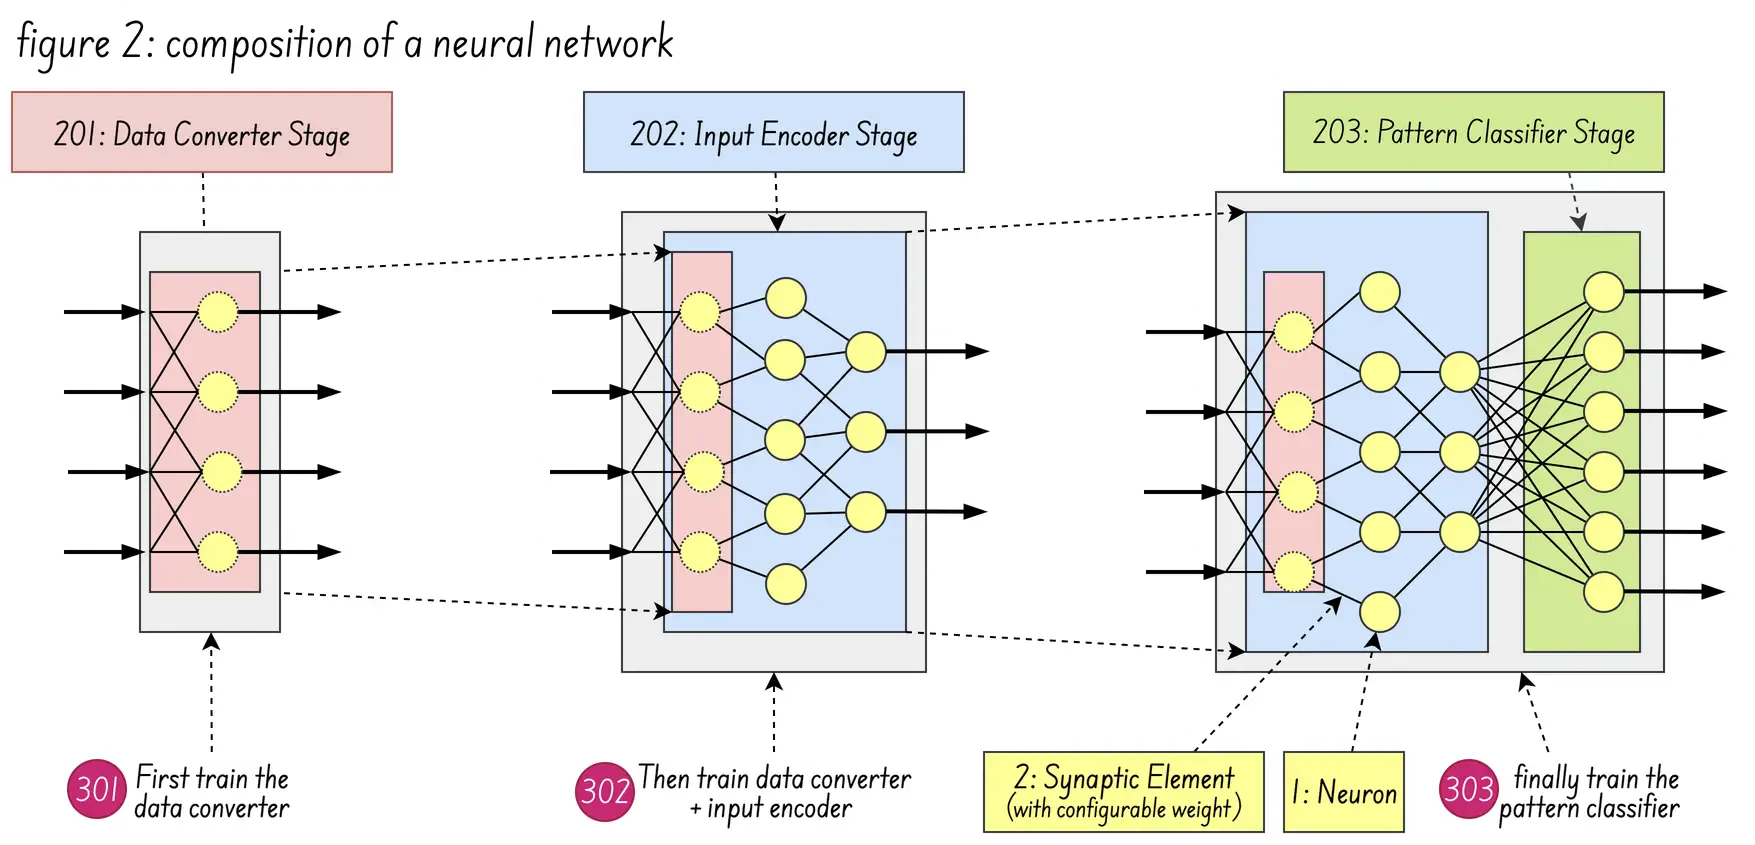
图 2(下方)展示了由数据转换器阶段 201、输入编码器阶段 202 和模式分类器阶段 203 集成而成的神经网络的组成。图 5B(上方)则展示了如何将多个时间脉冲序列融合为一个单一的融合脉冲序列。
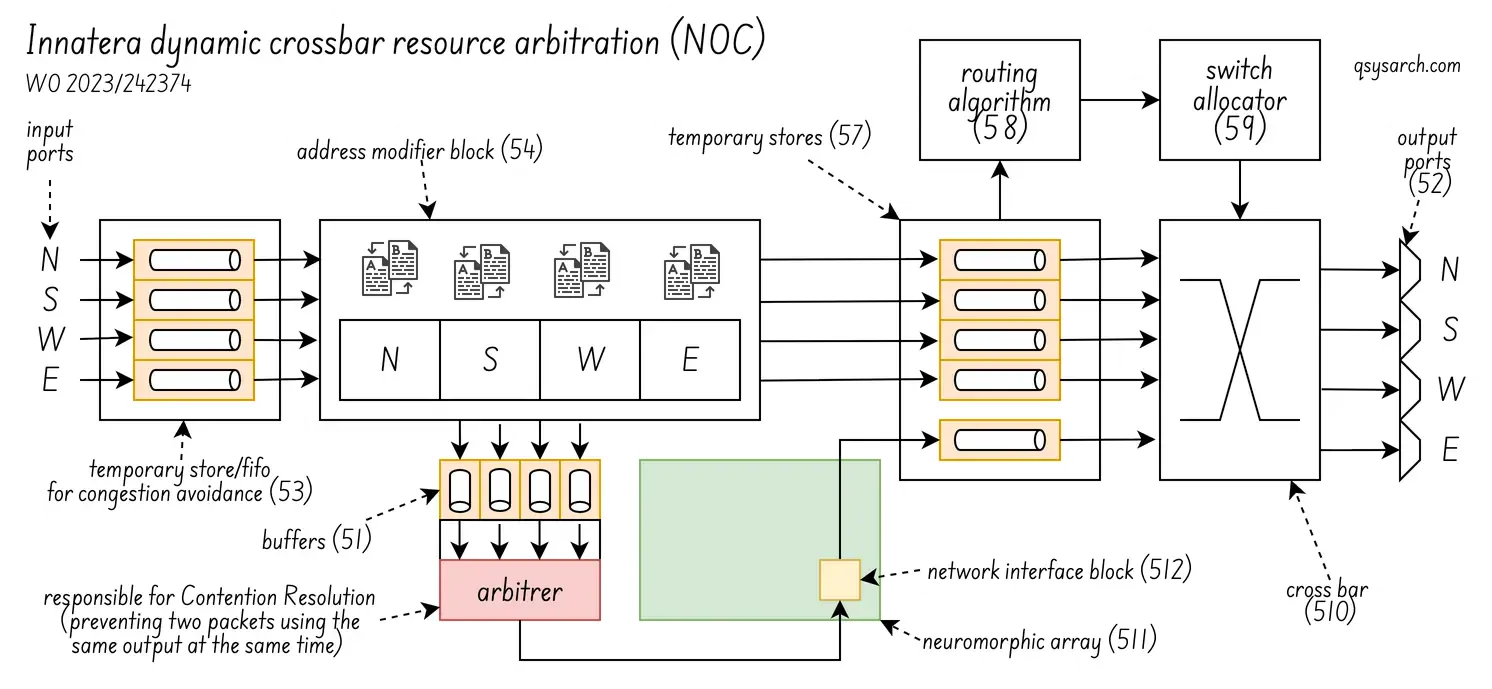
至于最后一项专利WO2023242374A1,它公开了Innatera公司的“脉冲神经网络架构”,该架构用于高效地利用片上网络实现单包组播。其目标是减少多核/众核系统中组播通信的重复数据、延迟和开销。
下图(专利中的图 5)展示了 NOC 仲裁的工作原理。其核心思想是防止两个(或多个)脉冲同时发送到同一个输出端口。这是一种高效的脉冲路由方式,可以确保每个周期都能高效地处理脉冲。不过,我很好奇实际硬件中 FIFO 的深度。
我不清楚的是核心网络和脉冲网络是如何协同工作的:核心网络有多少个神经元?核心网络之间是相互连接的还是协同工作的?或者它们是能够并行处理独立分类任务的独立单元?
我没有关于Innera核心架构的确切答案,但有很多研究论文详细介绍了可能的实现方式。其中一篇题为“神经形态计算机处理器的系统设计视角”的论文尤其值得关注,因为它比较了几种不同的架构。
其中一种架构是“可重构且非常高效的神经形态系统”,或称 RAVENS,如下图所示:
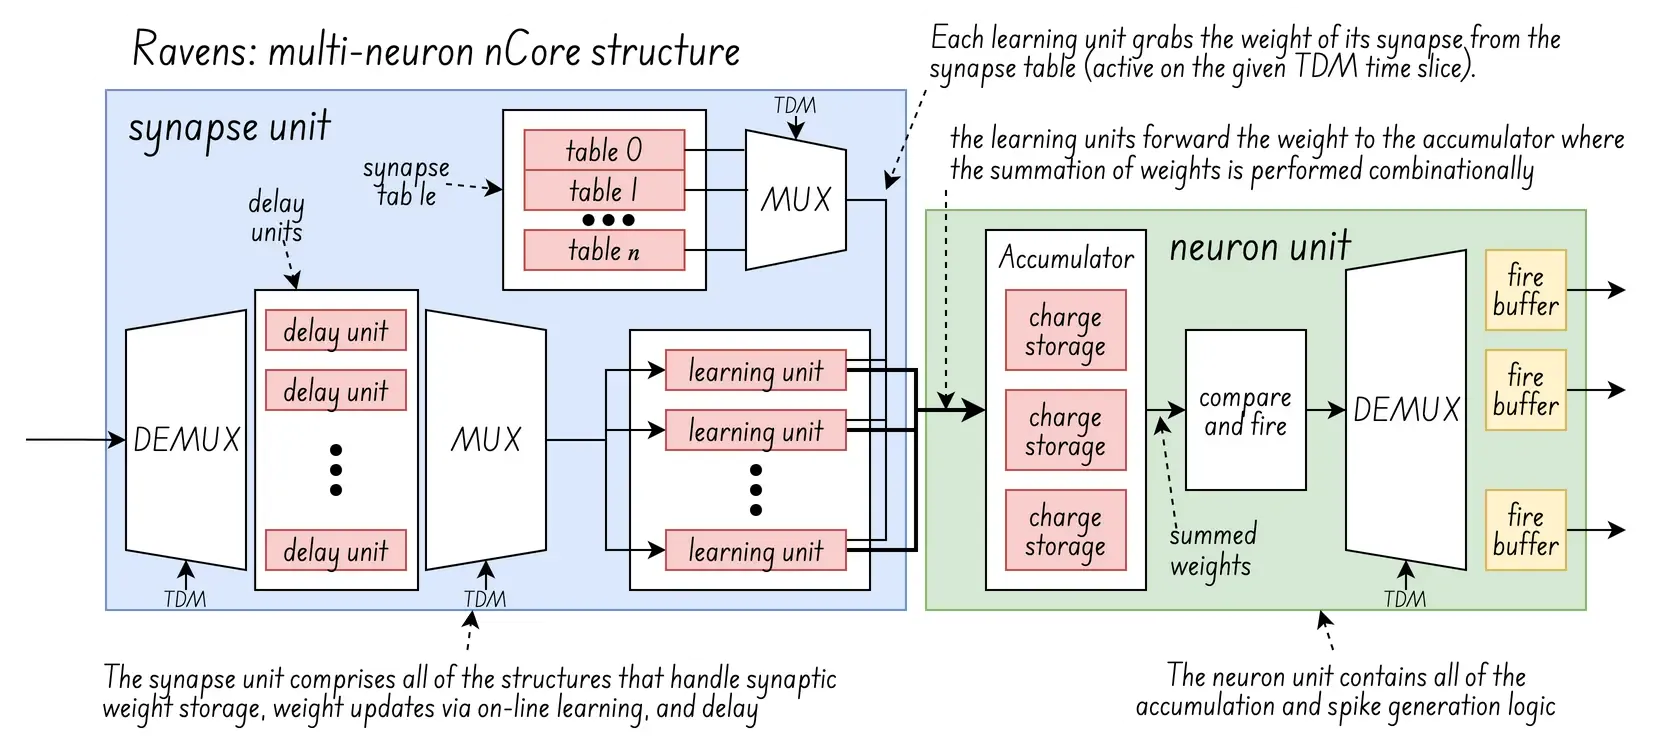 (图表根据原始图像更新:)
RAVENS 的核心思想是利用时分复用 (TDM) 技术,将多个“虚拟神经元”串联起来,分两个阶段进行处理,包括累积和更新。
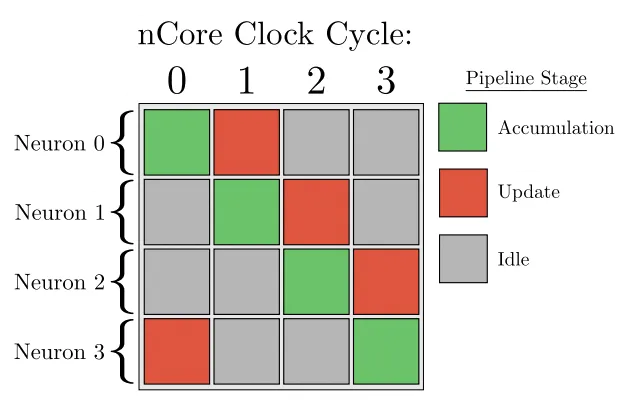
积累阶段:神经元从与其相连的输入突触积累电荷,并根据其预设阈值和不应期状态决定是否发生放电事件。
更新阶段:包括在线学习引起的突触权重变化、电荷泄漏、不应期计数器增量、以及由于退出不应期而导致的累积电荷变化
这里有趣的部分是在线学习:在神经形态集成电路中,在线学习通过使用诸如赫布学习或强化学习之类的算法来改变突触权重,从而根据突触前和突触后神经元的输入实时调整突触强度。
对于模拟内核,这种调整是通过忆阻器或磁隧道结(MTJ)等器件实现的,这些器件的电阻或电导状态会受到神经活动的调节,从而直接表示和存储突触权重。而对于数字内核,至少在RAVENS系统中,这种调整是通过突触表实现的。
软件栈:TALAMO
链接到标题
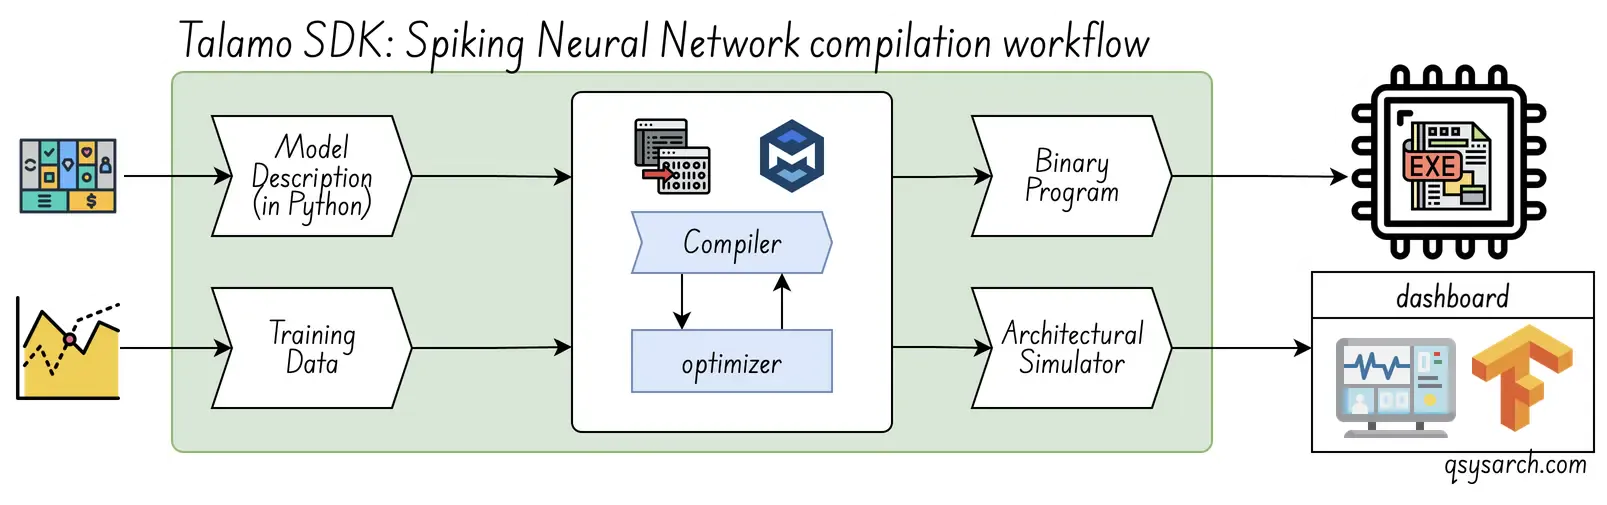
Innatera 的产品包含一个捆绑的 Talamo SDK,它无需 SNN 专业知识,支持端到端应用程序,并使用标准的深度学习工作流程。Talamo 工具包可帮助开发人员在基于 PyTorch 的环境中从头开始构建脉冲神经网络模型。它就像一个 内置电池。
编译工作流程非常标准。下图是 Innatera 原始 资料的略微更新版本,假设工作流程的核心部分是编译器。我还想知道模拟器是否以二进制可执行文件作为输入,如果是这样,它应该被称为模拟器。如果能获得更多关于优化过程的信息就太好了,以及是否存在用户可以调整的参数(例如将权重降低到1.58位)。
一旦生成二进制程序,即可使用此执行工作流程,该工作流程或多或少遵循专利 WO2023242374A1 中定义的流程。
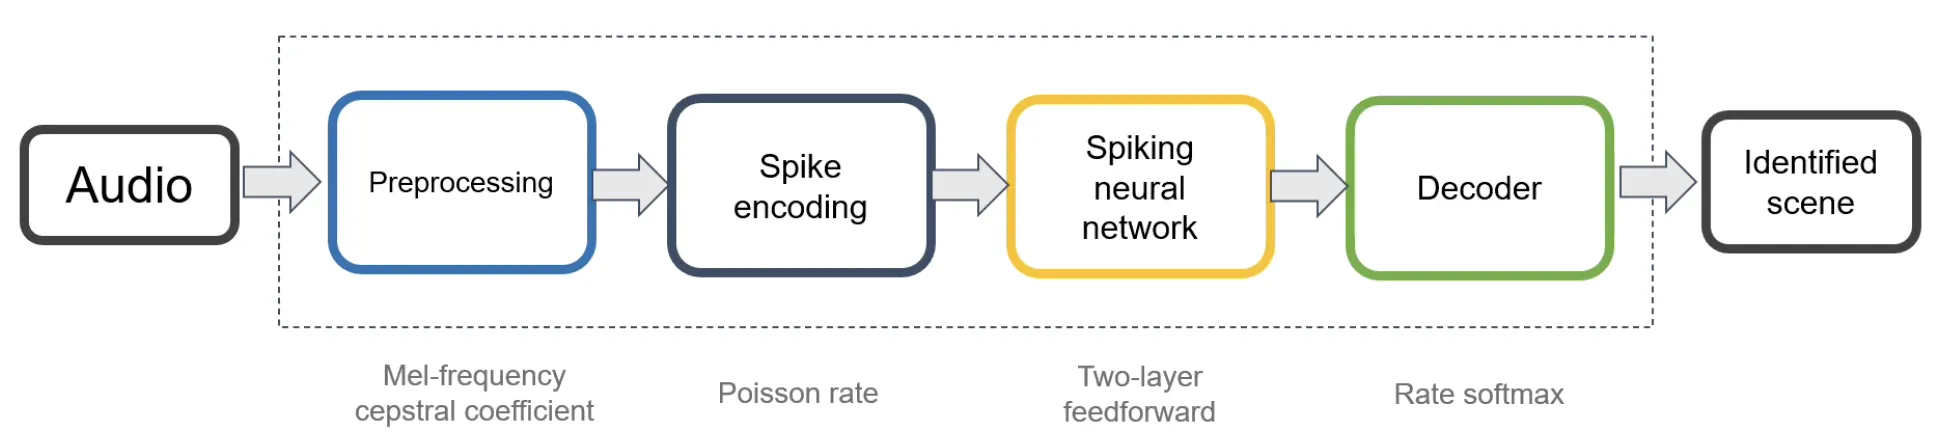
Innatera 的硬件包括强大的 RISC-V 处理器、功能强大的 GEM 处理器和 SFU 计算加速器。对于一些高级用户来说,能够直接访问这些硬件可能比仅仅将权重加载到针对 Innatera 架构的 C 库中更具吸引力。
或许提供某种形式的开源固件 SDK 会很有帮助。或者,可以考虑 CudaNN,它提供通用神经处理器单元 (GPNPU) 的使用体验,就像量子计算行业使用的 Cuda-Q 一样。此外,还可以考虑 NVNLink,类似于 NVQLink,以支持大规模 NPU 网络和混合架构?
也许这就是《神经形态技术的商业成功之路》 中所说的:“直到简单的编程模型和工具出现,以及对硬件的直接API访问,张量处理器才得以广泛应用。” 只需将“张量处理器”替换为神经形态处理单元(NPU)即可?
在我看来,这归根结底就是用户体验 (UX) 和开发者体验 (DX)。我坚信,易用性和开发者体验是打造真正卓越产品体验的关键推动因素或战略支柱。
 (图片来源:archi monarch)
# 结论
以上就是关于神经形态集成电路高层架构的简要概述。毫无疑问,这种硬件架构是一种极具潜力的强大替代技术。然而,有人可能会认为神经形态集成电路缺乏杀手级应用。但这不正是神经形态集成电路的魅力所在吗?难道这意味着我们需要创造与之配套的应用世界吗?
我相信Innetera团队属于“以不同视角看待世界的人”。鉴于人们对人工智能数据中心巨大的能耗需求感到担忧,神经形态集成电路难道不是解决“如何用更少的能源创造更大的价值”这一关键问题的一种方案吗?如果是这样,那么要如何扩展神经形态集成电路,使其计算能力达到人工智能数据中心所需的水平呢?
另外,我想知道在脉冲神经网络(SNN)中加入一些硅光子学技术是否会有帮助?这既有利于神经计算,也有利于在SNN的各个独立成分(IC)之间构建大规模互连网络。
# 参考
本备忘录中使用的DrawIO图表: