
本备忘录旨在了解 RDMA 的内部原理,特别是创建与 PCIe 子系统互连的“符合 RDMA 标准的网卡”所需的技术,例如与 DGX Spark 集成的 200Gb connectX-7(右图)。
RDMA 作为“客户端/服务器”协议
链接到标题
让我们首先概述一下 RDMA 协议。
设置 RDMA 数据通道时,需要先将内存缓冲区注册到网卡才能使用。注册过程包括以下步骤:
RDMA 通信基于一组三个队列。
RDMA 队列对,或称 QP,指的是发送队列 + 接收队列。
RDMA 工作队列元素
链接到标题
应用程序使用工作请求(也称为工作队列元素 (WQE))来发出作业。工作请求是一个包含指向缓冲区指针的小型结构体:
在发送队列中——它是指向要发送的消息的指针。
在接收队列中——它显示了传入消息应该放置的位置。
工作请求完成后,适配器会创建一个完成队列元素,并将其加入完成队列。
简单的 RDMA 写入示例
链接到标题
发送方(左)和接收方(右)实体已创建各自的队列对和完成队列,并在内存中注册了用于 RDMA 操作的区域。发送方实体指定了一个要移动到接收方实体的缓冲区。接收方实体已分配了一个空缓冲区用于存放待处理的数据。
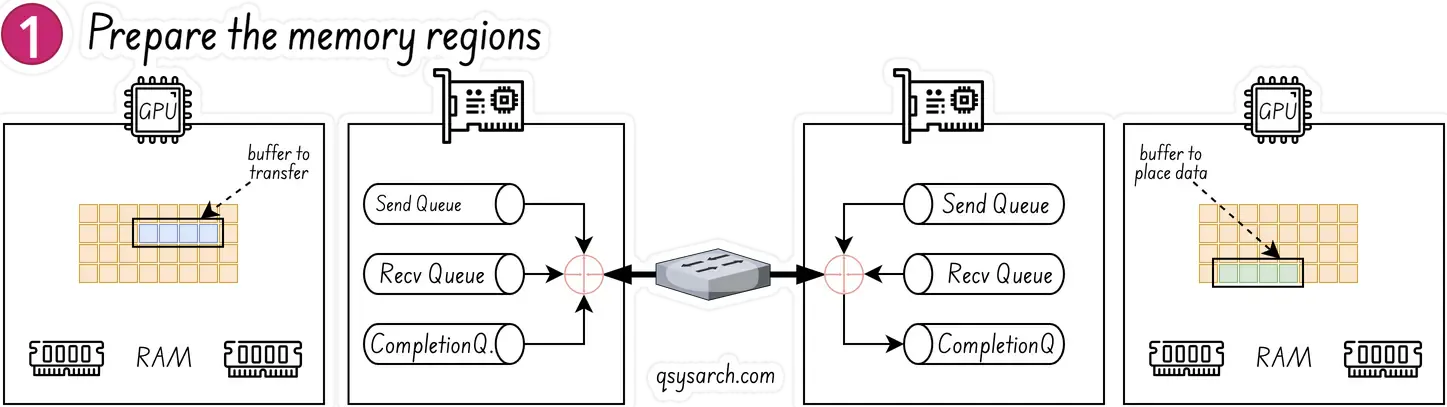
右侧的接收实体创建一个名为 WQE WOOKIE 的工作队列元素,并将其放入接收队列。该 WQE 包含一个指向内存缓冲区的指针,数据将存储在该缓冲区中。左侧的发送实体也创建一个 WQE,该 WQE 指向其内存中待发送数据的缓冲区。
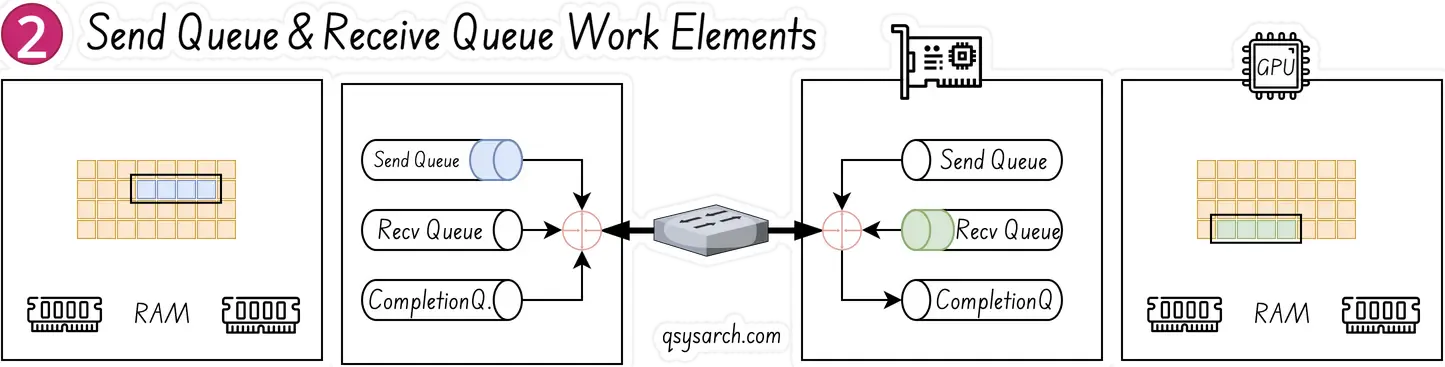
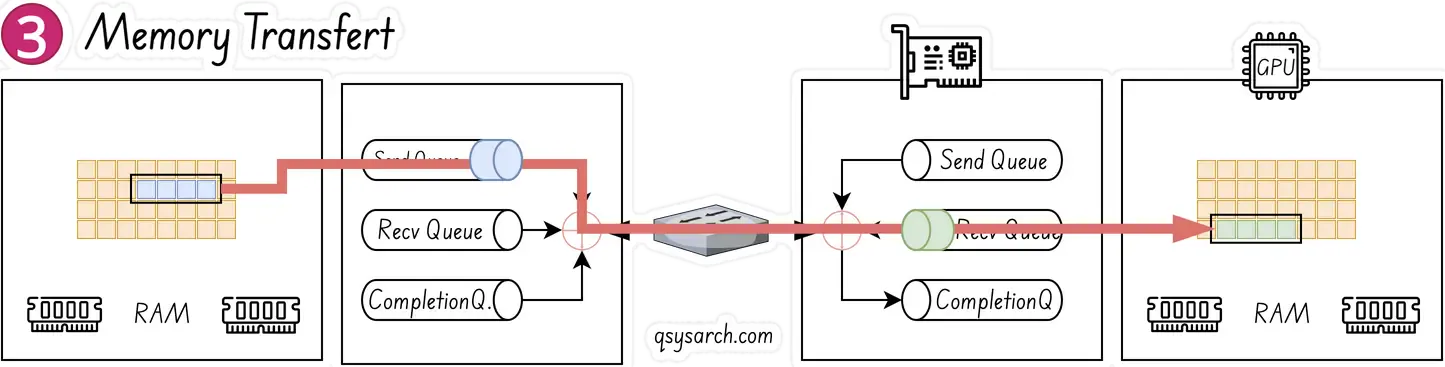
网卡(这里指的是支持 RDMA 的硬件网卡,简称 RNIC)会持续轮询发送队列中的 WQE(工作队列请求),此过程无需 GPU 和 CPU 参与,仅影响 RNIC。一旦 CPU 推送 WQE,RNIC 就会在发送端将其消耗,并开始将数据从内存区域流式传输到接收端。当数据开始到达接收端时,RNIC 会从接收队列中获取 WQE,以确定应该将数据放置在何处。
最后一步,当数据传输完成后,RNIC 会创建一个完成事件 CQE“COOKIE”,并将其放入完成队列中。该事件表明事务已完成。每消耗一个 WQE,就会生成一个 CQE。
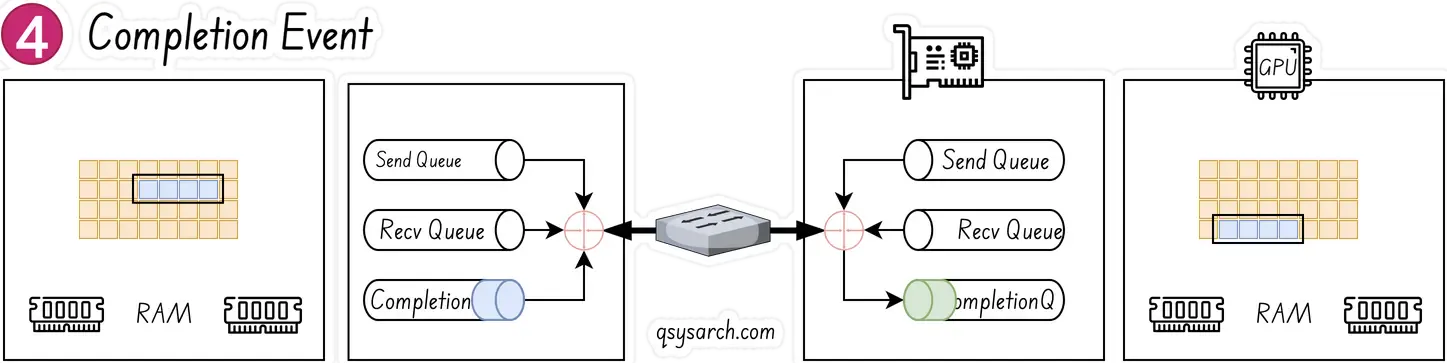
图片来源
需要注意的是,只有发送方是主动的;接收方是被动的;被动方不发出任何操作,不使用 CPU 周期,也不会收到“读取”或“写入”的指示。
要发出 RDMA 读取或写入请求,工作请求必须包含:
这意味着主动方必须事先获得被动方的地址和密钥。
从网络数据包角度看 RDMA
链接到标题
这部分内容基于 Toni Pasanen 的 Network Times 的优秀作品。
客户端计算节点(又称“CCN”)上的应用程序通过向服务器计算节点(又称“SCN”)上的应用程序发送通信请求(又称“REQ”)消息来建立连接。
REQ 消息包含用于识别物理 RNIC 和端口的方法:
- 本地通信标识符 (
LID) 和通道适配器的全局唯一标识符(本地 CA GUID)。本地 CA GUID 用于标识 RNIC,而本地通信 ID 用于标识网卡上的端口。
REQ 消息还包含有关队列对的所有元信息。
本地 QP 编号 (0x1234 5678)
QP 服务类型(连接不稳定)
起始数据包序列号 (PSN: 0x1882)
分区键值 (0x8012)
有效载荷大小(1024)。
REP 消息确认 QP 元数据。最后,客户端发送 Ready to Use (RTU) 消息,向服务器确认 QP 已建立。会话建立后,CCN 上的应用程序即可启动 RDMA 写入过程。

术语:
RDMA 工作请求消息
链接到标题
稍后会补充完整——WR 消息没有什么特别值得一提的地方——如果您想了解更多详情,请查看 Toni Pasanen 的 Network Times 和 InfiniBand 传输协议。
从网络传输角度看 RDMA
链接到标题
RDMA 不可靠连接
链接到标题
RDMA UC(不可靠连接)不执行重传;相反,它依赖应用程序来管理可靠性并处理丢失的数据包,因为 UC 是一种无连接的不可靠数据报服务。网络接口卡 (NIC) 会丢弃数据包而不尝试重传,应用程序负责跟踪并重新请求丢失的数据。这与可靠连接 (RC) QP 不同,在 RC 中,网络硬件会处理重传。那么,RDMA UC 应用程序如何知道数据包是否丢失呢?
如果接收方检测到序列中丢失了一个数据包,它需要通知发送方重新发送该数据包。而如果用于通知发送方的数据包也丢失了,那么情况就可能变得非常复杂。
- 超时:发送方期望接收方确认已收到的数据包。如果接收方未确认,发送方将主动重新发送尚未收到确认的数据包。
我们是否总是需要在 RDMA QP 之上构建一个独立的可靠性模块?不一定。在某些情况下,将丢失的数据包视为整个会话失败的原因,而不是仅仅重发丢失的数据包,也是可以接受的。这种方法之所以有效,是因为底层网络通常足够可靠,能够提供极高的可靠性,例如万亿分之一的数据包才会出现一个错误。
优先级流控制 (PFC) 和显式拥塞通知 (ECN)
链接到标题
RDMA UC 本身并不具备丢包检测功能,因为它是一种不可靠的协议,所以丢包处理由应用层或更高层负责。RDMA 的“无损”保证是通过优先级流控制 (PFC) 和显式拥塞通知 (ECN) 等底层网络技术实现的,这些技术从源头上防止了丢包的发生。
该协议将RDMA数据段封装到UDP数据段中,然后依次添加UDP头部、IP头部和以太网头部,形成一个三层数据包。它可以通过以太网VLAN中的PCP字段或IP头部中的DSCP字段进行分类。
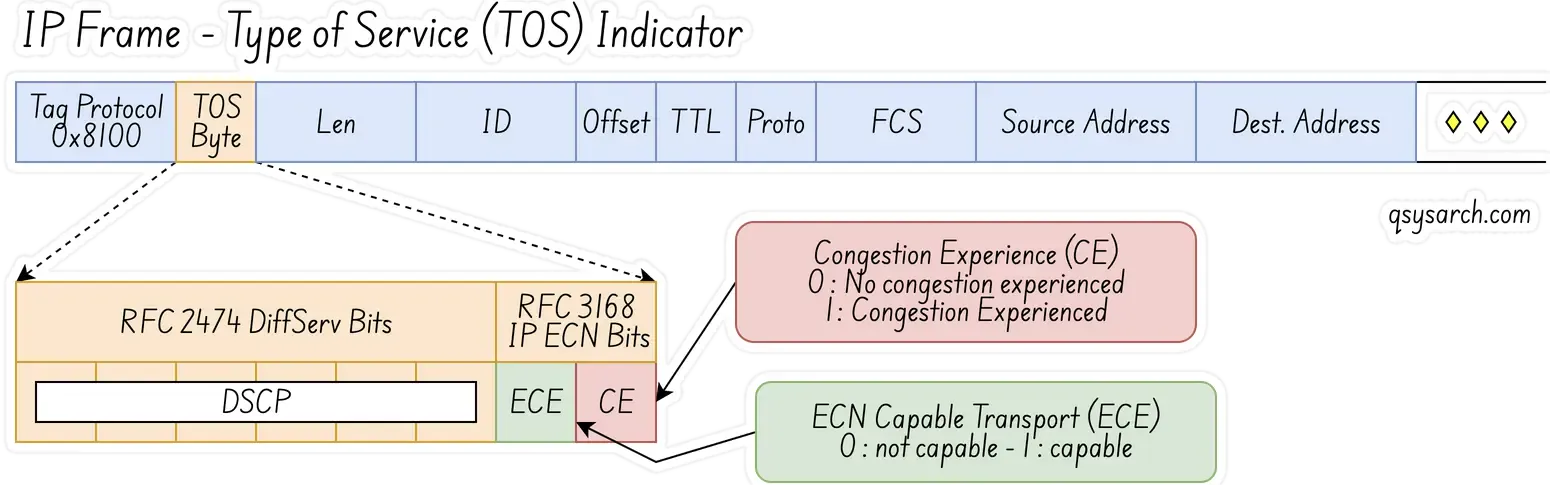
简单来说,在二层网络中,PFC 使用 VLAN 中的 PCP 位来区分数据流。在三层网络中,PFC 可以同时使用 PCP 和 DSCP,从而使不同的数据流能够享受独立的流量控制。目前大多数数据中心都使用三层网络,因此使用 DSCP 比 PCP 更具优势。
图片来源
从 PCIe 角度看 RDMA
链接到标题
 PCIe 分析基于 Dolphin 的优秀论文:SmartIO:通过 PCIe 网络实现零开销设备共享(https://dl.acm.org/doi/pdf/10.1145/3462545)(https://www.dolphinics.com/)。
PCIe 基地址寄存器
链接到标题
PCIe 的核心特性在于,它将设备映射到与 CPU 和系统内存相同的地址空间,如右图所示。由于这种映射关系的存在,CPU 可以像访问系统内存一样读写设备内存。这通常被称为内存映射 I/O (MMIO)。
在初始化时,系统检查 PCIe 树时,会为每个设备的内存区域预留一个内存地址范围(由 BIOS 或内核分配)。然后,该预留地址会被写入设备的基址寄存器 (BAR)。一个设备最多可以有六个 BAR。
PCIe 中断 (MSI)
链接到标题
PCIe 使用消息信号中断 (MSI) 而非物理中断线。支持 MSI 的设备会向 CPU 发送内存写入请求,该请求使用系统提供的特定地址和有效载荷。CPU 读取此内存写入请求,并使用该信息触发中断。
MSI-X 是 MSI 的扩展,它最多支持 2048 个不同的中断向量。其优势之一是,在多核系统中,MSI-X 中断可以针对特定的 CPU 核心。此外,不同的 MSI-X 向量可以指示不同类型的事件。
ConnectX-8 优化设计
链接到标题
[1] 跨两个 CPU 插槽的 GPU 间通信:在传统设计中,此路径可能会遇到主机 CPU 和插槽间瓶颈,根据 CPU 间链路利用率的不同,速度可能限制在 25 GB/s 或更低。相比之下,基于 CX8 的优化设计可为集群内所有 GPU 间通信提供高达 50 GB/s 的 I/O 带宽,因为 NCCL 会将所有流量直接路由到网络。
[2] GPU 与网卡通信:优化的架构在 2:1 GPU 与网卡配置中为每个 GPU 提供 50 GB/s 的带宽,无论 GPU 或主机系统是否支持 PCIe Gen5 或 Gen6。
[3] 通过同一 PCIe 交换机进行 GPU 到 GPU 的传输:配备 PCIe Gen6 的系统相比 Gen5 的带宽提高了一倍,显著加快了通过同一 PCIe 交换机进行的点对点 GPU 传输。
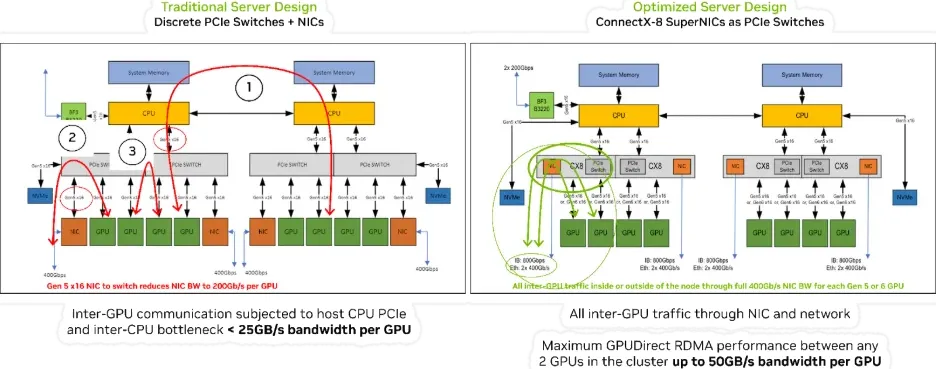
参考资料:NVIDIA ConnectX-8 SuperNICs 平台架构
从程序化 API 的角度看 RDMA
本节内容基于Netdev 0x16 RDMA教程。
## 设置
创建所需对象,包括 PD 和 CQ。
struct ibv_pd *pd = ibv_alloc_pd(verbs_context);
if (!pd) { /* error handling… */ }

struct ibv_cq_init_attr_ex cq_attr = {
.cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
分配一个缓冲区来保存数据,并将其注册到 libibverbs:
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
与 librdmacm 建立连接
链接到标题
类似套接字,具有异步事件驱动接口。(并非绝对必要,但提供了一种涵盖多种传输方式的抽象)首先创建一个“事件通道”:
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
双方都解析到了服务器地址:
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
被动端(SCN)创建并绑定监听“ID”并监听:
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
活动端创建ID并解析服务器地址:
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
用于处理连接事件的事件循环:
struct rdma_cm_event *event;
while (true) {
err = rdma_get_cm_event(test.channel, &event);
switch (event->event) {
case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
}
rdma_ack_cm_event(event);
}
需要处理的重要事件:
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
填写分散列表并将工作请求排队到接收队列:
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
填写收集列表并将工作请求排队发送到队列:
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
对完成队列条目进行非阻塞检查
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
end_flag = true;
/* consume cq->status, cq->wr_id, etc */
err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
从 GPU 直接的角度来看 RDMA
链接到标题
事情开始变得……非常……令人困惑。“GPUDirect RDMA”和RDMA之间有什么关系?正如之前帖子中提到的,Nvidia的官方文档明确指出两者之间没有任何关系!要理解其中的原因,我们需要追溯到它的起源,也就是它还是Mellanox的技术时期,大约在2016年。以下是当时的规范原文:
GPU-GPU 通信领域的最新进展是 GPUDirect RDMA。这项新技术在 GPU 内存和 NVIDIA HCA/NIC 设备之间建立了一条直接的 P2P(点对点)数据路径。这显著降低了 GPU-GPU 通信延迟,并完全卸载了 CPU,使其不再参与网络上的所有 GPU-GPU 通信。
根据 GPUNetIO 规范,启用网卡-GPU内存交互需要执行以下操作:
要使网卡能够使用 GPU 内存发送和接收数据包,请加载 NVIDIA 内核模块 nvidia-peermem,该模块通常包含在 CUDA 工具包安装包中。
GPU数据包处理网络应用可以分为两个基本阶段:
在 CPU 的安装设置阶段,应用程序必须:
因此,DOCA GPUNetIO 由两个库组成:
示例:UDP 网络流量
链接到标题
这是接收和分析数据包头的最通用用例。为了应对 100Gb/s 的传入网络流量,负责 UDP 流量的 CUDA 内核将一个包含 512 个 CUDA 线程的 CUDA 块(文件 gpu_kernels/receive_udp.cu)专门分配给一个不同的以太网 UDP 接收队列。
数据路径循环是:
- 使用名为
doca_gpu_dev_eth_rxq_receive_block 的 GPUNetIO 函数接收数据包。
每个 CUDA 线程处理接收到的数据包的一个子集。
获取包含数据包的 DOCA 缓冲区。
分析数据包有效载荷,以区分 DNS 数据包与其他通用 UDP 数据包。
清除数据包有效载荷,确保旧数据包不会被再次分析。
每个 CUDA 块使用 DOCA GPUNetIO 信号量向 CPU 线程发送统计信息。
CPU 线程检查信号量以获取统计信息并将其打印到控制台。
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
struct doca_gpu_eth_rxq *rxq0,
struct doca_gpu_eth_rxq *rxq1,
struct doca_gpu_eth_rxq *rxq2,
struct doca_gpu_eth_rxq *rxq3,
int sem_num,
struct doca_gpu_semaphore_gpu *sem0,
struct doca_gpu_semaphore_gpu *sem1,
struct doca_gpu_semaphore_gpu *sem2,
struct doca_gpu_semaphore_gpu *sem3)
{
__shared__ uint32_t rx_pkt_num;
__shared__ uint64_t rx_buf_idx;
__shared__ struct stats_udp stats_sh;

doca_error_t ret;
struct doca_gpu_eth_rxq *rxq = NULL;
struct doca_gpu_semaphore_gpu *sem = NULL;
struct doca_gpu_buf *buf_ptr;
struct stats_udp stats_thread;
struct stats_udp *stats_global;
struct eth_ip_udp_hdr *hdr;
uintptr_t buf_addr;
uint64_t buf_idx = 0;
uint32_t lane_id = threadIdx.x % WARP_SIZE;
uint8_t *payload;
uint32_t sem_idx = 0;

if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

if (threadIdx.x == 0) {
DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}
__syncthreads();

while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
stats_thread.dns = 0;

/* No need to impose packet limit here as we want the max number of packets every time */
ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
/* If any thread returns receive error, the whole execution stops */
if (ret != DOCA_SUCCESS) { ... }

if (rx_pkt_num == 0) continue;

buf_idx = threadIdx.x;
while (buf_idx < rx_pkt_num) {
doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
raw_to_udp(buf_addr, &hdr, &payload);

if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

/* Double-proof it's not reading old packets */
wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
buf_idx += blockDim.x;
}
__syncthreads();

for (int offset = 16; offset > 0; offset /= 2) {
stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
__syncwarp();
}

if (lane_id == 0) {
atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
}

__syncthreads();

if (threadIdx.x == 0 && rx_pkt_num > 0) {
ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
if (ret != DOCA_SUCCESS) { ... }

DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
__threadfence_system();

sem_idx = (sem_idx + 1) % sem_num;

DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}

__syncthreads();
}
}
RDMA 在哪里?
在上面的例子中,实际上并没有用到 RDMA。GPUNetIO 只是让 GPU 直接处理数据包。它与 RDMA 唯一相似的地方在于,数据包通过直接 DMA 传输从网卡传输到 GPU,跳过了 CPU 内存。
在结束之前,还有一个令人困惑的地方:DOCA RDMA。在上一节中,我们了解了 DOCA GPUNetIO。但是 DOCA RDMA 是什么?它与我们之前了解的“ibv”API 有何不同?
答案很简单:DOCA RDMA 是 NVIDIA 的软件框架,用于使用 CPU 或 GPU 执行 RDMA 操作。IBV 是传统的底层 InfiniBand Verbs 库,它是用于对 InfiniBand 和 RoCE 硬件进行编程的标准 API 的一部分。关键区别在于,DOCA RDMA 是一个更高级别、更全面的 SDK,它基于 Verbs 接口的基本功能,实现了 GPU 加速,并将 RDMA 任务从 CPU 卸载到 GPU。
例如,这是发送 RDMA 数据包的代码:
doca_error_t rdma_send(struct rdma_config *cfg)
{
struct rdma_resources resources = {0};
union doca_data ctx_user_data = {0};
const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
doca_error_t result, tmp_result;

/* Allocating resources */
result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
doca_rdma_cap_task_send_is_supported,  &resources);

result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
rdma_send_error_callback, NUM_RDMA_TASKS);

result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

/* Include the program's resources in user data of context to be used in callbacks */
ctx_user_data.ptr = &(resources);
result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

/* Create DOCA buffer inventory */
result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

/* Start DOCA buffer inventory */
result = doca_buf_inventory_start(resources.buf_inventory);

/* Start RDMA context */
result = doca_ctx_start(resources.rdma_ctx);

/*
* Run the progress engine which will run the state machine defined in
* rdma_send_state_change_callback(). When the context moves to idle, the context change
* callback call will signal to stop running the progress engine. */
while (resources.run_pe_progress) {
if (doca_pe_progress(resources.pe) == 0)
nanosleep(&ts, &ts);
}

// ... cleanup
}
跳出固有思维:如果不用 RDMA 呢?
链接到标题
我们在上一节中探讨了RDMA的各个方面。RDMA的最终目标是在CPU、GPU和量子控制栈之间实现数据传输,延迟仅为几微秒。需要传输的信息量很大,包括I/Q软读出数据、控制脉冲样本(“波”),以及脉冲的参数配置(通常在神经网络的上下文中)。此外,还需要传输一些更简单的信息,例如逻辑量子比特的伴随式,以及远程调用计算单元中的QEC解码器。在后一种情况下,我们可以简单地称之为“远程过程调用”(RPC)。
好消息是,关于基于 RDMA 的 RPC 的文献资料非常丰富,例如 mRPC,该文献基于 100 Gbps Mellanox Connect-X5 RoCE 网卡,给出了非常有趣的延迟数据。论文中存在一些矛盾之处,例如它指出“在 RDMA 下,mRPC 在中值延迟和尾部延迟方面分别比 eRPC 快 1.3 倍和 1.4 倍”,而表格却显示 eRPC 比 mRPC 更快。但目前,我们可以假设这些延迟数据在实验上是合理的。
 更有趣的是,mRPC 的后续论文https://www.usenix.org/system/files/atc24-ma.pdf,其中使用计算快速链接 (CXL) 创建了一种速度更快的 RPC,他们称之为“HydraRPC”。数据本身就说明了一切,请参见右侧表格。这里需要提出的问题是,五年后情况会如何?在我看来,NVLink 也是一个非常有吸引力的机会……
# 结论
瞧,我花了更长时间才完成这份备忘录,不过我觉得这有助于我更好地理解。我认为 RDMA 和 GPUDirect 之间的混淆源于这样一个事实:RDMA 最初是由 Mellanox 开发的,纯粹是为了改进网络。Mellanox 被 Nvidia 收购后,RDMA 被扩展到可以“连接”到 GPU,但这种扩展并非最初的设计理念,最终成为了 DOCA 生态系统的一个附加组件。

References:
DrawIO diagrams used in this memo: