本备忘录将回归GPU基础知识,重点介绍深度学习的核心运算:矩阵乘法。首先,我将描述其基本实现和理论方法。然后,我将探讨如何优化GPU性能,使其发挥最大效用。
让我们从一个你在教科书中经常看到的简单例子开始。
/**
* Kernel to perform matrix multiplication C = A × B
* A is of size N x M, B is M x N, and C is N x N
* Each thread computes one element of matrix C.
*/

__global__ void naive_matrix_multiply(float* A, float* B, float* C) {

// Calculate global row and column for this thread
int row = blockIdx.y /* 0...16 */ * blockDim.y + threadIdx.y;
int col = blockIdx.x /* 0...16 */ * blockDim.x + threadIdx.x;

if (row < N && col < N) {
float sum = 0.0f;
for (int k = 0; k < M; k++) {
// C[row][col] = sum(A[row][i] * B[i][col])
sum += A[row * N + k] * B[k * N + col];
}
C[row * N + col] = sum;
}

}
乍一看,这似乎很简单。你只需要计算输出矩阵 C 的每个单元格即可。这段内核代码看起来确实能完成这项任务。下面是该内核的更直观的表示。
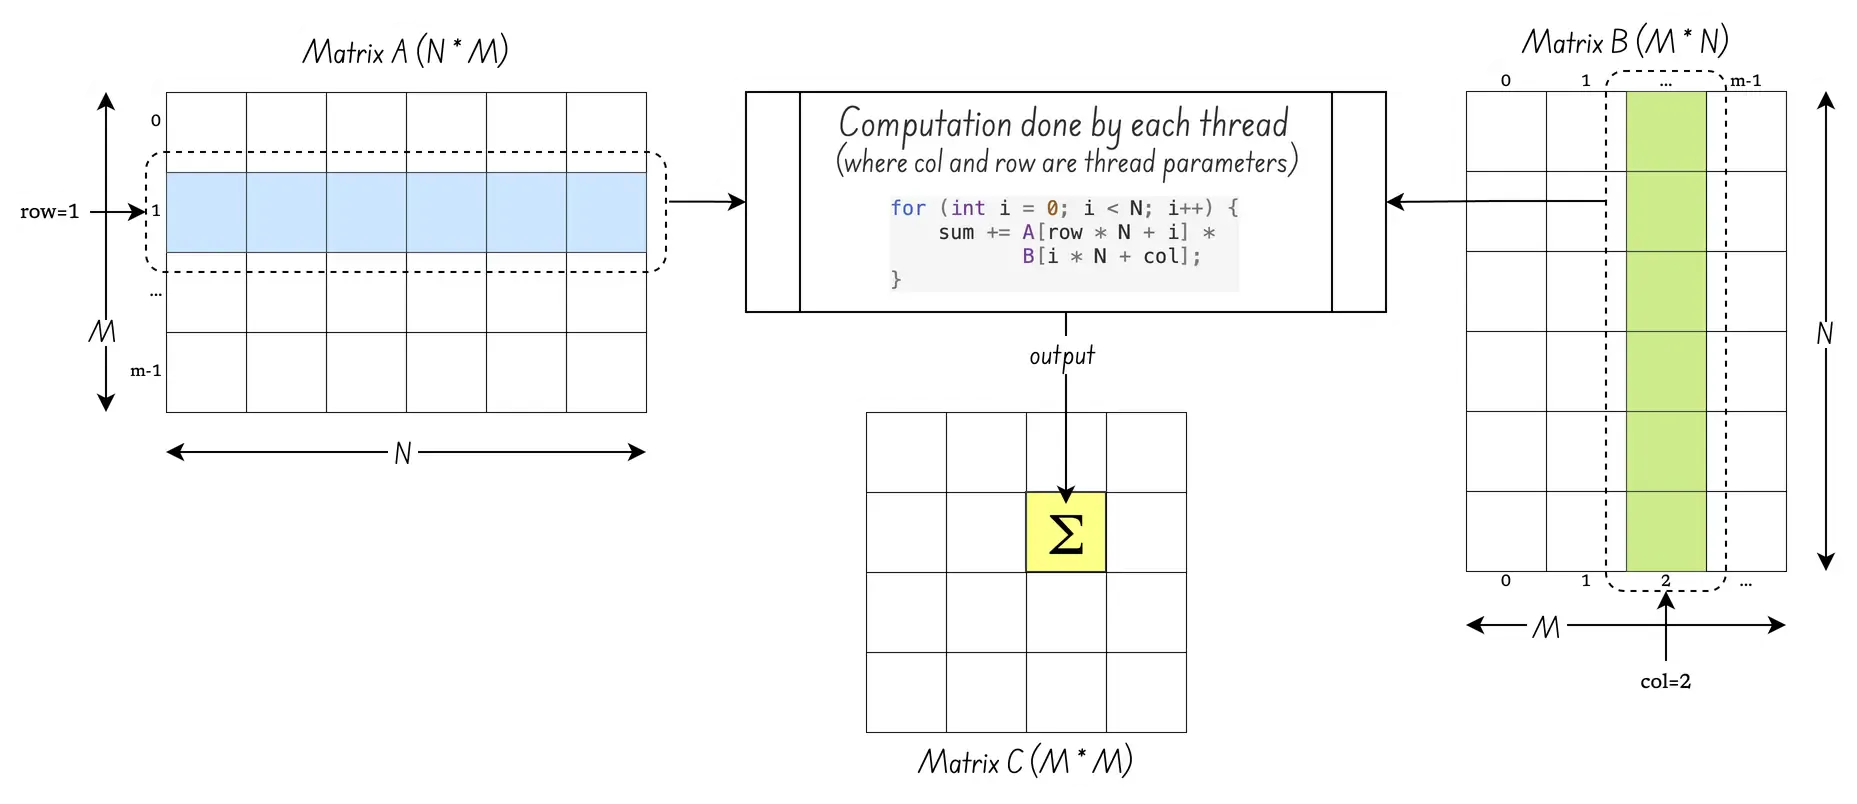
实际情况要复杂一些。如何理解 blockIdx、blockDim 和 threadIdx 呢?要理解这一点,我们需要回顾一下 GPU 的组织结构,它围绕着线程、线程束和流式多处理器展开。以下是英伟达 H100“Hopper”GPU 微架构的一个主观描述:
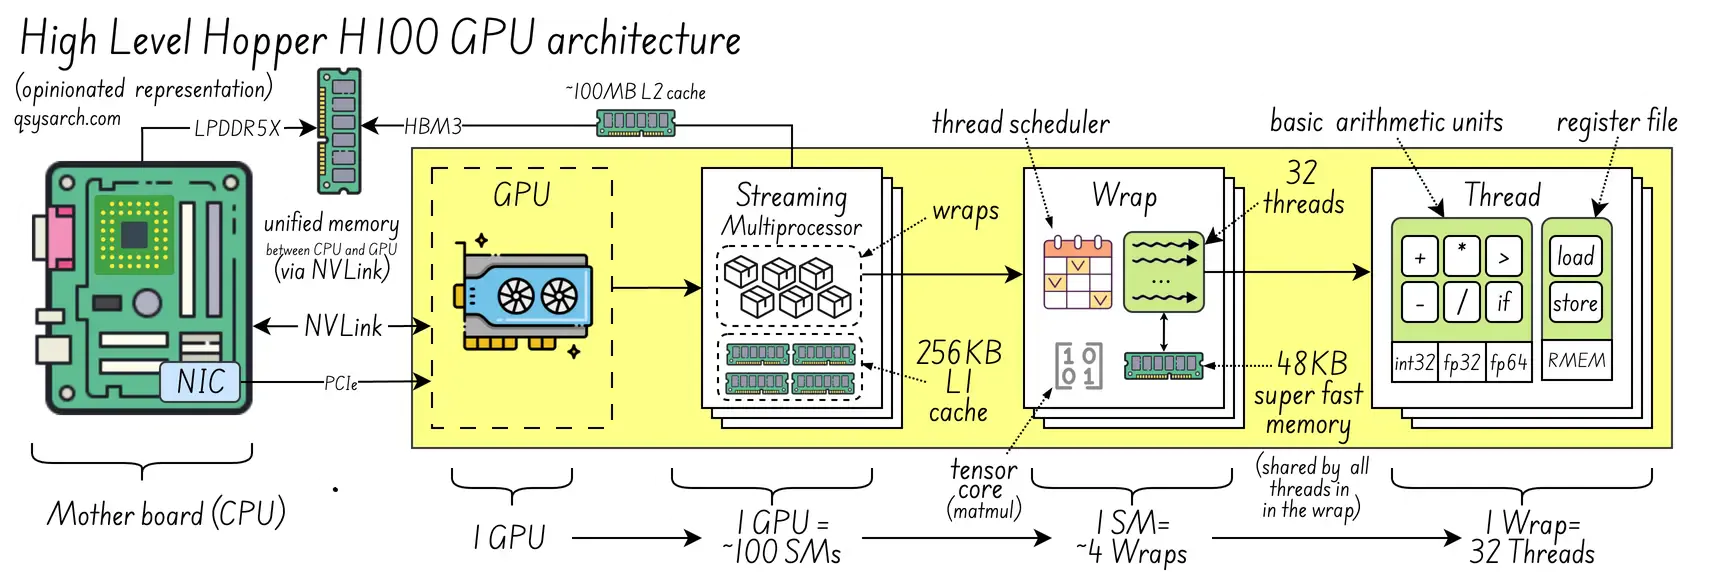
从宏观层面来看:
1 个 GPU = 10 到 100 个流式多处理器
1 流式多处理器 = 4 ~ 64 个封装
1圈 = 32~64根线
那么,计算 sum 的代码片段是如何与线程、线程束,甚至是流式多处理器关联的呢?内存分配和映射决策是在哪里做出的?首先,我们需要了解内核是如何配置的:
int launch_kernel(float *d_A, *d_B, *d_C) {

dim3 block_size(16, 16);  // 16x16 threads per block -> 256 threads
dim3 grid_size(4, 4);     // 4x4 blocks per grid = 64 blocks

// 2. Launch the kernel with the specified dimensions
naive_matrix_multiply<<<grid_size, block_size>>>(d_A, d_B, d_C);
}
这种分层配置映射到GPU硬件的方式如下:

在这种配置下,可以对大小为 N 的矩阵进行乘法运算,其值为 16*4 = 64。如果 N 为 1000 呢?在这种情况下,只需将网格大小设置为 (1000+15)/16 即可。
那么,如何将数据映射到实际硬件呢?这是否意味着数据块会被分配给线程束?如果数据块中的线程数大于硬件线程数该怎么办?
这就需要引入GPU调度机制了。简单来说,如果需要的线程数超过了物理硬件上的线程数,那么GPU就会分配多个线程束(warp):
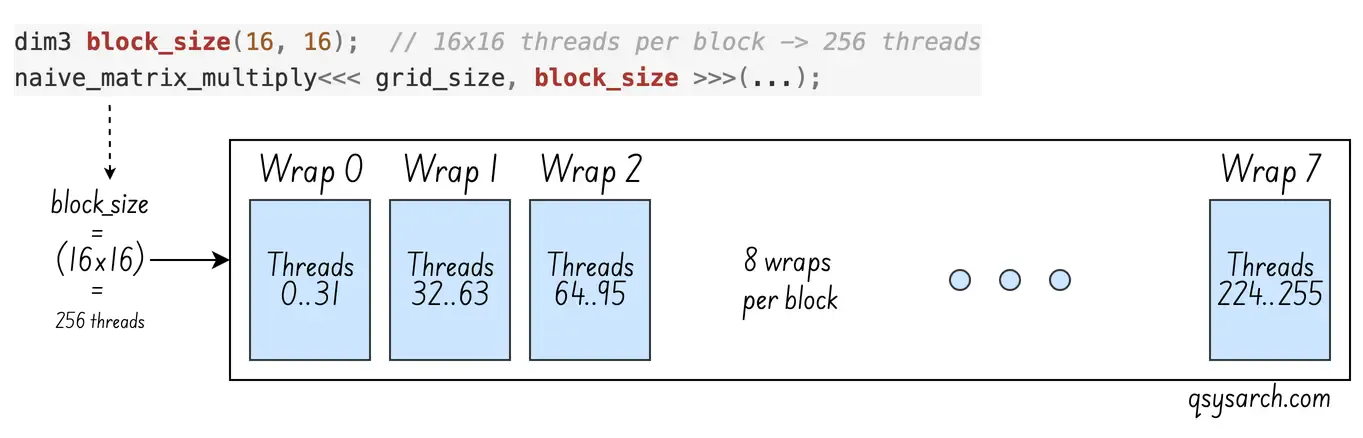
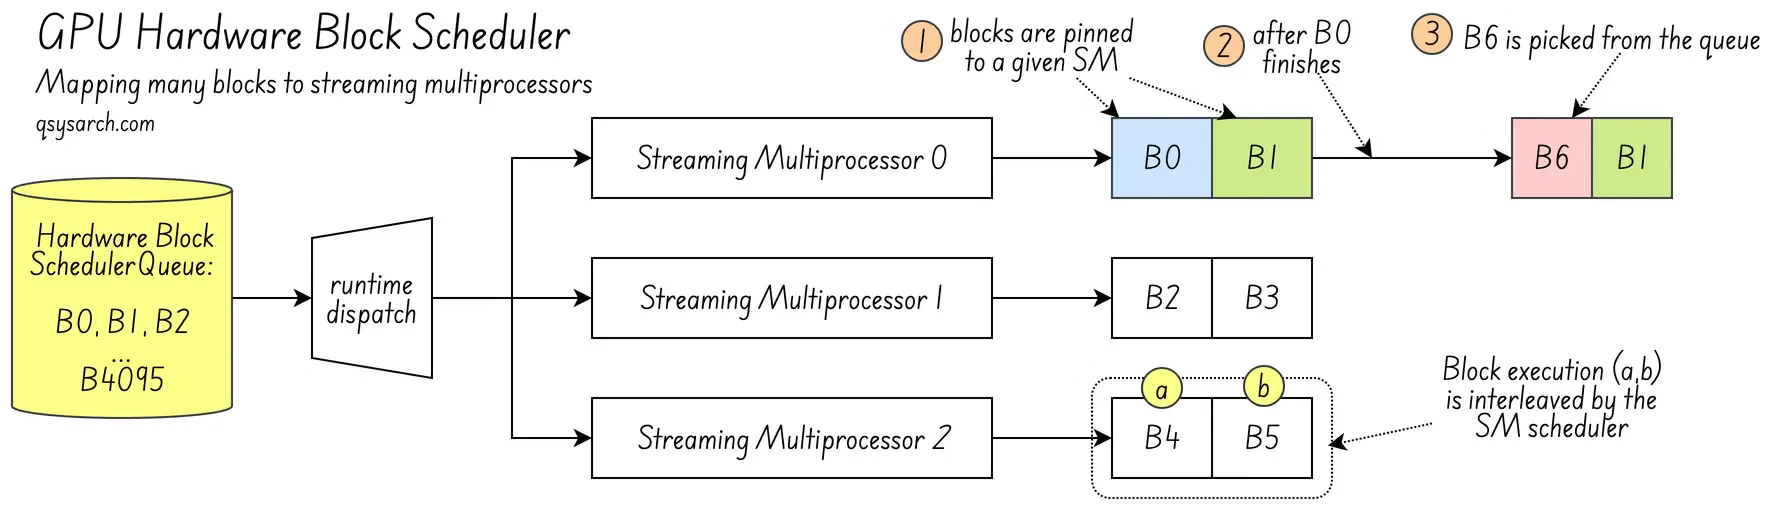
下一个问题是,每个数据块所需的 8 个线程束如何与流式多处理器关联起来,尤其是在流式多处理器拥有的线程束数量少于数据块所需数量的情况下。答案非常巧妙:一个流式多处理器可以拥有超过 4 个线程束,并且会交替调度这些线程束:每当一个线程束因内存访问而停滞时,流式多处理器会立即切换到另一个线程束。这被称为延迟隐藏,它是 GPU 性能提升的核心策略。如果没有这项技术,GPU 的效率就不会如此之高。
现在考虑 grid_size。grid_size 是否直接映射到硬件资源?并非如此。网格只是一个逻辑概念,它确保有足够的块来覆盖矩阵。grid_size 并不对应于硬件。块是在运行时从队列中分配给每个 SM 的。
分配依据是块所需的资源(每个包装器都有有限数量的寄存器,并且需要确保每个块都有自己静态分配的一组寄存器)。
当一个计算块完成计算后,SM 会从调度队列中取出一个新的计算块来替换已完成的计算块。一旦分配完成,该计算块就会被绑定到该 SM,并且其寄存器会被分配以供执行。
最后一个问题:内存块是绑定到SM还是绑定到线程束?内存块中线程使用的内存是否分配在线程束中?如果不是,SM就需要在不同线程束之间移动内存。是的,在SM内部,内存块的线程束是绑定的。如果内存块0分配到线程束0,内存块1分配到线程束1,则始终如此。
现在我们理解了并发线程执行,考虑一个简单的矩阵乘法内核。所有线程都竞争对矩阵 A 和 B 的内存访问。每个线程都从全局内存中读取 A 的一行和 B 的一列。内存无法重用。B 是按列访问的(B[i * N + col]),因此突发访问和内存缓存都无法有效利用。
最简单的解决方案是使用共享内存。首先,将矩阵的一部分以大小为 T*T 的块形式加载到线程束内存中。然后,让线程仅从这部分本地内存读取数据。这样,线程之间就不会争用内存。通过线程束交错,SM 可以确保当一个线程束将内存加载到缓存中时,另一个线程束可以计算总和。以下是增强后的内核:
__global__ void matmul_tiled(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x,  ty = threadIdx.y;
int row = blockIdx.y * T + ty;   // global row in C
int col = blockIdx.x * T + tx;   // global col in C

float accumulator = 0.0f;
for (int t = 0; t < M; t += T) {

// Read [T,T] subtile from matrix A and B.
// Assume that M and N are multiples of T (no bound check)
A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();   // wait all threads to finish loading

for (int k = 0; k < TILE; ++k)
accumulator += A_shared[ty][k] * B_shared[k][tx];

__syncthreads();   // all threads are ready to load again
}
C[row * N + col] = accumulator;
}
为简单起见,我假设 M 和 N 是 T 的倍数,因此在将全局矩阵加载到 A_shared 和 B_shared 时无需进行边界检查。
这段代码里藏着一些玄机。代码块内的所有线程都执行相同的内存读取操作:A[row * M + t + tx]。由于 t 是连续的,线程从同一内存区域读取数据。这使得内存突发读取和缓存成为可能。第一个线程发起突发读取,其他线程则使用由该突发读取填充的缓存。由于 B 没有被转置,所以这个技巧对 B 无效。此外,__syncthreads() 函数会同步代码块内的线程,确保它们运行在同一个内存块上。
使用之前的简单乘法器时,块大小是任意的。而使用分块方法时,块大小必须与图块大小 T*T 相匹配,如图所示:
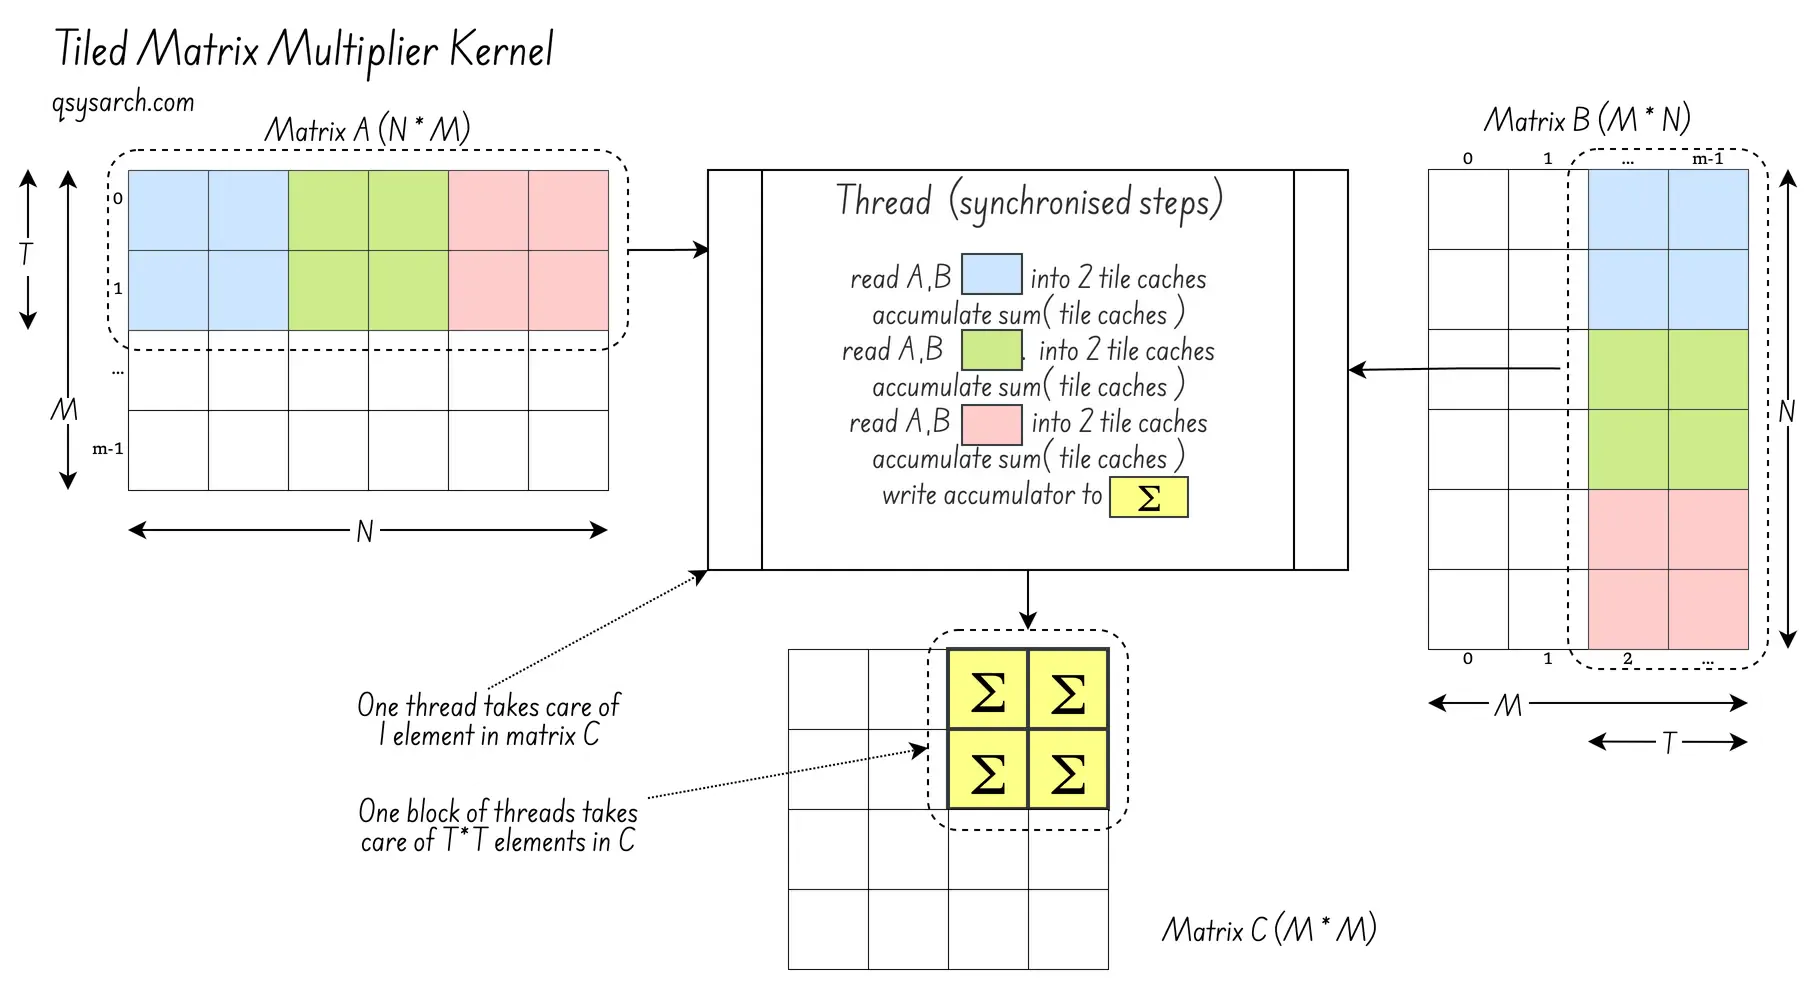
分块方法允许部分数据块加载,而其他数据块则进行计算。在这种情况下,计算量可能很小,耗时比内存加载时间更短。为了解决这个问题,可以在计算期间增加每个线程的工作量。每个线程可以计算一个 2x2 的元素集,而不仅仅是一个。当 K=2 且 T 是 K 的倍数时,这是可行的。
_global__ void matmul_tiled_and_coarsened(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x, ty = threadIdx.y;
int rowBase = blockIdx.y * T * K + ty;
int colBase = blockIdx.x * T * K + tx;

float accumulators[K][K]; // That's register memory

for (int t = 0; t < M; t += TILE) {

A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();

for (int k = 0; k < TILE; ++k)
for (int wr = 0; wr < K; ++wr)
for (int wc = 0; wc < K; ++wc)
acc[wr][wc] += A_shared[ty + wr * (T/K)][k] * B_shared[k][tx + wc * (T/K)];

__syncthreads();
}

// Write out the T×T accumulated result
for (int wr = 0; wr < T; ++wr)
for (int wc = 0; wc < T; ++wc) {
int r = rowBase + wr * (T/K);
int c = colBase + wc * (T/K);
C[r * N + c] = acc[wr][wc];
}
}
# 结论
瞧!这就是通用矩阵乘法(GEMM)单元的基本工作原理!
接下来,我应该介绍一些特殊硬件,例如 Tensor Core(NVIDIA)或 Matrix Fused Multiply-Add(AMD)。这些是流式多处理器中的专用单元,用于计算 T*T*K 次累积乘法。我稍后会在备忘录中详细说明!
References:
DrawIO diagrams used in this memo: