我最近接触到了容量与效率工程的概念,这是一门旨在以最优方式设计和运行系统的学科。它是系统架构的关键支柱,在规模至关重要的领域(例如量子计算系统)尤为重要。
简而言之,产能与效率工程是一门优化生产的科学或学科。它通过平衡最大产量(产能)与资源消耗(效率)来实现这一目标。
容量与效率工程(CEE)的优势在于它是一个定义明确的领域,文献资料丰富,并有完善的工程实践体系支撑。本备忘录旨在提炼CEE中的一些关键概念。
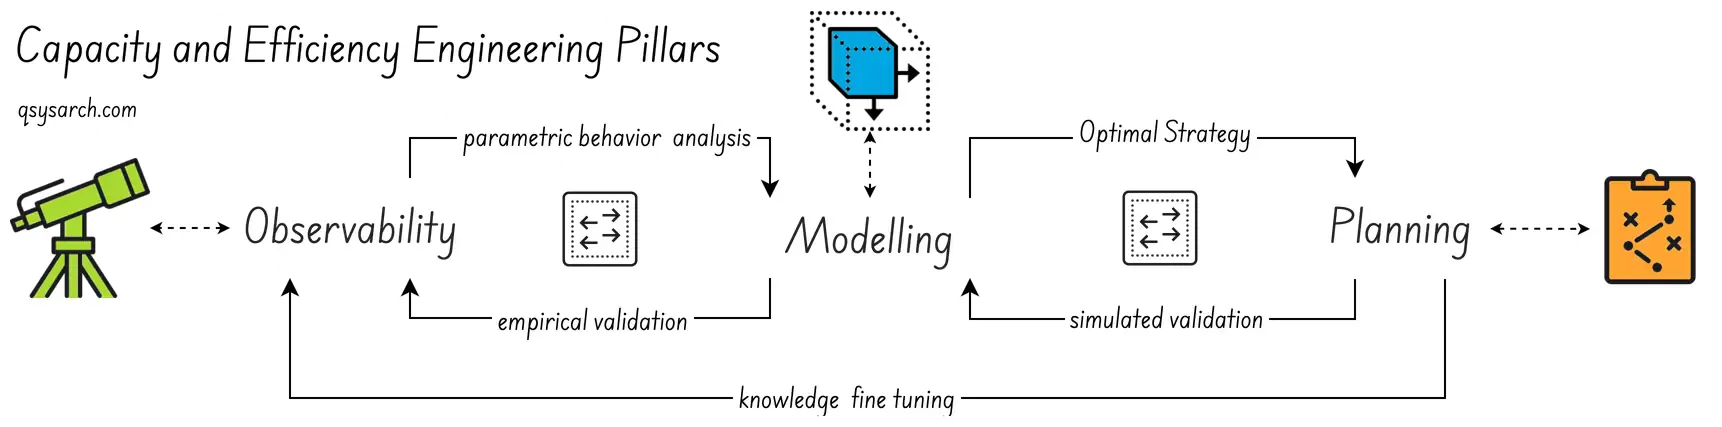
容量与效率工程建立在三大核心支柱之上:可观测性、建模和规划。
可观测性
造型
规划
最终目标是制定一个能够通过模型有效模拟的计划。该模型应通过实证观察进行验证。通过模拟增长、识别瓶颈并进行战略性资源分配,该计划可以防止资源过载或利用不足,从而确保系统最佳运行。
需要注意的是,系统资源可以是任何事物,包括CPU、内存等IT资源,也可以是人员或设备。事实上,CEE可以应用于各个领域。例如,它可以帮助优化项目管理中的人员配置,或者降低基础设施管理中的云托管成本。
可观测性是对系统进行实证分析。在计算机系统中,日志经常与可观测性混淆,但它们只是其中的一部分。例如,OpenTelemetry标准涵盖了多种可观测的“信号”:日志、指标、追踪和冗余信息。对于计算机工程和工程(CEE)而言,有效的可观测性应提供:
关键在于能够对系统进行事后分析,并且无论在高负载、维护还是空闲期间,都必须进行分析。详细了解发生了什么、何时发生以及为什么发生至关重要。如果没有这些可观察的数据,就无法确定系统故障的根本原因。
当然,要收集完整系统的全部观测数据并非易事:观测成本可能非常高昂,甚至可能具有破坏性(例如在量子计算中,测量系统会改变其状态——这种现象被称为观测者效应)。这意味着,仅仅是观测系统这一行为本身就可能改变其行为并降低其性能。解决这个问题的方法是采样(仅收集部分事件的数据,而非全部事件)。其核心思想是将采样率(数据收集频率)作为可调的系统参数,如下图所示(图片来源:OpenTelemetry)。

对于非计算系统而言,有效的可观测性能够解释项目延期的原因。可观测数据很可能是 ISO9001 标准规定的技术和非技术文档,这些文档解释了项目每个阶段所做的可追踪决策。
在可观测性建立之后,就可以开始理解系统的分析参数行为。这种行为构成了下一个支柱的基础:它可以被描述并转化为参数模型。下一步是明确在给定一组参数或条件的情况下,这样的模型需要提供什么:
关键在于模拟系统行为并观察其在不同运行条件下的性能。由于该模型包含了资源成本,因此可以展现这些条件下的成本权衡。这些信息对于规划阶段至关重要。
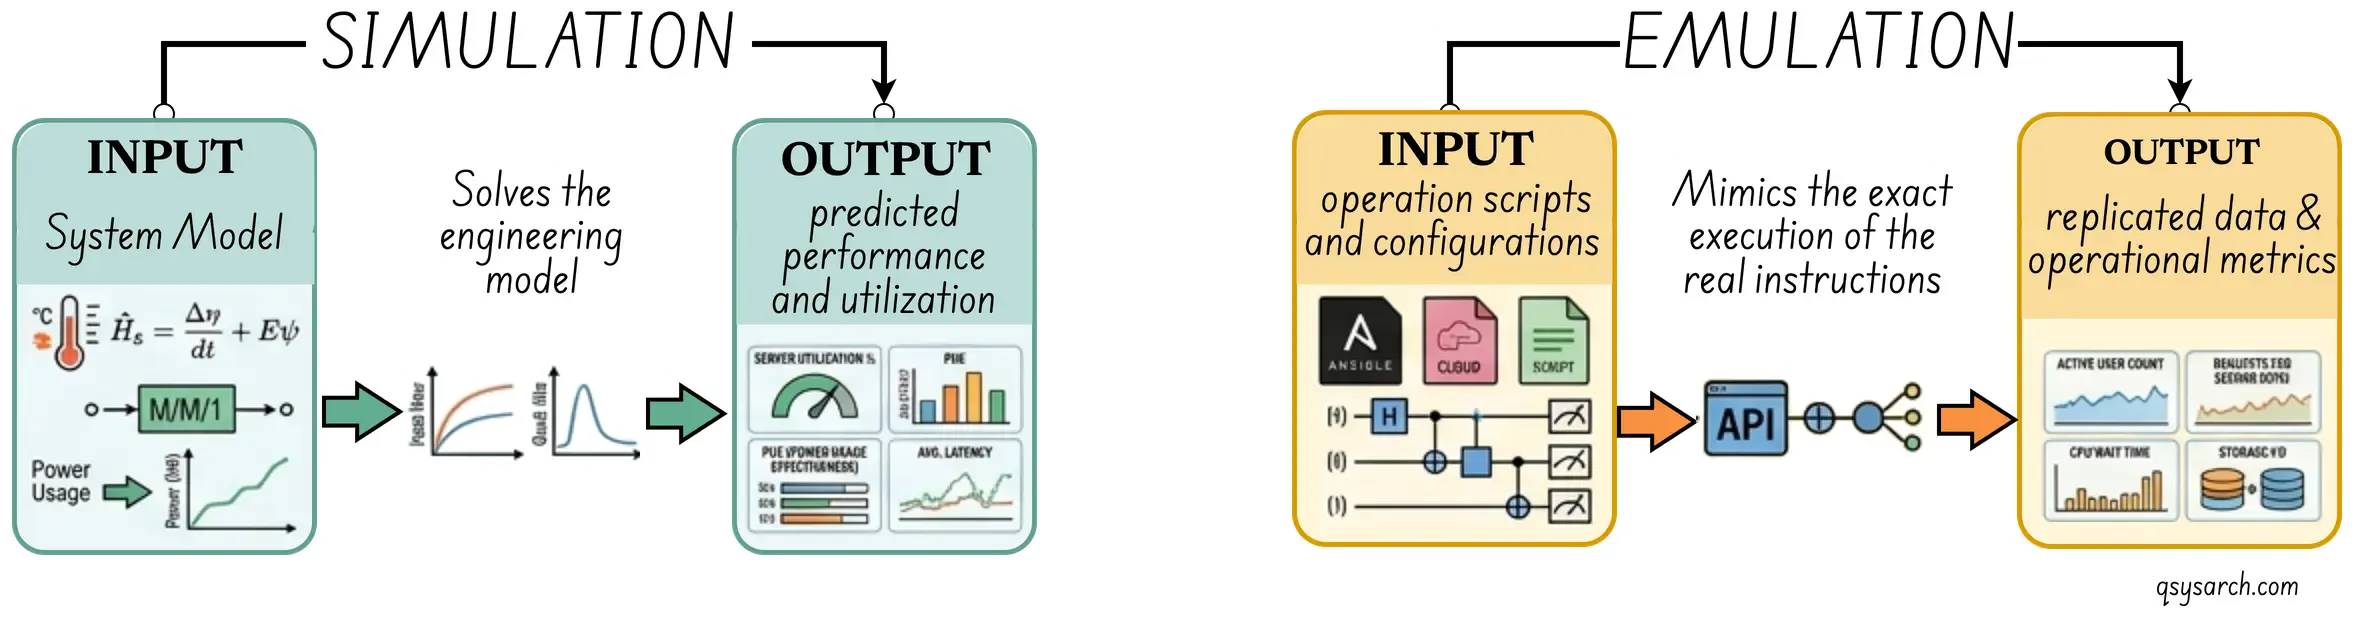
这里值得一提的是_仿真_和_模拟_之间的区别。从宏观层面来说,模拟创建了一个系统的模拟版本,而仿真则基于系统的抽象模型进行操作。使用模拟,由于输入相同,因此可以将模拟性能与实际性能进行比较。我认为在CEE的语境下,模型主要指的是模拟器。
一个好的非计算系统模型可以预测向项目中添加更多资源的影响。事实上,有时添加资源反而会降低系统性能。这种违反直觉的结果被称为布鲁克斯定律。
有了模型,就可以开始规划系统运行了。利用模型模拟各种情况,找出最优方案。根据这些结果,策略性地分配资源以满足需求。一个好的计划应该包含需求预测、成本管理和故障保护措施。预测用于预测未来的使用情况、流量或需求。成本控制用于控制资源过度配置,同时确保高峰时段的容量。故障保护措施则提供缓冲,以应对意外需求。
关键在于高效可靠地运行系统,应对峰值负载而不发生故障,确保成本效益,通过预测容量实现主动重新配置,并提供足够的缓冲来应对意外事件。
该计划结合了最佳情况(需求符合预期)和最差情况(需求高于或低于预期)。这种方法实现了产能的成本效益最优配置。
先有鸡还是先有蛋的问题
构建一个好的模型是一个先有鸡还是先有蛋的问题。除非你知道在系统中应该观察什么以及如何观察,否则很难构建一个高效且准确的模型。而没有准确的模型,计划就不太可能产生好的结果。
当模拟计划与实际行为出现差异时,你需要找出缺失的参数。这通常是通过事后分析被观测系统的日志来实现的。目标是识别需要观察的新参数。
上图中,这种学习循环被表示为_知识微调_。
工程平台
如果没有一个自动化平台来支持其整个工作流程,CEE本身将无法独立运作。下图展示了这个工程平台。
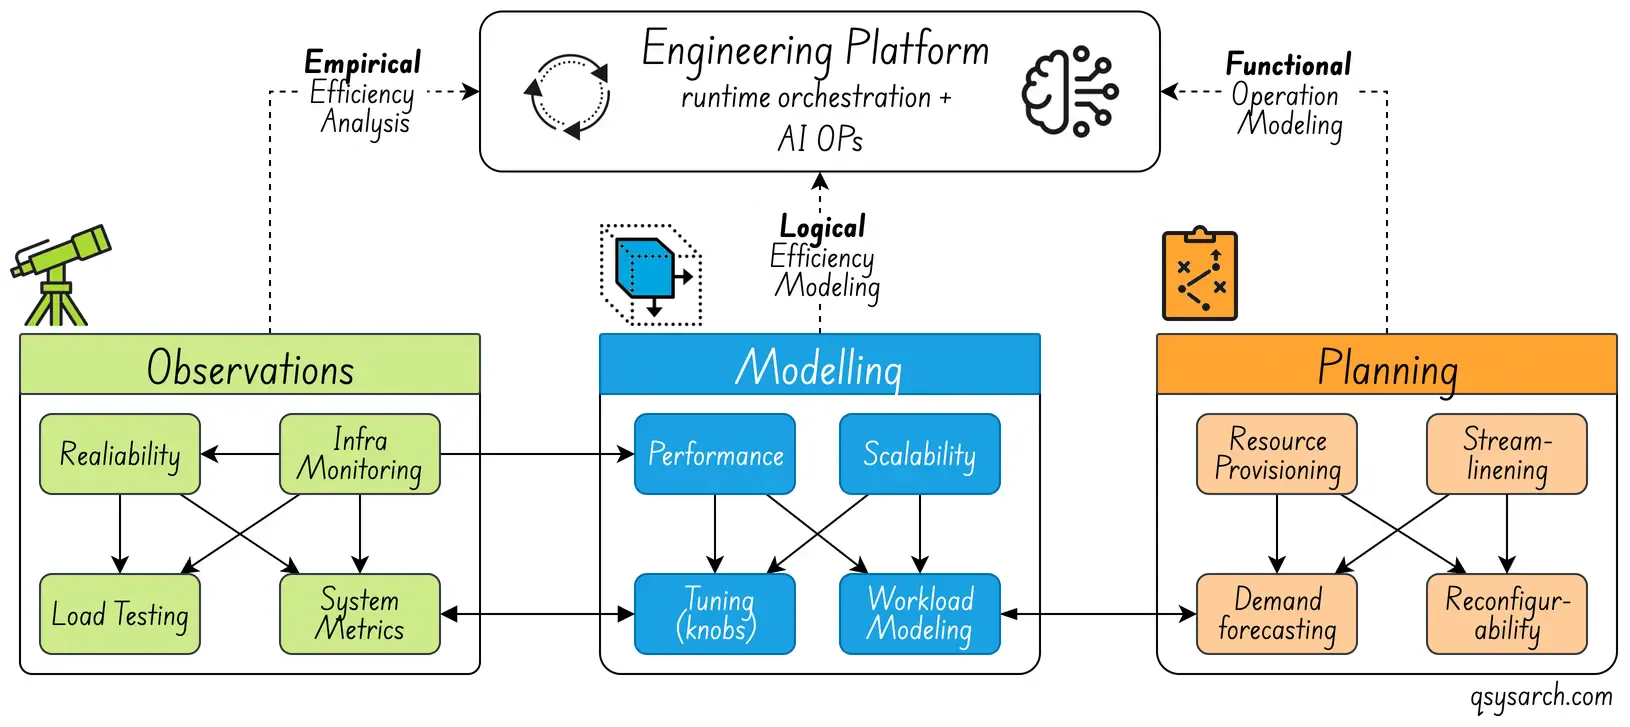
该工程平台的理念不仅在于自动化系统扩展和缩减的过程(该过程可委托给 AI 运维代理),还在于持续验证模拟模型与经验观察结果的匹配度,并将差异反馈给机器学习代理以进行模型微调。该代理很可能是一个基于强化学习的代理,如果用于实时应用,则需要对其进行治理。
未能快速扩大规模的代价,又称延迟的代价。
链接到标题
为了确保系统的稳定性和可靠性,性能应该限制在稳定的水平,而不是最大值。一般来说,稳定的性能约为最大性能的三分之二。超过这个阈值,系统性能就会下降。此时,停机成本会迅速(通常是指数级地)超过过度配置的成本。
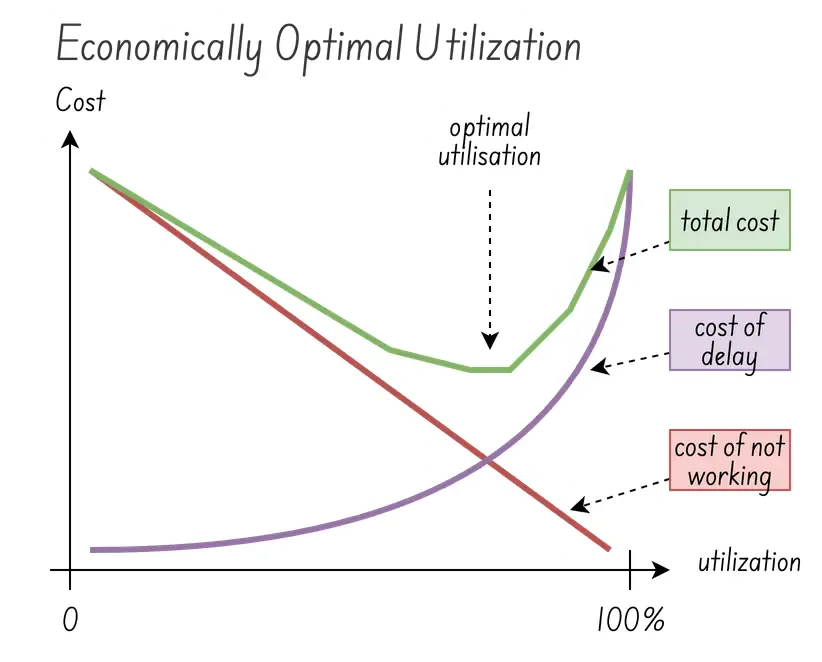
右图中,延迟成本可以理解为在系统(实时)扩展时无法满足需求所造成的经济损失。这是一种暂时性成本。当利用率较低时,延迟只会影响少数需求。但当利用率较高时,延迟会影响大量需求,延迟成本也会呈指数级增长。
最佳利用率是指能够同时最小化延迟成本和故障成本(过度配置)的资源利用率。绿色曲线表示总成本,即这两个因素之和。这条曲线的局部最小值,通常在最大性能的 2/3 左右,标志着最佳利用率。关于最佳利用率,实际上还有很多值得探讨的地方,我相信有些人会认为最佳利用率应该在 80% 左右。关键在于认识到,通过优化系统来降低延迟成本,可以提高最佳利用率(图片来源:show me the data)。
改进的成本
如果降低系统故障成本意味着最大限度地缩短扩展时间,那么试想一下,如果一个系统能够在几毫秒甚至几微秒内进行自我调整,以扩展规模并满足需求,那该有多好。当然,开发这样的系统成本可能非常高昂(想想高频交易)。但是,如果开发这样一个系统的成本低于系统更高利用率带来的收益呢?
这一挑战也是CEE(核心经济环境)的一部分。通过对系统改进成本进行建模,可以制定一个平衡改进成本与收益的计划。这与其说是一项运营挑战,不如说是一项战略投资。然而,它仍然遵循CEE的相同原则,并将这些原则应用于企业的运营战略,将其视为一个系统。
在产能和效率工程的背景下,价值流图(VSM)通常被用作诊断工具,以确定产能消耗在哪里,从而识别浪费和瓶颈的根本原因。
价值流是指系统交付服务过程中工作流程中的每一个步骤或活动,而价值流图则是对这一端到端流程的可视化呈现。价值流图区分三种类型的活动:
增值(VA):直接有助于客户获得所需输出的步骤(例如实际计算)。
非增值但必要的步骤(NNVA):系统所需的步骤,但没有直接的客户价值(例如握手)。
浪费(Muda,或無駄,日语术语意为“浪费”):消耗产能而不增加任何价值的步骤。
目标是消除浪费步骤,而价值流图 (VSM) 正好擅长识别这些步骤。VSM 的强大之处在于它能够找到可以减少在制品 (WIP) 的正确优化方案。这一点至关重要,因为利特尔定律指出,平均交付周期(或周期时间)等于平均在制品 (WIP) 除以平均吞吐量:
交付周期 = 在制品 / 吞吐量这意味着,即使吞吐量保持不变,如果在制品数量翻倍,交货周期也会翻倍。因此,控制在制品数量是改善交付延迟(即“延迟”)从而提高系统效率的最直接手段之一。
# 结论
瞧,这份周日早晨关于容量和效率工程 (CEE) 的简短备忘录帮助我更好地理解了这个主题。现在,我想记住的是,当一个系统的效率非常低时,很可能表明该系统或其工作流程充斥着大量的浪费 (Muda)。应对这一挑战的答案是:与其过度配置资源,不如投资降低延迟成本?
References:
DrawIO diagrams used in this memo:
Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
Key
methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
Unique
angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
Metrics
emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |