xPU:它是专用处理单元 (PU) 的一个统称,其中“x”可以代表任何针对特定工作负载定制的计算架构。常见的变体包括 GPU(图形)、TPU(张量/AI)、NPU(神经)、DPU(数据)或 PPU(脉冲,主要用于量子控制堆栈)。
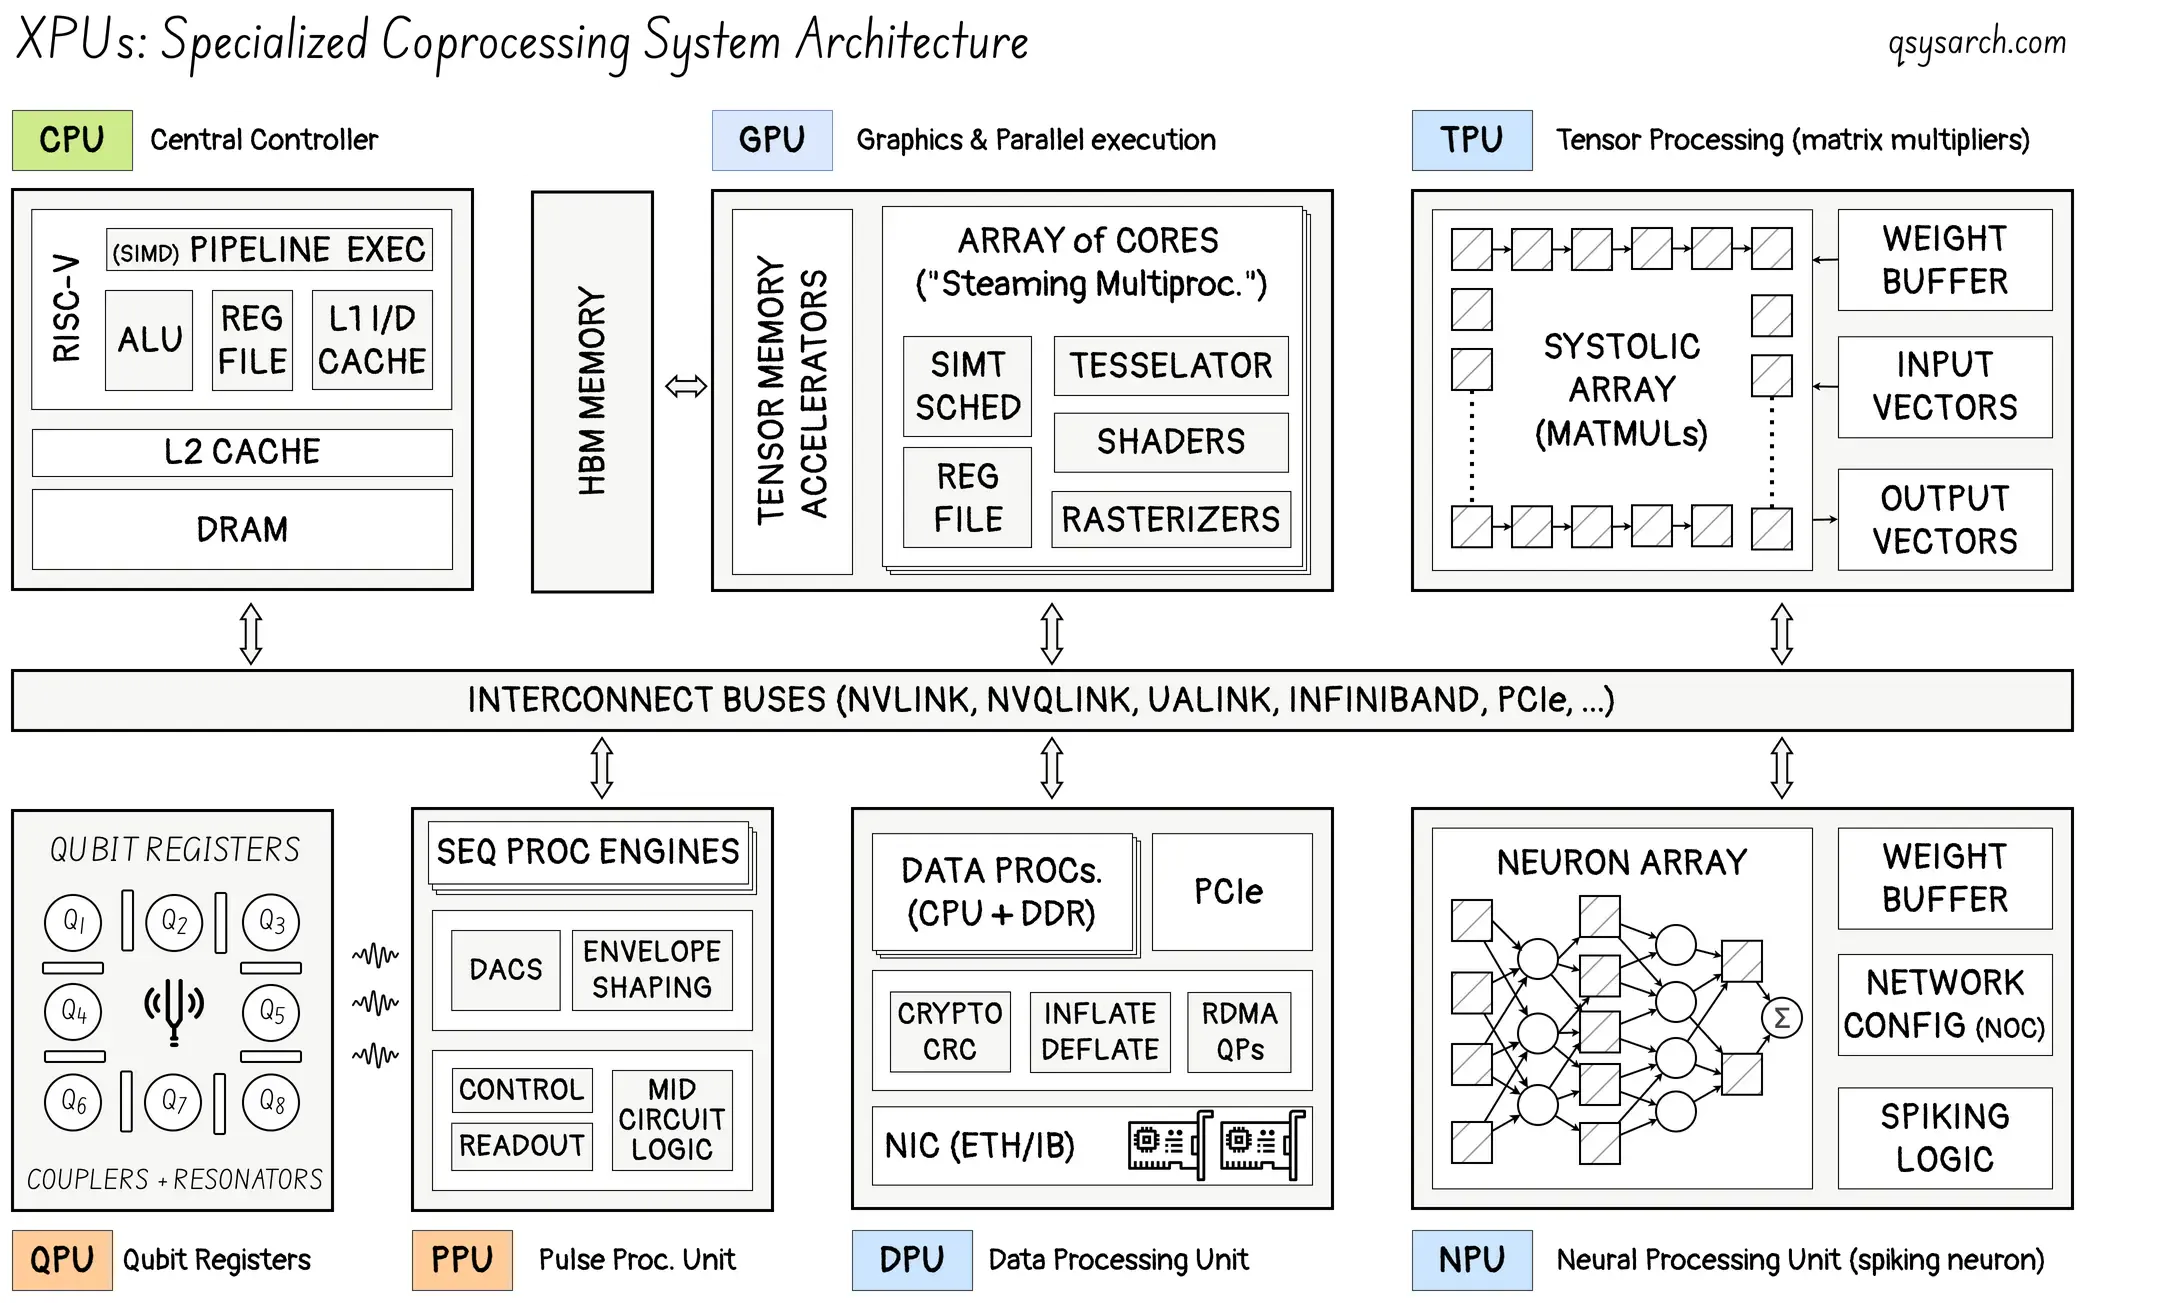
这份超短备忘录旨在深入分析应用于人工智能推理的 xPU 市场格局。
在审视人工智能推理ASIC的市场格局时,最有价值的指标或许并非原始性能,而是供应商的差异化优势能否在未来3-5年内保持竞争力。从这个角度来看,可以归纳出三个集群:
通用平台:NVIDIA 和 垂直整合商:AMD、Google
当前挑战者 Groq、Cerebras、FuriosaAI、Positron、SambaNova、Axelera AI。
未来挑战:Extropic、Normal Computing、Unconvential、Mottronix、Akhetonics!部分 xPU 制造商
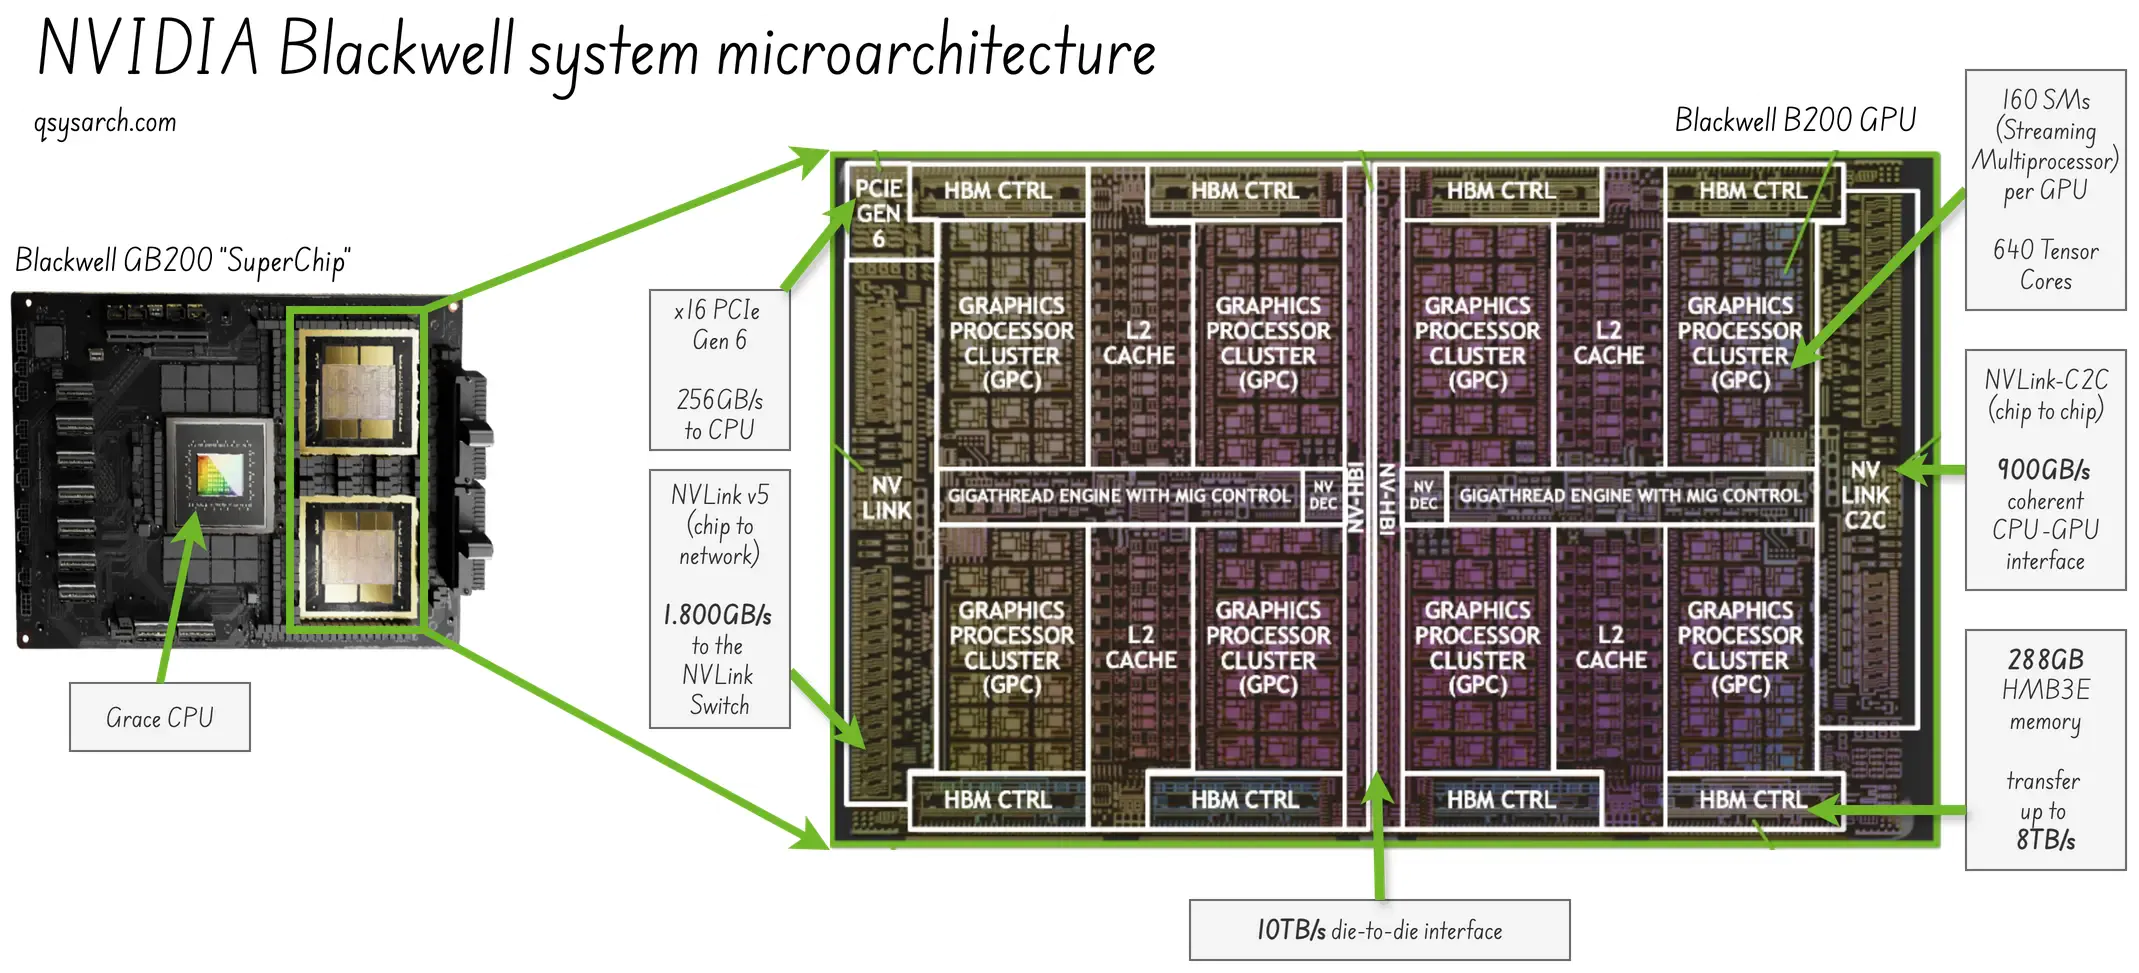
NVIDIA
架构:GPU(2024 年采用 Blackwell 架构)
核心优势:生态系统锁定、软件栈深度、完整的系统集成
目标工作负载:通用 — 大规模 LLM 训练和推理 - 图形着色器
缺点:成本高、功耗高;未针对稀疏计算进行优化
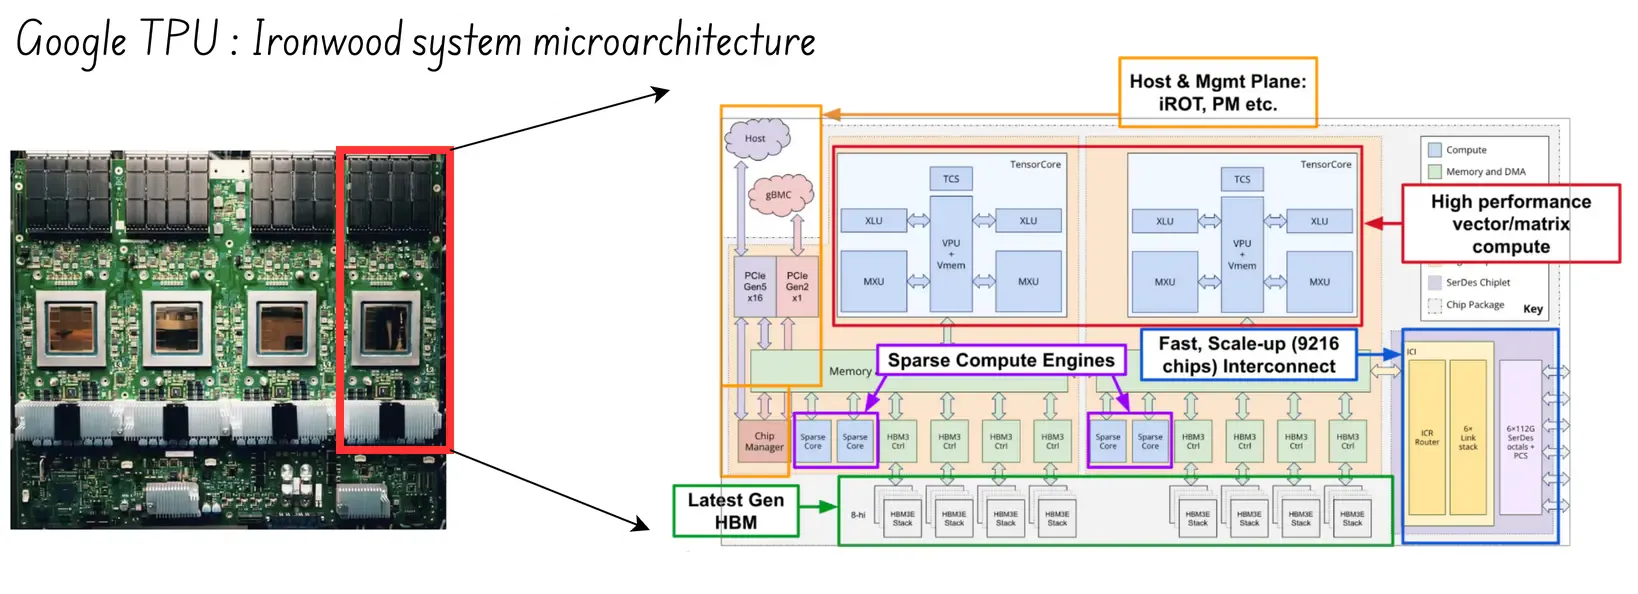
谷歌
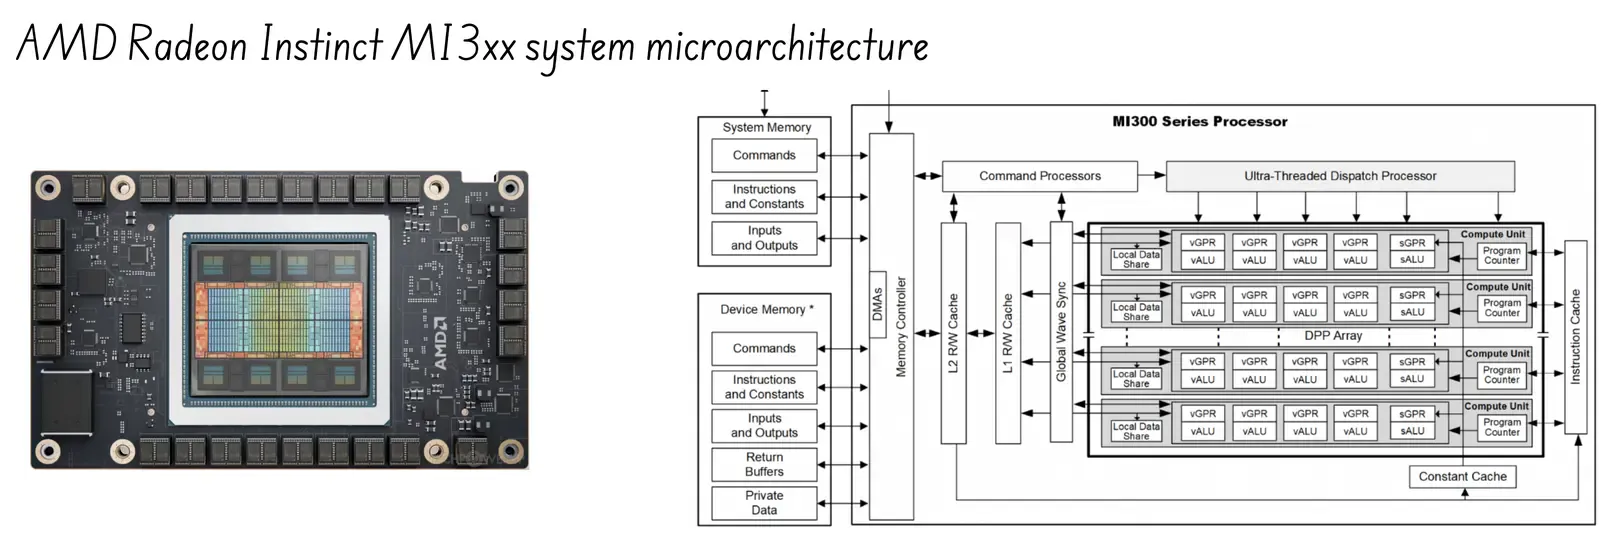
AMD
架构:MI300 Instinct + ROCm(AMD 自研 CUDA)
核心优势:CUDA 定价方案;熟悉的 GPU 模型;
目标工作负载:对云成本敏感的高性能计算和推理
漏洞:软件与 CUDA 的差距;缺乏前沿生态系统(例如 NVQLINK)
Groq(已被 NVIDIA 收购)
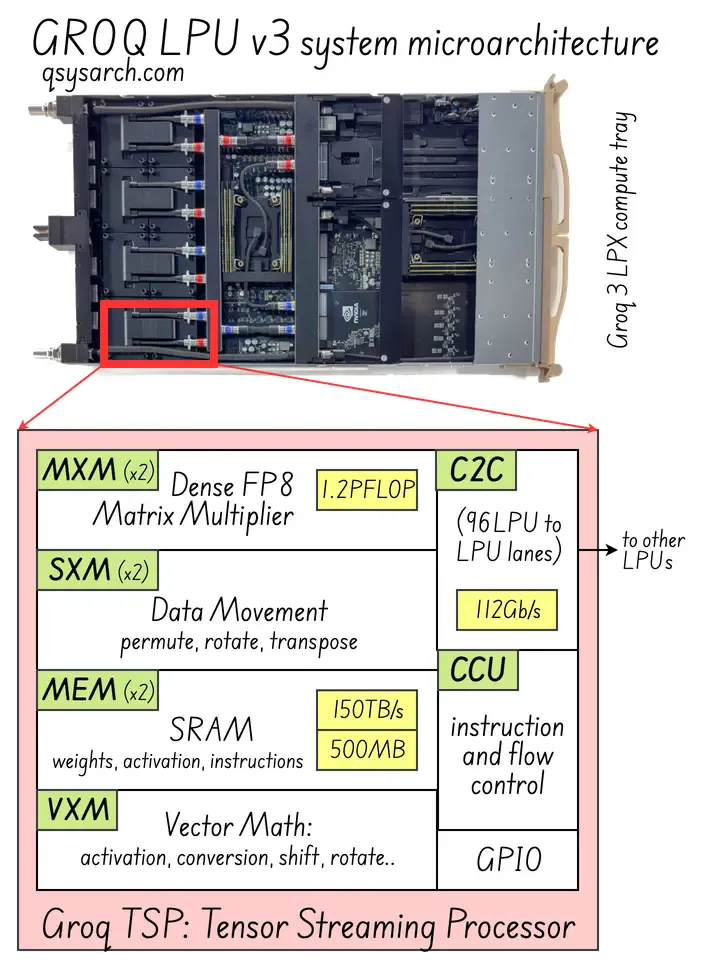
架构:LPU(语言处理单元)
工作原理:基于核心张量流处理器 (TSP) 架构,执行时间完全可预测,精确到时钟周期。
核心优势:确定性的超低延迟;无内存瓶颈;所有操作都由编译器预先“规范”。
目标工作负载:实时推理
弱点:以速度换取空间:没有大容量 HBM(高带宽内存),只有小容量嵌入式超高速 SRAM(尽管这使其成为 NVIDIA 收购后 NVIDIA Blackwell 生态系统的良好补充!)
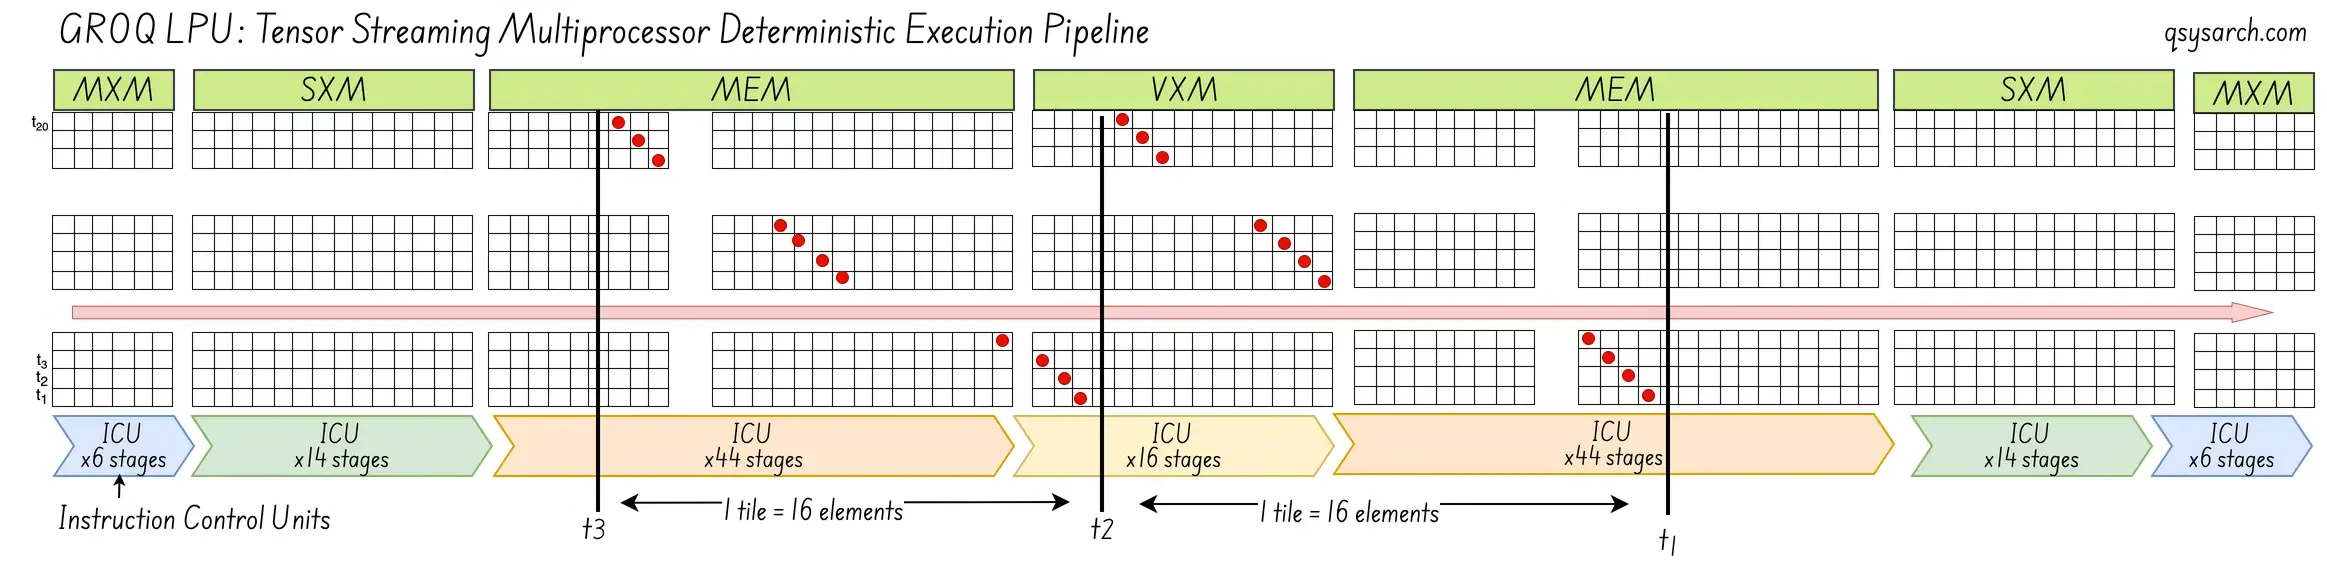
请注意,Groq LPU 架构于 2020 年发布,2024 年商业化推出,并于 2026 年被收购。这为那些渴望成为独角兽的公司提供了一个不错的时间表:4 年的开发时间,2 年的市场认可时间,如果更大的竞争对手感受到竞争压力,就能获得巨额收益!
认真研究以下每个供应商的解决方案可能需要几天时间;而我写这份备忘录时并没有那么多时间——因此,请对以下描述持保留态度,因为它可能不完整和/或主观。
SambaNova [差点被英特尔收购]
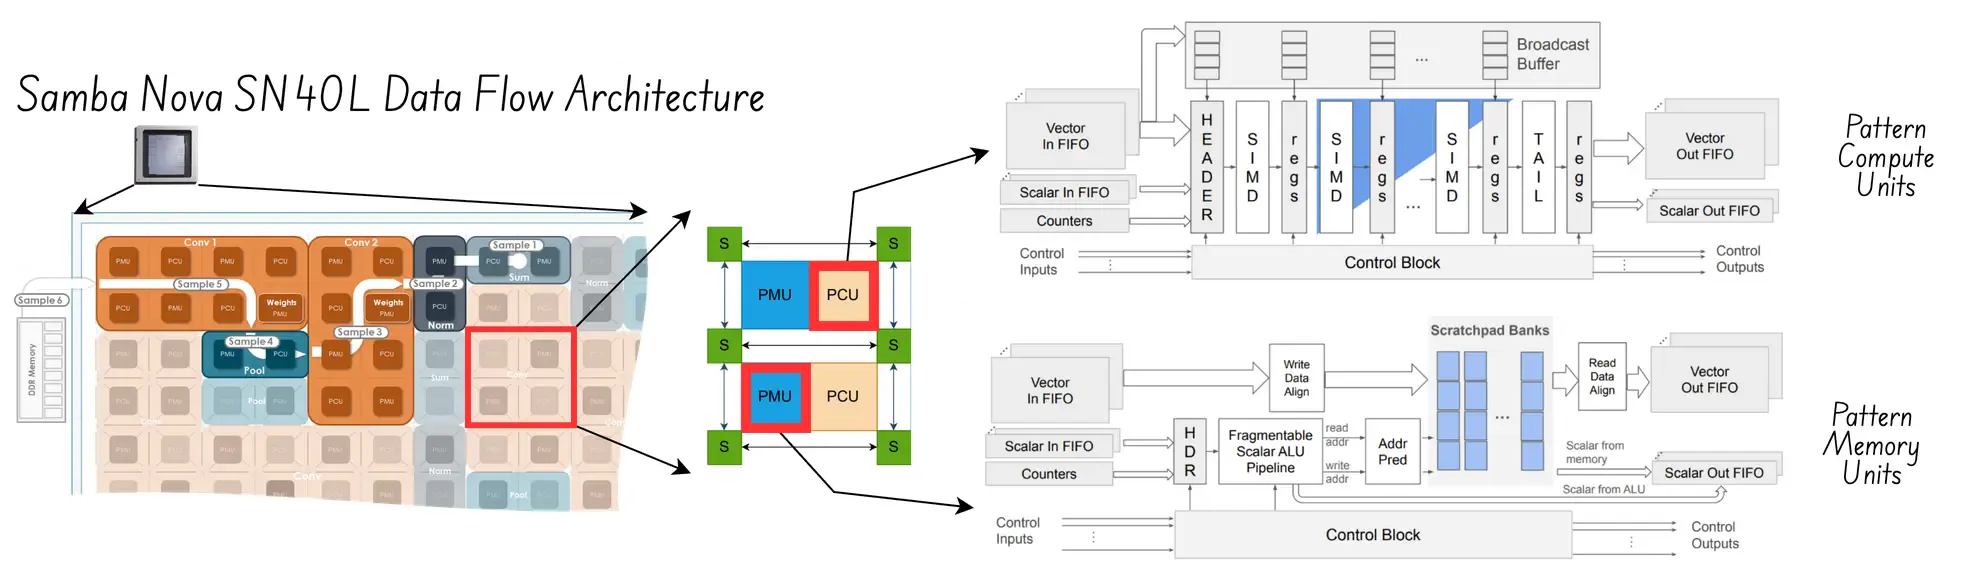
- 架构:RDU(可重构数据流单元);支持为整个计算图构建自定义集成数据+处理流水线,最大限度地减少数据移动,从而实现高硬件利用率。下图展示了其SN40L中使用的PCU(模式计算单元)和PMU(模式存储单元)的详细架构:
Cerebras
架构:晶圆级引擎 (WSE) 充当巨型流水线矩阵乘法器。
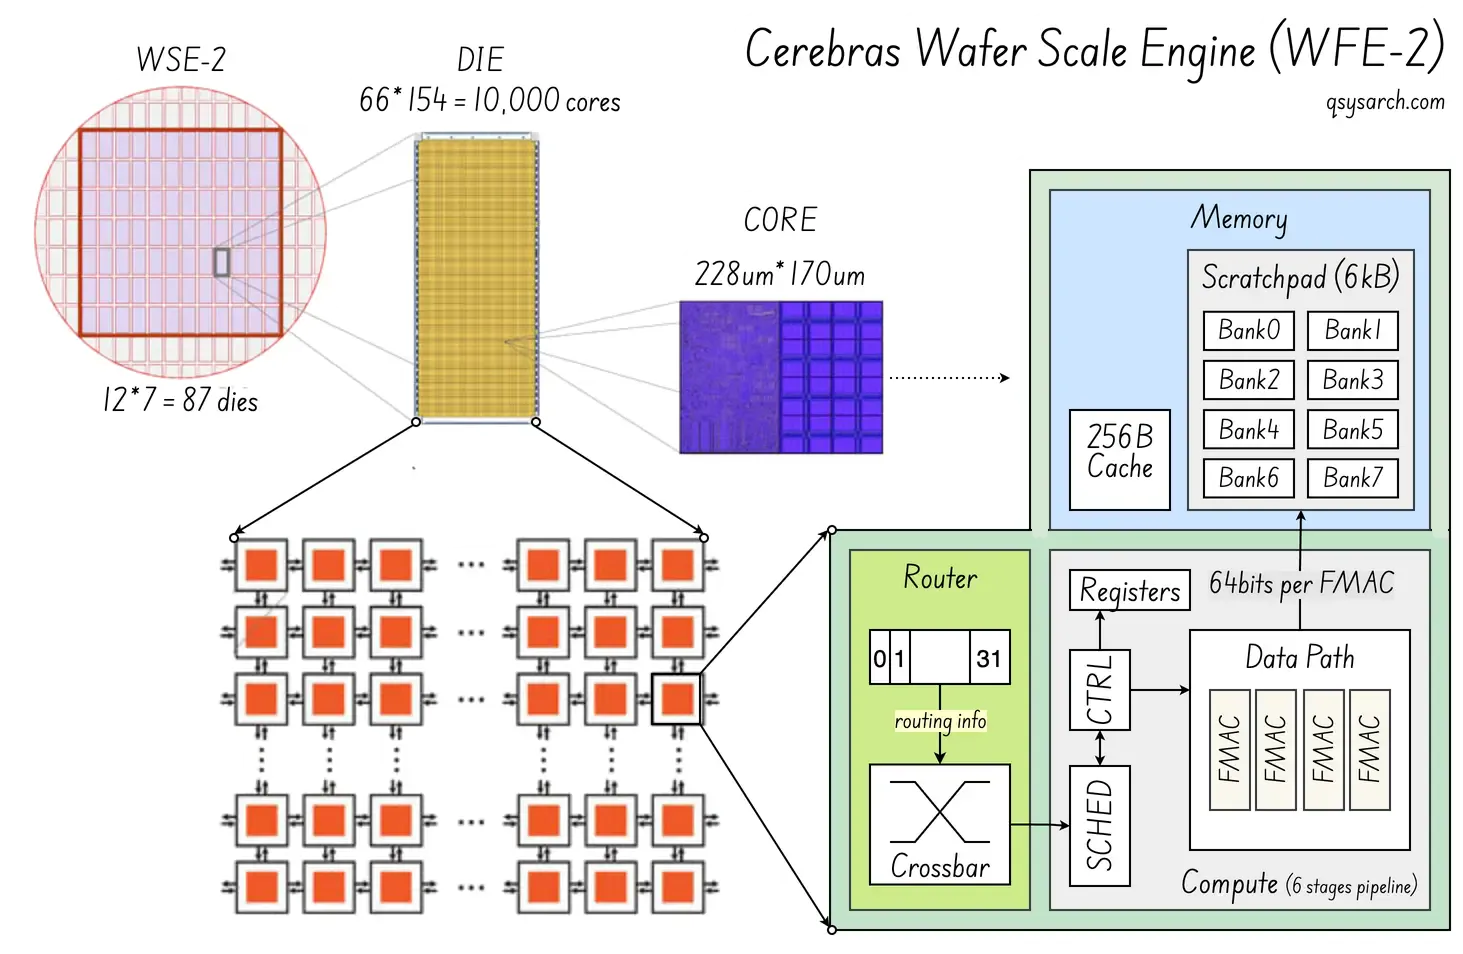
核心优势:海量片上SRAM,消除HBM瓶颈。高密度独立内核(WSE-2高达85万个),可进行“内存张量计算”。晶圆上各节点间单时钟延迟架构路由。
目标工作负载:大型 LLM 推断,特别是稀疏模型。
漏洞:需要一流的软件堆栈才能充分利用其大规模优势(就像所有“PIM”或内存处理微架构一样)。
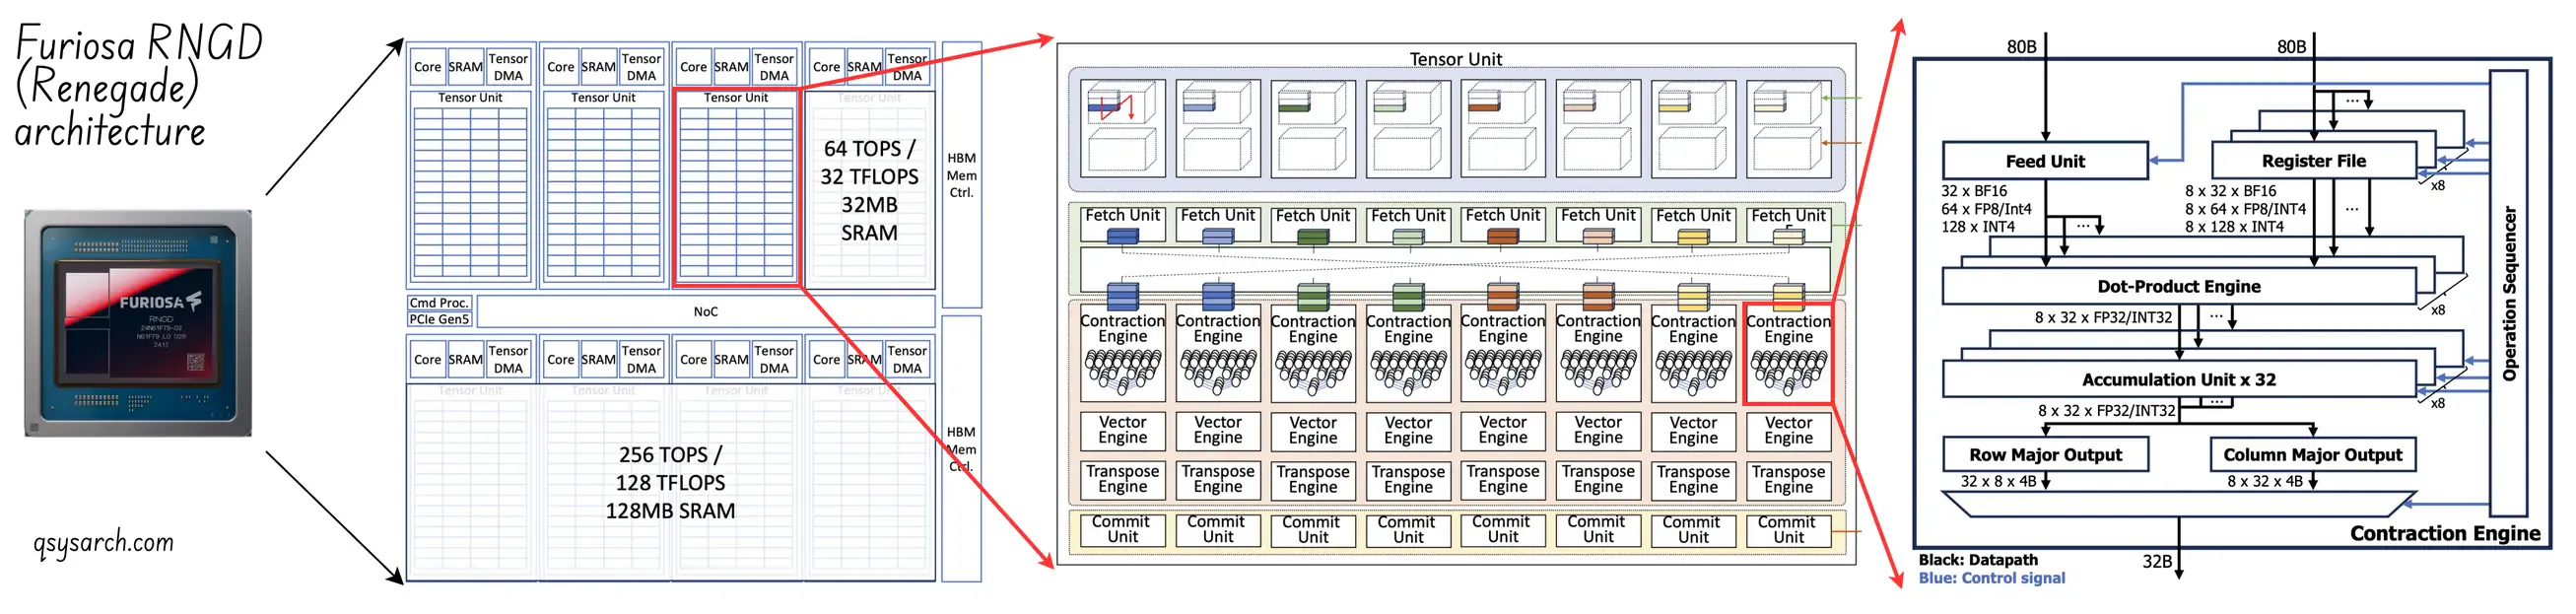
FuriosaAI
- 架构:张量收缩处理器(TCP),以 Renegade (RGND) Asic 的名义进行销售。与具有固定网格的 TPU 脉动阵列相比,Furiosa 的 TCP 架构使用小型、可配置的计算单元,这些计算单元可以动态地重新排列(就像一个超级智能的网络运营中心)。
Positron
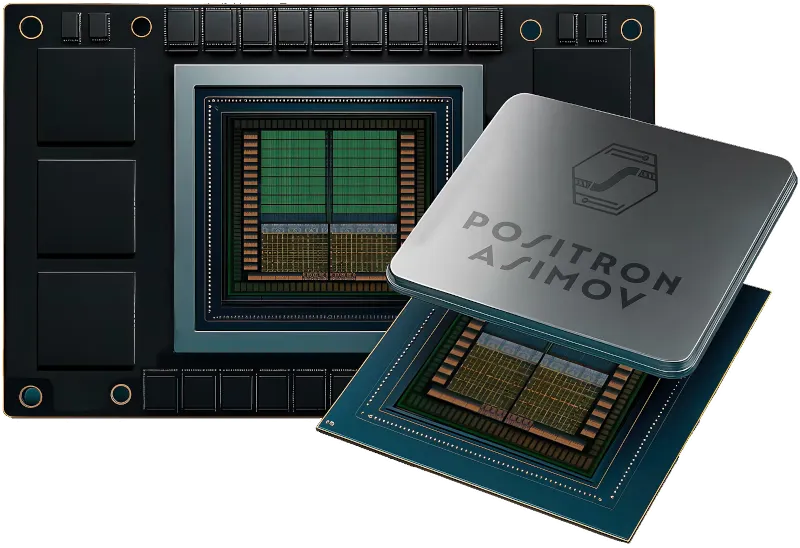
- 架构:Asimov ASIC - 目前可用的信息不多,但 Positron 传达的关键信息是内存为王:因此,如果他们能够使用芯片堆叠技术将更多标准的 DDR5 内存嵌入到他们的 ASIC 中,那么与内存容量较低的 NVIDIA Blackwell 相比,他们就能提供极具吸引力的产品。
核心优势:专注于高内存带宽利用率 (MBU) 而非标准高内存带宽 (HBM)。这意味着他们可以提高内存总线的占空比或利用率,从而提供同等甚至更高的内存性能(带宽乘以占空比,类似于电力的 V*I = 瓦特),进而超越那些仍在为昂贵内存而苦苦挣扎的竞争对手。
Axelera AI:
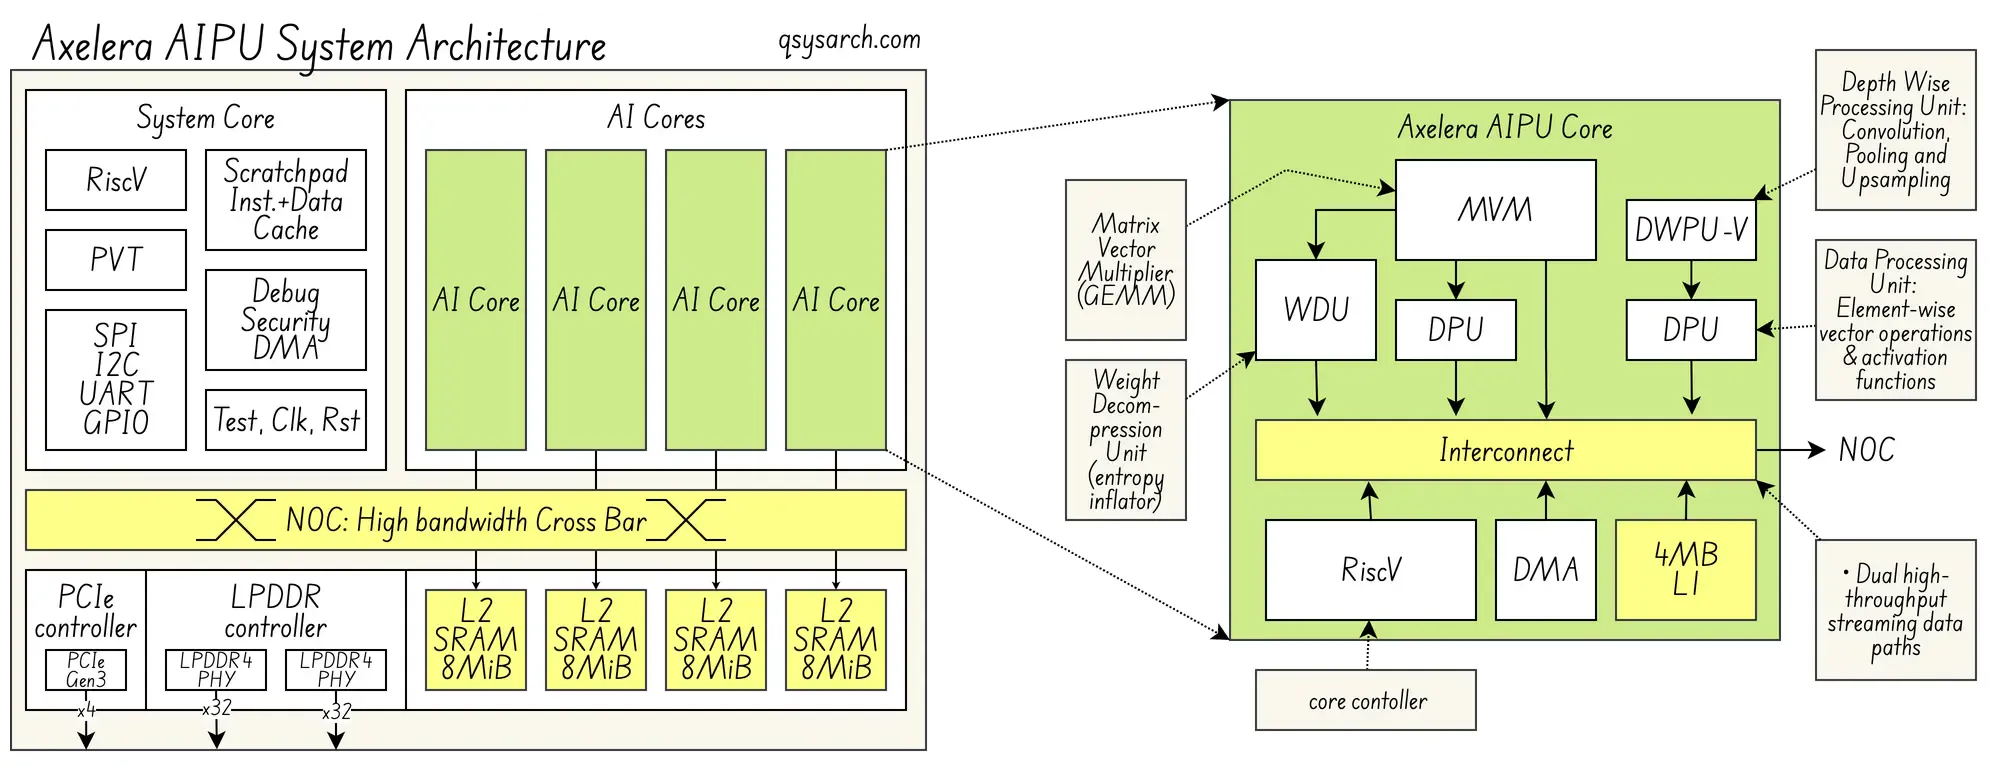
核心优势:利用内存计算,它可以直接在数字存储单元内部执行复杂的矩阵乘法运算,从而消除数据移动;这使得其能效达到 15 TOPS/瓦(相比之下,NVIDIA Blackwell 的能效约为 3 TOPS/瓦)。此外,它还是完全由欧洲设计的 IP,使其成为一项自主解决方案。
目标工作负载:第一代产品专注于计算机视觉/多流视频分析;新一代产品(M2 集成)也可用于边缘 LLM 和 vLM 工作负载。
弱点:Axelera 的弱点不在于其工程技术——他们的技术是世界一流的。他们真正的弱点在于市场摩擦:他们能否在不分散注意力的情况下打入市场?
在查找上述公司信息的过程中,我偶然发现了一些制造业挑战者和颠覆者,它们可能在未来几年发挥重要作用。其中最后一家公司——Unconventional AI——绝对不容忽视,这要归功于其领导者过去的成功和远见卓识。

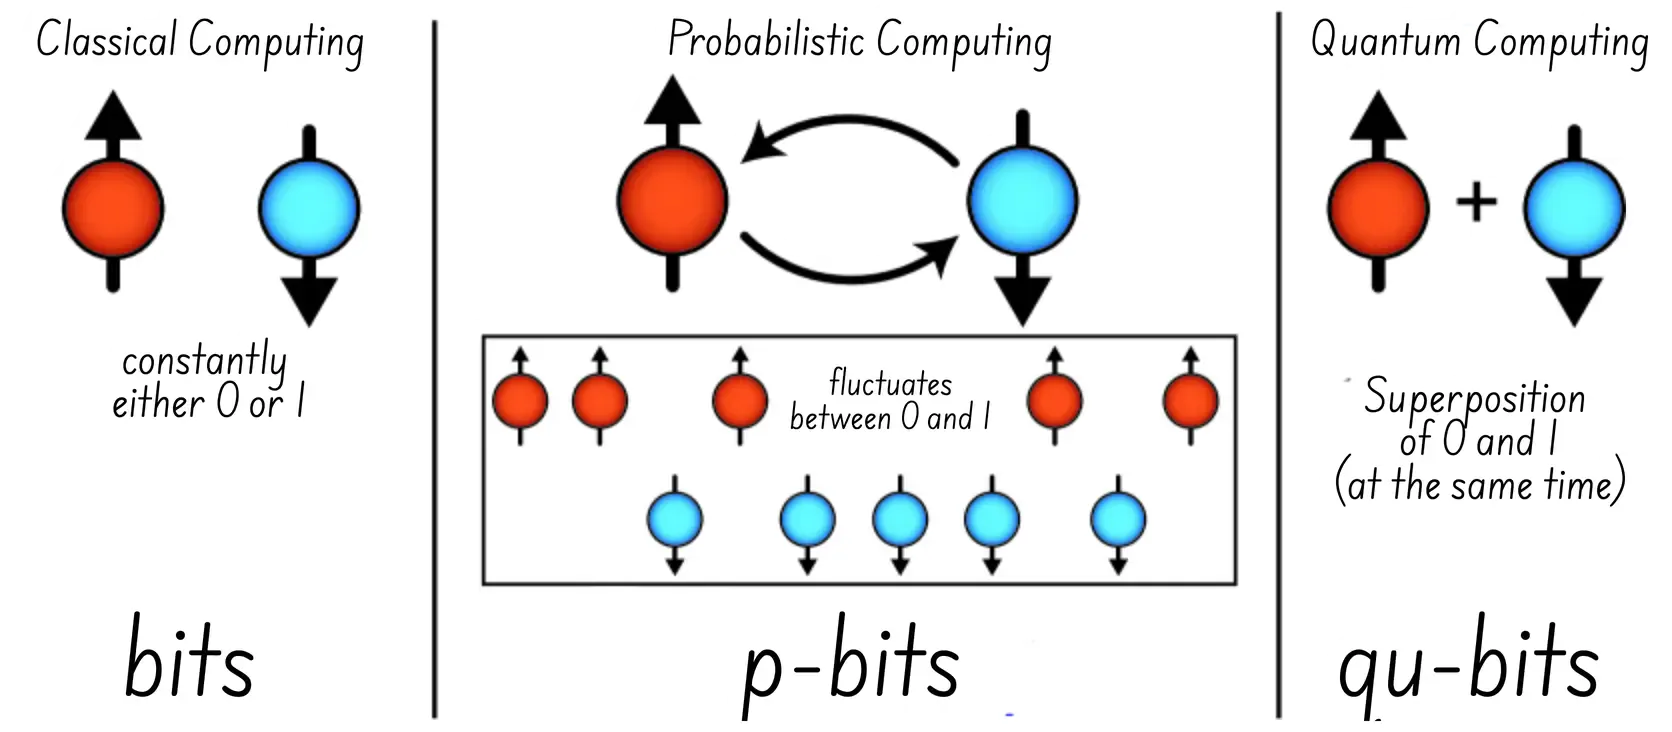
Extropic 和 Normal Computing
- 架构:TSU(热力学采样单元)/ SPU(随机处理单元),用于操作“p 位”(又称概率位)
Mottronix
架构:使用莫特存储器(Mott-RAM)的 SPU(脉冲神经网络)。
为什么这很重要:我们需要有远见的人来研究替代存储器,例如电阻式存储器(ReRAM),或者像 Mottronix 的 Mott RAM。
弱点:必须证明它可以从研究成果转化为产品化的集成电路。
Akhetonics
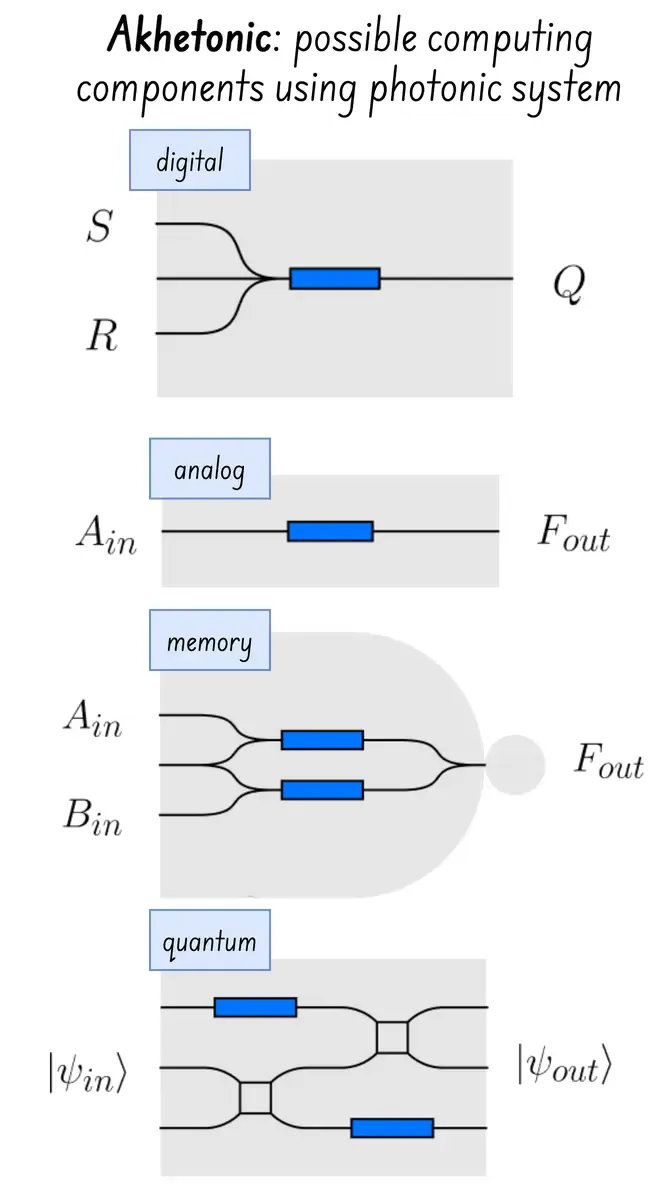
架构:采用全光数字处理器的推理处理单元 (RPU)
重要性:过去十年,光子集成电路的良率取得了巨大的提升——例如,NVIDIA 现在已经能够商业化生产硅光子网络交换机——将其应用于计算工作负载是顺理成章的下一步!(这也使得光寻址量子计算成为可能!)
漏洞:OAQ 量子计算和 RPU 推理计算之间的区别尚不明确,而且在扩展到商业解决方案之前,都需要仔细的校准和调整。
Arago
- 架构:“JEF”作为光子AI加速器,能够降低10倍至30倍的能耗——关于Arago的公开信息非常有限,但它似乎是一种混合确定性/经典+光子加速器集成解决方案,并结合了全栈和PyTorch兼容的软件SDK。
 非常规人工智能
架构:采用仓本振荡器的[UN]CPU([非]常规处理单元)
为什么这很重要:我非常喜欢这个想法,而要实现它,执行力至关重要:敢于另辟蹊径只是成功的一半;真正改变世界的人需要日复一日地努力。为此,他们拥有一位经验丰富的领导者。
漏洞:他们仍处于第 0 到 1 天,因此执行力是关键。
2026年6月市场回顾
链接到标题
当前可能改变市场格局的真正战场在哪里?
- 英伟达的结构性优势不在于GPU,而在于过去十年间建立的CUDA生态系统。赢得这场竞争需要赢得软件,而不仅仅是芯片——而这正是许多以硬件为中心的创新型公司失败的原因。
AMD是NVIDIA近期最被低估的威胁:它无需超越CUDA,因为他们拥有自己的工具,只需满足对成本敏感的云服务买家的需求即可。ROCm 6.x正在以超出预期的速度缩小差距。
大多数创新者都在尝试各种时空折衷方案;要么增加更多超高速的局部内存;要么允许动态可配置的数据流(管道);目前,瓶颈在于 RAM;
- 也许最终的赢家是那些能够同时解决这两个问题的算法,这对于稀疏矩阵计算(包含大量“零”)来说尤为重要,因为在稀疏矩阵计算中,人们既要避免内存传输零值,又要避免计算零值!Renegade 能否成为制胜关键?
技术与市场方向(2026~2029)
链接到标题
以下概述是对一级到三级市场格局的个人见解。下一个周期将由三个转变主导,它们按影响程度排序。
LLM(层级逻辑模型)越来越受内存带宽限制,而非计算限制。随着模型规模扩大,上下文窗口扩展到100万个以上的令牌,权重在HBM(高动态范围模型)内外迁移的成本和延迟成为主要因素。权衡的关键在于利用片上SRAM进行近内存计算和使用具有足够带宽的大容量内存:关键KPI可能成为内存功耗,定义为带宽乘以占空比。
仅激活每个标记部分参数(使用稀疏矩阵)的混合专家模型也属于此类:大多数加速器尚未针对稀疏激活模式进行优化,因此 NVIDIA 推出了 Tensor Core。它可能并非最终解决方案,而只是在等待更稳定可靠的方案出现期间的一个“硬件补丁”。
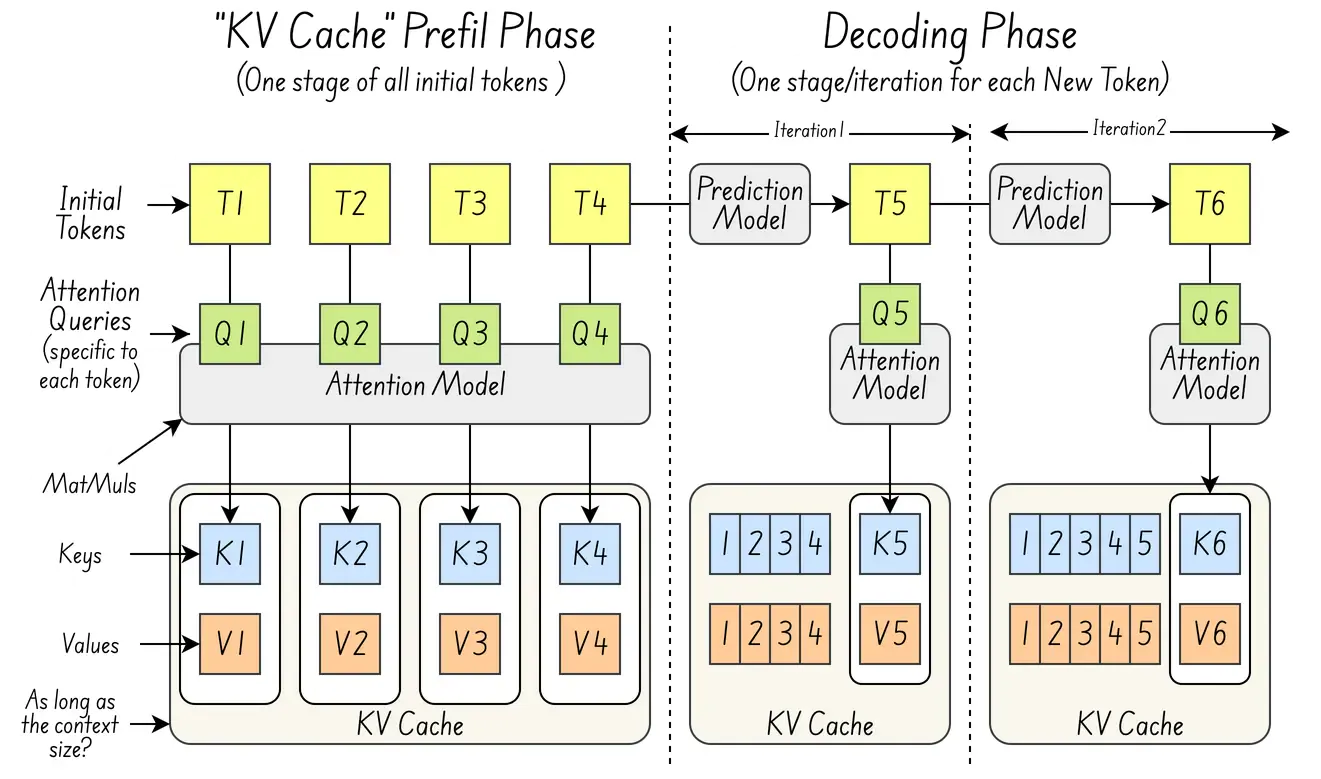 例如,现在通常采用预填充/解码 (PD) 分离来分离 LLM 的预填充阶段(从多个词元构建初始键值缓存)和解码阶段(一次生成一个词元)。这为专用推理协处理器打开了大门,因为预填充需要更强的计算能力,而解码需要更强的内存能力(需要为每个词元加载新的键值缓存)。
NVIDIA Tensor Core 用于稀疏混合专家模型,也属于这一类。
推理定价在两年内下降了约 10 倍。企业级 AI 的普及不再受模型质量的限制,而是受推理成本的限制。这意味着:通用推理硬件的价格已经低于高端硬件(NVIDIA H100/B200),无法满足标准 LLM 服务的需求。这正是挑战者们最有机会大展拳脚的地方。试想一下,如果能够使用 Positron Asimov 处理器在通用硬件上运行 GLM5.2,那该有多棒!
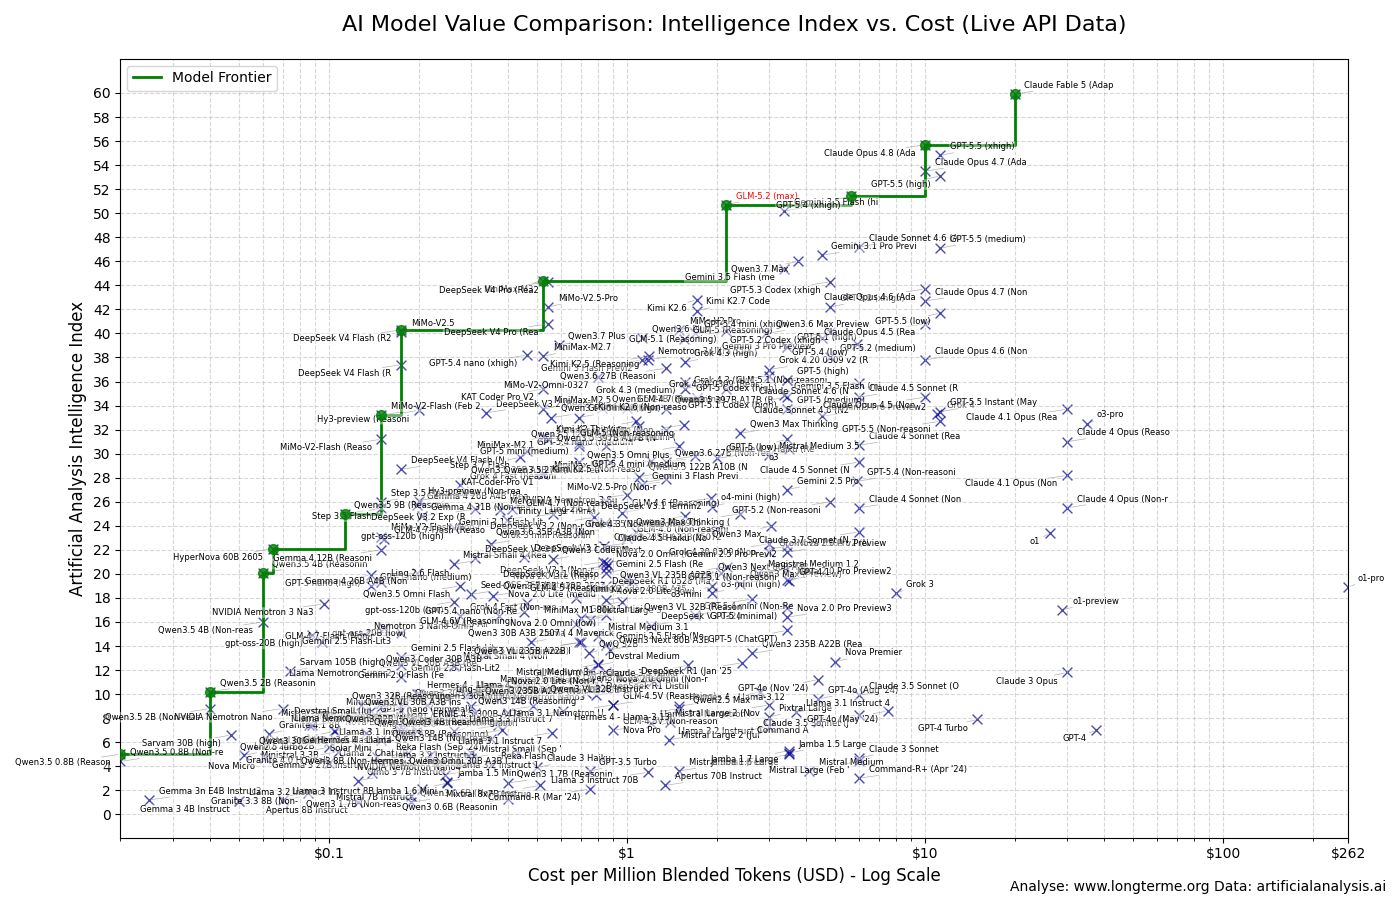 (图片来源:L’Observatoire du Long Terme - Z AI GLM5.2 在智能/成本方面显然是局外人 - 但需要接近 200GB 的内存)
部署简易性: 最后但同样重要的是:硬件到软件、用户界面和工具的易用性
链接到标题
企业往往低估了运营的复杂性。那些提供“盒装推理”和零配置运行时环境(而不仅仅是芯片)的供应商将赢得企业钱包中不成比例的份额。
由于欧盟和亚太地区的监管压力,对本地推断的需求将会加剧这种情况,因为,是的,许多企业不希望将其专有知识推断到外国系统中。
2024-2026 年的推理市场与 2000-2003 年的网络市场颇为相似。NVIDIA 就像当年的思科:占据主导地位,产品设计过度,价格也高得离谱。问题不在于是否要在 NVIDIA 最擅长的工作负载上挑战它,而在于 NVIDIA 在哪些方面过度服务于市场,以及在哪些方面,一款专用的替代方案能够以 40% 的成本提供 80% 的性能。
与此同时,NVIDIA 也在大力投资生态系统,并将 CudaQ 和 NVQLink 等优秀的完全开源贡献免费提供给社区,这将使任何 NVIDIA 的竞争对手更难赢得这些社区的支持。
瞧,这就是一份简短而肤浅的周日早晨备忘录。我还需要深入研究未来挑战者的架构细节,幸运的是,今年夏天我至少可以就其中两个挑战者撰写一份备忘录。与此同时,下一份备忘录将探讨大家期待已久的话题(不少读者都要求我谈谈):量子纠错简述!
# 参考
https://api-docs.deepseek.com/news/news260424
在多核异构神经形态平台 SpiNNaker2 上进行 SNN 推理](https://arxiv.org/pdf/2406.17049)
本备忘录中使用的DrawIO图表: