Ralf Levien 因其高效实现的全球最快字形渲染引擎而闻名,该引擎采用了一种非常巧妙的基于 Rust 的 SIMD 设计。2023 年我在 Bestechnics 设计 SIMD GPU 时,他的工作给了我很大的启发。后来,Ralf Levien 还开发了该字形渲染引擎的 GPU 版本。
所以,当我偶然看到他关于“Rust 如何获胜:追求高性能、高可靠性软件”的最新演讲时,我决定花一个小时观看演讲,并从中汲取任何值得学习的见解。
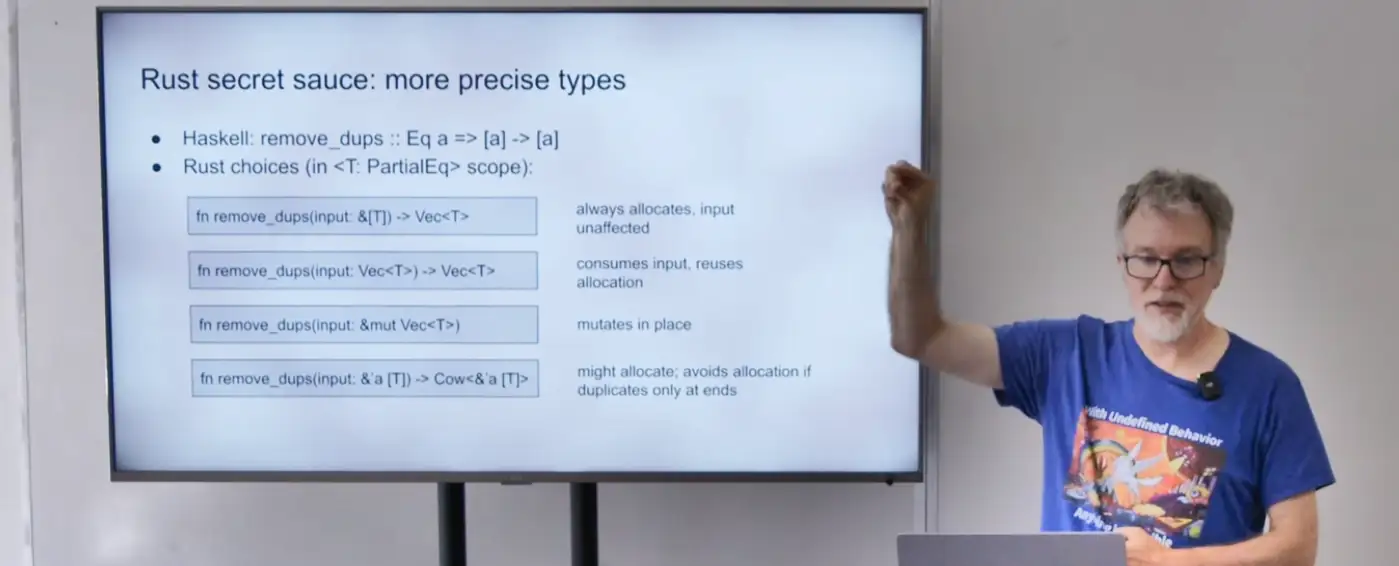
紧张的部分(也称为溺水区)大约从 55:00 开始,幻灯片标题为“Rust 秘方:更精确的字体”。
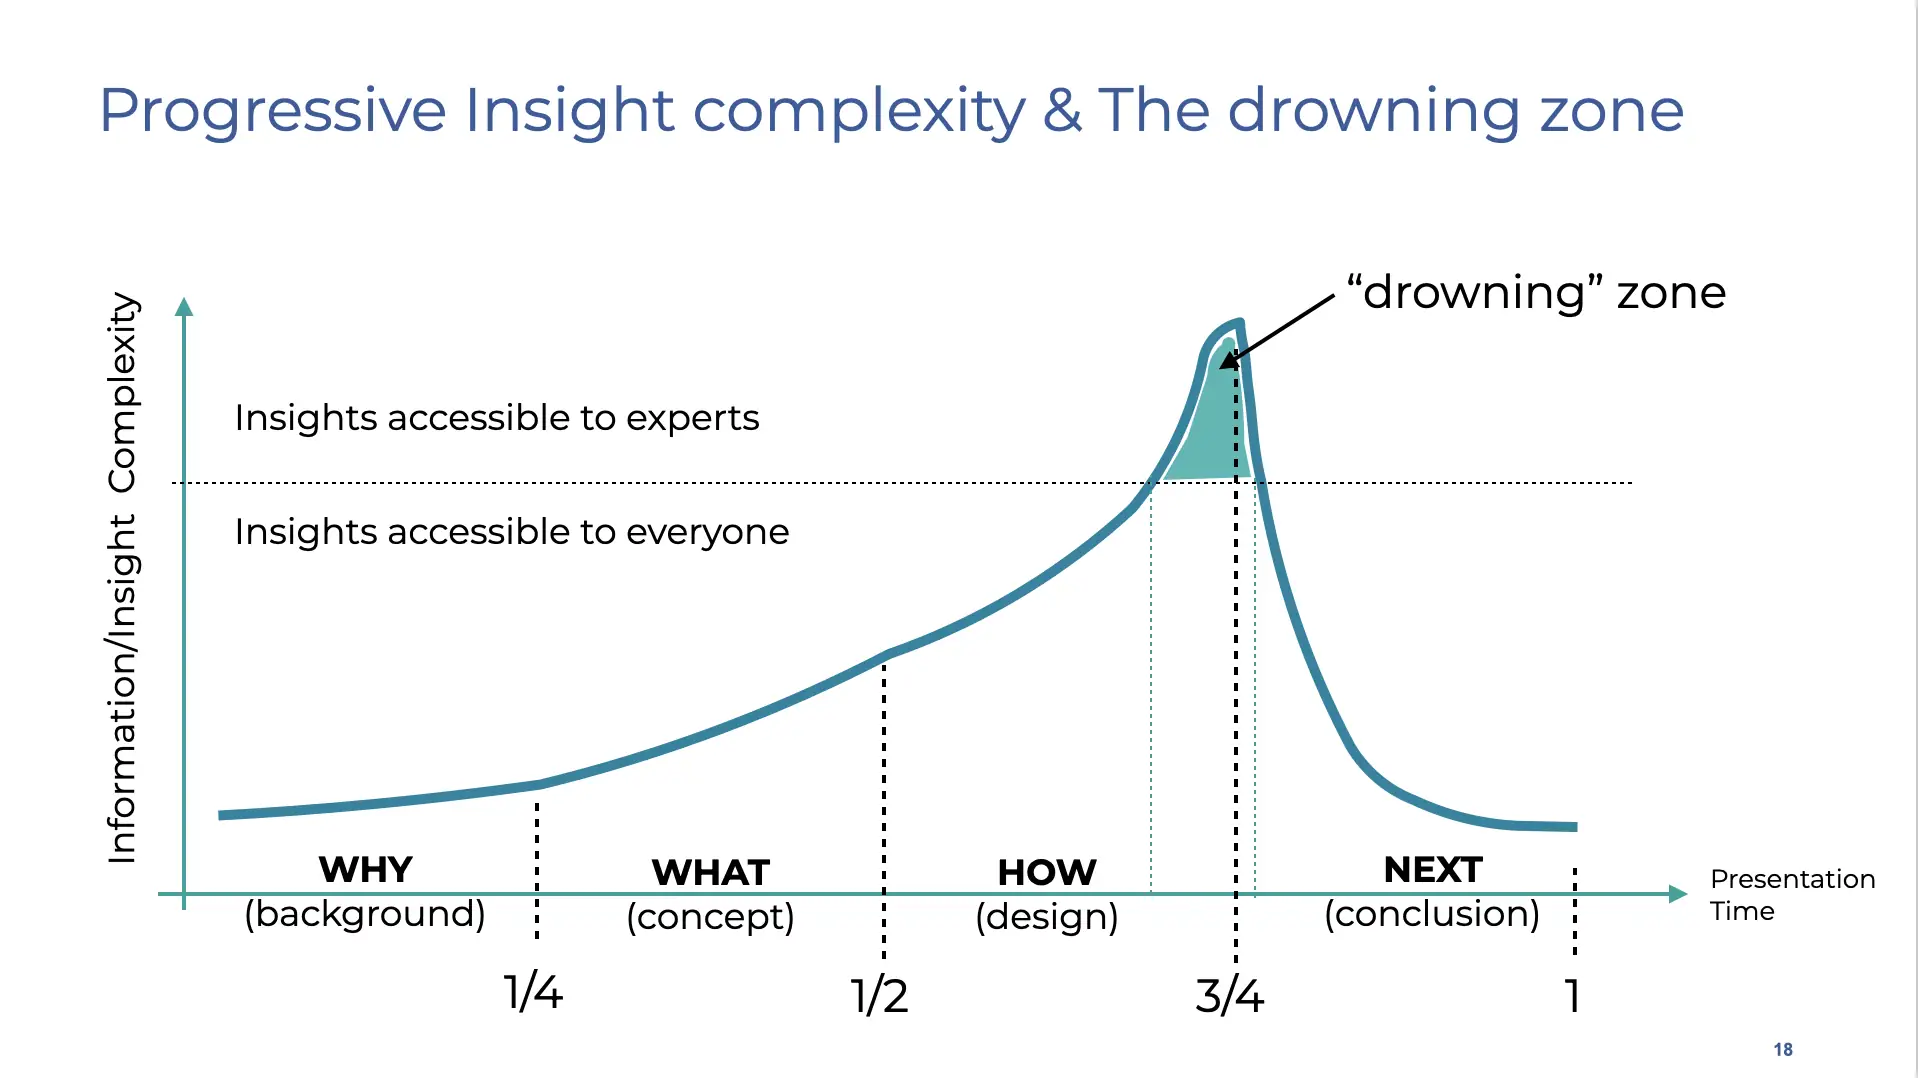
在 56 分 50 秒,Raph 说:“这就是仿射类型发挥作用的地方;你想把(可克隆性)建模为‘存在一个实例’;而这种类型允许你在函数签名中仔细指定如何处理所有权;最后一个例子我就略过了,不过挺有意思的,对吧……”
我绝对不敢自称是 Rust 专家,而且我承认自己更偏爱 Go——所以,问题是,我能理解 affine type 的真正含义吗?能否用通俗易懂的语言解释一下,而不用让我淹没在浩瀚的知识海洋中?
YouTube评论里还提到了一个问题:最后一个函数的返回类型应该是Cow<'a, [T]>,而不是Cow<&'a [T]>。说实话,这看起来比量子算法还要复杂。但也许并非如此!
那么,让我们仔细看看这些“更精准的类型秘诀”的例子:
fn α( l: &[T] ) → Vec<T> : 始终分配内存,输入不受影响
fn β( l: Vec<T> ) → Vec<T> : 消耗输入并重用分配的内存。
fn δ( l: &mut Vec<T> ): 不进行内存分配,只是修改输入向量
fn ω( l: &'a [T]) → Cow<'a,[T]>: 可能需要分配内存;如果重复项仅出现在两端,则避免分配内存。
通用模板 T 中首先要检查的问题是:它真的能正常工作吗?这些函数可以这样编译吗?让我们用最简单的函数版本来尝试一下:
// fails with: error cannot find type T in this scope
fn α( l: &[T] ) -> Vec<T> { vec![] }
这显然行不通,并会报错“在此作用域中找不到类型 T”。如果您熟悉 C++,就会知道类型 T 必须与函数名一起声明,因此需要声明 α。而不是 α。
// all right with the T declaration
fn α<T>( l: &[T] ) -> Vec<T> { vec![] }
这样可以正常工作!但是,当添加一个基本实现(仅转换为 vec,而不删除重复项)时,编译器会报错,提示“trait bound T: Clone 未满足”。
// fails with: the trait bound `T: Clone` is not satisfied
fn α<T>( l: &[T] ) -> Vec<T> { l.to_vec() }
幸运的是,Rust 对泛型和 traits 有非常好的文档,阅读 10 分钟后,我们就能清楚地意识到需要修改 α。到 `α<T: Clone>作为表达T型性状界限的一种手段。
// all right with the trait bound
fn α<T: Clone>( l: &[T] ) -> Vec<T> { l.to_vec() }
下一步是实现去除重复项的解决方案。为此,一种方法是使用 HashSet。首先,将数组转换为迭代器(let iterator: std::slice::Iter)。 = l.iter();),然后我们从该迭代器构建一个哈希集(HashSet::from_iter(iterator)),最后将哈希集转换为向量set.into_iter().collect()`。
//Fails with: the trait bound `T: Eq` is not satisfied
use std::collections::HashSet;
fn α<T: Clone>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
不出所料,这失败了!这很正常,因为如果你花了十分钟阅读 Rust 的 trait 文档,就会知道 HashSet 可能需要某种能够“比较”类型 T 的元素的方法。这就是 Eq trait 的作用——所以,我们只需将其添加到 trait 的边界中(从 α 开始)。<T: Clone>到 α<T: Clone + Eq> ):
//Fails with: the trait bound `T: Hash` is not satisfied
use std::collections::HashSet;
fn α<T: Clone + Eq>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
它仍然失败,原因是我们忘记提及类型 T 需要能够转换为哈希值。这就是 Hash trait 的作用。所以,让我们从 α 改为 T。<T: Clone + Eq>到 α<T: Clone + Eq + Hash>
//Fails with: a value of type `Vec<T>` cannot be built from an iterator over elements of type `&T`
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
这就是可克隆性乐趣所在:哈希集是一个结构体,其中包含指向列表中初始元素的指针,这些元素是按值传递的(准确来说,数组是通过指针传递的,而数组中的元素也是按值引用的)。因此,我们需要告诉哈希集复制这些元素,这可以通过在最后一个 collect 方法之前添加 cloned() 来实现(collect 方法用于将迭代器转换为向量集合)。
// all right!
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().cloned().collect()
}
瞧,第一个函数示例就准备好了:
fn main() {
println!("{:?}", α(&["A","A","B","D"]));
println!("{:?}", α(&[1,1,2,4]));
}
说实话,这既复杂又不复杂。说它复杂,是因为编译器强制执行严格的规则,这些规则必须显式声明,而不能隐式推导,因此学习曲线陡峭。说它不复杂,是因为一旦你花了“10分钟”阅读文档,事情应该就会变得容易一些。也许问题不在于阅读文档需要10分钟,而在于理解文档的内容需要10个小时。这感觉似曾相识……
第二项挑战:仿射类型
关于可克隆性,我还有一个问题。我们能否返回一个只包含对数组中传入元素的引用的向量?乍一看,似乎只需要修改 Vec 即可。将 Vec<&T> 转换为 Vec<&T>……并正确处理仿射类型约束?让我们试一试:
// All right - works fine
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<&T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
嗯,这样可以!而且没有关于生命周期的问题?我的意思是,我们是不是在借用元素,所以应该检查生命周期才对?是不是我们的 main 函数太简单了?那么,我们来试试更复杂的情况:
// fails with expected named lifetime parameter
fn limited_lifetime() -> vec<&str> {
let l = ["A","A","B","D"];
α(&l)
}

fn main() {
let v = limited_lifetime();
println!("{:?}",v);
}
这次失败了:编译器报错说缺少生命周期参数,所以我们不妨花这额外的 10 分钟阅读一下 Rust 文档中关于“使用生命周期验证引用”的部分(https://doc.rust-lang.org/book/ch10-03-lifetime-syntax.html)。乍一看,我们似乎只需要添加一个“a”?
//  fais with: mismatched types; expected `&[str]`, found `&[&str; 4]`
fn limited_lifetime<'a>() -> Vec<&'a str> { ... }
但是不行,这样做行不通。我们来尝试将“不可变字符串”转换为动态字符串:
// fails with: cannot return value referencing local variable `l`
fn limited_lifetime<'a>() -> Vec<&'a String> {
let l = ["A".into(),"A".into(),"B".into(),"D".into()];
α(&l)
}
好的,这确实是我们预期的错误——借用检查器确实在工作。但是,我们该如何告诉编译器,我们希望转移这些局部分配变量的所有权呢?要实现这一点,我们需要告知编译器,我们希望将数组 l 分配到堆上。为此,我们需要使用 vec 而不是数组。
// this works
fn β<T: Clone + Eq + std::hash::Hash>( l: Vec<T> )  -> Vec<T> {
let hash_set: HashSet<_> = l.into_iter().collect();
hash_set.into_iter().collect()
}

fn limited_lifetime<'a>() -> Vec<&'a str> {
let l2 = vec!["A","B","B","D"];
β(l2)
}

fn main() {
println!("{:?}",limited_lifetime());
}
这个版本之所以有效,是因为新的 β 函数接受一个元素向量,并返回向量中的元素本身,而不是指向这些元素的指针。因此,元素被克隆了。但如果我们希望 β 函数返回指向输入元素的指针呢?
第三项挑战:写入时克隆
还记得最后一个 omega 函数中的“Cow”吗?
fn ω( l: &’a [T]) → Cow<&’a [T]>
Cow 实际上是一个枚举类型。它可以保存一个不可变的(借用的)引用,也可以保存同一个对象的可变克隆。例如:
use std::borrow::Cow;
fn trim_input(input: &str) -> Cow<str> {
if input.ends_with(' ') {
Cow::Owned(input.trim_end().to_string())
}
else  Cow::Borrowed(input)
}
那么,我们应该写 Cow<'a [T]> 还是 Cow<&'a [T]> 呢?乍一看,由于输入是指向类型为 [T] 的对象的指针 &,其生命周期为 'a,因此输出也是指向相同类型对象的指针。区别在于 Cow<> 本身也表示指针。所以,正确答案应该是 Cow<'a, [T]>。
fn ω<'a, T>( l: &'a [T]) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
有趣的是,在 Rust 中,数组的长度在编译时就已经确定了。那么,我们如何在运行时分配一个动态大小的新数组呢?显然,根据这条 stackoverflow 评论 的说法,这是不可能的。也许 Ralf 原本想用的是 vec 类型?
fn ωx<'a, T: Clone + Eq + std::hash::Hash>( l: &'a Vec<T>) -> Cow<'a, Vec<T>> {
let hash_set: HashSet<_> = l.into_iter().collect();
if hash_set.len()==l.len() {
return Cow::Borrowed(l);
}
let own_copy = hash_set.into_iter().cloned().collect();
return Cow::Owned(own_copy);
}
说实话,我必须承认,我被语法“fn ω<‘a, T>( l: &‘a [T]) -> Cow<‘a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }”难住了,它本应只是表示“同一个的克隆”。
如果我们认为 &'a T 可以重写为 Ptr<'a,T>,那么我们也可以将函数重写为:
fn ω<'a, T>( l: Ptr<'a, [T]>) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
如果我们忽略 T 是一个数组这一事实,上面的代码可以重写为:
fn ω<'a, T: ToOwned>( l: Ptr<'a, T>) -> Cow<'a, T> { Cow::Borrowed(l) }
那么,如果将类型重写为基于宏的表达式而不是语法呢?
fn ω<'a, T>( l: Ptr<'a, T> ) -> !Cow(l) { Cow::Borrowed(l) }
通过允许重写,!Cow(l) 宏可以隐式地表明类型 T 必须绑定到 trait ToOwned。这样看来,我们可以预见到 'a 和 T 是泛型类型,在使用 Ptr trait 时无需显式指定。
fn ω( l: Ptr ) -> !Cow(l) { Cow::Borrowed(l) }
那么令人困惑的是,我们同时指定了编译时类型和运行时实现,却没有任何区别。但也许这正是 Rust 的本质所在?
# 结论
我认为拉尔夫的“秘诀”需要花一个小时才能解释清楚,而且应该专门做一套幻灯片——而不是仅仅在一小时的演讲中用三分钟就讲完。对它进行批判性的审视也很有价值;也许它并非处处都那么有趣?也许其中存在一些过度设计,导致不少开发者望而却步?而这或许正是它所谓的“乐趣”所在?总之,我会在接下来的几周里尝试准备一些幻灯片,以便进行一个小时的演讲。
回到量子计算的挑战——问题在于,我们是否需要类似的复杂度才能让量子计算系统运行?这或许才是当今的挑战?尽管量子算法看似复杂,但与这种原始的Rust语法相比,它们其实相当简单。或许我们需要更进一步,才能解决量子计算的“实用性”挑战?而如果没有这种额外的复杂性,我们或许仍然只能进行一些基本的计算?
假设这一切都与我们想要操纵的对象语义有关,那么或许我们需要意识到,在量子比特之上存在一个逻辑抽象层,而这个抽象层目前还不明显,因为业界仍在努力使量子比特正常工作。