Utilizarea inteligenței artificiale, sau mai precis a rețelelor neuronale (NN), nu este doar evidentă, ci și o parte aproape obligatorie a oricărui sistem în 2025. Nu este surprinzător faptul că numeroase lucrări de cercetare au fost publicate pe această temă. Cu toate acestea, cele mai recente cercetări au dus limitele la un alt nivel, permițând integrarea de înaltă performanță a rețelelor neuronale în cadrul sistemului de control cuantic.
Îmi bazez acest articol pe munca depusă de Centrul pentru Tehnologii Cuantice din Singapore [CQT/NUS] (https://www.cqt.sg/) și, mai precis, pe cercetarea lui Arthur Strauss, cu care am avut marea onoare să discut și să schimb idei în cadrul ultimului eveniment [SQA] (https://www.sqa-conference.org/).
Învățarea prin consolidare vine în ajutor
Link to heading
Ideea lor este fascinantă: utilizarea unei abordări de învățare prin consolidare pentru a ajuta sistemul de control cuantic să ajusteze controlul qubitilor (cunoscut și sub numele de porți), bazat pe un sistem de recompense care vizează maximizarea eficienței controlului. Vă puteți întreba de ce contează acest lucru. Ei bine, așa cum s-a explicat în articolul anterior (link), qubiții sunt „entități” destul de sensibile care necesită o atenție deosebită. Și aici intervine rețeaua neuronală, ajutând la cuantificarea calității acestei atenții, care este uneori denumită și fidelitate.
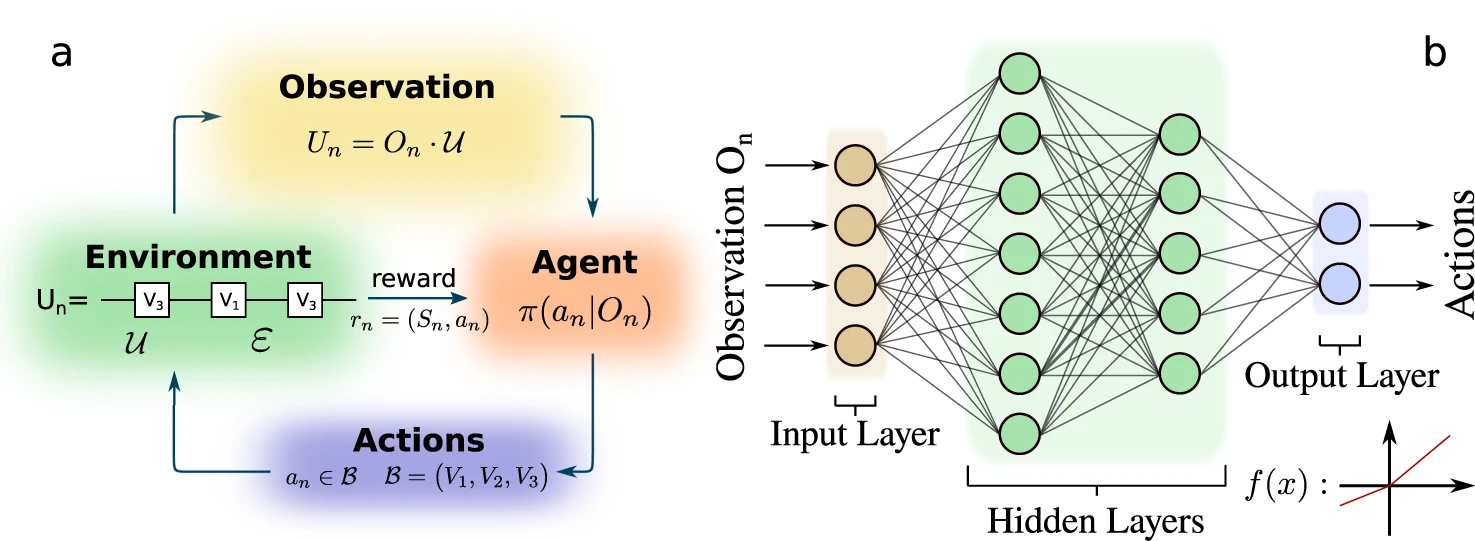
Cum funcționează asta? Învățarea prin consolidare se bazează pe un ciclu de Observații/Acțiuni care sunt învățate printr-un sistem iterativ de recompensare Mediu -> Agent („a” în diagrama de mai jos), de obicei rulat cu un GPU și apoi, odată învățat, executat pe un matmul strâns cuplat (sau nu!) pe sistemul de control cuantic („b” în diagrama de mai jos).
 Credite: Nature
Rețineți că, deoarece observația (numită și citire qubit) distruge starea cuantică, ciclul de învățare resetează mai întâi starea qubitului, execută o poartă de control, citește starea qubitului și transmite informațiile agentului.
Să analizăm în detaliu cele 4 componente ale învățării prin consolidare:
Mediul este controlorul cuantic și qubitul în sine.
Acțiunile constă în ajustarea diferitelor „butoane” sau parametri de impuls ai motorului generatorului RF.
Observația reprezintă caracteristicile qubitului după ce au fost manipulate de mediu.
Agentul este cel care învață politica ce reacționează la caracteristicile observate ale qubitului și adaptează parametrii impulsului în consecință.
Sisteme RL: Metode de învățare
Link to heading
Metodele de RL pot fi clasificate în general în două mari categorii: bazate pe valoare și bazate pe gradient de politici.
Metodele bazate pe valori se concentrează pe estimarea unei funcții valorice și derivarea politicilor din aceasta. Metodele bazate pe gradient de politici optimizează direct politica prin maximizarea recompensei cumulative așteptate prin ascensiunea gradientului.
Avantajul iterației politicilor este că converge mult mai rapid decât algoritmii bazați pe valori, deși este mai scump din punct de vedere computațional. Și aici intervin algoritmii gradientului de politici, prin reducerea complexității calculului. Exemplu de algoritmi gradient de politici, inclusiv algoritmul reinforce:
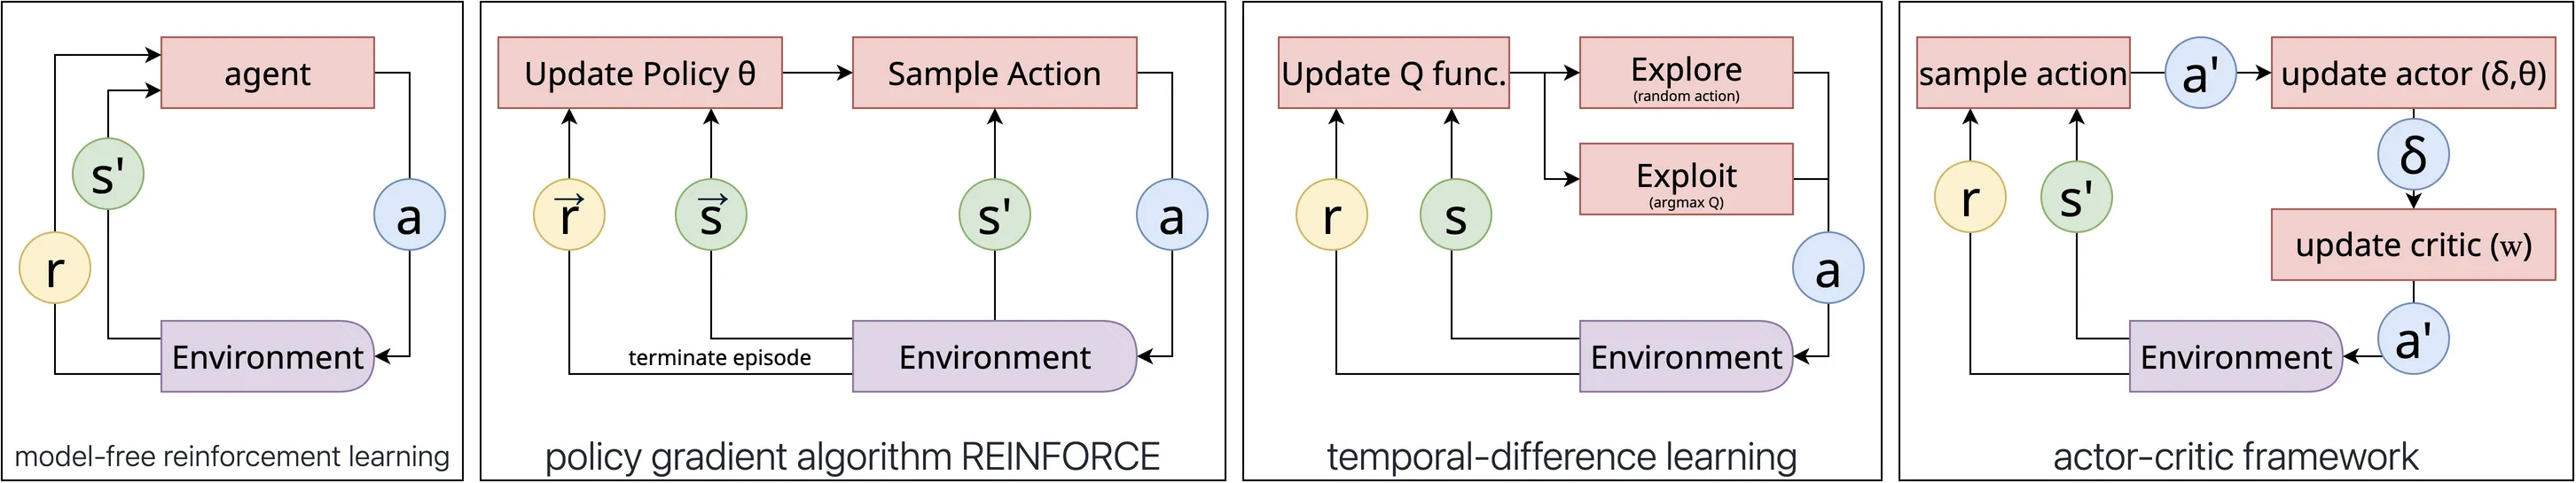
În diagramele de mai sus, „s” reprezintă starea, „a” acțiunea și „r” recompensă.
Sisteme RL: Iterație vs. Episoade
Link to heading
În învățarea prin consolidare, un episod și o iterație sunt concepte diferite:
Un episod este o secvență completă de interacțiuni între agent și mediu, începând de la o stare inițială și terminând la o stare terminală (sau după un orizont de timp maxim).
În unele lucrări/cod, o iterație poate însemna un pas temporal al interacțiunii agent-mediu (stare → acțiune → recompensă → starea următoare).
În contexte de optimizare, o iterație poate însemna o etapă de actualizare a algoritmului de învățare (de exemplu, o etapă de coborâre a gradientului, care s-ar putea baza pe mai multe episoade sau tranziții).
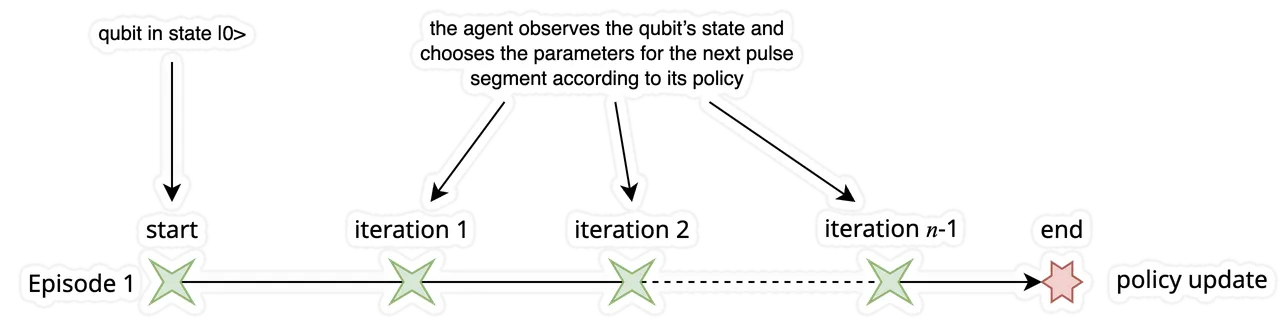
Să implementăm aceste idei una câte una, începând cu eșantionarea episoadelor.
Episoadele încep cu qubitul în starea |O>.
- Începeți bucla observă-acționează
agentul observă starea qubitului
În loc să aleagă în mod determinist acțiunea „cea mai bună” (de exemplu, cea cu cea mai mare probabilitate), eșantionarea înseamnă că agentul va extrage aleatoriu o acțiune din acea distribuție, în funcție de probabilități.
Această eșantionare este esențială în metoda de consolidare.
Cu alte cuvinte, evaluați ∇(𝜃) pentru acțiunea eșantionată.
- Calculați recompensa sa când se ajunge la sfârșitul programului de puls.
Scorul și recompensa, împreună, determină actualizarea învățării în învățarea prin consolidare cu gradient de politici:
Analiză practică aprofundată: Flax și Jax
Link to heading
să fie completat
Îmi pare rău, acesta trebuia să fie un blog ușor și se dovedește a fi mult mai complex. Poate că trebuie să continui să „simplific ecuația”. În orice caz, ce am învățat aici? Procesul de optimizare pentru cuantificarea optimă a calității qubiților are prea multe dimensiuni - și, așa cum era de așteptat, rețelele neuronale sunt foarte bune la rezolvarea acestei provocări. În acest blog, ne-am concentrat pe o optimizare a fidelității unui singur qubit. Dar gândiți-vă la doi qubiți sau mai mulți: atunci trebuie să învățați impactul interacțiunii. Există multe întrebări și provocări, în special în ceea ce privește modul de învățare: global la nivel de mai mulți qubiți sau local și la nivel de pereche de qubiți. Poate chiar ierarhic la nivel logic de qubiți. Multe întrebări, pe care le voi analiza în următorul blog despre Corecția Erorilor Cuantice.
Lecturi suplimentare și linkuri: