Într-o lume în care inteligența artificială este avidă de energie, unitatea de procesare Tensor (TPU) schimbă regulile jocului. Este un cip personalizat, conceput de Google special pentru sarcini de învățare automată.
Această scurtă notă este o încercare de a oferi o imagine de ansamblu asupra arhitecturii TPU-urilor și a modului în care acestea au evoluat de la înființarea lor în 2016.
Voi încerca, de asemenea, să răspund la această întrebare esențială: de ce avem nevoie de TPU-uri dacă avem deja GPU-uri? Ce fel de avantaje au acestea față de GPU-uri? Cum se compară cu circuitele integrate neuromorfice? Și există vreo arhitectură alternativă la TPU-uri și GPU-uri?
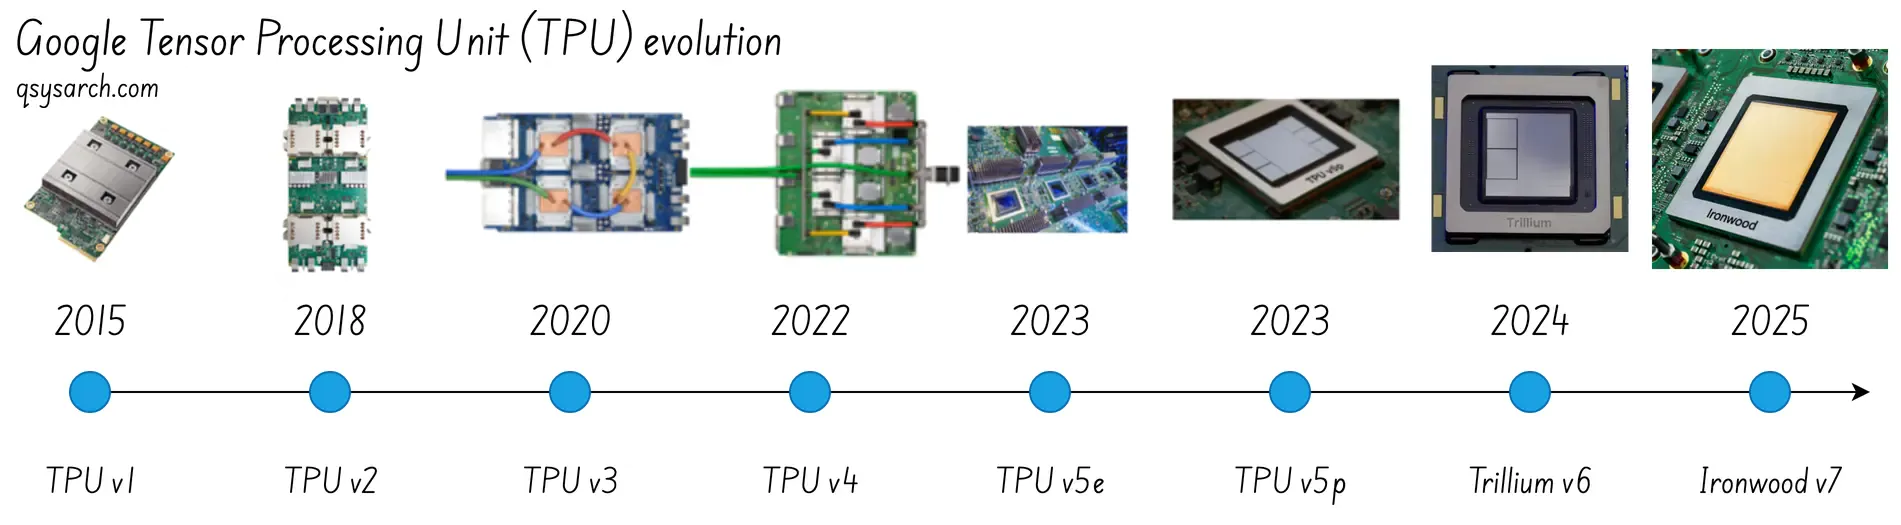 (Sursa: Google Cloud)
De ce există TPU — și ce probleme rezolvă
Link to heading
TPU-ul are același obiectiv ca și GPU-ul: să depășească limitarea introdusă de încetinirea Legii lui Moore, prin permiterea paralelismului masiv. Spre deosebire de procesoarele tradiționale, care pot fi folosite pentru a gestiona calcule generice și care, într-o oarecare măsură, au un nivel de paralelism prin conceptul de multi-core (datorită legii scalării Dennard), TPU-ul și GPU-ul sunt hardware specializat conceput pentru a gestiona sarcini simple și specifice, dar într-un mod mult mai eficient decât ar putea face orice procesor.
La un nivel general, se poate spune că oferă performanțe și eficiență mult mai bune decât procesoarele sau GPU-urile de uz general, „compromițând generalitatea în favoarea performanței”.
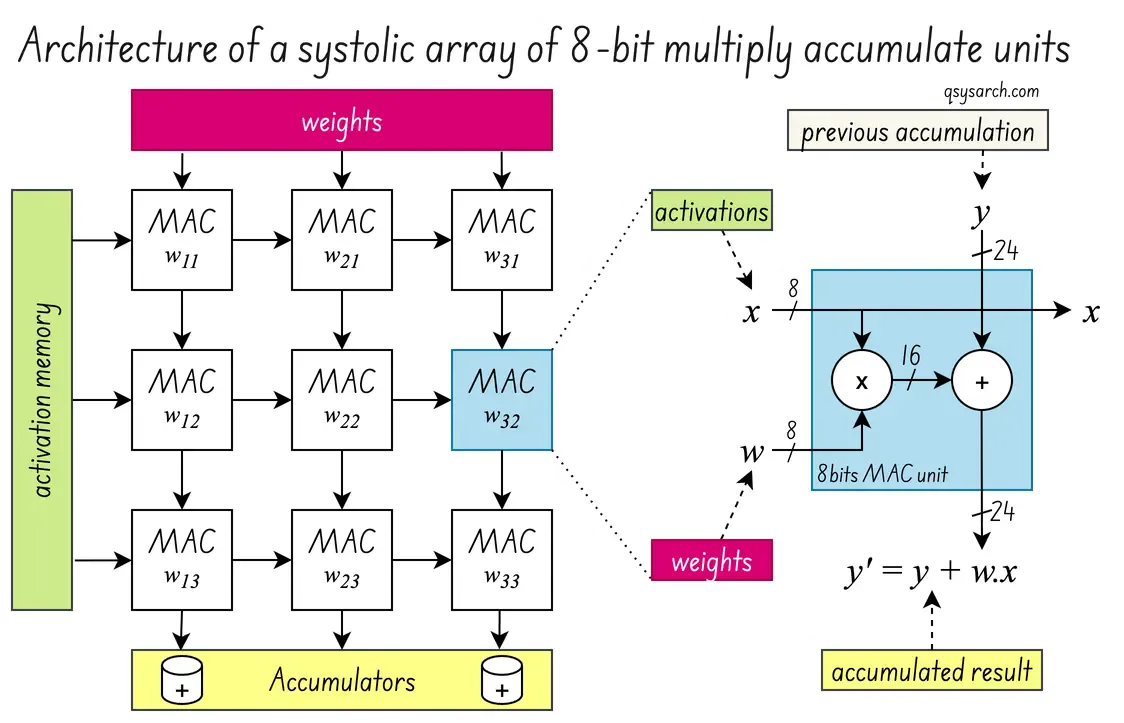
TPU este conceput fundamental pentru sarcini complexe de algebră liniară, cum ar fi înmulțirile matriceale și operațiile tensoriale, utilizate de rețelele neuronale.
În inima TPU se află matricea sistolică, o matrice de elemente de procesare (numită de obicei PE, notată cu MAC în diagrama din dreapta) care poate efectua calcule paralele.
În cazul TPU, această unitate de procesare, sau MAC, este un multiplicator simplu pe 8 biți care înmulțește și acumulează valorile de activare (integrarea) cu ponderile rețelei neuronale. Numai prin efectuarea acestei operații într-un mod masiv paralel, TPU atinge un randament mult mai mare decât un CPU. Și la fel și GPU-urile! Dar mai întâi, să aruncăm o privire la evoluția TPU în timp.
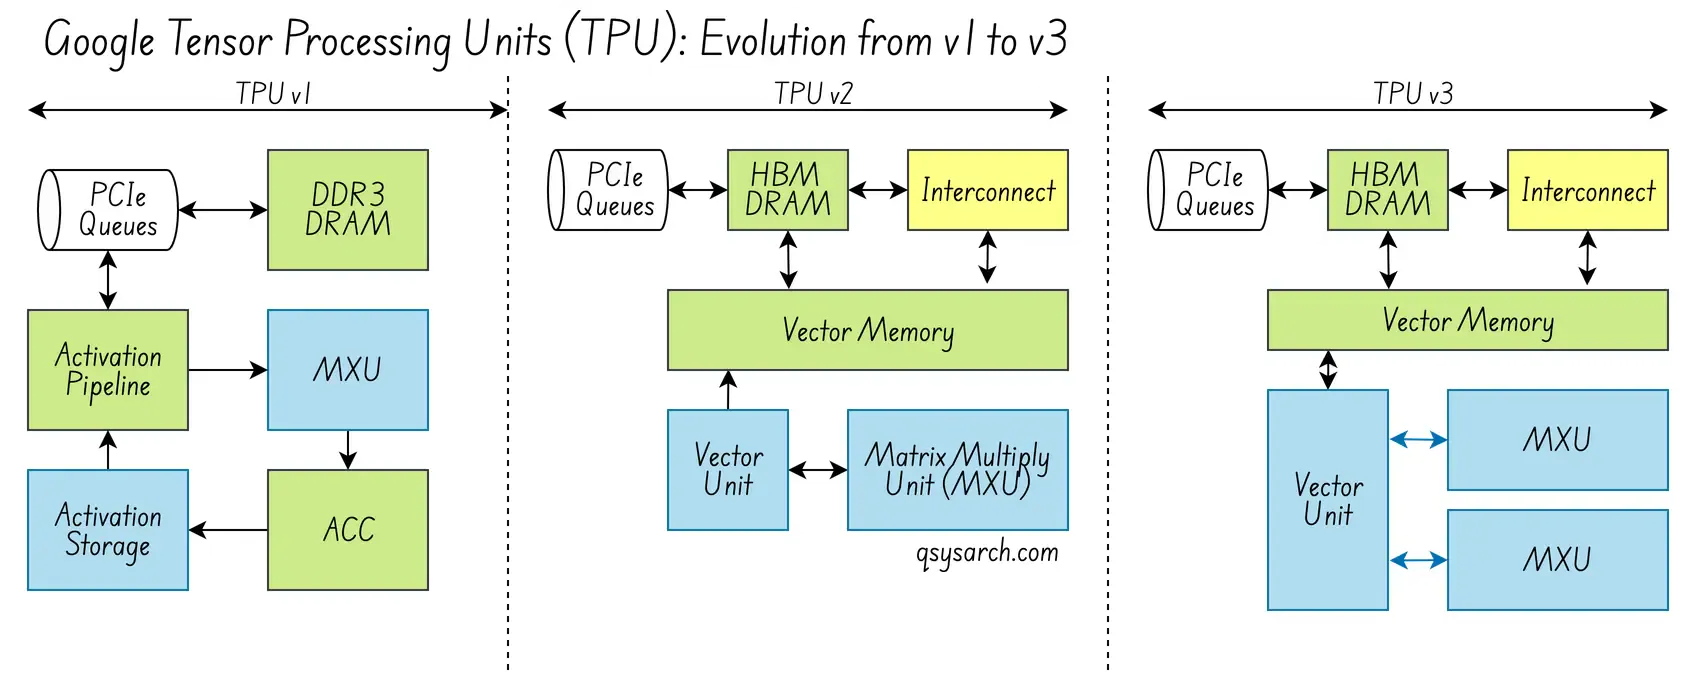
TPUv1 a fost dezvoltat în doar 15 luni, cu scopul principal de a îmbunătăți inferența rețelelor neuronale (nu chiar învățarea, ci doar inferența). Pentru aceasta, Google avea nevoie de multiplicatori matriciali și avea constrângeri nu doar în ceea ce privește atingerea unei viteze mari, ci și în ceea ce privește reducerea consumului de energie. Cheia reducerii consumului de energie era îmbunătățirea localității memoriei, de exemplu, reducerea mișcării inutile a datelor între memoria externă și memoria TPU. Acest lucru ar permite creșterea intensității aritmetice per unitate de control, adică reducerea timpului de inactivitate al TPU în așteptarea datelor.
Din perspectiva hardware-ului, designul TPU v1 a fost simplu, dar elegant și eficient:
coprocesor cu un singur fir de execuție pe o placă PCie standard.
Fără cache pe mai multe niveluri, fără multithreading, fără predicție de ramificații.
Calcule deterministice rapide pe numere întregi pe 8 biți prin MXU sau unitatea de multiplicare matriceală.
Tabloul sistolic este format din 256 * 256 * MXU
Complexitatea a fost mutată la planificatorul software, cu două responsabilități principale:
mențineți conducta ocupată, programând operațiunile astfel încât MXU să nu fie niciodată inactiv.
memorie dublă tamponată, ca mijloc de a ascunde latența accesului la memorie
TPUv2 și v3: Îmbunătățirea memoriei și a interconectării
Link to heading
Conceptele cheie din v2 și v3 sunt antrenarea următoarei generații de modele care necesită retropropagare, precizie mai mare și mult mai multe TPU-uri distribuite și interconectate.
Din perspectiva procesării hardware de bază, au introdus câteva concepte interesante:
- un cip dual core, de exemplu un TPUv2 este alcătuit din două TPU
Fiecare TPU avea o matrice sistolică de patru ori mai mare, constând din 128*128 MXU,
- Capacitatea de a gestiona valori în virgulă mobilă, utilizând formatul Brain Floating Point (BF16), o versiune îmbunătățită a formatului standard IEEE 754 FP16 în virgulă mobilă.
O nouă memorie cu lățime de bandă mare (HBM) în cadrul TPU pentru latența de acces la memorie; (TPUv1 are doar o memorie DRAM de bază, cu timp de acces lent, în timp ce HBM este mult mai rapidă)
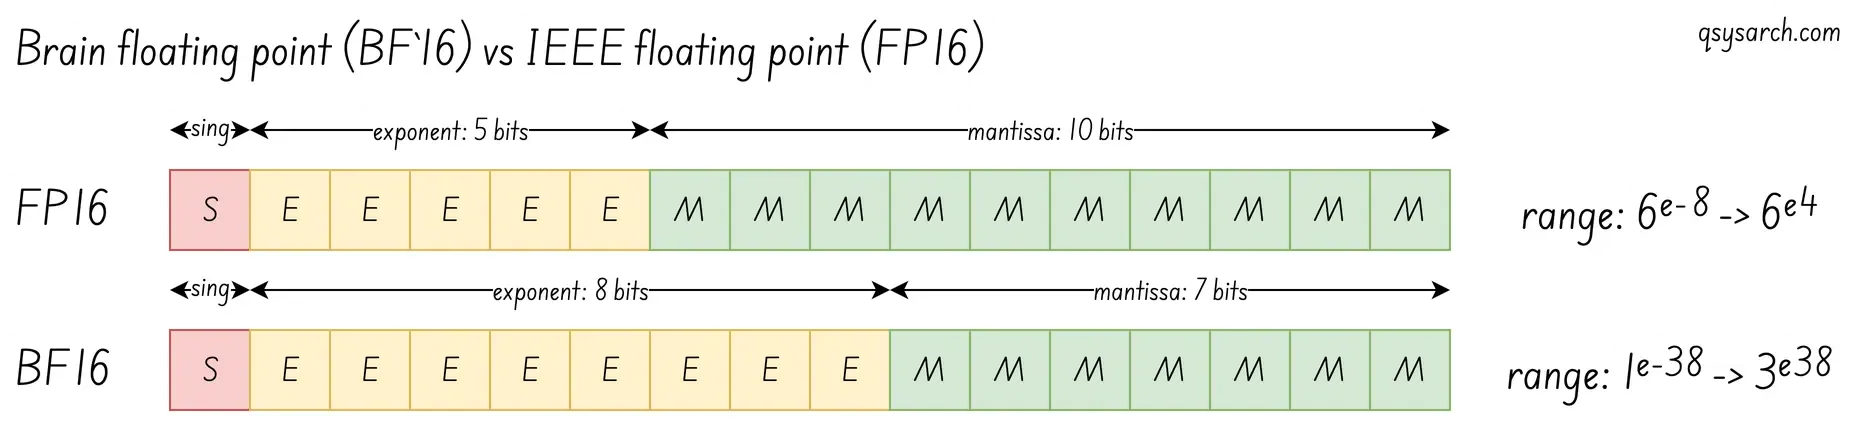
Din perspectiva conectivității hardware,
O interconectare inter-core (ICI), structura de lățime de bandă mare care permite scalarea, prin intermediul unei rețele torice 2D de 16x16 (rețea inelară) - un supercomputer cu 256 de cipuri.
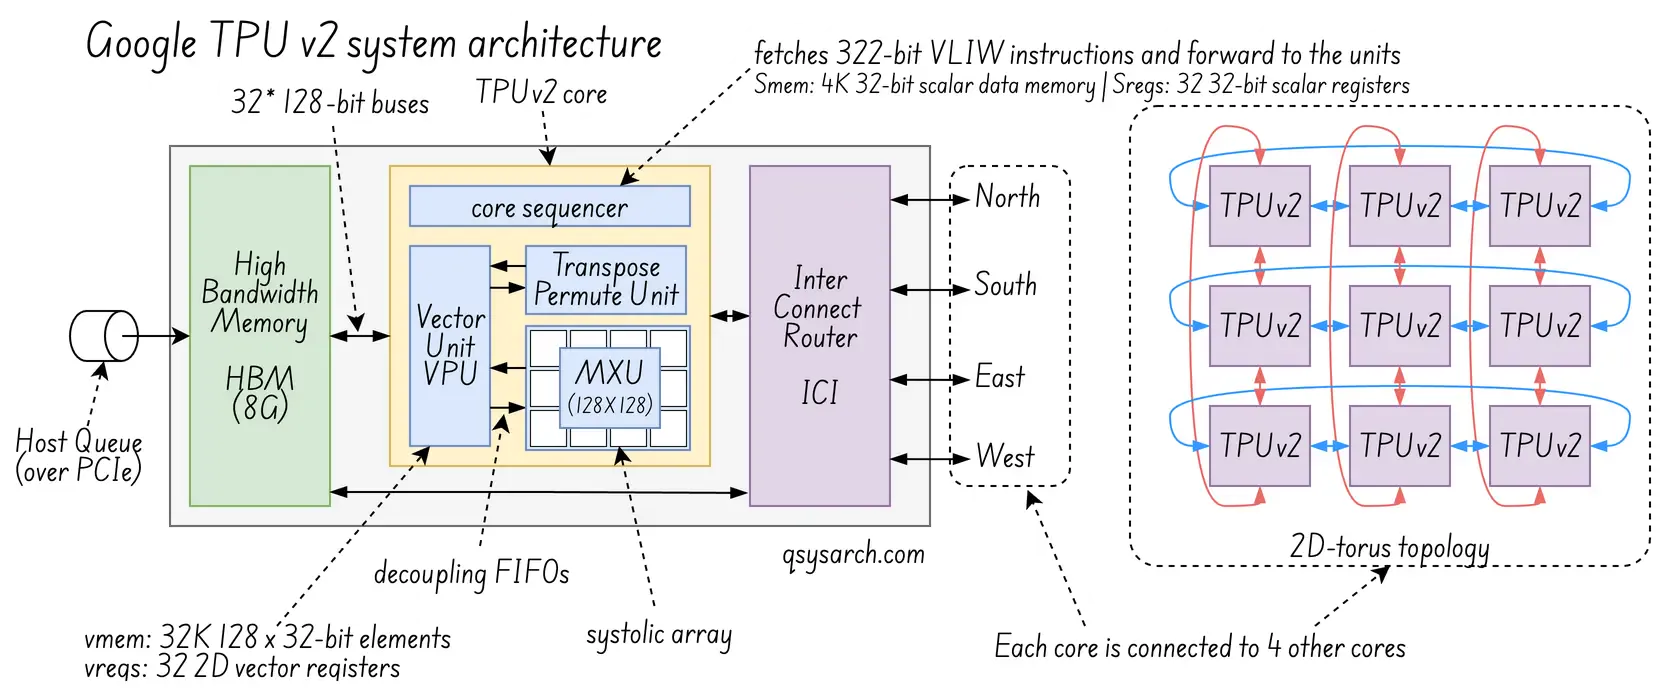
Din perspectiva SW, un compilator puternic:
- Compilator XLA: creierul care generează instrucțiunile VLIW utilizate de secvențiatorul principal (TCS).
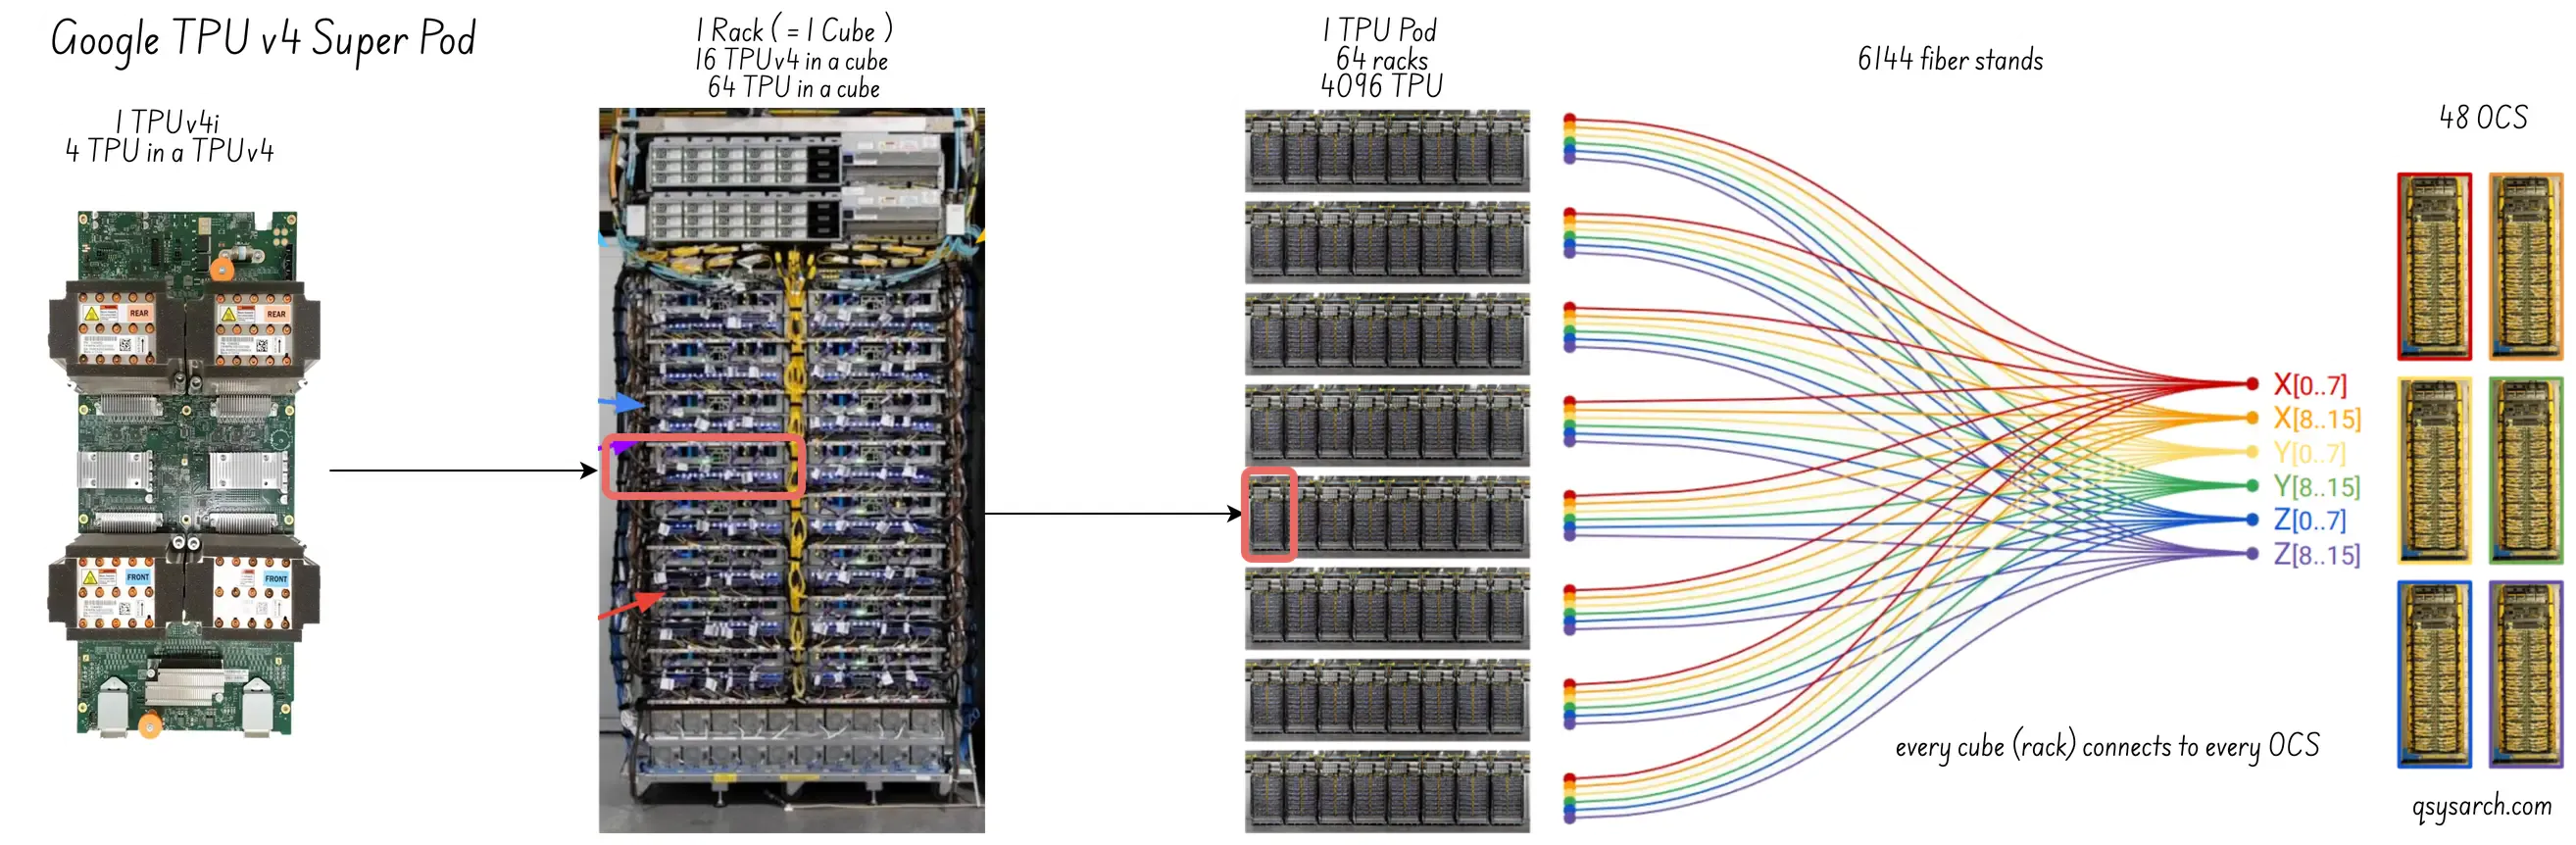
Conceptul cheie în versiunea v4 a fost capacitatea de a rula modele de inteligență artificială la hiperscală. Aceasta a însemnat că metrica principală a fost Costul Total de Proprietate (TCO).
Cele mai noi generații sunt concepute pentru antrenament la scară largă. Cipurile sunt conectate în rack-uri sau pod-uri, cu sisteme avansate de memorie și interconexiuni. Acestea suportă operații tensoriale mari, antrenament distribuit, sincronizare și partajare eficientă a datelor pe mai multe cipuri.
Din perspectiva procesării hardware de bază, au introdus câteva concepte interesante:
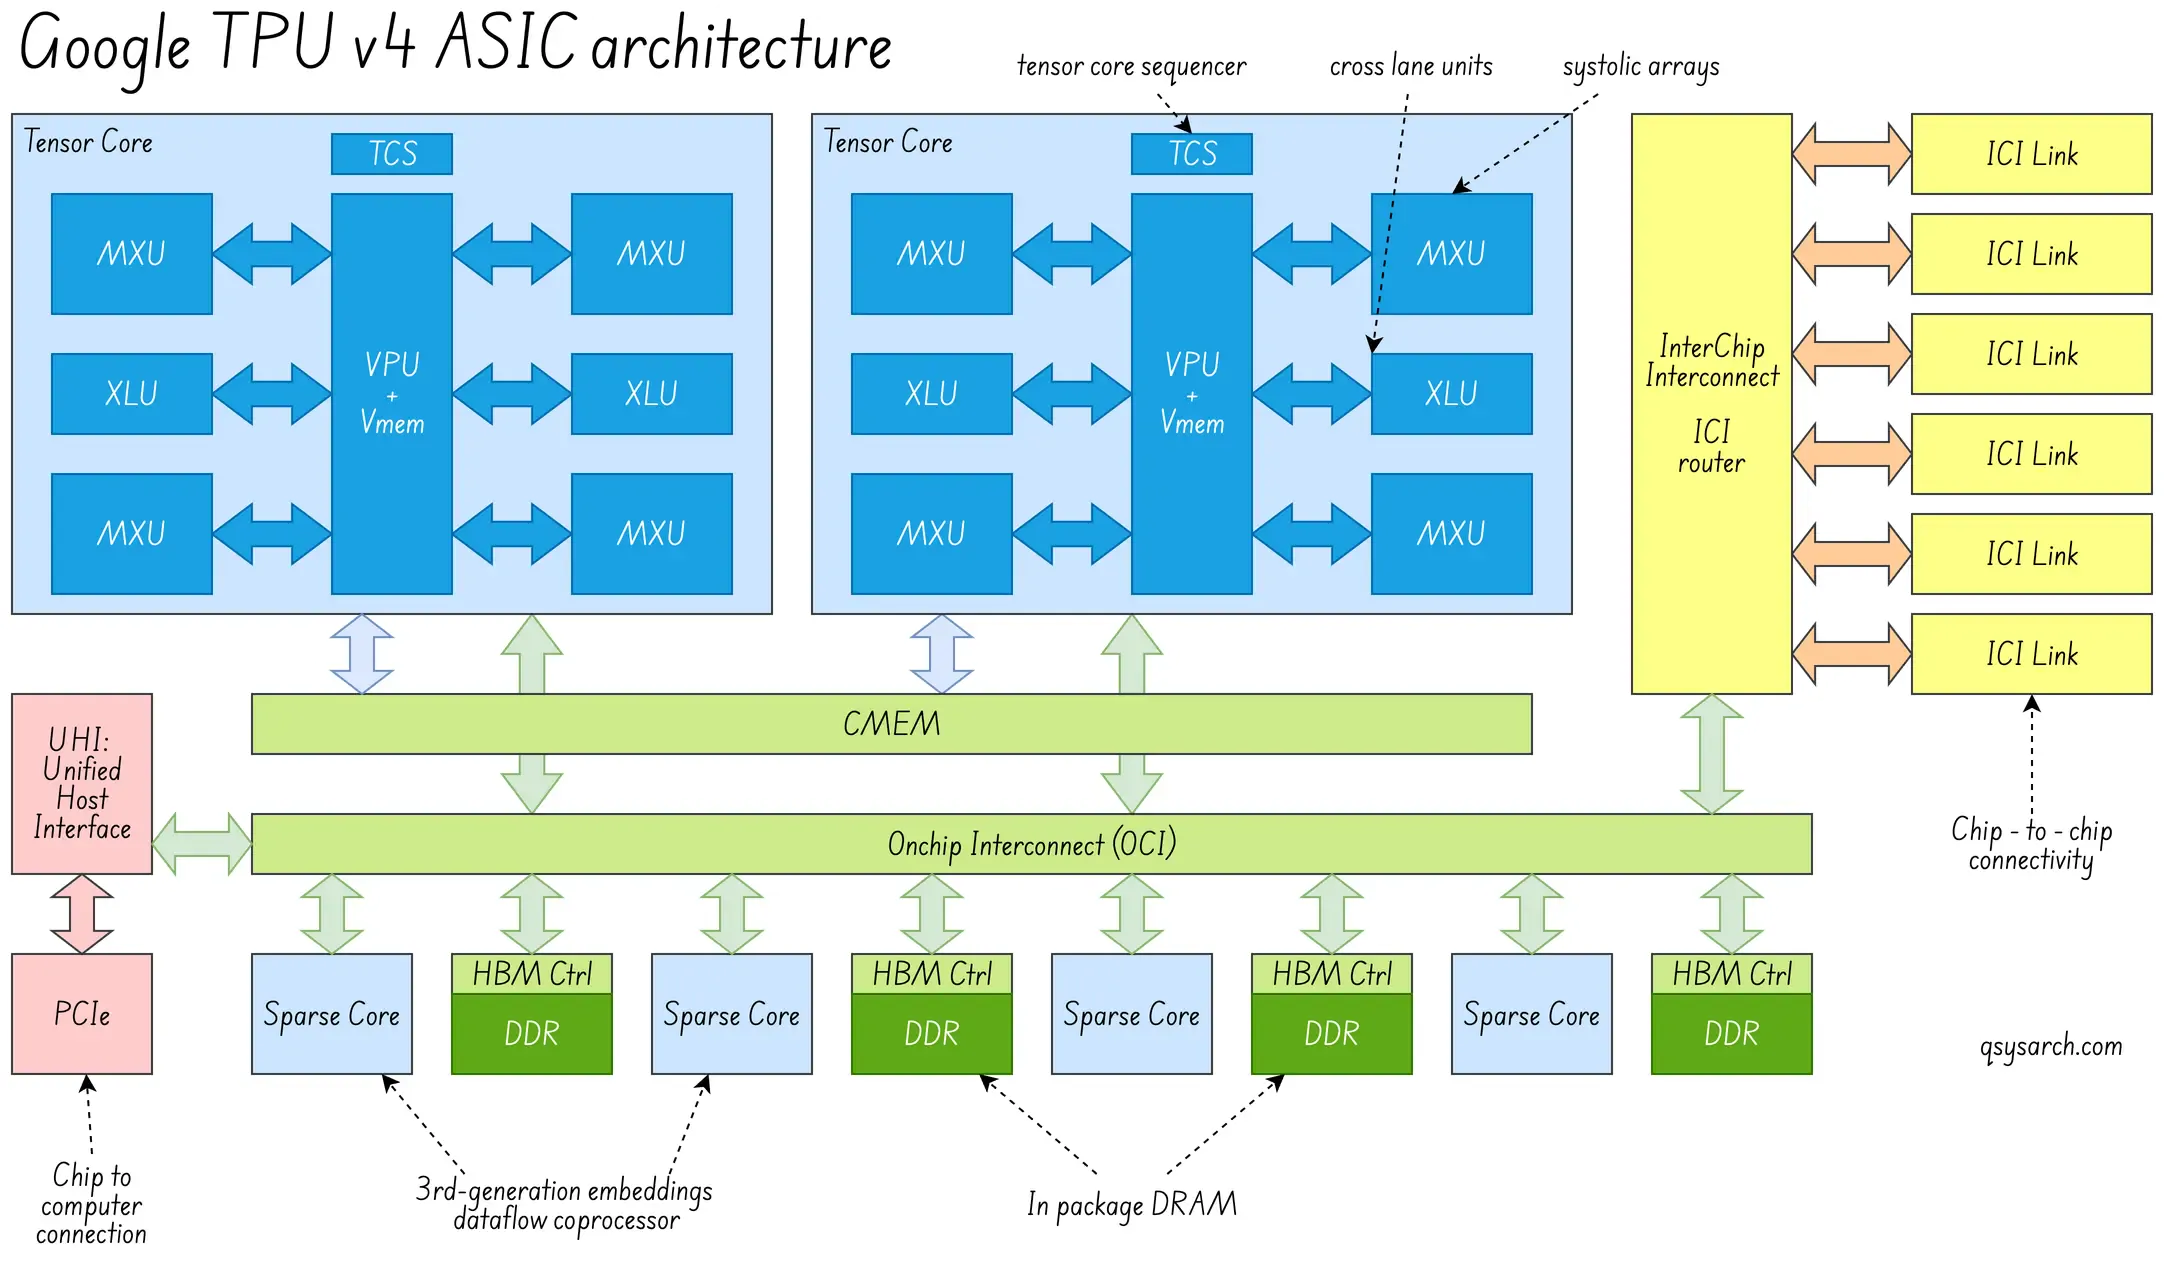
Din perspectiva conectivității hardware,
TPUv4, la fel ca TPUv2 și v3, utilizează în continuare un router de interconectare (ICI), implementat ca o legătură electrică de mare viteză între TPU-urile din același rack.
Totuși, TPUv4 primește o legătură optică suplimentară între rack-uri, numită comutare circuit optică sau OCS. Aceasta permite creșterea numărului de TPU-uri dintr-un pod la 4K (comparativ cu 64 într-un singur rack), precum și atenuarea defecțiunilor prin reconfigurarea rutării OCS.
În cele din urmă, dar cel mai puțin important, rutarea devine acum tridimensională, prin implementarea unui tor 3D, care are avantajul deloc neglijabil de a scala eficiența comunicării mult mai bine decât torul 2D.
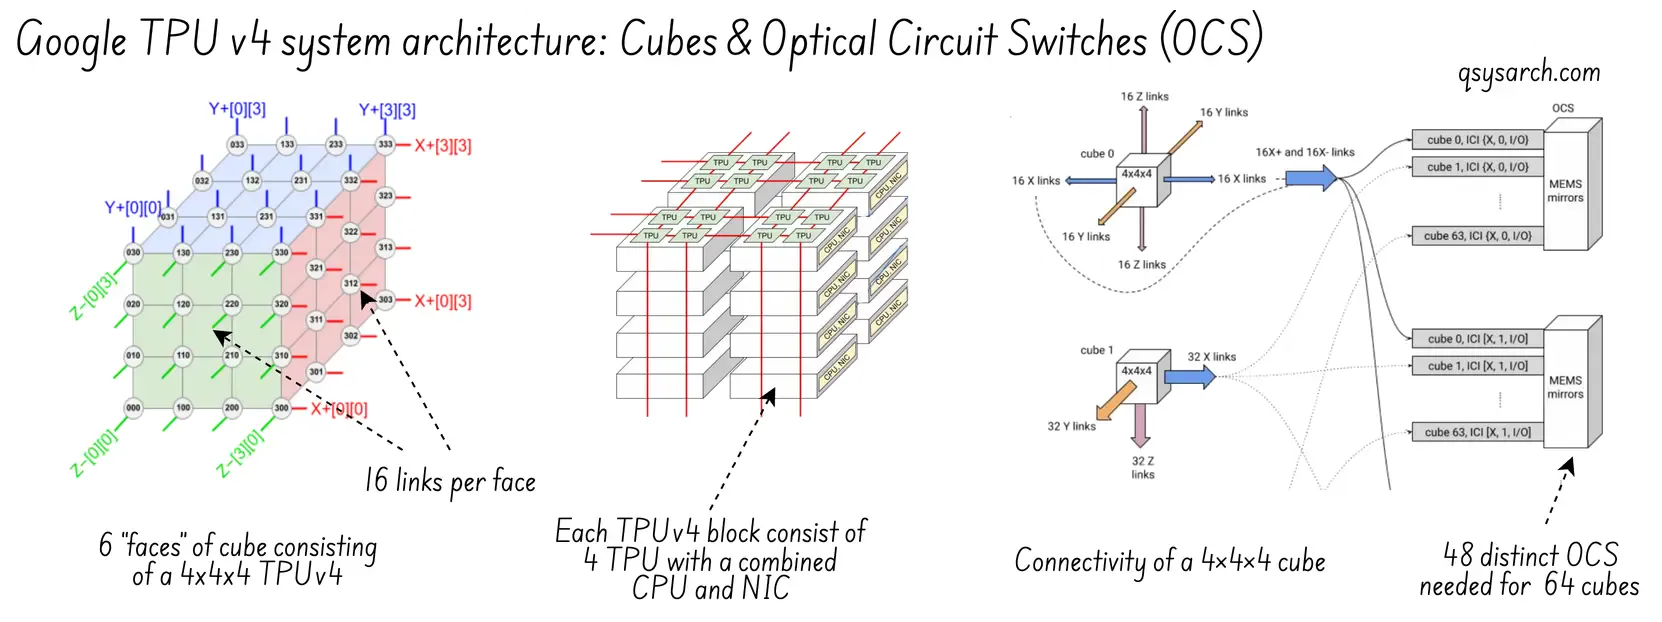
Din perspectiva SW:
Introducerea de noi instrumente: Borg ca manager de cluster; manager de pod-uri pentru configurarea OCS; și Libpunet pentru configurarea tabelelor de rutare ICI și gestionarea toleranței la erori.
Compilator avansat de date multiple pentru un singur program (SPMD): Acesta poate fi văzut ca un compilator care generează mai multe fire de execuție, unde fiecare fir de execuție este un program care rulează pe un TPU diferit, în același rack sau nu. Este oarecum similar cu conceptul SIMT al GPU-ului, unde compilatorul generează cod pentru fire de execuție dintr-o deformare GPU.
Întrucât multe TPU-uri rulează același program, orchestratorul Borg trebuie să se asigure că toate TPU-urile sunt conexe - acesta este rolul Gang Scheduler.
- Explicați conceptul de „căi”, necesar pentru gestionarea fluxului de date asincron pentru Ministerul Educației.
SparseCore (cunoscut și sub numele de SC) din TPUv4 este responsabil pentru accelerarea sarcinilor de lucru cu matrice dispersă, unde majoritatea valorilor sunt zero sau redundante (așa cum este cazul elementelor integrate găsite în LLM). Este descris ca un optimizator de „căutare a elementelor integrate”, iar fiecare TPUv4 include patru procesoare SparseCore.
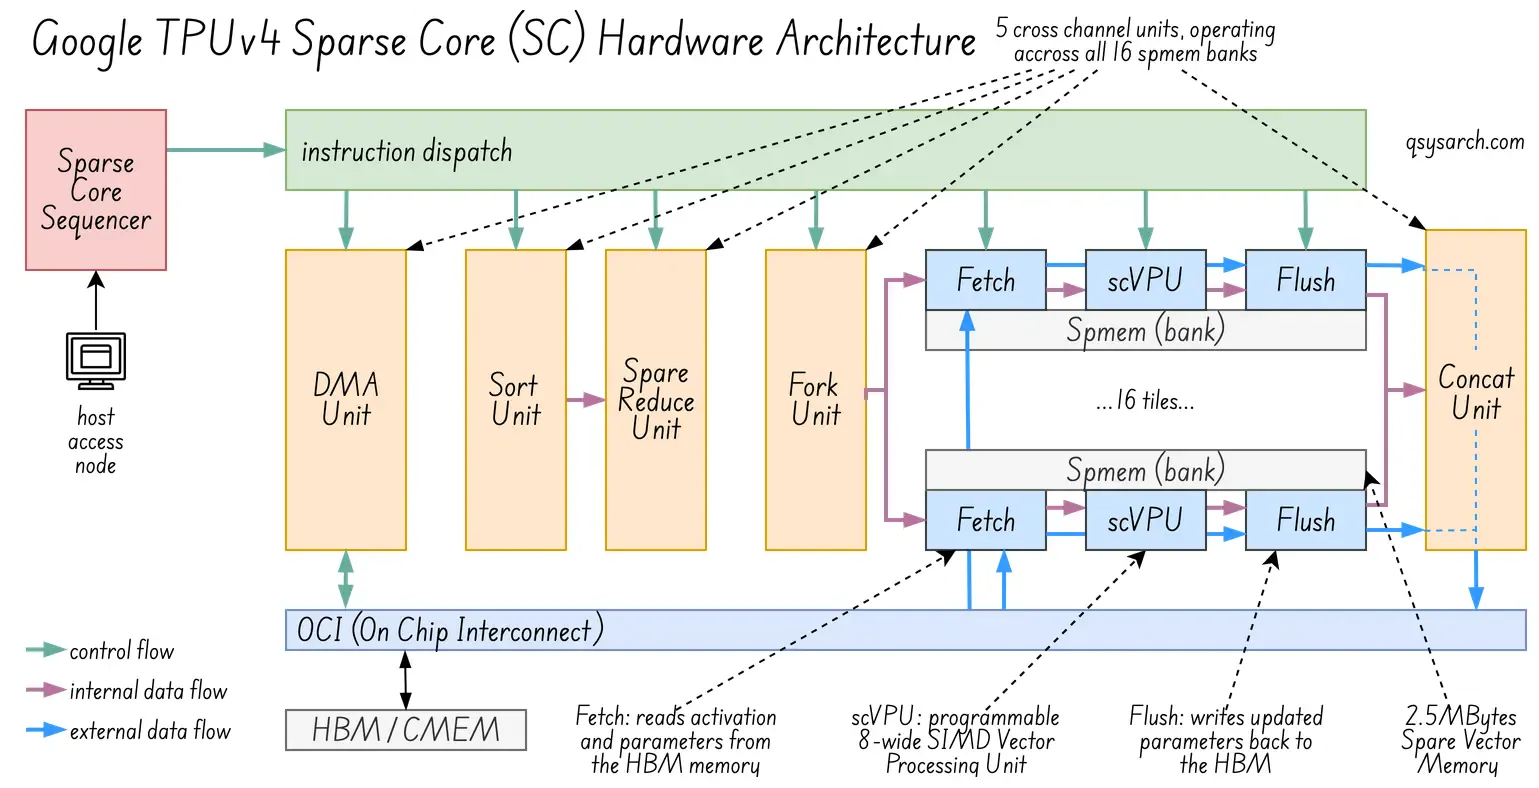 (imagine adaptată din sursă imagine)
Secvențatorul SparseCore (în roșu în colțul din stânga sus) este orchestratorul responsabil pentru trimiterea instrucțiunilor către cele 5 unități cross-channel (în portocaliu), precum și către cele 3 unități SIMD „fetch/process/flush” (în albastru). Fiecare unitate SIMD funcționează pe propriul scratchpad de memorie strâns cuplată de 2,5 MB (în gri).
Având în vedere că fiecare unitate SIMD de tip „fetch/process/flush” operează 8 benzi de date simultan (SIMD=8) și că există 16 astfel de unități SIMD într-un procesor Sparse Core, acest lucru îl face o unitate de procesare foarte puternică, aproape ca un GPU minuscul în interiorul GPU-ului! Sau, mai precis, 4 GPU-uri minuscule în interiorul unui TPU!
Ar fi foarte frumos să arunc o privire la ISA-ul folosit pentru a programa această unitate de procesare SparseCore puternică, dar nu am găsit nicio informație online. Probabil pentru că este mai degrabă ca un „computer DMA compatibil SIMD ALU sincron” puternic, cu instrucțiuni atât de specifice încât are sens doar să ofere o abstractizare de nivel superior, cum ar fi biblioteca JAX.
În practică, utilizatorul scrie codul funcțional la nivel înalt, iar compilatorul XLA (Accelerated Linear Algebra) identifică modele care corespund capacităților hardware ale SparseCore.
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
@nn.compact
def __call__(self, indices):
embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
Ce se întâmplă în ascuns? Metoda model.apply apelează compilatorul XLA, care reduce codul la SparseCore. Pentru aceasta, aceasta potrivește nn.Embed (o operație gather) și generează următoarele „pseudo-instrucțiuni”:
Deduplicare: XLA observă că numerele 42 și 105 apar de două ori în datele de intrare. Generează instrucțiuni SparseCore pentru a le deduplica înainte de preluare.
DMA: Generează instrucțiunile SC-scalare pentru a calcula offset-urile de memorie pentru ID-urile 105, 42 și 28.
Push: Mută tensorul 5*128 rezultat înapoi în memoria comună (CMEM).
Compilatorul XLA trebuie să aibă grijă și de plasarea datelor. În special, deoarece Sparse Core va trebui să acceseze indicii nn.Embed, acești indici trebuie plasați într-o memorie accesibilă de către nucleul sparse. Ar putea fi plasată în CMEM, dar aceasta este destul de mică (128 MB), așa că de obicei plasează embeddeding-ul în HBM mare (32 GB pentru TPUv4). Rezultatul procesării Sparse Core este însă plasat înapoi în CMEM, deși este doar o porțiune de date.
De asemenea, merită observat că arhitectura SparseCore a evoluat în următoarele generații v6+.
Amestec de experți și căi de dezvoltare ale Ministerului Educației
Link to heading
Amestecul de experți (MoE), spre deosebire de metodele convenționale …
Conceptul pathways se referă la rutele fizice și logice pe care le parcurg token-urile pe măsură ce sunt împărțite între experți care locuiesc pe diferite cipuri TPU.
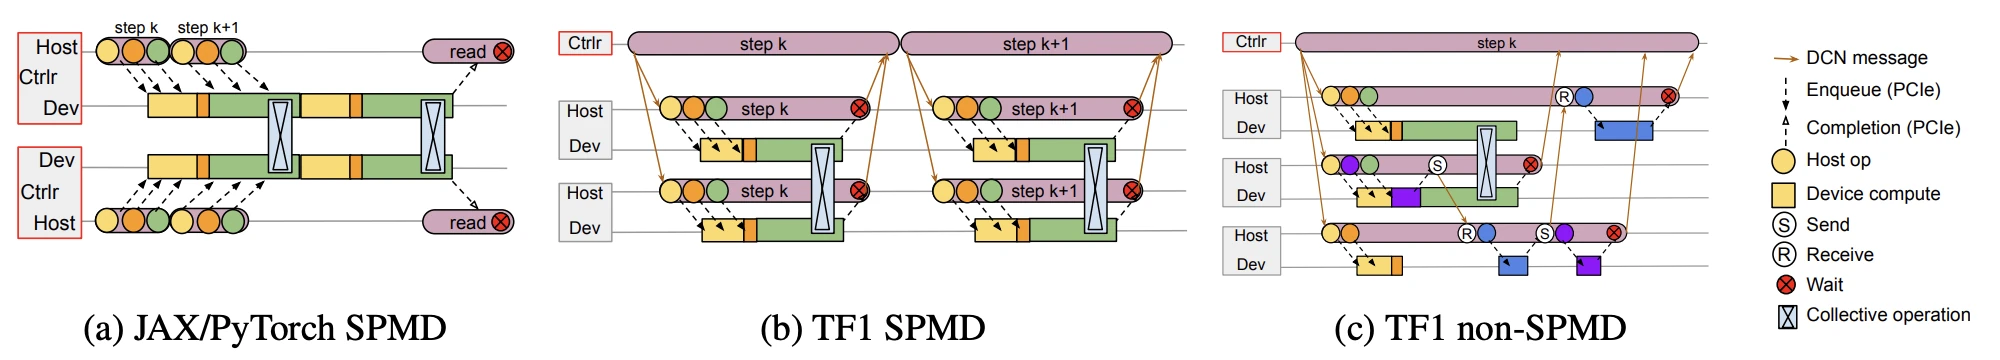 (sursa imaginii)
Din 2023 încoace: v5, v6 (Trillum) și v7 (Ironwood)
Link to heading
Nu există prea multe informații disponibile despre generațiile mai noi, așa că acestea sunt farurile mari:
v6: 32 GiB HBM3e per cip; Performanță îmbunătățită a BF16
- v7: 192 GiB HBM3e; Nouă precizie FP8
Cu Ironwood v7, un super pod este alcătuit din ~9K TPU-uri.
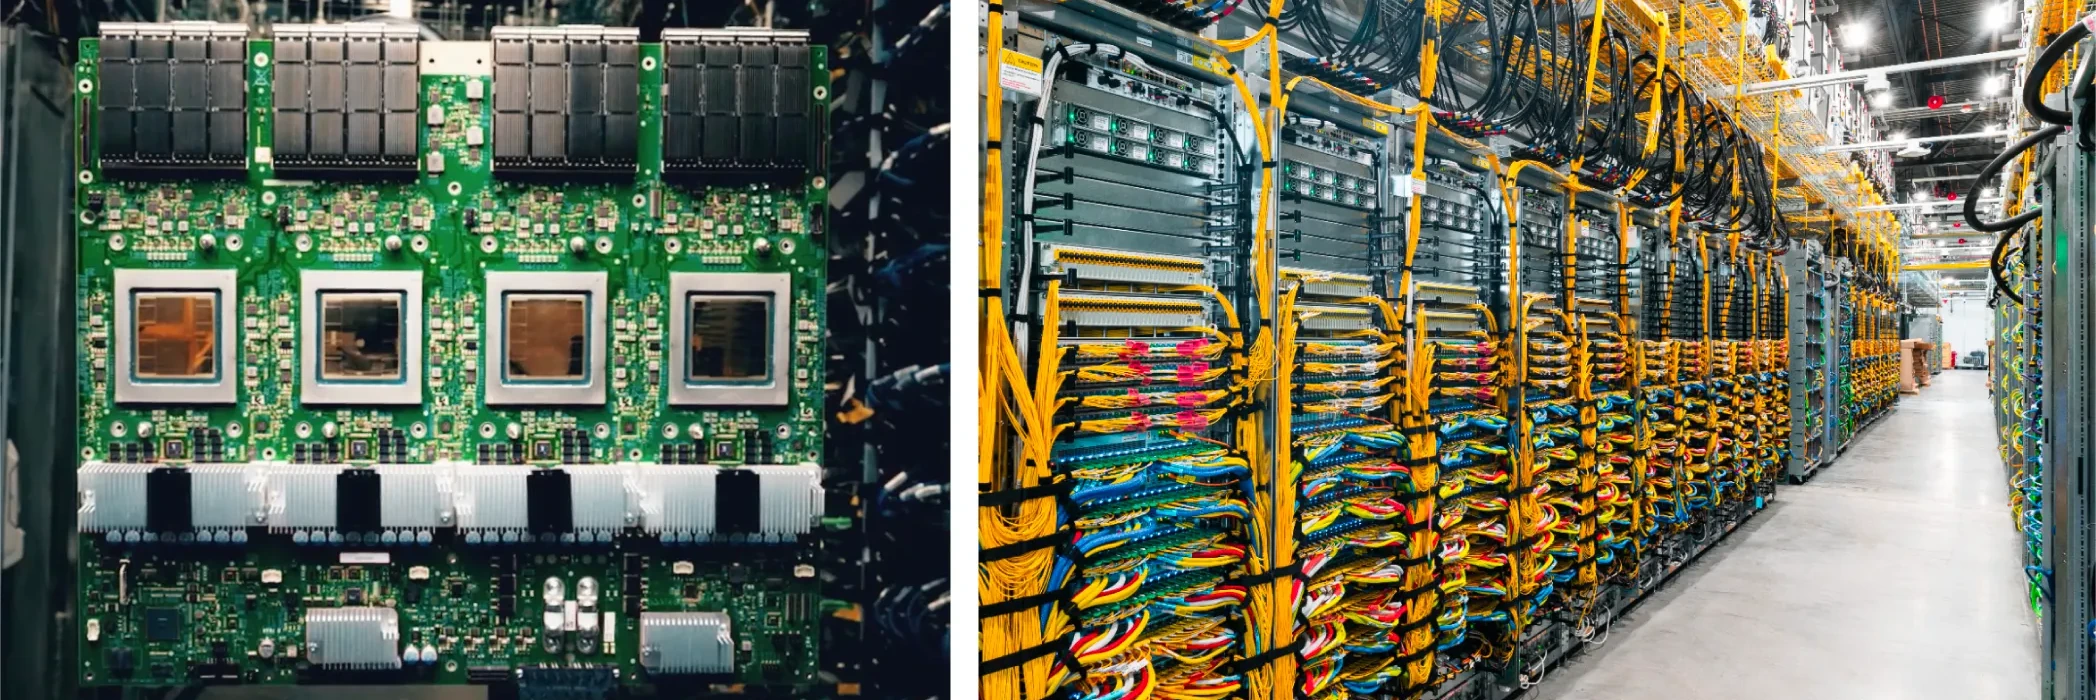
Deci, de ce mai avem nevoie de GPU-uri dacă avem TPU-uri
Link to heading
Designul TPU, care echilibrează memoria, puterea de calcul, consumul de energie și comunicarea datelor, arată că construirea de sisteme de inteligență artificială de înaltă performanță la scară largă nu înseamnă doar cipuri rapide. De asemenea, necesită coordonarea dintre hardware, software, sisteme și conexiuni de rețea.
Procesarea pixelilor vs. procesarea matricelor
Link to heading
Chiar dacă sarcinile de lucru bazate pe inteligența artificială sunt mai variate în zilele noastre, acoperind inferențe, antrenament, modele disperse și sisteme de recomandare, unitățile de procesare a pixelilor (TPU) nu sunt concepute pentru a procesa pixeli. GPU-urile, însă, nu sunt populare astăzi, deoarece Nvidia a expus un model programatic și o experiență de dezvoltare care au permis GPU-urilor să se comporte ca un TPU.
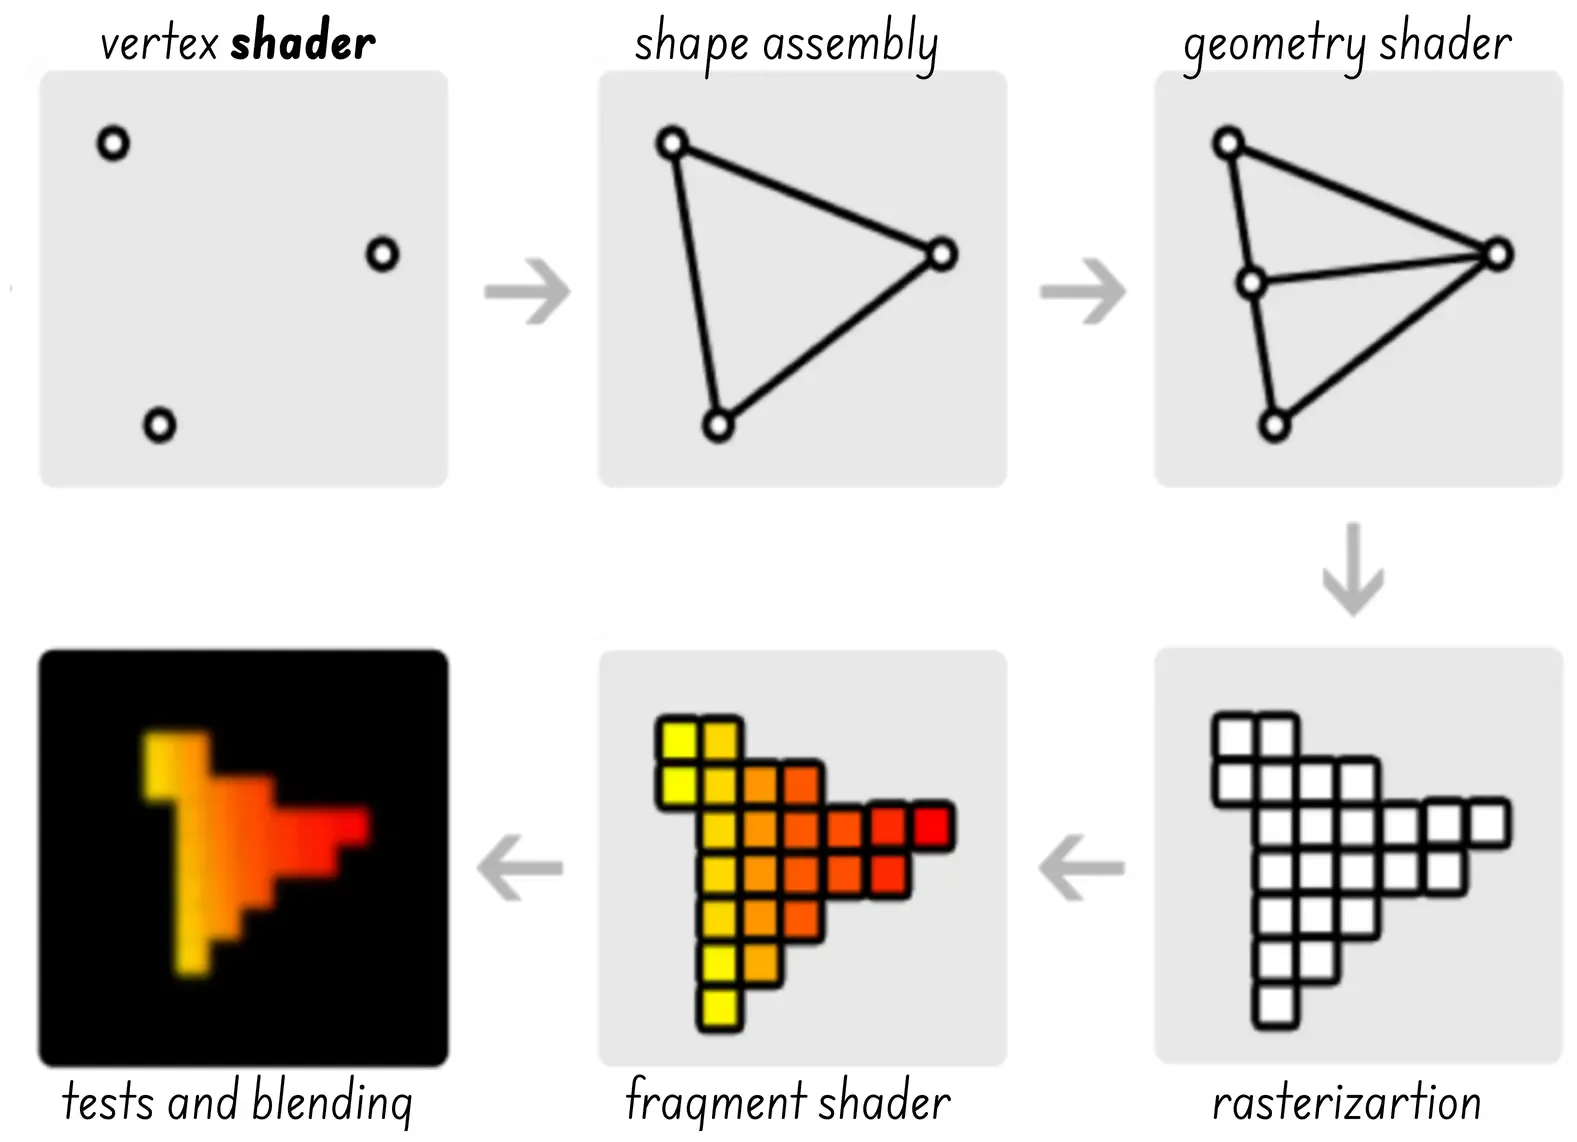
Înseamnă asta că GPU-urile sunt superioare? Nu neapărat - având în vedere sarcini de lucru foarte specifice, unitățile de procesare a energiei (TPU) pot fi mai eficiente decât GPU-urile, în special în ceea ce privește consumul de energie și performanța per watt. Și în lumea în care trăim, unde centrele de date bazate pe inteligență artificială consumă din ce în ce mai multă energie, TPU-urile ar putea face toată diferența.
Dar circuitele integrate neuromorfice analogice?
Link to heading
Și cum rămâne cu IC-urile neuromorfice? Comparativ cu TPU, acestea vizează un consum de energie și mai mic prin utilizarea calculului analogic și a procesării bazate pe evenimente la frecvență mai mică. Ce va fi necesar pentru ca IC-urile neuromorfice să devină mainstream și să atingă aceeași scară ca super-capsulele TPUv7?
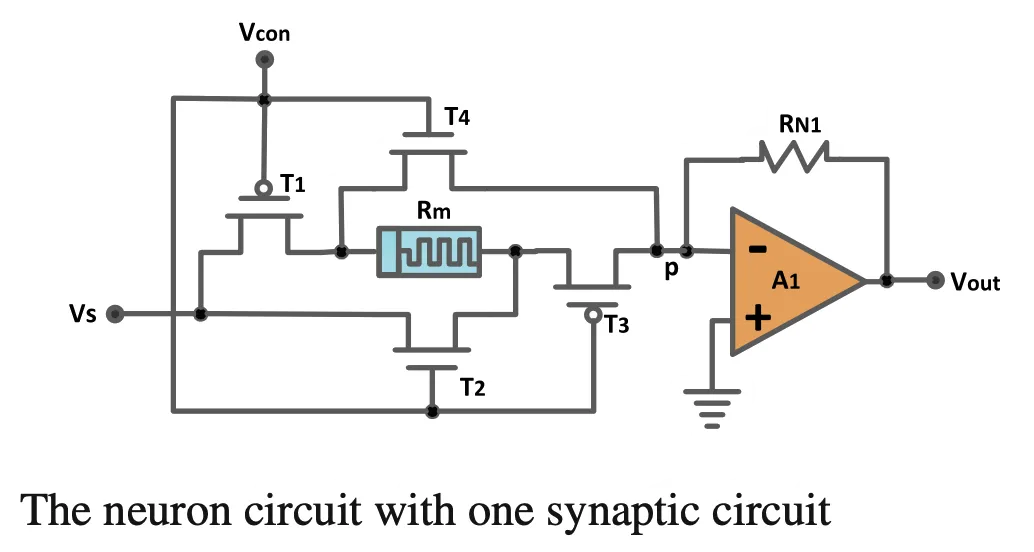
Una dintre provocările pe care le mai am este să înțeleg mai bine consumul relativ de energie al rețelei sistolice (MXU + Spares Core) față de restul TPU (inclusiv ICI, OCI, TCS) și cum se compară acest raport cu rețeaua neuronală neuromorfică Spiking (SNN) față de logica de control (copro RiscV și Spike).
De asemenea, dacă circuitele integrate neuromorfice ar atinge scara TPUv7, ar fi probabil necesar un nivel similar de investiții în software, sisteme și conexiuni de rețea. Dacă nu, s-ar putea lua în considerare conectarea unei rețele SNN la un TPU și utilizarea „logicii de control” a TPU pentru a gestiona comunicarea dintre SNN și restul TPU/Rack/Pad. Dar este nevoie de acest lucru? Ce problemă rezolvăm? Poate că ar trebui să gândim diferit.
Înapoi în viitor: Unitatea de Procesare a Limbii
Link to heading
Această notă nu ar fi completă fără a menționa [Unitatea de Procesare a Limbii] (https://arxiv.org/pdf/2408.07326v1), un nou tip de procesor conceput pentru a optimiza inferența modelelor lingvistice mari.
Va trebui să creez o notă dedicată acestui subiect, așa că, deocamdată, aceasta este doar o comparație la nivel înalt, încercând să înțeleg dacă LPU este mai mult decât o reinventare a TPUv1, care se concentra doar pe inferență și nu pe antrenament.
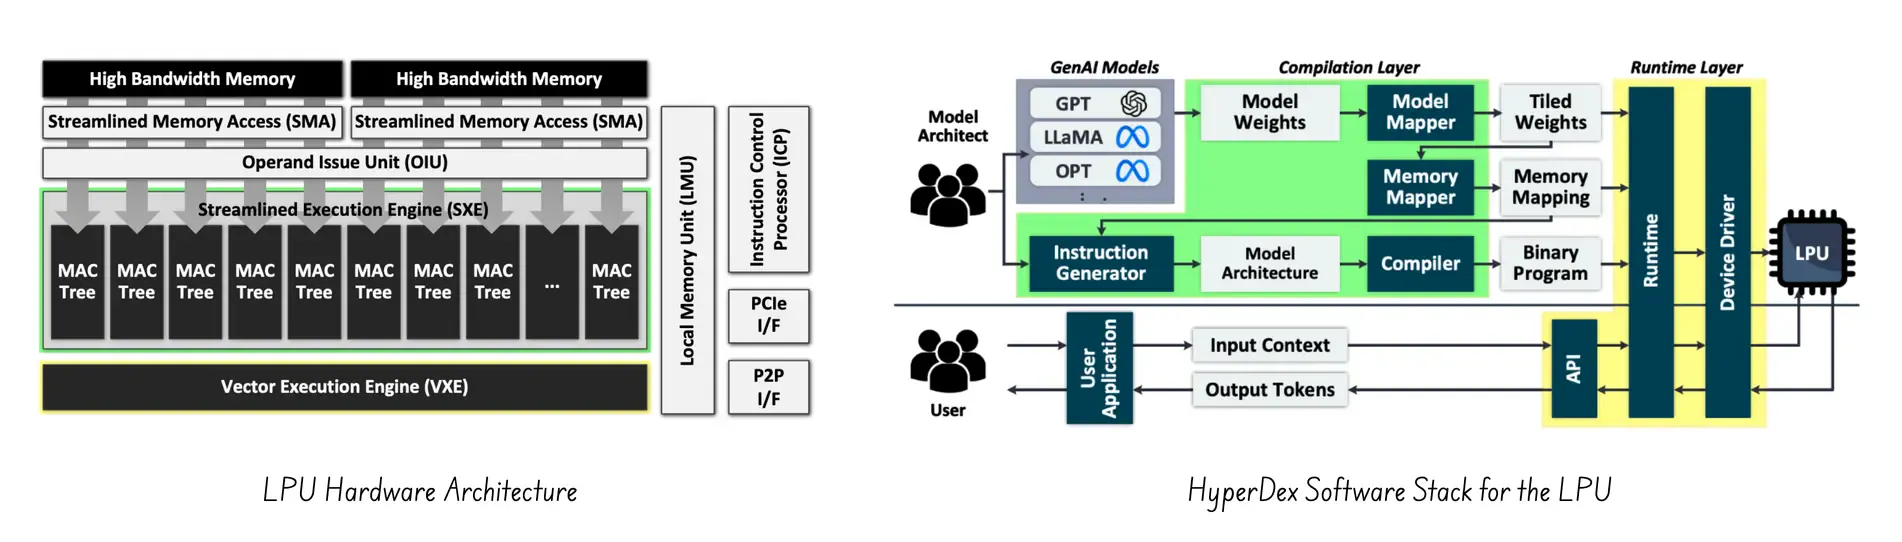
La nivel general, da, TPU și LPU au în comun nevoia de a face câteva lucruri foarte eficient și la scară largă, folosind o arhitectură specifică domeniului (DSAs). Dar când vine vorba de implementare și optimizare specifică, LPU este o cu totul altă fiară, cu un obiectiv diferit.
Principala diferență este că TPUv1 a fost conceput înainte ca LLM să existe (amintiți-vă, lansarea inițială a ChatGPT a fost în 2022) și s-a concentrat pe inferența generală a rețelelor neuronale profunde (DNN). Aceasta însemna asigurarea debitului și a performanței per watt pentru operațiuni masive, de volum mare, implementate de o matrice sistolică MXU subiacentă.
Pe de altă parte, LPU este conceput pentru a optimiza inferența modelelor lingvistice mari (LLM). Accentul lor este pus pe îmbunătățirea latenței per token. Și pentru asta, au nevoie de un ISA care să suporte o arhitectură multi-pipeline complet deterministă, planificată static, bazată pe VLIW. Desigur, s-ar putea argumenta că TPUv4 introduce un ISA VLIW similar pentru TCS. Dar principala diferență este că LPU ISA este o mașină VLIW complet deterministă, unde fiecare încărcare, calcul și stocare este planificată ciclu cu ciclu. În timp ce pentru TPU, MXU este o matrice sistolică „auto-drivenă”.
Voilà, acesta este un scurt memoriu care, încă o dată, a durat mai mult decât se aștepta. Ceea ce reiese clar din această analiză detaliată este că evoluția arhitecturii TPU arată că proiectarea acceleratoarelor de inteligență artificială este o sarcină complexă care necesită echilibrarea mai multor factori.
Designul TPU, care echilibrează memoria, puterea de calcul, consumul de energie și comunicarea datelor, arată că construirea de sisteme de inteligență artificială de înaltă performanță la scară largă nu înseamnă doar cipuri rapide. De asemenea, necesită coordonarea dintre hardware, software, sisteme și conexiuni de rețea.
Este un fel de sentiment de déjà vu. Ar putea fi Unitatea de Procesare Cuantică (QPU) următorul pas în evoluția acceleratoarelor de inteligență artificială?
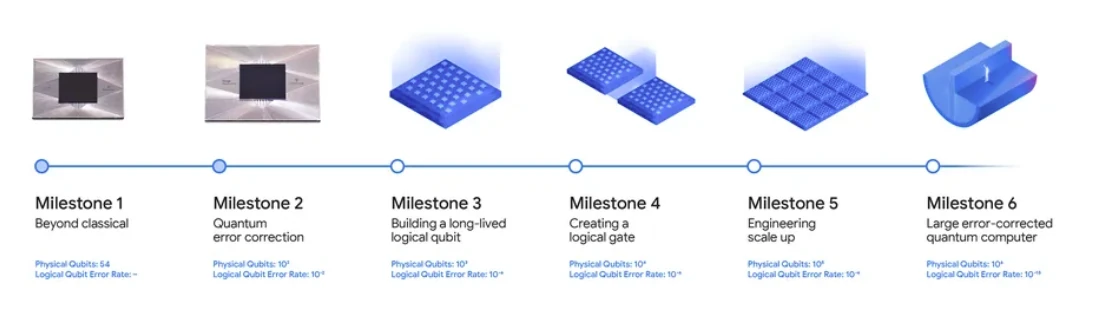 (sursa imaginii: Google Willow)
Diagrame DrawIO utilizate în acest memo: