
Există numeroase cuvinte la modă asociate cu RDMA în contextul GPU-urilor: GPU-direct, NvLink, NVLink Fusion, InfiniBand, Quantum InfiniBand, GPUNetIO și DOCA. Acest lucru este confuz, dar poate că nu trebuie să fie așa?
Acest articol este scris sub forma unei note personale, încercând să articuleze diversele tehnologii și să le vizualizeze cu ajutorul câtorva diagrame.
GPU Direct și RDMA: Marketing vs. Tehnologie.
Link to heading
Să începem in-medias-res cu pagina confuză GPUNetIO din documentația oficială Nvidia:
Rețineți că acronimul RDMA descrie protocolul care permite accesul direct la distanță la memoria unui computer în memoria altuia, fără a implica sistemul de operare al niciunuia dintre ele. … Nu trebuie confundat cu GPUDirect RDMA, care nu este legat de protocolul RDMA.
Clar, deci GPUDirect RDMA nu este același lucru cu protocolul RDMA! Dar, oare GPUDirect RDMA folosește cel puțin protocolul RDMA? Sper că da; altfel, ar fi foarte confuz.
GPUDirect RDMA este una dintre tehnologiile activate de NVIDIA în familia de tehnologii GPUDirect. Aceasta permite plăcii de rețea să trimită sau să primească date accesând direct memoria GPU, ocolind copiile memoriei CPU și rutinele sistemului de operare. GPUDirect RDMA poate fi activat de orice framework de rețea care funcționează cu Ethernet, InfiniBand sau RoCE.
Bine, cel puțin este clar: GPUDirect RDMA poate fi implementat pe orice nivel de transport, fie că este Ethernet (ETH) sau InfiniBand (IB). Dar, așadar, ce este GPUNetIO și cum se leagă de RDMA? Ei bine, răspunsul este simplu. GPUNetIO este, așa cum indică și numele, o implementare bazată pe rețea a GPU Direct RDMA pe o placă de rețea. Asta nu înseamnă că GPU Direct trebuie să fie controlat de o placă de rețea, ci doar că GPUNetIO este o versiune specializată pentru tipul de placă de rețea.
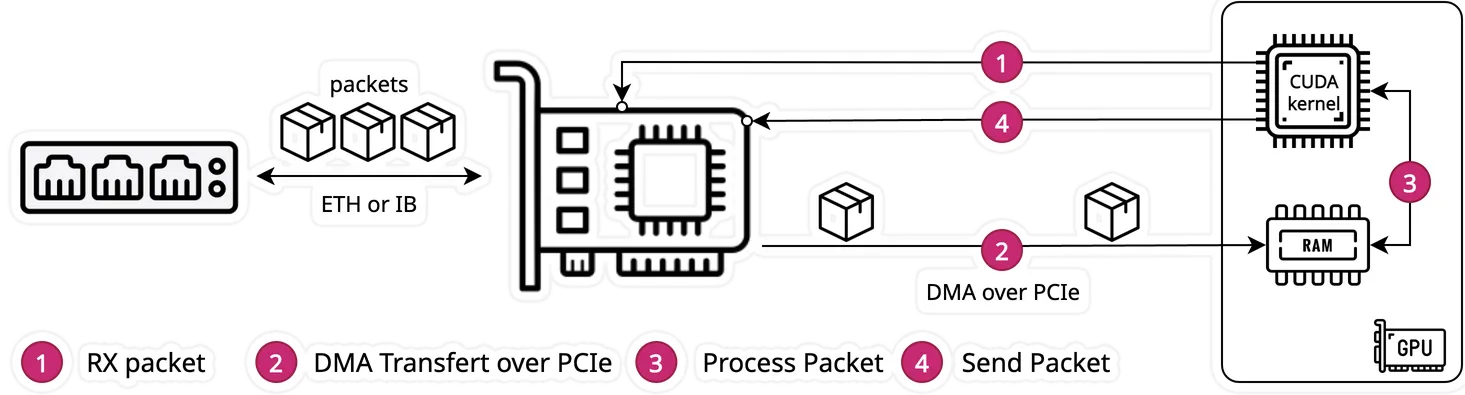
În diagrama de mai sus din [documentația] GPUNetIO (https://docs.nvidia.com/doca/sdk/doca+gpunetio/index.html), caseta „CUDA” este puțin confuză. Presupun că este vorba de un kernel care rulează pe GPU, dar haideți să vedem ce spune documentația:
Abordările tradiționale se bazează adesea pe un model centrat pe procesor, în care procesorul se coordonează cu placa de rețea pentru a primi pachete în memoria GPU folosind GPUDirect RDMA. Ulterior, procesorul notifică un kernel CUDA de pe GPU pentru a procesa pachetele. …. DOCA GPUNetIO abordează această provocare oferind o soluție centrată pe GPU care elimină procesorul din calea critică.
Pentru mine, acest lucru nu este încă complet clar - se menționează „GPU-centrat” pentru calea critică, dar care este calea critică? Sunt aceștia pașii (1) până la (4) menționați în diagramă? Și pentru ce mai este necesar procesorul? Pentru a găsi răspunsul, trebuie să ne uităm la modul „Async Kernel-Initiated”, care este descris ca fiind posibilitatea ca „un kernel GPU CUDA să controleze comunicațiile de rețea pentru a trimite sau primi date”. GPUDirect IKA permite:
GPU poate controla comunicațiile Ethernet (Ethernet/IP/UDP/TCP/ICMP)
GPU poate controla comunicațiile RDMA (InfiniBand sau RoCE sunt acceptate)
Intervenția procesorului nu este necesară în calea critică a aplicației
Deci, este 100% clar:
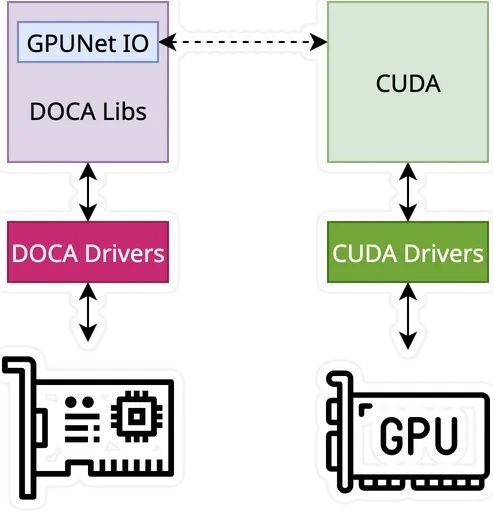
GPU Direct RDMA „permite transferuri directe de date către/din memoria GPU fără copii de stocare a procesorului”.
GPU Direct AKI oferă posibilitatea GPU-ului de a „controla” placa de rețea.
GPUNetIO este o componentă software care gestionează atât tehnologiile GPU Direct RDMA, cât și cele AKI.
DOCA este SDK-ul furnizat de Nvidia pentru programarea hardware-ului compatibil cu GPUNetIO (printre altele).
Presupun că confuzia apare din faptul că „AKI” ar trebui menționat ca „GPU Direct RDMA + AKI”, deoarece completează capacitatea RDMA ce permite ocolirea procesorului.
Înțelegem acum că GPU Direct RDMA, așa cum este comercializat de Nvidia sub umbrela GPUNetIO, este o soluție bazată pe o placă de rețea (NIC), care conectează GPU-ul la NIC printr-o conexiune PCIe. Să analizăm în detaliu această conexiune PCIe, să rezumăm partea GPUNetIO și să ne concentrăm din nou pe partea RDMA:
În documentația oficială CUDA GPUDirect RDMA (https://docs.nvidia.com/cuda/gpudirect-rdma/index.html), se spune că singura cerință este un complex rădăcină PCIe:
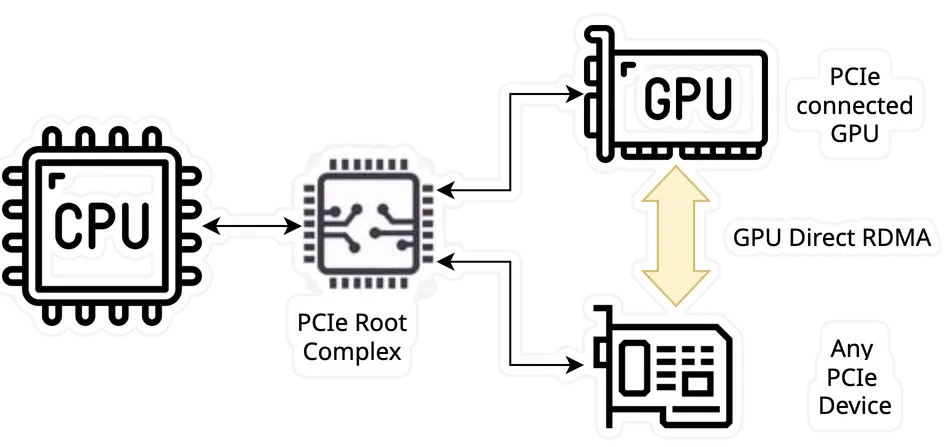
GPUDirect RDMA este o tehnologie introdusă în GPU-urile din clasa Kepler și CUDA 5.0, care permite o cale directă pentru schimbul de date între GPU și un dispozitiv terț peer, utilizând caracteristicile standard ale PCI Express. …. Se pot aplica o serie de limitări, cea mai importantă fiind că cele două dispozitive trebuie să partajeze același complex rădăcină PCI Express în amonte.
GPUDirect RDMA este o soluție care permite oricărui dispozitiv PCIe să comunice direct cu GPU-ul, cu condiția să se afle sub același complex rădăcină. Așadar, deși este „comercializat și vândut” în principal de Nvidia ca o soluție în care dispozitivul PCIe este o placă de rețea, ar putea fi orice placă PCIe, de exemplu, o placă PCIe pentru o cameră de mare viteză. Este interesant, dar haideți să încercăm să înțelegem cum ar funcționa asta.
La configurarea comunicării GPUDirect RDMA între doi peer-i, toate adresele fizice sunt aceleași din punctul de vedere al dispozitivelor PCI Express. În acest spațiu de adrese fizice există ferestre liniare numite PCI BAR. Fiecare dispozitiv are cel mult șase registre BAR, deci poate avea până la șase regiuni BAR active pe 32 de biți. BAR-urile pe 64 de biți consumă două registre BAR. Dispozitivul PCI Express emite citiri și scrieri către adresele BAR ale unui dispozitiv peer în același mod în care acestea sunt emise către memoria sistemului.
În mod tradițional, resursele precum ferestrele BAR sunt mapate la spațiul de adrese al utilizatorului sau al kernelului folosind MMU-ul procesorului ca adrese I/O mapate în memorie (MMIO). Cu toate acestea, deoarece sistemele de operare actuale nu au suficiente mecanisme pentru schimbul de regiuni MMIO între drivere, driverul kernelului NVIDIA exportă funcții pentru a efectua traducerile și mapările de adrese necesare.
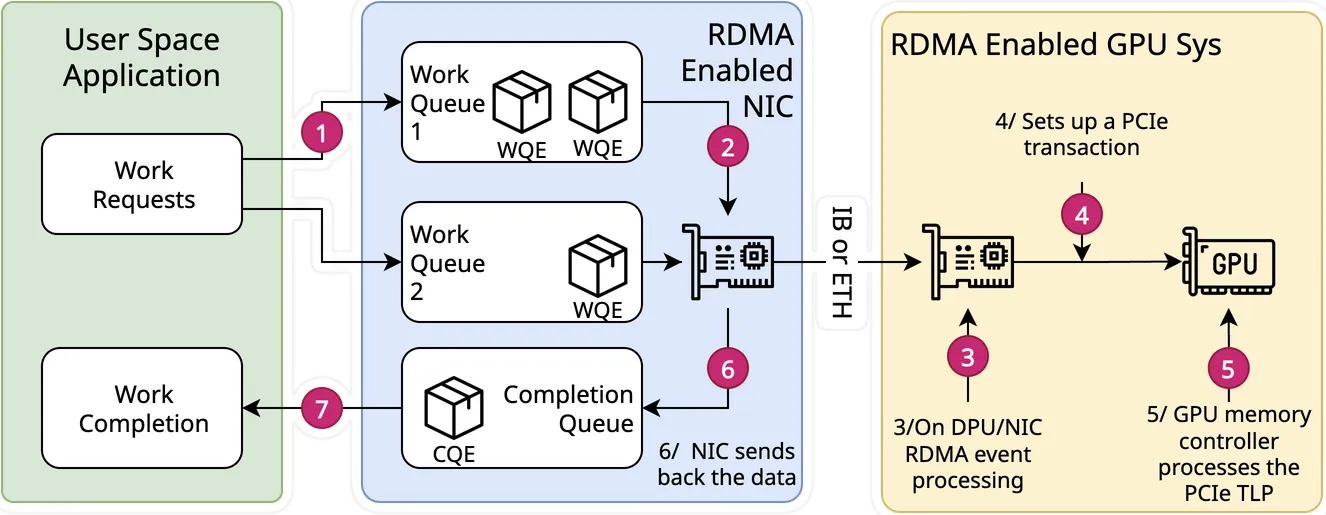
Ceea ce poate fi confuz aici este faptul că termenul „DMA” poate părea mai potrivit în comparație cu „RDMA” atunci când se ia în considerare un sistem intra-PCIe care conectează dispozitive eterogene. Dar acesta este și scopul. DMA este soluția pentru transferul de date, iar RDMA, mai presus de acesta, este protocolul folosit pentru a da semantică datelor transferate, folosind verbe. Așadar, DMA reprezintă de fapt doar pașii (4) și (5) în diagrama de mai jos, în timp ce protocolul RDMA din hardware-ul de pe partea de recepție reprezintă doar (3).
Un lucru de remarcat este că Nvidia precizează clar că nu este un lucru simplu, așa că, pentru a obține cea mai bună performanță, este probabil mai bine să folosiți un testbed cunoscut:
Chiar dacă singura cerință teoretică pentru ca GPUDirect RDMA să funcționeze între un dispozitiv terț și un GPU NVIDIA este ca acestea să aibă același complex rădăcină, există erori (în principal în chipset-uri) care determină performanța slabă sau chiar imposibilitatea funcționării în anumite configurații.
Există încă o confuzie evidentă în terminologie, în special între Ethernet, InfiniBand și RoCE: faptul că RoCE se bazează pe Ethernet.

Asociatul comercial InfiniBand descrie în termeni simpli ca o evoluție, reprezentată în diagrama de mai sus. Rețineți că am folosit în mod intenționat denumirea „100G + PFC” în loc de mențiunea originală „DCB” (cunoscută și sub numele de Data Center Bridging). Dacă am înțeles bine, DCB este un superset al PFC (cunoscut și sub numele de priority flow control), iar ideea este de a spune că pentru ca DCB/PFC să funcționeze, este nevoie de infrastructura de rețea, inclusiv comutatoarele, pentru a implementa aceste tehnologii. Altfel, te întorci la categoria Ethernet.
Această notă nu ar fi completă fără o referire la NVLink. Întrebarea imediată este dacă NVlink și InfiniBand sunt identice sau oarecum înrudite. Pe scurt, sunt complementare, nu concurente.

NVLink: Comunicare rapidă intra-nod (în cadrul unui server, între GPU-uri).
InfiniBand: Comunicare rapidă între noduri (între serverele dintr-un cluster)
În diagrama din dreapta, este clar că săgețile verzi sunt folosite pentru a interconecta GPU-urile între ele. În timp ce conexiunea dintre NIC-uri este InfiniBand.
Ceea ce este interesant de observat este că NVLink este intern hardware-ului Nvidia și nu este expus la exterior, spre deosebire de conectorii InfiniBand, așa cum se arată în diagrama de mai jos. Rețineți că Quantum InfiniBand X800 este o bestie puternică, cu legături de 800Gb/s, cu silicon photonics integrate, dar nu are nicio legătură cu calculul cuantic.
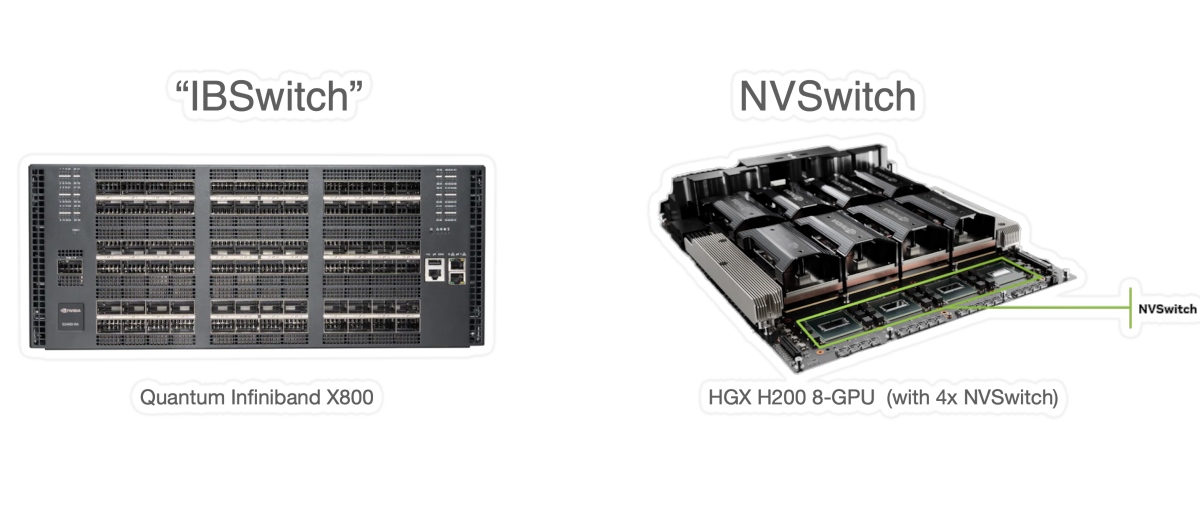
Un ultim punct demn de menționat: Nvidia a introdus NVlink fusion ca o modalitate de a deschide standardul NVLink. Așadar, mâine, probabil vom vedea o integrare personalizată, poate necesitând în continuare un PCB ca „comutator” (mai degrabă decât un cablu), dar cu SoC, care s-ar putea să nu fie un SoC Nvidia. De asemenea, merită menționat faptul că AMD a răspuns standardului Nvidia prin introducerea UALink.
Pe scurt, RDMA nu este chiar complex:
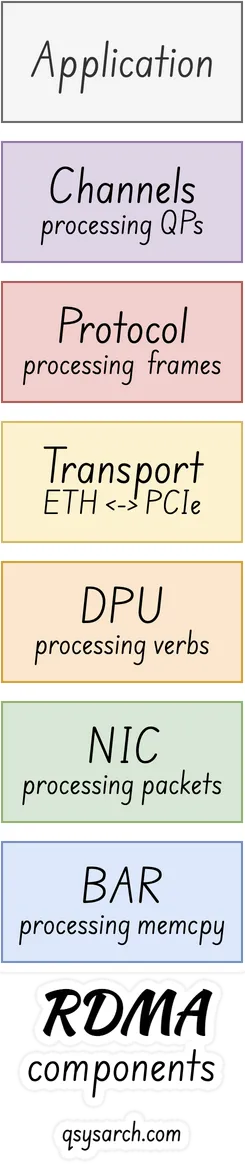
RDMA BAR: ca mapare PCIe BAR: La nivelul fizic, există un dispozitiv PCIe care se conectează la GPU prin același complex rădăcină PCIe și mapează bara de memorie a tuturor dispozitivelor.
Placă de rețea RDMA: ca placă de rețea hardware (NIC): Această placă PCIe este de obicei o placă de rețea - dar nu trebuie să fie așa. Cu toate acestea, se pare că există o singură placă de rețea pe piață cu capacitate RDMA.
RMDA DPU: ca procesor de verbe în hardware: Pentru ca placa PCIe să fie compatibilă cu RDMA, hardware-ul trebuie să poată procesa verbele RDMA direct în hardware, de obicei folosind un procesor numit DPU.
Transport RDMA: ca strat de transport pentru conexiunea de rețea: Dispozitivul PCIe este expus, pe partea de rețea, ca transport care poate fi Ethernet, mai bine Ethernet (RoCev2) și Infiniband.
Protocolul RDMA: ca format de cadru: Protocolul utilizat pentru comunicarea prin legătura de rețea se numește tot RDMA - nu m-am uitat la detaliile formatului de cadru, dar este în RFC5040
Canale RDMA: ca modalitate de comunicare prin QP: SW-ul / driverul / SDK-ul utilizat pe gazdă pentru a comunica cu dispozitivul RDMA se numește și RDMA, dar este definit ca Queue Paris and Channels.
Voila. Cred că înțeleg RDMA puțin mai bine acum.
Revenind la provocarea calculului cuantic - întrebarea este de ce ne pasă de RDMA? Ei bine, asta pentru că Nvdia și-a numit comutatorul InfinBand „Quantum InfiniBand”!
Totuși, în ciuda faptului că cel mai recent Quantum-X800 al lor este o bestie, nu are nicio legătură cu calculul cuantic. Dar poate că ar putea juca un rol cheie în interconectarea Controlului Cuantic la GPU, pentru provocarea de învățare prin consolidare?