Sunt extrem de încântat să fac parte din echipa de la Qblox, care a lucrat și încă lucrează activ cu Nvidia pentru a promova standardul NVQLink, ca o modalitate de interconectare a sistemelor eterogene calculate pe GPU-uri, CPU-uri și QPU-uri (procesoare cuantice, inclusiv controlerele cuantice incipiente pe care Qblox le dezvoltă).
NVQLink nu este încă un „cablu” pentru conectarea GPU-urilor la procesoarele Quantum, ci mai degrabă un framework complet care permite interconectarea dispozitivelor eterogene, de la rețea la stiva de software:
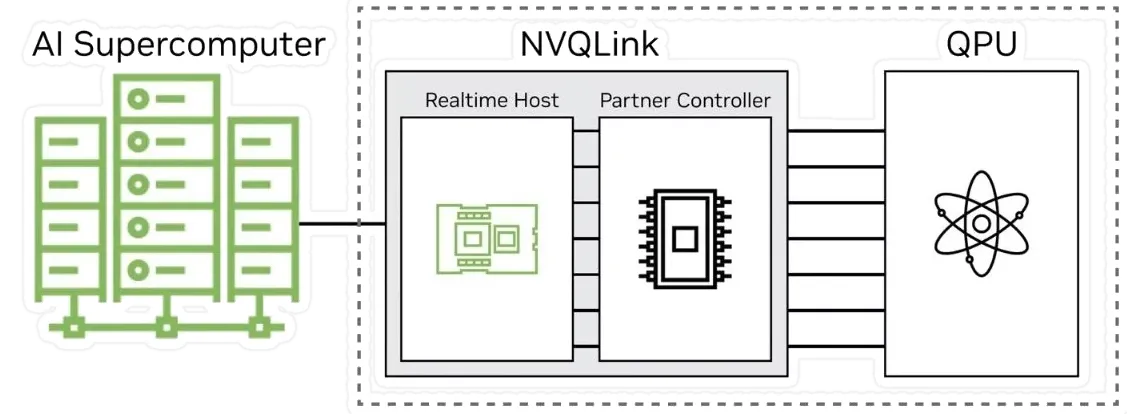 Credit imagine: Nannod
Specificațiile cheie „hardware” pun accentul pe performanța resurselor de rețea și de calcul:
Debit de rețea: Până la 400 Gb/s de la GPU la QPU.
Latență rețea: latență dus-întors (FPGA → GPU → FPGA) mai mică de 4,0 microsecunde.
GPU HW: Gazdă în timp real construită pe supercipuri NVIDIA GB200 Grace Blackwell, cu mulți TFLOPS.
S-ar putea să vă întrebați: „De ce este important acest lucru?”
Creează un standard deschis pentru a integra strâns hardware-ul cuantic cu calculul accelerat prin GPU.
Permite fluxuri de lucru hibride: calibrarea rețelelor neuronale, corecția erorilor cuantice (QEC) etc.
- Oferă o platformă deschisă ce integrează software și hardware ca una singură, permițând oricui să interacționeze cu computerele cuantice, fără a fi nevoit să se înece într-un ocean de cunoaștere, datorită Cuda-Q.
Specificație NVQLink: Proiectare arhitecturală
Link to heading
Documentul informativ NVQLink este acum disponibil la https://arxiv.org/abs/2510.25213, așa că haideți să analizăm în detaliu arhitectura propusă:
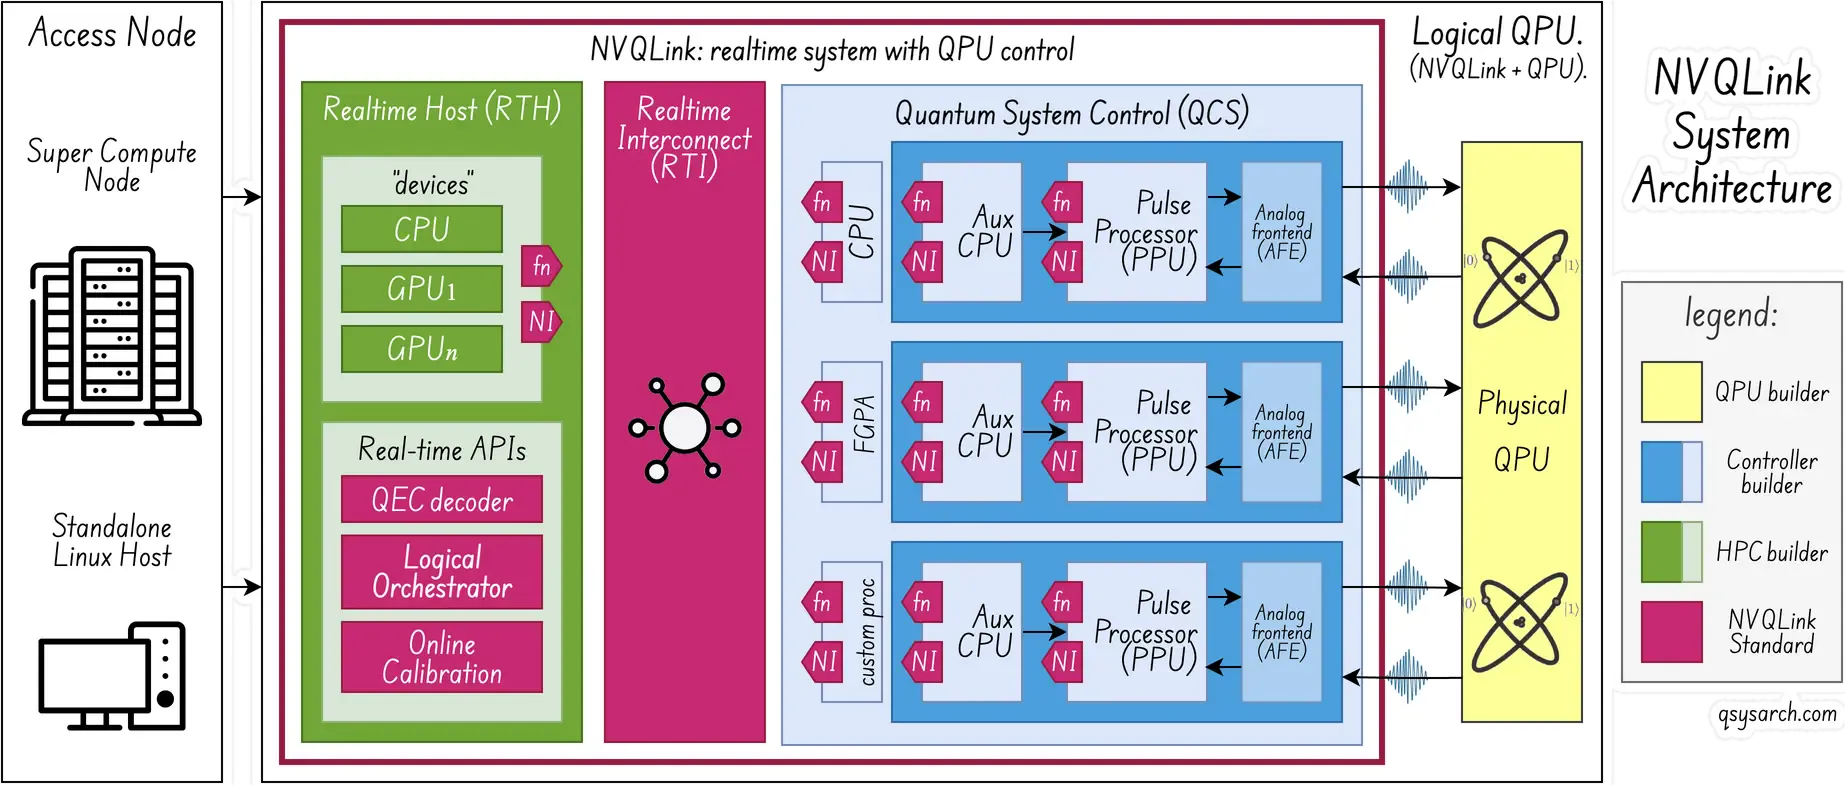 (diagrama sistemului adaptată după imaginea originală din cartea albă)
Așa cum era de așteptat, detaliile corespund cu prezentarea generală la nivel înalt de la Nannod. Din perspectiva componentelor, arhitectura NVQLink cuprinde gazda în timp real („RTH”) și sistemul de control QPU („QSC”). Aceste două componente sunt conectate printr-o interconectare în timp real („RTI”) scalabilă și cu latență redusă. RTH are resurse de calcul HPC tradiționale, cum ar fi procesoarele și GPU-urile. În ceea ce privește QSC, acesta include de obicei unitățile de procesare a impulsurilor („PPU”) care controlează QPU.
Această diagramă introduce două cuvinte cheie importante: fn și NI. În modelul mental NVQLink („modelul de programare”), fiecare dintre procesoare, procesoare grafice, unități de procesare a datelor (PPU) (sau alte circuite integrate/FPGA specializate) este denumit „dispozitive”, iar NVQLink face posibilă apelarea procedurilor la distanță („callback-uri” sau fn) către oricare dintre aceste dispozitive. Aceasta este o soluție extrem de puternică, în care NVQLink acționează ca liant pentru sistemul eterogen. Implementarea propriu-zisă a runtime-ului fn este extrem de optimizată, până la punctul în care se ia în considerare chiar și marshalling-ul. În acest fel, se pot asigura latențe de câteva microsecunde. Cât despre NI, acesta înseamnă Network Interface (Interfață de rețea) și este conceptualizat ca o placă/interfață/cablu de rețea „mică” și opțională pe care toate părțile o pot utiliza pentru a avea un sistem unificat și interconectat.
NVQLink introduce, de asemenea, conceptul foarte important al domeniilor de timp: acest lucru este necesar deoarece nu se așteaptă ca toate „unitățile de procesare” implicate în sistem să urmeze „același ceas”.
Există 4 categorii de domenii de timp, de la cel mai rapid la cel mai lent:

Domeniul fizic al timpului (PTD): De obicei, ceasul QPU.
Domeniul temporal determinist (DTD): De obicei, ceasul QSC/FPGA-urilor, capabil să funcționeze cu scale de timp cuantice coerente.
Domeniul în timp real (RTD): De obicei în CPU-ul sau GPU-ul clasic. Poate fi în timpul coerent cuantic sau între două experimente coerente cuantice.
Domeniul Timpului de Aplicație (ATD): De obicei, laptopul pe care rulează notebook-ul Jupyter!
Fără nicio surpriză, NVQLink utilizează RDMA și GPUDirect pentru a ocoli orice tip de procesare inutilă a CPU-ului și pentru a asigura o latență optimă. Așa cum este scris în specificație, „beneficiind de aceste două tehnologii, doar placa de rețea și GPU-ul sunt implicate în timpul procesării pachetelor care vin de la și merg către QSC, fără nicio implicare a gazdei”.
Specificația recomandă, de asemenea, utilizarea modului RDMA „Conexiune nesigură”, deoarece prețul latenței plătit pentru conexiunile RC (conexiuni fiabile) poate fi exagerat în comparație cu o rețea proiectată corespunzător.
Specificația oferă o „dovadă de concept” pentru arhitectura rețelei, ca mijloc de verificare a latenței posibil realizabile. Se utilizează modulul Holoscan Sensor Bridge, care oferă mijloace de trimitere a datelor între un FPGA și o placă de rețea utilizând protocolul RDMA over Converged Ethernet (RoCE), precum și gestionarea pașilor de enumerare și a semnalelor de control. Folosind această arhitectură, specificația arată că este posibil să se obțină o latență dus-întors sub 4 microsecunde, pentru o sarcină utilă RDMA de 32 de octeți, echivalentă cu un cadru Ethernet de 92 de octeți.
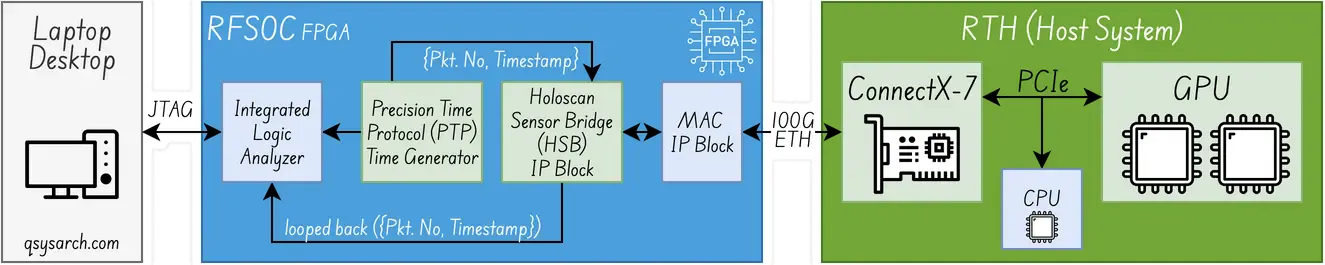 (diagramă adaptată după imaginea originală din documentul informativ)
Arhitectură de compilare (cunoscută și sub numele de model de programare CudaQ+NVQLink)
Link to heading
NVQLink face distincție între modalitățile lente și cele rapide, iar în această secțiune voi examina în mod specific impactul arhitecturii modalității rapide (așa-numita „Sensibilitate latență ridicată”). Principala diferență față de modalitățile lente este că arhitectura permite compilarea Just-in-Time (JIT), precum și posibila mediere RTH în timpul execuției.
Pentru ca CudaQ + NVQLink să funcționeze cu modalități rapide, specificația stipulează că programele ISA complete trebuie încărcate în prealabil pe FPGA-uri și declanșate atomic, cu o comunicare interactivă minimă cu gazda în timp real în timpul execuției. JIT este o tehnologie foarte interesantă, așa că este păcat că nu poate fi utilizată pentru modalități rapide. Cu toate acestea, specificația clarifică faptul că FPGA-urile au voie să „primească” actualizări dinamice de la RTH („prin intermediul unei coazi de instrucțiuni”), cu condiția ca coada de instrucțiuni să rămână negoală până la terminarea programului. Asta sună a programare „just in time”.
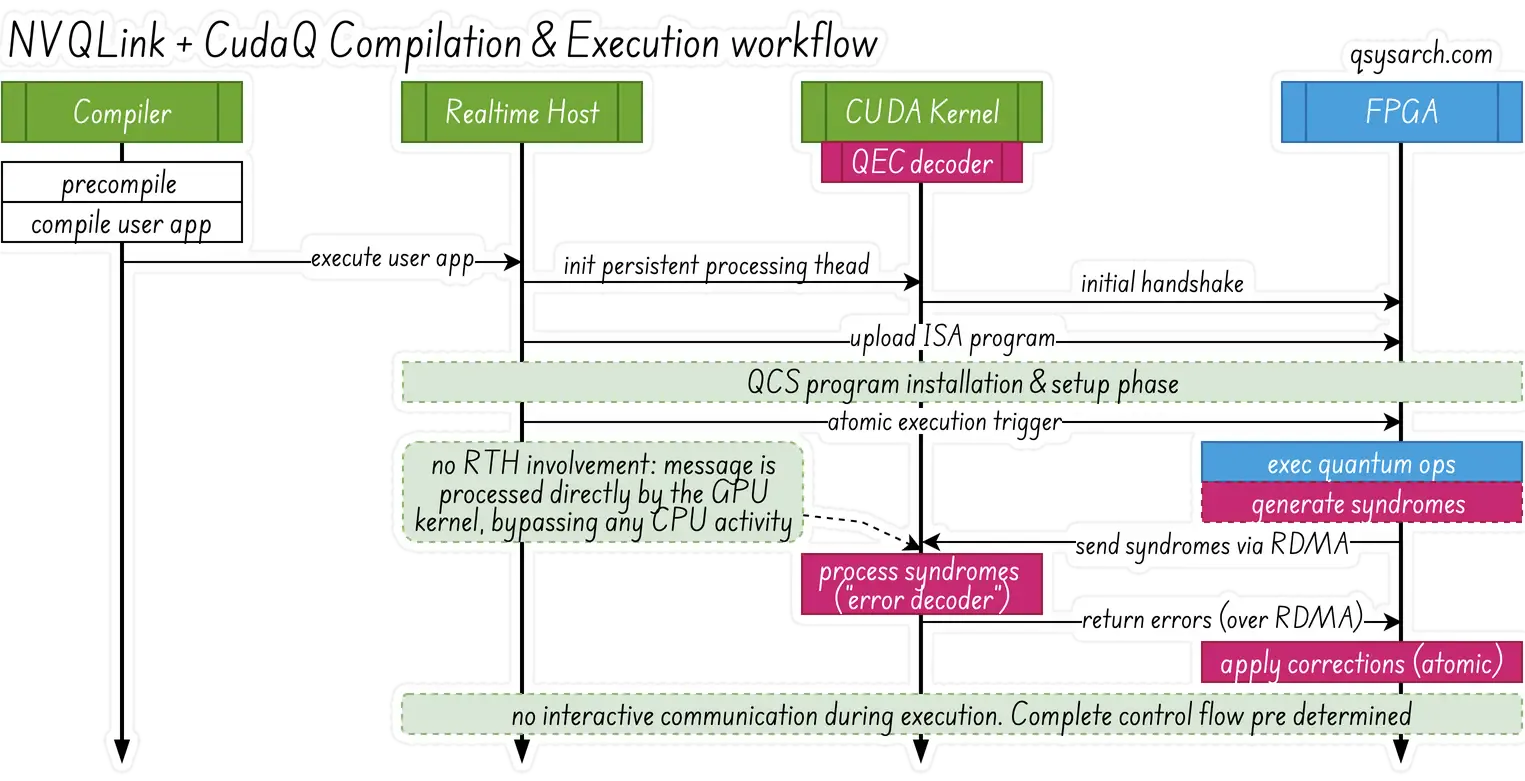
Fără nicio surpriză, specificația clarifică faptul că compilarea trebuie să efectueze optimizări agresive în avans - iar acesta este cu siguranță un lucru pe care toți furnizorii de stive de control cuantic îl fac cu ardoare. De asemenea, se menționează că, dacă trebuie executată vreo funcție de apel invers în GPU, nucleul CUDA din GPU trebuie să fie preinițializat și să aștepte activ evenimente - nimic special aici, acesta este fluxul de lucru standard DOCA GPUNetIO
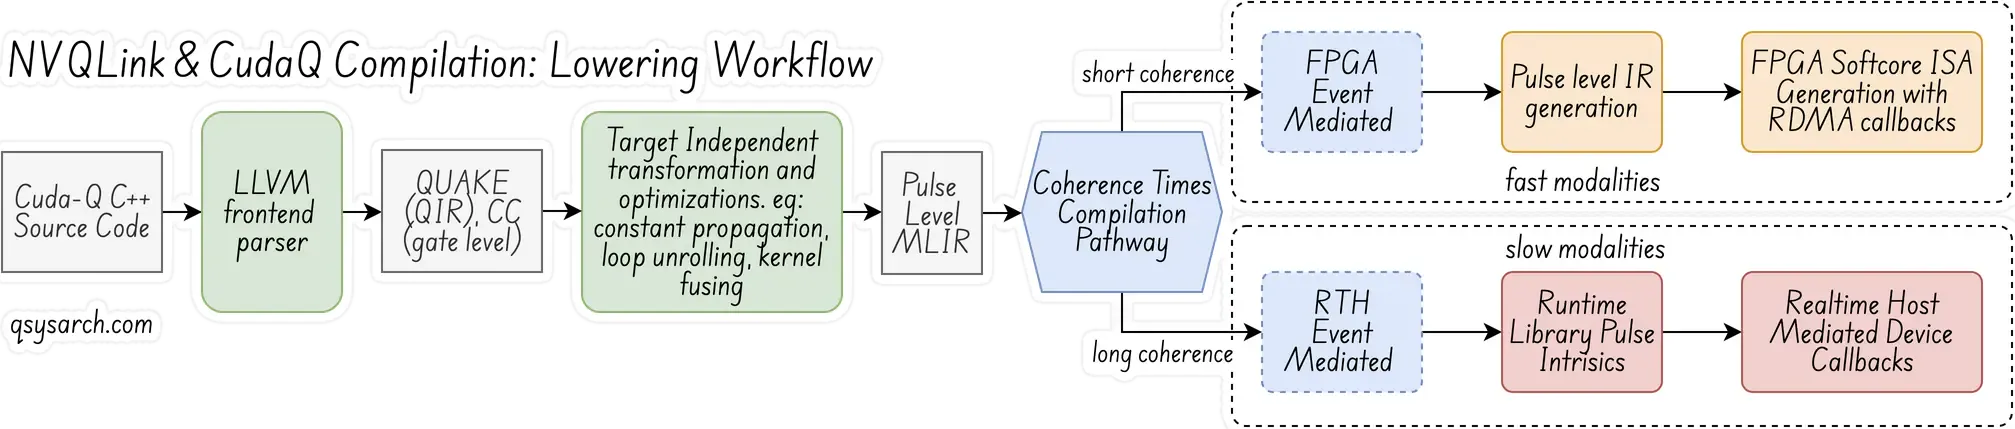
Fluxul de lucru pentru compilarea și coborârea CUDA=Q la arhitectura NVQLink se bazează pe arhitectura standard LLVM MLIR (vezi diagrama de mai sus). Primul pas este analizarea nucleelor CUDA și generarea IR-urilor intermediare Quantum IR (cunoscut și sub numele de QIR sau QUAKE) și CC (classic compute), care sunt abstractizate la nivel de poartă. O fază ulterioară introduce optimizarea necesară și fuziunea nucleului, producând un dialect la nivel de impuls. Apoi, în funcție de tipul de modalitate, următoarea fază de coborâre utilizează fie medierea RTH, fie medierea FPGA.
„Nucleul cuantic” este identificat prin prefixul __qpu__.
int gpu_adder(int, int);  // This function is executed on GPU
__qpu__ int simple_quantum_kernel(int i) { // This function (kernel) is executed on the QCU
cudaq::qubit q;
h(q); // Operate an H gate on qubit q
auto readout = mz(q); // Read the Z axis of qubit q
return cudaq::device_call(2, gpu_adder, i, readout); // This is tail function call
}
În faza de compilare, este mai întâi convertit („redus”) într-un amestec de reprezentări intermediare (IR) sau dialecte QUAKE (Quantum dialect) și CC (Classical Compute dialect):
func.func @simple_quantum_kernel(%arg0: i32) -> i32 {
%0 = quake.null_wire
%1 = quake.h %0 : (!quake.wire) -> !quake.wire
%measOut, %wires = quake.mz %1 : (!quake.wire) -> (!quake.measure, !quake.wire)
%2 = quake.discriminate %measOut : (!quake.measure) -> i1
%3 = cc.cast unsigned %2 : (i1) -> i32
%4 = cc.device_call @gpu_adder on 2 (%arg0, %3) : (i32, i32) -> i32
return %4 : i32
}
În conformitate cu conceptul de zero-copy, adânc înrădăcinat în RDMA, runtime-ul NVQLINK promovează, de asemenea, performanțe ridicate și abstractizare zero-overhead, obținute prin intermediul a două concepte esențiale:
compoziție bazată pe trăsături: Este un mijloc în timpul compilării pentru a exprima comportamentul oricărui dispozitiv, iar NVQLink propune un set de trăsături standard.
polimorfism static: Este un mijloc în timpul compilării prin care compilatorul poate instanția metoda corectă fără a fi nevoie de indirecționarea tabelului virtual.
Există 4 trăsături esențiale:
explicit_data_marshalling_trait: înseamnă alocarea și transferul de date în cadrul sistemului.
device_callback_trait: înseamnă invocarea funcțiilor dispozitivului („RPC”)
quantum_control_trait: înseamnă încărcarea și pornirea programului pe QCS
rdma_trait: înseamnă inițializarea eficientă a structurii din bufferul de memorie brută.
În practică, trăsăturile utilizează limbajul C++ la un nivel super-avansat. Aceasta este, de exemplu, trăsătura data marshalling.
template <typename Derived> class explicit_data_marshaling_trait {
public:
void *resolve_pointer(device_ptr &devPtr);
device_ptr malloc(size_t size) const;

template <typename... Sizes, enable_if_t<(conjunction_v<is_integral<Sizes>...>),int> = 0>
auto malloc(Sizes... szs) { return make_tuple(static_cast<Derived *>(this)->malloc(szs)...); }

void free(device_ptr &d);

template <typename... Ptrs, typename = enable_if_t<(conjunction_v<is_same< remove_cv_t<remove_reference_t<Ptrs>>, device_ptr>...>)>>
void free(Ptrs &&...d) { (free(d), ...);
}
void send(device_ptr &dest, const void *src);
void recv(void *dest, const device_ptr &src);
};
Există multe de explicat în această sintaxă, care este, în opinia mea, chiar mai puternică decât sintaxa Rust (de exemplu, cow). Această sintaxă este cunoscută și sub numele de metaprogramming, iar în contextul NVQLINQ, se referă la polimorfism static sau la compilare. Să aruncăm o privire la linia template <typename… Sizes, enable_if_t<(conjunction_v<is_integral …>),int> = 0> mai detaliat:
este_integrală<Sizes> ca α: true dacă Sizes este un tip integral adică int, float, bool, etc…
conjunction_v<α...> as β: true dacă toate valorile din α... sunt adevărate
enable_if_t<(β),int> ca δ: o condițională grupul 2 care ar trebui să eșueze dacă β ar fi fals.
șablon<typename... Sizes, δ = 0> : O construcție SFINAE care previne eșecul lui δ.
Cu această sintaxă, devine posibil să existe un malloc specializat format din mai multe blocuri simultan:
class gemm_device : public explicit_data_marshalling_trait {  ... }
gemm_device gpu_gemm; // "gemm" stands for general matrix multiply
auto [column, row, matrix] = device.malloc(1024, 1024, 1024*1024);
Vă puteți întreba de ce contează asta. Este la fel de simplu ca oferirea posibilității de a avea o specializare optimă la momentul compilării. În acest caz, implementarea malloc poate grupa buffer-ul de memorie în mod contiguu, făcându-l potrivit pentru schimburi RDMA și pentru marshalling-ul atomic al mai multor date. Grozav, nu-i așa?
NVQLink oferă un set de interfețe standard pentru compilarea, încărcarea și executarea (declanșarea) nucleelor cuantice. Întrucât o imagine este mai bună decât o mie de cuvinte, voi rezuma această secțiune cu acest desen:
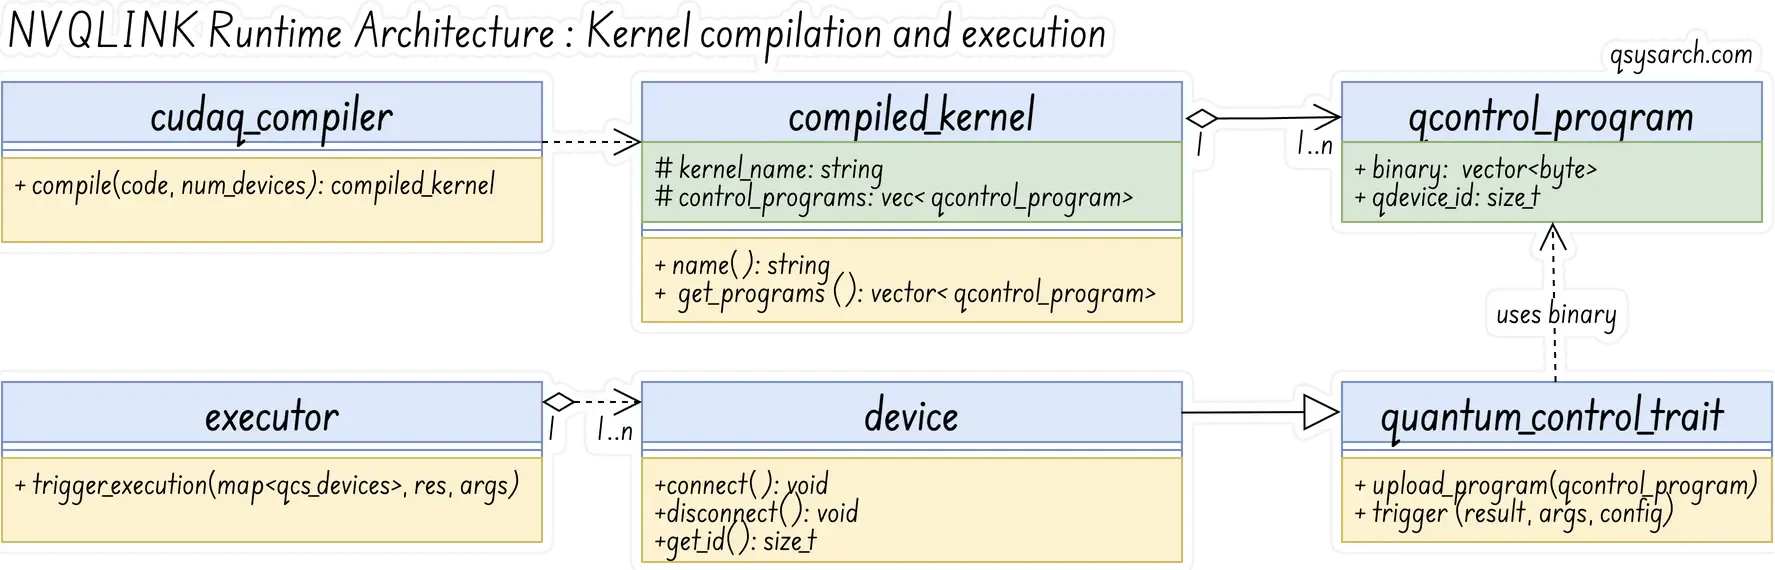
Un lucru de remarcat este că un QCS (Sistem de Control Cuantic) este compus din mai multe PPU-uri (Unități de Procesare a Impulsurilor). Prin urmare, la compilarea unui kernel, acesta poate necesita executare co-sincronă pe mai multe PPU-uri. (Rețineți că NVQLink este agnostic față de co-sincronizare, dar fiecare furnizor de QCS are propria soluție, cum ar fi SYNQ pentru Qblox).
În contextul interfețelor NVQLINK, conceptul de PPU este abstractizat și înlocuit de QCS, care reprezintă un dispozitiv cuantic generic. Așadar, la compilarea unui kernel, NVQLINK generează mai multe programe pentru fiecare dintre QCS.
Arhitectură Runtime: „Bibliotecă” de abstractizare de nivel superior
Link to heading
Întrucât codul explicat în secțiunea anterioară poate fi destul de complex de înțeles și de construit pe baza acestuia, NVQLINK oferă un set de API-uri de nivel superior, sub formă de funcții:
Biblioteca conține funcții pentru a gestiona funcțiile de bază de inițializare și oprire, pentru a gestiona API-ul de mutație a datelor specifice dispozitivului, cum ar fi memcpy, pentru a muta date către și de la QPU-ul logic, pentru a gestiona încărcarea și execuția. Mai jos este o versiune simplificată a acestor funcții:
void initialize(DeviceTypes &&...in_devices);
void shutdown();

device_ptr malloc(size_t size, size_t devId);
void free(device_ptr &d);

void memcpy_to_qpu(device_ptr &arg, const void *src);
void memcpy_from_qpu(void *dest, const device_ptr &src);

handle load_kernel(const string &code, const string &kernel_name);
void launch_kernel(handle kernelHandle, device_ptr &result, const vector<device_ptr> &args);
Exemplu de aplicație: Să ne teleportăm
Link to heading
să fie completat
NVQLINK este o abstracție puternică la nivel de sistem care permite interconectarea sistemelor eterogene cu un timp de execuție extrem de eficient și optimizat. Ceea ce îl face mai atractiv decât orice alt framework este faptul că sistemul NVQLink este compus din stive standard, inclusiv RDMA pentru rețea, LLVM pentru compilator și trăsături și API-uri standardizate pentru timpul de execuție.
Cu NVQLINK, dezvoltatorii și integratorii nu mai trebuie să-și facă griji cu privire la interconectare. În schimb, se pot concentra pe compunerea sistemului lor eterogen și pe compilarea kernel-urilor multi-dispozitiv într-un singur framework, lăsând runtime-ul NVQLINK să orchestreze execuția diferitelor „dispozitive”, ca și cum ar fi un singur sistem. Runtime-ul NVQLink se ocupă de crearea de rețele, organizarea și apelurile inter-dispozitive, astfel încât dumneavoastră să nu mai fie nevoie să faceți acest lucru.
Acesta este un salt uriaș - împreună cu CudaQ, va permite inginerilor cuantici să creeze aplicații puternice, la fel cum Nvidia CUDA a permis aplicații puternice de rețele neuronale. Gândiți-vă la un LLM cu puțină cuanticitate…
Prompt: desenați o imagine a unui „Model de Qubiți Mari” care este calculat pe un GPU adiacent conectat prin sistemul NVQLINK > > ChatGPT nu a înțeles că NVLINK nu este NVQLINK.
Prompt: Poți desena o imagine în stil desen animat a unui sistem NVQLINK, interconectând un „Model Qubit Mare” conectat la un GPU adiacent? > > ChatGPT încă nu înțelege că NVQLINK nu este un „cablu”, ci un framework la nivel de sistem care face posibilă compunerea de kerneluri executate pe mai multe dispozitive eterogene. Și că, deocamdată, se așteaptă ca cablul să fie un RDMA (deoarece este un standard), dar ar putea fi și NVLink peste 5 ani.
References
DrawIO diagrams used in this memo: