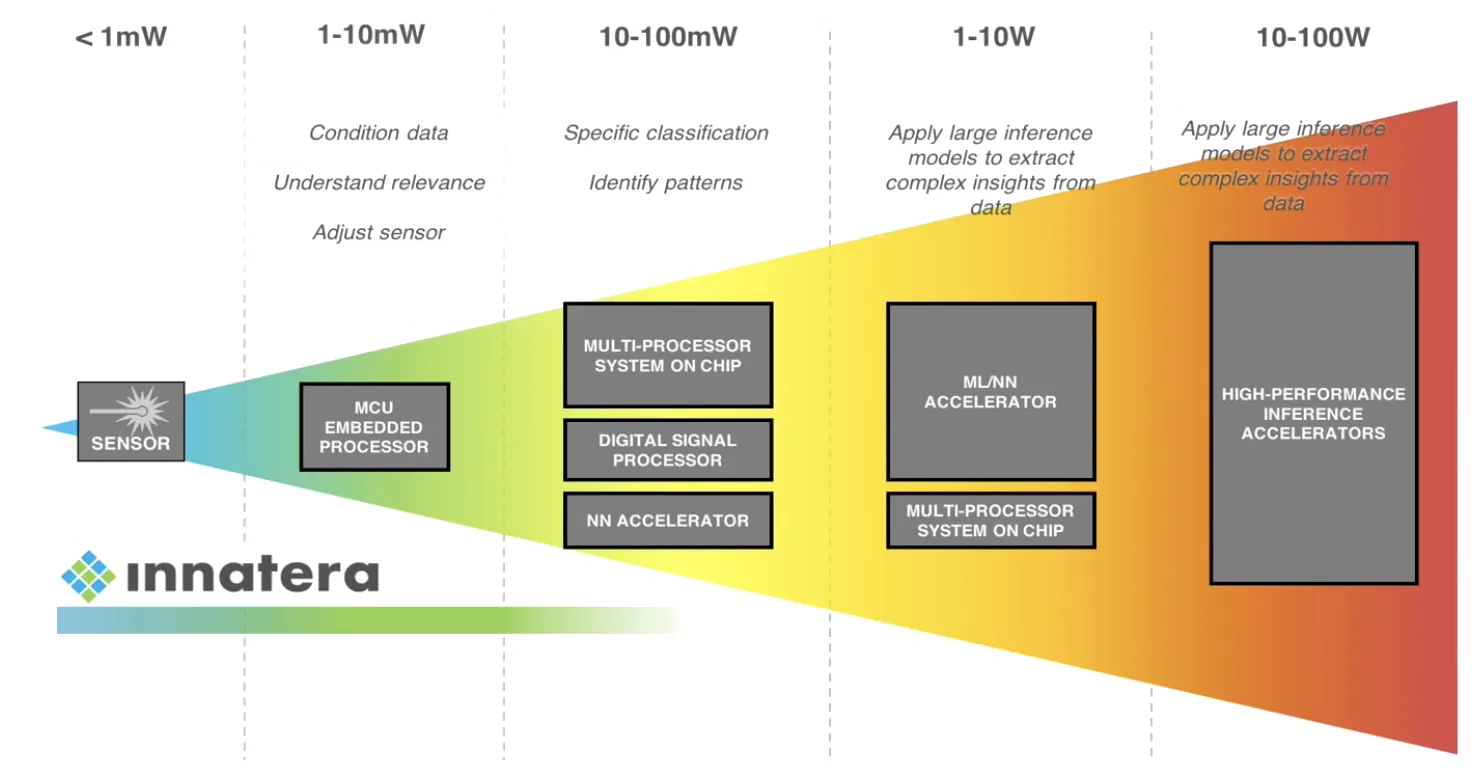
Am auzit recent despre Unitățile de Procesare Neuromorfice, sau NPU-uri, în timp ce discutam despre Neuralink.
 Aceste NPU-uri nu au nicio legătură cu calculul cuantic, dar m-am gândit că ar fi interesant să petrecem puțin timp inspirându-mă de o nouă arhitectură de procesare. Și, de fapt, unul dintre principalii furnizori de circuite integrate în acest domeniu este o companie olandeză numită Innatera. Cel mai recent circuit integrat al Innatera, Pulsar, se bazează pe rețele neuronale de tip Spiking cu consum redus de energie (vezi imaginea din dreapta).
În acest memo, voi încerca să descifrez cât mai multe informații posibil despre modul în care sunt arhitecturate acele circuite integrate neuromorfice, cum sunt proiectate rețelele neuronale Spiking și ce stivă de software este expusă pentru a programa aceste dispozitive.
Aceasta este o încercare de a redesena diagrama arhitecturală pentru circuitul integrat Pulsar ([imagine] originală(https://www.embedded.com/innatera-pulsar-brings-brain-intelligence-to-the-edge/), completată cu informații din documentul informativ):

Îmi place ideea de a utiliza un procesor RISC-V - acesta este un semn clar că echipa de la Innatera ia decizia corectă de la bun început în ceea ce privește arhitectura. Într-una dintre diagramele de pe cipul anterior T1 al Innatera, procesorul RISC-V este inclus cu o extensie F (suport pentru calcul în virgulă mobilă).
Circuitul integrat integrează numeroase interfețe standard (SPI, I2C, …) și o unitate de gestionare a energiei (PMU) care pornește și oprește părți ale circuitului integrat atunci când intră în „modul repaus” sau în modul „economisire energie”. Din păcate, nu am găsit nicio informație despre consumul real de energie, cu excepția unui pachet de amplificatoare „mai puțin de 1 mW”. Presupunând o tensiune de alimentare de 1,8 V, aceasta ar fi mai mică de 500 µA (I=W/V). De asemenea, mă întreb dacă valorile de consum „pe ciclu” sunt relevante: în acest caz, presupunând o frecvență de 100 Hz (perioada de actualizare sinaptică), aceasta ar însemna în medie 5 µA per actualizare sinaptică.
Cea mai recentă diagramă de la Pulsar arată două acceleratoare: un CNN și o FFT. Cred că acestea ar putea fi descrise mai larg ca un GEMM (multiplicator matricial general, cheia pentru calculul NN) și o SFU (unitate funcțională specială, utilizată pentru a accelera calculul FFT). Consultați postarea despre arhitectura GPU pentru mai multe informații. Există, de asemenea, un encoder-decoder spike, care pare să fi fost dezvoltat ca un coprocesor pentru RISC-V, dar nu am putut găsi mai multe detalii.
Arhitectură de rețea neuronală cu vârfuri
Link to heading
Întrebarea care rămâne este despre Rețeaua Neuronală Spiking sau SNN: Cum funcționează aceasta?
L-am rugat pe Gemini să ofere o metaforă pentru un copil de 8 ani despre Rețeaua Neuronală Spiking. Iată povestea pe care am primit-o:
Imaginați-vă creierul ca o poștă uriașă, iar „neuronii” sunt micii mesageri care poartă bilețele.
- Mesageri și note:
Într-un program normal de calculator, fiecare mesager vorbește și strigă mereu numere. Într-o rețea neuronală cu impulsuri, mesagerii sunt foarte silențioși și eficienți din punct de vedere energetic: trimit doar un mesaj rapid „Hei!” atunci când se întâmplă ceva important - cum ar fi un mic vârf electric.
- Indicatorul de scânteie:
Fiecare mesager are un contor care se umple când aude „Hei!” de la ceilalți: Când contorul se umple suficient (atinge pragul), mesagerul respectiv se excită și strigă „Hei!”. Imediat după ce strigă, își resetează contorul, astfel încât să nu mai poată striga imediat (perioada refractară).
- Momentul este totul:
Dacă un mesager aude o mulțime de „Heis!” rapid, înseamnă că mesajul este foarte important (cum ar fi „Foc!”). Dacă un mesager strigă „Hei!” puțin mai devreme decât toți ceilalți, ar putea fi un semn secret că se întâmplă ceva special (cum ar fi „Se apropie tigrul!”). Așadar, mesagerii trebuie să fie atenți la timp.
- Învățarea este cheia:
Mesagerii învață exact ca tine: dacă Mesagerul A strigă „Hei!” chiar înainte ca Mesagerul B să strige „Hei!” (pentru că ceva i-a entuziasmat pe amândoi), prietenia lor devine mai puternică, iar mesajul Mesagerului A îl ajută pe Mesagerul B să-și umple mai repede contorul data viitoare.
Rețelele SNN sunt speciale deoarece sunt concepute să fie incredibil de rapide și eficiente. Nu irosesc energie vorbind tot timpul; se activează doar atunci când au un vârf de informații de partajat! Ajută computerele să înțeleagă sincronizarea, să recunoască tipare și să consume foarte puțină energie.
Adevăratul design de sub capotă
Link to heading
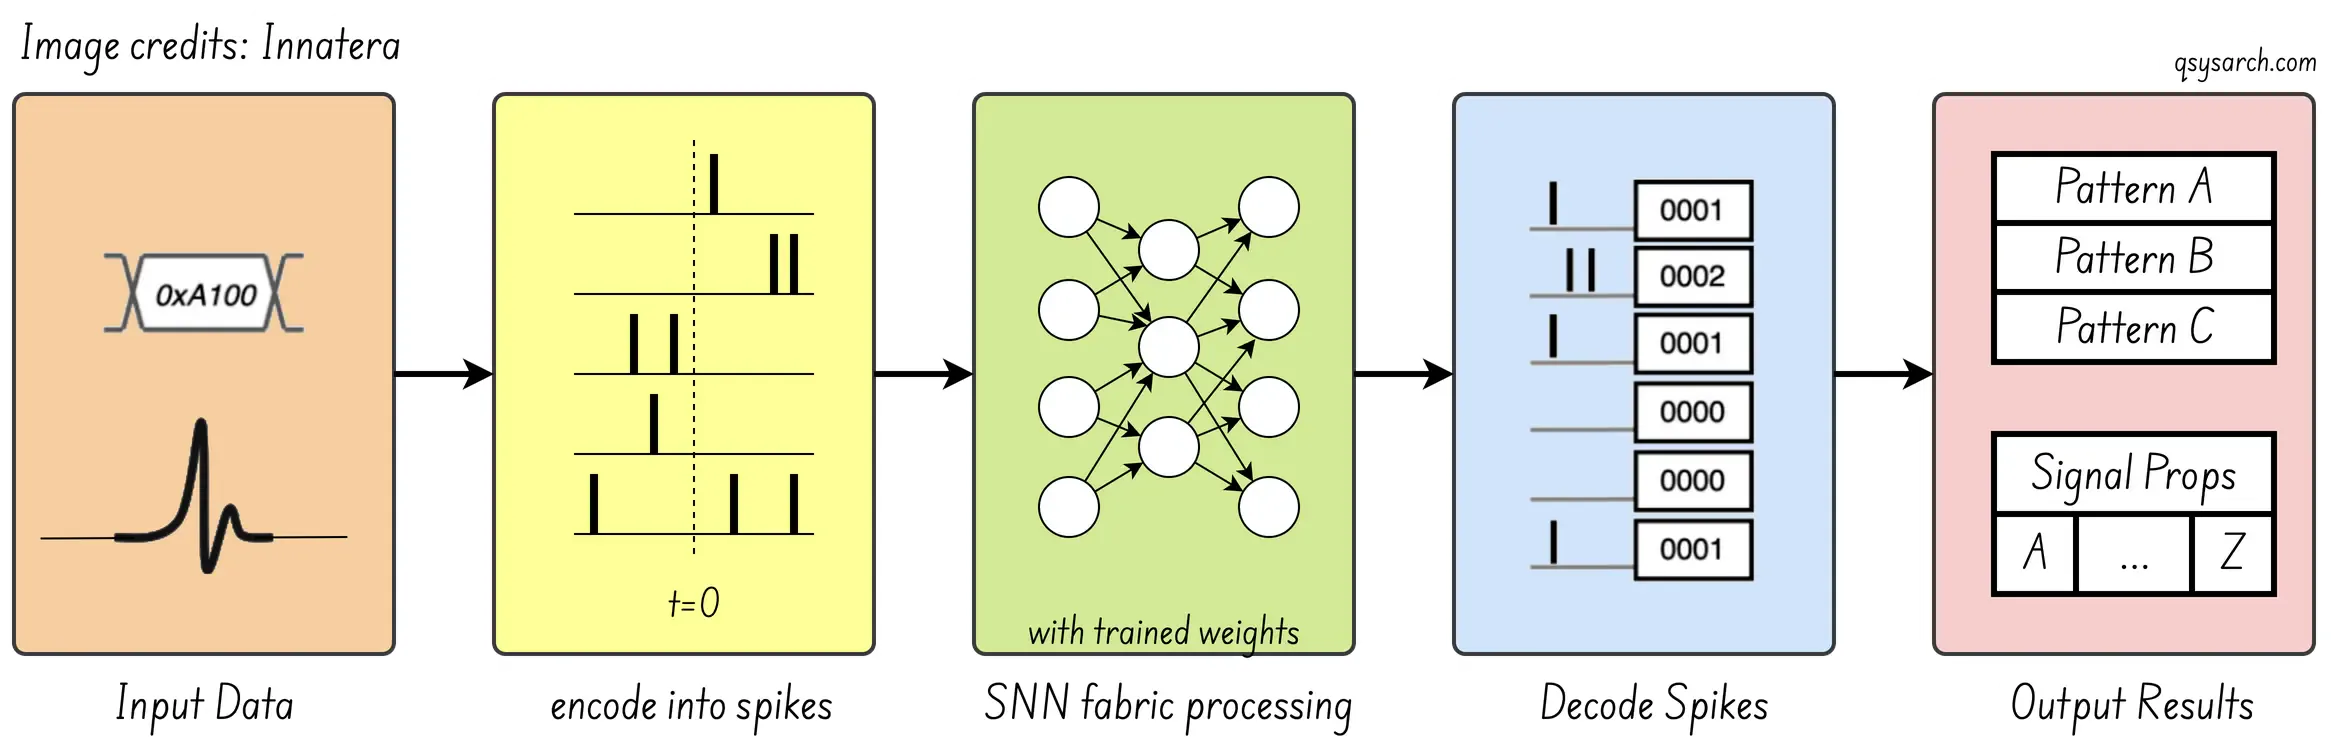
Blogul Innatera Thinking in Pulses oferă o bună prezentare generală a modului în care acest lucru ar putea fi implementat în hardware. Codificați „heys”-urile în valori binare, treceți-le printr-o rețea neuronală (NN) și extrageți caracteristicile. Până acum, nimic special; acesta este un proces standard al unei NN.
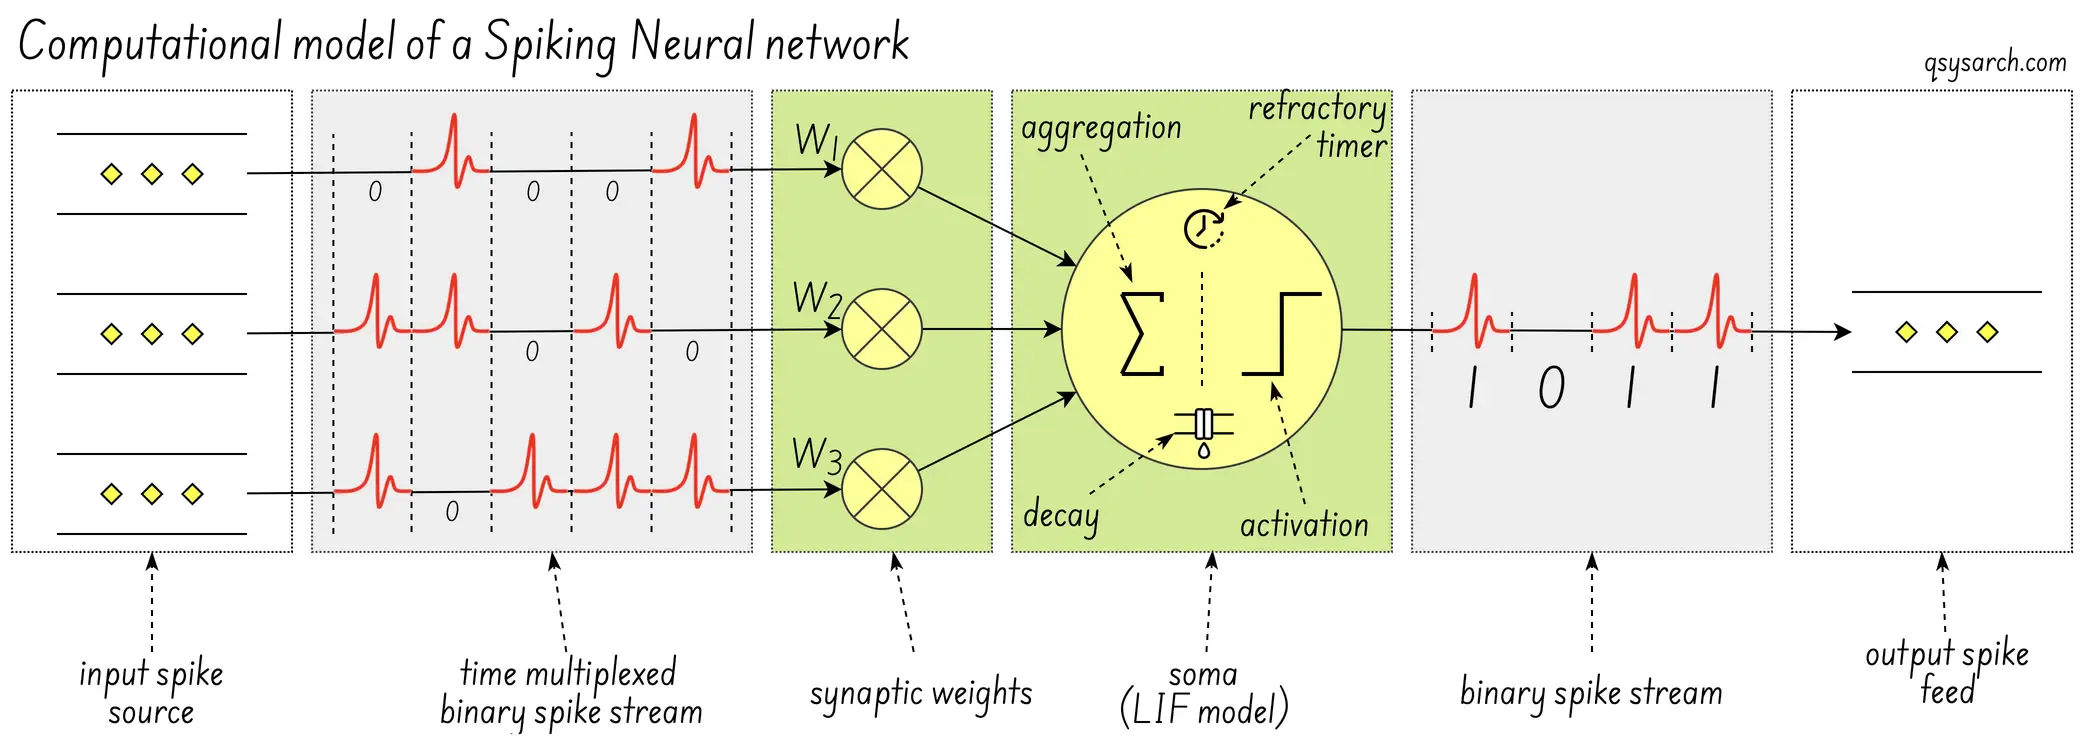
Întrebarea mai interesantă este cum este implementată această rețea SNN. Imaginea de mai jos pare a fi un „model computațional” convențional al neuronului digital (imagine sursă) - unde am adăugat noțiunea explicită de „integrare și foc cu scurgeri” (LIF) în cadrul SOMA.
Ce face ca implementarea hardware să consume puțină energie
Link to heading
de completat: sunt necesare explicații pentru
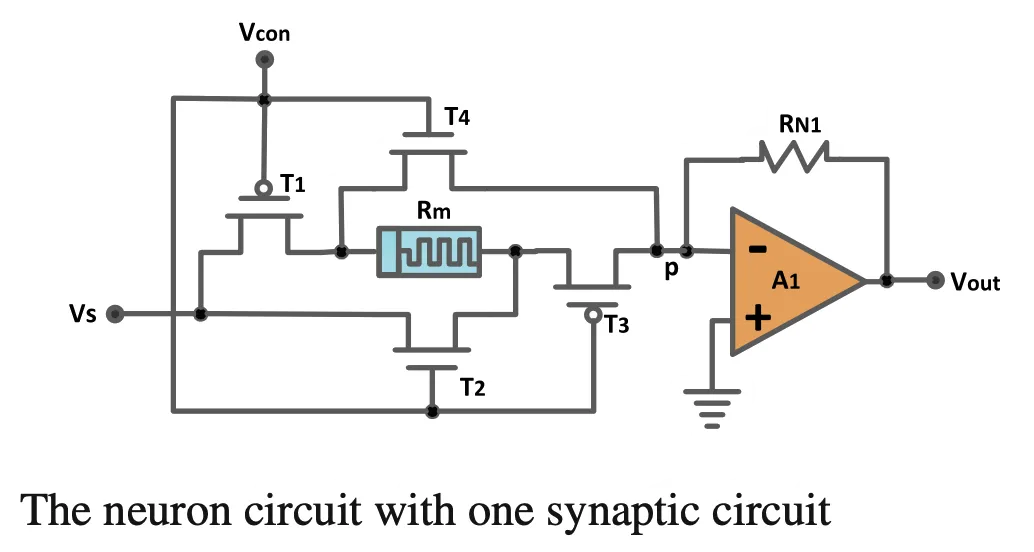
câștigul de performanță (10x, 1000x sau mai mult?)
latențele de propagare a NN realizabile
compromisurile și limitările
Performanța designului analogic vs. digital.
consum de energie relativ la GPU-uri/TPU-uri
O întrebare legată de designul Pulsar este: de ce există două SNN? Răspunsul este că structura SNN analogică (semnal analogic mixt proprietar) a Innatera este optimizată pentru eficiență energetică maximă și procesare foarte rapidă a evenimentelor, cu consum ultra-redus de energie. În timp ce structura SNN digitală are un design mai programabil și flexibil, care suportă rețele mai configurabile la o putere puțin mai mare. (Sursa)
Nu există prea multe informații pe site-ul Innatera despre arhitectura internă a rețelei lor neuronale cu spiking, dar, din fericire, au câteva brevete pe care putem încerca să le descifrăm!
| Data depunerii | Numărul publicației | Titlu (prescurtat) |
| 2021-02-09 | US20220230051A1 | Rețea neuronală Spiking |
| 2021-12-09 | EP4505212A1 | Metodă pentru preprocesarea eficientă a radarului |
| 26.01.2022 | EP4323923B1 | Rețea neuronală multi-segment cu spiking ierarhic reconfigurabilă |
| 14 februarie 2022 | EP4238006A2 | Structură computațională sinaptică multicomponentă distribuită |
| 22.03.2022 | EP4226281B8 | Adaptarea snns prin sincronizare tranzitorie |
| 2022-04-08 | EP4548260A1 | Calibrarea rețelelor neuronale de spiking |
| 2022-06-03 | EP4562540A | Sistem și metodă pentru codificatoare analogice eficiente, centrate pe caracteristici, de la vârfuri la vârfuri |
| 24 iunie 2022 | EP4573485A1 | Mașină neuronală secvențială pentru inferență optimizată pentru memorie |
| 2022-09-08 | WO2024038102A1 | Sistem și metodă pentru procese computaționale neurosinaptice modulare reconfigurabile... |
| 18 octombrie 2022 | WO2024153705A1 | Semnal mixt, sintetizabil cu feedback anticipat auto-temporizat și scalabil din punct de vedere tehnologic ... |
| 18.05.2023 | WO2024175770A1 | Module și metode de procesare audio neuromorfică mereu active |
| 24.05.2023 | WO2024175767A1 | Sistem și metodă pentru maparea rețelelor neuronale cu spiking pe neuromorfe … |
| 19 iunie 2023 | WO2025012331A1 | Metodă de antrenare a modelelor de învățare automată pentru substraturi stocastice |
| 22.06.2023 | WO2025017094A1 | Metodă de construire și implementare a rețelelor neuronale de tip spiking pe un dispozitiv hardware |
| 23 octombrie 2023 | WO2025021573A1 | Sistem și metodă pentru detectarea ocupării utilizând un senzor bazat pe cadru |
| 2023-12-06 | WO2025062034A1 | Extragerea caracteristicilor și codificarea rețelelor neuronale de tip spiking folosind metoda convoluțională |
| 2024-03-08 | WO2023242374A1 | Interconectare Spike pe cip multicast cu un singur pachet |
Este vorba despre o cantitate destul de mare de brevete pentru un startup! Pentru a economisi timp, m-am uitat doar la primul și ultimul brevet din această listă.
Să începem cu primul brevet US20220230051A1, care pare a fi cea mai apropiată de descrierea implementării hardware reale a SNN: Brevetul este centrat pe o metodologie compozițională pentru construirea SNN-urilor din subrețele specializate, pre-antrenate („celule”), folosind un principiu de „răspuns unic”.
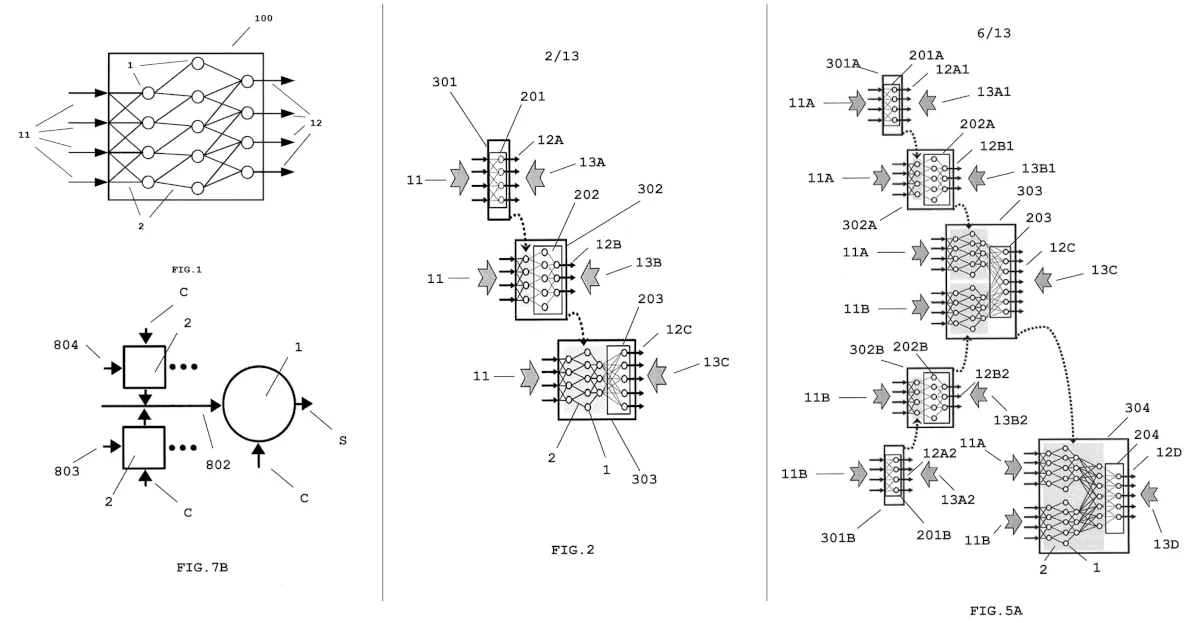
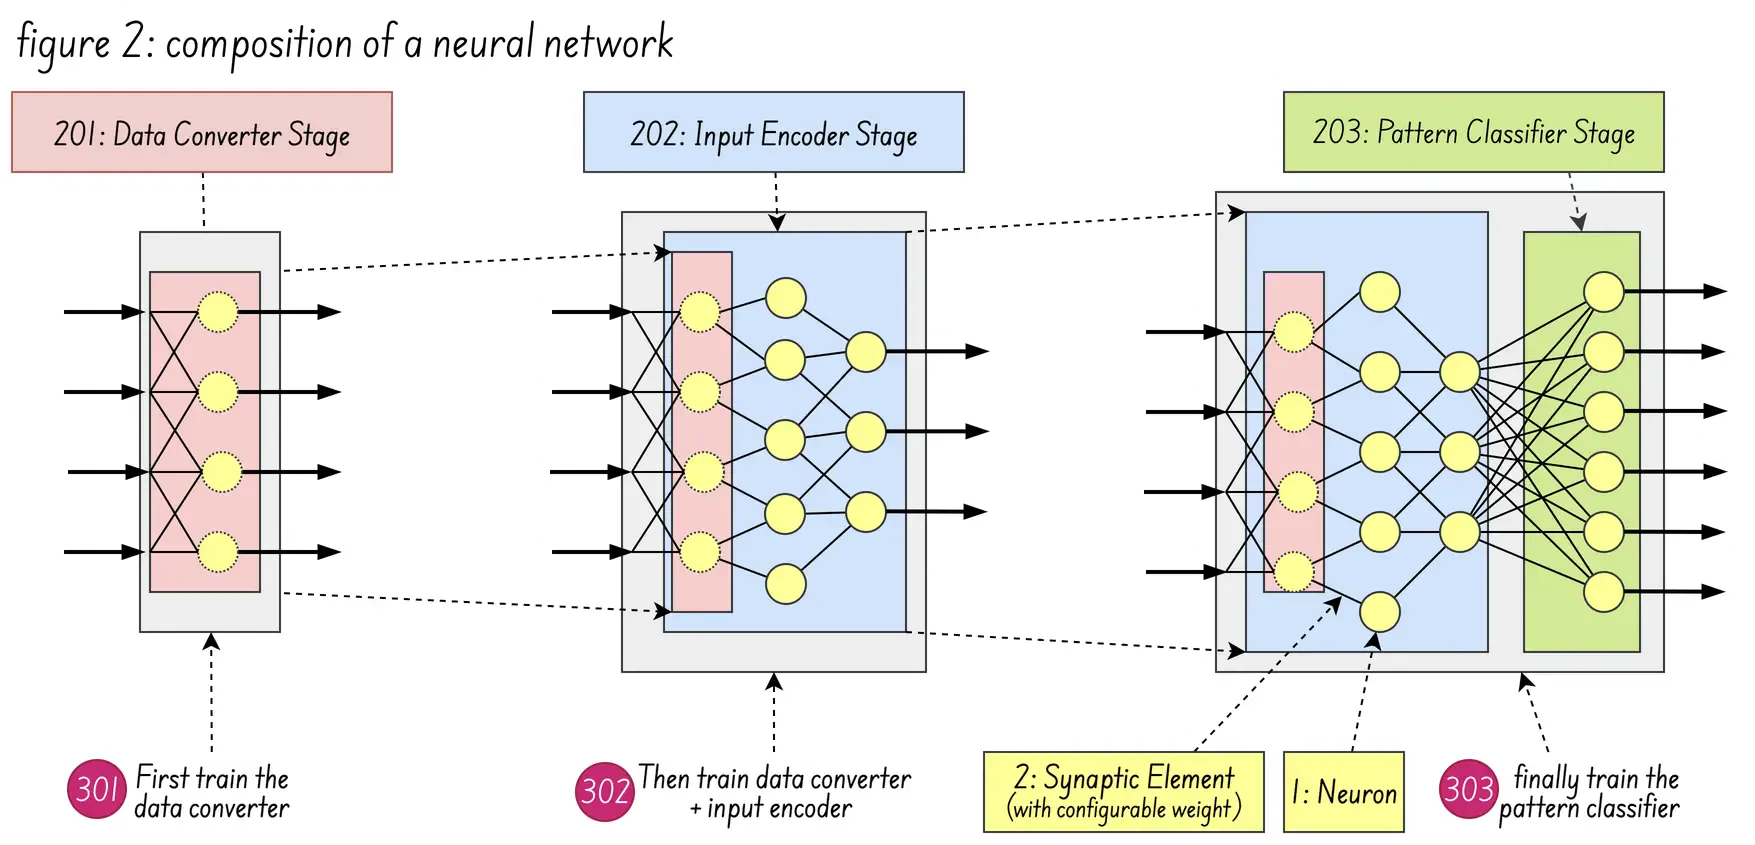
Figura 2 (mai jos) prezintă compoziția unei rețele neuronale formate prin integrarea unui etaj de conversie de date 201, a unui etaj de codificare de intrare 202 și a unui etaj de clasificare de modele 203. La fel ca în figura 5B (de mai sus), aceasta arată cum mai multe trenuri de spike temporale sunt fuzionate într-un singur tren de spike fuzionat.
În ceea ce privește ultimul brevet WO2023242374A1, acesta dezvăluie arhitectura de rețea neuronală Spiking a Innatera, utilizată pentru implementarea eficientă a multicastului cu un singur pachet folosind rețele network-on-chip. Scopul este de a reduce duplicarea, latența și overhead-ul în sistemele multicore/many-core pentru comunicarea multicast.
Diagrama de mai jos (figura 5 din brevet) arată cum funcționează arbitrajul NOC. Ideea este de a preveni trimiterea a două vârfuri (sau mai multe) către același port de ieșire în același timp. Aceasta este o modalitate eficientă de a ruta vârfurile în fiecare ciclu. Deși mă întreb cât de adânci sunt bornele FIFO din hardware-ul real.
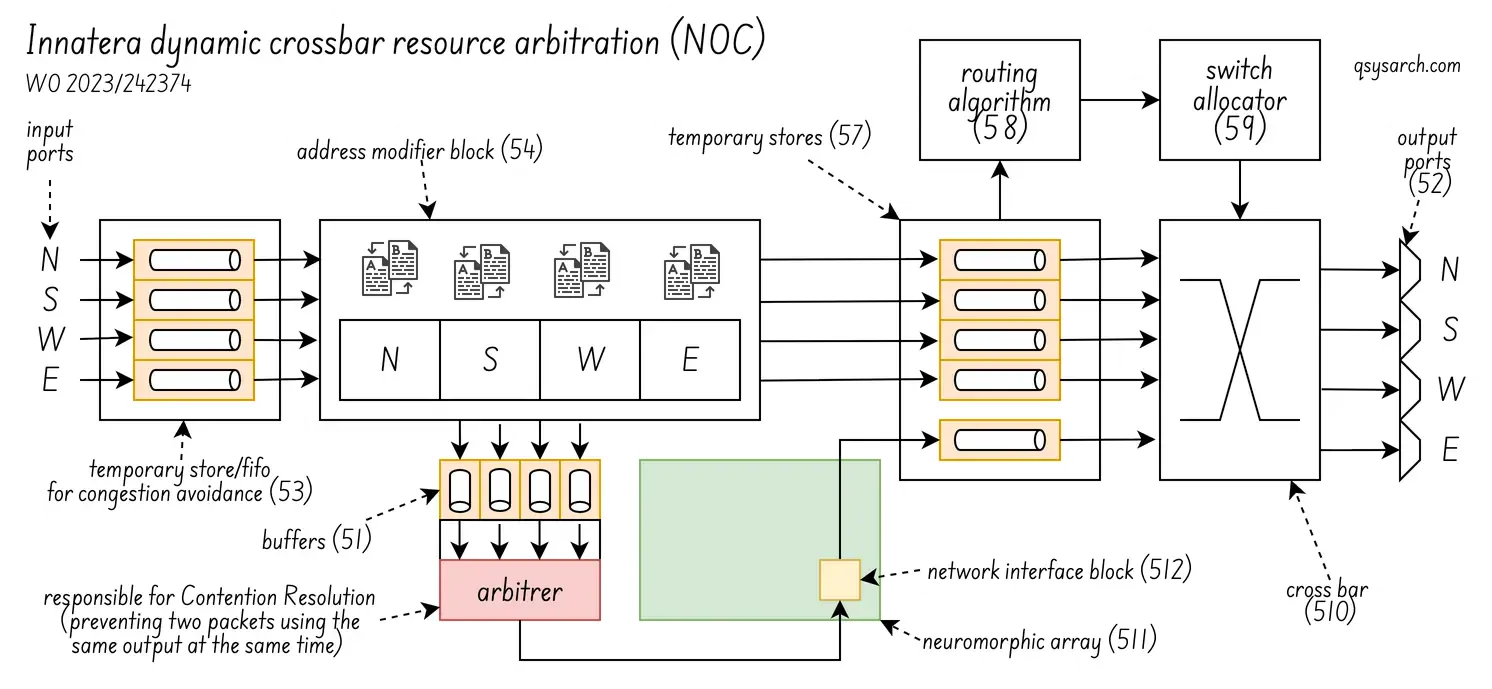
Ceea ce nu-mi este clar este cum se îmbină nucleul și rețeaua de spicule: Câți neuroni sunt într-un nucleu? Nucleul este interconectat sau lucrează împreună? Sau sunt unități independente care pot procesa clasificarea independentă în paralel?
Alt design al nucleului neuronal
Link to heading
Nu am răspunsul despre arhitectura de bază exactă a Innera, dar există o mulțime de lucrări de cercetare care oferă mai multe detalii despre posibilele implementări. Lucrarea „o perspectivă asupra designului de sistem asupra procesoarelor neuromorfice ” este deosebit de interesantă, deoarece compară mai multe arhitecturi.
Una dintre aceste arhitecturi este „sistemul neuromorfic reconfigurabil și foarte eficient”, sau RAVENS, care este prezentat în diagrama de mai jos:
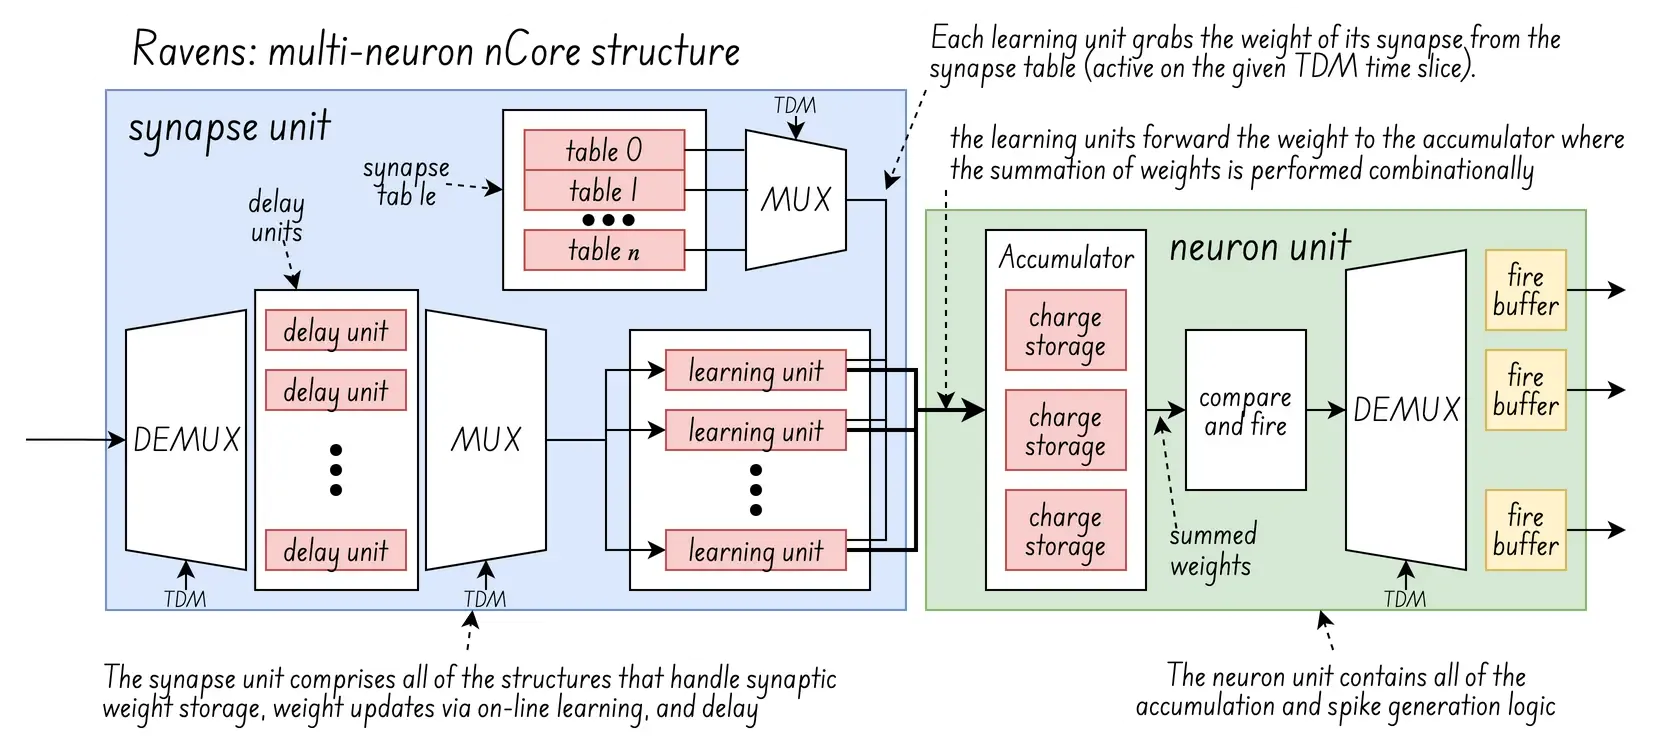 (diagrama a fost actualizată după imaginea originală: )
Ideea din spatele RAVENS este de a conecta mai mulți „neuroni virtuali” folosind multiplexarea cu diviziune în timp (TDM), într-un proces în două etape constând în acumulare și actualizare.
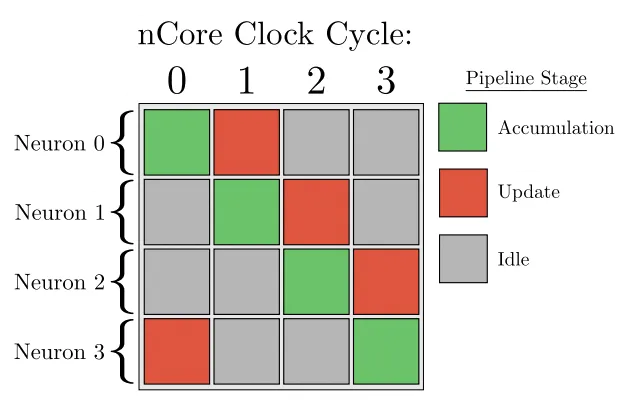
stadiul de acumulare: un neuron acumulează sarcină de la sinapsele de intrare conectate la acesta și determină dacă ar trebui să aibă loc sau nu un eveniment de incendiu pe baza pragului său programat și a stării refractare
etapa de actualizare: include învățare online modificări ale ponderilor sinaptice, pierderi de sarcină, incremente ale contoarelor refractare, modificări ale sarcinii acumulate datorate ieșirii dintr-o perioadă refractară
Partea interesantă aici este învățarea online: în circuitele integrate neuromorfice, învățarea online modifică ponderile sinaptice folosind algoritmi precum învățarea Hebbian sau învățarea prin consolidare pentru a ajusta puterea sinaptică în timp real pe baza inputului de la neuronii pre- și post-sinaptici.
În cazul nucleelor analogice, această ajustare este implementată fizic prin dispozitive precum memristoare sau joncțiuni de tunel magnetic (MTJ), a căror rezistență sau stare de conductanță este modulată de activitatea neuronală, reprezentând și stocând direct ponderile sinaptice. Iar în cazul nucleelor digitale, aceasta se face prin intermediul tabelelor de sinpaze, cel puțin ale RAVENS.
Oferta Innatera include un SDK Talamo inclus, care nu necesită expertiză SNN, acceptă aplicații end-to-end și utilizează un flux de lucru standard de deep learning. Kitul Talamo ajută dezvoltatorii să construiască modele de spiking de la zero într-un mediu bazat pe PyTorch. Este o baterie inclusă.
Fluxul de lucru al compilării este foarte standard. Diagrama de mai jos este o versiune ușor actualizată a materialului original al Innatera, presupunând că partea centrală a fluxului de lucru este compilatorul. De asemenea, mă întreb dacă simulatorul preia executabilul binar ca intrare, caz în care s-ar numi emulator. Un lucru despre care ar fi foarte bine să obținem mai multe informații este procesul de optimizare și dacă există parametri care pot fi modificați de către utilizator (cum ar fi reducerea ponderilor la 1.58 biți).
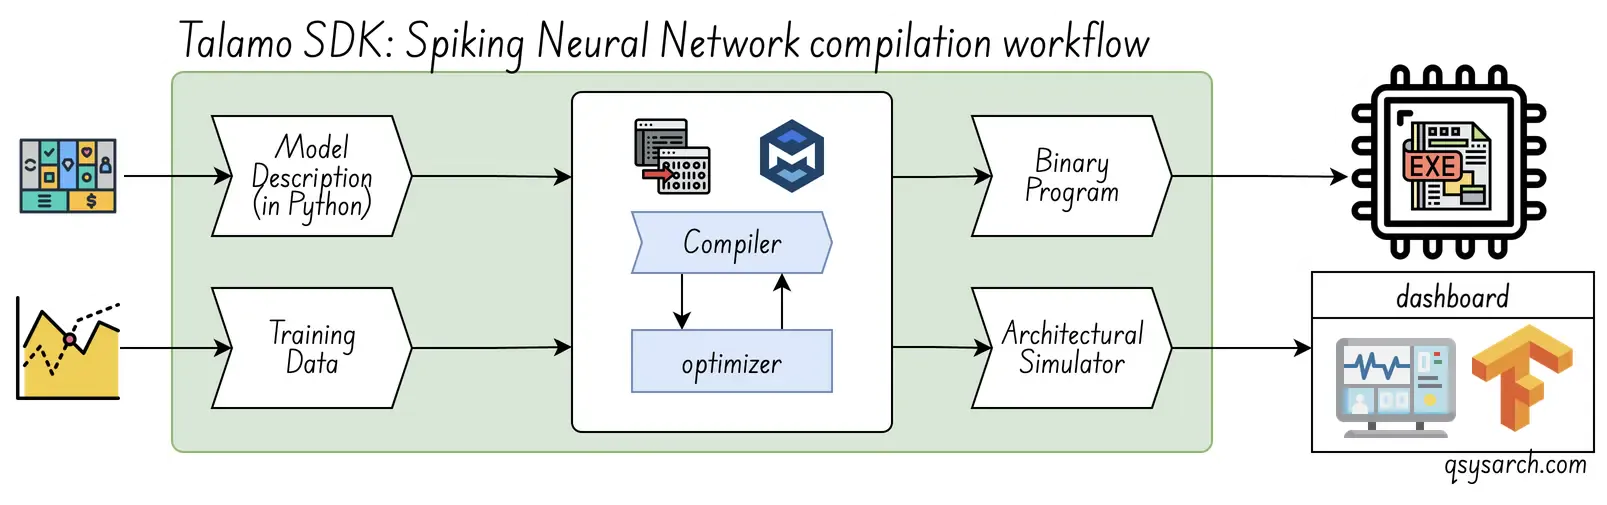
Odată ce programul binar a fost generat, se utilizează acest flux de lucru de execuție și urmează mai mult sau mai puțin procesul definit în brevetul WO2023242374A1.
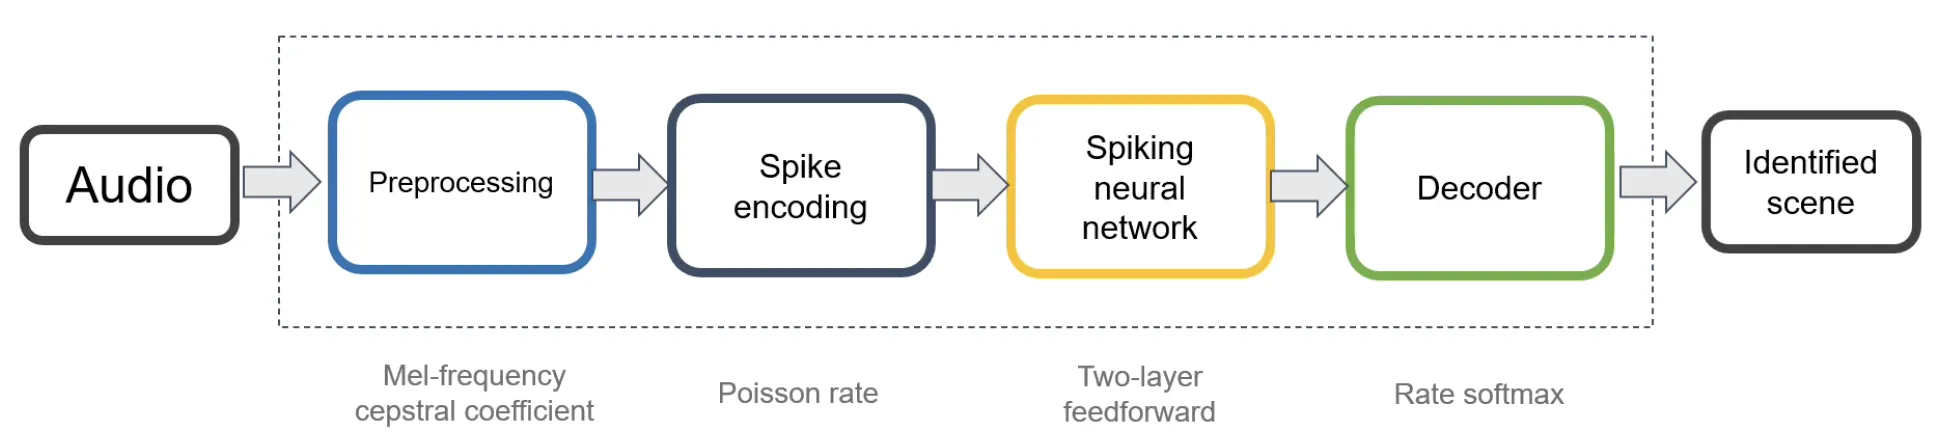
Hardware-ul Innatera include un RISC-V puternic, un GEM capabil și un accelerator de calcul SFU. Unii utilizatori avansați ar putea considera mai atractiv accesul bare metal la acest hardware, comparativ cu simpla încărcare a ponderilor într-o bibliotecă C ce poate fi direcționată către arhitectura Innatera.
Poate că oferirea unei forme de SDK pentru firmware open-source ar fi benefică. Alternativ, s-ar putea lua în considerare CudaNN, care să ofere o experiență de tip General Purpose Neural Processor Unit (GPNPU), la fel cum există Cuda-Q pentru industria cuantică. Precum și un NVNLink, similar cu NVQLink, care să permită rețele NPU la scară largă și arhitecturi hibride?
Poate că asta se înțelege prin drumul către succesul comercial al tehnologiilor neuromorfice : „abia odată cu apariția unor modele și instrumente simple de programare, simultan cu accesul API direct la hardware, procesoarele tensoriale au ajuns la o adoptare pe scară largă”. Trebuie doar să înlocuim procesoarele tensoriale cu unități de procesare neuromorfice (NPU)?
Pentru mine, aceasta se reduce la experiența utilizatorului (UX) și experiența dezvoltatorului (DX). Și cred cu tărie că ușurința în utilizare și experiența dezvoltatorului se numără printre factorii cheie, sau pilonii strategici, în crearea unor experiențe de produs cu adevărat remarcabile.
 (Credite imagine: archi monarch)
Aceasta încheie această scurtă prezentare a arhitecturii de nivel înalt a circuitelor integrate neuromorfice. Fără îndoială, această arhitectură hardware este o tehnologie alternativă, puternică, cu un potențial semnificativ. Totuși, s-ar putea argumenta că circuitelor integrate neuromorfice le lipsește o aplicație de succes. Dar nu este aceasta partea interesantă a circuitelor integrate neuromorfice? Înseamnă asta că lumea care le însoțește trebuie creată?
Cred cu tărie că echipa de la Innetera se numără printre „oamenii care văd lumea diferit”. Și, în contextul îngrijorărilor legate de apetitul vorace al centrelor de date bazate pe inteligență artificială pentru wați, nu sunt circuitele integrate neuromorfice un răspuns la întrebarea esențială: Cum să obținem mai multă valoare din mai puțină energie? Dacă acesta este cazul, atunci ce va fi necesar pentru a scala circuitele integrate neuromorfice pentru a atinge nivelul de putere de calcul echivalent cu cel necesar centrelor de date bazate pe inteligență artificială?
De asemenea, mă întreb dacă adăugarea unui pic de siliciu fotonică la SNN ar fi de vreun ajutor? Ar putea fi fie pentru calculul neuronal, dar și pentru a crea o rețea de interconectare la scară largă între circuitele integrate SNN.
Diagrame DrawIO utilizate în acest memo: