
Acest memoriu își propune să înțeleagă funcționarea internă a RDMA și, în special, ce este necesar pentru a crea o „placă de rețea compatibilă cu RDMA” care se interconectează cu un subsistem PCIe, cum ar fi connectX-7 de 200 GB integrat cu DGX Spark (imaginea din dreapta).
RDMA ca protocol „client-server”
Link to heading
Să începem acest memo cu o prezentare generală a RDMA ca protocol.
La configurarea canalelor de date RDMA, bufferele de memorie trebuie înregistrate la placa de rețea înainte de a putea fi utilizate. Procesul de înregistrare constă în următorii pași:
- Fixează memoria astfel încât să nu poată fi interschimbată de sistemul de operare.
Stocați informațiile de traducere a adreselor în placa de rețea.
Setați permisiunile pentru regiunea de memorie.
Creați chei locale și la distanță, utilizate de placa de rețea la executarea verbelor RDMA.
Comunicarea RDMA se bazează pe un set de trei cozi
SQ: Coadă de trimitere
RQ: Coadă de primire
CQ: Coadă de finalizare
Perechea de coadă RDMA sau „QP” se referă la coada de trimitere + coada de primire.
Elemente ale cozii de lucru RDMA
Link to heading
Aplicațiile lansează un job folosind o cerere de lucru, denumită și element de coadă de lucru (WQE). O cerere de lucru este o structură mică cu un pointer către un buffer:
Într-o coadă de trimitere – este un pointer către un mesaj care trebuie trimis.
Într-o coadă de primire – arată unde ar trebui plasat un mesaj primit.
Odată ce o cerere de lucru a fost finalizată, adaptorul creează un element de coadă de finalizare și îl pune în coada de finalizare.
Exemplu simplu de scriere RDMA
Link to heading
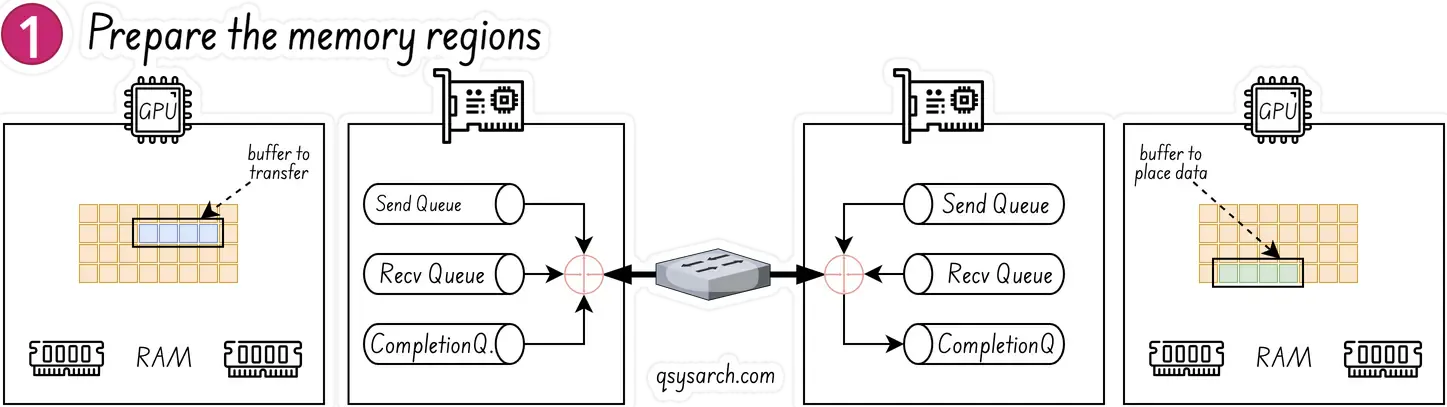
Entitățile expeditor (stânga) și receptor (dreapta) și-au creat perechile de cozi și cozile de finalizare, precum și au înregistrat regiuni în memorie pentru ca RDMA să aibă loc. Entitatea expeditoare identifică un buffer pe care dorește să îl mute către entitatea receptoră. Entitatea receptoră are un buffer gol alocat pentru plasarea datelor.
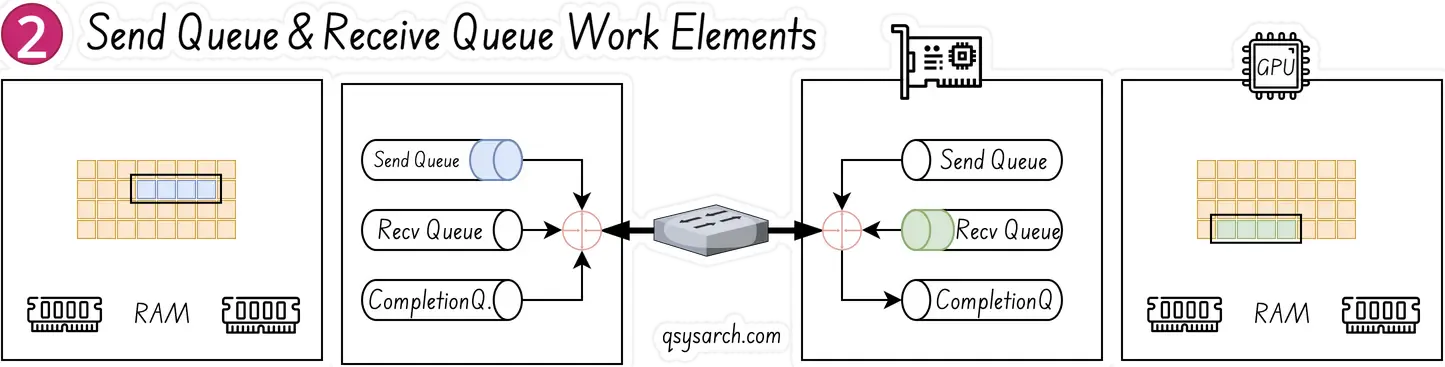
Entitatea receptoare din dreapta creează un element de coadă de lucru WQE WOOKIE și îl plasează în coada de recepție. Acest WQE conține un pointer către bufferul de memorie unde vor fi plasate datele. Entitatea transmițătoare din stânga creează, de asemenea, un WQE care indică bufferul din memoria sa care va fi transmis.
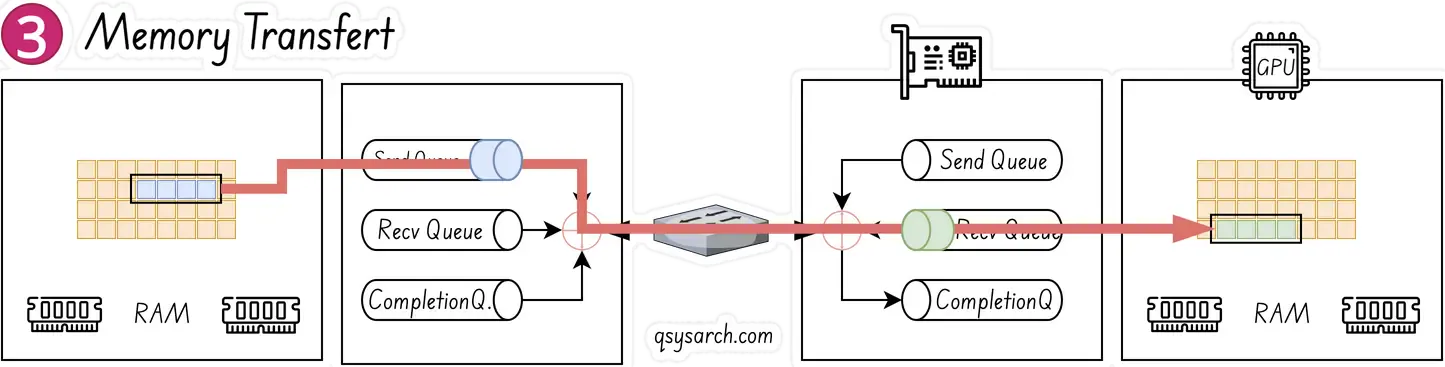
Placa de rețea (înțeleasă ca placă de rețea hardware compatibilă RDMA, cunoscută și sub numele de RNIC) efectuează constant un polling și caută WQE-uri în coada de trimitere - acest lucru se face fără a implica GPU-ul și CPU-ul, polling-ul afectând doar RNIC-ul. Odată ce un WQE este trimis de CPU, RNIC-ul îl consumă pe entitatea care trimite și începe să transmită datele din regiunea de memorie către entitatea receptoare. Când datele încep să sosească la entitatea receptoare, RNIC-ul va consuma WQE-ul din coada de recepție pentru a afla unde ar trebui să plaseze datele.
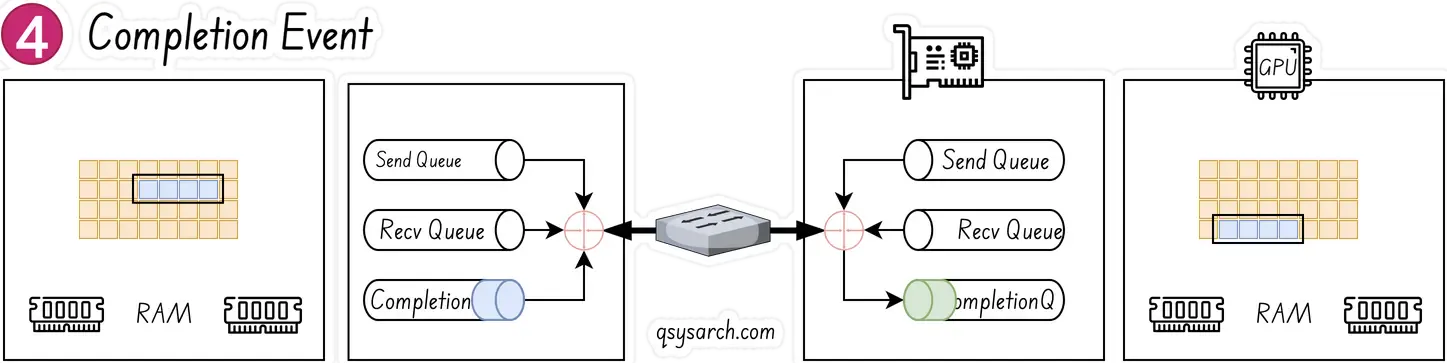
Ca ultim pas, când transferul datelor este complet, RNIC creează un eveniment de finalizare CQE „COOKIE”, care este plasat în coada de finalizare. Evenimentul indică faptul că tranzacția s-a finalizat. Pentru fiecare WQE consumat, se generează un CQE.
Credite imagine
Este important de observat că doar partea emițătorului este activă; receptorul este pasiv; partea pasivă nu efectuează nicio operațiune, nu utilizează cicluri CPU și nu primește nicio indicație că a avut loc o „citire” sau o „scriere”.
Pentru a emite o citire sau o scriere RDMA, solicitarea de lucru trebuie să includă:
adresa de memorie virtuală a părții la distanță
cheia de înregistrare a memoriei părții la distanță
Asta înseamnă că partea activă trebuie să obțină în prealabil adresa și cheia părții pasive.
RDMA din perspectiva pachetelor de rețea
Link to heading
Această parte se bazează pe excelenta lucrare a lui Toni Pasanen din Network Times
Aplicația de pe nodul de calcul al clientului (cunoscut și sub numele de CCN) începe stabilirea conexiunii prin trimiterea unui mesaj de solicitare de comunicare (REQ) către aplicația de pe nodul de calcul al serverului (SCN).
Mesajul REQ include un mijloc de identificare a RNIC-ului fizic și a portului:
- Identificatorul de comunicare locală (
LID) și identificatorul unic global pentru adaptorul de canal (GUID CA local). GUID CA local identifică placa de rețea RNIC, în timp ce ID-ul de comunicare local identifică portul de pe placa de rețea.
Mesajul REQ conține, de asemenea, toate metainformațiile despre perechile de coadă.
- Număr QP local (0x1234 5678)
Tipul serviciului QP (Conexiune nesigură)
Numărul de secvență al pachetului inițial (PSN: 0x1882)
Valoarea cheii de partiție (0x8012)
dimensiunea sarcinii utile (1024).
Mesajul REP confirmă primirea metadatelor QP. În final, clientul trimite înapoi un mesaj „Ready to Use” (RTU) pentru a confirma serverului că QP-ul este acum stabilit. După stabilirea sesiunii, aplicația de pe CCN poate începe procesul de scriere RDMA.

Terminologie:
CCN: nod de calcul client
SCN: nod de calcul al serverului
PD: Domeniu de protecție
L_Key, R_Key: taste locale și de la distanță
QP: Pereche de cozi (QP) = Coadă de trimitere + Coadă de primire.
CQ: Coadă de finalizare
RC: Conexiune fiabilă
UD: Datagramă nesigură
CERINȚĂ: CCN trimite ID-ul local, numărul QP, P_Key și PSN.
Răspuns: SCN răspunde cu ID-uri, informații QP și PSN.
RTU: Gata de utilizare: CCN confirmă conexiunea.
WR: Cerere de lucru
Mesaj de solicitare de lucru RDMA
Link to heading
De completat mai târziu - nu există nimic remarcabil în mesajele WR care să merite menționat aici - dacă doriți mai multe detalii, consultați Network Times și InfiniBand Transport Protocol de Toni Pasanen.
RDMA din perspectiva transferului de rețea
Link to heading
RDMA UC (Unreliable Connected - Conexiune nesigură) nu efectuează retransmisii; în schimb, se bazează pe aplicație pentru a gestiona fiabilitatea și a gestiona pachetele pierdute, deoarece UC este un serviciu de datagrame fără conexiune și nesigur. Placa de interfață de rețea (NIC) elimină pachetele fără a încerca retransmisia, iar aplicația este responsabilă pentru urmărirea și solicitarea din nou a datelor lipsă. Acest lucru este în contrast cu punctele cheie (QP) cu conexiune fiabilă (RC), unde hardware-ul de rețea se ocupă de retransmisii. Așadar, cum știe o aplicație RDMA UC dacă un pachet este pierdut?
- Detectarea pierderii de pachete la nivel de aplicație
Numere de secvență ale pachetelor (PSN): Aplicația atribuie un număr secvențial unic fiecărui pachet pe care îl trimite. Receptorul ține evidența acestor numere de secvență. Un gol în numerele de secvență indică faptul că unul sau mai multe pachete au fost pierdute.
Timeout-uri: Protocolul la nivel de aplicație poate implementa un mecanism de timeout. Dacă nu se primește un răspuns sau o confirmare într-un anumit interval de timp, aplicația presupune că pachetul a fost pierdut și inițiază o retransmisie.
- Recuperare pierderi de pachete la nivel de aplicație

Dacă receptorul detectează un pachet pierdut în secvență, trebuie să informeze expeditorul să retransmită acest pachet. Iar dacă și pachetul folosit pentru a informa expeditorul este pierdut, atunci se pot ajunge la situații destul de complexe.
- Timeout: Expeditorul se așteaptă ca receptorul să confirme primirea pachetelor. Dacă nu, expeditorul retrimite proactiv pachetul care nu a fost încă confirmat.
Trebuie întotdeauna să construim un modul de fiabilitate separat peste RDMA QP? Nu neapărat. În unele situații, este acceptabil să tratăm un pachet pierdut ca un motiv pentru a marca întreaga sesiune ca eșuată, în loc să retrimitem pur și simplu pachetul lipsă. Această abordare funcționează deoarece rețeaua subiacentă este de obicei suficient de fiabilă pentru a oferi o fiabilitate extrem de ridicată, cum ar fi o singură eroare la un trilion de pachete.
Controlul fluxului prioritar (PFC) și notificarea explicită a congestiei (ECN)
Link to heading
Protocolul UC RDMA nu știe în mod inerent dacă un pachet este pierdut, deoarece este un protocol nesigur, așadar pierderea pachetelor este gestionată de aplicație sau de un nivel superior. Garanția „fără pierderi” în RDMA este realizată prin tehnologii de rețea subiacente, cum ar fi Priority Flow Control (PFC) și Explicit Congestion Notification (ECN), care previn pierderile de pachete în primul rând.
Acest protocol încapsulează segmentul de date RDMA în segmentul de date UDP, adaugă antetul UDP, apoi antetul IP și, în final, antetul Ethernet, care este un pachet de date cu trei straturi. Acesta poate fi clasificat utilizând câmpul PCP din VLAN-ul Ethernet sau câmpul DSCP din antetul IP.
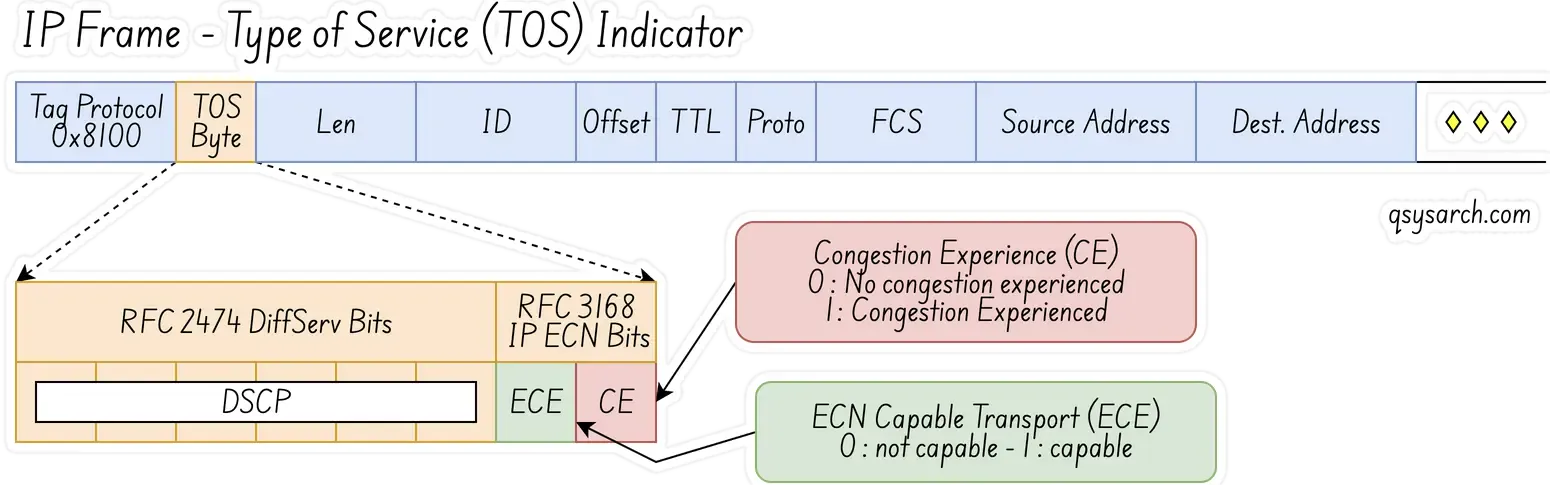
În termeni simpli, în cazul unei rețele de Nivel 2, PFC utilizează bitul PCP din VLAN pentru a distinge fluxurile de date. În cazul unei rețele de Nivel 3, PFC poate utiliza atât PCP, cât și DSCP, astfel încât diferite fluxuri de date să se poată bucura de un control independent al fluxului. În prezent, majoritatea centrelor de date utilizează rețele de Nivel 3, așadar utilizarea DSCP este mai avantajoasă decât PCP.
Credite imagine
 Analiza PCIe se bazează pe excelentul articol: SmartIO: Partajare dispozitive fără supraîncărcare prin intermediul rețelelor PCIe de la Dolphin.
Registre de adresă de bază PCIe
Link to heading
Caracteristica definitorie a PCIe este aceea că dispozitivele sunt mapate în același spațiu de adrese ca și procesorul (CPU) și memoria sistemului, așa cum se arată în figura din dreapta. Deoarece există această mapare, un procesor (CPU) poate citi și scrie în memoria dispozitivului în același mod în care ar accesa memoria sistemului. Aceasta este adesea denumită I/O mapată în memorie (MMIO).
La momentul inițializării, când sistemul verifică arborele PCIe, un interval de adrese de memorie este rezervat (de către BIOS sau kernel) pentru regiunile de memorie ale fiecărui dispozitiv. Această adresă rezervată este apoi scrisă în registrele de adrese de bază ale dispozitivului (BARs). Un dispozitiv poate avea până la șase BAR-uri.
PCIe utilizează întreruperi semnalizate prin mesaje (MSI) în loc de linii de întrerupere fizice. Dispozitivele care acceptă MSI trimit o scriere în memorie către procesor, utilizând o adresă și o sarcină utilă specifice furnizate de sistem. Procesorul citește această scriere în memorie și folosește informațiile pentru a genera o întrerupere.
MSI-X este o extensie a MSI care permite până la 2048 de vectori de întrerupere diferiți. Un avantaj este că o întrerupere MSI-X poate viza un anumit nucleu al procesorului în sistemele multi-core. De asemenea, diferiți vectori MSI-X pot semnala diferite tipuri de evenimente.
Design optimizat pentru ConnectX-8
Link to heading
[1] Comunicații GPU-GPU prin două socketuri CPU: În designul tradițional, această cale poate întâmpina blocaje la nivelul CPU-ului gazdă și între socketuri, limitându-se la 25 GB/s sau mai puțin, în funcție de utilizarea legăturii între CPU. În schimb, designul optimizat bazat pe CX8 permite o lățime de bandă IO de până la 50 GB/s per GPU pentru toate comunicările între GPU din cadrul clusterului, deoarece NCCL direcționează tot traficul direct prin rețea.
[2] Comunicare GPU-NIC: Arhitectura optimizată oferă fiecărui GPU o lățime de bandă de 50 GB/s într-o configurație GPU-NIC 2:1, indiferent dacă GPU-ul sau sistemul gazdă acceptă PCIe Gen5 sau Gen6.
[3] GPU-to-GPU prin același switch PCIe: Sistemele echipate cu PCIe Gen6 beneficiază de o lățime de bandă dublă față de Gen5, accelerând semnificativ transferurile GPU peer-to-peer prin același switch PCIe.
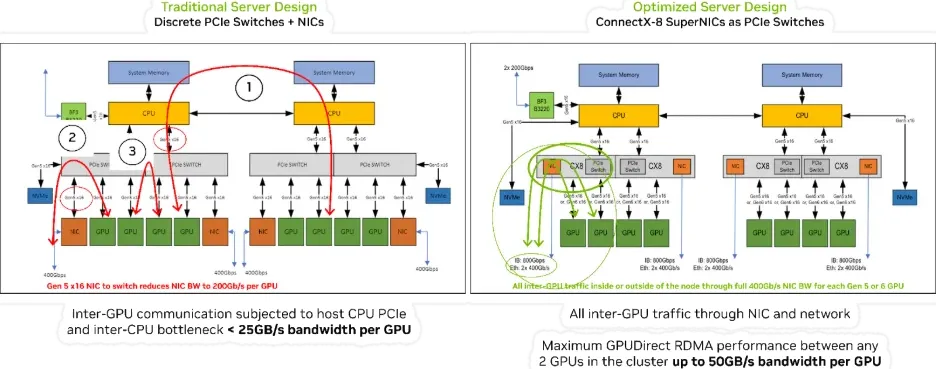
Referință: Arhitectura platformei NVIDIA ConnectX-8 SuperNICs
RDMA din perspectiva unei API-uri programatice
Link to heading
Această secțiune se bazează pe tutorialul Netdev 0x16 RDMA.
Creați obiectele necesare, inclusiv PD și CQ
struct ibv_pd *pd = ibv_alloc_pd(verbs_context);
if (!pd) { /* error handling… */ }

struct ibv_cq_init_attr_ex cq_attr = {
.cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
Alocă un buffer pentru a stoca date și înregistrează-l cu libibverbs:
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
Stabilirea conexiunii cu librdmacm
Link to heading
Similar cu socket-urile, cu o interfață asincronă bazată pe evenimente. (Nu este strict obligatoriu, dar oferă o abstractizare care acoperă mai multe transporturi) Mai întâi creați un „canal de evenimente”:
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
Ambele părți rezolvă adresa serverului:
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
Partea pasivă (SCN) creează și leagă un „ID” de ascultare și ascultă:
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
Partea activă creează ID-ul și rezolvă adresa serverului:
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
Bucla de evenimente pentru gestionarea evenimentelor de conexiune:
struct rdma_cm_event *event;
while (true) {
err = rdma_get_cm_event(test.channel, &event);
switch (event->event) {
case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
}
rdma_ack_cm_event(event);
}
Evenimente notabile de gestionat:
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
Postare primire cerere de lucru
Link to heading
Completați o listă de dispersie și o cerere de lucru în coadă pentru a primi coada:
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
Completați o listă de colectare și puneți cererea de lucru în coadă pentru a trimite coada:
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
Verificare neblocantă pentru intrările din coada de finalizare
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
end_flag = true;
/* consume cq->status, cq->wr_id, etc */
err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
RDMA dintr-o perspectivă directă a GPU-ului
Link to heading
Aici începe să devină …foarte… confuz. Care este relația dintre „GPUDirect RDMA” și RDMA? După cum am menționat într-o [postare] anterioară (/posts/the-confusing-world-of-rdma-and-infiniband/), documentația oficială de la Nvidia afirmă că nu există nicio relație! Pentru a înțelege motivul, trebuie să ne întoarcem la punctul de plecare, când era încă o tehnologie Mellanox, în jurul [2016] (https://github.com/Mellanox/nv_peer_memory/blame/master/README.md). Iată ce spunea specificația la momentul respectiv:
Cea mai recentă inovație în domeniul comunicațiilor GPU-GPU este GPUDirect RDMA. Această nouă tehnologie oferă o cale de date P2P (Peer-to-Peer) directă între memoria GPU și/de la dispozitivele NVIDIA HCA/NIC. Aceasta oferă o scădere semnificativă a latenței comunicării GPU-GPU și descarcă complet procesorul, eliminându-l din toate comunicațiile GPU-GPU din rețea.
Din specificațiile GPUNetIO (https://docs.nvidia.com/doca/sdk/doca+gpunetio/index.html#src-4012579584_id-.DOCAGPUNetIOv3.1.0-EnablingNIC-GPUMemoryInteraction), se menționează că pentru a activa interacțiunea dintre memoria NIC și GPU:
Pentru a permite plăcii de rețea să trimită și să primească pachete folosind memoria GPU, încărcați modulul kernel NVIDIA nvidia-peermem, de obicei inclus în instalarea CUDA Toolkit.
O aplicație de rețea de procesare a pachetelor GPU poate fi împărțită în două faze fundamentale:
- Faza de configurare pe CPU (configurarea dispozitivelor, alocarea memoriei, lansarea nucleelor CUDA…)
Faza căii de date în care GPU-ul și placa de rețea interacționează pentru a-și exercita funcțiile
În timpul fazei de configurare pe CPU, aplicațiile trebuie:
Lansează un kernel CUDA care transmite handler-ul GPU al obiectului pentru a lucra cu obiectul pe parcursul căii de date.
Din acest motiv, DOCA GPUNetIO este compus din două biblioteci:
libdoca_gpunetio cu funcții invocate de CPU pentru a pregăti GPU-ul, a aloca memorie și obiecte
- libdoca_gpunetio_device cu funcții invocate de GPU în cadrul kernel-urilor CUDA pe parcursul căii de date
Acesta este cel mai generic caz de utilizare al antetelor de pachete de tip „receive-and-analyze”. Conceput pentru a ține pasul cu traficul de rețea de intrare de 100 Gb/s, kernelul CUDA responsabil pentru traficul UDP dedică un bloc CUDA de 512 fire de execuție CUDA (fișierul gpu_kernels/receive_udp.cu) unei cozi de recepție Ethernet UDP diferite.
Bucla căii de date este:
- Primește pachete cu funcția GPUNetIO numită
doca_gpu_dev_eth_rxq_receive_block.
Fiecare fir de execuție CUDA procesează un subset al pachetelor primite.
- Preia buffer-ul DOCA care conține pachetul.
Analizați sarcina utilă a pachetului pentru a distinge pachetele DNS de alte pachete UDP generice.
- Ștergeți sarcina utilă a pachetului pentru a vă asigura că pachetele vechi nu sunt analizate din nou.
Fiecare bloc CUDA trimite statistici către firul de execuție al CPU folosind un semafor DOCA GPUNetIO.
Firul de execuție al procesorului verifică semafoarele pentru a obține statisticile și le afișează în consolă.
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
struct doca_gpu_eth_rxq *rxq0,
struct doca_gpu_eth_rxq *rxq1,
struct doca_gpu_eth_rxq *rxq2,
struct doca_gpu_eth_rxq *rxq3,
int sem_num,
struct doca_gpu_semaphore_gpu *sem0,
struct doca_gpu_semaphore_gpu *sem1,
struct doca_gpu_semaphore_gpu *sem2,
struct doca_gpu_semaphore_gpu *sem3)
{
__shared__ uint32_t rx_pkt_num;
__shared__ uint64_t rx_buf_idx;
__shared__ struct stats_udp stats_sh;

doca_error_t ret;
struct doca_gpu_eth_rxq *rxq = NULL;
struct doca_gpu_semaphore_gpu *sem = NULL;
struct doca_gpu_buf *buf_ptr;
struct stats_udp stats_thread;
struct stats_udp *stats_global;
struct eth_ip_udp_hdr *hdr;
uintptr_t buf_addr;
uint64_t buf_idx = 0;
uint32_t lane_id = threadIdx.x % WARP_SIZE;
uint8_t *payload;
uint32_t sem_idx = 0;

if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

if (threadIdx.x == 0) {
DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}
__syncthreads();

while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
stats_thread.dns = 0;

/* No need to impose packet limit here as we want the max number of packets every time */
ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
/* If any thread returns receive error, the whole execution stops */
if (ret != DOCA_SUCCESS) { ... }

if (rx_pkt_num == 0) continue;

buf_idx = threadIdx.x;
while (buf_idx < rx_pkt_num) {
doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
raw_to_udp(buf_addr, &hdr, &payload);

if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

/* Double-proof it's not reading old packets */
wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
buf_idx += blockDim.x;
}
__syncthreads();

for (int offset = 16; offset > 0; offset /= 2) {
stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
__syncwarp();
}

if (lane_id == 0) {
atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
}

__syncthreads();

if (threadIdx.x == 0 && rx_pkt_num > 0) {
ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
if (ret != DOCA_SUCCESS) { ... }

DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
__threadfence_system();

sem_idx = (sem_idx + 1) % sem_num;

DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}

__syncthreads();
}
}
În exemplul de mai sus, RDMA nu este de fapt implicat. GPUNetIO pur și simplu permite GPU-ului să proceseze direct datele pachetelor. Singura parte care seamănă cu RDMA este că pachetul se mută de la placa de rețea la GPU printr-un transfer DMA direct, ocolind memoria procesorului.
Înainte de a concluziona, rămâne un element de confuzie: DOCA RDMA. În secțiunea anterioară, am analizat DOCA GPUNetIO. Dar ce este DOCA RDMA și cum se compară cu API-ul „ibv” anterior, pe care l-am verificat anterior?
Răspunsul este simplu: DOCA RDMA este framework-ul software de la NVIDIA pentru efectuarea operațiunilor RDMA utilizând fie CPU-ul, fie un GPU. IBV este biblioteca tradițională InfiniBand Verbs de nivel scăzut, care face parte din API-ul standard pentru programarea hardware-ului InfiniBand și RoCE. Diferența cheie este că DOCA RDMA este un SDK de nivel superior, mai cuprinzător, care se bazează pe capabilitățile fundamentale ale interfeței Verbs, permițând accelerarea GPU și descărcarea sarcinilor RDMA de la CPU la GPU.
De exemplu, acesta este codul pentru trimiterea unui pachet RDMA:
doca_error_t rdma_send(struct rdma_config *cfg)
{
struct rdma_resources resources = {0};
union doca_data ctx_user_data = {0};
const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
doca_error_t result, tmp_result;

/* Allocating resources */
result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
doca_rdma_cap_task_send_is_supported,  &resources);

result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
rdma_send_error_callback, NUM_RDMA_TASKS);

result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

/* Include the program's resources in user data of context to be used in callbacks */
ctx_user_data.ptr = &(resources);
result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

/* Create DOCA buffer inventory */
result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

/* Start DOCA buffer inventory */
result = doca_buf_inventory_start(resources.buf_inventory);

/* Start RDMA context */
result = doca_ctx_start(resources.rdma_ctx);

/*
* Run the progress engine which will run the state machine defined in
* rdma_send_state_change_callback(). When the context moves to idle, the context change
* callback call will signal to stop running the progress engine. */
while (resources.run_pe_progress) {
if (doca_pe_progress(resources.pe) == 0)
nanosleep(&ts, &ts);
}

// ... cleanup
}
În afara tiparelor: Ce se întâmplă dacă nu este RDMA?
Link to heading
Am examinat diverse aspecte ale RDMA în secțiunea anterioară. Obiectivul final al RDMA este de a transfera date între procesoare, GPU-uri și stiva de control cuantic, cu o latență de câteva microsecunde. Există o mulțime de informații de transferat, fie că este vorba de datele de citire soft I/Q, eșantioanele de impulsuri de control („Unde”) sau doar configurația parametrică a impulsurilor, de obicei în contextul unei rețele neuronale. Există, de asemenea, nevoia de a transfera informații mai simple, cum ar fi sindroamele qubiților logici, și de a apela de la distanță un decodor QEC în unitatea de calcul. În acest ultim caz, este în regulă să numim o pisică „pisică” și să denumim acest comportament pur și simplu „apel de procedură la distanță” sau RPC-uri.
 Partea bună este că există multă literatură disponibilă despre RPC prin RDMA, cum ar fi mRPC, care prezintă valori foarte interesante ale latenței, bazate pe placa de rețea RoCE Mellanox Connect-X5 de 100 Gbps. Există confuzie în lucrare, deoarece se afirmă că „Pe RDMA, mRPC accelerează eRPC cu 1,3× și 1,4× în ceea ce privește latența mediană și respectiv coadă”, în timp ce tabelul indică faptul că eRPC este mai rapid decât mRPC. Dar, deocamdată, se poate presupune că valorile latenței sunt empiric posibile.
 Și mai interesant este studiul articolului privind continuarea publicației despre mRPC, unde un Compute Express Link (CXL) este utilizat pentru a crea un RPC și mai rapid, pe care îl numesc „HydraRPC”. Numerele vorbesc de la sine, consultați tabelul din dreapta. Întrebarea care trebuie pusă aici este cum va fi acest lucru peste 5 ani? În opinia mea, NVLink pare și el o oportunitate foarte atractivă…
Voila, mi-a luat mai mult timp să termin acest memo și cred că m-a ajutat să înțeleg puțin mai bine. Cred că confuzia dintre RDMA și GPUDirect provine din faptul că RDMA a fost dezvoltat inițial de Mellanox ca o pură îmbunătățire a rețelei. După ce Mellanox a fost achiziționată de Nvidia, a fost extinsă pentru a se „conecta” la GPU, dar această extensie nu a fost niciodată concepută ca un concept de la început și a ajuns să fie un add-on în ecosistemul DOCA.

References:
DrawIO diagrams used in this memo: