Această notă revine la elementele de bază ale GPU-ului. Se concentrează pe operațiunea de bază a învățării profunde: înmulțirea matricelor. Mai întâi, voi descrie implementarea de bază și academică. Apoi, voi analiza optimizările necesare pentru a utiliza GPU-ul eficient.
Înțelegerea multiplicatorului matricial naiv
Link to heading
Să începem cu acest exemplu simplu pe care îl găsiți adesea în manuale.
/**
* Kernel to perform matrix multiplication C = A × B
* A is of size N x M, B is M x N, and C is N x N
* Each thread computes one element of matrix C.
*/

__global__ void naive_matrix_multiply(float* A, float* B, float* C) {

// Calculate global row and column for this thread
int row = blockIdx.y /* 0...16 */ * blockDim.y + threadIdx.y;
int col = blockIdx.x /* 0...16 */ * blockDim.x + threadIdx.x;

if (row < N && col < N) {
float sum = 0.0f;
for (int k = 0; k < M; k++) {
// C[row][col] = sum(A[row][i] * B[i][col])
sum += A[row * N + k] * B[k * N + col];
}
C[row * N + col] = sum;
}

}
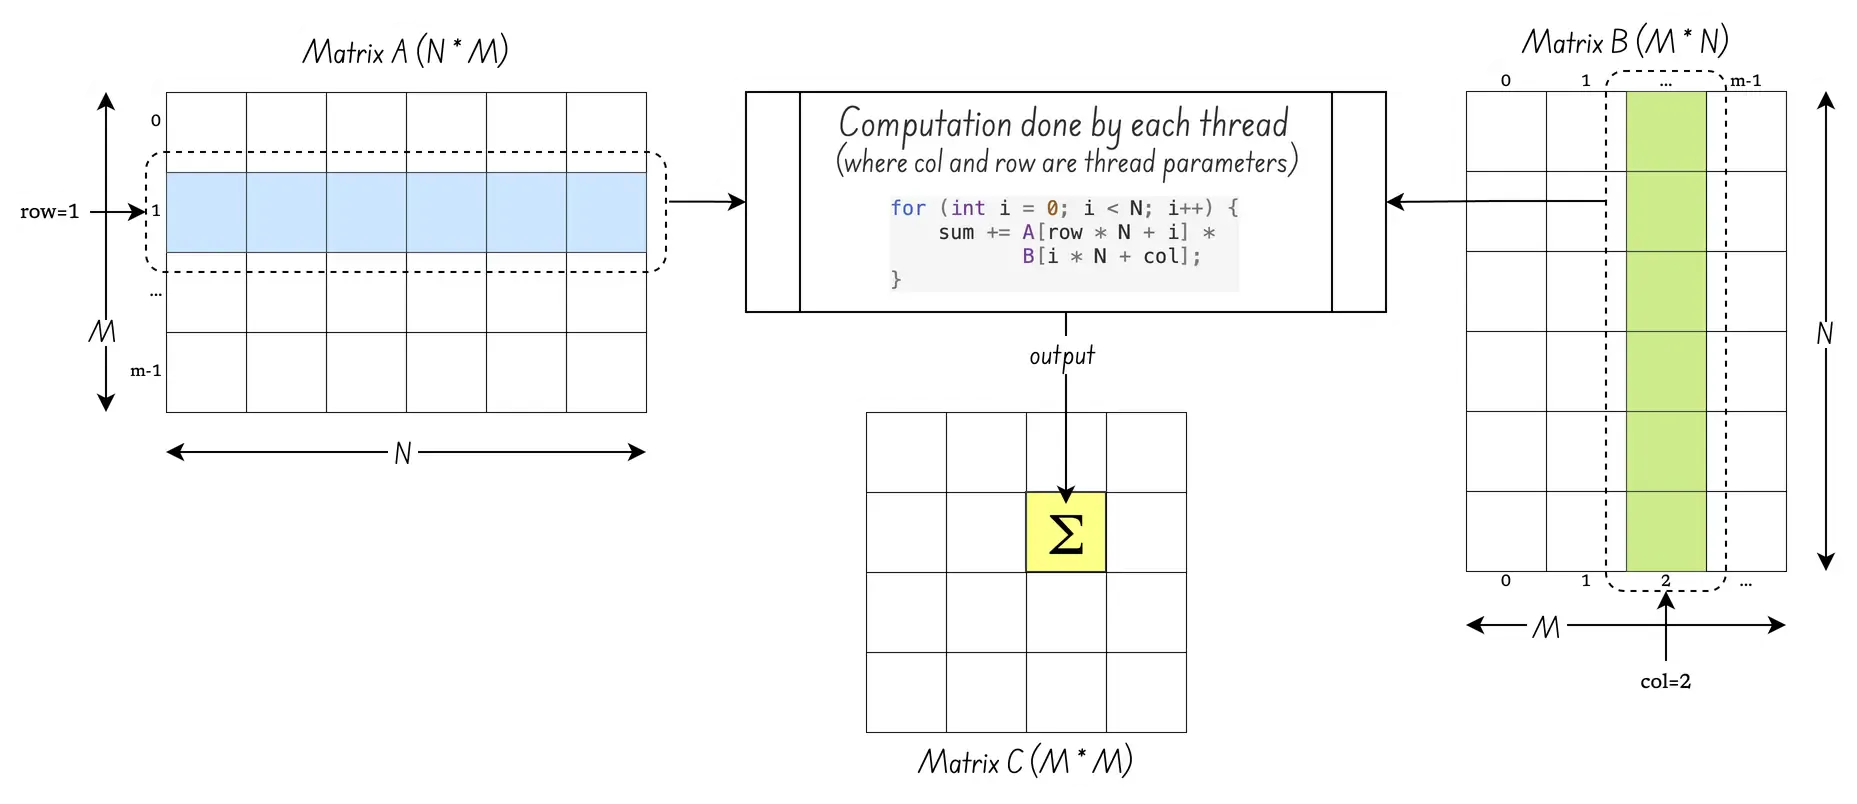
La prima vedere, acest lucru pare simplu. Trebuie doar să calculați fiecare celulă a matricei de ieșire C. Acest cod kernel pare să îndeplinească această funcție. Iată o reprezentare mai vizuală a kernelului.
Realitatea este puțin mai complexă. Cum înțelegi termenii blockIdx, blockDim și threadIdx? Pentru a înțelege acest lucru, reveniți la modul în care GPU-urile sunt organizate în jurul thread-urilor, warp-urilor și multiprocesoarelor de streaming. Iată o reprezentare orientativă a microarhitecturii GPU „Hopper” H100 de la Nvidia:
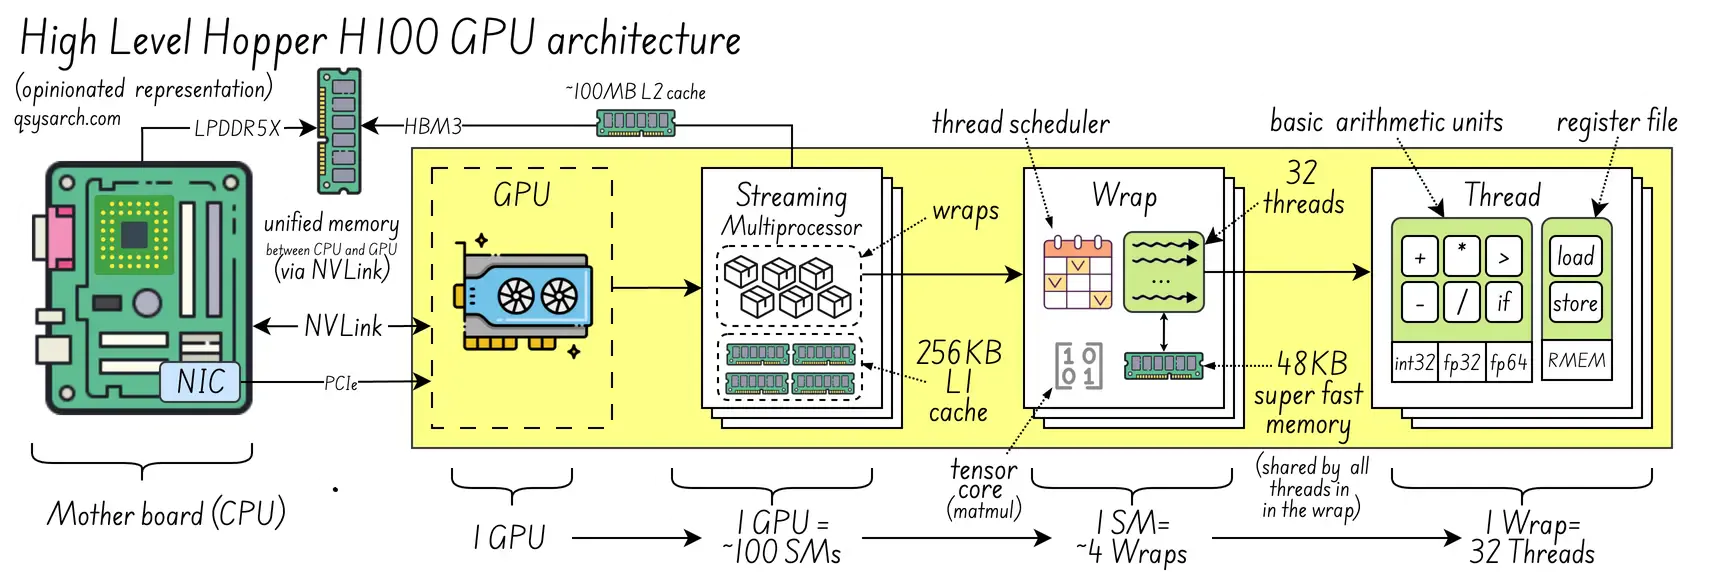
La nivel înalt:
1 GPU = 10 ~ 100 Multiprocesoare de streaming
1 Multiprocesoare de streaming = 4 ~ 64 Wrap-uri
1 înfășurare = 32 ~ 64 fire
Dar, așadar, cum este asociat fragmentul de cod care calculează sum cu un thread, un warp sau chiar un multiprocesor de streaming? Unde se iau deciziile de alocare și mapare? Mai întâi, trebuie să înțelegem cum este configurat kernelul:
int launch_kernel(float *d_A, *d_B, *d_C) {

dim3 block_size(16, 16);  // 16x16 threads per block -> 256 threads
dim3 grid_size(4, 4);     // 4x4 blocks per grid = 64 blocks

// 2. Launch the kernel with the specified dimensions
naive_matrix_multiply<<<grid_size, block_size>>>(d_A, d_B, d_C);
}
Această configurație ierarhică este mapată la hardware-ul GPU după cum urmează:

Cu această configurație, este posibil să se înmulțească o matrice cu dimensiunea N de 16*4 = 64. Ce se întâmplă dacă N ar fi 1000? În acest caz, trebuie doar să setați dimensiunea grilei la (1000+15)/16.
Dar maparea la Hardware-ul propriu-zis? Înseamnă asta că blocurile sunt alocate warp-urilor? Ce se întâmplă dacă numărul de thread-uri din bloc este mai mare decât numărul de thread-uri hardware?
Ei bine, aici trebuie introdusă planificarea GPU. Pe scurt, dacă sunt necesare mai multe thread-uri decât există thread-uri pe hardware-ul fizic, atunci GPU-ul va aloca mai multe warp-uri:
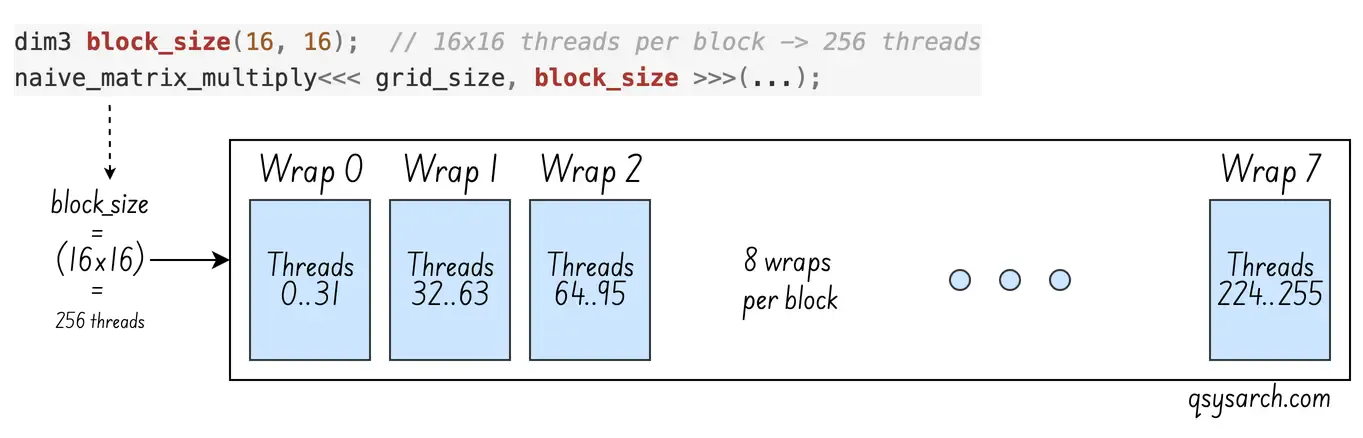
Următoarea întrebare este cum sunt asociate cele 8 warp-uri necesare per bloc cu multiprocesorul de streaming, mai ales atunci când un multiprocesor de streaming are mai puține warp-uri decât necesită un bloc. Răspunsul este fantastic: un multiprocesor de streaming poate avea mai mult de 4 warp-uri, pe care le programează alternativ: ori de câte ori un warp se oprește din cauza unui acces la memorie, multiprocesorul de streaming trece imediat la un alt warp. Aceasta se numește ascunderea latenței și este strategia fundamentală de performanță a GPU-ului. Fără aceasta, eficiența nu ar fi atât de mare.
Acum luați în considerare grid_size. Este grid_size mapat direct la resursele hardware? Nu este. Grila este doar un concept logic. Aceasta asigură că sunt disponibile suficiente blocuri pentru a acoperi matricea. grid_size nu corespunde hardware-ului. Blocurile sunt alocate fiecărui SM în timpul execuției dintr-o coadă.
Alocarea se bazează pe resursele necesare blocului (fiecare wrap are un număr limitat de registre și trebuie să se asigure că fiecare bloc are propriul set de registre alocate static).
Când un bloc și-a terminat calculul, SM-ul extrage un bloc nou din coada planificatorului pentru a-l înlocui pe cel finalizat. Odată atribuit, blocul este fixat la SM-ul respectiv, iar registrele sale sunt alocate pentru execuție.
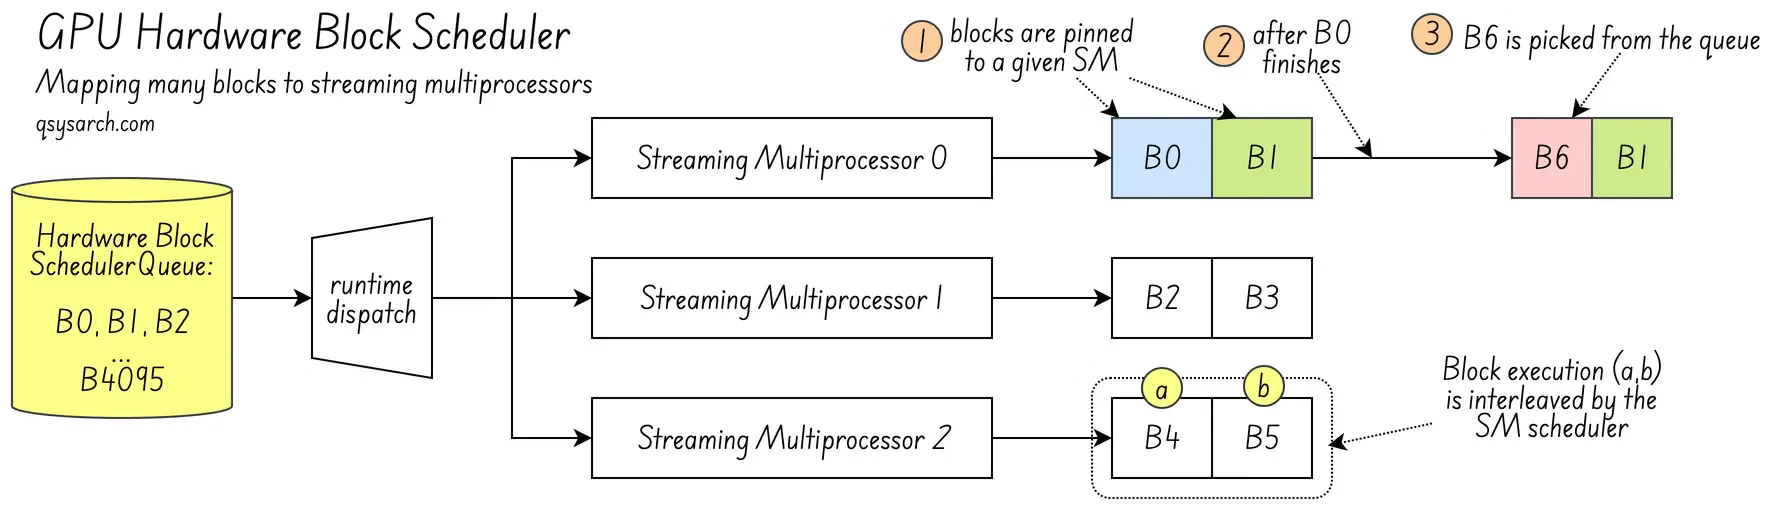
O ultimă întrebare: Blocurile sunt fixate la SM sau la warp? Este memoria utilizată de thread-uri în blocul alocat în warp? Dacă nu, SM-ul ar trebui să mute memoria între warp-uri. Da, în cadrul SM-ului, warp-urile unui bloc sunt fixate. Dacă blocul 0 este alocat warp-ului 0, iar blocul 1 warp-ului 1, acest lucru va fi întotdeauna cazul.
Îmbunătățirea multiplicatorului matricial naiv
Link to heading
Acum, că înțelegem execuția concurentă a firelor de execuție, să luăm în considerare nucleul naiv de înmulțire a matricelor. Toate firele de execuție concurează pentru accesul la memorie la matricile A și B. Fiecare fir de execuție transmite un rând întreg de A și o coloană de B din memoria globală. Nu există reutilizare. B este accesat pe coloane (B[i * N + col]), deci accesul în rafale și memorarea în cache a memoriei nu pot fi utilizate eficient.
Cel mai simplu răspuns este să utilizați memoria partajată. Mai întâi, încărcați o parte a matricei în memoria warp ca o placă de dimensiunea T*T. Apoi, permiteți thread-urilor să citească doar din această memorie locală. În acest fel, thread-urile nu concurează pentru accesul la memorie. Folosind intercalarea warp, SM se asigură că, în timp ce o memorie warp încarcă memoria în cache, cealaltă memorie warp calculează suma. Iată kernel-ul îmbunătățit:
__global__ void matmul_tiled(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x,  ty = threadIdx.y;
int row = blockIdx.y * T + ty;   // global row in C
int col = blockIdx.x * T + tx;   // global col in C

float accumulator = 0.0f;
for (int t = 0; t < M; t += T) {

// Read [T,T] subtile from matrix A and B.
// Assume that M and N are multiples of T (no bound check)
A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();   // wait all threads to finish loading

for (int k = 0; k < TILE; ++k)
accumulator += A_shared[ty][k] * B_shared[k][tx];

__syncthreads();   // all threads are ready to load again
}
C[row * N + col] = accumulator;
}
Pentru simplitate, presupun că M și N sunt multipli ai lui T, deci nu există nicio verificare legată la încărcarea matricei globale în A_shared și B_shared.
Există un pic de magie în acest cod. Toate thread-urile din bloc execută aceeași citire de memorie: A[row * M + t + tx]. Deoarece t este contiguu, thread-urile citesc din aceeași regiune de memorie. Acest lucru permite citirea în rafale de memorie și memorarea în cache. Primul thread inițiază citirea în rafale. Alte thread-uri folosesc memoria cache populată de acea rafală. B nu este transpus, deci trucul nu funcționează pentru B. De asemenea, __syncthreads() sincronizează thread-urile dintr-un bloc, asigurându-se că rulează pe același SM.
Cu multiplicatorul naiv anterior, dimensiunea blocului era arbitrară. Cu abordarea tiled, dimensiunea blocului trebuie să se potrivească cu dimensiunea tile-ului T*T, așa cum arată diagrama:
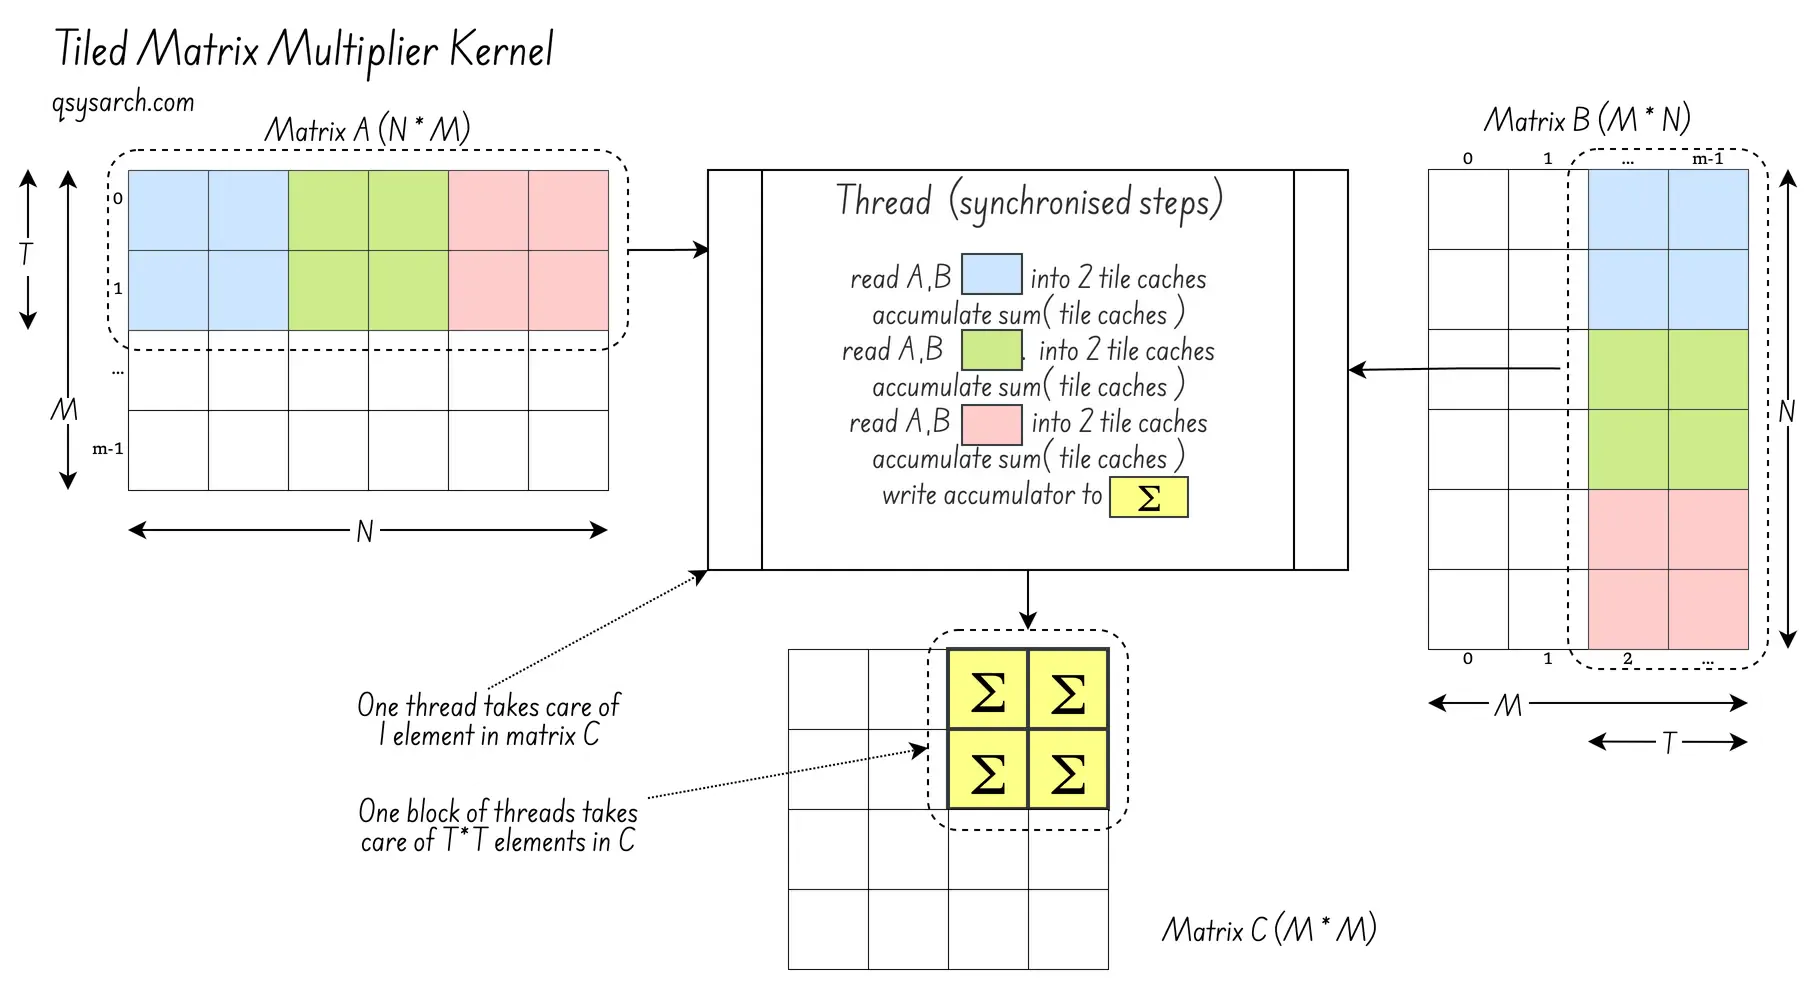
Abordarea tile permite încărcarea blocurilor în timp ce altele calculează. În acest caz, calculul poate fi ușor și poate dura mai puțin timp decât încărcarea memoriei. Pentru a rezolva această problemă, creșteți volumul de lucru per fir de execuție în timpul calculului. Fiecare fir de execuție poate calcula un set de elemente 2x2 în loc de unul singur. Cu K=2 și T un multiplu al lui K, acest lucru este posibil.
_global__ void matmul_tiled_and_coarsened(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x, ty = threadIdx.y;
int rowBase = blockIdx.y * T * K + ty;
int colBase = blockIdx.x * T * K + tx;

float accumulators[K][K]; // That's register memory

for (int t = 0; t < M; t += TILE) {

A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();

for (int k = 0; k < TILE; ++k)
for (int wr = 0; wr < K; ++wr)
for (int wc = 0; wc < K; ++wc)
acc[wr][wc] += A_shared[ty + wr * (T/K)][k] * B_shared[k][tx + wc * (T/K)];

__syncthreads();
}

// Write out the T×T accumulated result
for (int wr = 0; wr < T; ++wr)
for (int wc = 0; wc < T; ++wc) {
int r = rowBase + wr * (T/K);
int c = colBase + wc * (T/K);
C[r * N + c] = acc[wr][wc];
}
}
Voila. Practic, așa funcționează o unitate GEMM (Înmulțire Matriceală Generală)!
Apoi, ar trebui să introduc hardware special, cum ar fi Tensor Core (NVIDIA) sau Matrix Fused Multiply-Add (AMD). Acestea sunt unități specializate în multiprocesorul de streaming care calculează multiplicările acumulate T*T*K. Voi păstra asta pentru o notă ulterioară!
References:
DrawIO diagrams used in this memo: