Când se compilează pentru GPU-uri NVIDIA, CUDA este adesea considerat framework-ul de compilare de referință. Dar cum funcționează compilatorul de fapt? Ce fel de arhitectură a seturilor de instrucțiuni, sau ISA, trebuie să genereze compilatorul atunci când creează un „executabil” pentru GPU? Și cum funcționează compilatorul de fapt? Ce fel de arhitectură este utilizată pentru a genera cod care poate fi lansat de pe un CPU și executat pe un GPU?
Această notă de duminică dimineață își propune să fie o prezentare generală a arhitecturii compilatorului GPU NVIDIA. Acoperă setul de instrucțiuni GPU, compilatorul NVCC din framework-ul CUDA și, în final, arhitecturi alternative care vizează setul de instrucțiuni GPU.
Arhitectură GPU de nivel scăzut
Link to heading
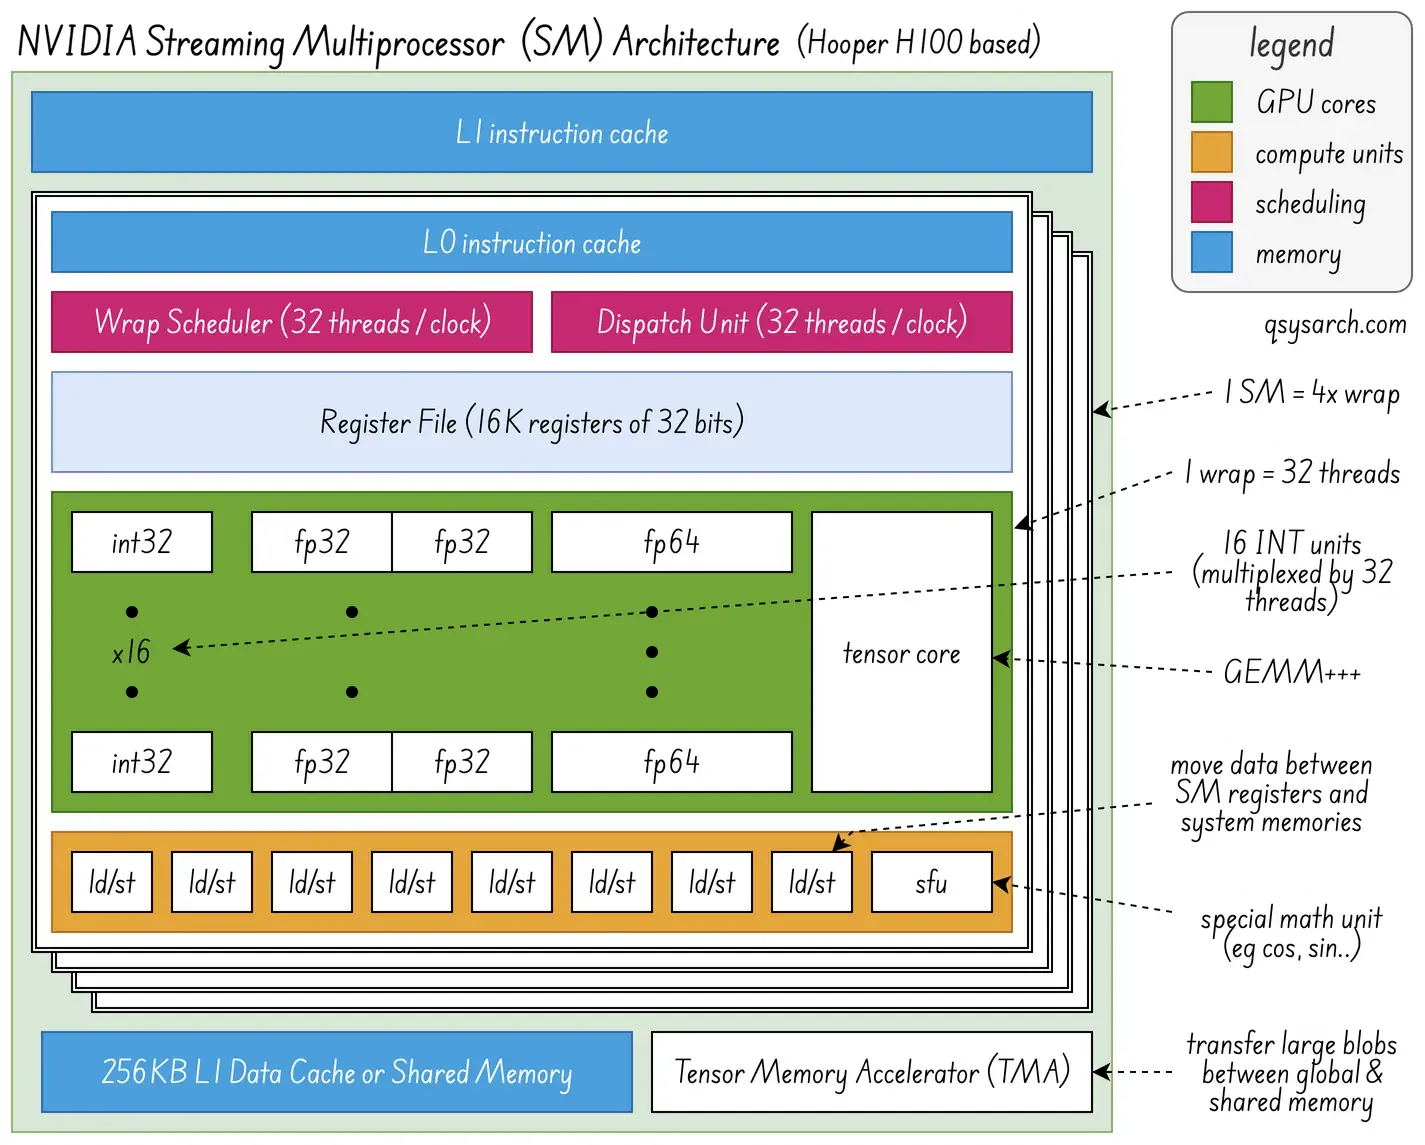
Când țintim un dispozitiv precum un GPU, avem nevoie de un set de instrucțiuni pentru a-l programa. În cazul NVIDIA, acest dispozitiv este multiprocesorul de streaming (SM) reprezentat în diagrama din dreapta. Ceea ce este interesant în diagramă este faptul că există multe unități concurente, cum ar fi sumatoarele IN32, unitatea cu funcții speciale, nucleul tensorial GEMM+++, și că compilatorul ar trebui să se asigure că acestea sunt utilizate (pipelined) în cel mai eficient mod (unde eficiența este definită ca minimizarea timpului de inactivitate).
Aceasta este terminologia utilizată:
ISA (Arhitectura Setului de Instrucțiuni): set de instrucțiuni.
Cod mașină: Reprezentare compactă și binară a instrucțiunilor
Asamblare (limbaj): reprezentare textuală mai puțin compactă a instrucțiunilor
Există două ISA-uri pentru GPU-urile NVIDIA:
PTX: Execuție paralelă pe fire de execuție - Asamblare intermediară utilizată la compilarea kernelurilor Cuda.
SASS: Streaming ASSembly. Asamblare de nivel inferior, specifică fiecărei arhitecturi GPU.
Să presupunem că vrem să compilăm acest kernel:
__global__ void normalizeVector(float* x, float* y, float* z, int n)
{
int i = blockIdx.x * blockDim.x + threadIdx.x;

float vx = x[i], vy = y[i];
float len2 = vx*vx + vy*vy;
float invLen = rsqrtf(len2);  // Use SFU fast reciprocal square root
z[i] = invLen; // Normalized length
}
Magia aici constă în faptul că rsqrtf ar trebui trimis către canalul SFU. Cum funcționează acest lucru? Linia float invLen = rsqrtf(len2); este convertită în PTX ca rsqrt.approx.ftz.f32 și apoi în SASS ca MUFU.RSQ, așa cum se arată în imaginea de mai jos de la [godbolt](https://godbolt.org/#g:!((g:!((g:!((h:codeEditor,i:(filename:'1',fontScale:14,fontUsePx:'0',j:1,lang:cuda,selection:(endColumn:2,endLineNumber:15,positionColumn:2,positionLineNumber:15,selectionStartColumn:2,selectionStartL ineNumber:15,startColumn:2,startLineNumber:15),source:’global+void+normalizeVector(float*+x,+float*+y,+float*+z,+int+n)%0A%7B%0A++++int+i+%3D+blockIdx.x++blockDim.x+%2B+threadIdx.x%3B%0A%0A++++float+vx+%3D+x%5Bi%5D%3B%0A++++float +vy+%3D+y%5Bi%5D%3B%0A++++float+len2+%3D+vxvx+%2B+vyvy%3B%0A%0A++++//+Utilizați+SFU+rapid+reciproc+rădăcină+pătrată%0A++++flo at+invLen+%3D+rsqrtf(len2)%3B+%0A%0A++++//+Normalizarea+vectorului%0A++++x%5Bi%5D+%3D+vx++invLen%3B%0A++++y%5Bi%5D+%3D+ vy+*+invLen%3B%0A%7D’),l:‘5’,n:‘0’,o:‘CUDA+C%2B%2B+source+%231’,t:‘0’)),k:33.333333333333336,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:compiler,i:(compiler:nvcc130u2,filters:(b:‘0’,binary:‘1’,binaryObject:‘1’,commentOnly:‘0’,debugCalls:‘1’, demangle:‘0’,directive:‘0’,execute:‘1’,intel:‘0’,libraryCode:‘0’,trim:‘1’,verboseDemangling:‘0’),flagsViewOpen:‘1’,fontScale:14,fontUsePx:‘0’,j:1,lang:cuda,libs:!(),options:’-arch+sm_90+-use_fast_math+-O3’,overrides:!(),selection:(en dColumn:1,endLineNumber:1,positionColumn:1,positionLineNumber:1,selectionStartColumn:1,selectionStartLineNumber:1,startColumn:1,startLineNumber:1),source:1),l:‘5’,n:‘0’,o:’+NVCC+13.0.2+(Editor+%231)’,t:‘0’)),k:33.333333333333336,l:‘4’ ,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:device,i:(compilerName:‘NVCC+13.0.2’,device:‘SASS+(sm_90)’,editorid:1,fontScale:14,fontUsePx:‘0’,j:1,selection:(endColumn:6,endLineNumber:21,positionColumn:1,positionLineNumber:1,selectionStartColumn:6,s electionStartLineNumber:21,startColumn:1,startLineNumber:1),treeid:0),l:‘5’,n:‘0’,o:‘Device+Viewer+NVCC+13.0.2+(Editor+%231,+Compiler+%231)’,t:‘0’)),k:33.33333333333333,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’)),l:‘2’,n:‘0’,o:’’,t:‘0’)),version:4).
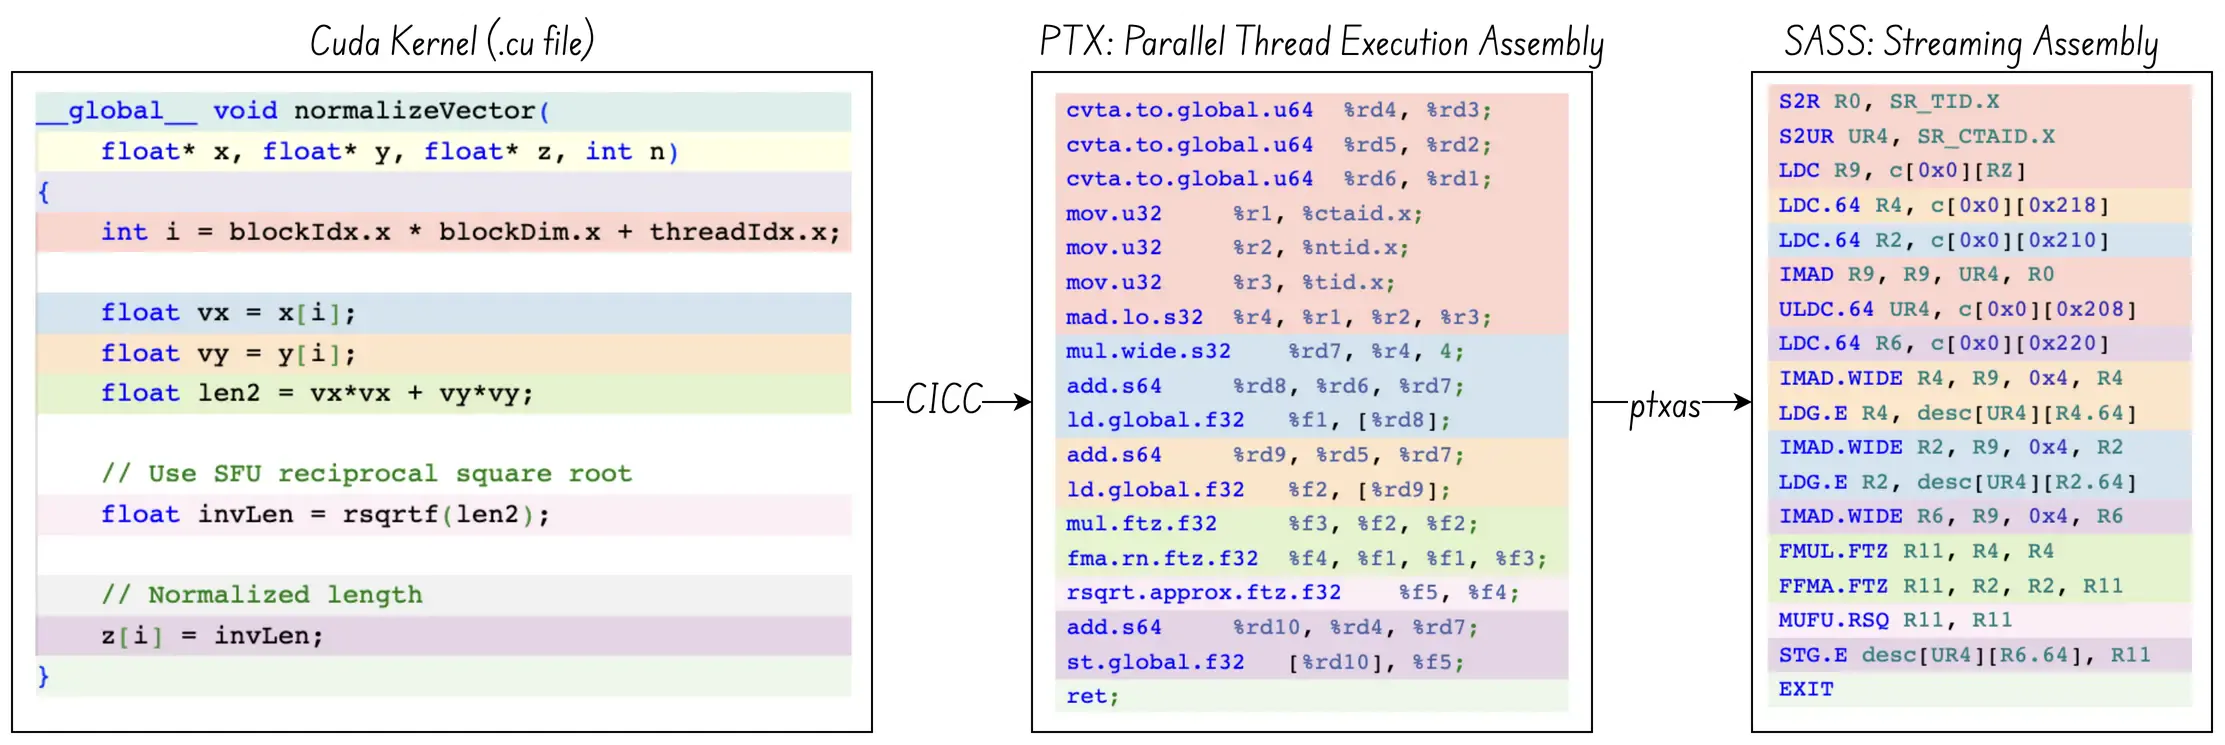
MUFU înseamnă unitate multifuncțională, cunoscută și sub numele de SFU, unitatea cu funcții speciale. MUFU.RSQ trimite registrul prin „conducta” Root Square a unității SFU. Există multe alte instrucțiuni în ansamblul SASS, cum ar fi FMUL (Fused Multiply) sau FFMA (Fused Multiply and Accumulate), care sunt în schimb expediate către unitatea centrală tensorial. Unitatea de expediere este responsabilă pentru trimiterea instrucțiunilor către unitatea corectă a conductei.
Există trei lucruri care merită observate:
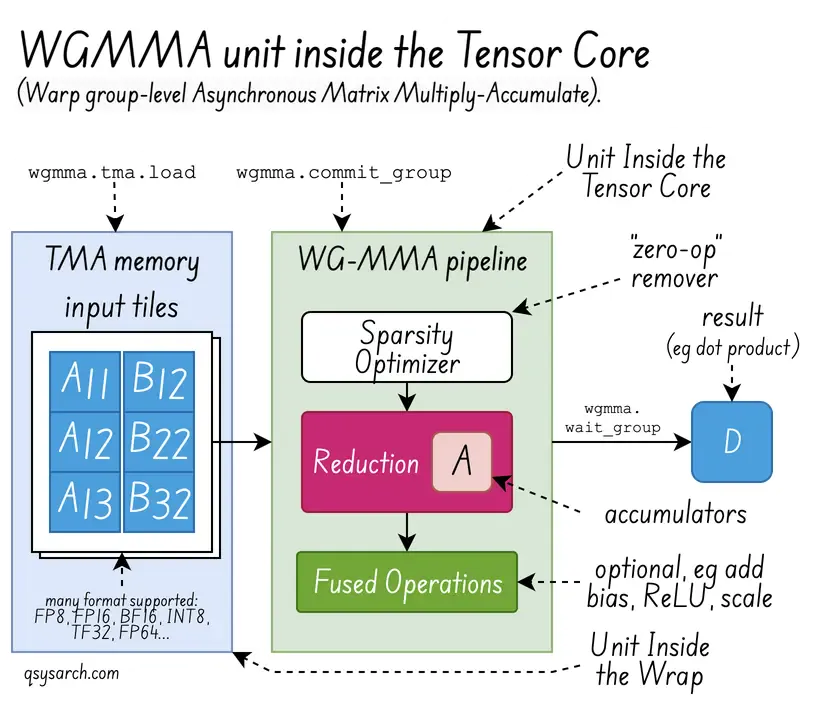
Tensorul este un nucleu mult mai mare decât un multiplicator matricial general (GEMM): De exemplu, poate efectua operații de reducere (sumă, min/max, produs scalar) prin intermediul unei unități MMA (multiplicare-acumulare a matricei) din interiorul nucleului tensorial.
Diferența dintre o unitate INT32 și un registru: Unitatea este responsabilă pentru calcul (de exemplu, ADD, SHIFT, XOR, … sau, mai general, operații aritmetice sau ALU), în timp ce a doua este responsabilă pentru stocarea valorilor.
Există doar 16 unități INT32, dar 32 de fire de execuție. Aceasta nu este o greșeală: motivul este că planificatorul warp va comuta între două fire de execuție setate în fiecare ciclu. Deci, în ciclul 0, unitățile vor efectua operațiuni ALU pentru fire de execuție de la 0 la 15, iar în ciclul 1, pentru fire de execuție de la 16 la 31.
Instrucțiunile de multiplicare-acumulare a matricei de nivel Warpgroup asincrone (WGMMA) sunt destul de puternice. Puteți citi mai multe în documentul NVIDIA, precum și în fantasticul blog de la Aleksa Gordić.
Arhitectura compilatorului NVIDIA CUDA
Link to heading
Acum că înțelegem puțin mai multe despre ISA-ul de nivel scăzut al GPU-ului pentru programarea multiprocesorului de streaming GPU, haideți să încercăm să înțelegem cum sunt compilate kernelurile C++ de nivel înalt în SASS. Știm că compilatorul folosit pentru a converti kernelurile CUDA (fișiere .cu) în PTX se numește NVCC.
Deci, care este diferența dintre NVCC și LLVM? NVCC este un driver de compilare specializat care folosește infrastructura de compilare open-source LLVM ca back-end. În schimb, LLVM este un framework de compilare flexibil, mai degrabă decât un compilator gata de utilizare, precum NVCC.
Driver Program: NVCC este un driver care gestionează procesul de compilare a codului CUDA C/C++. Acesta separă codul gazdă (CPU) de codul dispozitivului (GPU).
Lanț de instrumente: NVCC este un lanț de instrumente care folosește un compilator C++ gazdă (de exemplu, GCC/Clang pe Linux) pentru codul CPU și un compilator intern specific NVIDIA (de exemplu, CICC) pentru codul GPU (PTX și SASS).
Fișiere binare grase: NVCC produce de obicei „fișiere binare grase” care includ atât executabilul gazdă, cât și codul GPU compilat, adesea cu versiuni multiple pentru diferite arhitecturi GPU.
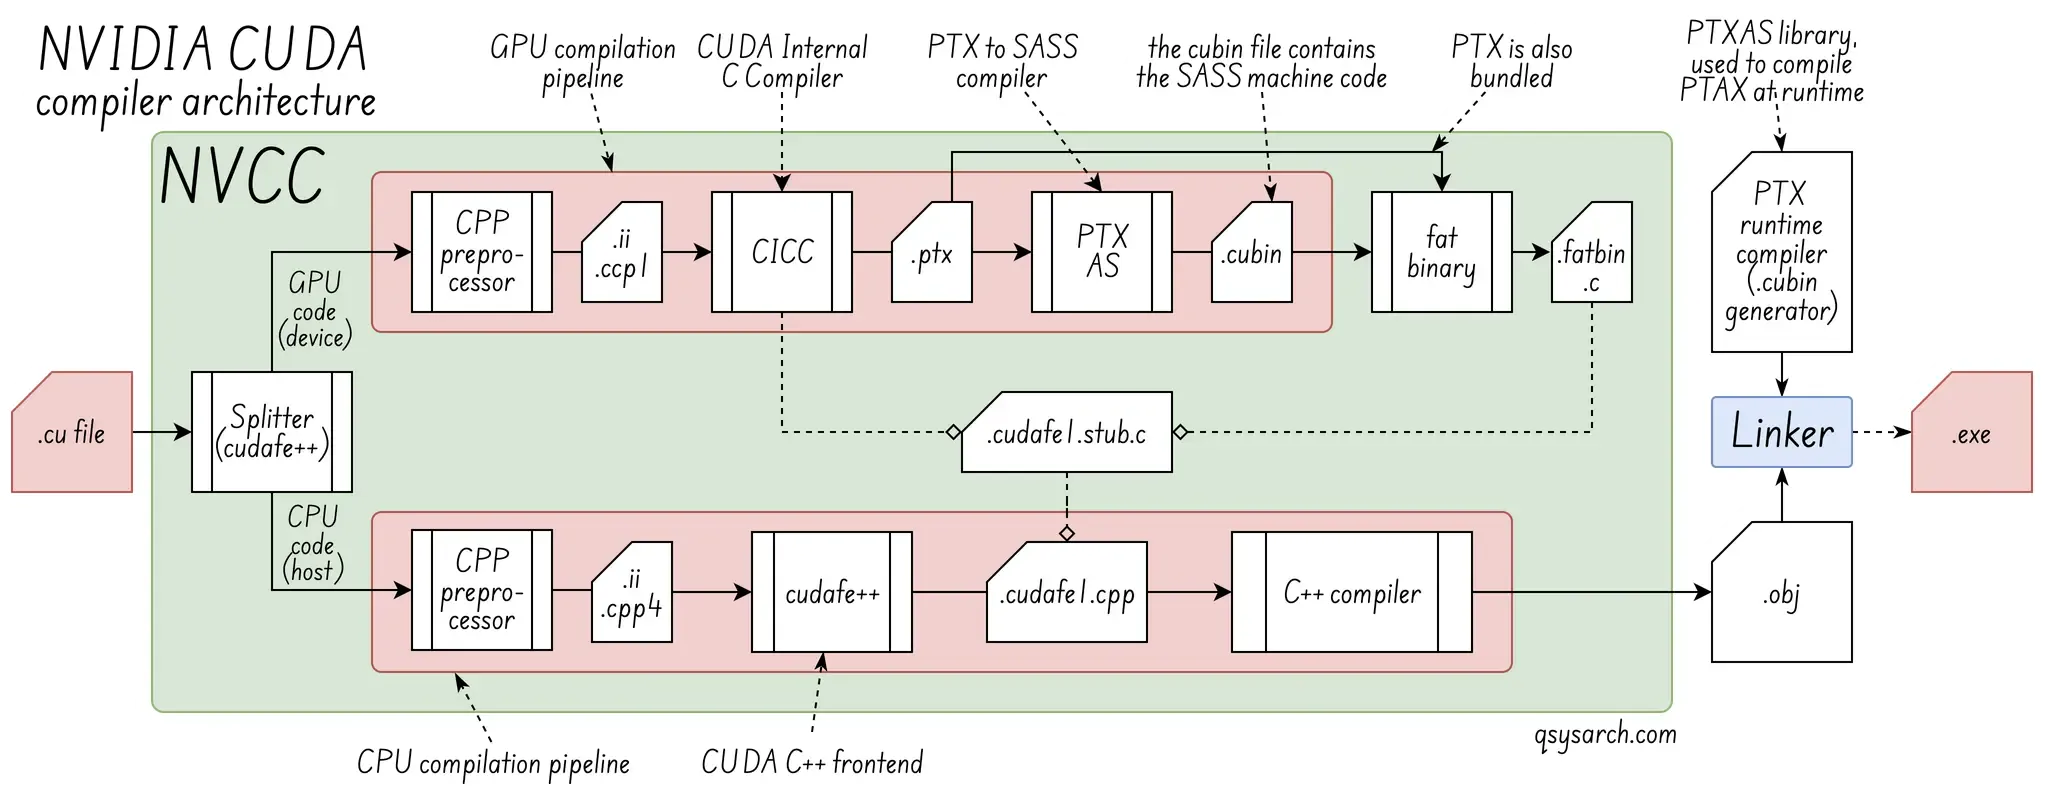
Framework: LLVM este o colecție de tehnologii de compilare, biblioteci și instrumente gratuite, deschise, modulare și reutilizabile, concepute pentru a construi o gamă largă de compilatoare și lanțuri de instrumente pentru limbaje de programare.
Reprezentare Intermediară (IR): LLVM IR este un „strat intermediar” agnostic față de mașină, care acționează ca legătură universală între front-end-uri (C++, Go…) și back-end-uri ISA (x86, ARM…).
Optimizare: Optimizatorul LLVM aplică diverse îmbunătățiri de performanță (cum ar fi desfășurarea buclelor și eliminarea codului mort) la IR, indiferent de limbajul sursă sau arhitectura țintă.
Este demn de remarcat faptul că LLVM poate compila CUDA: front-end-ul Clang (parte a proiectului LLVM) poate gestiona cod CUDA cu back-end-ul LLVM PTX, fără a necesita driverul nvcc.
Arhitectura compilatorului Triton
Link to heading
Limbajul Triton este un limbaj specific domeniului (DSL) puternic, bazat pe Python, conceput pentru a ajuta la crearea de algoritmi vectorizați de nivel înalt, care pot fi compilați în cod paralelizat eficient pentru ținte GPU.
Acesta este un exemplu al celui mai simplu kernel, care încarcă date dintr-un bloc de memorie și le scrie într-un alt bloc. Valoarea lui offsets este [pid*BLOCK_SIZE….(pid+1)*BLOCK_SIZE-1]. Magia, care nu este arătată în acest fragment, constă în faptul că Triton poate opera eficient asupra vectorului v, de exemplu efectuând operațiuni matematice.
import triton.language as tl

@triton.jit
def move_kernel(in_ptr, out_ptr, BLOCK_SIZE: tl.constexpr):
pid = tl.program_id(axis=0)
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
v = tl.load(x_ptr + offsets)
tl.store(output_ptr + offsets, v)
Triton nu se limitează la vectori unidimensionali și poate face față mai multor dimensiuni folosind tensori. De exemplu:
import triton.language as tl

@triton.jit
def load_2d_tensor( input_ptr, output_ptr,
stride_row, stride_col,  # Stride of the input tensor (elements per row, elements per column)
M , N , # Number of rows and columns
BLOCK_SIZE_M,BLOCK_SIZE_N, # Block size for rows and columns
):
# X and Y tile position
pid_m, pid_n = tl.program_id(axis=0), tl.program_id(axis=1)
# Ptr in memory based on the stride
base_ptr = input_ptr + (pid_m * BLOCK_SIZE_M * stride_row) + (pid_n * BLOCK_SIZE_N * stride_col)
# Offsets for X and Y indices
offs_m, offs_n = tl.arange(0, BLOCK_SIZE_M), tl.arange(0, BLOCK_SIZE_N)
offsets_2d = (offs_m[:, None] * stride_row) + (offs_n[None, :] * stride_col)
# 2D loading ...that's magic!
loaded_2d_tensor = tl.load(base_ptr + offsets_2d)
return loaded_2d_tensor
Comparativ cu CUDA, Triton poate fi văzut ca o abstracție de nivel superior, dedicată construirii nucleelor de rețele neuronale (datorită abordării blocurilor tensoriale) și care poate genera cod GPU eficient, vectorizat și paralel. Triton suportă, de asemenea, mai multe GPU-uri backend:
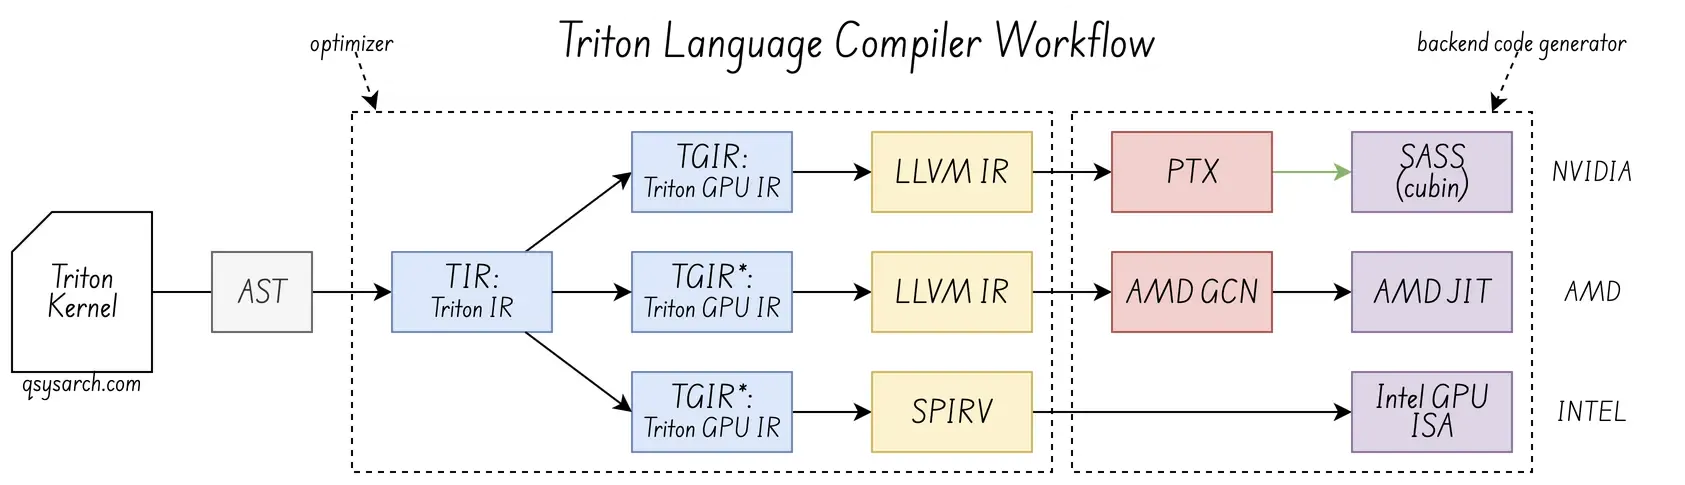
Triton nu folosește propriul parser de limbaj. În schimb, se bazează pe runtime-ul și AST-ul Python, apoi convertește acel AST în propriile reprezentări intermediare, TIR și TGIR, înainte de a genera cod GPU. Legătura dintre compilatorul backend CUDA și compilatorul front-end Triton este LLVMIR universal, iar pentru GPU-urile Intel se bazează pe SPIRV (deși nu sunt sigur dacă TGIR este redus direct la SPIRV, mai degrabă decât să treacă prin LLVMIR-ul intermediar).
Am scris „algoritmi vectorizați”, deși conceptul central este mai concentrat pe modele tiled, la nivel de bloc:
 Tiling-ul este mecanismul principal. Modelul mental al lui Triton se învârte în jurul operațiunilor de programare pe submatrici multidimensionale mici, de formă statică, sau „tile”, pe care compilatorul le paralelizează automat între nucleele GPU.
Vectorizarea, văzută ca încărcarea/stocarea mai multor elemente de date într-o singură instrucțiune, este o optimizare: compilatorul o folosește ca o strategie cheie de optimizare internă pentru a implementa eficient aceste plăci pe hardware-ul subiacent. Acest concept se aliniază cu strategiile de împărțire imbricată (vezi figura din dreapta), care vizează descompunerea plăcilor în micro-plăci și, în cele din urmă, nano-plăci pentru a se potrivi cât mai strict posibil capacităților de calcul și ierarhiei de memorie a unei mașini.
Triton Language Etape de coborâre până la Streaming Assembly
Link to heading
Să vedem cum instrucțiunea de nivel înalt tt.load în limbajul triton este redusă la SASS. (Pentru cititor: Codul de mai jos este pseudocod și nu funcționează ca atare)
Etapa inițială, după analizarea AST-ului Python, este Triton IR (TIR, un dialect MLIR), independent de mașină. La acest nivel, o operație tt.load este definită pe o dală, iar operația tt.load este o instrucțiune de nivel înalt, neoptimizată, care exprimă o încărcare de memorie a unei dale întregi. Dala poate fi o singură matrice, dar poate fi și o matrice 2D sau chiar una cu orice dimensiuni.
// simplified, illustrative TTIR fragment for 2 dimensionnal array
// load of 32 bits floating point values (without masks)
%ptrs = ...              : tt.tensor<MxN, ptr<global f32>>
%vals = "tt.load"(%ptrs) : (tt.tensor<MxN, ptr<global f32>>) -> tt.tensor<MxN, f32>
Operația tt.load de nivel înalt asupra unui pointer tensorial și a unui bloc de date (tile). Primul parametru de intrare %ptrs este tensor (matrice de n dimensiuni) reprezentat de tensor <MxN, ptr<global f32> >. Returnează un tensor de aceeași dimensiune, dar cu valori în loc de un pointer către valori.
În practică, tt.load primește și o mască și o valoare implicită a parametrului, necesare pentru citirea din limitele memoriei (în cazul în care dimensiunile vectoriale nu sunt aliniate pe pas).
%ptrs = ... : tensor<MxN, ptr<global f32>>
%mask = ... : tensor<MxN, i1>         // in-bounds mask (optional)
%fallback = constant 0.0 : f32
%vals = "tt.load"(%ptrs, %mask, %fallback) : (tensor<MxN, ptr<global f32>>, tensor<MxN, i1>, f32) -> tensor<MxN, f32>
În etapa următoare, IR-ul Triton-GPU este utilizat pentru a converti layout-uri tensoriale generice în layout-uri specifice hardware-ului, în special în ceea ce privește layout-ul memoriei și distribuția acesteia între fire de execuție și warp-uri. Cu alte cuvinte, TGIT cheltuiește sarcina n dimensională în operațiuni de încărcare vectorială per fir de execuție, care sunt mai ușor de redus la LLVM.
// TGIR (illustrative)
%vec_ptr = tt.get_contiguous_vector_ptr %ptrs, vec_len=4
%vec_vals = ttg.load.global.v4f32 %vec_ptr  // a vectorized 4-wide global load
%vec_vals_cast = f32x4 -> f32  // unpack to tensor<MxN, f32> shape
IR-ul Triton-GPU este apoi convertit în instrucțiuni per fir de execuție reprezentate în IR-ul LLVM. Acest IR de nivel scăzut reprezintă îndeaproape instrucțiunile finale ale mașinii și utilizează operații LLVM standard, cum ar fi aritmetica pointerilor, încărcarea memoriei și primitivele de sincronizare. Abstracția tensorială a dispărut în mare parte, fiind înlocuită de operații individuale de acces la memorie pentru fiecare fir de execuție.
// Example LLVM IR snippet (conceptual)
%thread_ptr = getelementptr inbounds float, ptr %base_ptr, i64 %thread_offset
%value = load float, ptr %thread_ptr, align 4
Reprezentare: Încărcarea plăcuțelor este împărțită într-o serie de instrucțiuni individuale de încărcare cu aritmetică a pointerilor pentru elementul(elemente) de date specifice fiecărui fir de execuție și, eventual, operațiuni de memorie shared dacă memoria partajată a fost utilizată ca zonă de staging.
Când backend-ul LLVM vizează GPU-urile NVIDIA, următorul pas este coborârea la PTX. Instrucțiunile de încărcare LLVM sunt mapate direct la instrucțiunile de încărcare PTX corespunzătoare.
// Example PTX snippet
ld.global.f32 %r1, [%thread_ptr]; // Load from global memory
// Or if staged via shared memory:
ld.shared.f32 %r1, [%shared_ptr];
În cele din urmă, compilatorul de drivere NVIDIA (ptxas) convertește ansamblul PTX în SASS (Streaming Assembly), codul nativ al mașinii executat de nucleele GPU. După cum s-a văzut anterior, acest pas se face de obicei Just-In-Time (JIT).
// Example SASS snippet (conceptual, might involve specific opcodes)
MOV R1, ...
LDG.E.32 R1, [R0]; // Load from global memory
Un lucru demn de remarcat este faptul că CUDA este o modalitate foarte convenabilă de a genera cod mașină pentru GPU-urile NVIDIA. Triton folosește CUDA atunci când coboară de la PTX la SASS. Coborârea la PTX se face din LLVM IR, dar necesită biblioteci furnizate cu setul de instrumente CUDA (de exemplu, libdevice.bc).
 DeepSeek a adoptat o altă abordare și a optat pentru optimizarea manuală PTX: au fost scriși manual instrumente de asistență personalizate pentru kernelul PTX, tratând PTX ca limbaj de asamblare pentru GPU. DeepSeek nu s-a bazat pe un compilator de uz general pentru a genera acest cod specific, extrem de non-standard. Triton, dimpotrivă, fiind un limbaj generic, folosește back-end-ul standard al compilatorului LLVM cu ținta NVPTX pentru a traduce automat reprezentarea sa intermediară (Triton-IR/MLIR) în cod de asamblare PTX optimizat.
 Încapsularea DeepSeek în csrc/kernels/utils.cuh folosind instrucțiunea mbarrier.try_wait
De ce contează acest lucru? Citat din raportul tehnic DeepSeek (https://arxiv.org/html/2412.19437v1): Mai exact, noi (DeepSeek) folosim instrucțiuni PTX (Parallel Thread Execution) personalizate și reglăm automat dimensiunea blocurilor de comunicare, ceea ce reduce semnificativ utilizarea memoriei cache L2 și interferențele cu alte SM-uri. Înseamnă acest lucru că backend-ul LLVM NVPTX nu este optim eficient? Pentru mine, acest lucru înseamnă că există loc pentru optimizări suplimentare, dar nu numai la nivelul LLVM, ci și la expunerea unui bare metal [ISA] mai bun (https://medium.com/prompt-engineering/deepseek-and-deepep-understanding-deep-seeks-custom-cuda-ptx-instruction-214d5408de6a)! Este o situație din care toată lumea are de câștigat!
Voila, această notă a durat din nou mai mult decât mă așteptam. Dar este o lucrare de studiu preliminar foarte necesară înainte de a introduce arhitectura Cuda-Q. Voi actualiza această postare când va fi gata.
 (credit imagine: LLVM MOS)
Diagrame DrawIO utilizate în acest memo: