Recent am dat peste conceptul de Inginerie a Capacitatii și Eficienței, care este disciplina proiectării și operării sistemelor într-un mod optim. Este un pilon cheie al arhitecturii sistemelor și este deosebit de important atunci când scala contează, cum ar fi în sistemele de calcul cuantic.
Pe scurt, Ingineria Capacitatii și Eficienței este știința sau disciplina optimizării producției. Aceasta se realizează prin echilibrarea producției maxime (capacitatea) cu consumul de resurse (eficiența).
Avantajul Ingineriei Capacitatii și Eficienței (CEE) este că este un domeniu bine definit, bine acoperit în literatura de specialitate și susținut de practici inginerești bine structurate. Acest memoriu încearcă să extragă câteva concepte cheie utilizate în CEE.
Piloni de inginerie ai capacității și eficienței
Link to heading
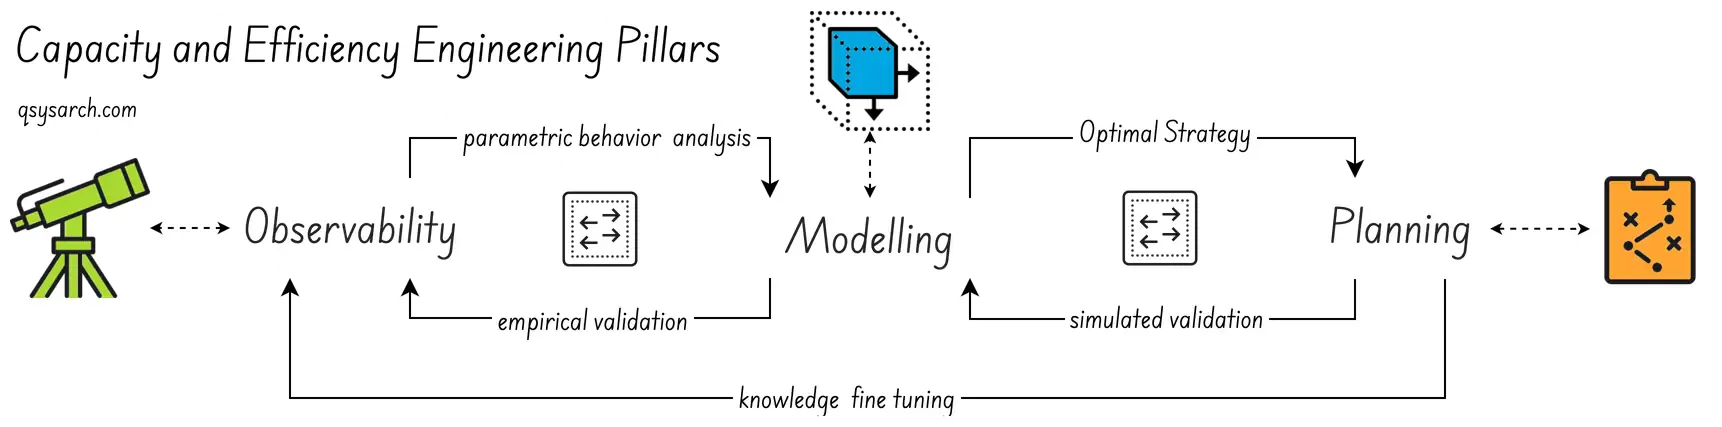
Ingineria capacității și eficienței se bazează pe trei piloni principali: Observabilitate, Modelare și Planificare.
Observabilitate
Modelare
Planificare
Scopul final este de a crea un plan care poate fi simulat eficient folosind un model. Modelul ar trebui validat în funcție de observațiile empirice. Prin modelarea creșterii, identificarea blocajelor și alocarea strategică a resurselor, planul previne supraîncărcarea sau subutilizarea. Acest lucru asigură funcționarea optimă a sistemului.
Trebuie menționat că resursa de sistem poate fi orice. Poate varia de la resurse IT, cum ar fi CPU sau memorie, până la personal sau utilaje. De fapt, CEE poate fi aplicat în diverse domenii. De exemplu, poate ajuta la optimizarea alocării personalului în managementul de proiect sau la reducerea costurilor de găzduire în cloud în managementul infrastructurii.
Observabilitatea este analiza empirică a unui sistem. În sistemele de calcul, jurnalele (logurile) sunt adesea confundate cu observabilitatea, dar ele reprezintă doar o parte a imaginii. De exemplu, standardul OpenTelemetry cuprinde mai multe semnale observabile: jurnalele, metricile, urmele și bagajul. Pentru CEE, observabilitatea eficientă ar trebui să ofere:
Utilizarea resurselor: Observarea și urmărirea consumului de resurse. Observația ar trebui să specifice ce, când și de către cine este utilizată resursa și dacă au apărut erori.
Indicatori de performanță: Urmăriți indicatorii cheie de performanță (KPI), cum ar fi latența și debitul. Inclusiv randamentul, risipa sau ratele de eroare.
Identificarea blocajelor: Identificarea constrângerilor din sistem care degradează randamentul.
Cheia este să se poată efectua o analiză post-mortem a sistemului, în orice condiții - fie că este vorba de sarcină intensă, întreținere sau perioade de inactivitate. Este important să se înțeleagă în detaliu ce s-a întâmplat, când și de ce. Fără astfel de observabile, ar fi imposibil să se identifice cauzele principale ale defecțiunilor sistemului.
Desigur, există o provocare în colectarea întregii observații a unui sistem complet: observațiile pot fi foarte costisitoare sau chiar distructive (ca în cazul calculului cuantic, unde măsurarea unui sistem îi poate schimba starea - un fenomen cunoscut sub numele de efectul observatorului). Aceasta înseamnă că simplul act de observare a sistemului îi poate altera comportamentul și îi poate degrada performanța. Răspunsul la aceasta este eșantionarea (colectarea datelor doar de la unele evenimente în loc de toate). Ideea este de a face din rata de eșantionare (frecvența colectării datelor) un parametru de sistem reglabil, așa cum se arată în diagrama de mai jos (credite: OpenTelemetry).

Pentru un sistem non-computer, o observabilitate eficientă ar permite, de exemplu, o explicație a motivului pentru care un proiect este întârziat. Datele observabile ar fi probabil documentele tehnice și netehnice obligatorii conform ISO9001 care explică deciziile urmăribile luate în timpul fiecărei faze a proiectului.
Odată ce observabilitatea a fost stabilită, se poate începe să se înțeleagă comportamentul parametric analitic al sistemului. Acest comportament formează fundamentul următorului pilon: poate fi descris și tradus într-un model parametric. Următorul pas este de a clarifica ce trebuie să ofere un astfel de model, având în vedere un set de parametri sau condiții:
Performanță: Care este debitul și latența maxime pe care le poate oferi sistemul.
Cost de operare: Cât costă operarea sistemului, în funcție de numărul de resurse alocate? Acest cost poate varia în funcție de momentul zilei.
Reconfigurare: Care este impactul tranzitoriu (efectele temporare) al actualizării parametrilor de sistem? De exemplu, la alocarea unui nou server sau QPU și configurarea corectă a acestuia.
Cheia este de a simula comportamentul sistemului și de a observa performanța acestuia în diferite condiții de funcționare. Deoarece modelul include costurile resurselor, acesta poate arăta compromisurile de costuri în aceste condiții. Aceste informații sunt importante pentru faza de planificare.
Merită menționată aici diferența dintre simulare și emulare. La nivel general, emularea creează o versiune falsă a sistemului, în timp ce simularea operează pe baza unui model abstract al sistemului. Cu ajutorul emulării, este posibil să se compare performanța emulată cu performanța reală, deoarece datele de intrare sunt aceleași. Presupun că, în contextul Europei Centrale și Orientale, modelul se referă în mare parte la un simulator.

Un model bun pentru un sistem non-computer ar putea prezice efectele adăugării de resurse suplimentare la un proiect. Și într-adevăr, uneori, adăugarea de resurse scade de fapt performanța sistemului. Acest rezultat contraintuitiv este cunoscut sub numele de [Legea lui Brooks] (https://en.wikipedia.org/wiki/Brooks%27s_law).
Cu modelul la îndemână, puteți începe planificarea operațiunilor sistemului. Folosiți modelul pentru a simula diverse condiții și a le găsi pe cele optime. Folosiți aceste rezultate pentru a aloca strategic resursele cererii. Un plan bun ar trebui să ofere previziuni ale cererii, gestionarea costurilor și măsuri de siguranță. Previziunea prezice utilizarea, traficul sau nevoile viitoare. Costurile controlează supraaprovizionarea, menținând în același timp capacitatea pentru orele de vârf. Măsurile de siguranță oferă zone tampon pentru a gestiona cererile neașteptate.
Cheia este să operați sistemul eficient și fiabil. Să gestionați sarcinile de vârf fără defecțiuni. Să garantați eficiența din punct de vedere al costurilor. Capacitatea prognozată permite reconfigurarea proactivă. Să oferiți un buffer suficient pentru a face față evenimentelor neprevăzute.
Planul combină scenariul optim, în care cererea este conform așteptărilor, și scenariul pesimist, în care cererea este mai mare sau mai mică decât cea prevăzută. Această abordare realizează o alocare optimă din punct de vedere al costurilor a capacității.
Proiectarea unui model bun este o problemă de tipul „oul și găina”. Dacă nu știi ce să observi și cum să observi în sistem, este dificil să construiești un model eficient și precis. Fără un model precis, este puțin probabil ca planul să producă rezultate bune.
Când apar discrepanțe între planul simulat și comportamentul real, se încearcă găsirea parametrilor lipsă. Acest lucru se face de obicei prin analizarea ulterioară a jurnalelor sistemului observat. Scopul este de a identifica noi parametri de observat.
Această buclă de învățare este reprezentată ca ajustare fină a cunoștințelor în diagrama de mai sus.
În sine, CEE nu ar fi suficient fără o platformă automatizată care să suporte întregul flux de lucru. Această platformă de inginerie este reprezentată în diagrama de mai jos.
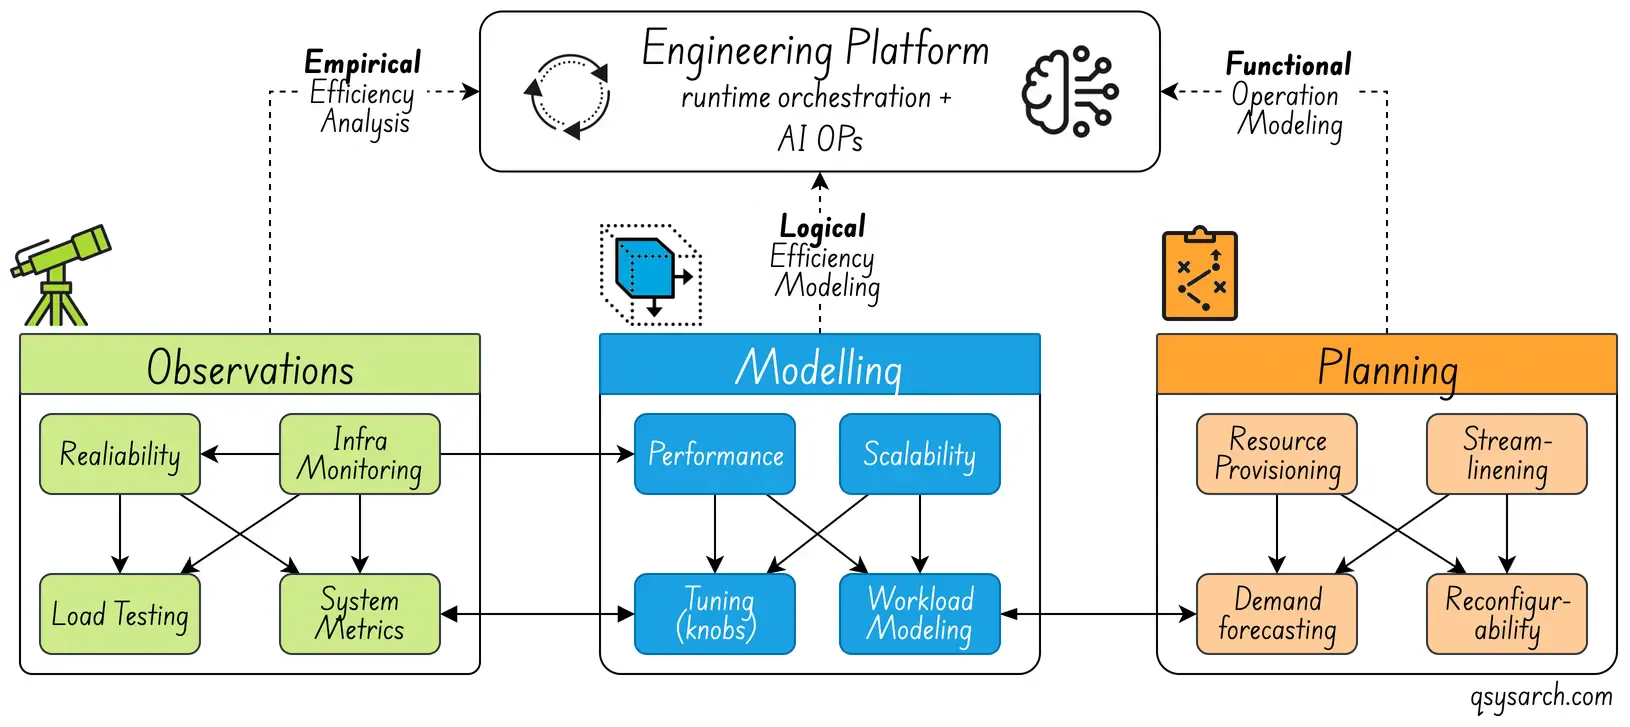
Ideea platformei de inginerie nu este doar de a automatiza procesul de scalare a sistemului în sus și în jos, care poate fi delegat agenților Ai Ops. De asemenea, este vorba de a verifica continuu adecvarea modelului simulat în raport cu observațiile empirice și de a transmite discrepanțele către un agent ML care poate regla fin modelul. Acest agent este probabil un agent bazat pe învățare prin consolidare, care ar trebui să fie guvernat dacă este utilizat în timp real.
Costul eșecului de a scala suficient de repede, adică costul întârzierii.
Link to heading
Pentru ca un sistem să fie stabil și robust, performanța ar trebui limitată la niveluri stabile, nu la niveluri maxime. Ca regulă generală, performanța stabilă este de aproximativ două treimi din performanța maximă. Dincolo de acest prag, sistemul se degradează. Costul timpului de nefuncționare poate apoi depăși rapid - adesea exponențial - costul supraaprovizionării.

În imaginea din dreapta, costul întârzierii poate fi considerat ca impactul financiar al incapacității de a satisface cererea în timp ce se scalează sistemul (în timp real). Acesta este un cost tranzitoriu. Când gradul de utilizare este scăzut, întârzierea afectează doar câteva cereri. Dar când gradul de utilizare este ridicat, întârzierea afectează multe cereri, iar costul întârzierii crește exponențial.
Punctul ideal reprezintă utilizarea optimă care minimizează atât costul întârzierii, cât și costul nefuncționării (supraaprovizionare). Curba verde arată costul total ca sumă a acestor doi factori. Minimul local al acestei curbe, de obicei în jurul a 2/3 din performanța maximă, marchează utilizarea optimă. De fapt, sunt multe de spus despre punctul ideal, despre care sunt sigur că unii vor susține că este în jur de 80%. Cheia este să înțelegem că reducerea costului întârzierii prin optimizarea sistemului permite creșterea utilizării optime (credite imagine: arată-mi datele).
Dacă reducerea costului defectului unui sistem poate însemna minimizarea timpului necesar pentru scalare, imaginați-vă un sistem care se poate ajusta în milisecunde sau chiar microsecunde pentru a se extinde și a satisface cererea. Desigur, dezvoltarea unui astfel de sistem poate fi foarte costisitoare (gândiți-vă la HFT). Dar ce-ar fi dacă costul dezvoltării unui astfel de sistem ar fi mai mic decât beneficiul de a putea opera sistemul la o utilizare mai mare?
Această provocare face parte, de asemenea, din CEE (Economic Environmental Environmental Efficiency). Prin modelarea costului îmbunătățirii sistemului, devine posibilă crearea unui plan care să echilibreze costul îmbunătățirii cu beneficiul. Este mai puțin o provocare operațională și mai mult o investiție strategică. Cu toate acestea, este în continuare condusă de aceleași principii ale CEE aplicate strategiei operaționale a afacerii, văzută ca un sistem.
Maparea fluxului valorii (VSM), în contextul ingineriei capacității și eficienței, este utilizată în mod obișnuit ca instrument de diagnosticare pentru a determina unde este consumată capacitatea, permițând identificarea cauzelor principale ale risipei și blocajelor.
Un Flux de Valoare (Value Stream) reprezintă fiecare pas sau activitate din fluxul de lucru utilizat de sistem pentru a furniza un serviciu, iar harta este o reprezentare vizuală a acestui flux end-to-end. VSM (Value Stream Management - Sistem de Monitorizare a Valorilor) distinge între trei tipuri de activități:
Valoare adăugată (VA): Pași care contribuie direct la rezultatul dorit de client (de exemplu, calculul propriu-zis).
Fără valoare adăugată, dar necesare (NNVA): Pași necesari de sistem, dar fără valoare directă pentru client (de exemplu, strângeri de mână).
Deșeuri (Muda sau 無駄, un termen japonez care înseamnă „risipă”): Pași care consumă capacitate fără a adăuga nicio valoare.
Scopul este de a elimina etapele Muda, iar VSM excelează în identificarea lor. Puterea VSM constă în capacitatea sa de a identifica optimizările potrivite care pot reduce lucrările în curs (WIP). Acest lucru este important datorită Legii lui Little, care afirmă că timpul mediu de livrare (sau timpul de ciclu) este egal cu munca în curs (WIP) medie împărțită la randamentul mediu:
Timp de livrare = Lucrări în curs / RandamentAceasta înseamnă că, dacă WIP-ul se dublează, timpul de livrare se dublează, chiar dacă randamentul rămâne același. Prin urmare, controlul WIP-ului este una dintre cele mai directe pârghii pentru îmbunătățirea latenței de livrare („întârzierea”) și, prin urmare, a eficienței sistemului.
Voila, această scurtă notă de duminică dimineață despre Ingineria Capacitatii și Eficienței (CEE) m-a ajutat să înțeleg mai bine subiectul. Deocamdată, ceea ce vreau să rețin este că, atunci când un sistem are o eficiență foarte scăzută, este foarte probabil un semn că sistemul sau fluxurile sale de lucru sunt suprasolicitate de Muda. Răspunsul la această provocare: să investesc în reducerea costului întârzierii, mai degrabă decât prin supra-aprovizionare?
References:
DrawIO diagrams used in this memo:
Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
Key
methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
Unique
angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
Metrics
emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |