xPU: Este un termen generic pentru o unitate de procesare (PU) specializată, unde „x” poate reprezenta orice arhitectură de calcul personalizată pentru o sarcină de lucru specifică. Variațiile comune includ GPU-uri (grafică), TPU-uri (tensor/AI), NPU-uri (neuronale), DPU-uri (date) sau PPU-uri (pulse, utilizate în principal pentru stive de control cuantic).
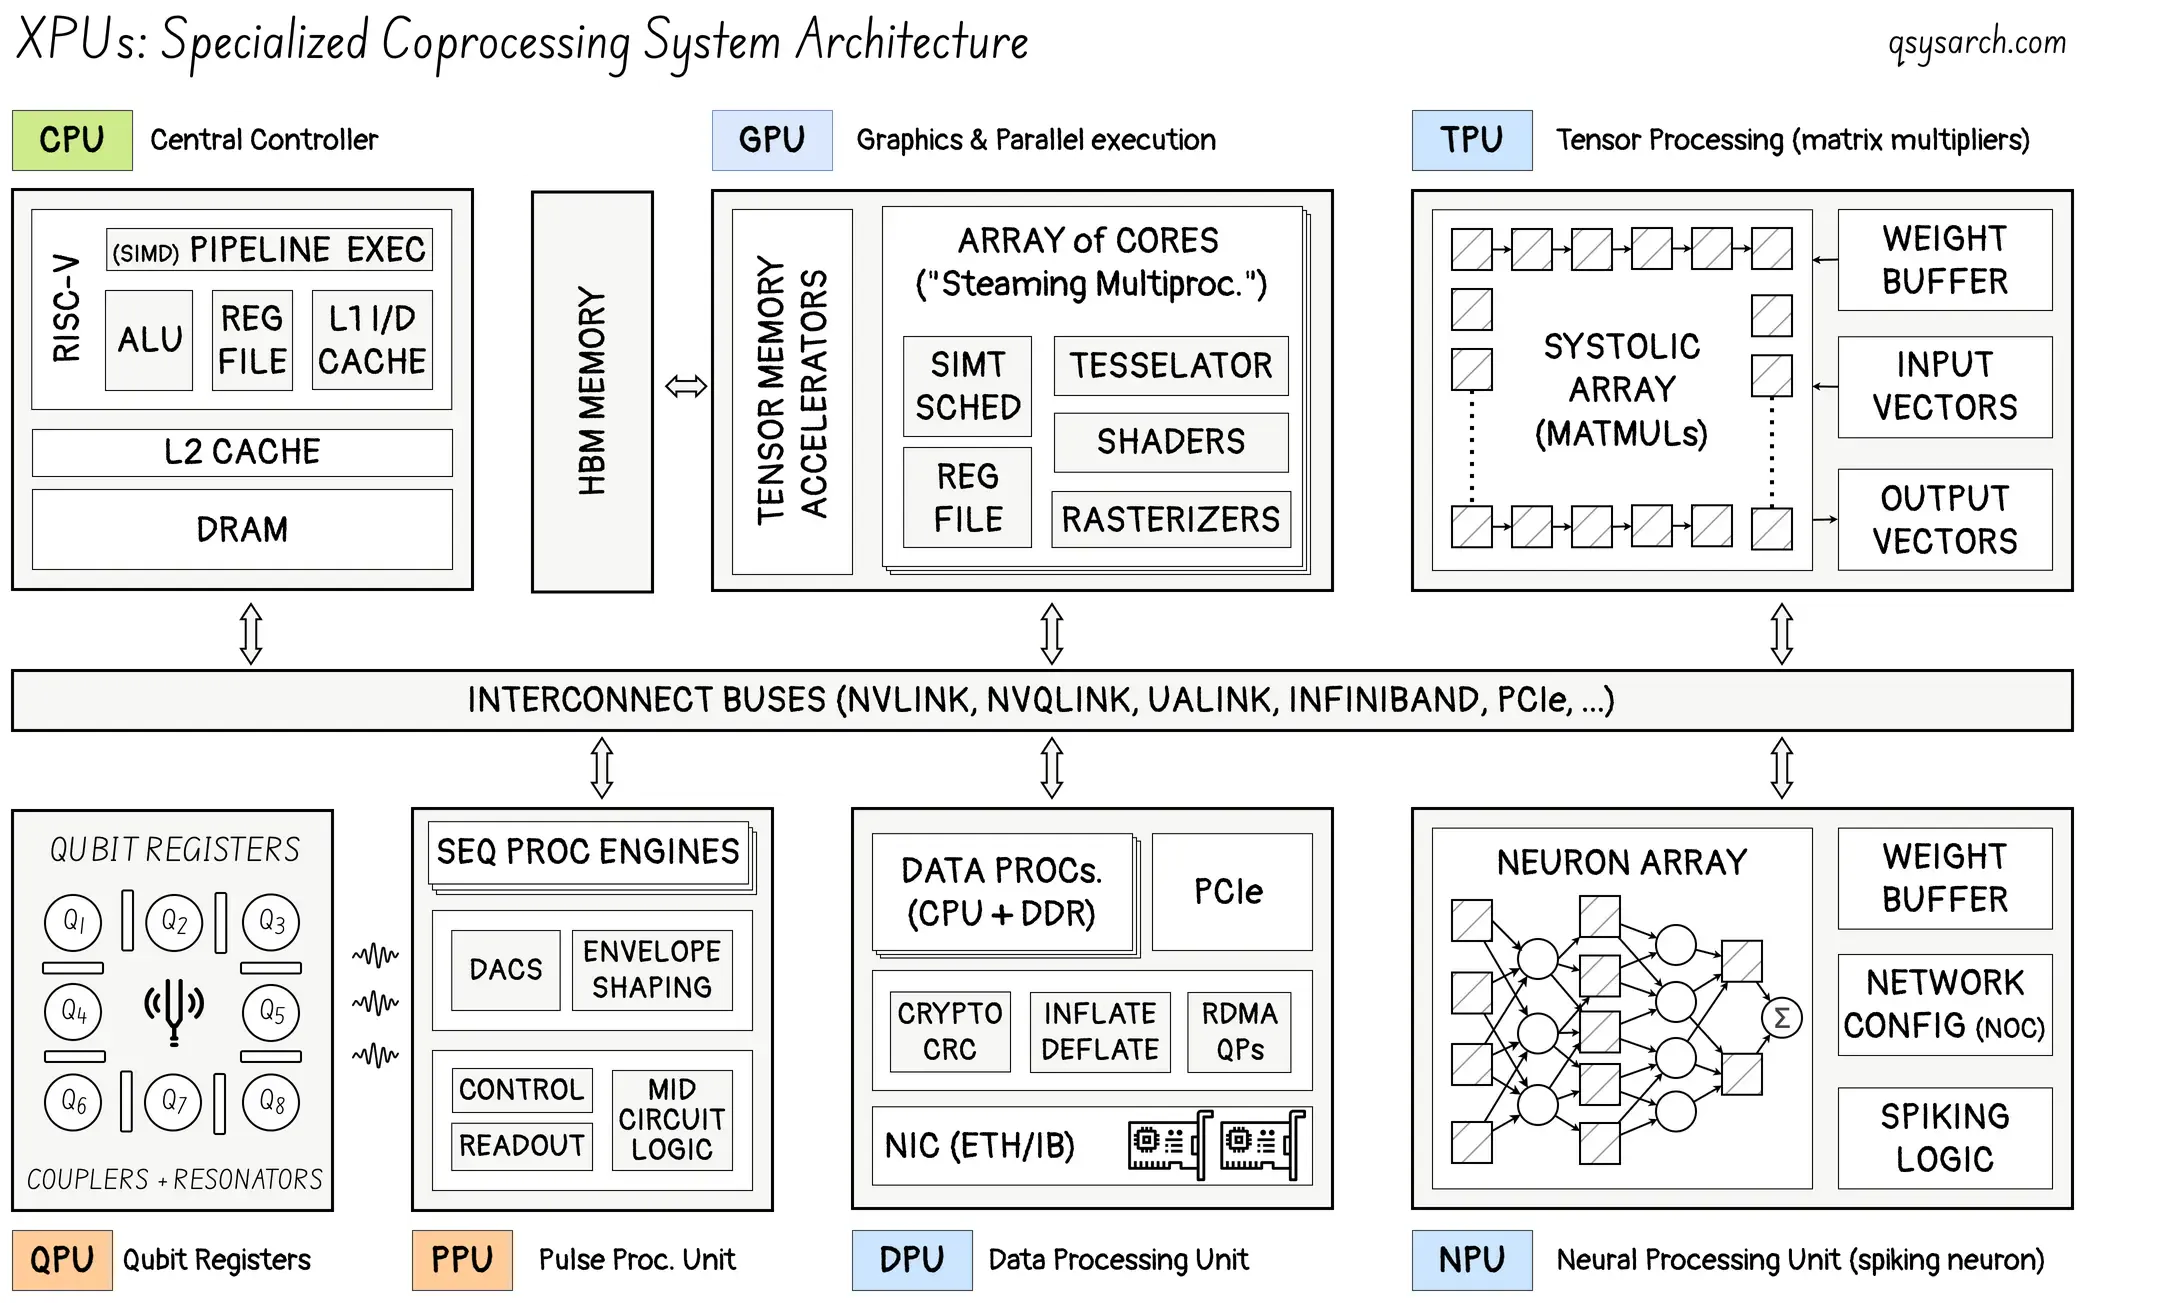
Această notă extrem de scurtă își propune să ofere informații despre peisajul pieței xPU, așa cum este aplicată inferenței AI.
Când analizăm peisajul pieței pentru ASIC-uri de inferență pentru inteligență artificială, cea mai utilă axă poate să nu fie performanța brută, ci dacă diferențierea unui furnizor este justificabilă pe un orizont de 3-5 ani. Din acest punct de vedere, apar trei grupuri:
Platforma universală: NVIDIA și integratorii verticali: AMD, Google
provocatorii actuali Groq, Cerebras, FuriosaAI, Positron, SambaNova, Axelera AI.
Provocările viitorului: Extropic, Normal Computing, Neconvențional, Mottronix, Akhetonics
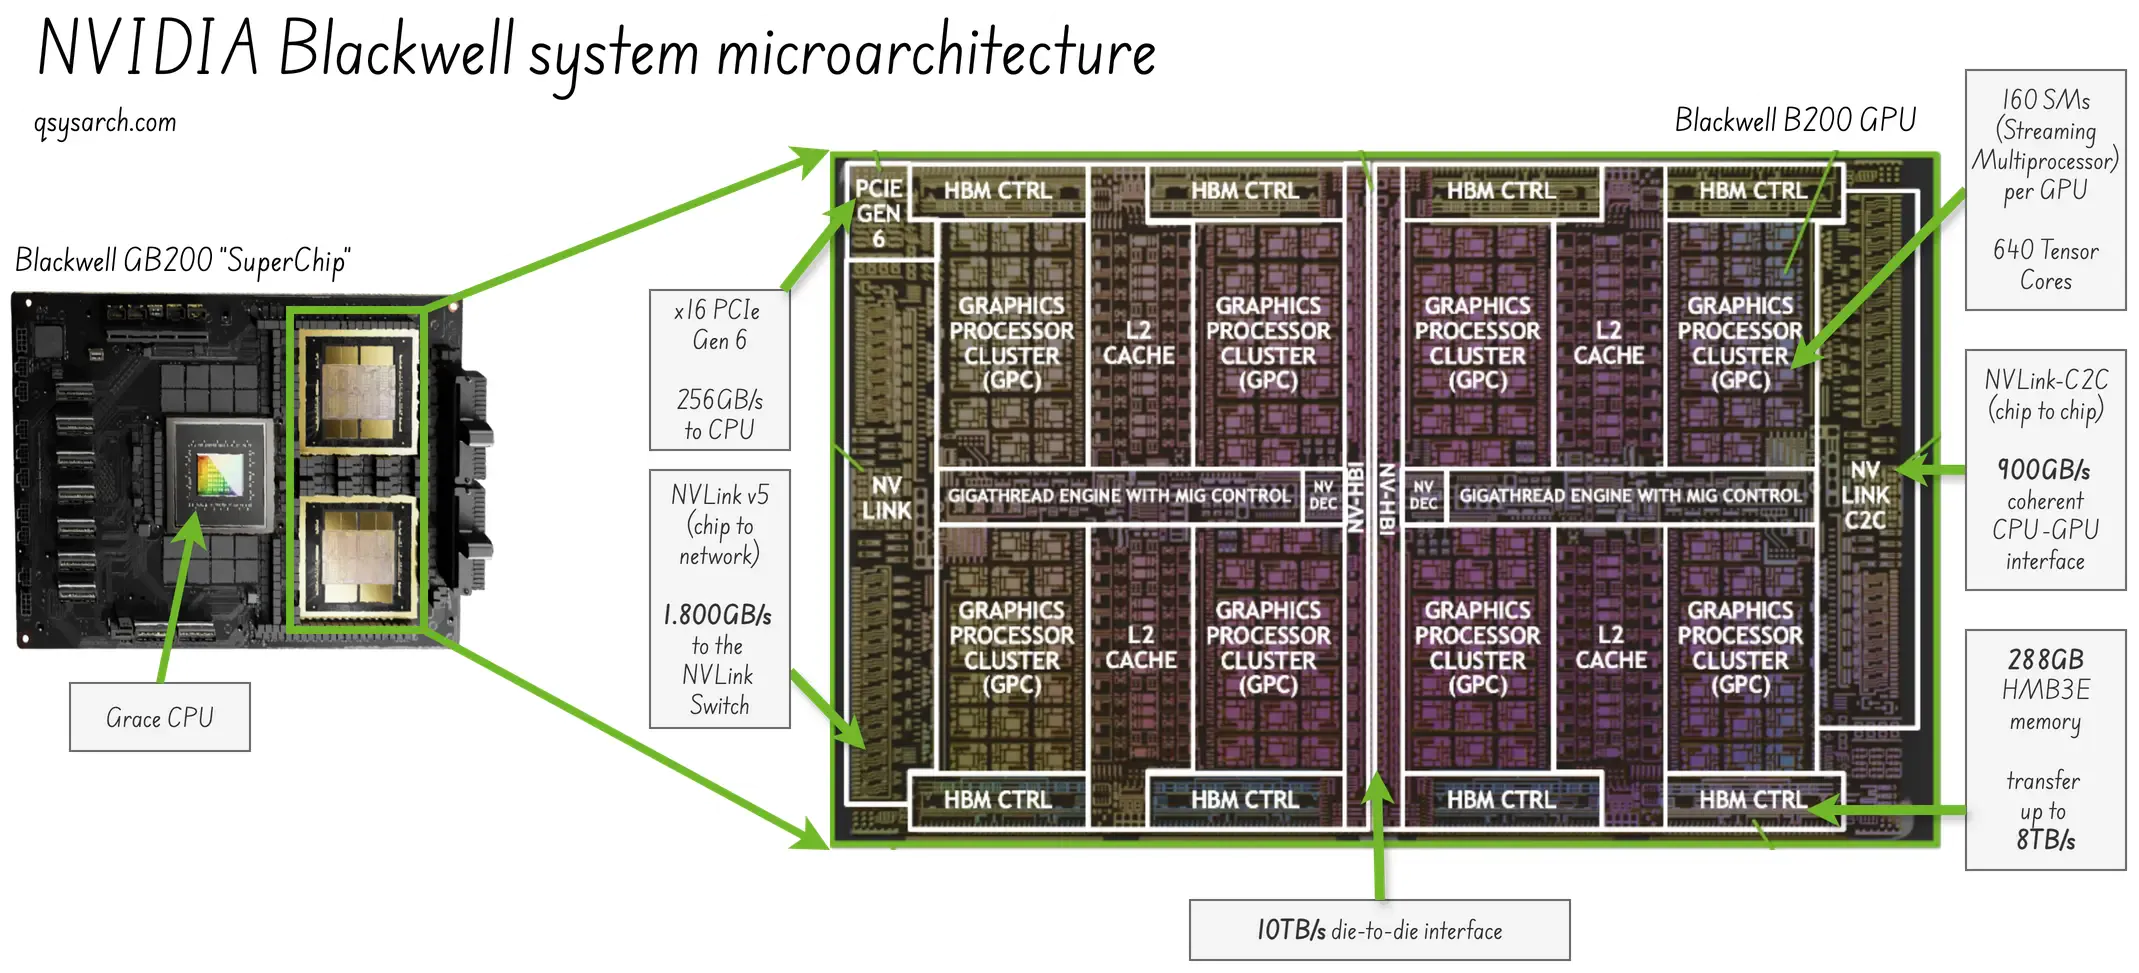
NVIDIA
Arhitectură: GPU (arhitectura Blackwell în 2024)
Puncte forte: Integrare completă în ecosistem, profunzime software, integrare completă a sistemului
Sarcină de lucru țintă: Universal — instruire LLM și inferență la scară largă - Shadere grafice
Vulnerabilitate: Cost ridicat, consum mare de energie; Nu este optimizat pentru putere de calcul redusă
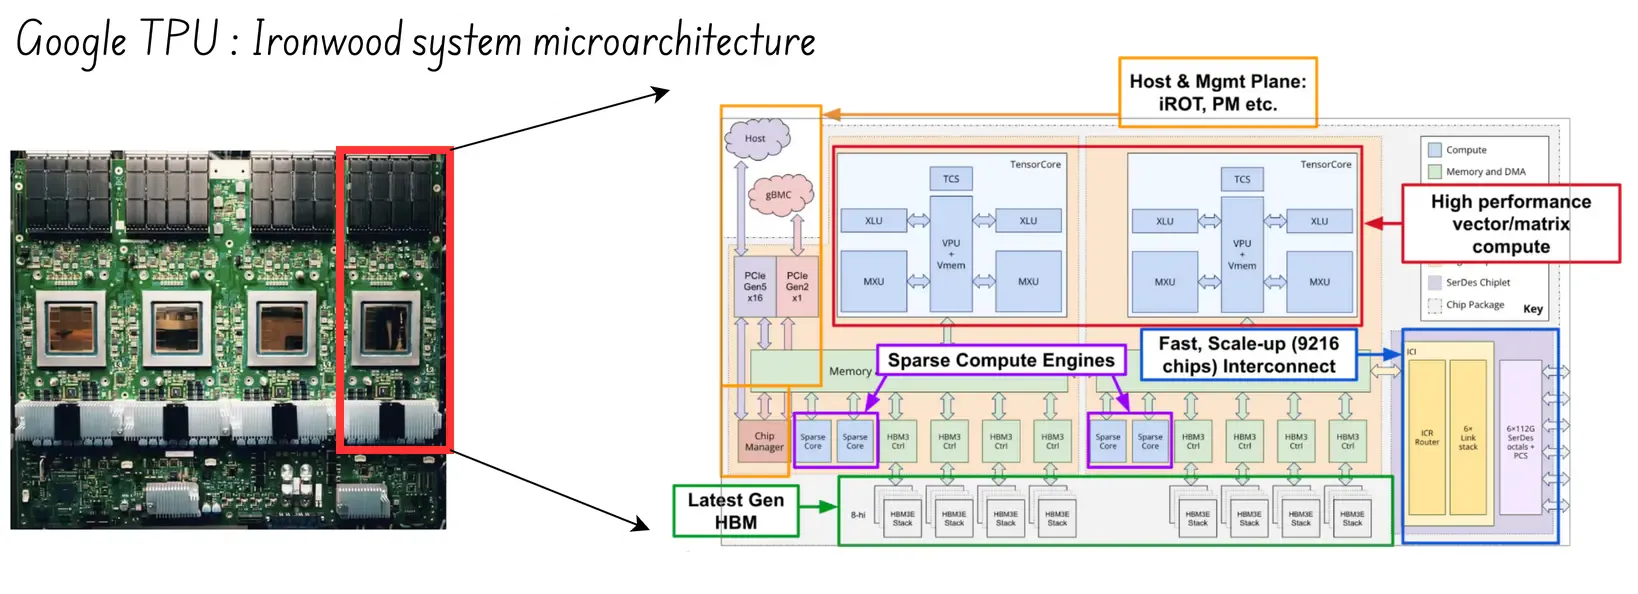
Google
Arhitectură: TPU, ASIC personalizat (sistolic)
Puncte forte principale: Integrare verticală; cel mai mic cost la scară Google
Sarcină de lucru țintă: sarcini de lucru Google Cloud, inferență Gemini
Vulnerabilitate: Disponibilă doar din Google Cloud; Nu este posibilă achiziționarea nucleelor TPU de la Google
AMD
Arhitectură: MI300 Instinct + ROCM (propriul CUDA al AMD)
Puncte forte: alternativă de preț CUDA; model GPU familiar;
Sarcină de lucru țintă: HPC și inferență sensibile la costurile din cloud
Vulnerabilitate: Decalaj software față de CUDA; Lipsă de întârziere față de ecosistemul de avangardă (de exemplu, NVQLINK)
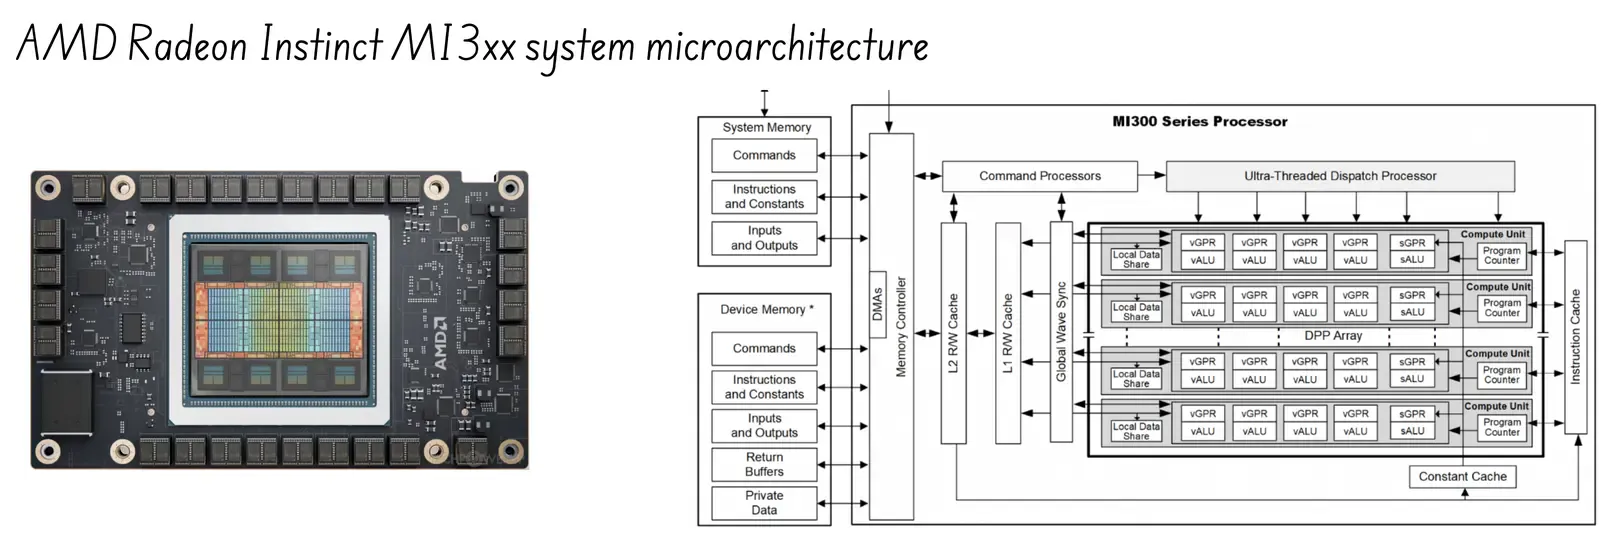
Challengerii deja achiziționați
Link to heading
Groq (achiziționat de NVIDIA)
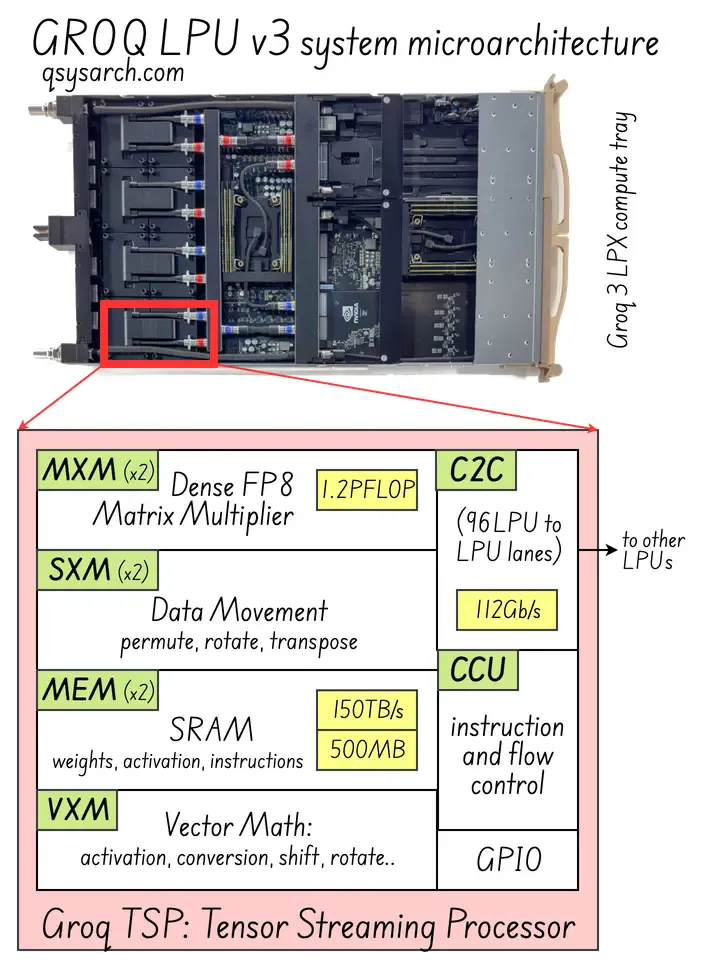
- Arhitectură: LPU (Unitate de Procesare a Limbii)
Principiu de funcționare: construit în jurul arhitecturii centrale a procesorului de streaming Tensor (TSP), timpul de execuție este complet previzibil până la ciclul exact de ceas.
Puncte forte ale nucleului: Latență deterministă ultra-scăzută; fără blocaje de memorie; totul este „disciplinat” în prealabil de către compilator.
Sarcină de lucru țintă: Inferență în timp real
Vulnerabilitate: Schimb de viteză pentru spațiu: Nu există memorie HBM (cu lățime de bandă mare) mare, ci doar SRAM încorporat super rapid de dimensiuni reduse (deși acest lucru îl face un complement bun pentru ecosistemul Nvidia Blackwell acum că a fost cumpărat de NVIDIA!)
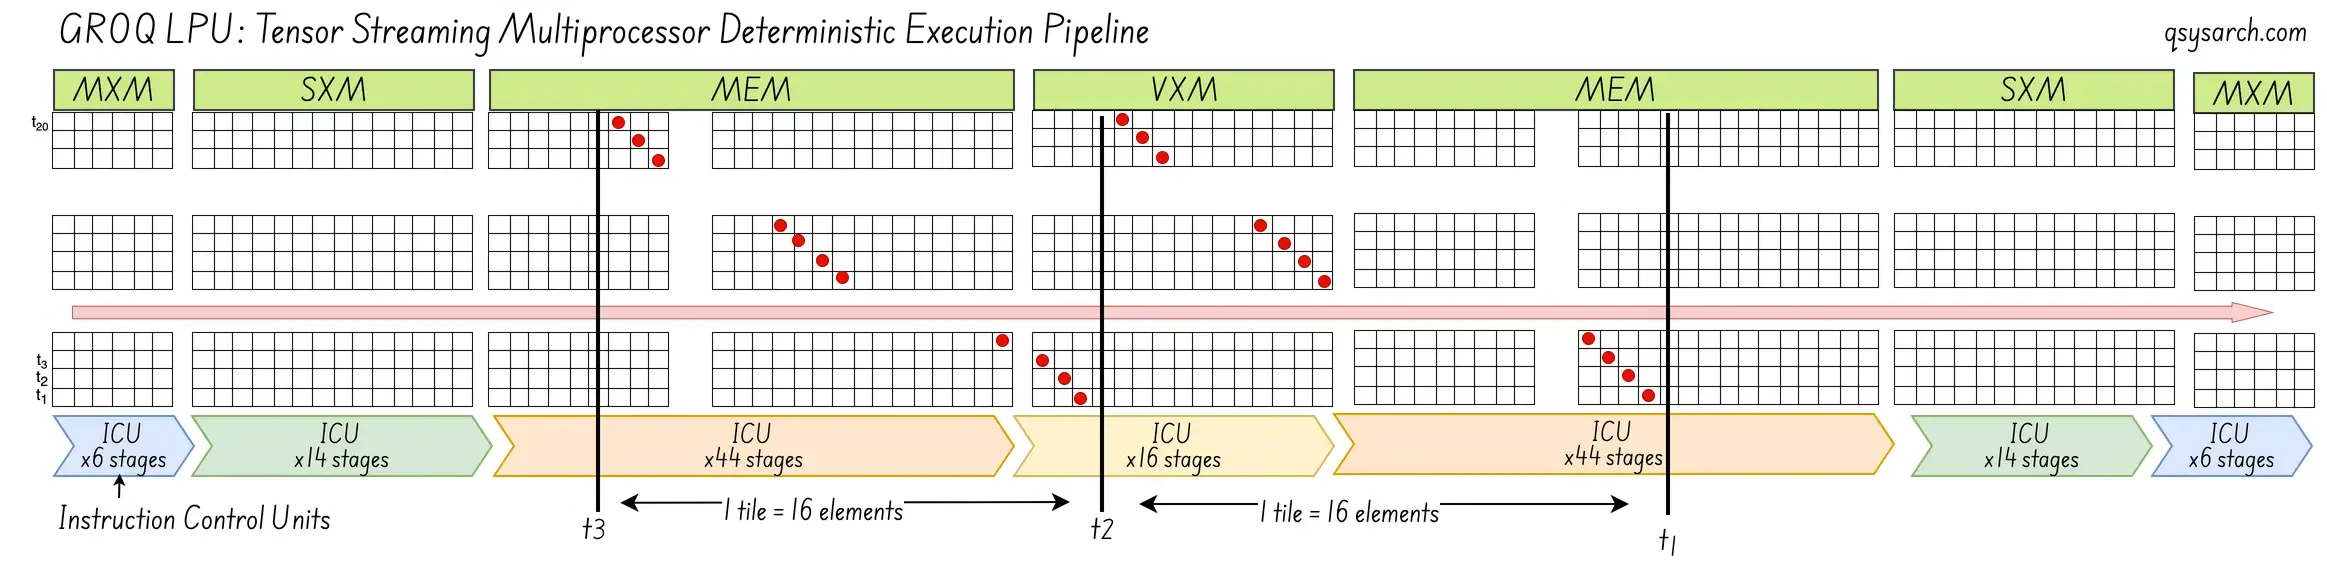
Rețineți că arhitectura Groq LPU a fost prezentată în 2020, lansată comercial în 2024 și achiziționată în 2026. Aceasta oferă un termen bun pentru aspiranții la unicorn: 4 ani pentru dezvoltare, 2 ani pentru confirmarea tracțiunii pe piață și jackpotul dacă un jucător mai mare simte presiunea rivalității!
Studierea cu atenție a soluțiilor de mai jos ar putea dura cu ușurință câteva zile pentru fiecare dintre furnizori; timp de care nu am avut la dispoziție pentru a scrie această notă - prin urmare, vă rog să luați descrierea de mai jos cu scepticism, deoarece ar putea fi incompletă și/sau subiectivă.
SambaNova [aproape achiziționat de Intel]
- Arhitectură: RDU (unitate de flux de date reconfigurabilă); permite conducte de date și procesare integrate personalizate pentru întregul grafic de calcul, reducând la minimum mișcarea datelor și rezultând o utilizare ridicată a hardware-ului. Diagrama de mai jos prezintă arhitectura detaliată a PCU (Unități de Calcul a Modelelor) și PMU (Unități de Memorie a Modelelor) utilizate în SN40L:
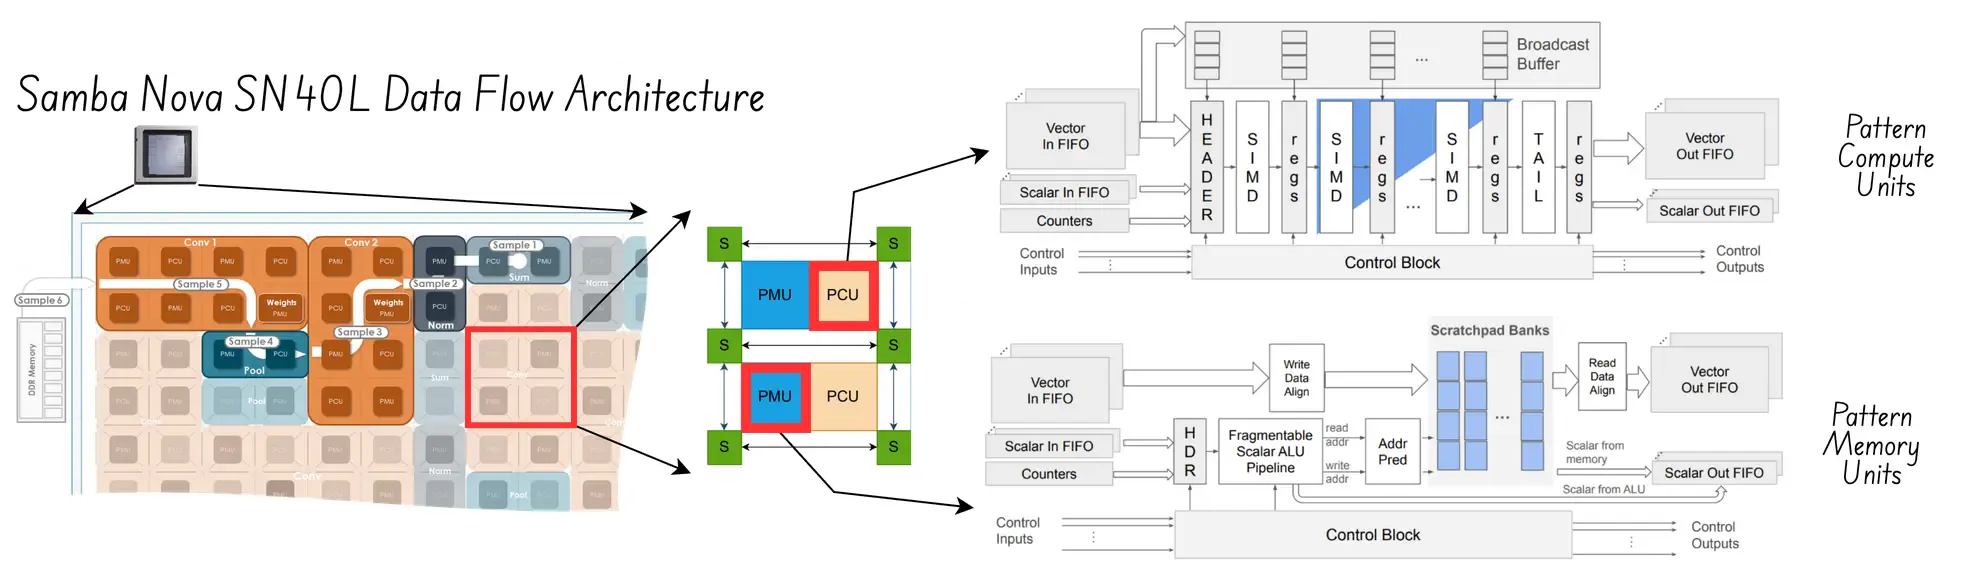
Puncte forte: Poate asigura o utilizare maximă a hardware-ului prin împărțirea atentă a fluxurilor sistemului în conductele de inferență concurente; Vine cu un stack complet de software, inclusiv integrare k8s de nivel înalt, compilator pentru PyTorch și Tensor Flow, precum și analizoare DataFlow.
Sarcină de lucru țintă: verticale reglementate la nivel de întreprindere, locale.
Vulnerabilitate: cost inițial ridicat al sistemului pentru hardware, care trebuie amortizat pe o perioadă lungă de timp pentru ca TCO să fie interesant.
Cerebras
Arhitectură: Motor la scară de napolitană (WSE) care acționează ca un multiplicator matricial gigantic prin conducte.
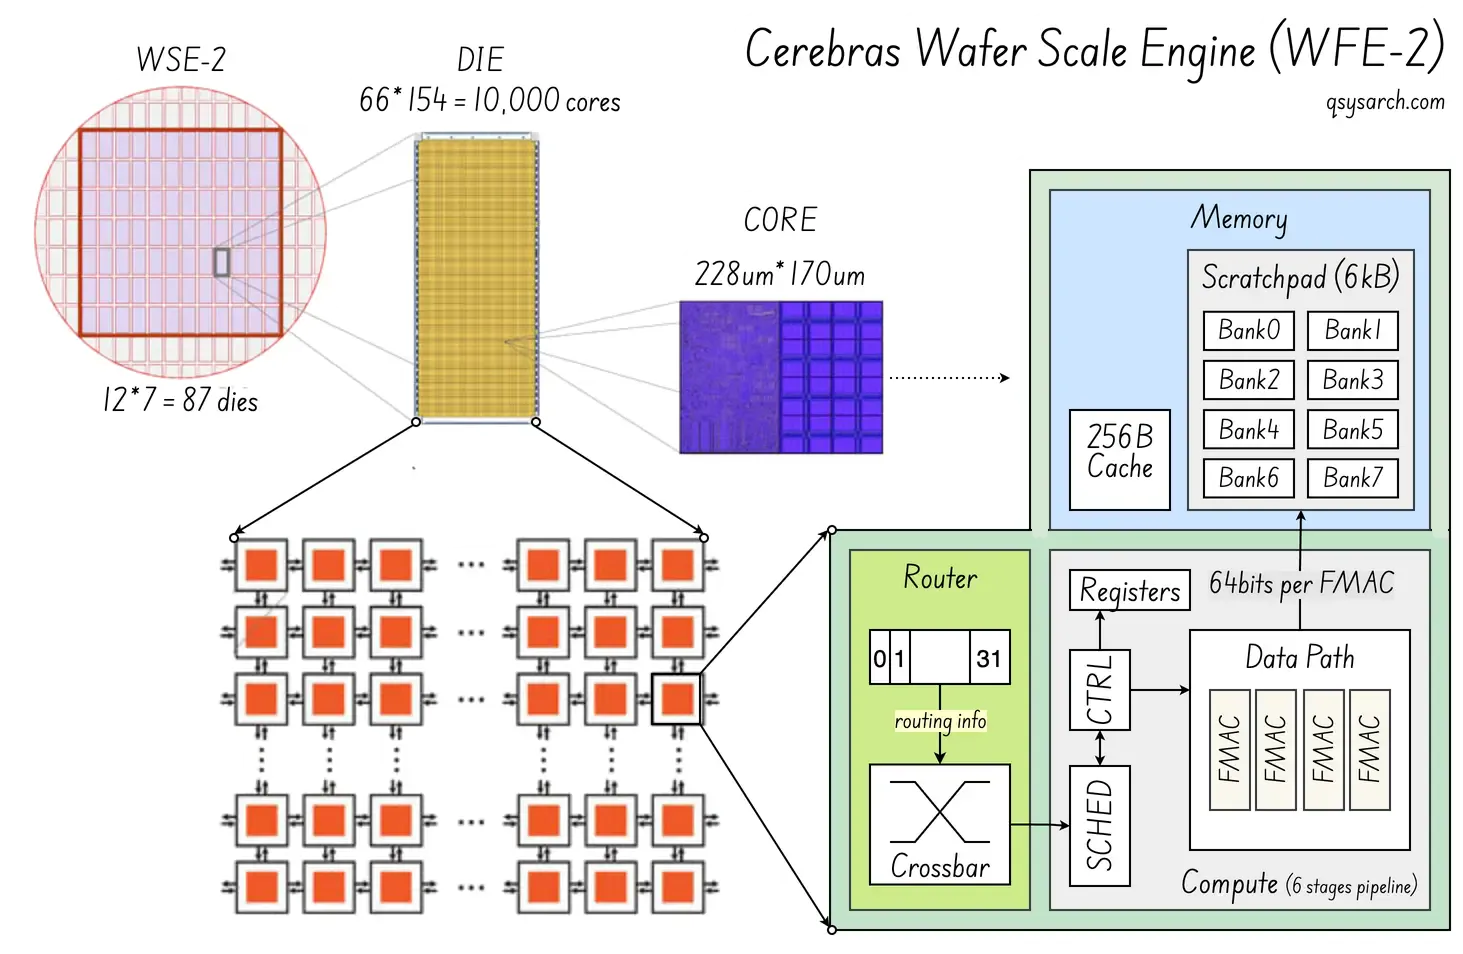
Puterea nucleului: SRAM masivă on-chip care elimină blocajele HBM. Nuclee independente de înaltă densitate (până la 850.000 pentru WSE-2) care pot „calcula tensor în memorie”. Router fabric cu latență de ceas unică între nodurile de pe wafer.
Sarcină de lucru țintă: Inferență LLM mare, în special modele rare.
Vulnerabilitate: Necesită un pachet software de top pentru a profita din plin de scara masivă (ca în cazul tuturor „PIM”-urilor sau procesărilor din microarhitecturile de memorie).
FuriosaAI
- Arhitectură: Procesor de contracție tensorală (TCP), comercializat sub denumirea de Renegade (RGND) Asic. Comparativ cu matricele sistolice TPU, care au o grilă fixă, arhitectura TCP a Furuisa utilizează unități de calcul mici, configurabile, care pot fi rearanjate dinamic (ca un NOC super-inteligent).
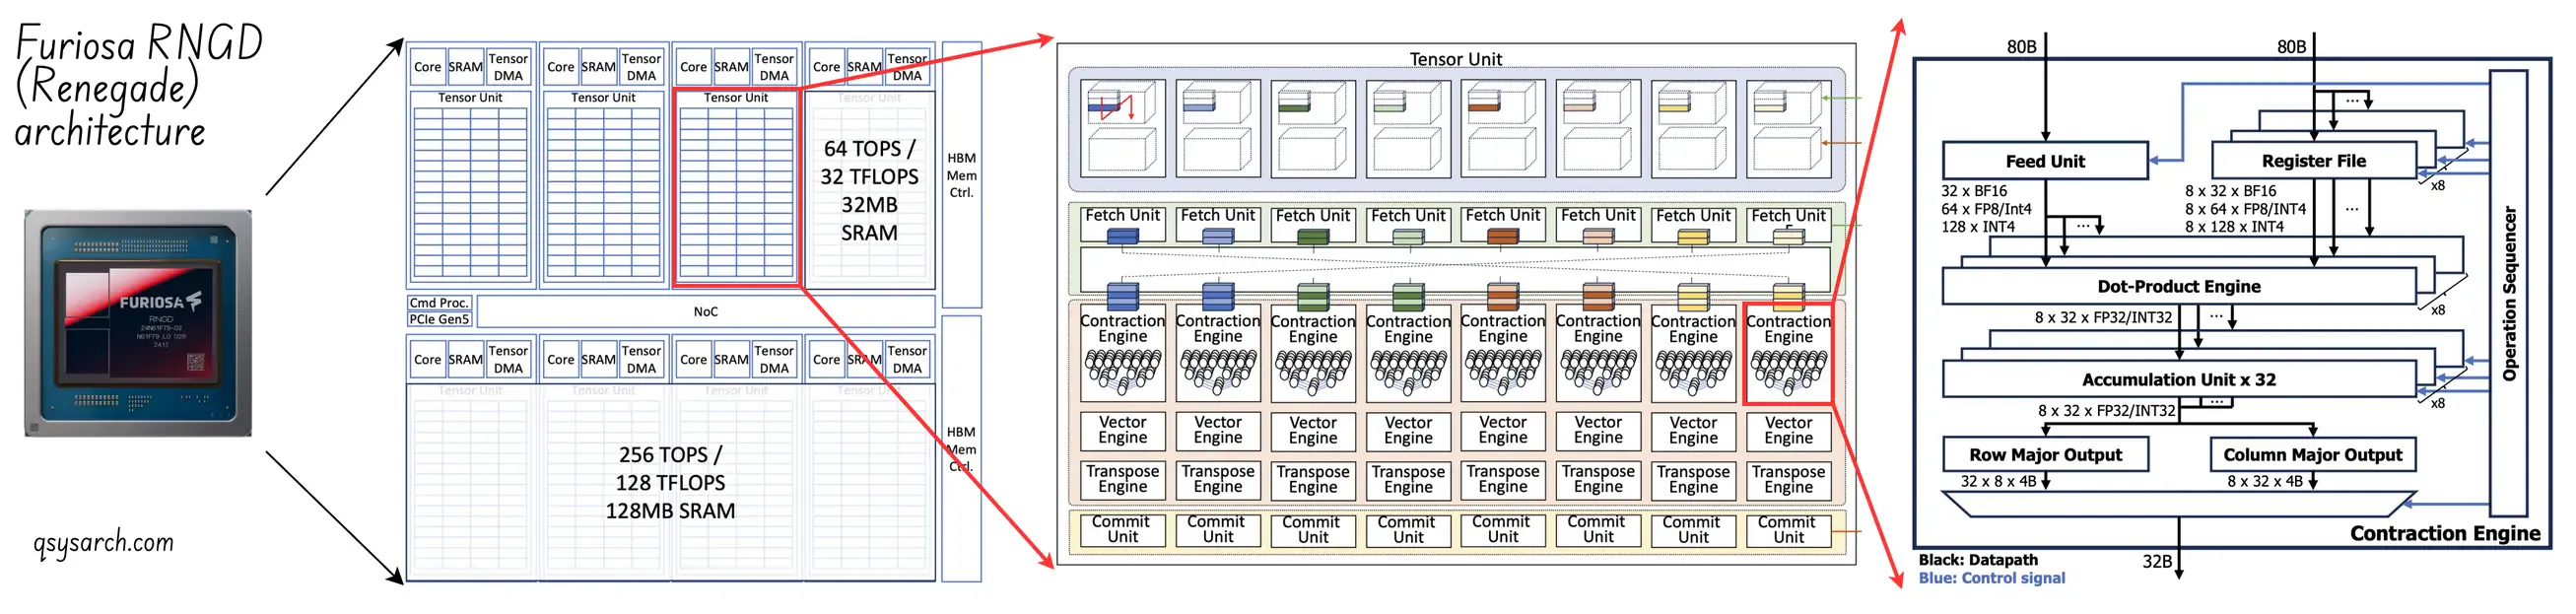
Puncte forte: Prin introducerea NOC-ului de tip „fetch”, Furiosa introduce programabilitatea spatio-temporală a rețelei tensoriale TPU, ducând nivelul de eficiență la nivelul următor, prin adaptarea perfectă la sarcina de calcul și la procesoarele de contracție a tensorilor.
Sarcină de lucru țintă: LLM-uri, VLMS-uri,..
Vulnerabilitate: Ecosistem limitat; risc de concentrare geografică (deși acest lucru ar putea fi benefic dacă ar captura o parte din piața asiatică - ceea ce înseamnă că ar fi o achiziție bună pentru, de exemplu, Intel care dorește să câștige mai multă cotă de piață)
Pozitron

Arhitectură: Asimov ASIC - Nu există multe informații disponibile, dar mesajul cheie transmis de Positron este că memoria este regele: Așadar, dacă pot încorpora mult mai multă memorie DDR5 standard în ASIC-ul lor, folosind chiplet stacking, atunci pot avea o ofertă convingătoare în comparație cu NVIDIA Blackwell cu o dimensiune mai mică a memoriei.
Puncte forte: Accentul pus pe utilizarea ridicată a lățimii de bandă a memoriei (MBU) mai degrabă decât pe lățimea de bandă ridicată a memoriei standard (HBM). Aceasta înseamnă că pot crește ciclul de funcționare sau rata de utilizare a magistralei de memorie și, prin urmare, oferă o putere a memoriei echivalentă (sau chiar mai bună) (lățime de bandă * ciclu de funcționare, ca în V*I = wați pentru electricitate), astfel încât ar putea depăși concurența care s-ar lupta în continuare cu memorii scumpe.
Sarcină de lucru țintă: Va fi văzut când va fi disponibil primul Asic - dar se poate ghici că vor viza LLM-uri standard.
Vulnerabilitate: Stadiu foarte incipient și necesitatea găsirii partenerilor potriviți pentru turnătorie; Foarte probabil la 2~4 ani distanță de disponibilitatea generală și de soluțiile comerciale - va mai fi memoria un blocaj până atunci?
Axelera AI:
- Arhitectură: Metis și Europe AIPU; Este o arhitectură de calcul în memorie cu sistem de control al fluxului de date bazat pe RiscV.
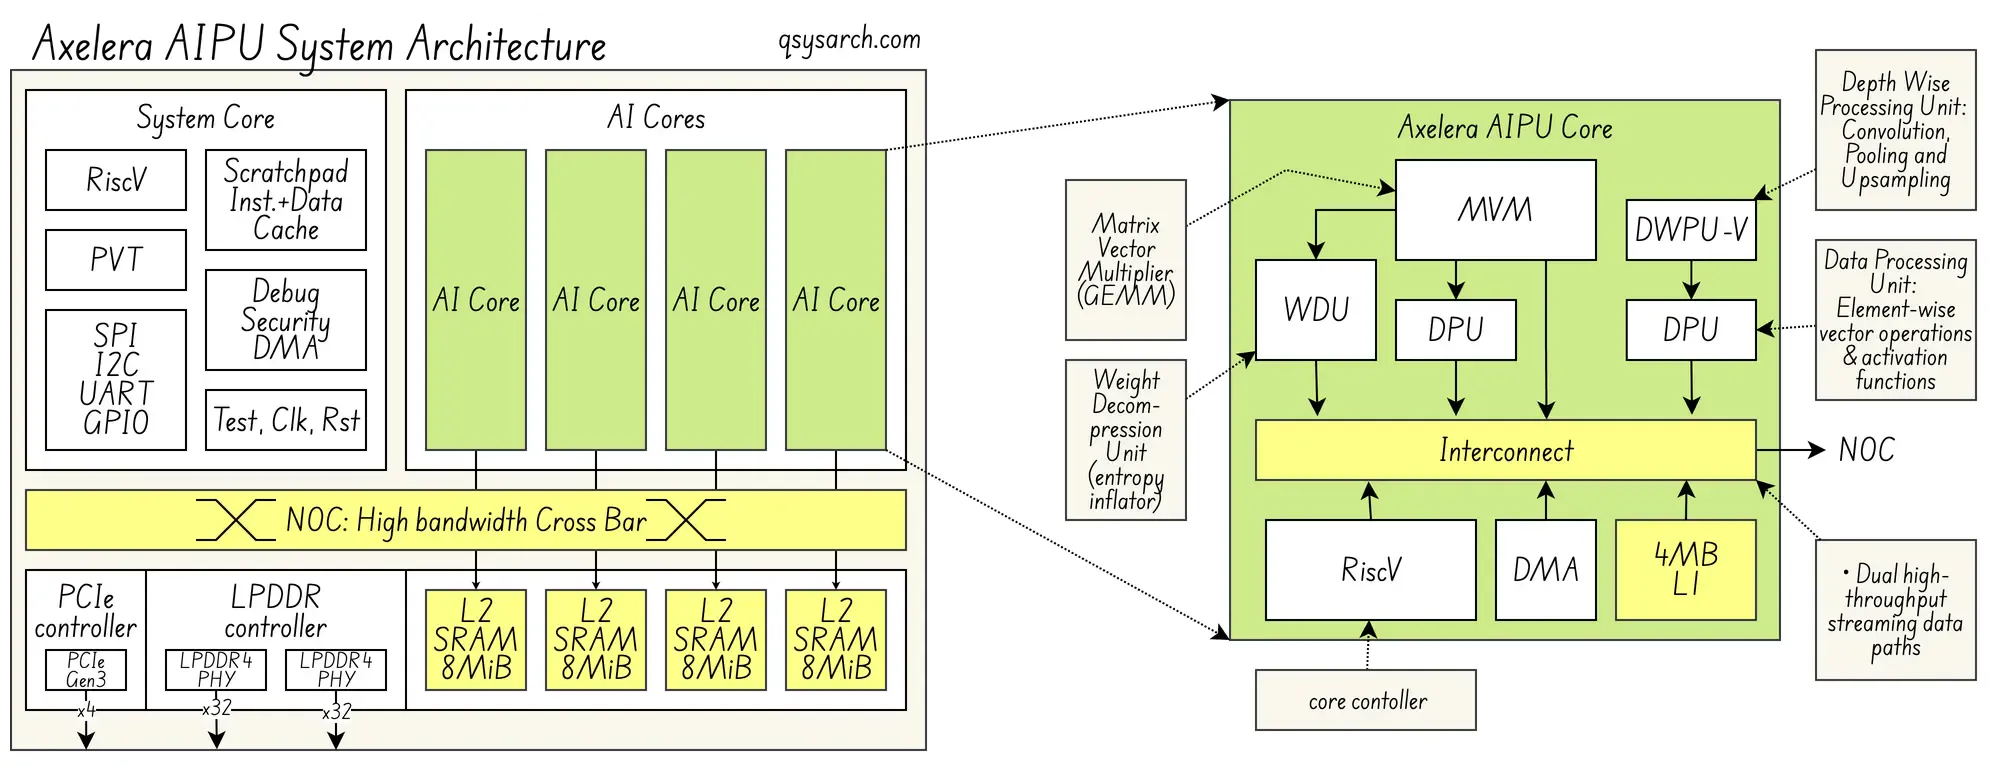
Putere centrală: Folosind procesarea în memorie, poate efectua operațiuni complexe direct în interiorul celulelor de memorie digitală, eliminând astfel mișcarea datelor; Acest lucru permite atingerea a 15 TOPS/Watt (comparativ cu ~3 pentru NVIDIA Blackwell). De asemenea, este o IP cu design complet european, ceea ce o face o soluție suverană.
Sarcină de lucru țintă: Prima generație s-a concentrat pe viziune computerizată / analiză video multi-stream; generația mai nouă (integrare M2) poate fi utilizată și pentru sarcini de lucru LLM și vLM la periferie.
Vulnerabilitate: Vulnerabilitatea Axelerei nu constă în inginerie - tehnologia lor este de talie mondială. Adevărata lor vulnerabilitate constă în fricțiunile pieței: pot pătrunde pe piață fără a-și diminua concentrarea?
În timp ce căutam informații despre companiile menționate mai sus, am dat peste alți câțiva factori care provoacă și disruptori în domeniul producției și care ar putea juca un rol semnificativ în anii următori. Iar ultima dintre ele, IA neconvențională, nu este cu siguranță cea mai puțin importantă, datorită succesului și viziunii sale anterioare liderului.

Extropic și Normal Computing
- Arhitectură: TSU (Unități de Eșantionare Termodinamică) / SPU (Unitate de Procesare Stochastică), folosind pentru operarea „p-biți” (cunoscut și sub numele de biți probabilistici)
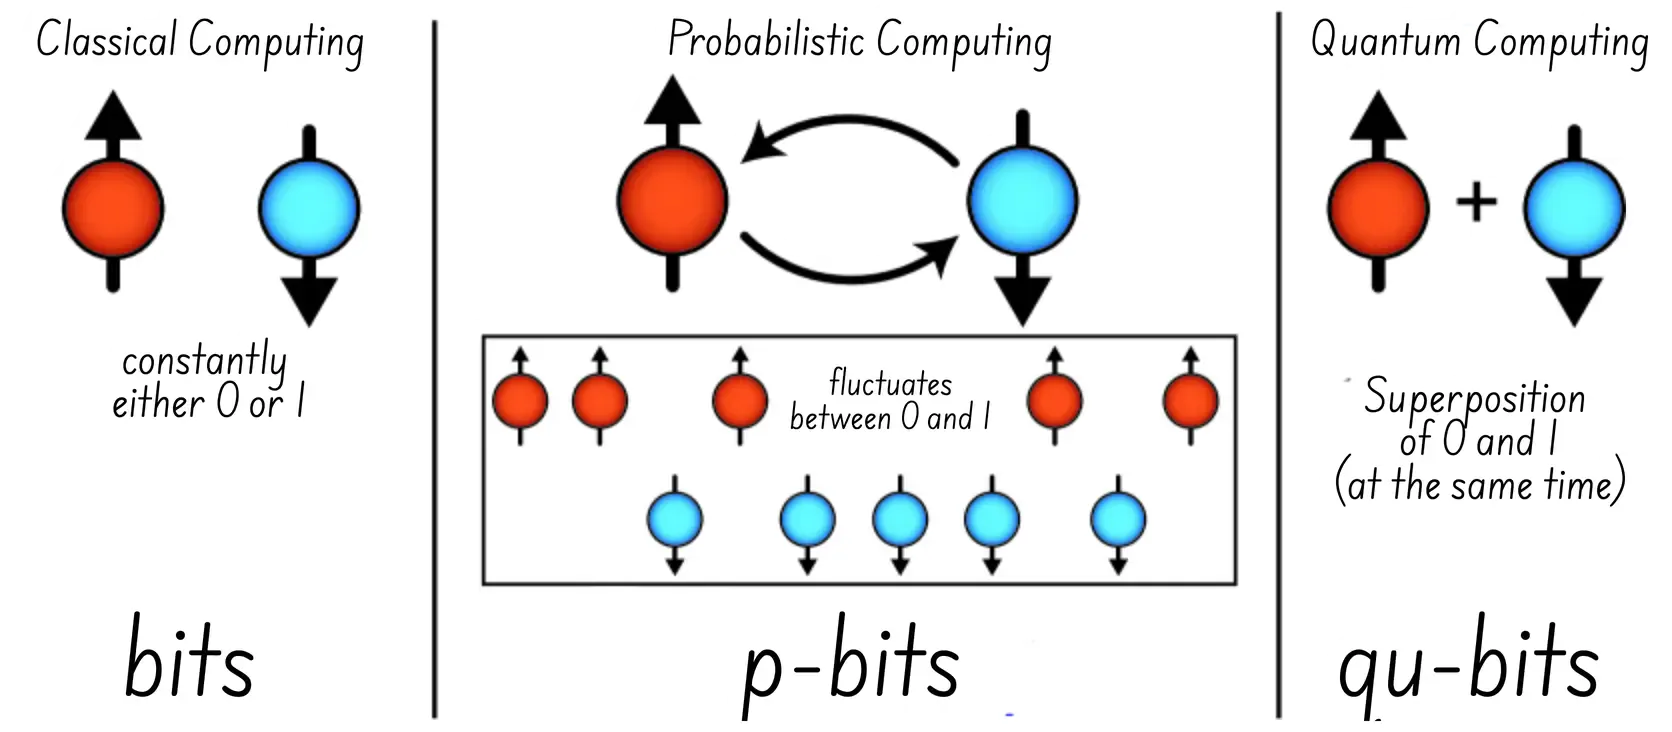
De ce este important acest lucru: Se pretinde că este de 10.000 de ori mai eficient decât GPU-ul pentru sarcini de lucru specifice, cum ar fi recoacerea (Aannealing). Acest lucru ar putea reprezenta o provocare semnificativă pentru biții cuantici.
Vulnerabilitate: Posibilitatea de utilizare la scală largă necesită încă destule cercetări.
Mottronix
Arhitectură: SPU (rețea neuronală cu spiking) folosind memorii Mott (Mott-RAM).
De ce este important acest lucru: Avem nevoie de oameni cu viziune de viitor care să ia în considerare memoria alternativă, cum ar fi memoria rezistivă (ReRAM) sau, în cazul Mottronix, memoria RAM Mott.
Vulnerabilitate: Trebuie să demonstreze că poate trece de la cercetare la IC productizat.
Akhetonics
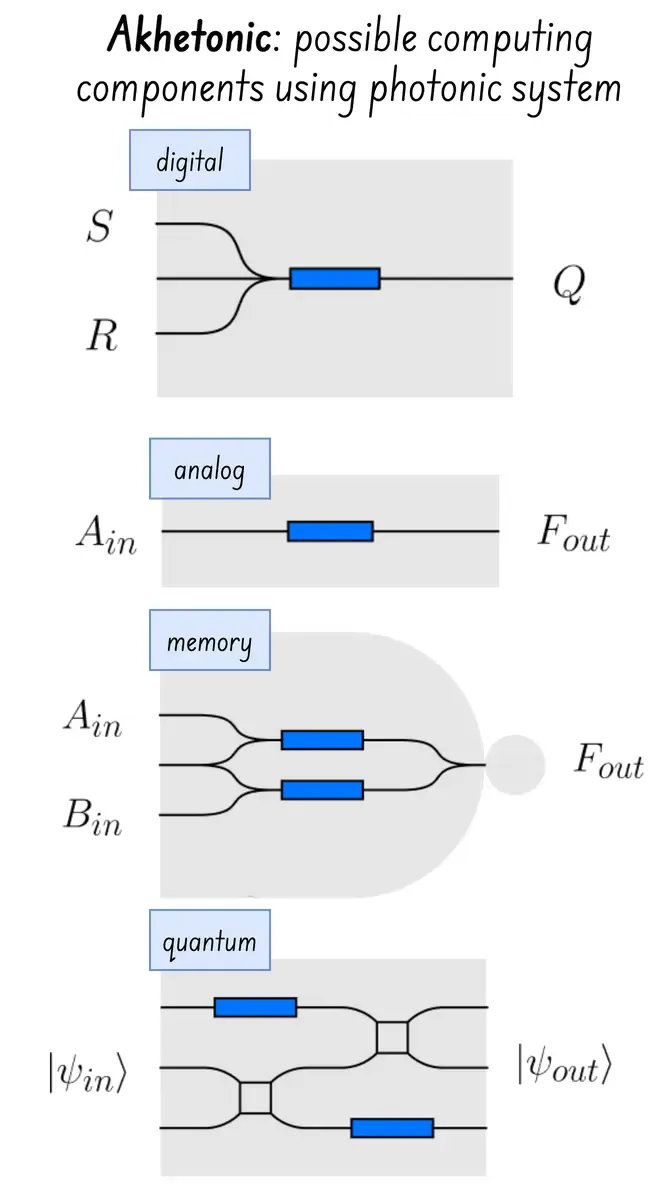
Arhitectură: RPU (Reasoning Processing Unit) utilizând un procesor digital complet optic
De ce este important acest lucru: Circuitele integrate fotonice au înregistrat o îmbunătățire extraordinară a randamentului în ultimul deceniu - NVIDIA, de exemplu, este acum capabilă să producă comercial comutatoare de rețea silicon photonic - iar aplicarea acestui lucru la sarcina de calcul este un pas firesc! (care permite, de asemenea, calculul cuantic adresat optic!)
Vulnerabilitate: Nu este clar care este diferența dintre calculul cuantic OAQ și calculul raționamentului RPU și, în ambele cazuri, necesită o calibrare și o reglare atentă înainte de scalarea la soluții comerciale.
Arago
- Arhitectură: „JEF” ca accelerator fotonic de inteligență artificială, capabil să ofere reduceri de 10×–30× ale consumului de energie - Informațiile publice despre Arago sunt foarte limitate, dar pare a fi o soluție hibridă deterministă/clasică + integrare a acceleratorului fotonic, combinată cu un SDK software full-stack și compatibil cu PyTorch.
 IA neconvențională
Arhitectură: [UN]CPU (Unitate de procesare [ne]convențională) folosind Oscilator Kuramoto
De ce contează acest lucru: Îmi place această idee, iar pentru ca ea să se întâmple, punerea în practică este esențială. Curajul de a gândi diferit este doar jumătate din luptă; cei care schimbă lumea cu adevărat depun efort zilnic pentru a realiza acest lucru. Și pentru asta, au un lider cu o experiență impresionantă.
Vulnerabilitate: Sunt încă la ziua 0->1, deci execuția este cheia.
Retrospectiva pieței în iunie 2026
Link to heading
Unde sunt adevăratele linii de luptă actuale care ar putea schimba peisajul actual al pieței?
Avantajul structural al NVIDIA nu este GPU-ul — ci ecosistemul CUDA creat în ultimii 10 ani. Pentru a duce această bătălie este nevoie de câștig la capitolul software, nu doar pe silicon — și aici eșuează multe companii inovatoare axate pe hardware.
AMD este cea mai subestimată amenințare pe termen scurt la adresa NVIDIA: nu trebuie să depășească CUDA, au propriul instrument și trebuie doar să fie „suficient de bun” pentru cumpărătorii de cloud sensibili la costuri. ROCm 6.x reduce decalajul mai repede decât se aștepta.
Majoritatea inovatorilor încearcă o variantă de compromis spațiu-timp; fie prin introducerea unei memorii localizate ultra-rapide; fie prin permiterea unui flux de date configurabil dinamic (conducte); În prezent, blocajul în memoria RAM;
- Poate că acești câștigători sunt cei care vor putea aborda ambele în același timp, ceea ce va fi și mai relevant pentru calculul matricelor rare (cu multe „zerouri”), unde se dorește evitarea transferului de zerouri în memorie, dar și calcularea de zerouri! Ar putea Renegade să facă diferența?
Producătorii de cipuri din următoarea generație privesc problema calculului dintr-un alt unghi: Poate că cheia este modelarea și alimentarea unui sistem dinamic, mai degrabă decât multiplicarea imperativă a numerelor unul după altul?
Ar putea fi granița o linie sensibilă între calculul cuantic și cel dinamic? Ar putea acest lucru rezolva atât provocarea criogenismului cuantic, cât și problema decoerenței qubitilor prin introducerea unui sistem intermediar care permite calculul exponențial fără a genera decoerență qubitilor?
Tehnologie și direcția pieței (2026~2029)
Link to heading
Rezumatul de mai jos este o viziune bazată pe opinii asupra orizonturilor de la nivelul 1 la nivelul 3. Trei schimbări vor defini următorul ciclu. Acestea sunt enumerate în ordinea impactului.
Memory Power™: Memoria, mai degrabă decât puterea de calcul, este factorul care permite accesul cantitativ la energie
Link to heading
LLM-urile sunt din ce în ce mai limitate de lățimea de bandă a memoriei, mai degrabă decât de capacitatea de calcul. Pe măsură ce modelele cresc și ferestrele de context se extind la peste 1 milion de token-uri, costul și latența mutării ponderilor către/de la HBM domină. Compromisul este între calculul aproape bazat pe memorie cu SRAM on-chip și memoria mare cu lățime de bandă suficientă: Indicatorul cheie de performanță (KPI) critic ar putea deveni puterea memoriei, definită ca lățime de bandă * ciclu de funcționare.
Modelele Mixture-of-Experts care activează doar o fracțiune din parametri per token (folosind o matrice dispersă) se încadrează, de asemenea, în această categorie: Majoritatea acceleratoarelor nu sunt încă optimizate pentru modele de activare dispersă, motiv pentru care NVIDIA a introdus Tensor Core. Poate că nu este soluția finală, ci un „patch hardware” în așteptarea a ceva mai consistent și robust.
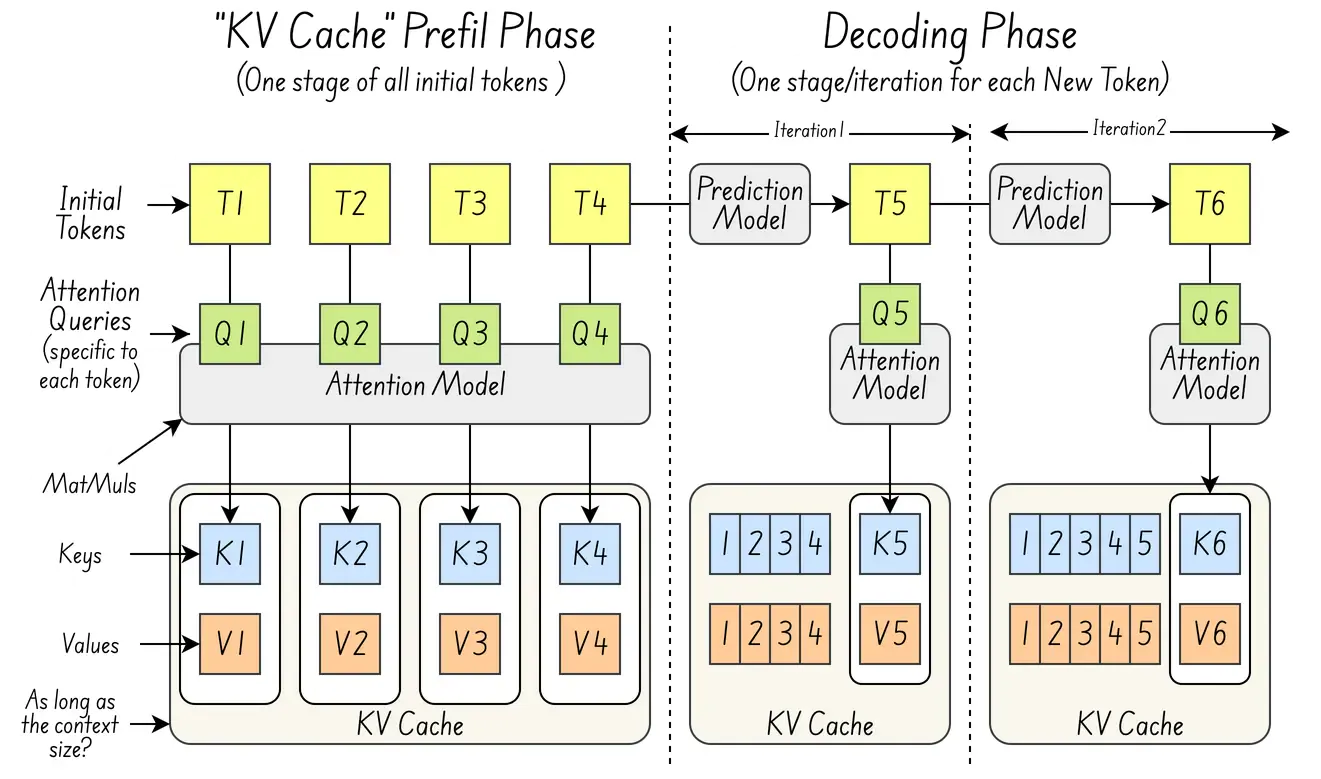 De exemplu, acum este obișnuit să se utilizeze dezagregarea de pre-umplere/decodare (PD) pentru a separa etapele de pre-umplere (memoria cache inițială KV construită din mai multe token-uri) și decodare (generarea câte un token pe rând) ale unui LLM. Acest lucru deschide calea pentru coprocesoare de inferență special concepute, deoarece pre-umplerea necesită o capacitate de calcul mai bună, în timp ce decodarea necesită o putere de memorie mai bună (necesitatea de a încărca un nou KVQ pentru fiecare token).
Nucleul NVIDIA Tensor pentru modelele Mixture-of-Experts disperse se încadrează și el în această categorie.
Prețurile pentru inferențe au scăzut de aproximativ 10 ori în doi ani. Adoptarea inteligenței artificiale în mediul enterprise este condiționată de costul inferenței, nu de calitatea modelului. Implicația: hardware-ul de inferență standard se situează sub nivelul de top (NVIDIA H100/B200) pentru servirea LLM standard. Aici, competitorii au cea mai clară oportunitate. Imaginați-vă că puteți rula GLM5.2 pe hardware-ul dvs. standard folosind procesorul Positron Asimov!
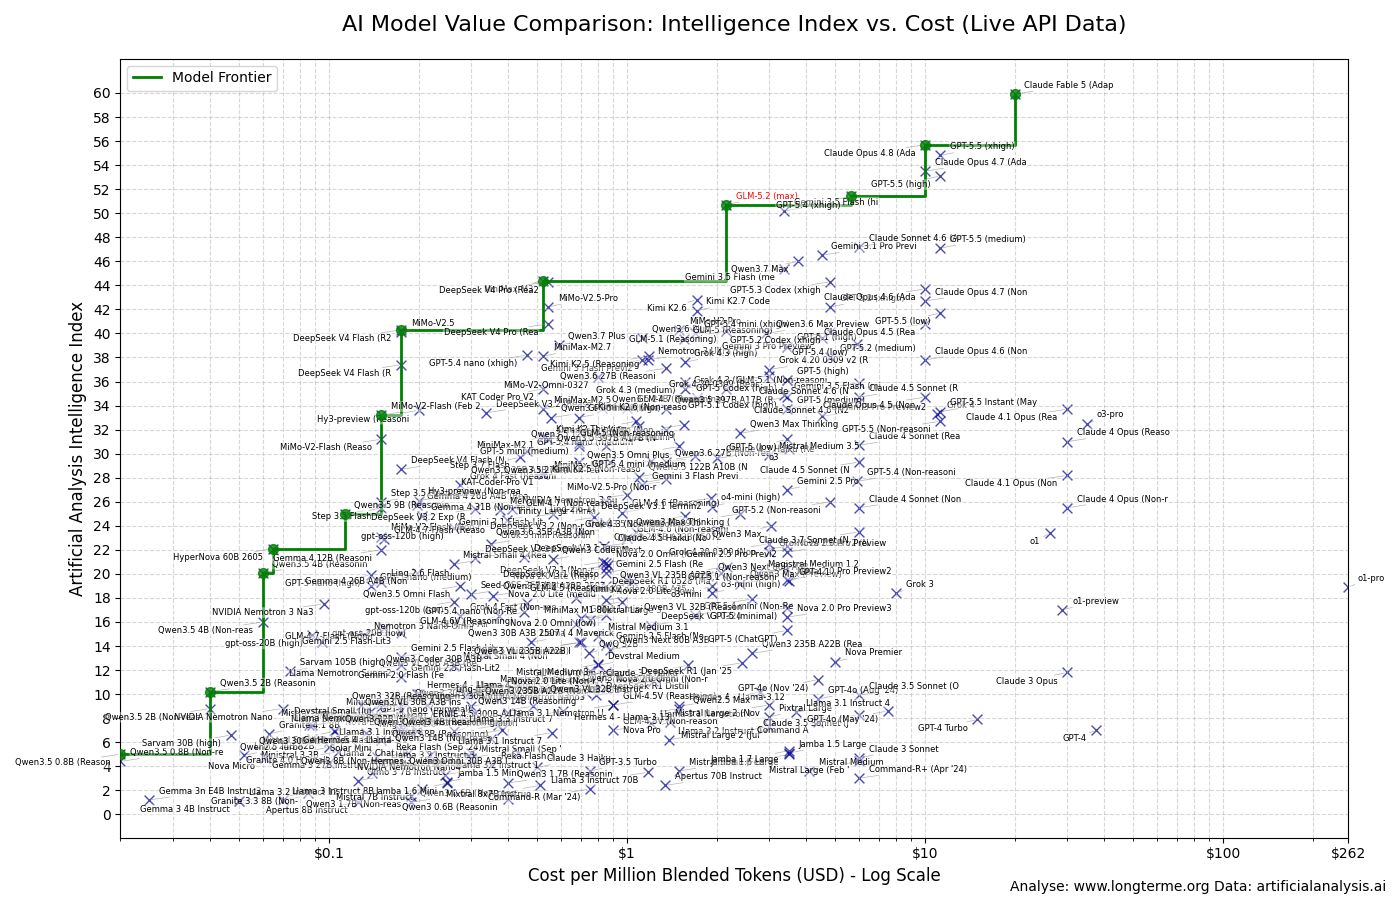 (sursa imaginii: L’Observatoire du Long Terme GLM5.2 este un străin clar în ceea ce privește inteligența/costul - dar necesită aproape 200 GB de memorie)
Simplitate în implementare: Nu în ultimul rând: ușurință în utilizare pentru hardware și software, interfață utilizator și instrumente
Link to heading
Întreprinderile subestimează în mod constant complexitatea operațională. Furnizorii care livrează „inferențe într-o cutie” cu runtime de configurare zero (nu doar cipuri) vor câștiga o cotă disproporționată din portofelul întreprinderii.
Acest lucru va fi accentuat de necesitatea de inferențe locale, din cauza presiunii de reglementare din UE și APAC, deoarece, da, multe companii nu doresc să își deducă cunoștințele de proprietate asupra unui sistem străin.
Piața inferenței în perioada 2024–2026 va arăta ca piața de rețele din perioada 2000–2003. NVIDIA este ca Cisco pe vremuri: dominantă, supra-proiectată pentru multe cazuri de utilizare și cu un preț premium. Întrebarea nu este dacă să contestăm NVIDIA în ceea ce privește cele mai bune sarcini de lucru ale sale. Ci acolo unde NVIDIA deservește prea mult piața și unde o alternativă special concepută poate oferi 80% din performanță la 40% din cost.
În același timp, NVIDIA investește masiv în ecosistem, iar contribuțiile excelente complet open-source, precum CudaQ și NVQLink, pe care NVIDIA le oferă gratuit comunității, vor îngreuna câștigarea de către orice concurent NVIDIA a acestor comunități.
Voila, acesta a fost un memoriu scurt și superficial de duminică dimineață. Va trebui să investighez mai mult detaliile arhitecturale ale viitorilor contracandidați și, din fericire, voi putea avea un memoriu pentru cel puțin doi dintre ei în această vară. Între timp, următorul memoriu va fi despre subiectul mult așteptat (pe care destui cititori m-au rugat să-l abordez): Corecția erorilor cuantice pe scurt!
https://api-docs.deepseek.com/news/news260424
Inferență SNN pe platforma neuromorfă eterogenă multi-core SpiNNaker2](https://arxiv.org/pdf/2406.17049)
Diagrame DrawIO utilizate în acest memo: