인공지능이 막대한 에너지를 소비하는 시대에 텐서 처리 장치(TPU)는 판도를 바꿀 만한 기술입니다. TPU는 구글이 머신러닝 작업을 위해 특별히 설계한 맞춤형 칩입니다.
이 간단한 메모는 TPU 아키텍처에 대한 개괄적인 시스템적 관점과 2016년 처음 출시된 이후 어떻게 발전해 왔는지에 대한 정보를 제공하기 위한 것입니다.
또한 다음과 같은 중요한 질문에 대한 답을 찾아보겠습니다. 이미 GPU가 있는데 왜 TPU가 필요할까요? TPU는 GPU에 없는 어떤 장점을 가지고 있을까요? 뉴로모픽 IC와는 어떻게 비교될까요? 그리고 TPU와 GPU를 대체할 만한 아키텍처는 없을까요?
 (출처: 구글 클라우드)
TPU가 존재하는 이유와 해결하는 문제점 Link to heading
TPU는 GPU와 마찬가지로 무어의 법칙으로 인한 성능 저하라는 한계를 극복하고 대규모 병렬 처리를 가능하게 하는 것을 목표로 합니다. 일반적인 연산을 처리하는 데 사용될 수 있고, 멀티코어 개념(데너드 스케일링 법칙 덕분)을 통해 어느 정도 병렬 처리를 할 수 있는 기존 CPU와 달리, TPU와 GPU는 단순하고 특정한 작업을 처리하도록 설계된 특수 하드웨어이며, 어떤 CPU보다 훨씬 효율적으로 작업을 수행합니다.
간단히 말해, 범용 CPU나 GPU보다 훨씬 뛰어난 성능과 효율성을 제공하는 것은 “일반성을 희생하고 성능을 향상시키는 것“이라고 할 수 있습니다.
TPU는 기본적으로 신경망에서 사용하는 행렬 곱셈 및 텐서 연산과 같은 복잡한 선형 대수 작업을 위해 설계되었습니다.
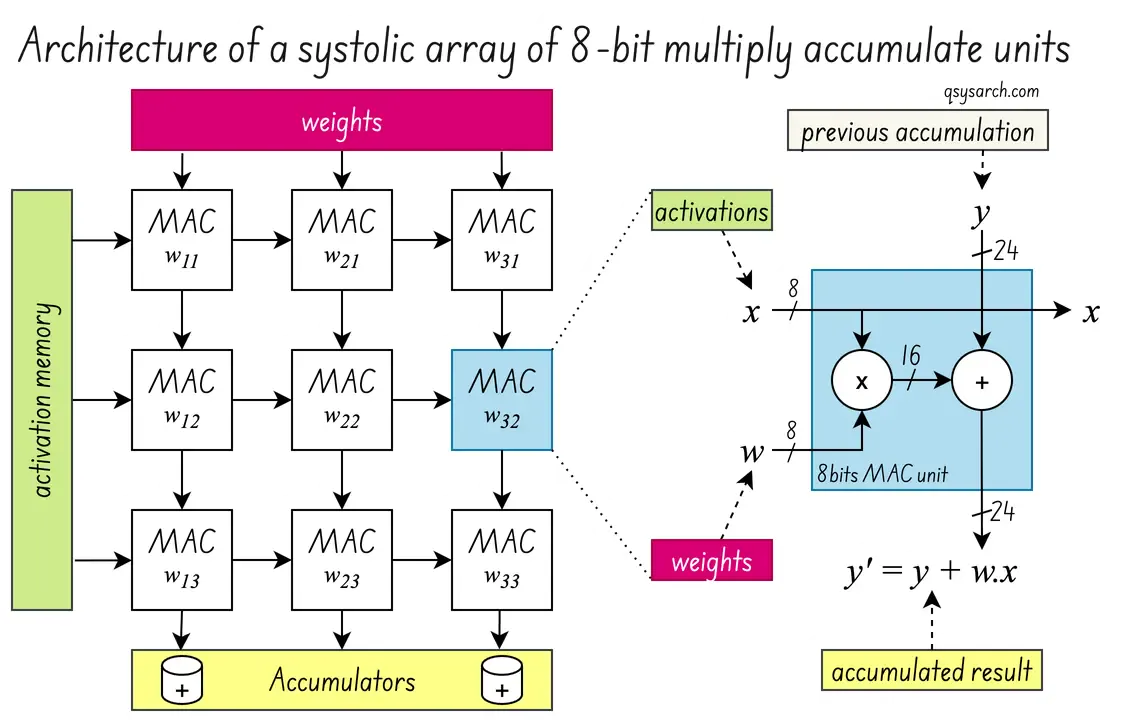
TPU의 핵심은 병렬 연산을 수행할 수 있는 처리 요소(일반적으로 PE라고 하며, 오른쪽 다이어그램에서는 MAC으로 표시됨)의 매트릭스인 시스톨릭 어레이입니다.
TPU의 경우, 이 처리 장치(MAC)는 활성화 값(임베딩)과 신경망 가중치를 곱하고 누적하는 간단한 8비트 곱셈기입니다. TPU는 이러한 연산을 대규모 병렬 방식으로 수행함으로써 CPU보다 훨씬 높은 처리량을 달성합니다. GPU도 마찬가지입니다! 하지만 먼저 TPU의 발전 과정을 살펴보겠습니다.
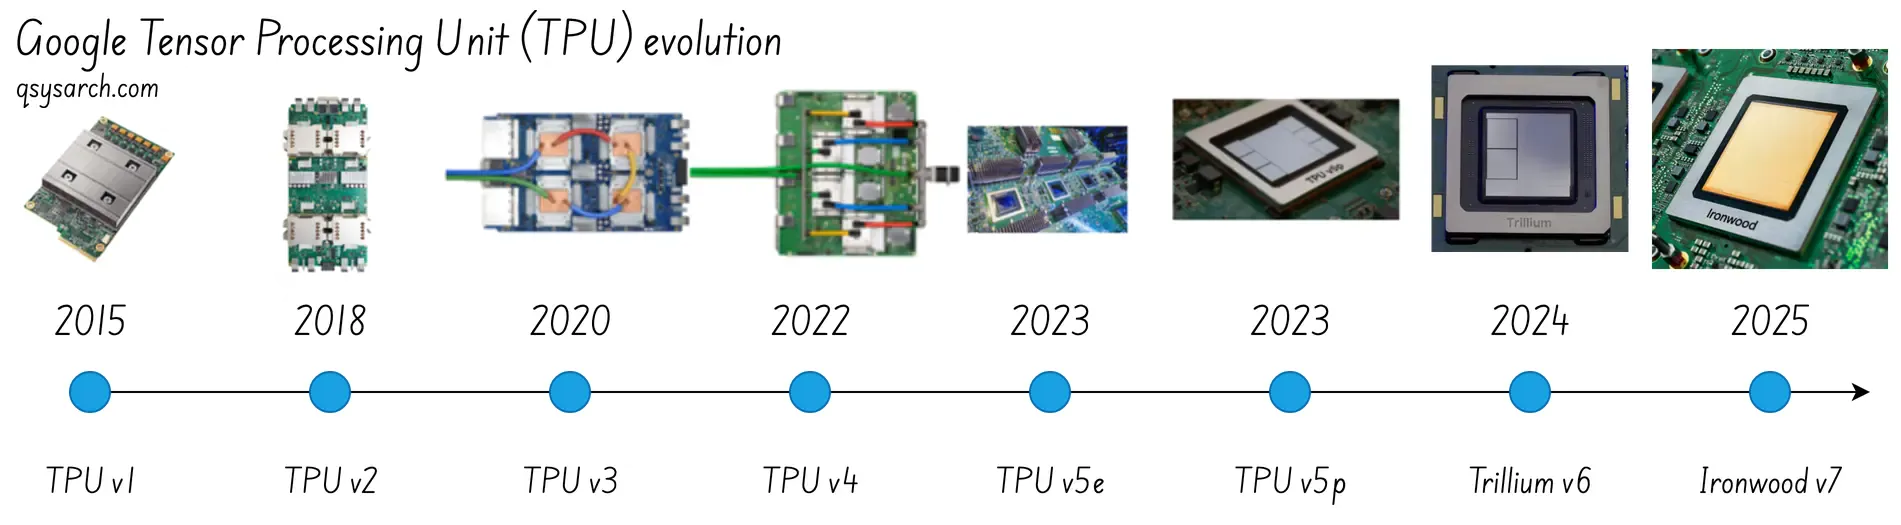
TPU의 시간 경과에 따른 변화 Link to heading
TPUv1: TPU의 첫 번째 세대 Link to heading
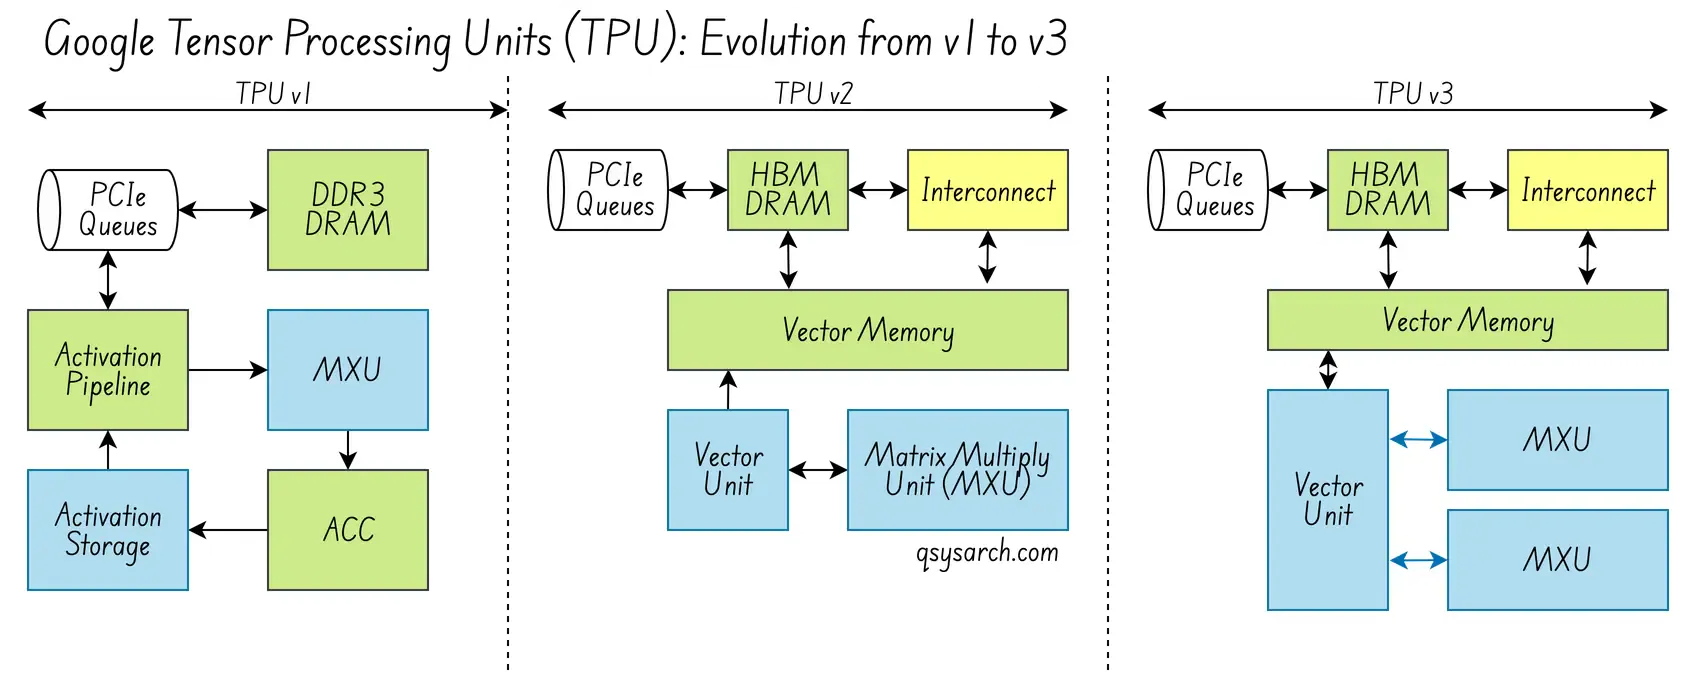
TPUv1은 신경망 추론 성능 향상(학습뿐 아니라 추론 자체)을 주된 목표로 삼아 단 15개월 만에 개발되었습니다. 이를 위해 구글은 행렬 곱셈기가 필요했고, 고속 처리뿐만 아니라 전력 소비 감소라는 제약 조건에도 직면했습니다. 전력 소비를 줄이는 핵심은 메모리 지역성을 개선하는 것이었습니다. 즉, 외부 메모리와 TPU 메모리 간의 불필요한 데이터 이동을 줄이는 것이었습니다. 이를 통해 단위 제어당 연산 강도를 높여 TPU가 데이터를 기다리는 유휴 시간을 줄일 수 있었습니다.
하드웨어 관점에서 볼 때, TPU v1 설계는 단순하면서도 우아하고 효과적이었습니다.
표준 PCIe 카드에 탑재된 단일 스레드 보조 프로세서.
다중 레벨 캐시, 멀티스레딩, 분기 예측 기능이 없습니다.
MXU(행렬 곱셈 장치)를 통해 8비트 정수에 대한 빠른 결정론적 연산을 수행합니다.
수축기 배열은 256 * 256 * MXU로 구성됩니다.
복잡성은 소프트웨어 스케줄러로 옮겨졌으며, 스케줄러는 두 가지 주요 책임을 맡게 되었습니다.
MXU가 유휴 상태가 되지 않도록 작업을 예약하여 파이프를 항상 가동 상태로 유지하십시오.
메모리 접근 지연 시간을 숨기기 위한 수단으로 메모리를 이중 버퍼링합니다.
구글 텐서 처리 장치(TPU)의 진화, V1부터 V3까지
TPUv2 및 v3: 메모리 및 인터커넥트 개선 Link to heading
v2와 v3의 핵심 개념은 역전파, 더 높은 정밀도, 그리고 훨씬 더 많은 분산형 상호 연결 TPU를 필요로 하는 차세대 모델을 학습시키는 것입니다.
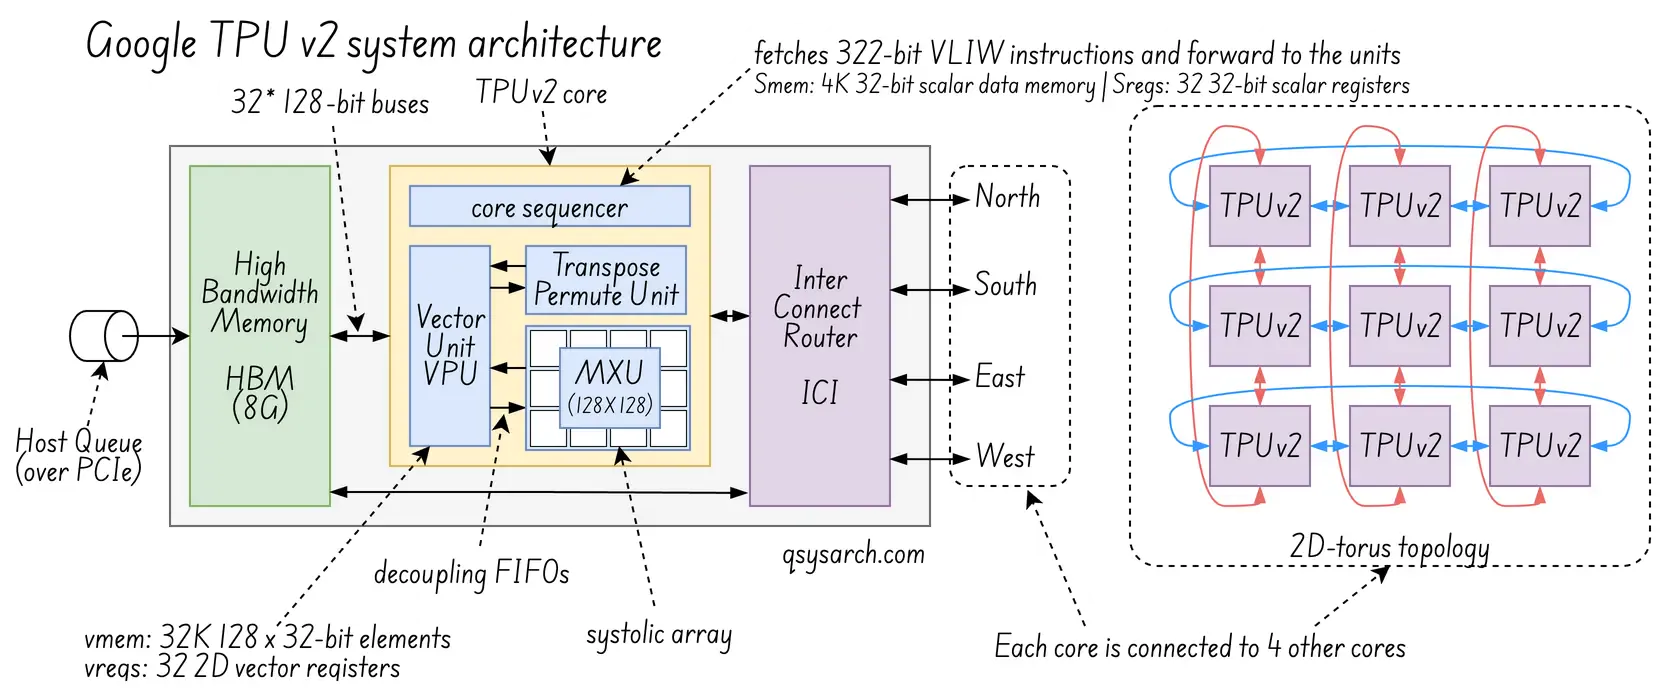
하드웨어 코어 프로세싱 관점에서 보면, 그들은 꽤 괜찮은 개념들을 많이 도입했습니다.
듀얼 코어 칩, 예를 들어 TPUv2는 두 개의 TPU로 구성됩니다.
각 TPU는 __128*128 MXU__로 구성된 4배 더 큰 수축기 어레이를 가지고 있었습니다.
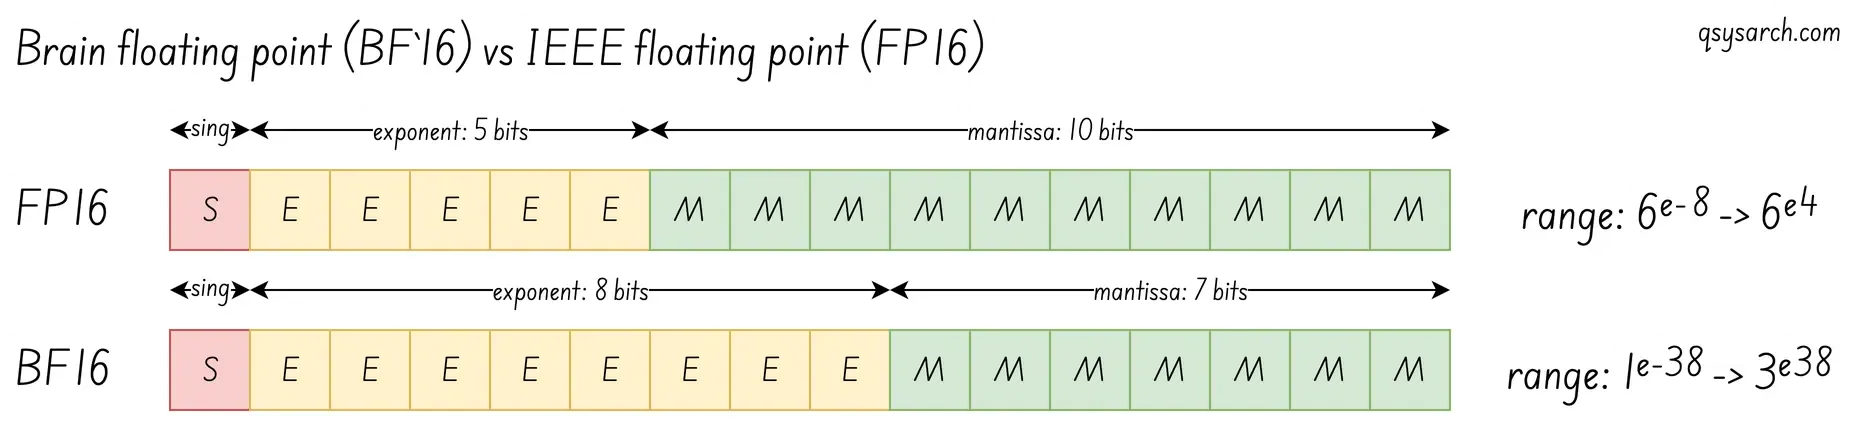
표준 IEEE 754 FP16 부동 소수점 형식의 향상된 버전인 브레인 부동 소수점 형식(BF16)을 사용하여 부동 소수점 값을 처리할 수 있는 기능.
TPU 내부에 새로운 고대역폭 메모리(HBM)를 탑재하여 메모리 접근 지연 시간을 단축했습니다. (TPUv1은 접근 속도가 느린 기본 DRAM만 사용했지만, HBM은 훨씬 빠릅니다.)
하드웨어 연결성 관점에서 볼 때,
- 코어 간 상호 연결(ICI)은 16x16 2D 토러스 네트워크(링 네트워크)를 통해 확장성을 가능하게 하는 고대역폭 패브릭입니다. - 256개의 칩으로 구성된 슈퍼컴퓨터 포드.
소프트웨어 관점에서 볼 때, 강력한 컴파일러는 다음과 같은 특징을 갖습니다.
- XLA 컴파일러: 코어 시퀀서(TCS)에서 사용하는 VLIW 명령어를 생성하는 핵심 장치.
TPUv4: 하이퍼스케일 AI Link to heading
v4의 핵심 개념은 AI 모델을 초고속으로 실행할 수 있는 능력이었습니다. 즉, 핵심적인 추진 지표는 총 소유 비용(TCO)이었습니다.
최신 세대 칩들은 대규모 학습에 최적화되어 있습니다. 칩들은 고급 메모리 시스템과 상호 연결 장치를 갖추고 랙이나 포드 형태로 연결됩니다. 또한 대규모 텐서 연산, 분산 학습, 동기화, 그리고 여러 칩 간의 효율적인 데이터 공유를 지원합니다.
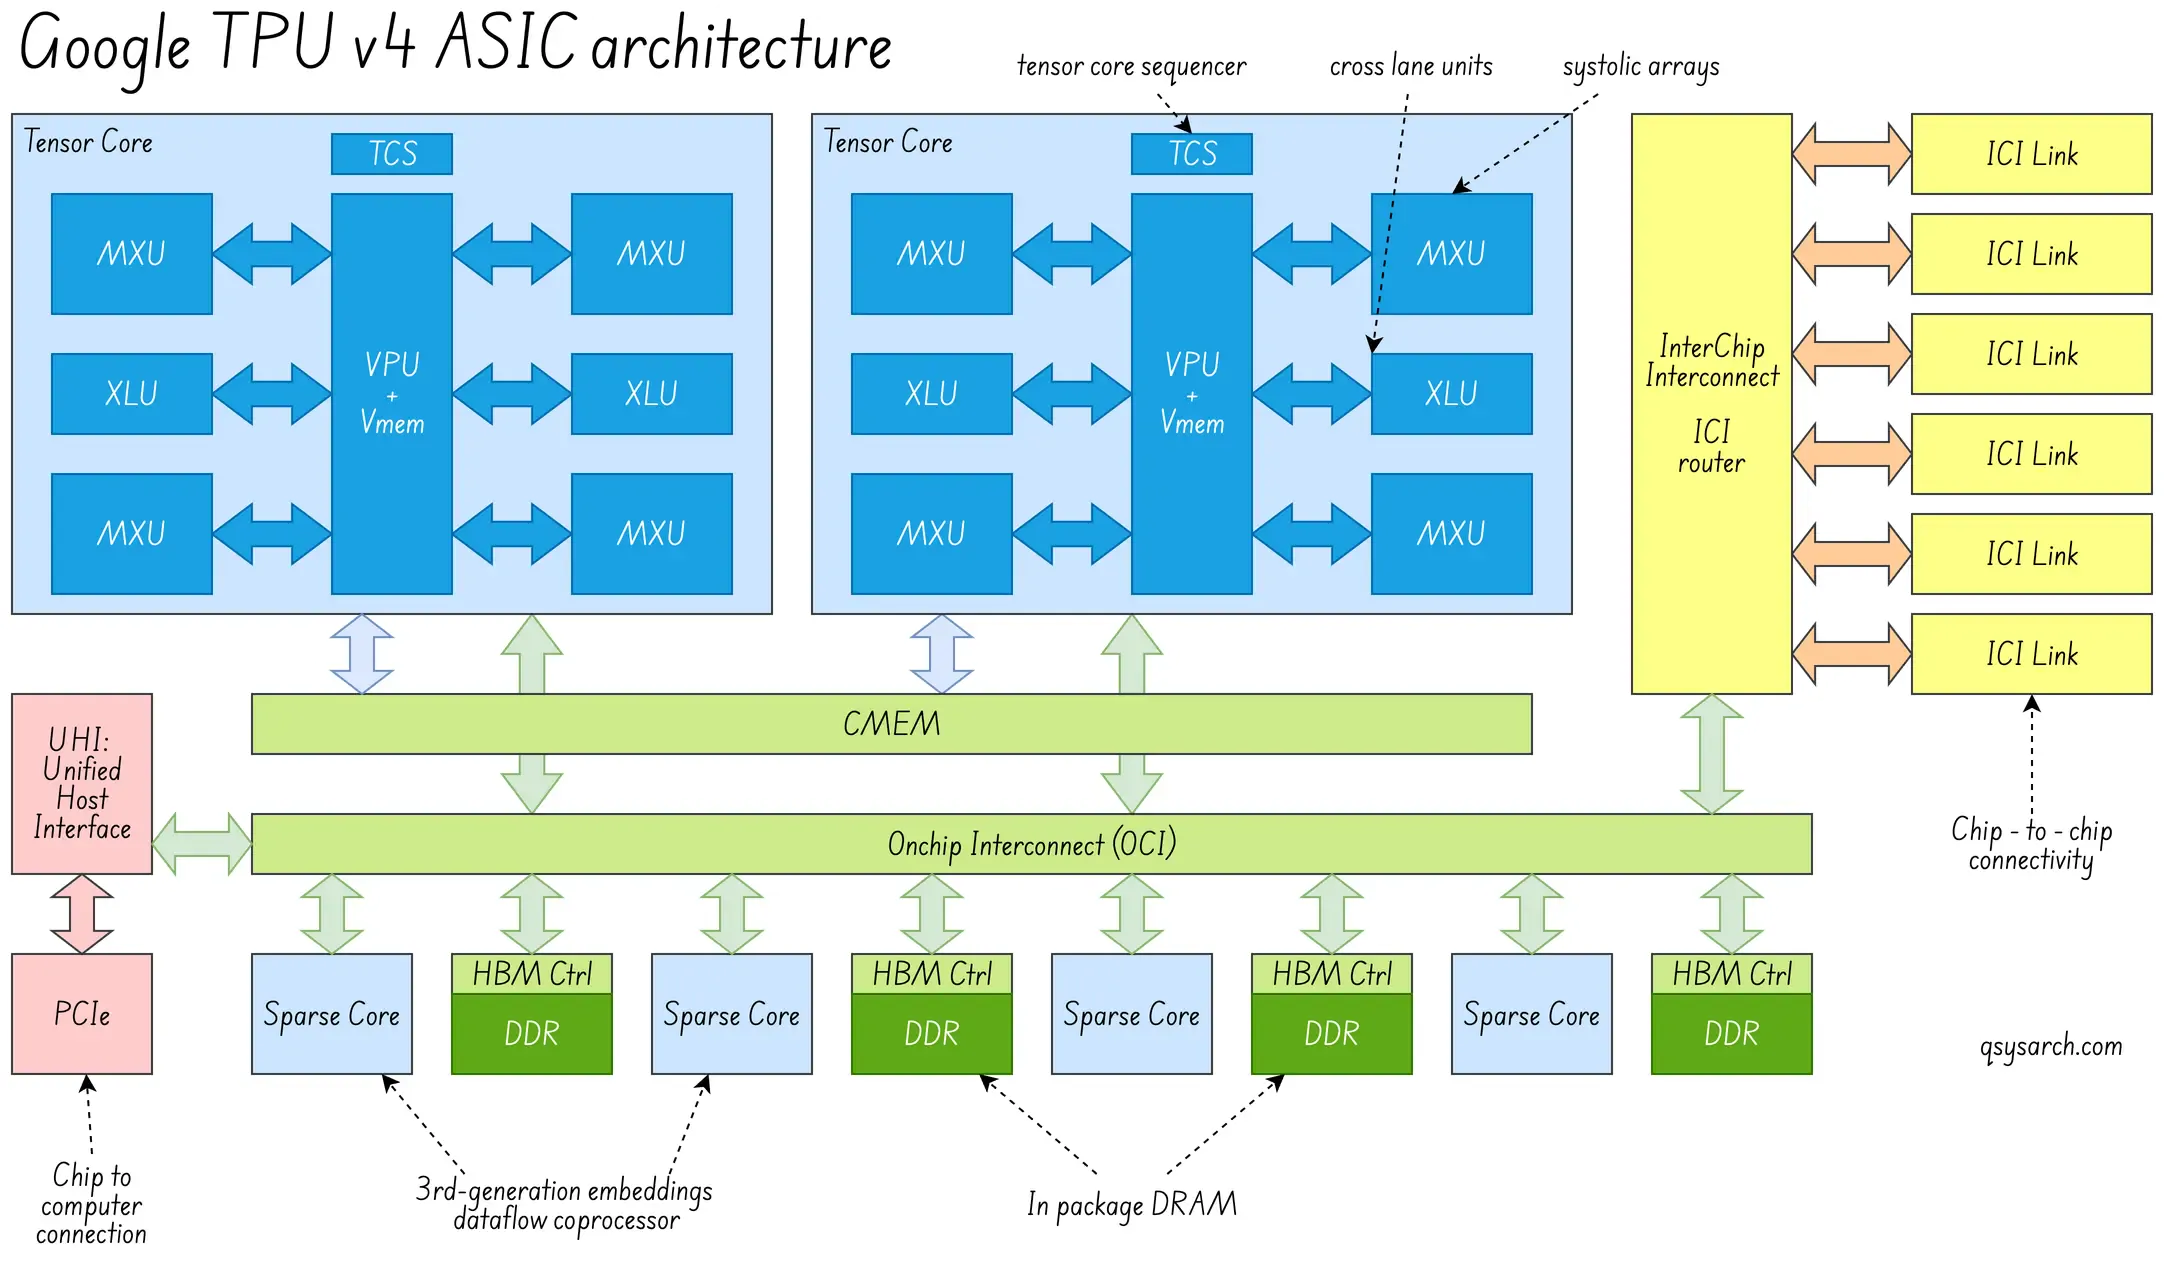
하드웨어 코어 프로세싱 관점에서 보면, 그들은 꽤 괜찮은 개념들을 많이 도입했습니다.
스페어 코어: “제로 작업"이 MXU에 도달하는 것을 방지하여 메모리 활용률을 향상시킵니다.
메모리 캐시: (원격 RAM 액세스보다 20배 더 효율적)
하드웨어 연결성 관점에서 볼 때,
TPUv4는 TPUv2 및 v3와 마찬가지로 동일한 랙 내의 TPU 간 고속 전기 링크로 구현되는 인터커넥트 라우터(ICI)를 계속 사용합니다.
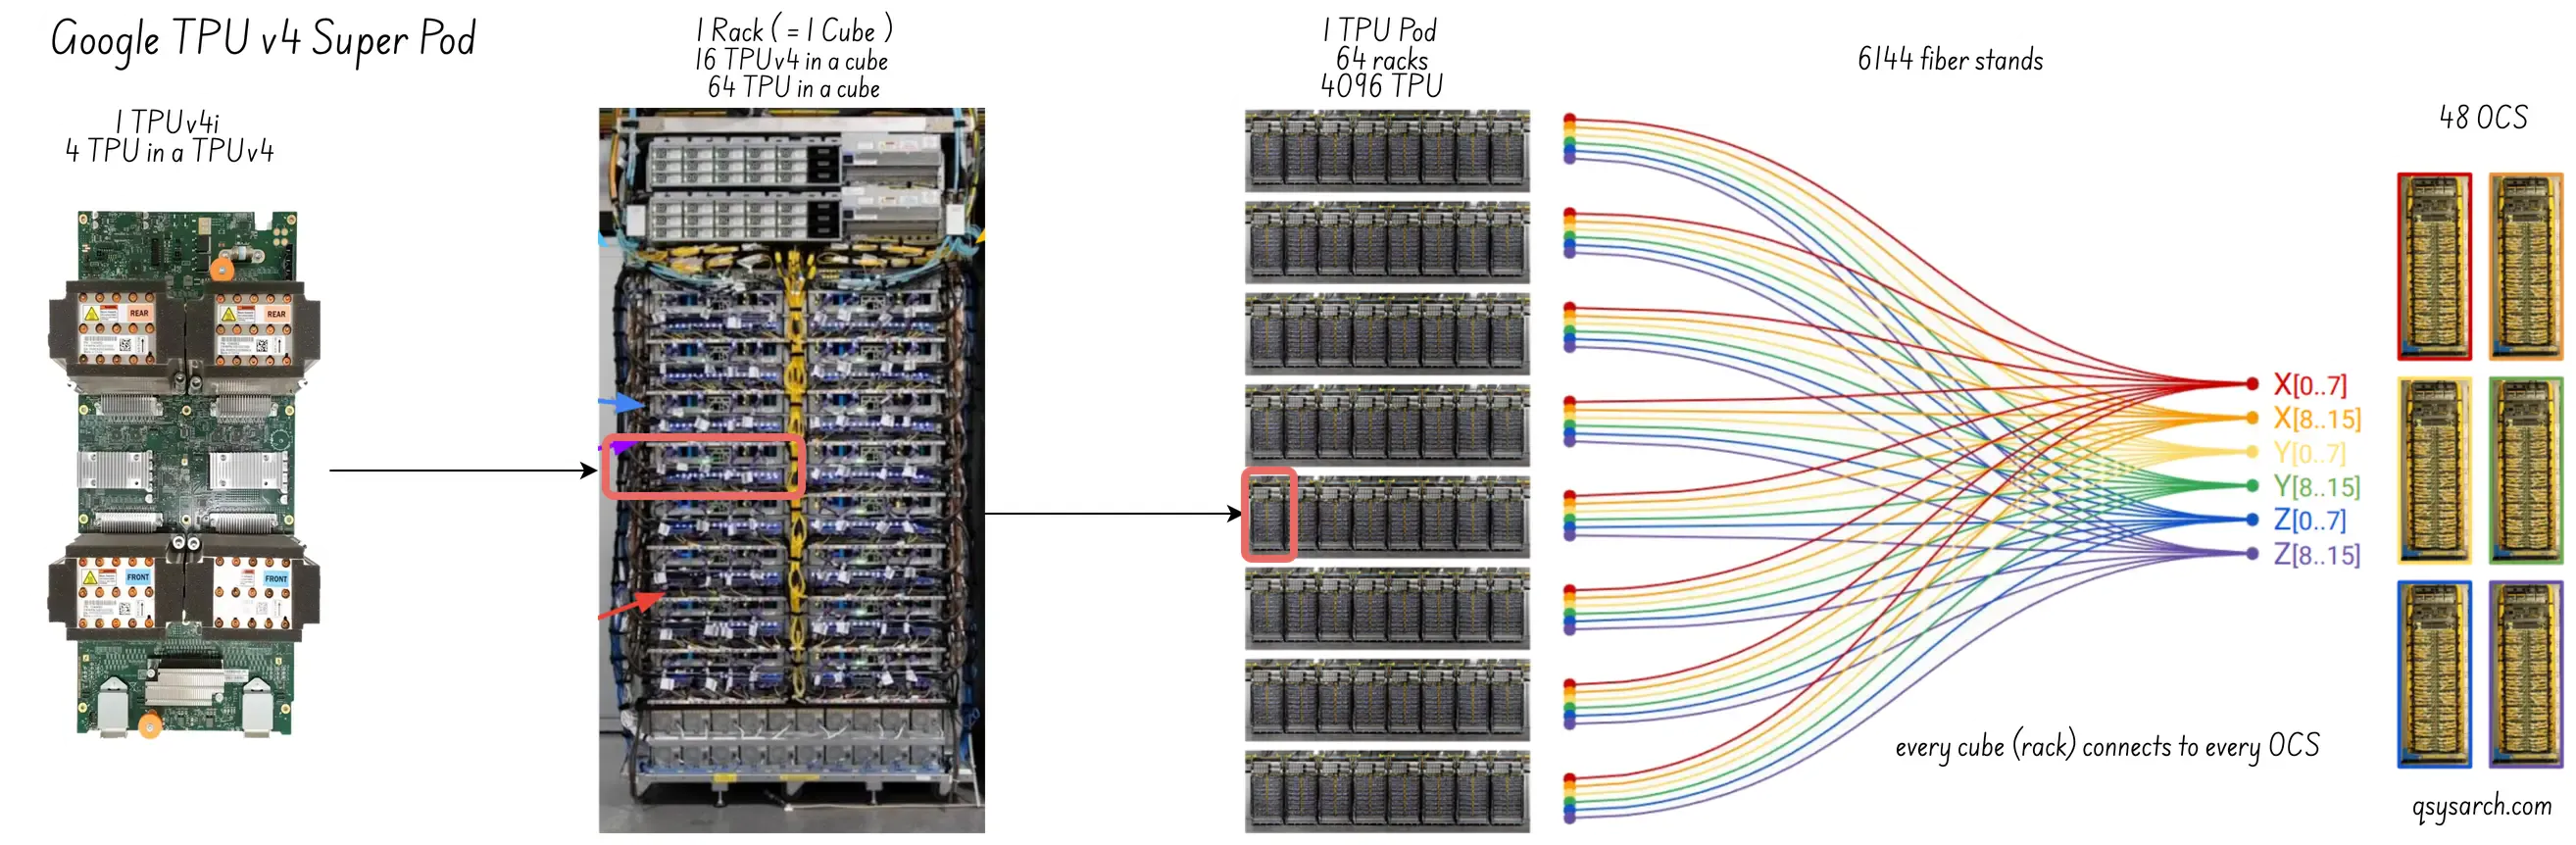
하지만 TPUv4는 랙 간에 OCS(Optical Circuit Switching)라고 하는 추가적인 Optial 링크를 갖습니다. 이를 통해 포드 내 TPU 수를 4,000개(단일 랙의 경우 64개)까지 늘릴 수 있을 뿐 아니라 OCS 라우팅을 재구성하여 장애 발생 시 성능을 향상시킬 수 있습니다.
마지막으로, 라우팅이 3차원 토러스를 구현함으로써 3차원화되었는데, 이는 2차원 토러스보다 통신 효율을 훨씬 더 효과적으로 확장할 수 있다는 무시할 수 없는 장점을 가지고 있습니다.
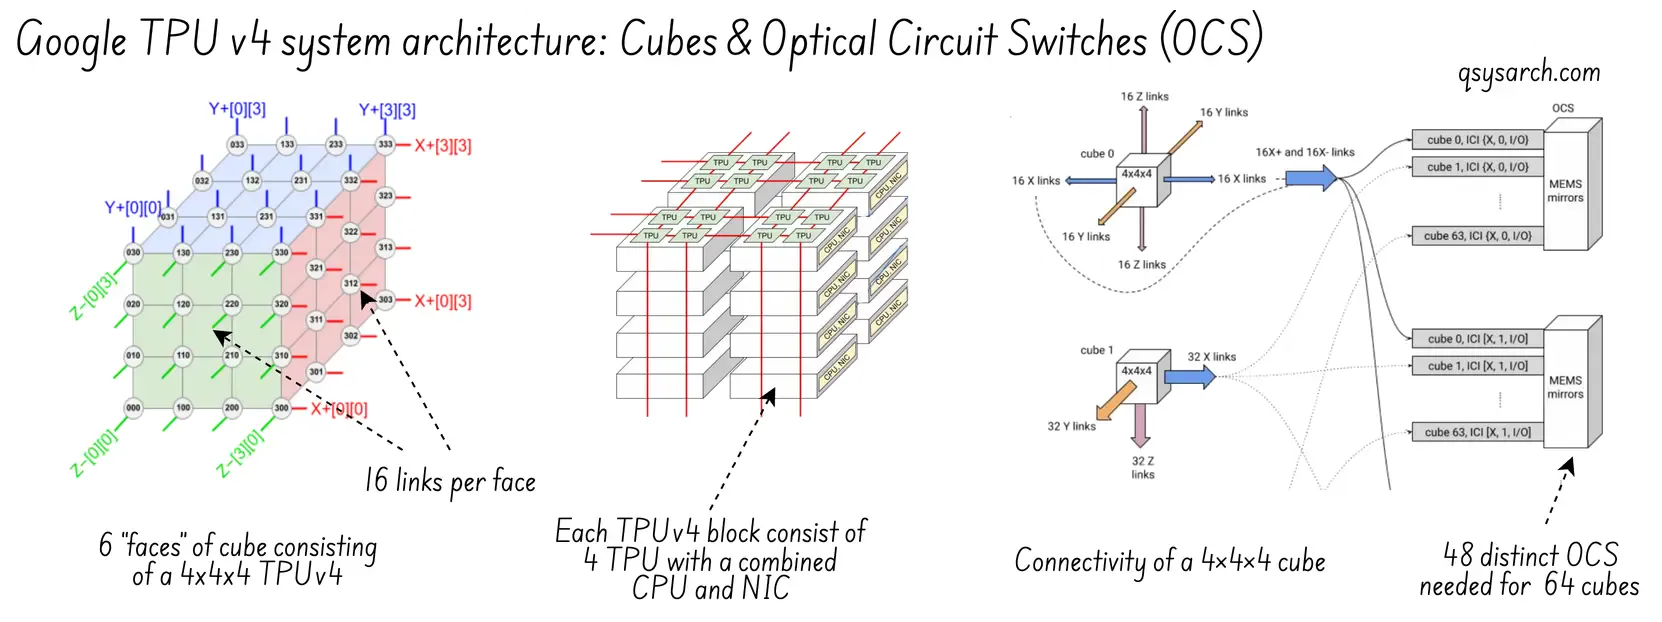
소프트웨어 개발 관점에서 보면 다음과 같습니다.
새로운 도구 도입: 클러스터 관리자로 Borg, OCS 구성을 위한 Pod Manager, 그리고 ICI 라우팅 테이블 설정 및 내결함성 처리를 위한 Libpunet이 도입되었습니다.
고급 단일 프로그램 다중 데이터(SPMD) 컴파일러: 이는 컴파일러가 여러 스레드를 생성하는 것으로 볼 수 있으며, 각 스레드는 동일한 랙 내 또는 다른 랙에 있는 서로 다른 TPU에서 실행되는 프로그램입니다. 이는 컴파일러가 GPU 워프 내의 스레드에 대한 코드를 생성하는 GPU의 SIMT 개념과 다소 유사합니다.
많은 TPU가 동일한 프로그램을 실행하고 있으므로 Borg 오케스트레이터는 모든 TPU가 동기화되도록 해야 합니다. 이것이 바로 갱 스케줄러의 역할입니다.
- 교육부의 비동기 데이터 흐름 처리에 필요한 “경로” 개념을 설명하십시오.
스파스코어 Link to heading
TPUv4의 SparseCore(https://openxla.org/xla/sparsecore)(일명 SC)는 대부분의 값이 0이거나 중복되는 희소 행렬(LLM에서 발견되는 임베딩의 경우와 유사함)을 사용하는 워크로드의 가속을 담당합니다. 이는 “임베딩 조회” 최적화 도구로 설명되며, 각 TPUv4에는 4개의 SparseCore 프로세서가 포함되어 있습니다.
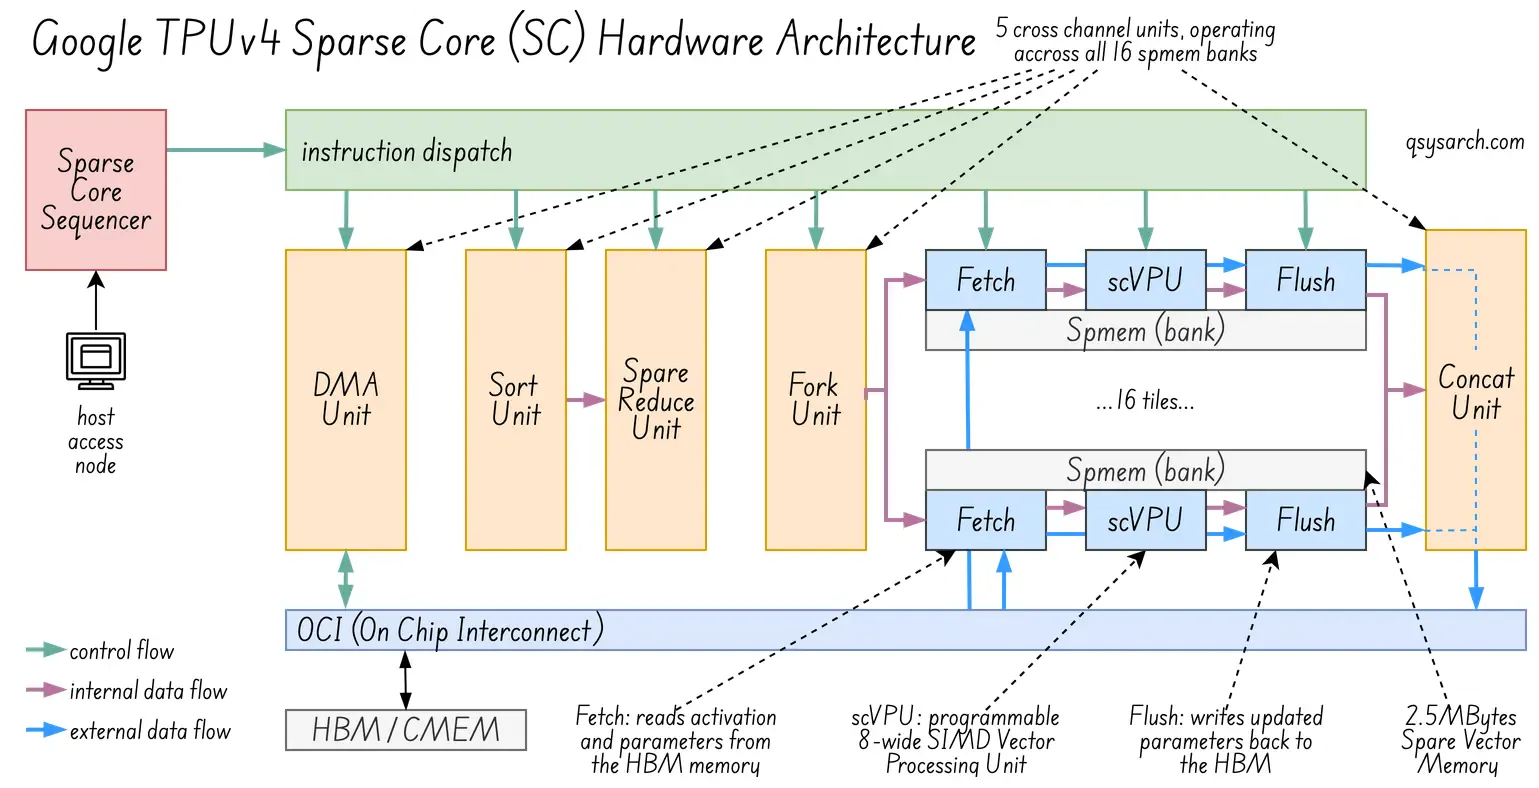 (원본 이미지 출처: 이미지 소스에서 발췌)
SparseCore 시퀀서(왼쪽 상단 모서리의 빨간색 부분)는 5개의 크로스 채널 유닛(주황색 부분)과 3개의 “가져오기/처리/플러시” SIMD 유닛(파란색 부분)에 명령어를 분배하는 역할을 담당하는 오케스트레이터입니다. 각 SIMD 유닛은 자체적으로 2.5MB 크기의 긴밀하게 연결된 메모리 스크래치패드(회색 부분)에서 작동합니다.
각 페치/프로세스/플러시 SIMD 유닛이 한 번에 8개의 데이터 레인(SIMD=8)을 처리하고, 스파스 코어 프로세서에는 이러한 SIMD 유닛이 16개 있다는 점을 고려하면, 이는 매우 강력한 처리 장치가 됩니다. 마치 GPU 안에 작은 GPU가 있는 것과 같죠! 더 정확히 말하면, TPU 안에 작은 GPU 4개가 있는 것과 같습니다!
이 강력한 SparseCore 프로세싱 유닛을 프로그래밍하는 데 사용된 ISA를 살펴볼 수 있다면 정말 좋겠지만, 온라인에서 관련 정보를 찾을 수 없었습니다. 아마도 이 유닛이 매우 특수한 명령어들을 사용하는 강력한 “동기식 SIMD ALU 및 DMA 기능을 갖춘 컴퓨터"와 같아서, JAX 라이브러리와 같은 상위 수준의 추상화 계층을 제공하는 것이 더 효율적이기 때문일 것입니다.
실제로 사용자는 고수준의 기능 코드를 작성하고, XLA(가속 선형 대수) 컴파일러는 SparseCore의 하드웨어 기능과 일치하는 패턴을 식별합니다.
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
    @nn.compact
    def __call__(self, indices):
        embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
        return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
내부적으로 무슨 일이 일어날까요? model.apply 메서드는 XLA 컴파일러를 호출하여 코드를 SparseCore로 변환합니다. 이를 위해 nn.Embed(gather 작업)를 찾아 다음과 같은 “의사 명령"을 생성합니다.
중복 제거: XLA는 입력에 42와 105가 두 번 나타나는 것을 감지합니다. 따라서 페치 전에 이러한 중복을 제거하기 위해 SparseCore 명령어를 생성합니다.
DMA: ID 105, 42, 28에 대한 메모리 오프셋을 계산하기 위한 SC 스칼라 명령어를 생성합니다.
푸시: 결과로 생성된 5*128 텐서를 공용 메모리(CMEM)로 다시 이동합니다.
XLA 컴파일러는 데이터 배치도 처리해야 합니다. 특히, 스파스 코어는 nn.Embed 인덱스에 접근해야 하므로, 해당 인덱스는 스파스 코어가 접근 가능한 메모리 영역에 배치되어야 합니다. CMEM에 배치할 수도 있지만, CMEM의 용량이 상당히 작기 때문에(128MB) 일반적으로 임베딩 데이터는 대용량 HBM(TPUv4의 경우 32GB)에 배치됩니다. 하지만 스파스 코어 처리의 출력 결과는 데이터의 일부에 불과하므로 다시 CMEM에 저장됩니다.
또한 SparseCore 아키텍처가 다음 v6+ 세대에서 진화했다는 점도 주목할 만합니다.
교육부 전문가 혼합 및 경로 Link to heading
전문가 혼합(MoE)은 기존 방식과는 달리…
경로 개념은 토큰이 서로 다른 TPU 칩에 있는 전문가들에게 분산될 때 거치는 물리적 및 논리적 경로를 나타냅니다.
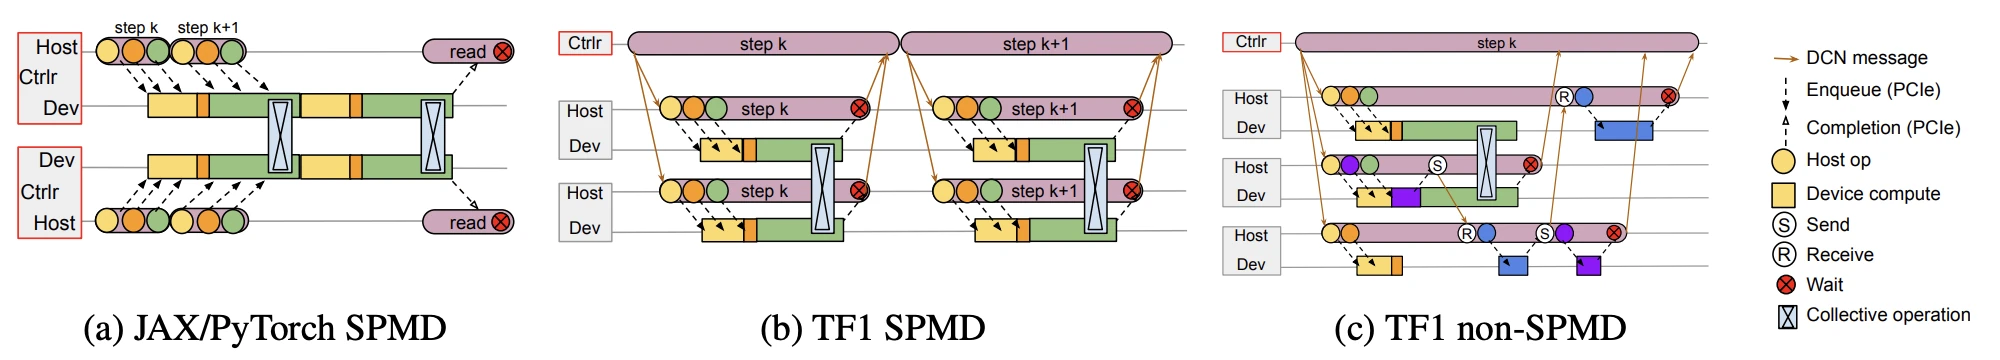 (이미지 출처)
2023년 이후: v5, v6(트릴럼) 및 v7(아이언우드) Link to heading
신형 모델에 대한 정보는 많지 않아서, 저것들이 바로 그 큰 헤드라이트입니다.
v5e: 칩당 16GiB HBM3e;
v5p: 칩당 95GiB HBM3e;
v6: 칩당 32GiB HBM3e; BF16 성능 향상
v7: 192 GiB HBM3e ; 새로운 FP8 정밀도
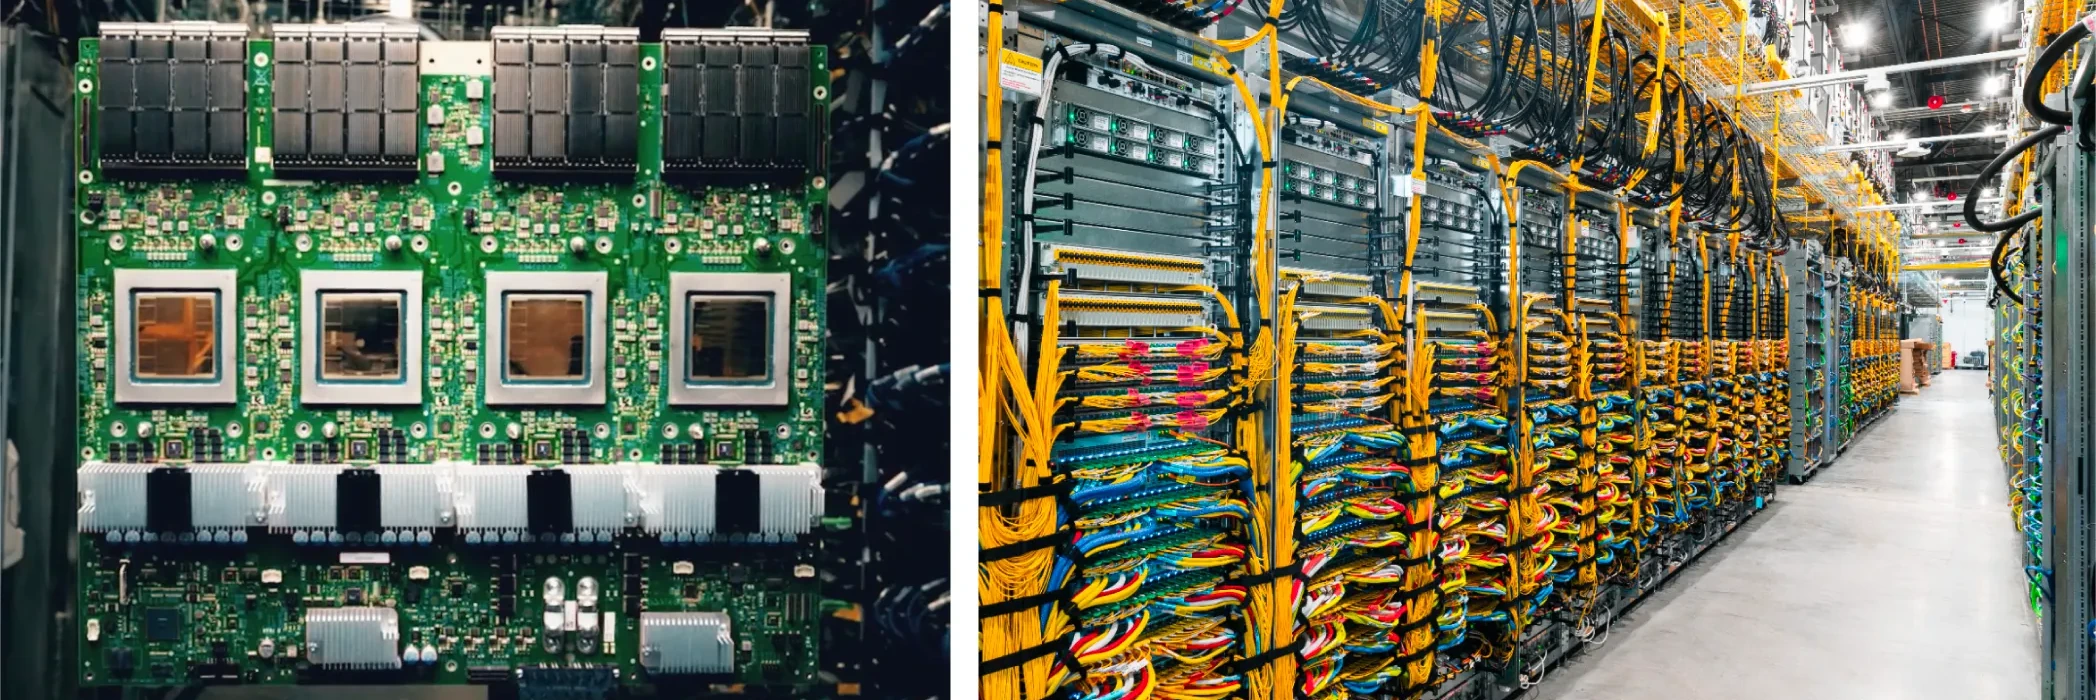
Ironwood v7을 사용하면 슈퍼 포드는 약 9,000개의 TPU로 구성됩니다.
그렇다면 TPU가 있는데 왜 여전히 GPU가 필요한 걸까요? Link to heading
TPU의 설계는 메모리, 컴퓨팅 성능, 에너지 사용량 및 데이터 통신 간의 균형을 맞추도록 되어 있으며, 이는 고성능 AI 시스템을 대규모로 구축하는 데 있어 단순히 빠른 칩을 사용하는 것만으로는 부족하다는 것을 보여줍니다. 하드웨어, 소프트웨어, 시스템 및 네트워크 연결 간의 조화 또한 필수적입니다.
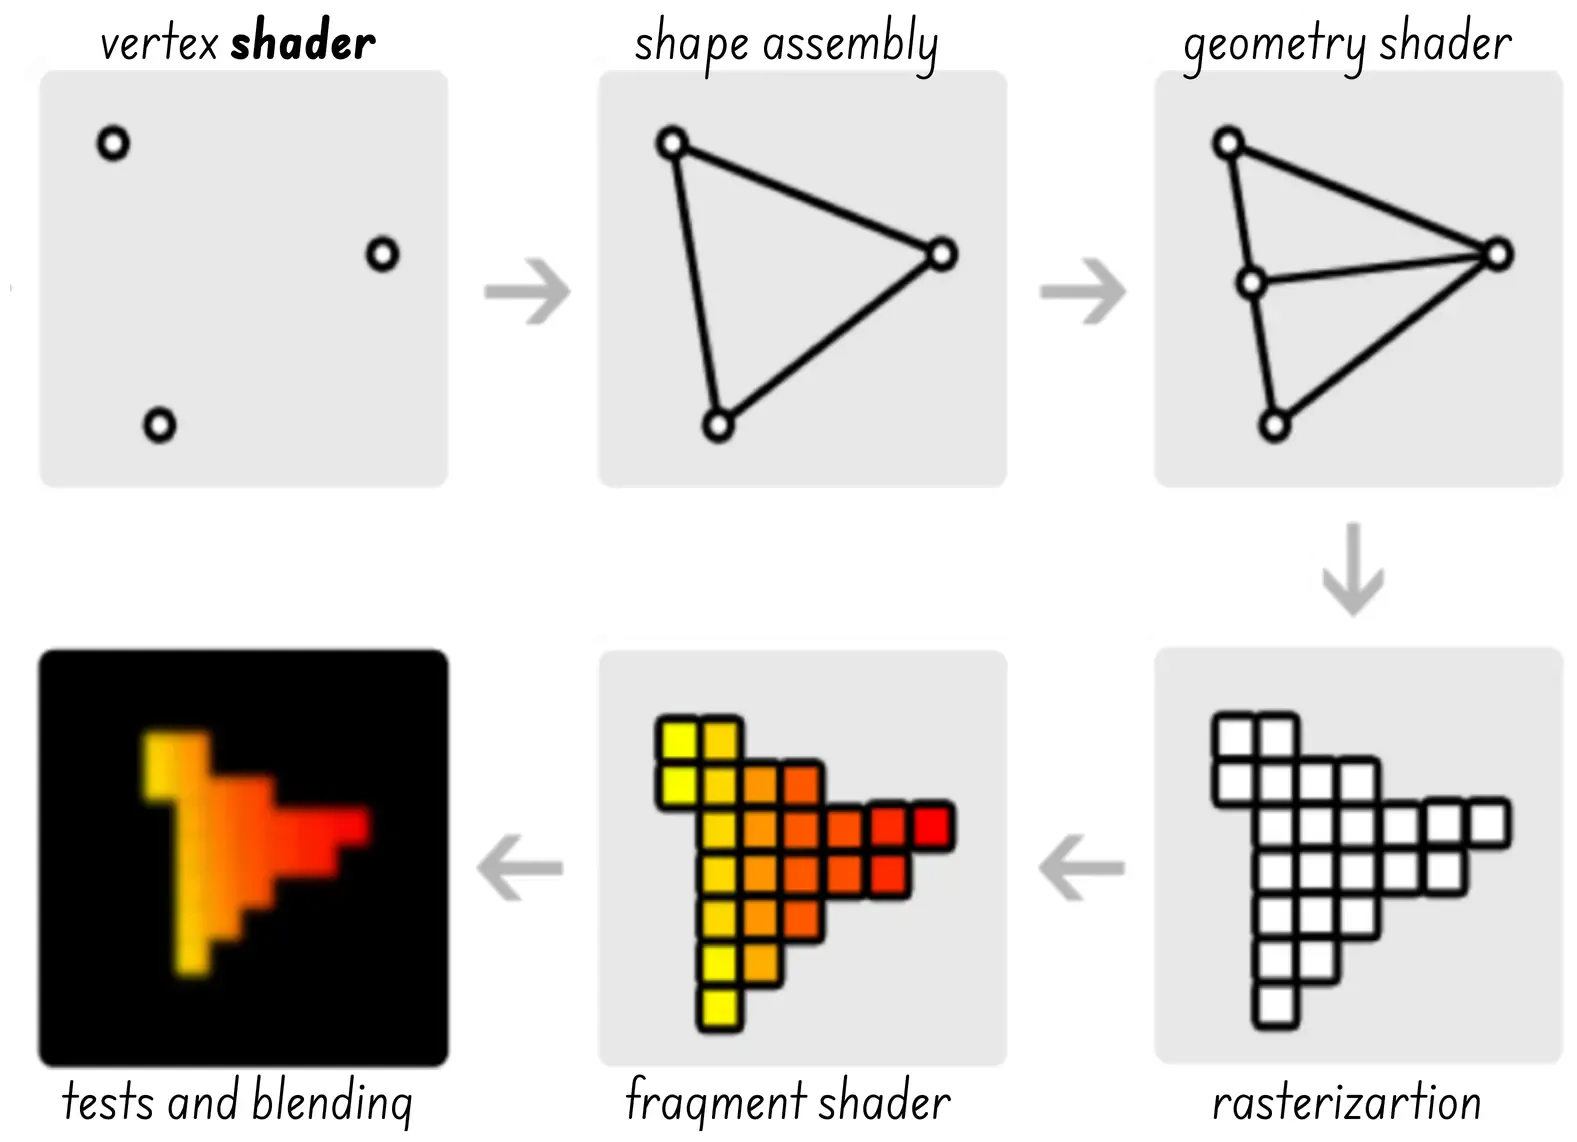
픽셀 처리 vs 행렬 처리
오늘날 AI 워크로드는 추론, 학습, 희소 모델, 추천 시스템 등 더욱 다양해졌지만, TPU는 픽셀 처리를 위해 설계된 것이 아닙니다. 하지만 GPU가 오늘날 널리 사용되는 이유는 엔비디아가 GPU를 TPU처럼 동작하게 하는 프로그래밍 모델과 개발자 환경을 제공했기 때문입니다.
그렇다면 GPU가 더 우수하다는 뜻일까요? 꼭 그렇지는 않습니다. 특정 작업 부하의 경우, TPU는 특히 전력 소비량과 와트당 성능 면에서 GPU보다 더 효율적일 수 있습니다. 그리고 AI 데이터 센터가 점점 더 많은 에너지를 소비하는 오늘날, TPU는 매우 중요한 역할을 할 수 있습니다.
아날로그 뉴로모픽 IC는 어떻습니까? Link to heading
그렇다면 뉴로모픽 IC는 어떨까요? TPU와 비교했을 때, 뉴로모픽 IC는 아날로그 컴퓨팅과 저주파 이벤트 기반 처리를 통해 더욱 낮은 전력 소비를 목표로 합니다. 뉴로모픽 IC가 주류로 자리 잡고 TPUv7 슈퍼팟과 같은 규모에 도달하려면 무엇이 필요할까요?
제가 여전히 해결해야 할 과제 중 하나는 수축기 어레이(MXU + 스페어 코어)와 나머지 TPU(ICI, OCI, TCS 포함)의 상대적인 전력 소비량을 더 잘 이해하고, 이 비율이 뉴로모픽 스파이킹 신경망(SNN)과 제어 로직(RiscV 및 Spike copro)의 전력 소비량과 어떻게 비교되는지 파악하는 것입니다.
또한, 뉴로모픽 IC가 TPUv7 수준에 도달하려면 소프트웨어, 시스템 및 네트워크 연결에 비슷한 수준의 투자가 필요할 가능성이 높습니다. 그렇지 않다면, SNN을 TPU에 연결하고 TPU의 “제어 로직"을 사용하여 SNN과 나머지 TPU/랙/패드 간의 통신을 처리하는 방식을 고려할 수 있습니다. 하지만 과연 이런 방식이 필요한 것일까요? 우리가 해결하려는 문제는 무엇일까요? 어쩌면 다른 관점에서 생각해 볼 필요가 있을지도 모릅니다.
미래로 돌아가기: 언어 처리 장치 Link to heading
이 메모는 대규모 언어 모델의 추론을 최적화하도록 설계된 새로운 유형의 프로세서인 언어 처리 장치를 언급하지 않고는 완전하지 않을 것입니다.
이 주제에 대해서는 별도의 메모를 작성해야 하므로, 지금은 LPU가 추론에만 집중하고 학습에는 신경 쓰지 않았던 TPUv1을 단순히 재창조한 것인지 여부를 파악하기 위한 개략적인 비교만 하겠습니다.
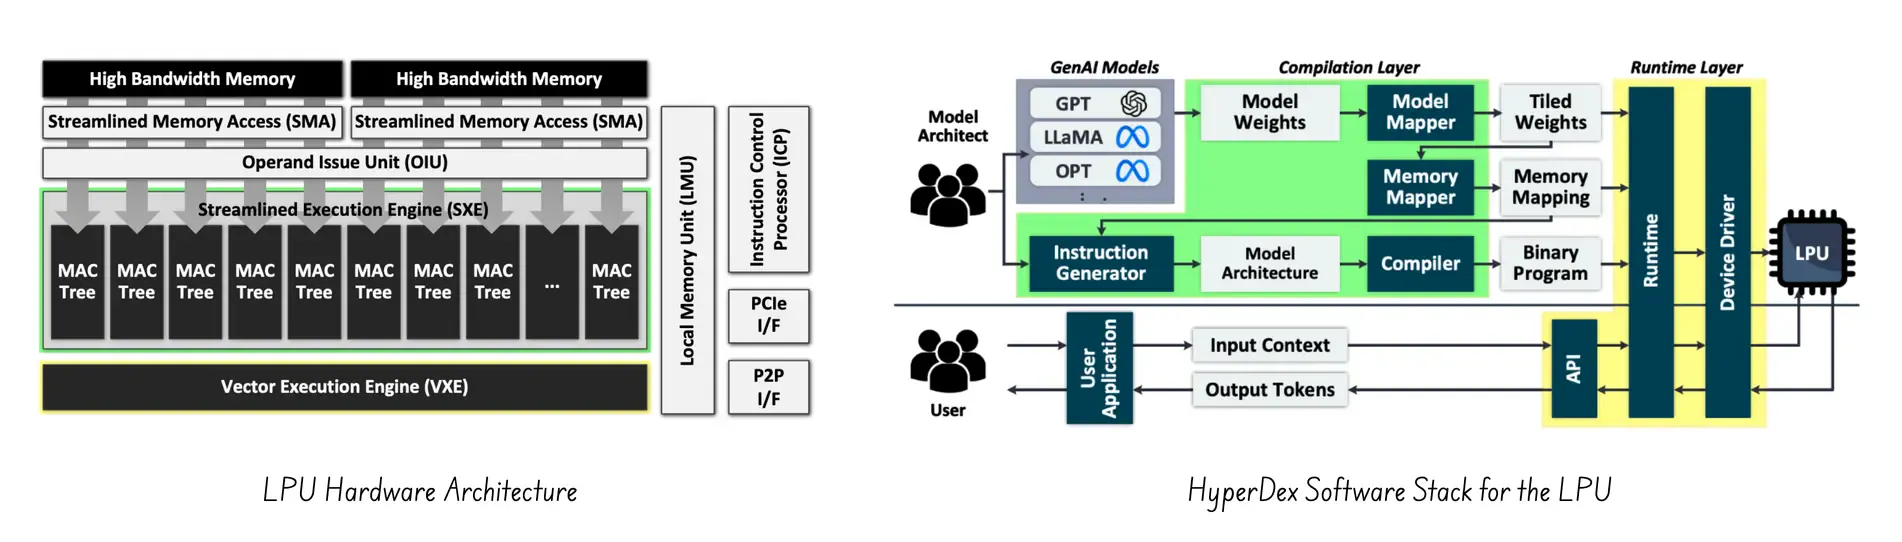
넓은 관점에서 보면 TPU와 LPU는 도메인 특화 아키텍처(DSA)를 사용하여 몇 가지 작업을 매우 효율적이고 대규모로 처리해야 한다는 공통점을 가지고 있습니다. 하지만 구체적인 구현 및 최적화 측면에서 보면 LPU는 완전히 다른 초점을 가진 별개의 프로세서입니다.
가장 큰 차이점은 TPUv1이 LLM이 존재하기도 전에 설계되었다는 점입니다(ChatGPT의 초기 출시가 2022년이었다는 점을 기억하세요). TPUv1은 일반적인 심층 신경망(DNN) 추론에 초점을 맞추었으며, 대규모 고용량 연산에 필요한 처리량과 와트당 성능을 보장하는 데 중점을 두었습니다. 이는 MXU 시스톨릭 어레이를 기반으로 구현되었습니다.
반면 LPU는 대규모 언어 모델(LLM)의 추론을 최적화하도록 설계되었습니다. LPU는 토큰당 지연 시간을 개선하는 데 중점을 두고 있으며, 이를 위해 완전 결정적이고 정적으로 스케줄링되는 VLIW 기반 멀티 파이프라인 아키텍처를 지원하는 ISA가 필요합니다. 물론 TPUv4도 TCS에 유사한 VLIW ISA를 도입했다고 주장할 수 있습니다. 하지만 주요 차이점은 LPU ISA는 모든 로드, 연산, 저장 작업이 사이클 단위로 스케줄링되는 완전 결정적 VLIW 머신인 반면, TPU의 MXU는 “자체 구동” 시스톨릭 어레이라는 점입니다.
결론 Link to heading
자, 이렇게 짧은 메모를 작성했는데, 이번에도 예상보다 시간이 오래 걸렸습니다. 이번 심층 분석을 통해 분명해진 것은 TPU 아키텍처의 발전 과정에서 AI 가속기 설계는 여러 요소를 균형 있게 고려해야 하는 복잡한 작업이라는 점입니다.
TPU의 설계는 메모리, 컴퓨팅 성능, 에너지 사용량 및 데이터 통신 간의 균형을 맞추도록 되어 있으며, 이는 고성능 AI 시스템을 대규모로 구축하는 데 있어 단순히 빠른 칩을 사용하는 것만으로는 부족하다는 것을 보여줍니다. 하드웨어, 소프트웨어, 시스템 및 네트워크 연결 간의 조화 또한 필수적입니다.
왠지 데자뷔 같은 느낌이 드네요. 양자 처리 장치(QPU)가 인공지능 가속기 진화의 다음 단계일까요?
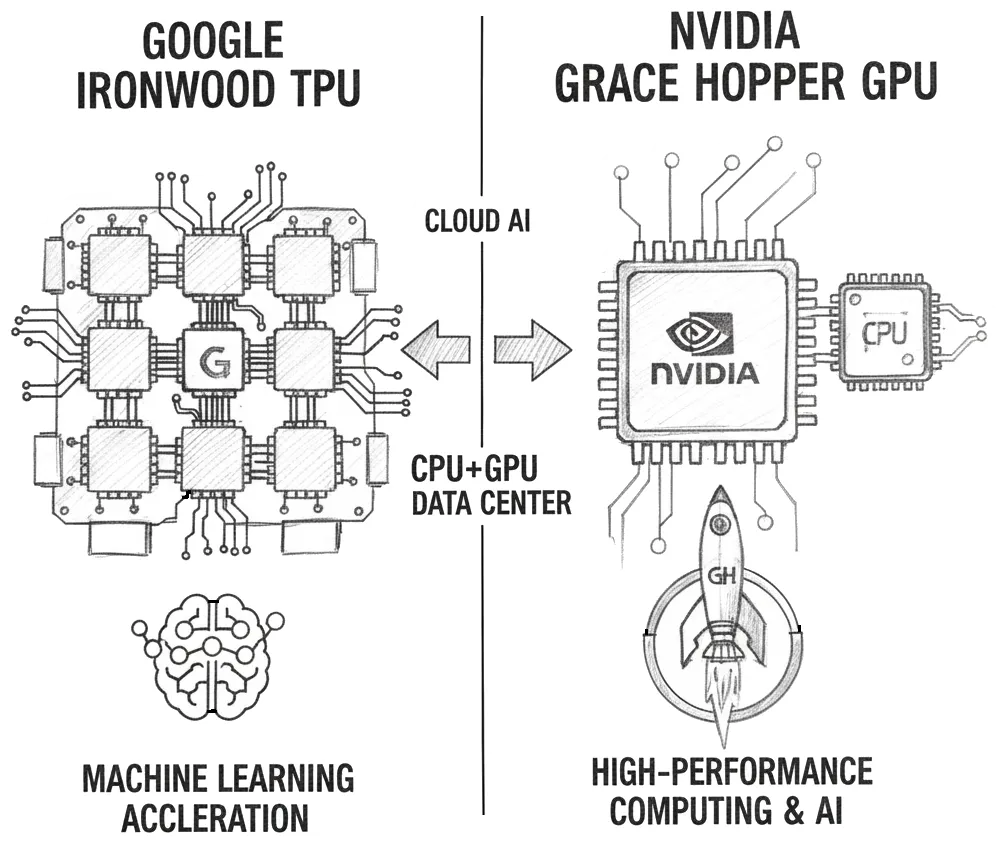
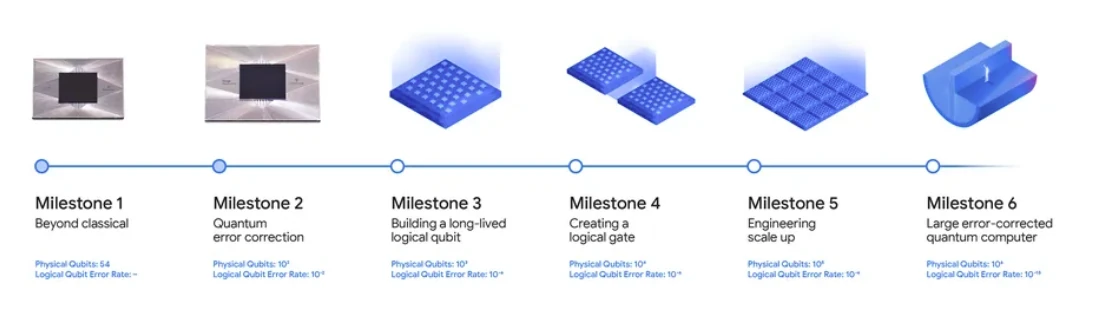 (이미지 출처: 구글 윌로우)
References Link to heading
- An in-depth look at Google’s first Tensor Processing Unit (TPU)
- Touching the Elephant - TPUs: Understanding the Tensor Processing Unit
- TPU Architecture: Complete Guide to Google’s 7 Generations
- Tensor Processing Unit
- Why Google’s TPU Could Beat NVIDIA’s GPU in the Long Run
- LPU: A Latency-Optimized and Highly Scalable Processor for Large Language Model Inference
- TPUv2: A DomainSpecific Supercomputer for Training Deep Neural Networks
- TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings
- A Machine Learning Supercomputer With An Optically Reconfigurable Interconnect and Embeddings Support
- Resiliency at Scale: Managing Google’s TPUv4 Machine Learning Supercomputer
- TPU deep dive
- Ten Lessons From Three Generations Shaped Google’s TPUv4i
- How to Think About TPUs
- Google’s AI Processor’s (TPU) Heart Throbbing Inspiration
- Tensor Processor Unit (TPU)
- Raytracing & GLSL
DrawIO diagrams used in this memo: