
GPU와 관련된 RDMA 용어는 GPU-direct, NvLink, NVLink Fusion, InfiniBand, Quantum InfiniBand, GPUNetIO, DOCA 등 매우 다양합니다. 이러한 용어들 때문에 혼란스러울 수 있지만, 꼭 그럴 필요는 없을지도 모릅니다.
이 글은 개인적인 메모 형식으로 작성되었으며, 다양한 기술들을 설명하고 몇 가지 도표를 통해 시각화하려는 시도입니다.
GPU Direct와 RDMA: 마케팅 vs. 기술. Link to heading
자, 그럼 엔비디아 공식 문서의 다소 혼란스러운 GPUNetIO 페이지부터 시작해 보겠습니다.
참고로, RDMA라는 약어는 두 컴퓨터 중 어느 한 컴퓨터의 운영 체제를 거치지 않고 한 컴퓨터의 메모리에서 다른 컴퓨터의 메모리로 원격 직접 메모리 접근을 가능하게 하는 프로토콜을 설명합니다. … 이는 RDMA 프로토콜과 관련이 없는 GPUDirect RDMA와 혼동해서는 안 됩니다.
알겠습니다. GPUDirect RDMA는 RDMA 프로토콜과 동일하지 않다는 말씀이시군요! 하지만 GPUDirect RDMA가 적어도 RDMA 프로토콜을 사용하는 건가요? 그랬으면 좋겠네요. 그렇지 않으면 정말 혼란스러울 것 같습니다.
GPUDirect RDMA는 NVIDIA의 GPUDirect 기술 제품군에 포함된 기술 중 하나입니다. 이 기술을 통해 네트워크 카드는 CPU 메모리 복사 및 운영 체제 루틴을 거치지 않고 GPU 메모리에 직접 접근하여 데이터를 송수신할 수 있습니다. GPUDirect RDMA는 이더넷, InfiniBand 또는 RoCE를 지원하는 모든 네트워크 프레임워크에서 활성화할 수 있습니다.
좋습니다, 적어도 GPUDirect RDMA는 이더넷(ETH)이든 인피니밴드(IB)든 어떤 전송 계층에서든 구현될 수 있다는 점은 분명합니다. 그런데 GPUNetIO는 무엇이며 RDMA와 어떤 관련이 있을까요? 답은 간단합니다. GPUNetIO는 이름에서 알 수 있듯이 네트워크 카드를 통해 GPU Direct RDMA를 구현한 네트워크 기반 기술입니다. 그렇다고 GPU Direct를 반드시 네트워크 카드에서 구동해야 한다는 의미는 아니며, 단지 GPUNetIO가 특정 네트워크 카드 유형에 특화된 버전이라는 뜻입니다.
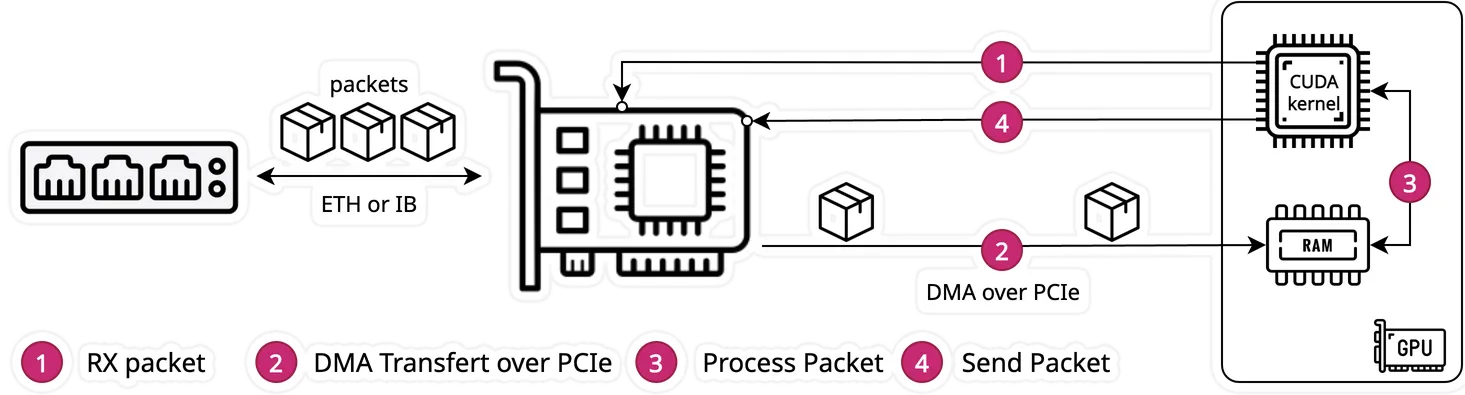
위 그림은 GPUNetIO 문서에 있는 다이어그램인데, “CUDA” 상자가 좀 헷갈립니다. GPU에서 실행되는 커널이라고 추측되는데, 문서에 뭐라고 나와 있는지 확인해 보겠습니다.
기존 방식은 대개 CPU 중심 모델에 의존하는데, 이 모델에서는 CPU가 NIC와 협력하여 GPUDirect RDMA를 통해 GPU 메모리에서 패킷을 수신합니다. 그 후 CPU는 GPU의 CUDA 커널에 패킷 처리를 알립니다. DOCA GPUNetIO는 CPU를 핵심 경로에서 제외하는 GPU 중심 솔루션을 제공함으로써 이러한 문제를 해결합니다.
제 생각에는 아직 완전히 명확하지 않습니다. 핵심 경로에 대해 ‘GPU 중심’이라고 명시되어 있는데, 핵심 경로란 무엇일까요? 다이어그램에 언급된 단계 (1)부터 (4)까지를 의미하는 것일까요? 그리고 CPU는 여전히 왜 필요한 걸까요? 답을 찾으려면 “비동기 커널 시작” 모드를 살펴봐야 합니다. 이 모드는 “GPU CUDA 커널이 네트워크 통신을 제어하여 데이터를 송수신할 수 있는 가능성“으로 설명됩니다. GPUDirect IKA는 다음을 활성화합니다.
GPU는 이더넷 통신(이더넷/IP/UDP/TCP/ICMP)을 제어할 수 있습니다.
GPU는 RDMA 통신을 제어할 수 있습니다 (InfiniBand 또는 RoCE 지원).
애플리케이션의 중요 경로에서는 CPU 개입이 불필요합니다.
그러니까, 이건 100% 확실해요:
GPU Direct RDMA는 CPU 복사 과정 없이 GPU 메모리로/에서 직접 데이터를 전송할 수 있도록 합니다.
GPU Direct AKI는 GPU가 네트워크 카드를 “제어"할 수 있도록 해줍니다.
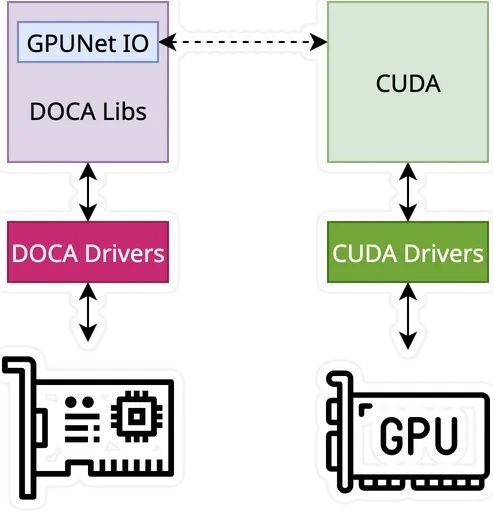
GPUNetIO는 GPU Direct RDMA 및 AKI 기술을 모두 처리하는 소프트웨어 구성 요소입니다.
DOCA는 NVIDIA에서 GPUNetIO를 지원하는 하드웨어(및 기타 하드웨어)를 프로그래밍하기 위해 제공하는 SDK입니다.
혼란은 “AKI"를 “GPU Direct RDMA + AKI"로 표기해야 한다는 사실에서 비롯된 것 같습니다. AKI는 CPU를 우회할 수 있도록 하는 RDMA 기능을 보완하는 역할을 하기 때문입니다.
RDMA GPU 상호 연결 Link to heading
이제 우리는 엔비디아가 GPUNetIO라는 이름으로 판매하는 GPU Direct RDMA가 PCIe 연결을 통해 GPU와 네트워크 카드(NIC)를 연결하는 NIC 기반 솔루션임을 이해했습니다. 이제 이 PCIe 연결에 대해 자세히 살펴보고, GPUNetIO 부분을 추상화하여 RDMA 부분에 다시 집중해 보겠습니다.
CUDA GPUDirect RDMA 공식 문서(https://docs.nvidia.com/cuda/gpudirect-rdma/index.html)에는 유일한 요구 사항은 PCIe 루트 컴플렉스라고 명시되어 있습니다.
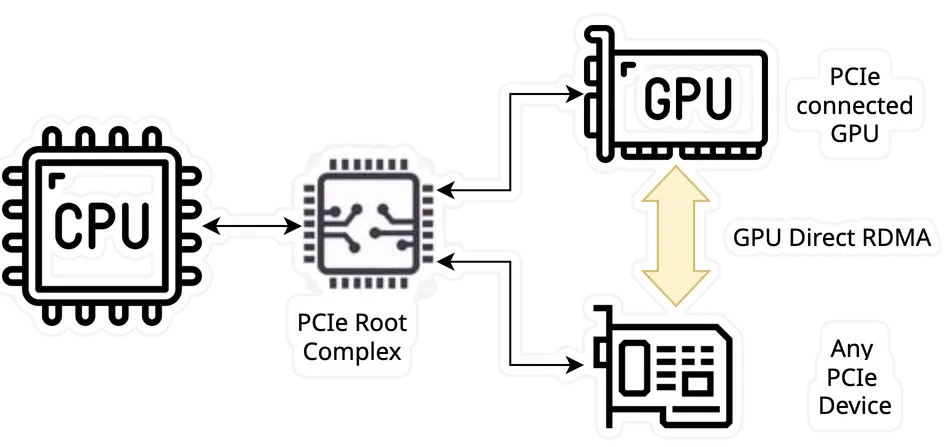
GPUDirect RDMA는 Kepler급 GPU와 CUDA 5.0에 도입된 기술로, PCI Express의 표준 기능을 사용하여 GPU와 타사 피어 장치 간의 직접적인 데이터 교환 경로를 제공합니다. … 몇 가지 제약 사항이 적용될 수 있으며, 가장 중요한 것은 두 장치가 동일한 업스트림 PCI Express 루트 컴플렉스를 공유해야 한다는 것입니다.
GPUDirect RDMA는 동일한 루트 컴플렉스 아래에 있는 모든 PCIe 장치가 GPU와 직접 통신할 수 있도록 하는 솔루션입니다. 따라서 엔비디아는 주로 네트워크 카드와 같은 PCIe 장치를 위한 솔루션으로 홍보하지만, 고속 카메라 PCIe 카드와 같은 모든 PCIe 카드에도 적용할 수 있습니다. 흥미로운 기능이지만, 실제로 어떻게 작동하는지 자세히 살펴보겠습니다.
GPUDirect RDMA 통신을 설정할 때, PCI Express 장치의 관점에서 모든 물리적 주소는 동일합니다. 이 물리적 주소 공간 내에는 PCI BAR라고 하는 선형 윈도우가 있습니다. 각 장치는 최대 6개의 BAR 레지스터를 가지므로 최대 6개의 활성 32비트 BAR 영역을 가질 수 있습니다. 64비트 BAR는 2개의 BAR 레지스터를 사용합니다. PCI Express 장치는 시스템 메모리에 대한 읽기 및 쓰기 작업과 동일한 방식으로 피어 장치의 BAR 주소에 대한 읽기 및 쓰기 작업을 수행합니다.
기존에는 BAR 창과 같은 리소스가 CPU의 MMU를 사용하여 메모리 매핑 I/O(MMIO) 주소로 사용자 또는 커널 주소 공간에 매핑되었습니다. 그러나 현재 운영 체제에는 드라이버 간 MMIO 영역을 교환하는 데 필요한 메커니즘이 충분하지 않기 때문에 NVIDIA 커널 드라이버는 필요한 주소 변환 및 매핑을 수행하는 함수를 제공합니다.
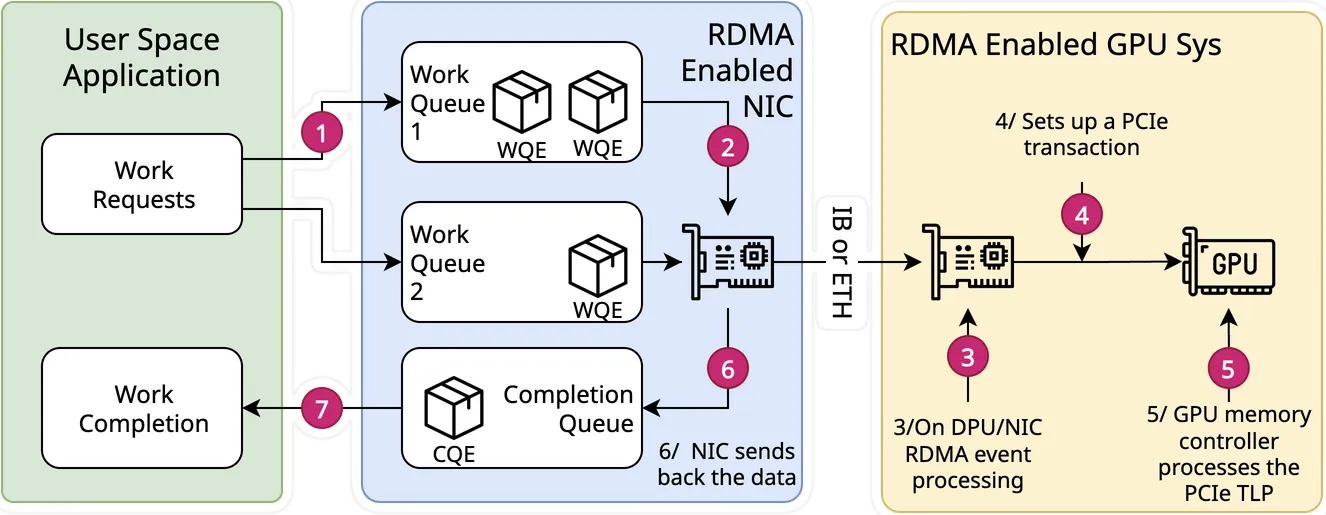
여기서 혼란스러울 수 있는 점은 이기종 장치를 연결하는 PCIe 내부 시스템을 고려할 때 “RDMA"보다 “DMA"라는 단어가 더 적합해 보일 수 있다는 것입니다. 하지만 바로 그 점이 중요합니다. DMA는 데이터를 전송하는 솔루션이고, 그 위에 있는 RDMA는 동사를 사용하여 전송되는 데이터에 의미론을 부여하는 데 사용되는 프로토콜입니다. 따라서 DMA는 아래 다이어그램에서 실제로 (4) 및 (5) 단계에 불과하고, 수신 측 하드웨어의 RDMA 프로토콜은 (3) 단계에 불과합니다.
한 가지 주목할 점은 엔비디아가 이것이 간단한 작업이 아니라는 점을 분명히 밝히고 있다는 것입니다. 따라서 최상의 성능을 얻으려면 검증된 테스트 환경을 사용하는 것이 더 나을 것입니다.
타사 장치와 NVIDIA GPU 간에 GPUDirect RDMA가 작동하기 위한 이론적인 유일한 요구 사항은 동일한 루트 컴플렉스를 공유하는 것이지만, (주로 칩셋에서 발생하는) 버그로 인해 특정 구성에서 성능이 저하되거나 전혀 작동하지 않는 경우가 있습니다.
전송 계층 Link to heading
이더넷, 인피니밴드, RoCE 간의 용어 사용에 여전히 명백한 혼란이 있습니다. 특히 RoCE가 이더넷을 기반으로 한다는 사실 때문에 더욱 그렇습니다.
인피니밴드 협회(InfiniBand Ta.org/roce-and-infiniband-which-should-i-choose/)는 이를 위의 다이어그램과 같이 간단하게 진화된 기술이라고 설명합니다. 저는 의도적으로 원래의 “DCB”(데이터 센터 브리징)라는 용어 대신 “100G + PFC"라는 용어를 사용했습니다. 제가 제대로 이해했다면, DCB는 PFC(우선순위 흐름 제어)의 상위 개념이며, DCB/PFC가 제대로 작동하려면 해당 기술을 구현할 수 있는 스위치를 포함한 네트워크 인프라가 필요하다는 의미입니다. 그렇지 않으면 이더넷을 사용해야 합니다.
NVLink는 어떤가요? Link to heading
이 메모는 NVLink에 대한 언급 없이는 완전하지 않을 것입니다. 당장 제기되는 질문은 NVLink와 InfiniBand가 동일한 것인지, 아니면 어떤 식으로든 관련이 있는지입니다. 간단히 말해서, 둘은 경쟁 관계가 아니라 상호 보완적인 관계입니다.

NVLink: 빠른 노드 간 통신(서버 내, GPU 간).
InfiniBand: 클러스터 내 서버 간 고속 통신
오른쪽 다이어그램에서 녹색 화살표는 GPU들을 서로 연결하는 데 사용되는 것을 알 수 있습니다. NIC 간의 연결은 InfiniBand를 사용합니다.
흥미로운 점은 아래 다이어그램에서 볼 수 있듯이 NVLink는 InfiniBand 커넥터와 달리 외부로 노출되지 않고 NVIDIA 하드웨어 내부에 있다는 것입니다. Quantum InfiniBand X800은 800Gb/s 링크와 실리콘 포토닉스(Silicon Photonics)가 함께 패키징된 강력한 제품이지만 양자 컴퓨팅과는 아무런 관련이 없습니다.
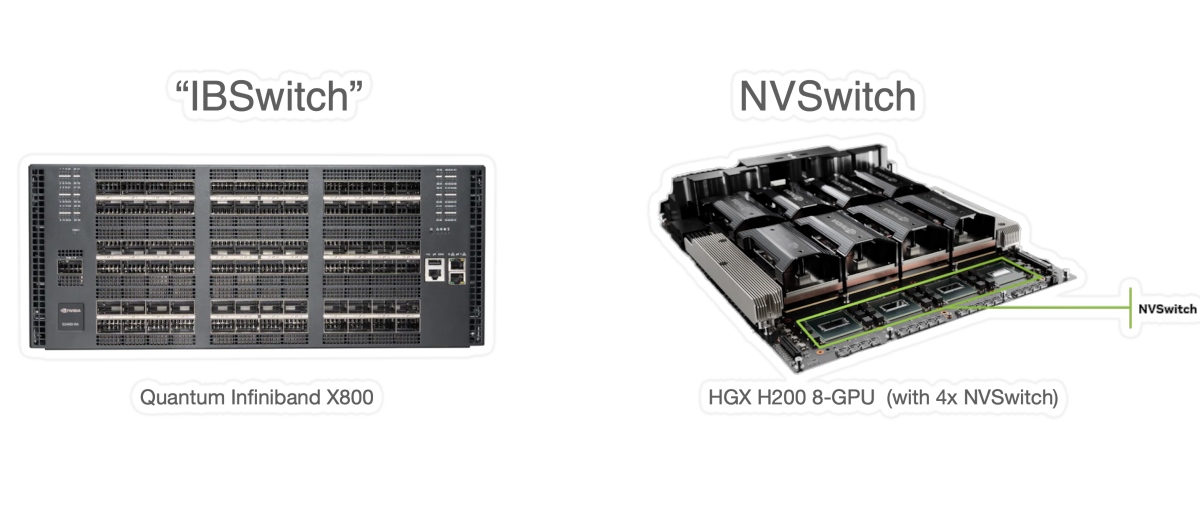
마지막으로 언급할 만한 점은 엔비디아가 NVLink 표준을 개방하기 위해 NVLink Fusion을 도입했다는 것입니다. 따라서 앞으로는 맞춤형 통합이 가능해질 것으로 예상되며, 여전히 케이블 대신 PCB를 “스위치"로 사용할 수도 있지만, 엔비디아 SoC가 아닌 다른 SoC를 사용할 수도 있습니다. 또한 AMD가 엔비디아의 표준에 대응하여 UALink를 도입했다는 점도 주목할 만합니다.
요약 Link to heading
요약하자면, RDMA는 그다지 복잡하지 않습니다.
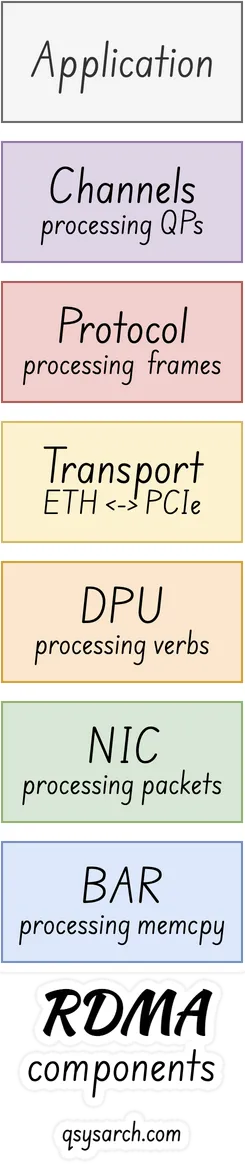
RDMA BAR: PCIe BAR 매핑: 물리적 계층에서 동일한 PCIe 루트 컴플렉스를 통해 GPU에 연결되는 PCIe 장치가 있으며, 모든 장치의 메모리 BAR를 매핑합니다.
RDMA NIC: 하드웨어 네트워크 카드(NIC)로서: 이 PCIe 카드는 일반적으로 네트워크 카드이지만, 반드시 네트워크 카드일 필요는 없습니다. 그러나 현재 시중에는 RDMA 기능을 갖춘 네트워크 카드가 단 하나뿐인 것으로 보입니다.
RMDA DPU: 하드웨어 내장형 동사 처리기: PCIe 카드를 RDMA 규격에 맞추려면 하드웨어가 RDMA 동사를 하드웨어에서 직접 처리할 수 있어야 하며, 일반적으로 DPU라고 하는 프로세서를 사용합니다.
RDMA 전송: 네트워크 loink의 전송 계층: PCIe 장치는 네트워크 측면에서 이더넷, 더 나은 이더넷(RoCev2) 및 Infiniband를 지원하는 전송 계층으로 노출됩니다.
RDMA 프로토콜: 프레임 형식: 네트워크 링크를 통해 통신하는 데 사용되는 프로토콜은 RDMA라고도 합니다. 프레임 형식에 대한 자세한 내용은 살펴보지 않았지만, RFC5040에 나와 있습니다.
RDMA 채널: QP를 통한 통신 방식: 호스트에서 RDMA 장치와 통신하는 데 사용되는 소프트웨어/드라이버/SDK도 RDMA라고 불리지만, 큐 패리어스(Queue Paris) 및 채널(Channels)로 정의됩니다.
자, 이제 RDMA를 조금 더 이해한 것 같네요.
결론 Link to heading
다시 양자 컴퓨팅 문제로 돌아가서, 우리가 왜 RDMA에 관심을 가져야 할까요? 바로 엔비디아가 자사의 인피니밴드 스위치를 “퀀텀 인피니밴드"라고 불렀기 때문입니다!
하지만, 최신 인피니밴드 퀀텀-X800이 엄청난 성능을 자랑함에도 불구하고, 양자 컴퓨팅과는 아무런 관련이 없습니다. 하지만 강화 학습 과제에서 양자 제어와 GPU를 연결하는 데 핵심적인 역할을 할 수 있을지도 모릅니다.