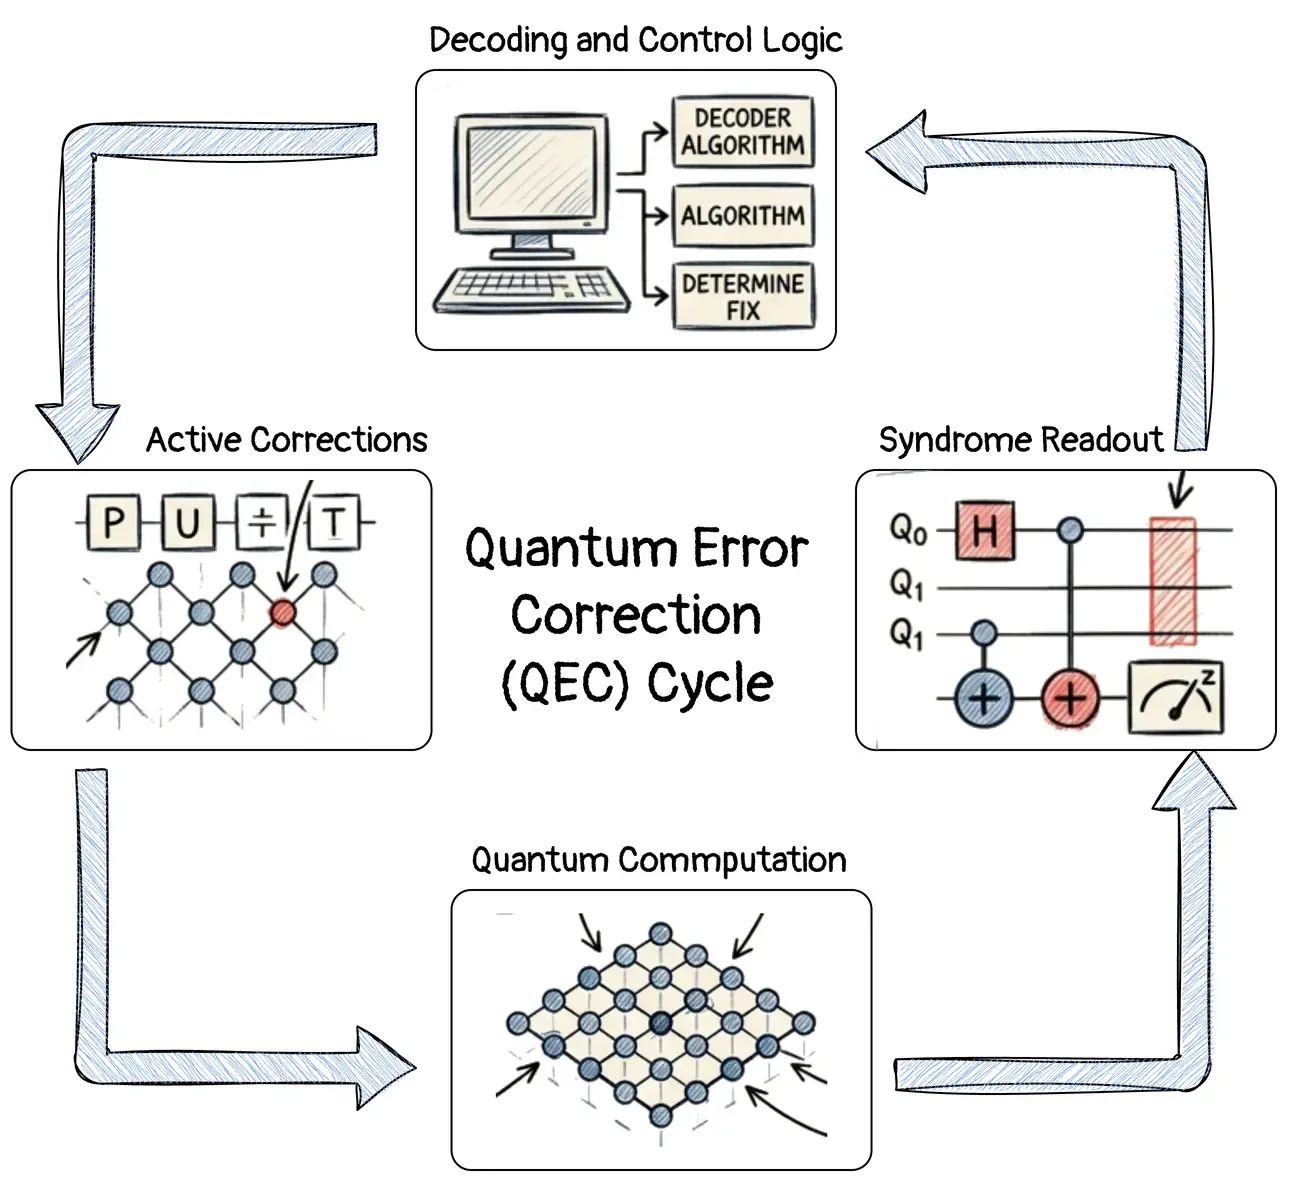
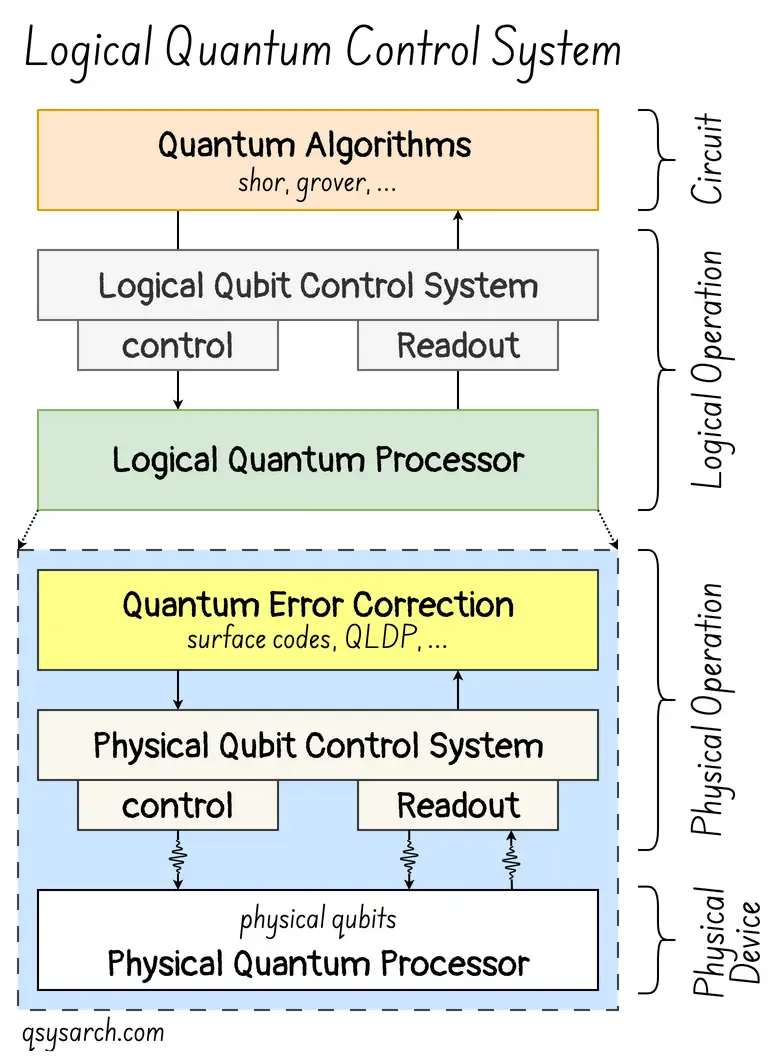
언뜻 보면 양자 오류 수정은 간단해 보입니다. 물리적 큐비트를 논리 큐비트로 그룹화하고, 큐비트 간의 일관성을 유지하는 방법을 적용한 다음, 이러한 논리 큐비트를 사용하여 양자 회로를 작동시키면 됩니다.
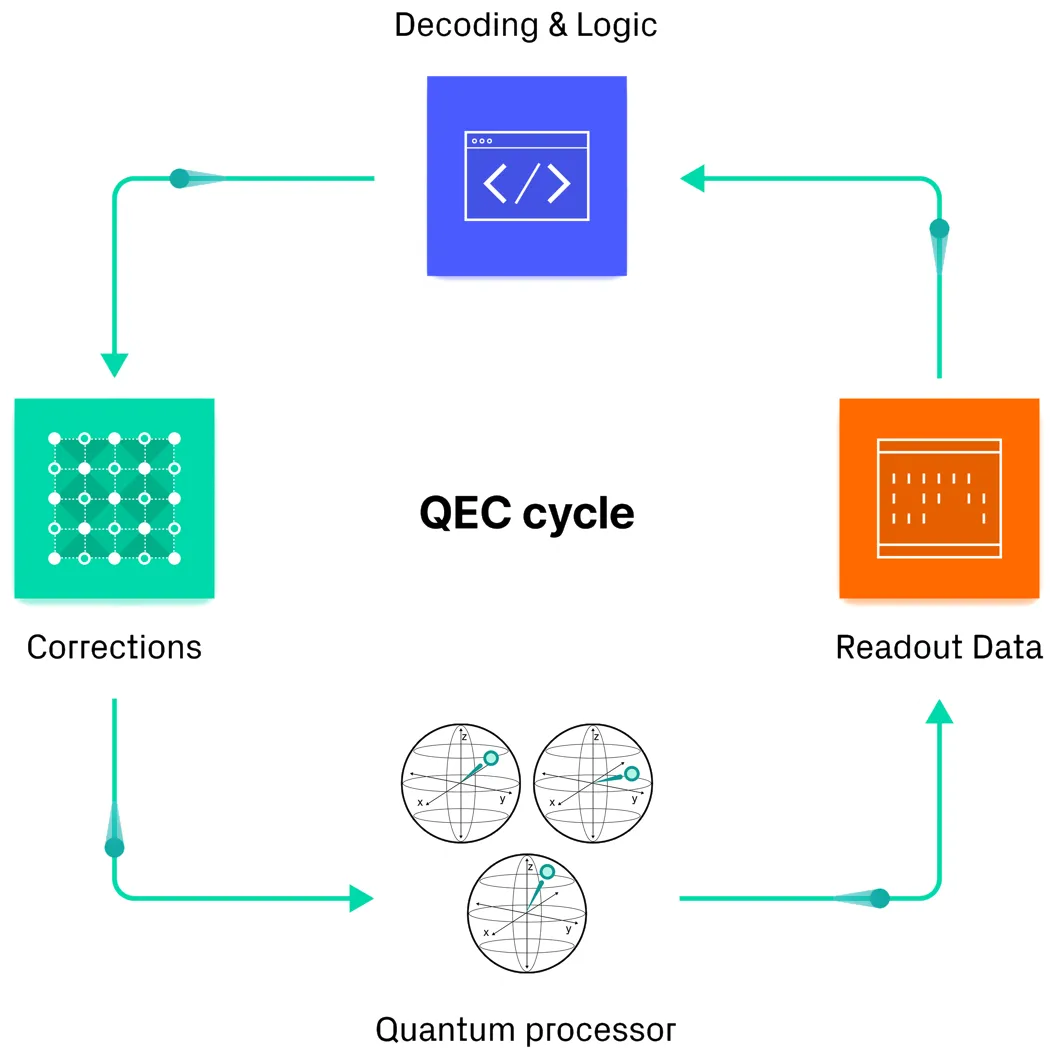 이미지 출처: 리버레인
하지만 실제로 이 첫 번째 단계는 결코 명확하지 않습니다. 논리 큐비트를 어떻게 생성하고 유지할까요? 예를 들어, 양자 제어 시스템(QCS)(QM OPX1000, ZI의 ZQCS 또는 Qblox Q1 Cluster 등)의 관점에서 논리 큐비트를 “작동"시키거나 “조작"하는 데 필요한 것은 무엇일까요? 그리고 이 논리 큐비트가 작동 준비가 되면, 1큐비트 및 2큐비트 게이트로 구성된 양자 회로를 통해 양자 연산을 수행하는 데 필요한 것은 무엇일까요? 이 간단한 질문은 하드웨어 제어 시스템뿐만 아니라 소프트웨어 스택, 특히 컴파일러에 관한 것입니다. 물리적 큐비트용 컴파일러와 논리적 큐비트용 컴파일러, 이렇게 두 개의 컴파일러가 필요한 것일까요? 그리고 규모 확장에 있어서, 하이브리드 GPU/QPU 및 QCS로 구성된 이기종 환경에서 10,000개의 물리적 큐비트를 처리할 때 컴파일러가 확장 복잡성에 대처하려면 무엇이 필요할까요? 간단해 보이는 질문이지만, 답은 결코 간단하지 않습니다!
이 메모는 양자 제어 시스템의 관점에서 양자 오류 수정에 관한 일련의 문서 중 첫 번째입니다. 이 짧은 첫 번째 메모에서는 물리 계층에서 일관된 논리 큐비트를 “생성"하는 데 필요한 기본 개념을 소개합니다.
논리 큐비트 생성 Link to heading
“논리 큐비트"란 무엇일까요? 논리 큐비트를 생성하려면 먼저 물리적 큐비트들을 그룹화하고 각각에 특정 역할을 할당해야 합니다. 일부는 보조 큐비트 역할을 하고, 다른 일부는 데이터 큐비트 또는 주 큐비트 역할을 합니다.
이러한 분류는 종종 오른쪽 다이어그램으로 표현되며, 이 다이어그램은 “거리 3을 기준으로 한 표면 코드 17"을 보여줍니다(이미지 출처: Irréversible Inc).
다음은 표면 코드에 적용 가능한 기본 구조입니다.
데이터 큐비트(흰색 원)는 양자 정보를 저장합니다. 표면 17에는 9개의 데이터 큐비트가 있습니다.
보조 큐비트(검은색 원)는 비파괴 패리티 검사를 수행합니다. 표면 17에는 8개의 보조 큐비트가 있습니다.
QEC 프로토콜 Link to heading
데이터 큐비트와 보조 큐비트 간의 상호 작용은 각 “플라켓"마다 다릅니다.
플라켓(녹색 및 분홍색 면)은 가운데 있는 보조 큐비트와 인접한 데이터 큐비트 간의 오류 검사 유형학적 관계를 정의합니다.
안정화기: 각 보조 큐비트는 하나의 파울리 연산자 또는 안정화기를 측정하는 데 사용됩니다. 표면 코드는 두 가지 안정화기를 가지고 있습니다. Z형 안정화기는 비트 반전(X) 오류를 감지하고, X형 안정화기는 위상 반전(Z) 오류를 감지합니다.
안정화기 측정은 단일 안정화기를 측정하는 것으로, 보조 큐비트를 인접한 데이터 큐비트에 순차적으로 연결한 다음 보조 큐비트를 측정함으로써 구현됩니다.
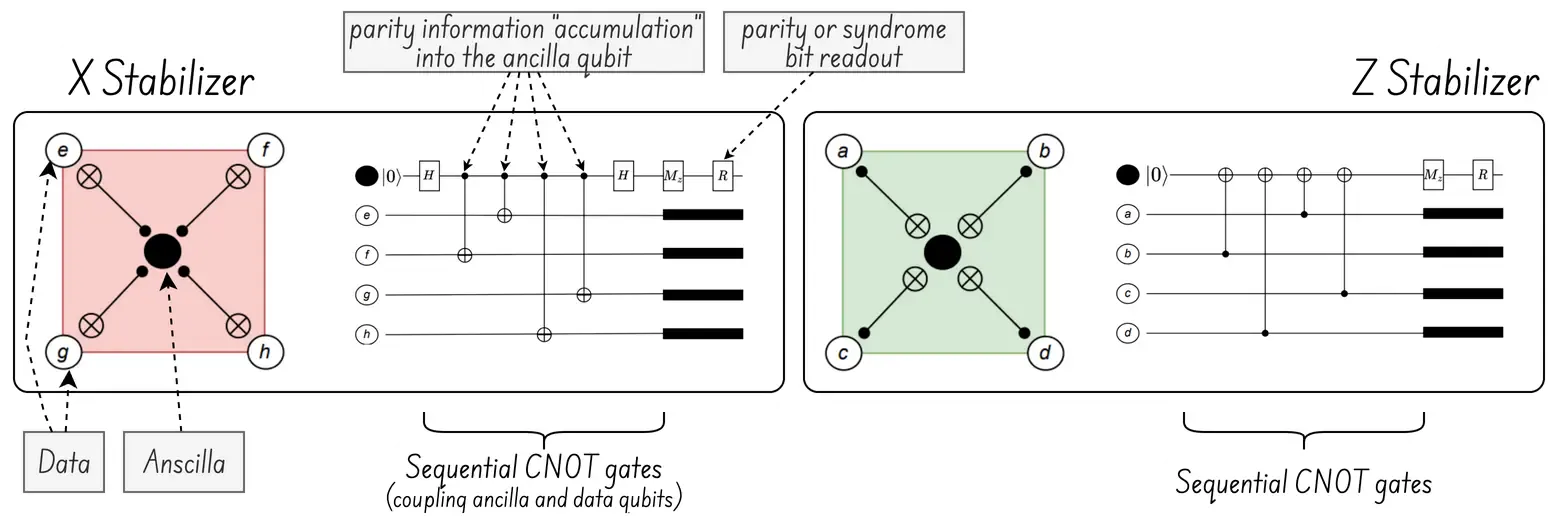
신드롬 비트는 패리티 검사 안정기 연산자 측정 결과에 생성됩니다. 신드롬 비트는 측정 주기마다 하나씩 생성됩니다.
증후군 추출은 오류 수정 주기에서 모든 안정기 측정을 수행하여 전체 오류 증후군을 얻는 완전한 프로세스입니다.
간단한 퀴즈: 큐비트의 범인은 누구일까요? Link to heading
이러한 맥락에서 아래 다이어그램을 살펴보십시오(출처: Alice & Bob의 Laurent Prost). Z₁Z₂ 와 Z₂Z₃ 는 각각 큐비트 1과 큐비트 2 사이, 그리고 큐비트 2와 큐비트 3 사이의 공동 패리티 검사(안정화) 측정을 나타냅니다. 이전의 2차원 플라켓과 달리, 이 다이어그램은 각 물리적 큐비트가 다른 하나의 큐비트에만 연결되어 있다고 가정하며, 이는 1차원 반복 코드를 나타냅니다.
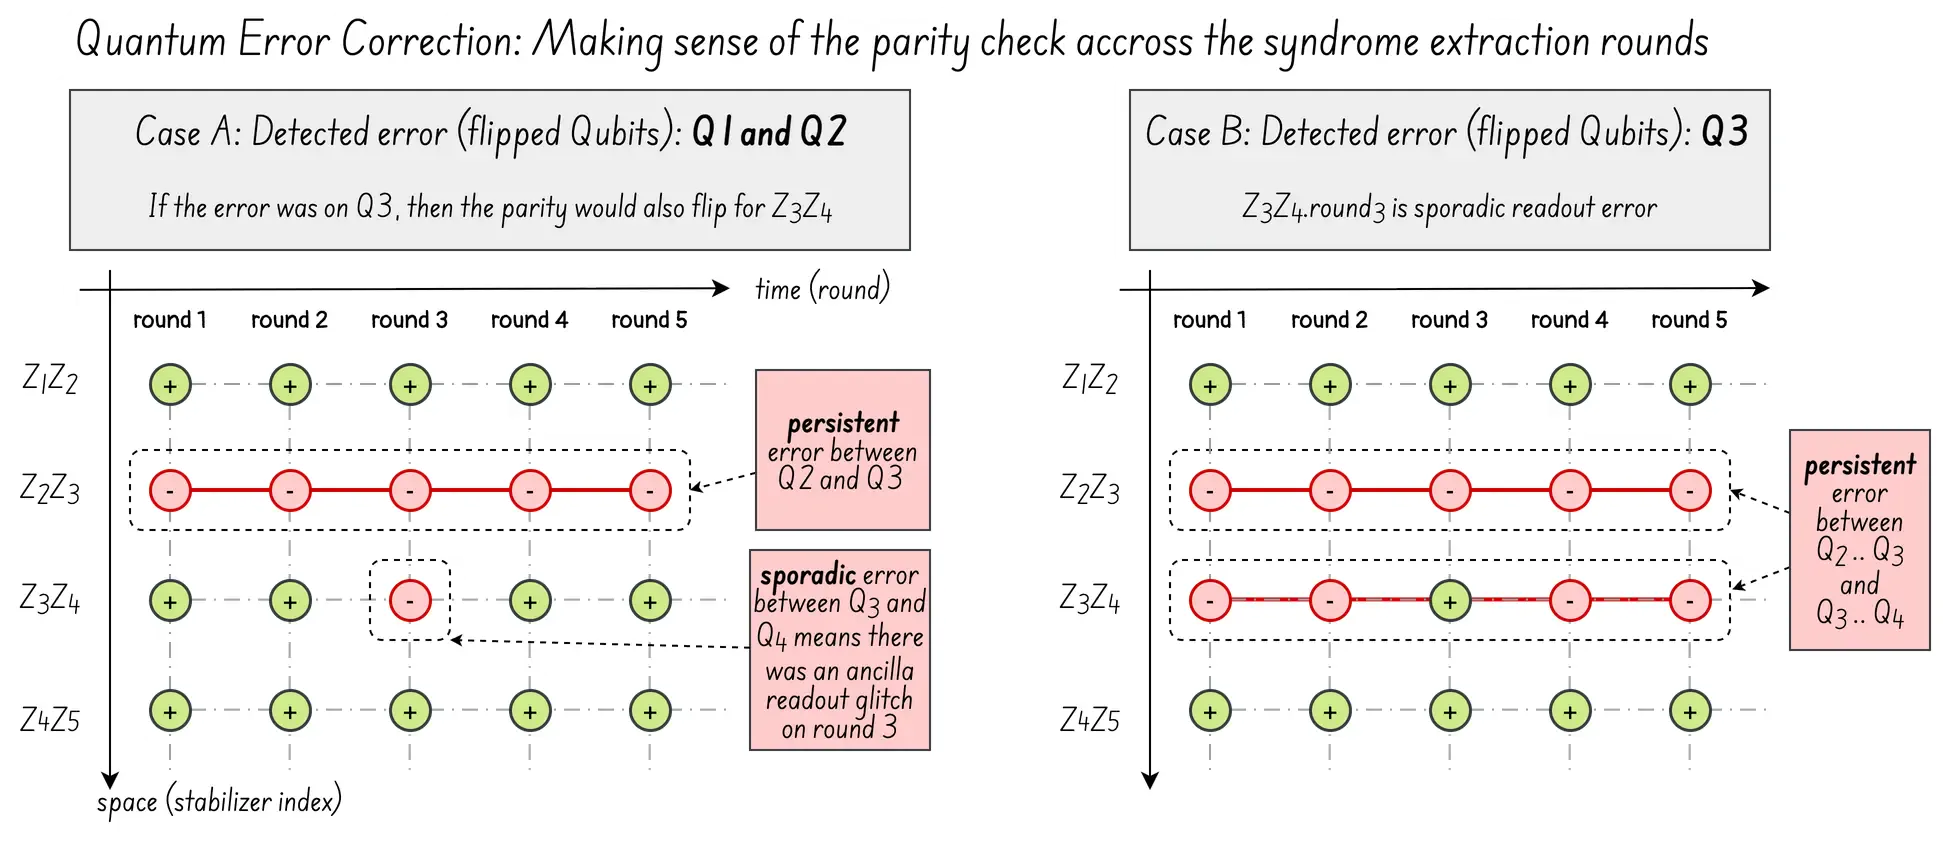
왼쪽 그림(사례 A)에서는 데이터 큐비트 3에 오류가 있는 것처럼 보이지만, 실제로는 데이터 큐비트 1과 2에 오류가 있음을 나타냅니다 . 빨간색 가로선은 오류가 Z₂Z₃ 에서만 발생함을 보여줍니다. 만약 오류가 큐비트 3 에 있었다면 Z₃Z₄ 도 뒤집혔을 것입니다. 따라서 Z₁Z₂ 는 비잔틴 오류(Byzantine error)를 나타내며, 이는 Q1과 Q2 모두 뒤집혔음을 의미합니다. 오른쪽 그림(사례 B)은 오류가 큐비트 3에 있을 경우 예상되는 결과를 보여줍니다.
비하인드 스토리: QEC의 “마법” Link to heading
이 두 번째 부분은 조금 더 어렵지만, 논리 그룹 내에서 물리적 큐비트의 오케스트레이션에 관한 후속 메모를 이해하는 데 중요합니다. 최대한 쉽게 설명하려고 노력했으며, 양자 컴퓨팅(QEC) 분야의 동료들이 훨씬 더 잘 설명할 수 있는 복잡한 수학적 세부 사항은 언급하지 않겠습니다!
도메인 경계와 퇴화 오류 Link to heading
Q1 + Q2 비잔틴 오류는 실제로 퇴화 오류라고 불리는 흔한 문제점입니다. 구체적으로 말하자면, 물리적으로 서로 다른 두 개 이상의 오류가 정확히 동일한 신드롬 비트를 생성하는 상황을 말하며, 이 경우 오류를 구분하는 것이 불가능해집니다.
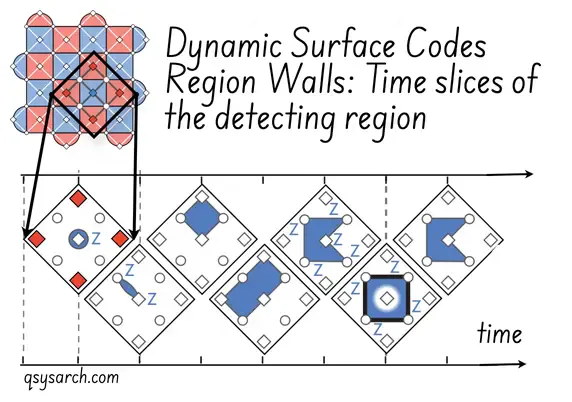 하지만 이는 QEC에서는 문제가 되지 않습니다. 안정화 장치는 오류를 직접 감지하는 데 사용되지 않습니다. 대신 안정화 장치는 오류 증후군이 반응하는 물리적 큐비트 경계(일명 영역 경계)를 식별하는 데 사용됩니다. 그런 다음 중복성을 높여 경계를 겹치게 함으로써 개별 오류를 정확히 찾아낼 수 있습니다(또는 오른쪽 그림에 표시된 것처럼 GoogleAI의 시간 동적 표면 코드를 사용할 수도 있습니다).
양자 시스템에서 이러한 중복성을 구현하는 것은 근본적으로 복잡하며 탄탄한 수학적 배경 지식을 요구합니다. 고차원적인 개념을 이해하기 위해서는 기본으로 돌아가야 합니다. 패리티 검사는 실제로 어떻게 작동하는 것일까요?
패리티 검사는 실제로 어떻게 작동하나요? Link to heading
처음에는 패리티 검사가 어떻게 작동하는지 불분명해 보일 수 있습니다. 패리티를 판별하려면 예상되는 신드롬 비트에 대한 정보가 필요한데, 이 신드롬 비트는 데이터 큐비트의 상태에 따라 달라지기 때문입니다. 하지만 데이터 큐비트의 상태를 미리 아는 것은 양자 컴퓨팅의 목적에 어긋납니다. 다시 말해,
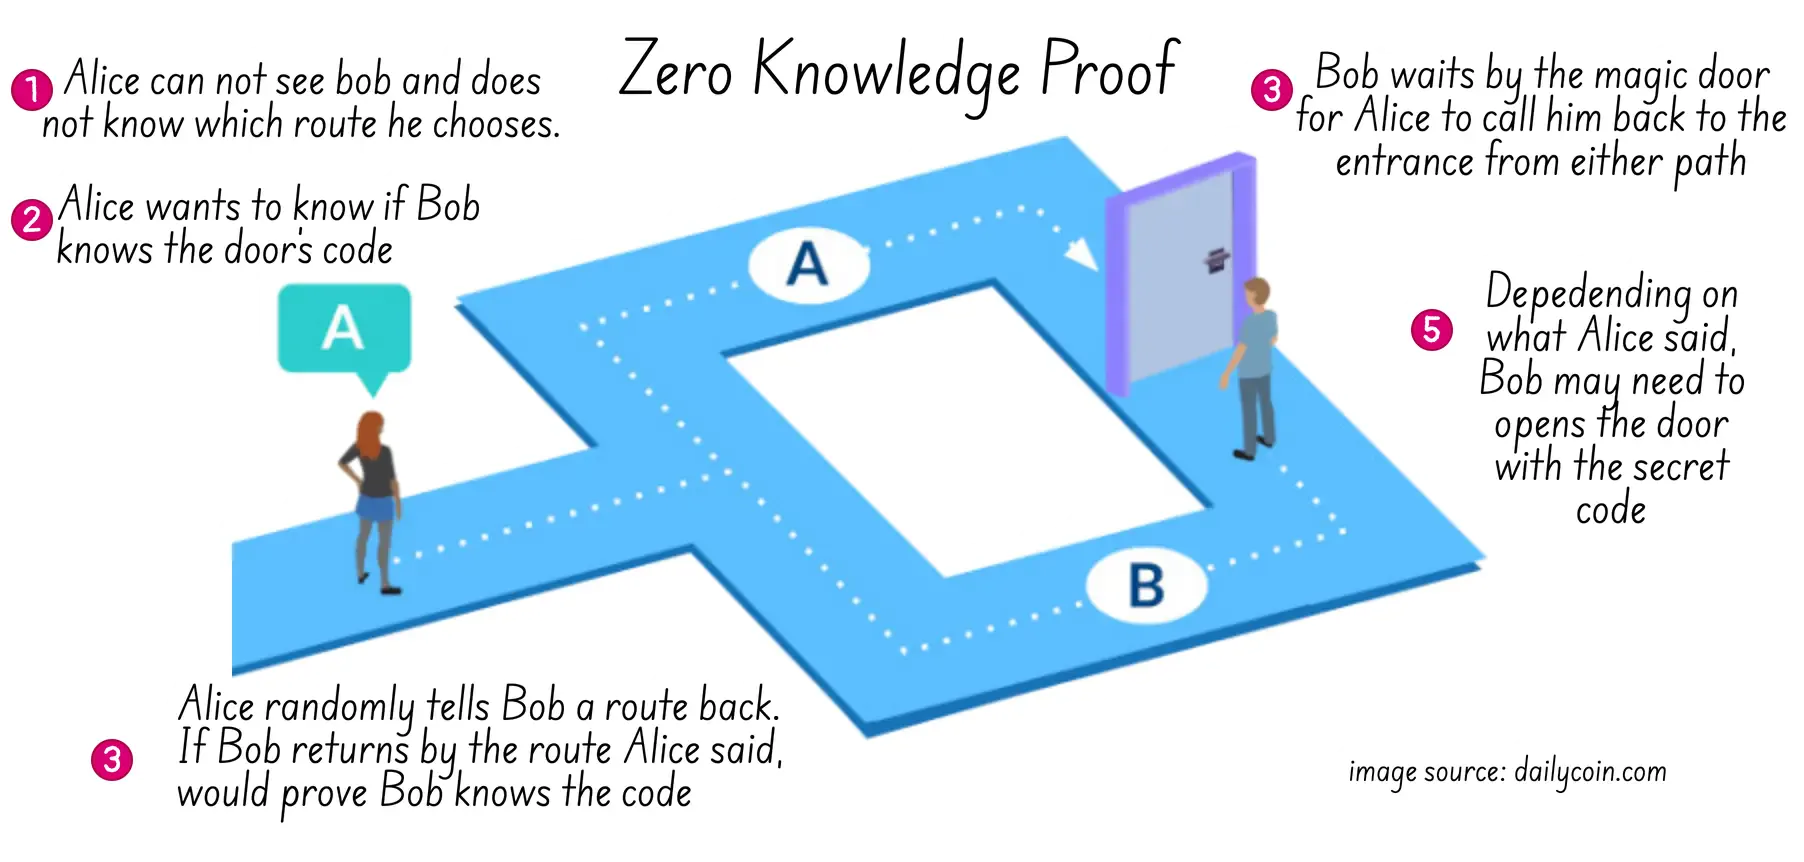 이 문제를 해결하려면 알리바바 동굴 실험에서 사용된 영지식 증명과 동일한 기법을 활용해야 합니다. 즉, 인코딩된 양자 정보가 무엇이든 상관없이 답을 알고 있는 특정 질문만 하면 됩니다. (이미지 출처: dailycoin)
이러한 구체적인 질문들은 파울리 안정화 연산자에 해당합니다. 신드롬 비트, 즉 측정 결과는 경로 A 또는 B로 볼 수 있습니다. 양자 오류 수정(QEC)에서 경로 A는 유효한 상태를 나타내고, 경로 B는 오류를 나타냅니다. QEC “엔진"은 논리 큐비트에 작용하는 양자 회로를 구성할 때, 이러한 제약 조건, 즉 “보호된 상태"를 유지하는 방식으로 작동해야 합니다.
보호된 상태 인코딩 Link to heading
바로 이 부분에서 엔지니어링이 매우 중요해집니다. 신드롬 측정 결과가 오류가 없을 때는 항상 경로 A를, 오류가 있을 때는 경로 B를 반환하도록 하려면, 다중 큐비트 패리티 정보는 모든 유효한 인코딩 상태에 대해 큐비트 간의 관계가 고정되도록 인코딩되어야 합니다.
이것이 인코딩 회로의 기능입니다. 이 회로의 목적은 단순하고 손상되지 않은 입력 상태(예: 빈 보조 큐비트 \(|00...0>\)를 가진 단일 물리적 큐비트 \(|ψ> = α|0> + β|1>\))를 양자 오류 수정으로 보호되는 고도로 얽힌 논리 큐비트 상태 \(|ψ_L>\)로 매핑하는 것입니다.
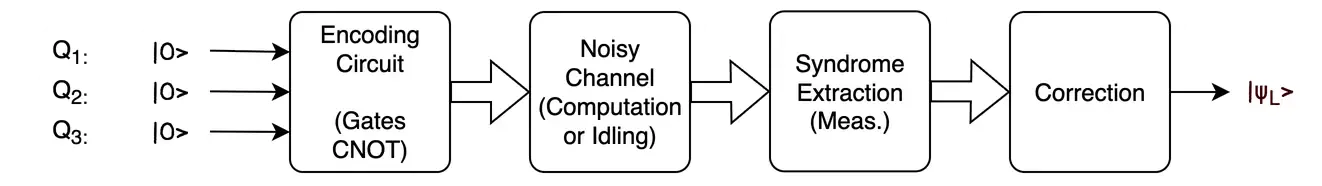
인코딩 회로에 대해서는 추후 메모에서 더 자세히 설명하겠습니다. 지금은 인코딩 회로를 논리 큐비트를 보호된 상태로 초기화하거나 부트스트랩하는 데 사용되는 특수 설계된 양자 회로로 이해하시면 됩니다.
거리 코드 Link to heading
퇴화 오류(즉, “비잔틴” Q 1 + Q 2 증후군)를 해결하기 위해 코드 거리 \( d \)를 증가시켜 중복성을 높일 수 있습니다. 언뜻 보기에 코드 거리 \( d \)는 오류 보호의 견고성을 정의한다고 할 수 있습니다.
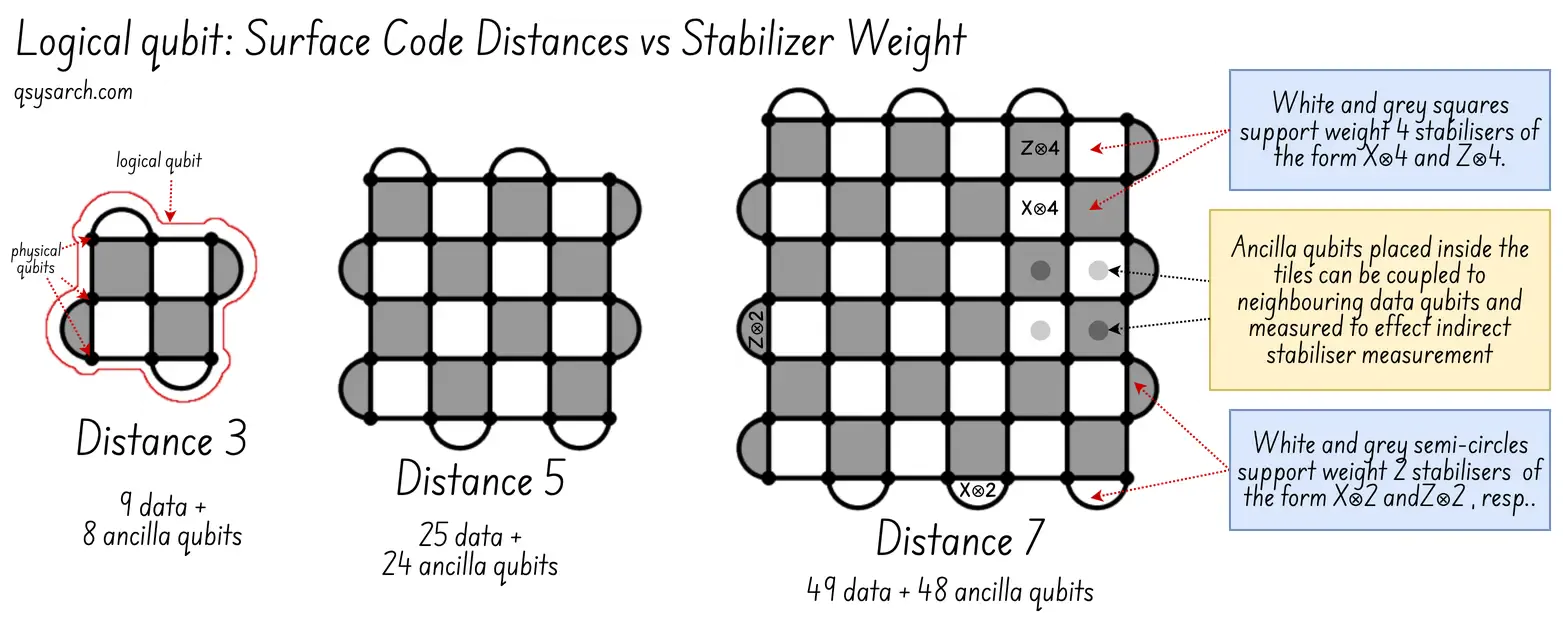
코드 거리가 \( d=3 \)인 경우, 인접한 두 큐비트를 뒤집으면 정보가 손실되어 QEC가 논리 큐비트를 수정하지 못하고, 즉 논리 큐비트를 보호 상태로 유지하지 못합니다. 코드 거리가 더 큰 경우, 예를 들어 \( d=5 \)이면 QEC 디코더는 Q 1 과 Q 2가 뒤집혀 Z 1 Z 2 검사에서 서로를 가리더라도 증가된 안정화 측정값을 통해 디코더가 Q 1 과 Q 2 를 이중 오류로 식별할 수 있는 충분한 컨텍스트를 확보할 수 있습니다. 수학적 관점에서 이는 다음과 같이 표현할 수 있습니다.
임계값 정리 Link to heading
만약 중복성이 문제를 해결한다면, 더 큰 차원의 표면 코드를 사용하면 되지 않을까요? 문제는 물리적 큐비트가 하나씩 추가될 때마다(중복성을 높이기 위해) 더 많은 안정화 장치를 측정해야 한다는 점입니다. 그리고 측정 횟수가 많아질수록 물리적 오류가 발생할 위험도 커집니다.
이는 소위 **임계값 정리**로 이어집니다.
간단히 말해 임계값 정리는 물리적 큐비트의 오류율 \(p\)이 임계값 \(p_{th}\)보다 작으면 오류 수정을 개선하기 위해 더 많은 물리적 큐비트를 추가할 수 있으며 추가된 큐비트의 수는 \(N.log(N)\) 복잡도임을 의미합니다.
이것이 왜 중요할까요? 큐비트가 항상 “제대로 작동하지 않더라도” 그런 현상이 너무 자주 발생하지 않는다면, 개별 큐비트의 합보다 더 나은 성능을 보이는 더 많은 큐비트 집합을 얻을 수 있다는 것을 의미하기 때문입니다. 이는 NISQ 이후, 즉 내결함성 양자 컴퓨팅(FTQC) 시대의 도래를 열어줍니다.
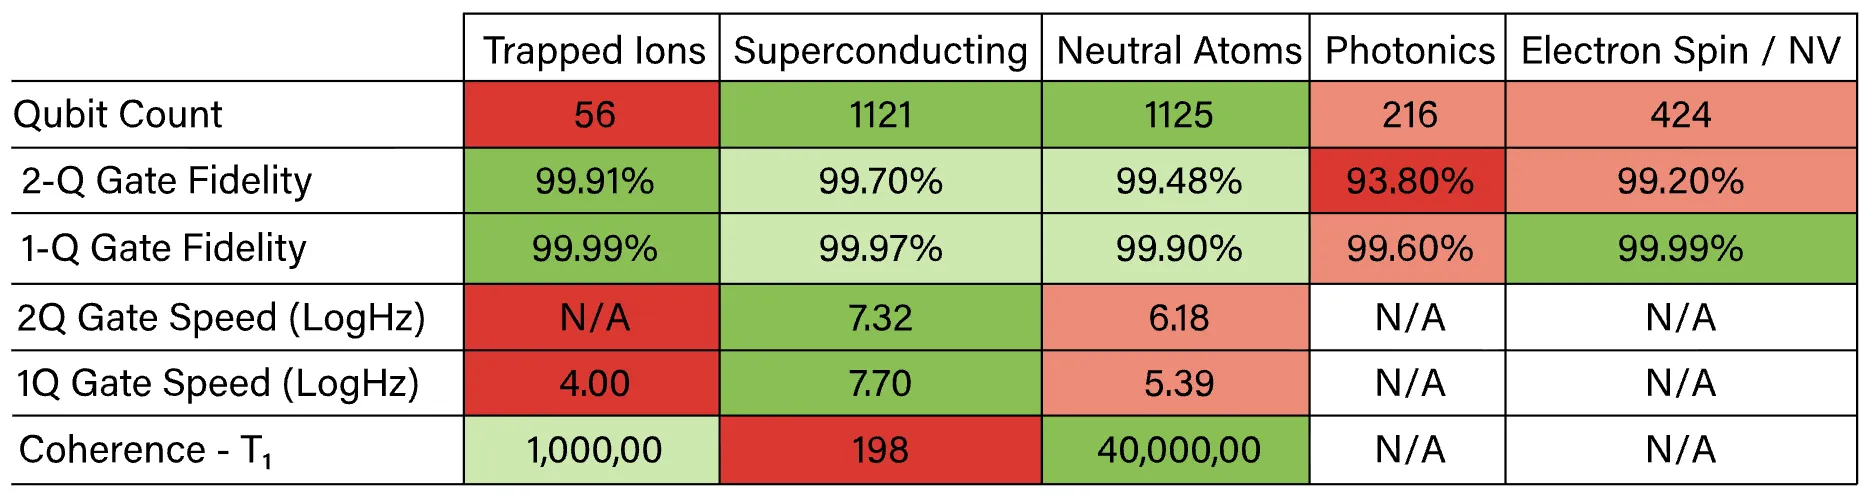
물론 여기서 핵심적인 질문은 이 임계값 \ (p _ {th} )이 무엇인가 하는 것입니다. 이 값은 0.1%에서 1% 정도이며, 낮아 보일 수 있지만 현대 큐비트는 이미 (1큐비트 게이트의 경우) 99.9%의 충실도를 달성할 수 있으므로 문제가 되지 않습니다.
결론 Link to heading
자, 이 짧은 메모는 양자 오류 수정에 사용되는 개념의 기초를 설명합니다.
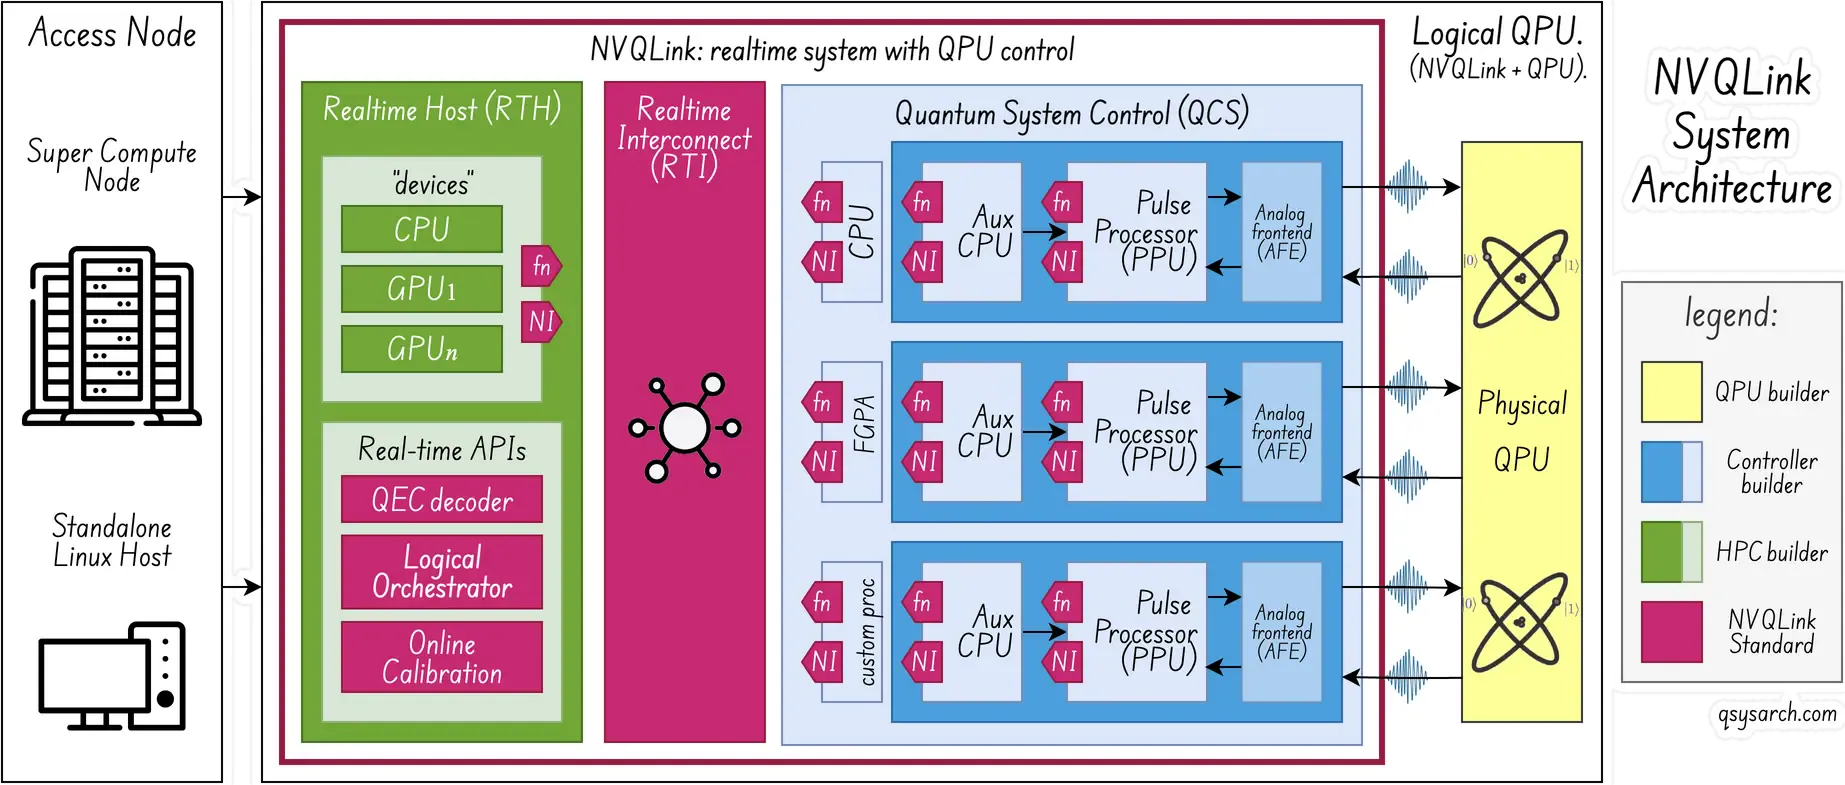
다음 두 개의 메모는 보다 실질적인 내용을 다룰 것입니다. 두 번째 메모에서는 양자 제어 시스템(및 오류 디코더)이 물리적 큐비트를 논리적 큐비트로 변환하는 과정이 제어, 판독 및 시퀀싱 측면에서 구체적으로 어떤 의미를 갖는지 분석할 것입니다. 세 번째 메모에서는 디코딩 시스템과 디코더와 제어 시스템 간의 저지연 및 실시간 통신에 대해 중점적으로 다룰 것입니다.
이 메모는 일련의 메모 중 첫 번째입니다. 다음 QEC 메모에서는 다음과 같은 주제를 다룰 예정입니다.
양자 제어 시스템 관점에서 증후군 추출을 오케스트레이션합니다.
실시간 오류 디코딩: 초저지연 ASIC, GPU 및 신경망.
공동 설계된 스마트 큐비트: 앨리스와 밥의 오류 방지 큐비트 사례
대규모 표면 코드 컴파일러: 수십억 건의 물리적 연산에 대한 내결함성을 극대화합니다.
계층적 디코딩 아키텍처: 지역성 원칙 및 다계층 처리
논리적 큐비트 오케스트레이션: 격자 수술 및 브레이딩
표면 코드 그 이상: qLDPC 코드로의 전환
매직 스테이트 증류 및 아날로그 회전
앞으로 6개월 동안은 이 일 때문에 엄청 바쁠 것 같네요!
References:
- Real-time Surface-Code Error Correction Using an FPGA-based Neural-Network Decoder
- Real-Time Quantum Error Correction System Stack: Architecture, Algorithms, and Engineering Practice
- Reinforcement learning control of quantum error correction
- Riverlane Deltaflow: The Quantum Error Correction Stack
- Quantum Machine: QEC decoding
- How IQM is tackling quantum error correction
- Q-CTRL: Towards practical Quantum Error Correction
- Building logical qubits in a superconducting quantum computing system
- The Quantum Leap That Needs Error Correction
- Error budgeting for quantum error correction
- How Space and Time Could Be a Quantum Error-Correcting Code
- Quantum error correction in the presence of biased noise
- What Makes a “Logical Qubit” Actually Logical?
- Hybrid Multiplexing with Dynamic Qubit Grouping for Low-cost and Scalable Quantum Wiring
- Defining the Logical Qubit: Five Criteria to Benchmark Logical Qubit Claims
- Real-Time Decoding for Fault-Tolerant Quantum Computing: Progress, Challenges and Outlook
- Why do quantum computers need QEC?
- To reset, or not to reset—that is the question
- A memristive neural decoder for cryogenic fault-tolerant quantum error correction
- Decoupling AI for Quantum Control and Calibration
- A high performance compiler for very large surface code computations
- All about quantum error correction: distillation, mitigation, self-correction and beyond
- StreamingQEC: Streaming Quantum Error Correction in Tightly Integrated Quantum-Classical Systems via Certified Recurrence
- A real-time, scalable, fast and highly resource efficient decoder for a quantum computer
- Constraint-Optimal Driven Allocation for Scalable QEC Decoder Scheduling
- Comparison of spin-qubit architectures for quantum error-correcting codes
DrawIO diagrams used in this memo: