저는 Qblox 팀의 일원이 되어 매우 기쁩니다. Qblox는 GPU, CPU 및 QPU(Qblox가 개발 중인 양자 컨트롤러를 포함한 양자 프로세서)에서 연산되는 이기종 시스템을 상호 연결하는 방법인 NVQLink 표준을 홍보하기 위해 Nvidia와 적극적으로 협력해 왔으며, 지금도 여전히 협력하고 있습니다.
NVQLink 개요 Link to heading
NVQLink는 GPU와 양자 프로세서를 연결하는 또 다른 “케이블"이 아니라, 네트워크에서 소프트웨어 스택에 이르기까지 이기종 장치를 상호 연결할 수 있는 완벽한 프레임워크입니다.
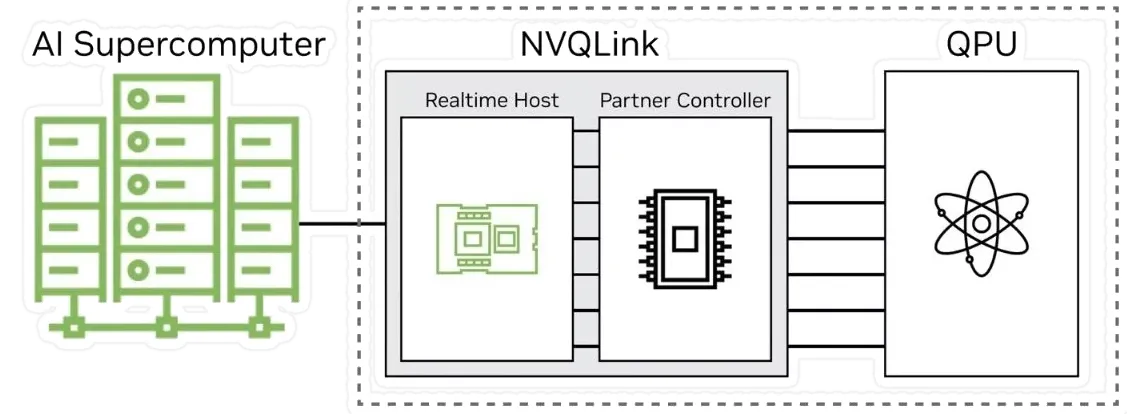 이미지 출처: Nannod
성능 사양은 무엇인가요? Link to heading
핵심 “하드웨어” 사양은 네트워크 및 컴퓨팅 리소스의 성능을 강조합니다.
네트워크 처리량: GPU에서 QPU까지 최대 400Gb/s.
네트워크 지연 시간: 왕복 지연 시간(FPGA → GPU → FPGA) 4.0마이크로초 미만.
GPU 하드웨어: NVIDIA GB200 Grace Blackwell 슈퍼칩 기반의 실시간 호스트로, 높은 TFLOPS 성능을 자랑합니다.
NVQLink가 필요한 이유 Link to heading
“이게 왜 중요할까요?“라고 질문하실 수도 있습니다.
이는 양자 하드웨어와 가속 GPU 컴퓨팅을 긴밀하게 통합하기 위한 개방형 표준을 만듭니다.
신경망 보정, 양자 오류 수정(QEC) 등과 같은 하이브리드 워크플로우를 지원합니다.
이는 소프트웨어와 하드웨어를 하나로 통합하는 개방형 플랫폼을 제공하여 누구나 방대한 지식의 바다에 빠지지 않고 양자 컴퓨터와 상호 작용할 수 있도록 해줍니다. 이는 Cuda-Q 덕분입니다.
NVQLink 사양: 아키텍처 설계 Link to heading
NVQLink 백서는 https://arxiv.org/abs/2510.25213에서 확인할 수 있으므로, 제안된 아키텍처의 세부 사항을 자세히 살펴보겠습니다.
시스템 아키텍처 Link to heading
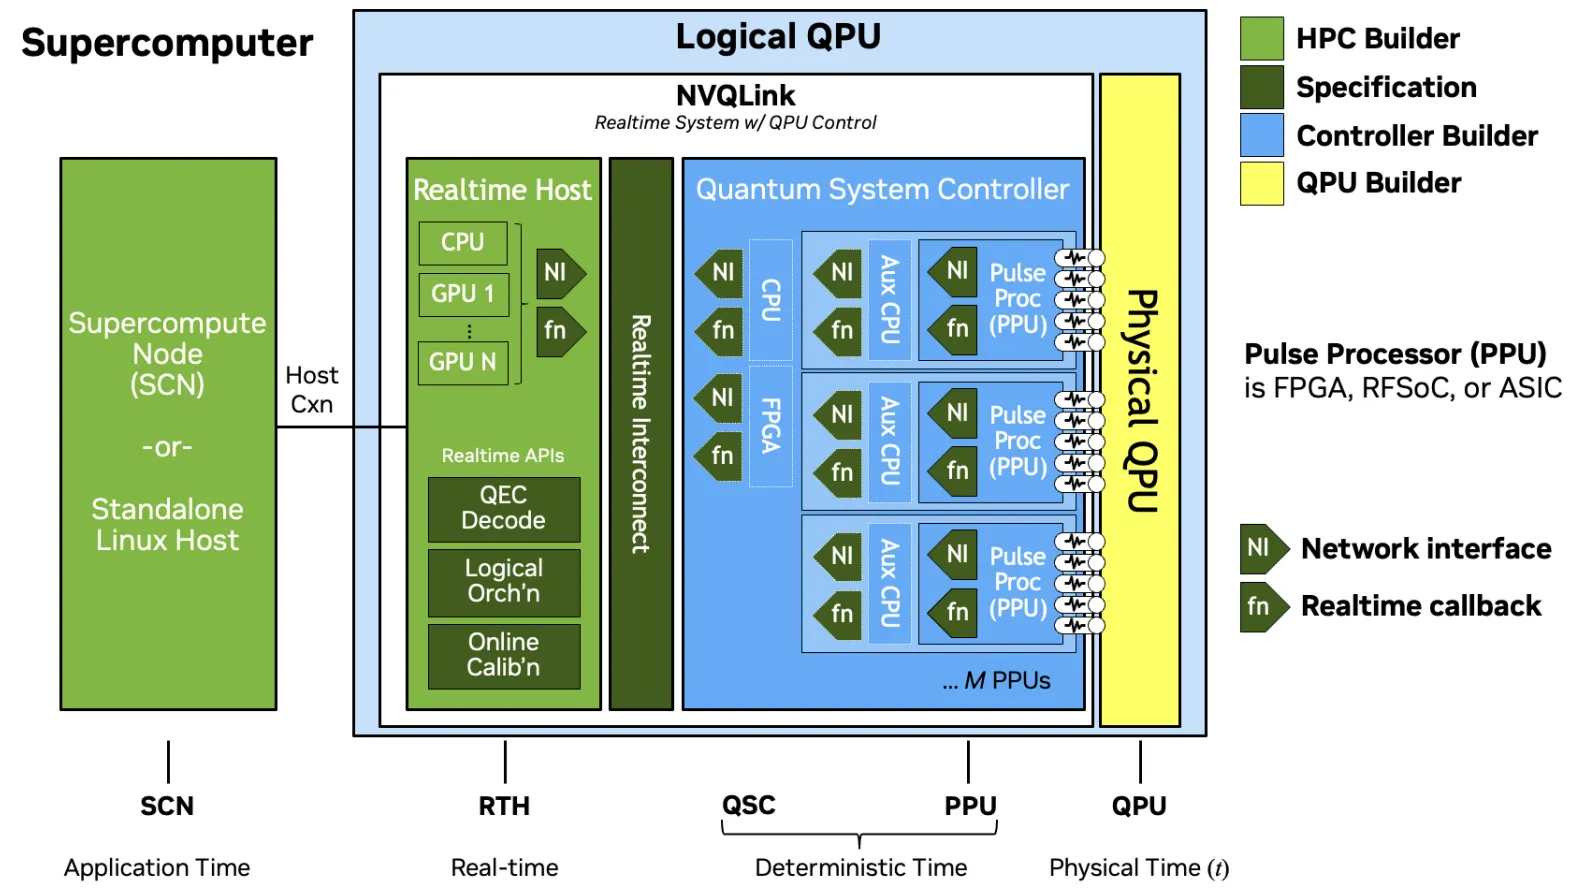
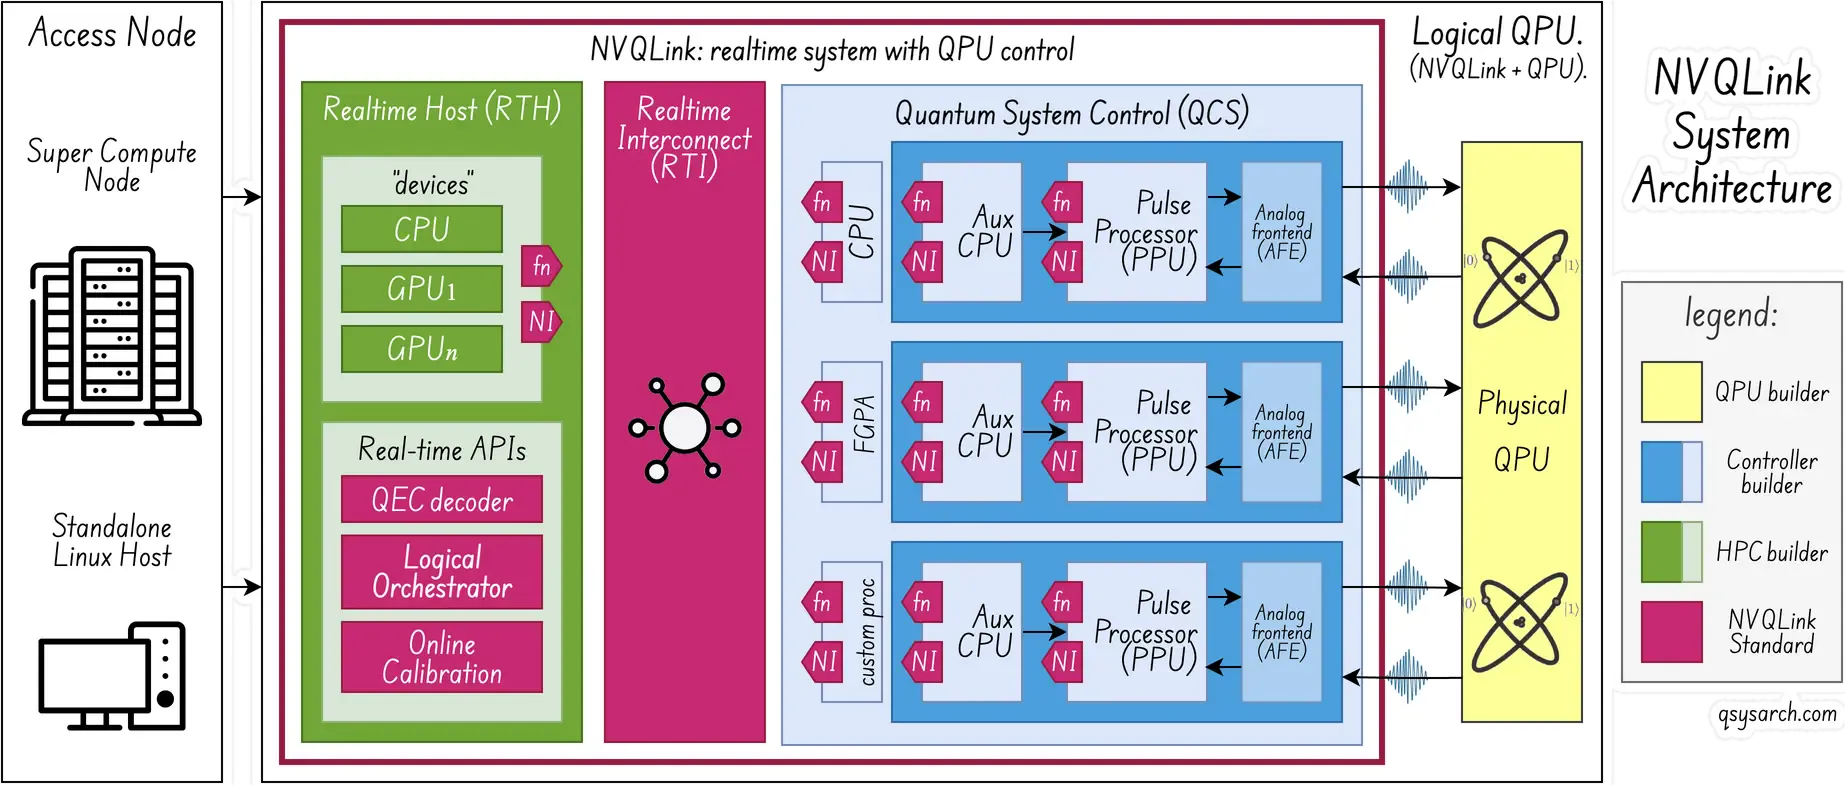 (시스템 다이어그램은 백서의 원본 그림을 기반으로 작성되었습니다.)
예상대로 세부 사항은 Nannod에서 제공한 개요와 일치합니다. 구성 요소 관점에서 NVQLink 아키텍처는 실시간 호스트(RTH)와 QPU 제어 시스템(QSC)으로 구성됩니다. 이 두 구성 요소는 저지연, 확장 가능한 실시간 인터커넥트(RTI)로 연결됩니다. RTH는 CPU 및 GPU와 같은 기존 HPC 컴퓨팅 리소스를 갖추고 있습니다. QSC는 일반적으로 QPU를 제어하는 펄스 처리 장치(PPU)를 포함합니다.
이 다이어그램은 fn과 NI라는 두 가지 중요한 키워드를 소개합니다. NVQLink의 개념 모델(“프로그래밍 모델”)에서는 각 CPU, GPU, PPU(또는 기타 특수 IC/FPGA)를 “장치"라고 하며, NVQLink를 사용하면 이러한 장치 중 어느 곳에서든 원격 프로시저 호출(“콜백” 또는 fn")을 수행할 수 있습니다. NVQLink는 이기종 시스템을 연결하는 접착제 역할을 하는 매우 강력한 솔루션입니다. fn런타임의 실제 구현은 마샬링까지 처리할 수 있을 정도로 고도로 최적화되어 있어 몇 마이크로초 수준의 지연 시간을 보장할 수 있습니다.NI`는 네트워크 인터페이스의 약자로, 모든 구성 요소가 통합된 상호 연결 시스템을 구축하는 데 사용할 수 있는 “소형"의 선택적 네트워킹 카드/인터페이스/케이블로 개념화됩니다.
시간 영역 Link to heading
NVQLink는 또한 시간 영역이라는 매우 중요한 개념을 도입합니다. 이는 시스템에 관련된 모든 “처리 장치"가 “동일한 클록"을 따를 필요는 없기 때문에 필요합니다.
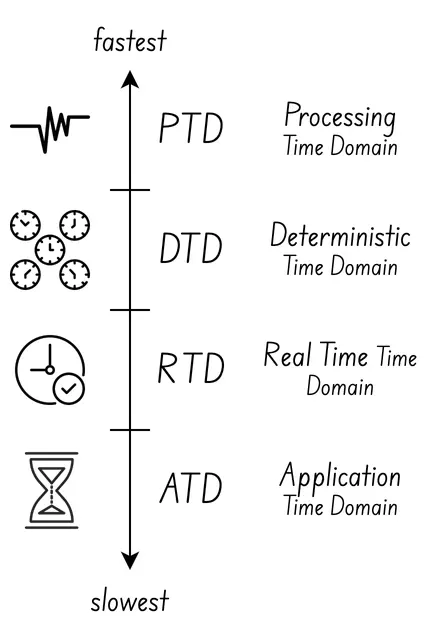
클럭 또는 시간 도메인은 가장 빠른 것부터 가장 느린 것까지 4가지 범주로 나뉩니다.
물리적 시간 영역(PTD): 일반적으로 QPU 클럭입니다.
결정론적 시간 영역(DTD): 일반적으로 양자 컴퓨팅(QSC)/FPGA의 클록으로, 양자 결맞음 시간 척도로 작동할 수 있습니다.
실시간 영역(RTD): 일반적으로 기존 CPU 또는 GPU에서 구현됩니다. 양자 결맞음 시간 내 또는 두 양자 결맞음 실험 사이에서 구현될 수 있습니다.
응용 프로그램 시간 영역(ATD): 일반적으로 Jupyter Notebook이 실행되는 노트북을 의미합니다!
네트워크 아키텍처 Link to heading
놀랄 것도 없이 NVQLink는 불필요한 CPU 처리를 우회하고 최적의 지연 시간을 보장하기 위해 RDMA와 GPUDirect를 사용합니다. 사양에 명시된 대로, “이 두 기술의 이점을 활용하여 호스트의 개입 없이 NIC와 GPU만 QSC에서 오가는 패킷 처리에 관여합니다.”
또한, 사양에서는 “신뢰할 수 없는 연결” RDMA 모드 사용을 권장하는데, 이는 RC(신뢰할 수 있는 연결)를 사용할 때 발생하는 지연 시간이 제대로 설계된 네트워크에 비해 과도할 수 있기 때문입니다.
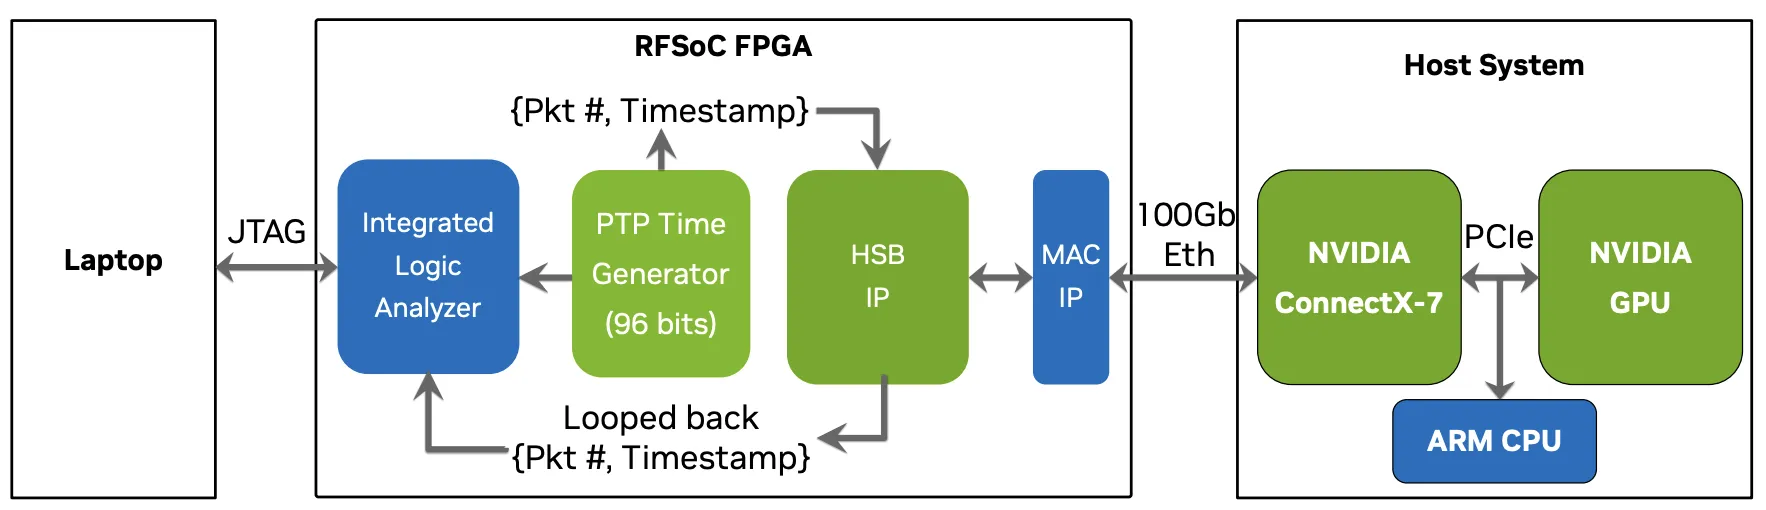
본 사양은 달성 가능한 지연 시간을 검증하기 위한 수단으로 네트워크 아키텍처에 대한 “개념 증명"을 제공합니다. FPGA와 NIC 간에 RoCE(RDMA over Converged Ethernet) 프로토콜을 사용하여 데이터를 전송하고 열거 단계 및 제어 신호를 처리하는 Holoscan Sensor Bridge 모듈이 사용됩니다. 이 아키텍처를 사용하면 32바이트 RDMA 페이로드(이더넷 프레임 92바이트에 해당)에 대해 4마이크로초 미만의 왕복 지연 시간을 달성할 수 있음을 사양에서 보여줍니다.
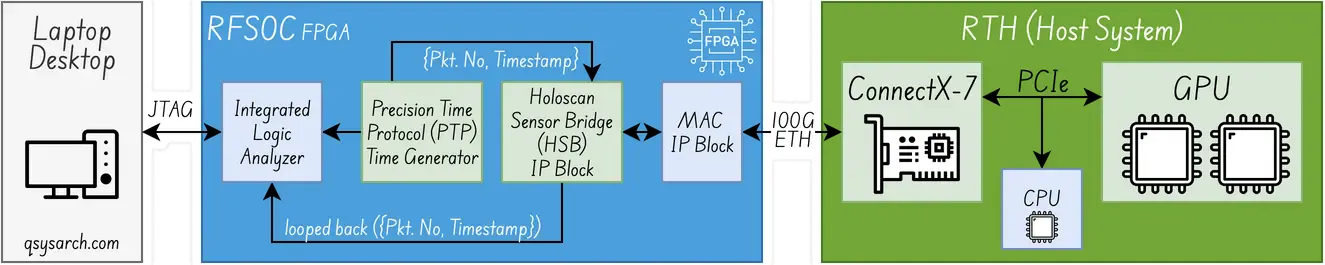 (백서의 원본 그림을 기반으로 작성된 다이어그램)
컴파일 아키텍처 (CUDAQ+NVQLink 프로그래밍 모델) Link to heading
NVQLink는 느린 모드와 빠른 모드를 구분하며, 이 섹션에서는 특히 빠른 모드 아키텍처의 영향(소위 “높은 지연 시간 민감도”)을 살펴보겠습니다. 느린 모드와의 주요 차이점은 빠른 모드 아키텍처가 JIT(Just-in-Time) 컴파일과 실행 중 RTH(Right-to-Time) 중재를 지원한다는 점입니다.
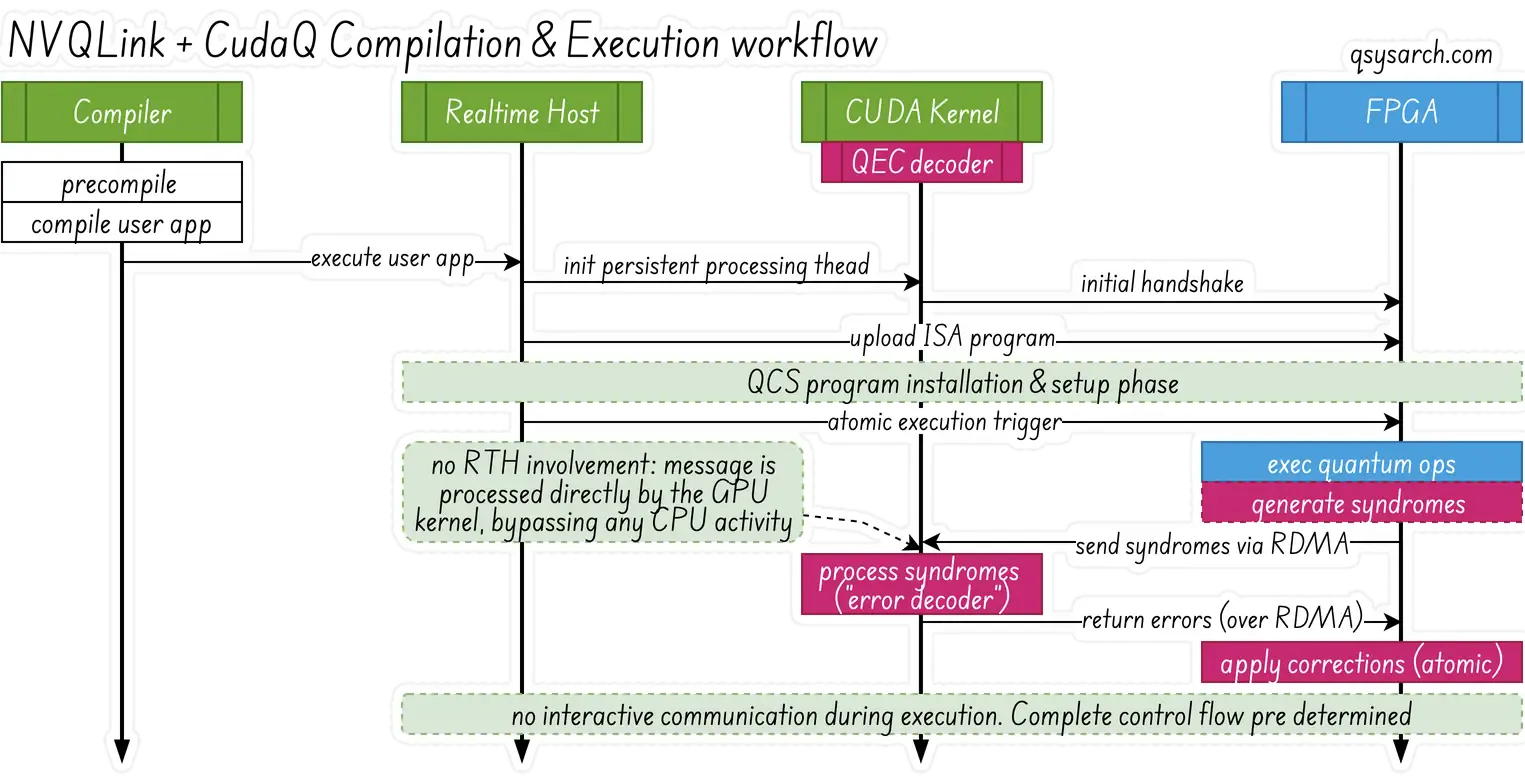
CUDAQ + NVQLink를 고속 모달리티와 함께 사용하려면, 명세에 따르면 완전한 ISA 프로그램이 FPGA에 미리 업로드되어 원자적으로 실행되어야 하며, 실행 중 실시간 호스트와의 상호 작용은 최소화되어야 합니다. JIT는 정말 멋진 기술인데, 고속 모달리티에 사용할 수 없다는 점이 아쉽습니다. 하지만 명세에서는 FPGA가 프로그램이 종료될 때까지 명령어 큐가 비어 있지 않은 한, 실시간 호스트로부터 동적 업데이트를 “수신"할 수 있다고 명시하고 있습니다(“명령어 큐를 통해”). 이는 “적시(Just-in-Time)” 스케줄링과 유사한 방식입니다.
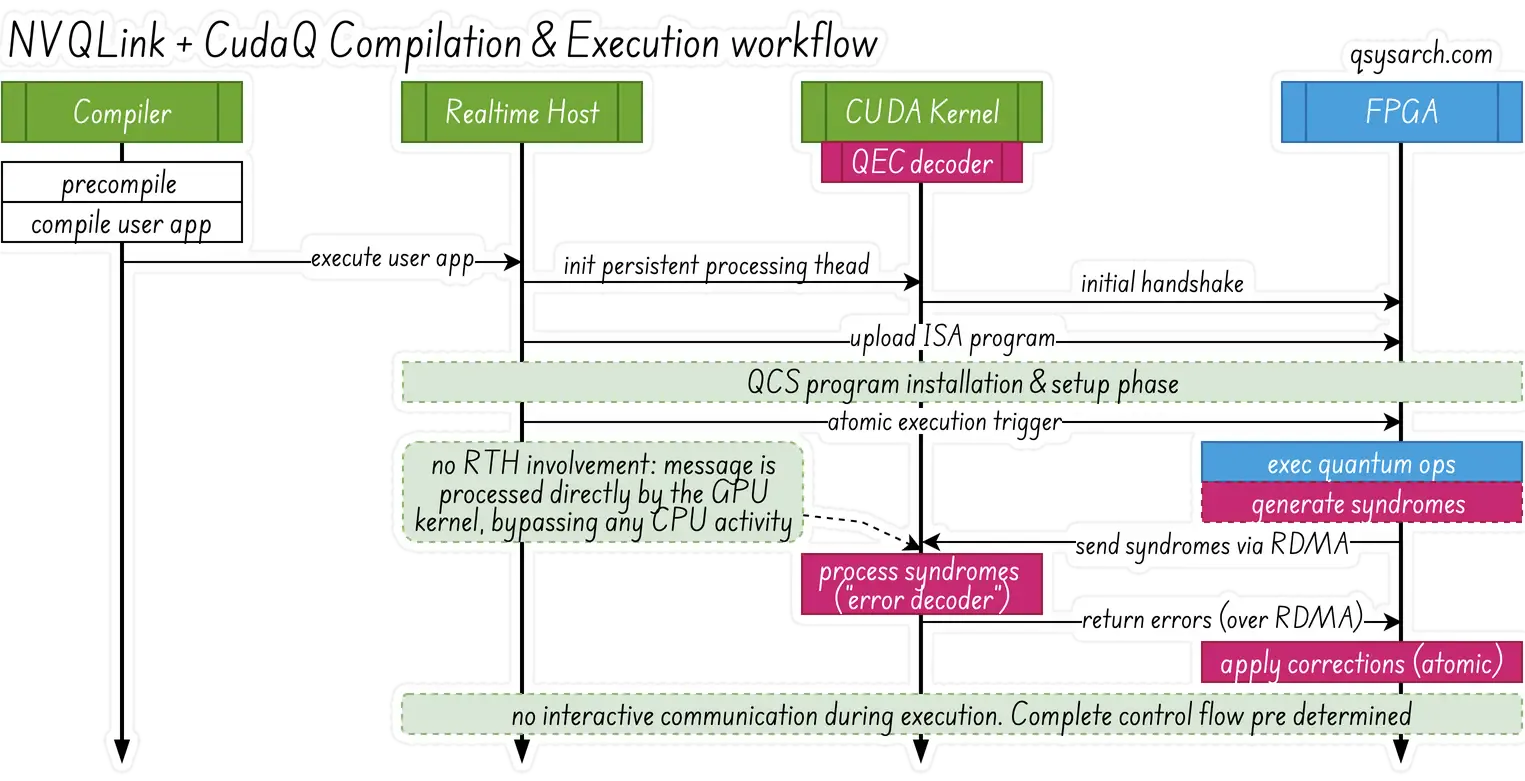
놀랄 것도 없이, 사양서에는 컴파일 시 적극적인 사전 최적화가 수행되어야 한다고 명시되어 있으며, 이는 모든 양자 제어 스택 공급업체가 핵심적으로 수행하는 작업입니다. 또한, 콜백 함수를 GPU에서 실행해야 하는 경우 GPU의 CUDA 커널이 미리 초기화되어 이벤트를 적극적으로 대기해야 한다고 언급되어 있는데, 이는 특별한 것이 아니라 표준 DOCA GPUNetIO 워크플로입니다.
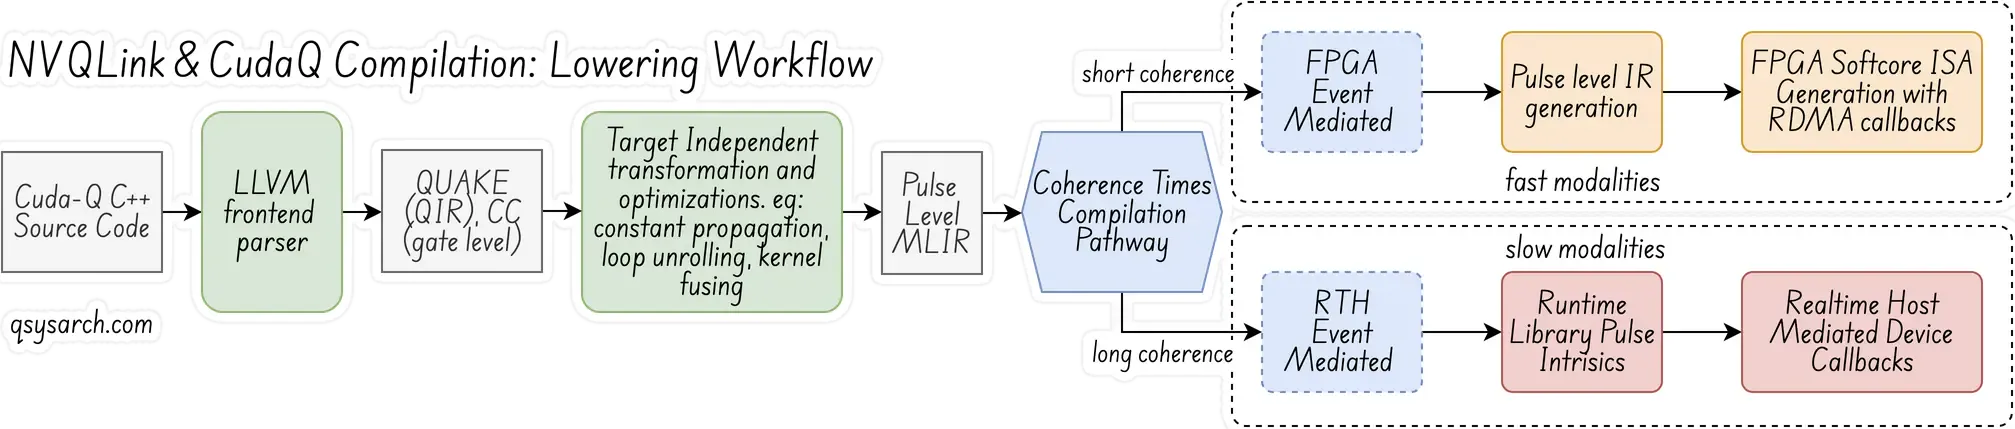
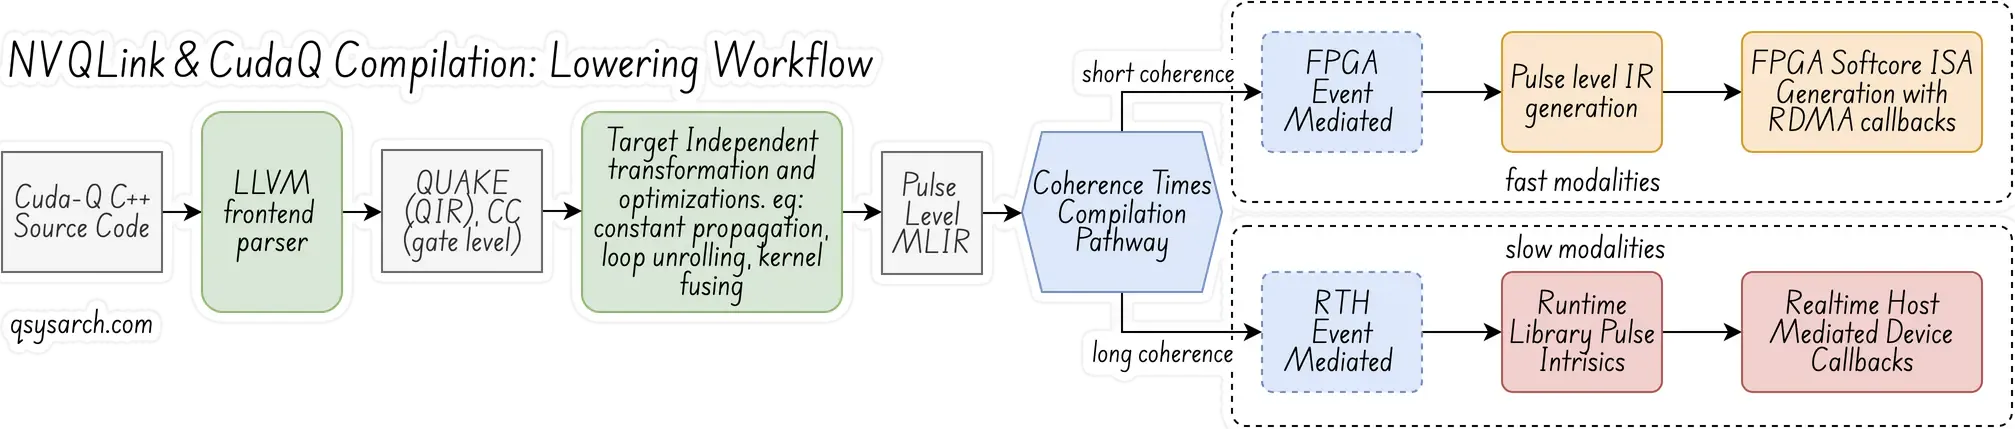
CUDA=Q 컴파일 및 NVQLink 아키텍처로의 변환 워크플로는 표준 LLVM MLIR 아키텍처를 기반으로 합니다(위 다이어그램 참조). 첫 번째 단계는 CUDA 커널을 파싱하여 게이트 레벨에서 추상화된 양자 IR(QIR 또는 QUAKE라고도 함) 및 CC(클래식 컴퓨팅) 중간 IR을 생성하는 것입니다. 다음 단계에서는 필요한 최적화 및 커널 융합을 통해 펄스 레벨 다이얼렉트를 생성합니다. 그런 다음 모달리티 유형에 따라 다음 변환 단계에서는 RTH 또는 FPGA 중개 방식을 사용합니다.
“양자 커널"은 __qpu__ 접두사로 식별됩니다.
int gpu_adder(int, int);  // This function is executed on GPU
__qpu__ int simple_quantum_kernel(int i) { // This function (kernel) is executed on the QCU
    cudaq::qubit q;
    h(q); // Operate an H gate on qubit q
    auto readout = mz(q); // Read the Z axis of qubit q
    return cudaq::device_call(2, gpu_adder, i, readout); // This is tail function call
}
컴파일 단계에서 먼저 QUAKE(양자 방언)와 CC(고전 컴퓨팅 방언) 중간 표현(IR) 또는 방언이 혼합된 형태로 변환(“낮춰짐”)됩니다.
func.func @simple_quantum_kernel(%arg0: i32) -> i32 {
    %0 = quake.null_wire
    %1 = quake.h %0 : (!quake.wire) -> !quake.wire
    %measOut, %wires = quake.mz %1 : (!quake.wire) -> (!quake.measure, !quake.wire)
    %2 = quake.discriminate %measOut : (!quake.measure) -> i1
    %3 = cc.cast unsigned %2 : (i1) -> i32
    %4 = cc.device_call @gpu_adder on 2 (%arg0, %3) : (i32, i32) -> i32
    return %4 : i32
}
런타임 아키텍처: 트레이트를 활용한 메타 프로그래밍
RDMA에 깊이 뿌리내린 제로 카피 개념에 따라 NVQLINK 런타임 또한 두 가지 핵심 개념을 통해 고성능과 오버헤드 없는 추상화를 추구합니다.
특성 기반 구성: 이는 모든 장치 동작을 표현하는 컴파일 시간 수단이며, NVQLink는 일련의 표준 특성을 제안합니다.
정적 다형성: 컴파일러가 가상 테이블 간접 참조 없이 올바른 메서드를 인스턴스화할 수 있도록 하는 컴파일 시간 수단입니다.
필수적인 특성은 4가지입니다.
explicit_data_marshalling_trait: 시스템 전체에 데이터를 할당하고 전송하는 방법을 의미합니다.
device_callback_trait: 장치 함수(“RPC”)를 호출하는 수단
quantum_control_trait: 양자 제어 시스템(QCS)에 프로그램을 업로드하고 시작하는 것을 의미합니다.
rdma_trait: 원시 메모리 버퍼에서 구조체를 효율적으로 초기화하는 것을 의미합니다.
실제로 이러한 특성들은 C++ 언어를 매우 고급 수준으로 활용합니다. 예를 들어 데이터 마샬링 특성이 그렇습니다.
template <typename Derived> class explicit_data_marshaling_trait {
public:
  void *resolve_pointer(device_ptr &devPtr);
  device_ptr malloc(size_t size) const;

  template <typename... Sizes, enable_if_t<(conjunction_v<is_integral<Sizes>...>),int> = 0>
  auto malloc(Sizes... szs) { return make_tuple(static_cast<Derived *>(this)->malloc(szs)...); }

  void free(device_ptr &d);

  template <typename... Ptrs, typename = enable_if_t<(conjunction_v<is_same< remove_cv_t<remove_reference_t<Ptrs>>, device_ptr>...>)>>
    void free(Ptrs &&...d) { (free(d), ...);
  }
  void send(device_ptr &dest, const void *src);
  void recv(void *dest, const device_ptr &src);
};
이 구문에는 파헤쳐볼 것이 많으며, 제 생각에는 Rust 구문보다 훨씬 강력합니다(예: cow). 이 구문은 ‘메타프로그래밍’이라고도 하며, NVQLINQ의 맥락에서는 컴파일 타임 또는 정적 다형성을 의미합니다. template’ 줄을 살펴보겠습니다. <typename… Sizes, enable_if_t<(conjunction_v<is_integral
is_integral<Sizes>as α:Sizes가 정수형(int, float, bool 등)인 경우true를 반환합니다.conjunction_v<α...>as β:α...의 모든 값이 참이면true입니다.enable_if_t<(β),int>as δ:β가 false인 경우 실패해야 하는 그룹 2 조건문입니다.템플릿<typename… Sizes, δ = 0>:δ`가 실패하는 것을 방지하는 SFINAE 구문입니다.
이 구문을 사용하면 여러 블록을 한 번에 할당하는 특수한 malloc 명령이 가능해집니다.
class gemm_device : public explicit_data_marshalling_trait {  ... }
gemm_device gpu_gemm; // "gemm" stands for general matrix multiply
auto [column, row, matrix] = device.malloc(1024, 1024, 1024*1024);
왜 이것이 중요한지 궁금하실 수도 있습니다. 간단히 말해 컴파일 시간에 최적의 특수화를 가능하게 하기 때문입니다. 이 경우 malloc 구현은 메모리 버퍼를 연속적으로 묶어서 저장할 수 있으므로 RDMA 교환 및 여러 데이터의 원자적 마샬링에 적합합니다. 멋지지 않나요?
런타임 아키텍처: 커널 Link to heading
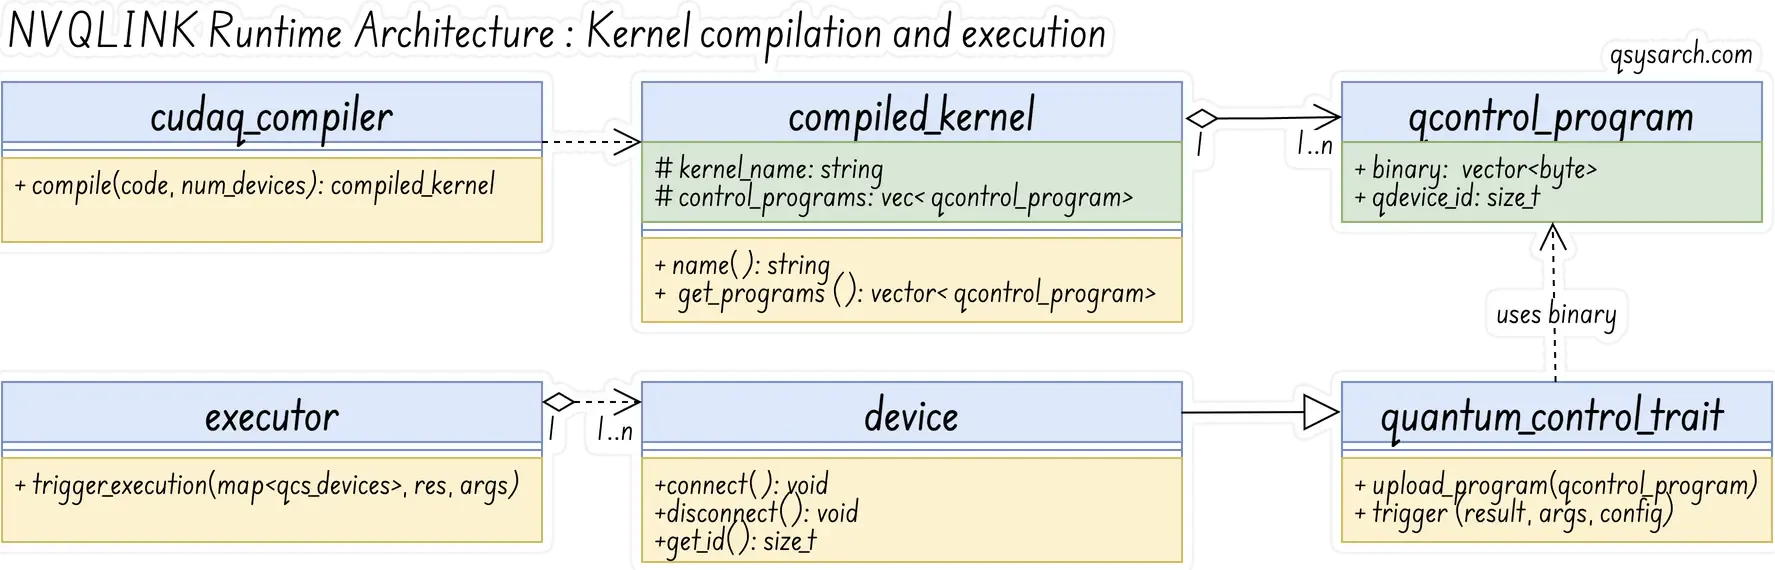
NVQLink는 양자 커널을 컴파일, 업로드 및 실행(트리거)하기 위한 표준 인터페이스 세트를 제공합니다. 백 마디 말보다 그림 한 장이 낫다는 말처럼, 이 부분을 다음 그림으로 요약하겠습니다.
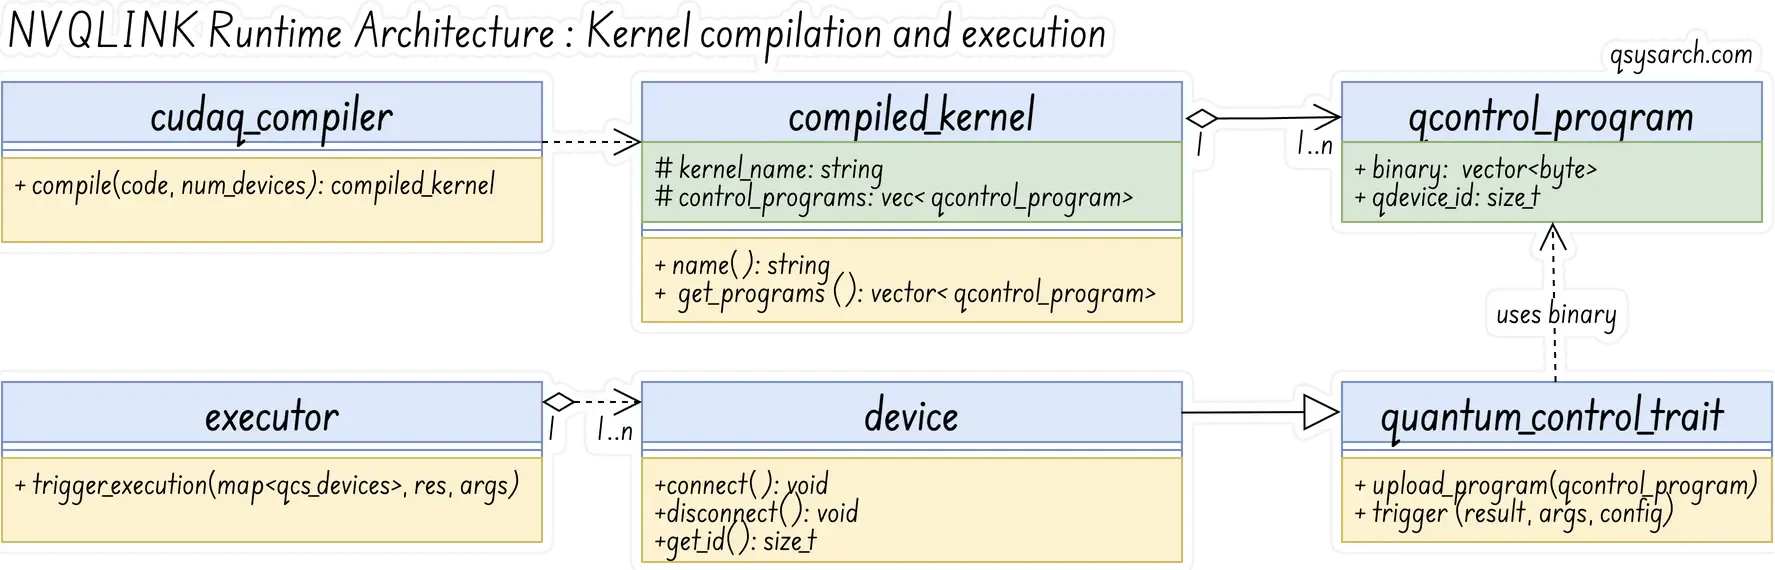
한 가지 주목할 점은 QCS(양자 제어 시스템)가 여러 개의 PPU(펄스 처리 장치)로 구성된다는 것입니다. 따라서 커널을 컴파일할 때 여러 PPU에서 동기적으로 실행해야 할 수도 있습니다. (참고로 NVQLink는 동기 실행 여부에 관계없이 작동하지만, 각 QCS 공급업체는 Qblox의 경우 SYNQ(https://docs.qblox.com/en/main/products/architecture/cluster/synq_linq.html#synq)와 같은 자체 솔루션을 제공합니다.)
NVQLINK 인터페이스의 맥락에서 PPU 개념은 추상화되어 일반적인 양자 장치를 나타내는 QCS로 대체됩니다. 따라서 커널을 컴파일할 때 NVQLINK는 각 QCS에 대해 여러 프로그램을 생성합니다.
런타임 아키텍처: 상위 수준 추상화 “라이브러리” Link to heading
이전 섹션에서 설명한 코드는 이해하고 활용하기에 다소 복잡할 수 있으므로, NVQLINK는 함수 형태의 상위 수준 API 세트를 제공합니다.
이 라이브러리에는 기본적인 초기화 및 종료 기능, memcpy와 같은 장치별 데이터 변형 API 처리, 논리적 QPU로의 데이터 이동 및 데이터 수신, 업로드 및 실행을 처리하는 함수가 포함되어 있습니다. 아래는 이러한 함수의 간소화된 버전입니다.
void initialize(DeviceTypes &&...in_devices);
void shutdown();

device_ptr malloc(size_t size, size_t devId);
void free(device_ptr &d);

void memcpy_to_qpu(device_ptr &arg, const void *src);
void memcpy_from_qpu(void *dest, const device_ptr &src);

handle load_kernel(const string &code, const string &kernel_name);
void launch_kernel(handle kernelHandle, device_ptr &result, const vector<device_ptr> &args);
응용 예시: 순간 이동해 봅시다 Link to heading
완료될 예정입니다
결론 Link to heading
NVQLINK는 이기종 시스템 간의 상호 연결을 매우 효율적이고 최적화된 런타임으로 가능하게 하는 강력한 시스템 수준 추상화입니다. NVQLink가 다른 프레임워크보다 매력적인 이유는 네트워크용 RDMA, 컴파일러용 LLVM, 런타임용 트레이트 및 표준화된 API를 포함한 표준 스택으로 구성되어 있기 때문입니다.
NVQLINK를 사용하면 개발자와 시스템 통합자는 더 이상 상호 연결에 대해 걱정할 필요가 없습니다. 대신, 이기종 시스템 구성에 집중하고 단일 프레임워크 내에서 멀티 디바이스 커널을 컴파일할 수 있으며, NVQLINK 런타임이 마치 하나의 시스템처럼 다양한 “디바이스"의 실행을 관리하도록 할 수 있습니다. NVQLINK 런타임은 네트워킹, 마샬링 및 디바이스 간 호출을 처리하므로 개발자는 이러한 작업에 신경 쓸 필요가 없습니다.
이는 엄청난 도약입니다. CudaQ와 함께라면 양자 엔지니어들이 강력한 애플리케이션을 만들 수 있게 될 것이며, 마치 엔비디아 CUDA가 강력한 신경망 애플리케이션을 가능하게 했던 것과 같습니다. 양자 기술이 접목된 LLM을 상상해 보세요.
지시사항: NVQLINK 시스템을 통해 연결된 인접한 GPU에서 계산되는 “대규모 큐비트 모델"의 이미지를 그리시오 >
ChatGPT는 NVLINK가 NVQLINK와 다르다는 점을 이해하지 못했습니다.
지시사항: 인접한 GPU에 연결된 “대형 큐비트 모델"을 상호 연결하는 NVQLINK 시스템을 만화 스타일로 그려주시겠습니까? >
ChatGPT는 NVQLINK가 “케이블"이 아니라 여러 이기종 장치에서 실행되는 커널을 구성할 수 있도록 하는 시스템 수준 프레임워크라는 점을 여전히 이해하지 못하는 것 같습니다. 그리고 현재로서는 표준이기 때문에 RDMA가 케이블 역할을 할 것으로 예상되지만, 5년 후에는 NVLink가 될 가능성도 충분히 있습니다.
References
- Platform Architecture for Tight Coupling of High-Performance Computing with Quantum Processors
- An LLVM-based C++ Compiler Toolchain for Variational Hybrid Quantum-Classical Algorithms and Quantum Accelerators
DrawIO diagrams used in this memo:


In the press Link to heading
QPU Vendor Link to heading
- Pasqal: Integrated with their Qadence/Pulser stack.
- Quandela: Integrated with the Merlin framework
- IQM: Together with Zurich Instruments.
- Infleqtion: Integrated with the Superstaq.
- OQC|Oxford Quantum Circuits:
- Orca Computing: PT-Series systems
- Rigetti
- Silicon Quantum Computing:
- SEEQC:
- Alice & Bob
- Quantinuum
- IonQ