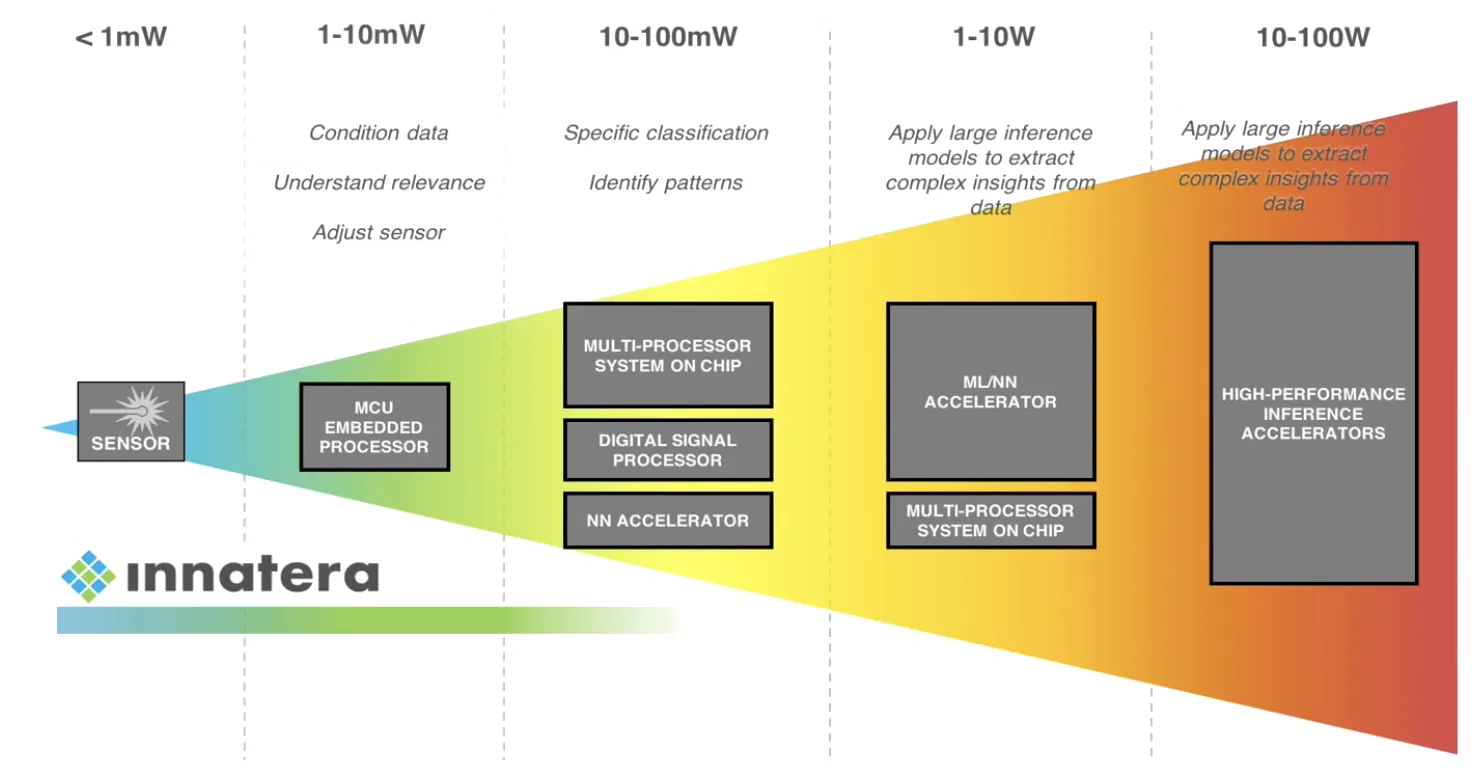
최근 뉴럴링크(Neuralink)에 대해 이야기하다가 뉴로모픽 프로세싱 유닛(NPU)에 대해 알게 되었습니다. 이 NPU는 양자 컴퓨팅과는 직접적인 관련은 없지만, 새로운 프로세싱 아키텍처에서 영감을 얻는 것도 흥미로울 것 같았습니다. 마침 이 분야의 선두 IC 제조사 중 하나인 네덜란드 회사 이네이트라(Innatera)의 최신 IC인 펄서(Pulsar)는 저전력 스파이킹 뉴럴 네트워크(Spiking Neural Networks, 오른쪽 그림 참조)를 기반으로 합니다.
이 메모에서는 뉴로모픽 IC의 아키텍처, 스파이킹 신경망의 설계 방식, 그리고 이러한 장치를 프로그래밍하는 데 사용되는 소프트웨어 스택에 대한 정보를 최대한 많이 역설계해 보려고 합니다.
하드웨어 아키텍처 Link to heading
본 문서는 Pulsar IC의 아키텍처 다이어그램을 다시 그려본 시도입니다(원본 이미지: 이미지, 백서(https://innatera.com/storage/app/media/Resources/Pulsar.pdf)의 내용을 보완했습니다).
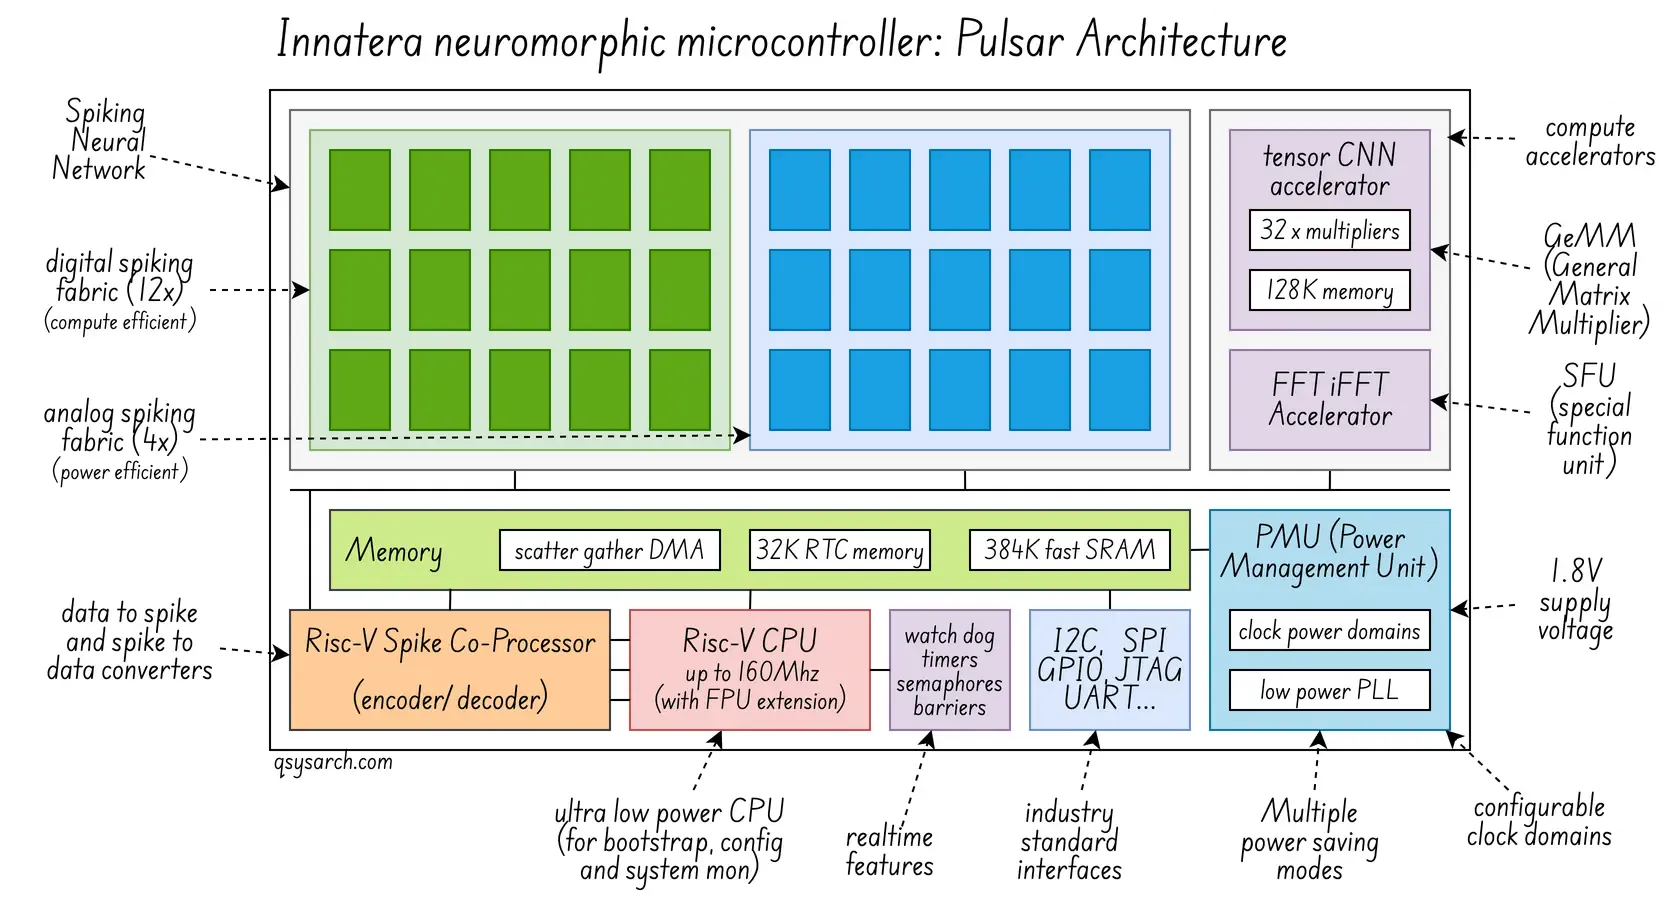
RISC-V CPU를 사용하는 아이디어는 정말 마음에 듭니다. 이는 Innatera 팀이 처음부터 올바른 아키텍처 결정을 내렸다는 분명한 증거입니다. Innatera의 이전 칩인 T1의 다이어그램 중 하나를 보면, RISC-V CPU에 F 확장(부동 소수점 연산 지원)이 포함되어 있습니다.
이 IC는 SPI, I2C 등 여러 표준 인터페이스와 “절전 모드” 또는 “전력 절약 모드"에 진입할 때 IC의 일부 기능을 켜고 끄는 전력 관리 장치(PMU)를 통합하고 있습니다. 하지만 실제 전력 소비량에 대한 자료는 찾을 수 없었고, 단지 “1mW 미만"이라는 정보만 있었습니다. 1.8V의 공급 전압을 가정하면 500µA 미만(I=W/V)이 될 것입니다. 또한 “주기당” 전력 소비량도 관련이 있는지 궁금합니다. 이 경우 100Hz 주파수(시냅스 업데이트 주기)를 가정하면 시냅스 업데이트당 평균 5µA가 소모될 것입니다.
Pulsar의 최신 다이어그램에는 CNN과 FFT라는 두 개의 가속기가 나와 있습니다. 제 생각에는 이들을 GEMM(일반 행렬 곱셈기, 신경망 연산의 핵심)과 SFU(특수 기능 장치, FFT 연산 가속에 사용)로 더 넓게 설명할 수 있을 것 같습니다. GPU 아키텍처에 대한 자세한 내용은 게시글을 참조하세요. 또한 RISC-V용 코프로세서로 개발된 것으로 보이는 스파이크 인코더-디코더도 있지만, 자세한 정보는 찾을 수 없었습니다.
스파이킹 신경망 아키텍처 Link to heading
남은 질문은 스파이킹 신경망(Spinking Neural Network, SNN)이 어떻게 작동하는가 하는 것입니다.
은유 Link to heading
저는 Gemini에 8살 아이가 이해할 수 있는 스파이킹 신경망에 대한 비유를 요청했습니다. 다음은 제가 받은 이야기입니다.
뇌를 거대한 우체국이라고 상상해 보세요. 그리고 “뉴런"은 쪽지를 전달하는 작은 전령과 같습니다.
- 메신저 및 메모:
일반적인 컴퓨터 프로그램에서는 모든 전달자가 끊임없이 숫자를 주고받으며 소리를 지릅니다. 하지만 스파이킹 신경망에서는 전달자들이 매우 조용하고 에너지 효율적입니다. 아주 작은 전기 스파이크처럼 중요한 일이 발생했을 때만 “이봐!“라는 짧은 메시지를 보냅니다.
- 스파크 미터:
각 전령은 다른 전령이 “이봐!“라고 외치는 소리를 들으면 차오르는 ‘미터’를 가지고 있습니다. 미터가 충분히 차면(임계값에 도달하면) 그 전령도 흥분해서 “이봐!“라고 외칩니다. 외친 직후에는 미터가 초기화되어 바로 다시 외칠 수 없습니다(불응기).
- 타이밍이 전부다:
전령이 “이봐!“라는 외침을 빠르게 여러 번 들으면, 그 메시지는 매우 중요한 내용이라는 뜻입니다(예: “불이야!”). 만약 전령이 다른 전령들보다 조금 일찍 “이봐!“라고 외친다면, 뭔가 특별한 일이 벌어지고 있다는 비밀 신호일 수도 있습니다(예: “호랑이가 온다!”). 그러므로 전령은 시간을 잘 파악해야 합니다.
- 학습이 핵심입니다:
전령들도 여러분처럼 학습합니다. 전령 A가 전령 B가 “안녕하세요!“라고 외치기 직전에 (둘 다 흥분되는 일이 생겨서) 외치면, 둘의 우정은 더욱 돈독해지고, 전령 A의 메시지는 다음번에 전령 B가 게이지를 더 빨리 채우는 데 도움이 됩니다.
SNN은 놀라울 정도로 빠르고 효율적으로 설계되었기 때문에 특별합니다. SNN은 끊임없이 통신하며 에너지를 낭비하지 않고, 공유할 정보가 급증할 때만 활성화됩니다! SNN은 컴퓨터가 타이밍을 이해하고 패턴을 인식하는 데 도움을 주며, 전력 소모도 매우 적습니다.
숨겨진 진짜 디자인 Link to heading
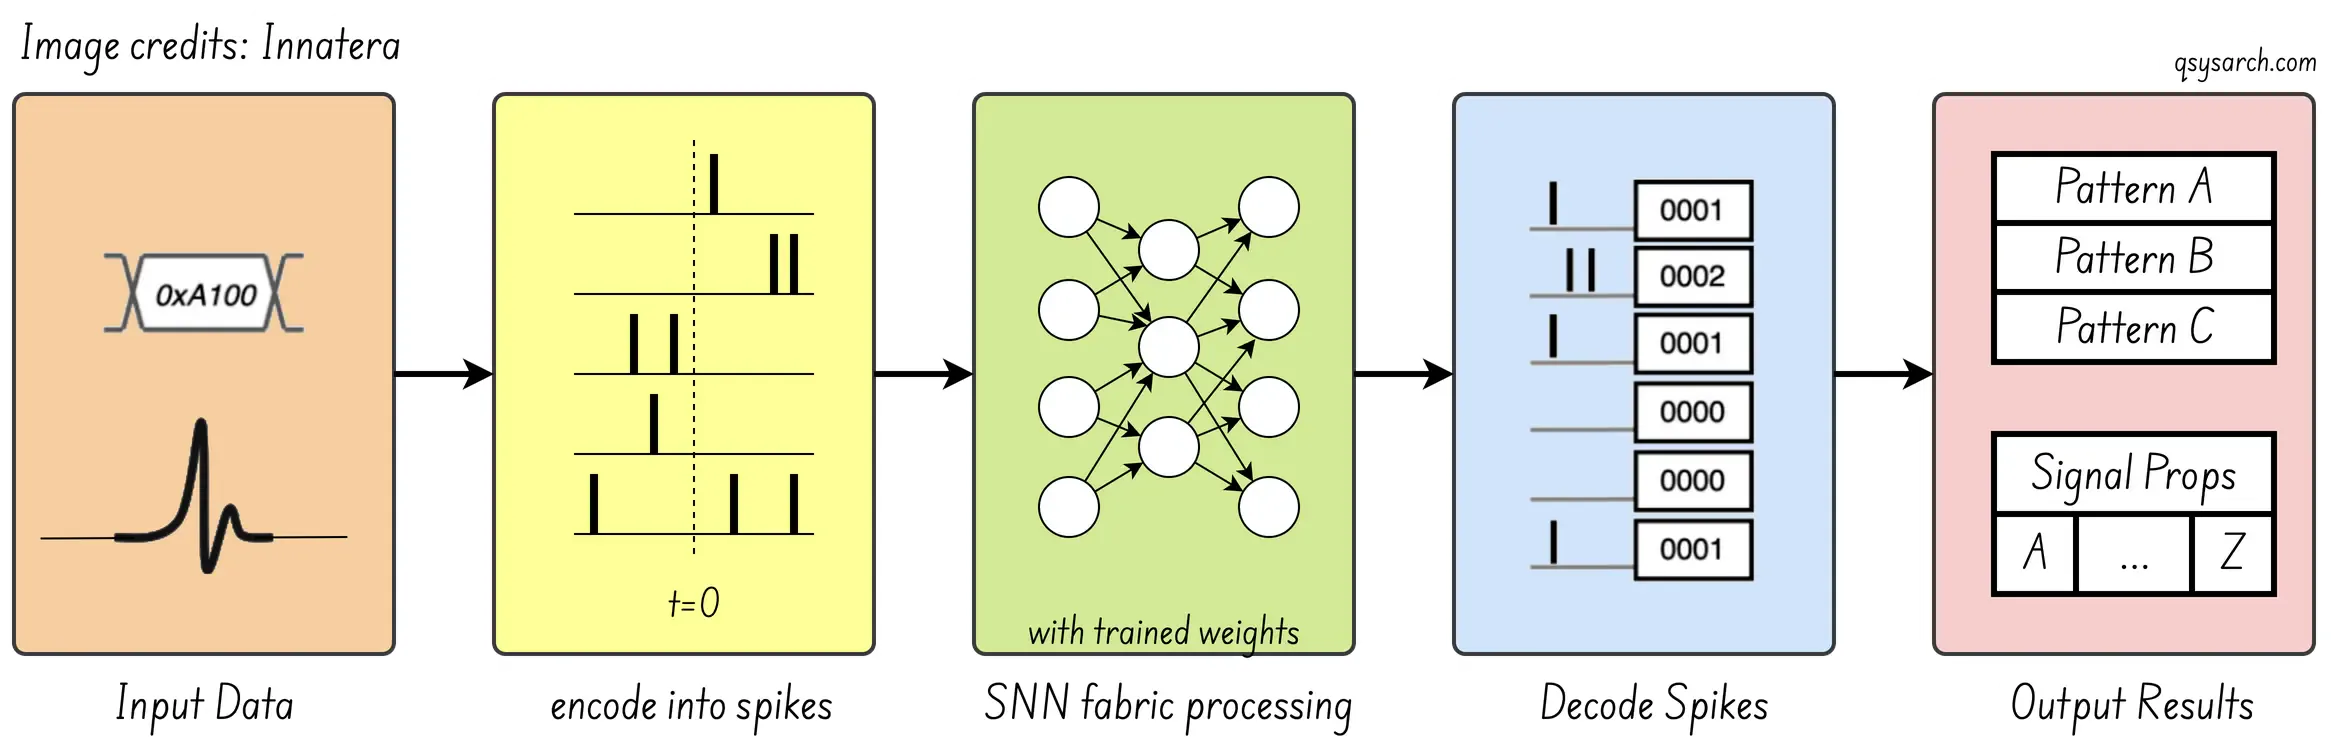
Innatera의 Thinking in Pulses 블로그는 하드웨어 구현 방식에 대한 좋은 개요를 제공합니다. “hey"를 이진 값으로 인코딩하고, 신경망을 통과시켜 특징을 추출합니다. 여기까지는 특별한 것이 없습니다. 표준적인 신경망 처리 과정입니다.
더 흥미로운 질문은 이 SNN이 어떻게 구현되는가입니다. 아래 이미지는 디지털 뉴런의 기존 “계산 모델"처럼 보입니다(이미지 출처: https://www.mdpi.com/1099-4300/27/4/333). 여기에 SOMA 내에 “누출 적분-발화(leaky integrate-and-fire, LIF)“라는 개념을 명시적으로 추가했습니다(참고 문헌: https://ieeexplore.ieee.org/abstract/document/10242251).
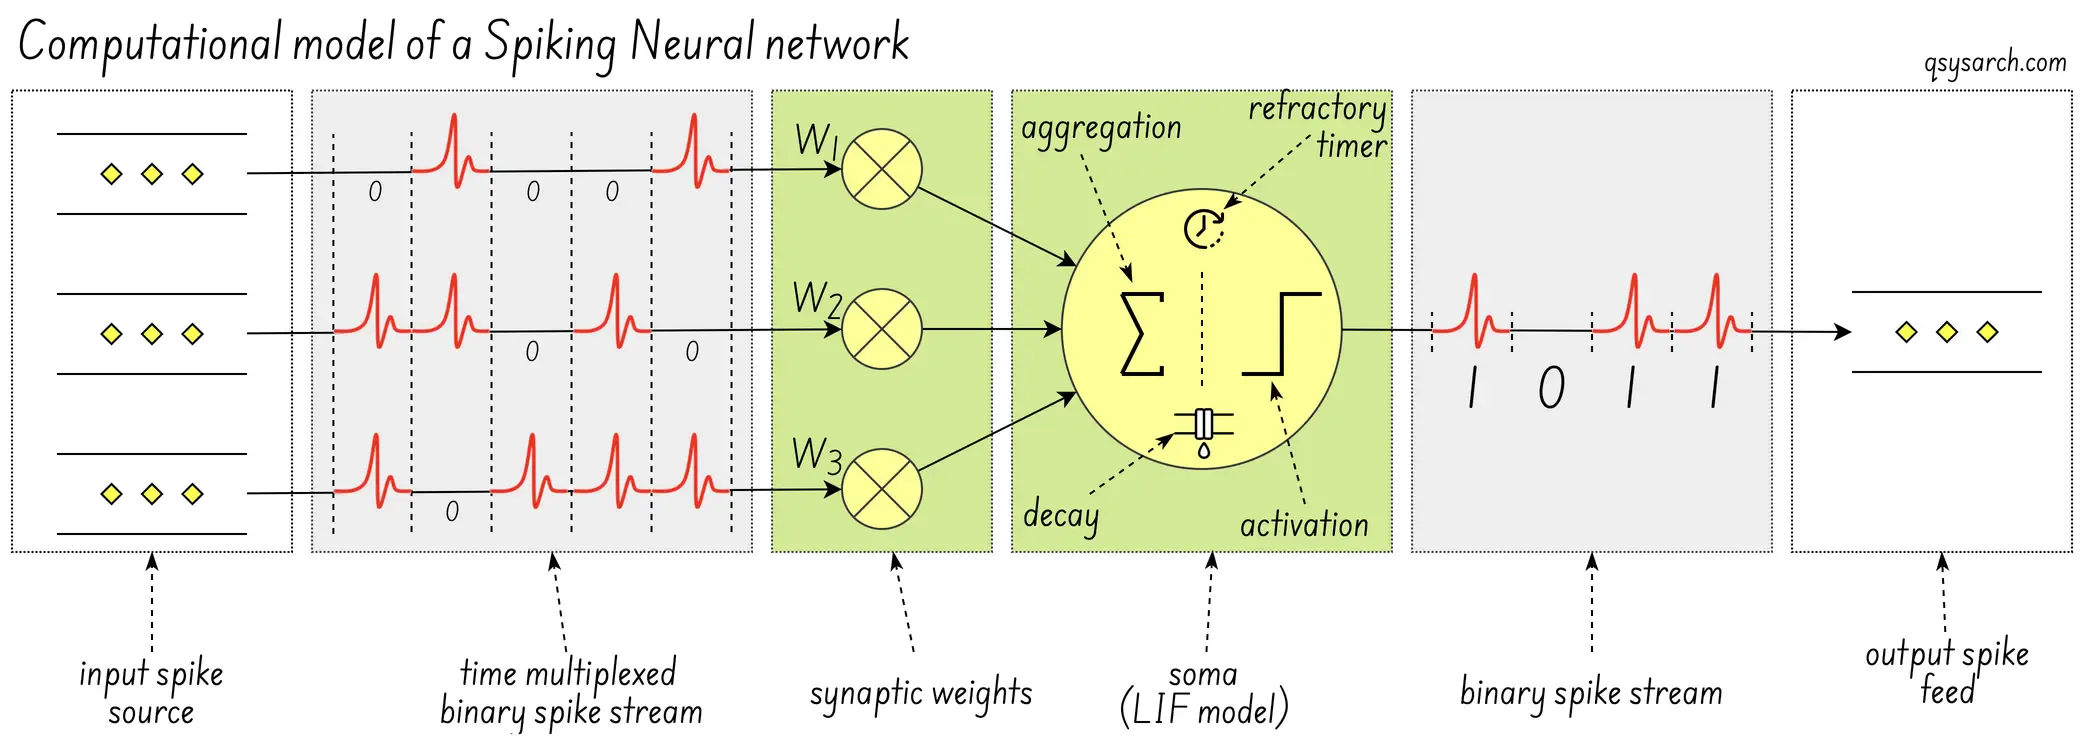
하드웨어 구현을 저전력으로 만드는 요소는 무엇일까요?
완료 예정: 다음 항목에 대한 설명이 필요합니다
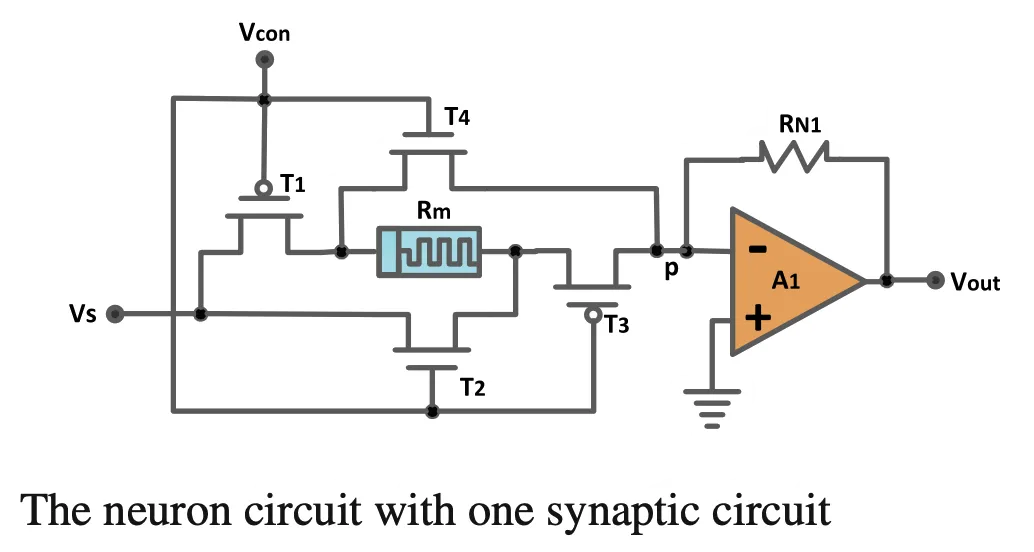
성능 향상 폭(10배, 1000배 또는 그 이상)은 어느 정도입니까?
달성 가능한 신경망 전파 지연 시간
절충점과 한계
아날로그 vs 디지털 설계 성능
GPU/TPU 대비 전력 소비량
인나테라의 핵심 디자인 Link to heading
펄서 설계에서 한 가지 의문점은 왜 SNN이 두 개나 있는가 하는 것입니다. 이에 대한 답은 이네이트라의 아날로그(독자적인 아날로그-혼합 신호) SNN 패브릭은 최대 에너지 효율과 초저전력의 빠른 이벤트 처리에 최적화되어 있기 때문입니다. 반면 디지털 SNN 패브릭은 보다 프로그래밍 가능하고 유연한 설계로, 약간 더 높은 전력 소모로 보다 다양한 구성이 가능한 네트워크를 지원합니다. (출처: https://spectrum.ieee.org/innatera-neuromorphic-chip)
Innatera 웹사이트에는 스파이킹 신경망의 내부 구조에 대한 정보가 많지 않지만, 다행히 Innatera가 보유한 몇 가지 특허를 역설계해 볼 수 있습니다!
| 제출일 | 출판 번호 | 제목 (약칭) |
| 2021년 2월 9일 | 미국20220230051A1 | 스파이킹 신경망 |
| 2021년 12월 9일 | EP4505212A1 | 효율적인 레이더 전처리 방법 |
| 2022년 1월 26일 | EP4323923B1 | 계층적 재구성 가능 다중 세그먼트 스파이킹 신경망 |
| 2022년 2월 14일 | EP4238006A2 | 분산형 다중 구성 요소 시냅스 연산 구조 |
| 2022년 3월 22일 | EP4226281B8 | 일시적 동기화를 통한 snns의 적응 |
| 2022년 4월 8일 | EP4548260A1 | 스파이킹 신경망의 보정 |
| 2022년 6월 3일 | EP4562540A | 효율적인 특징 중심 아날로그-스파이크 인코더 시스템 및 방법 |
| 2022년 6월 24일 | EP4573485A1 | 메모리 최적화 추론을 위한 순차 신경망 머신 |
| 2022년 9월 8일 | WO2024038102A1 | 재구성 가능한 모듈형 신경 시냅스 연산 시스템 및 방법… |
| 2022년 10월 18일 | WO2024153705A1 | 자체 타이밍 피드포워드 합성 가능 및 기술 확장 가능한 혼합 신호… |
| 2023년 5월 18일 | WO2024175770A1 | 상시 작동 뉴로모픽 오디오 처리 모듈 및 방법 |
| 2023년 5월 24일 | WO2024175767A1 | 신경 형태학적 아키텍처에 스파이킹 신경망을 매핑하는 시스템 및 방법… |
| 2023년 6월 19일 | WO2025012331A1 | 확률적 기질에 대한 기계 학습 모델 훈련 방법 |
| 2023년 6월 22일 | WO2025017094A1 | 하드웨어 장치에 스파이킹 신경망을 구축하고 배포하는 방법 |
| 2023년 10월 23일 | WO2025021573A1 | 프레임 기반 센서를 이용한 점유 감지 시스템 및 방법 |
| 2023년 12월 6일 | WO2025062034A1 | 합성곱 알고리즘을 이용한 스파이킹 신경망의 특징 추출 및 인코딩 |
| 2024년 3월 8일 | WO2023242374A1 | 스파이크 인터커넥트 온칩 단일 패킷 멀티캐스트 |
스타트업치고는 특허가 상당히 많네요! 시간 관계상 목록에서 첫 번째와 마지막 특허만 살펴봤습니다.
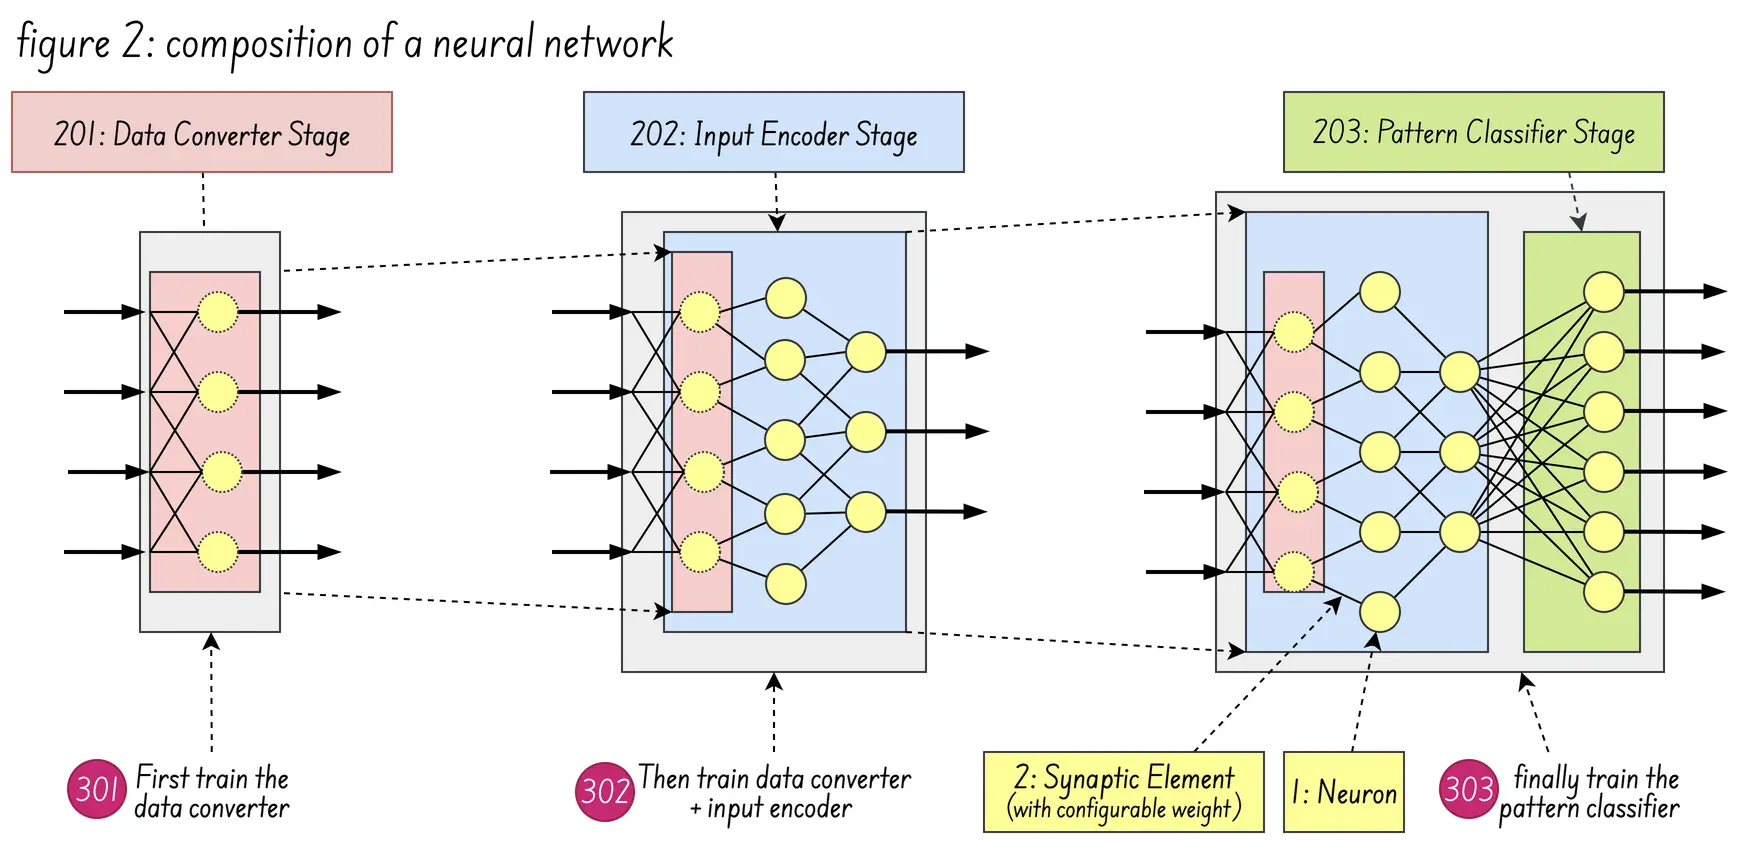
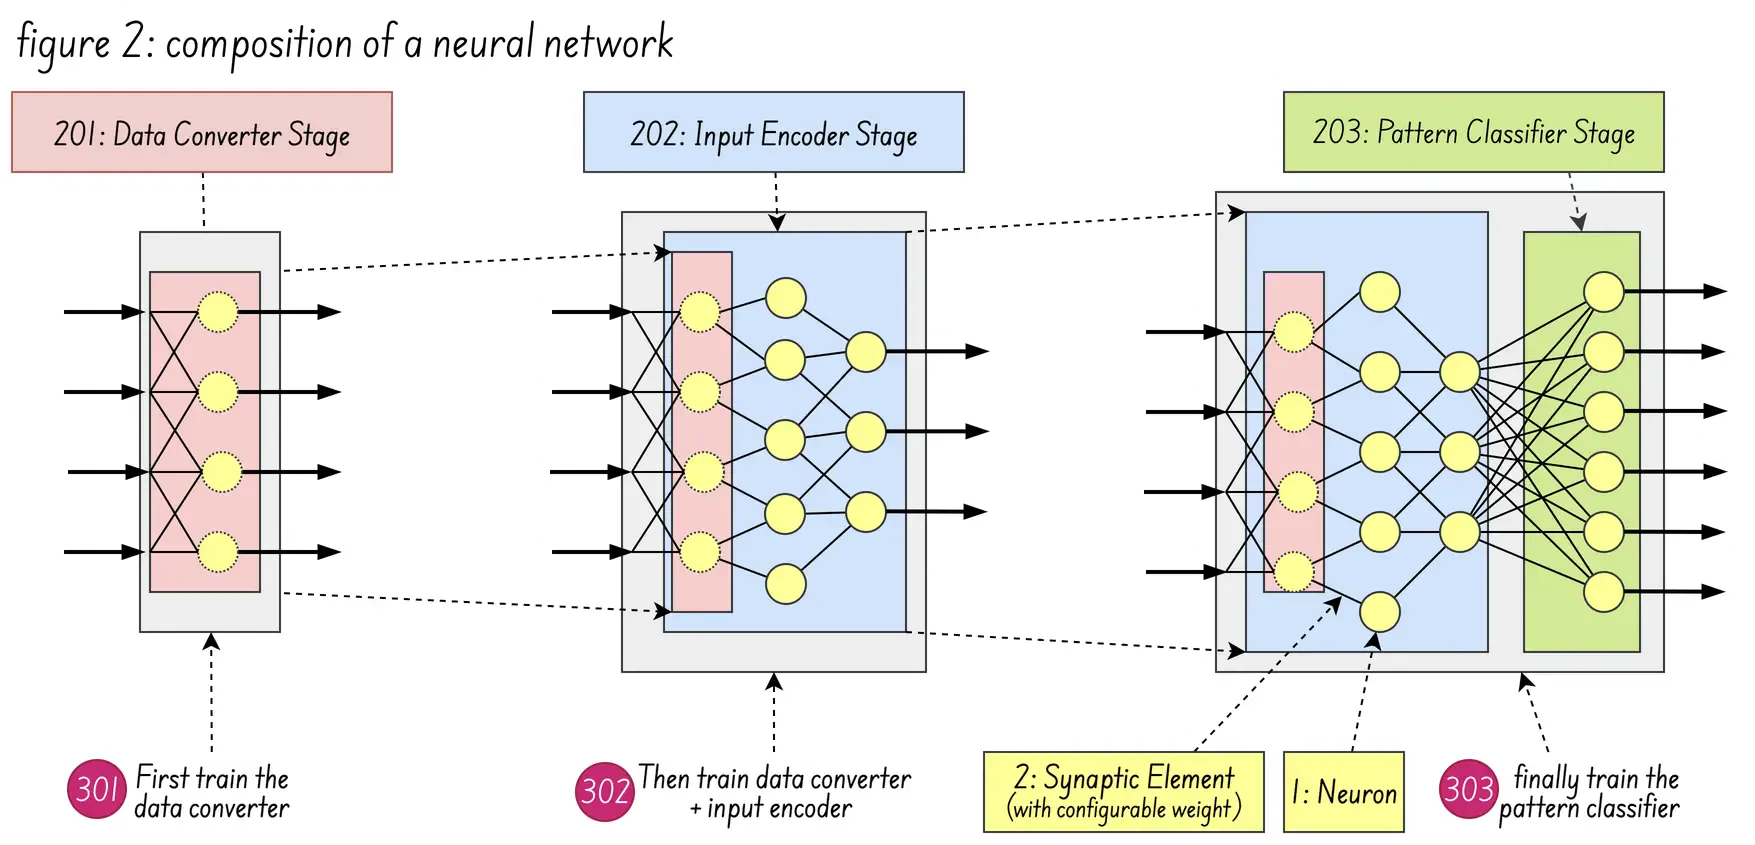
먼저 SNN의 실제 하드웨어 구현을 가장 잘 설명하는 것으로 보이는 첫 번째 특허 US20220230051A1부터 살펴보겠습니다. 이 특허는 “고유 응답” 원칙을 사용하여 특수화된 사전 학습된 하위 네트워크(“셀”)로부터 SNN을 구축하는 구성 방법론에 중점을 두고 있습니다.
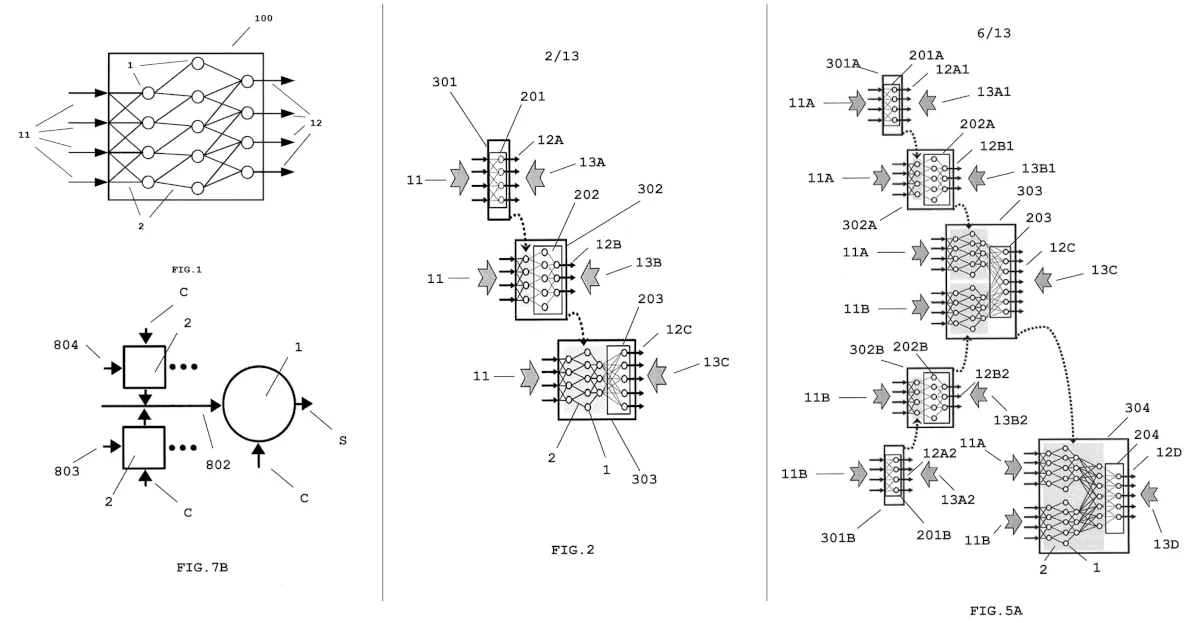
그림 2(아래)는 데이터 변환 단계 201, 입력 인코더 단계 202, 패턴 분류기 단계 203의 통합으로 구성된 신경망의 구성을 보여줍니다. 그림 5B(위)는 여러 개의 시간적 스파이크 열이 하나의 융합된 스파이크 열로 융합되는 방식을 보여줍니다.
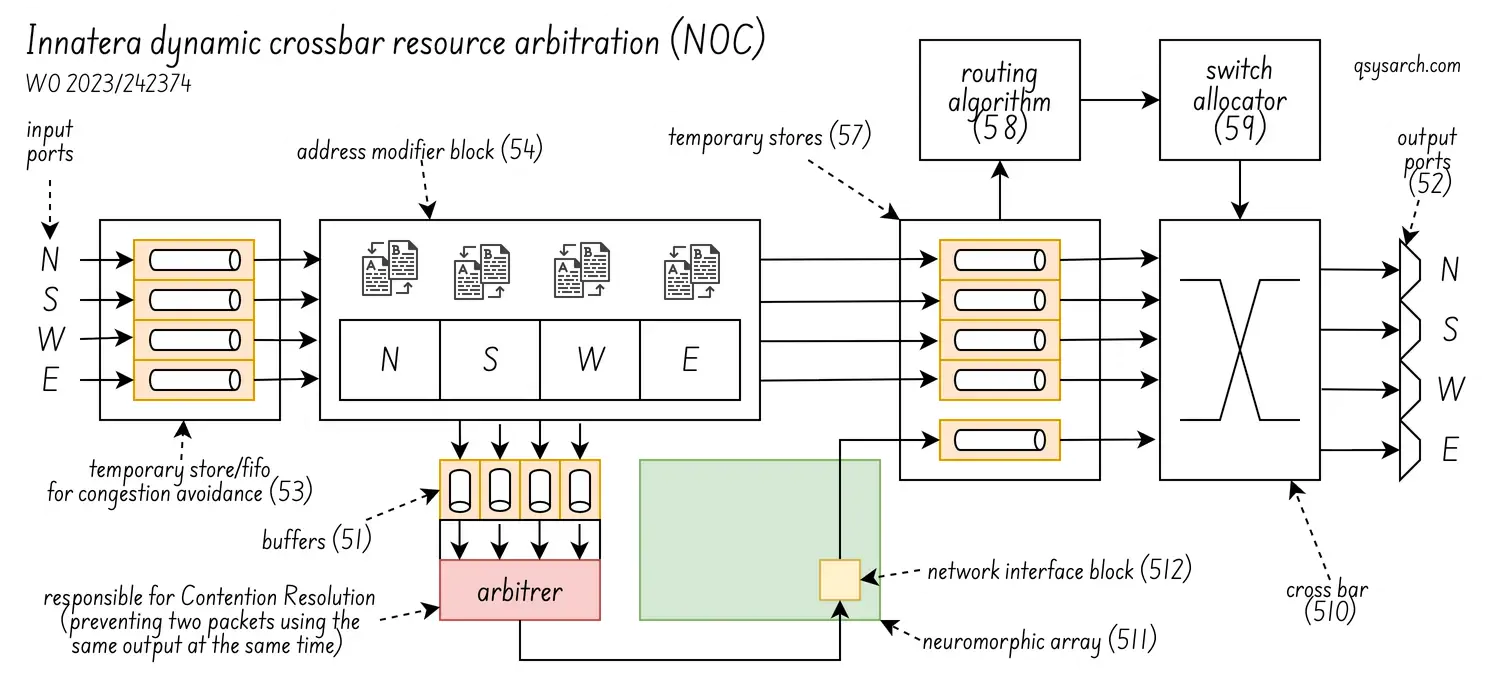
마지막 특허 WO2023242374A1는 Innatera의 _스파이킹 신경망 아키텍처_를 공개하고 있으며, 이는 네트워크 온 칩(NOC) 네트워크를 사용하여 단일 패킷 멀티캐스트를 효율적으로 구현하는 데 사용됩니다. 목표는 멀티코어/매니코어 시스템에서 멀티캐스트 통신 시 중복, 지연 및 오버헤드를 줄이는 것입니다.
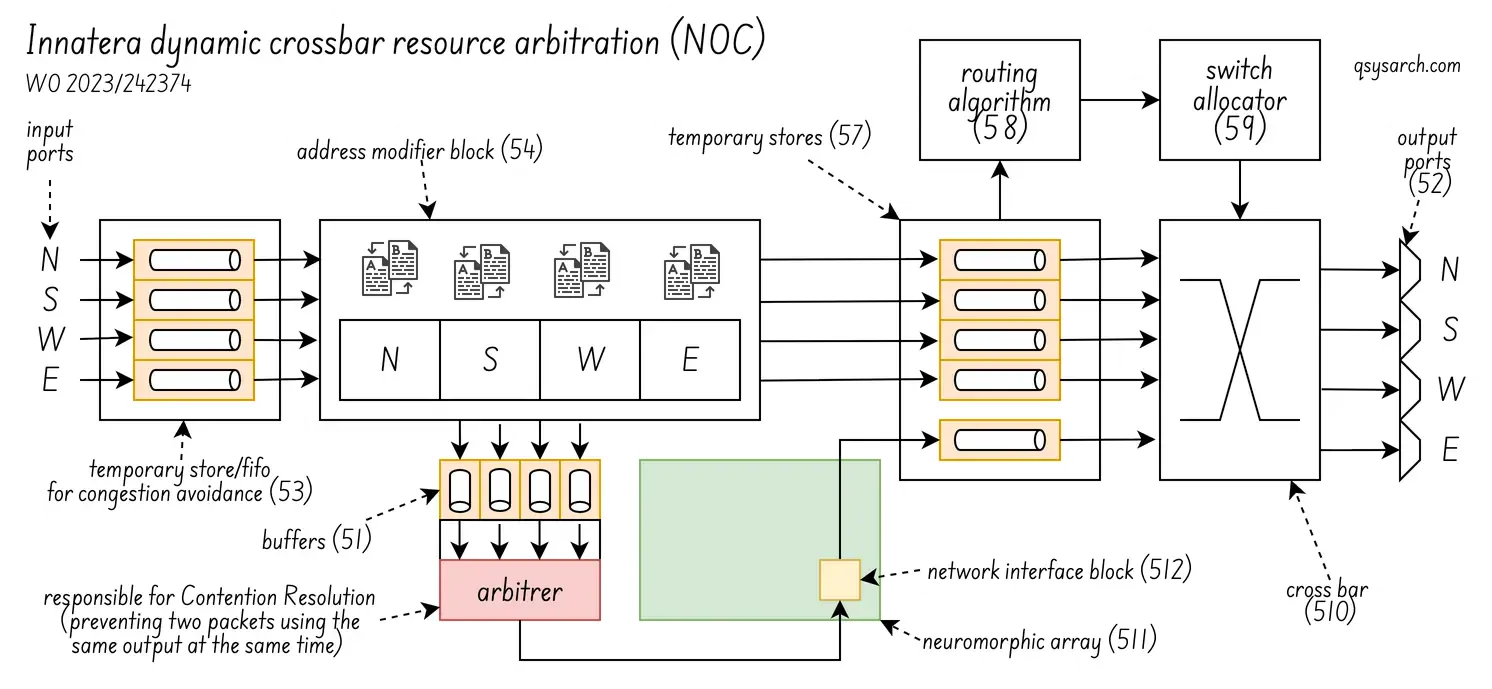
아래 그림(특허 문서의 그림 5)은 NOC 중재 방식이 어떻게 작동하는지 보여줍니다. 이 방식의 핵심은 두 개 이상의 스파이크가 동시에 동일한 출력 포트로 전송되는 것을 방지하는 것입니다. 이는 각 사이클마다 스파이크를 효율적으로 라우팅하는 방법입니다. 다만, 실제 하드웨어에서 FIFO가 얼마나 깊숙이 구현되어 있는지 궁금합니다. 특허 WO2023242374A1, 그림 5: Innatera 동적 크로스바 리소스 중재(NOC)
제가 잘 이해하지 못하는 부분은 코어와 스파이크 네트워크가 어떻게 연결되는지입니다. 코어에는 몇 개의 뉴런이 있나요? 코어는 서로 연결되어 있거나 함께 작동하는 건가요? 아니면 각각 독립적인 단위로서 병렬적으로 분류 작업을 처리하는 건가요?
기타 뉴럴 코어 디자인 Link to heading
저는 Innera의 정확한 핵심 아키텍처에 대한 답을 가지고 있지 않지만, 가능한 구현 방식에 대한 자세한 내용을 제공하는 연구 논문들이 많이 있습니다. 특히 “뉴로모픽 컴퓨터 프로세서에 대한 시스템 설계 관점"이라는 논문(https://iopscience.iop.org/article/10.1088/2634-4386/ac24f5/pdf)은 여러 아키텍처를 비교하고 있어 흥미롭습니다.
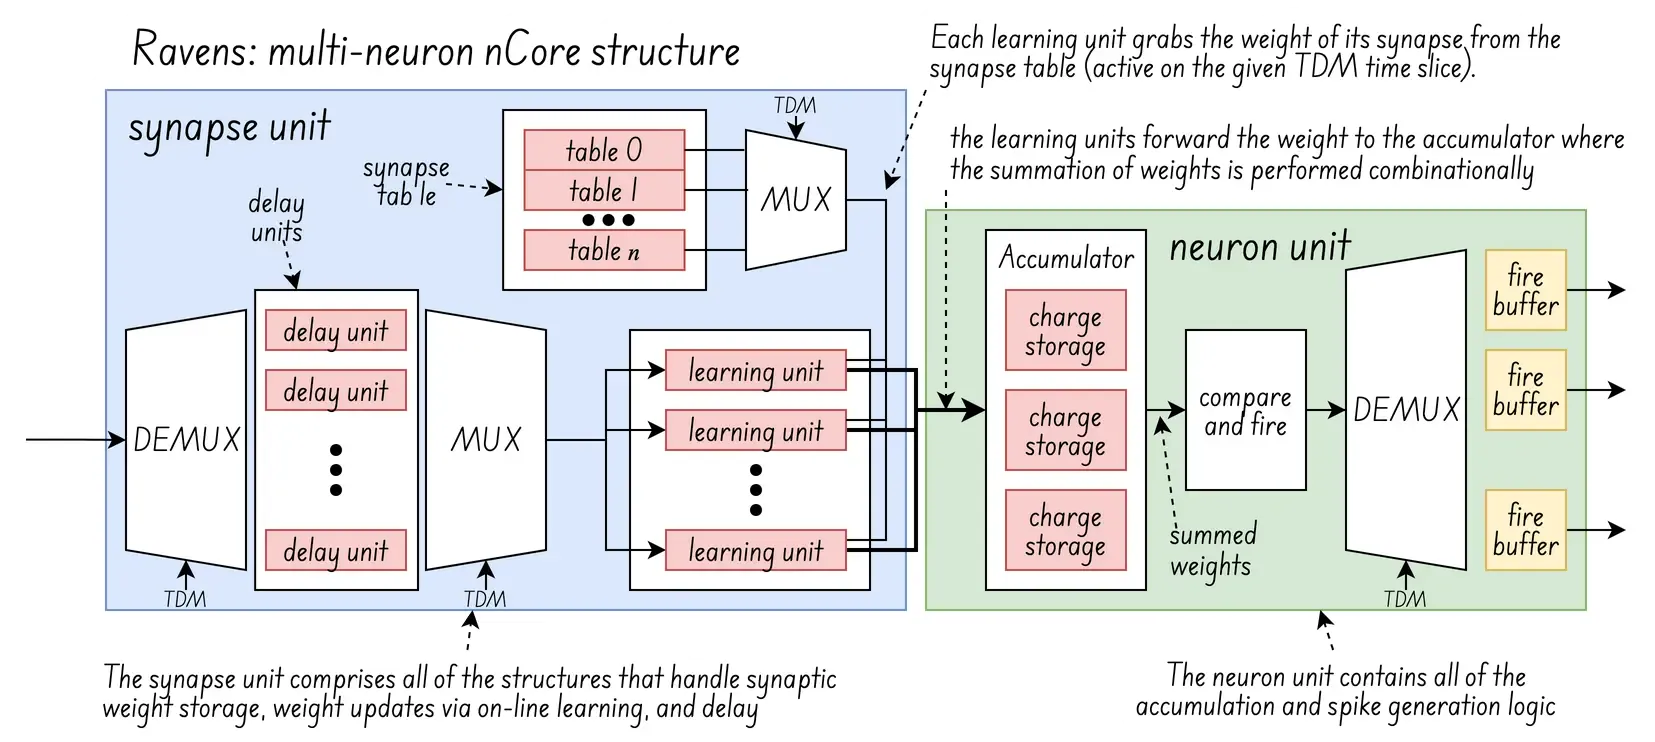
그러한 아키텍처 중 하나가 바로 아래 다이어그램에 나와 있는 “재구성 가능하고 매우 효율적인 뉴로모픽 시스템”, 즉 RAVENS입니다.
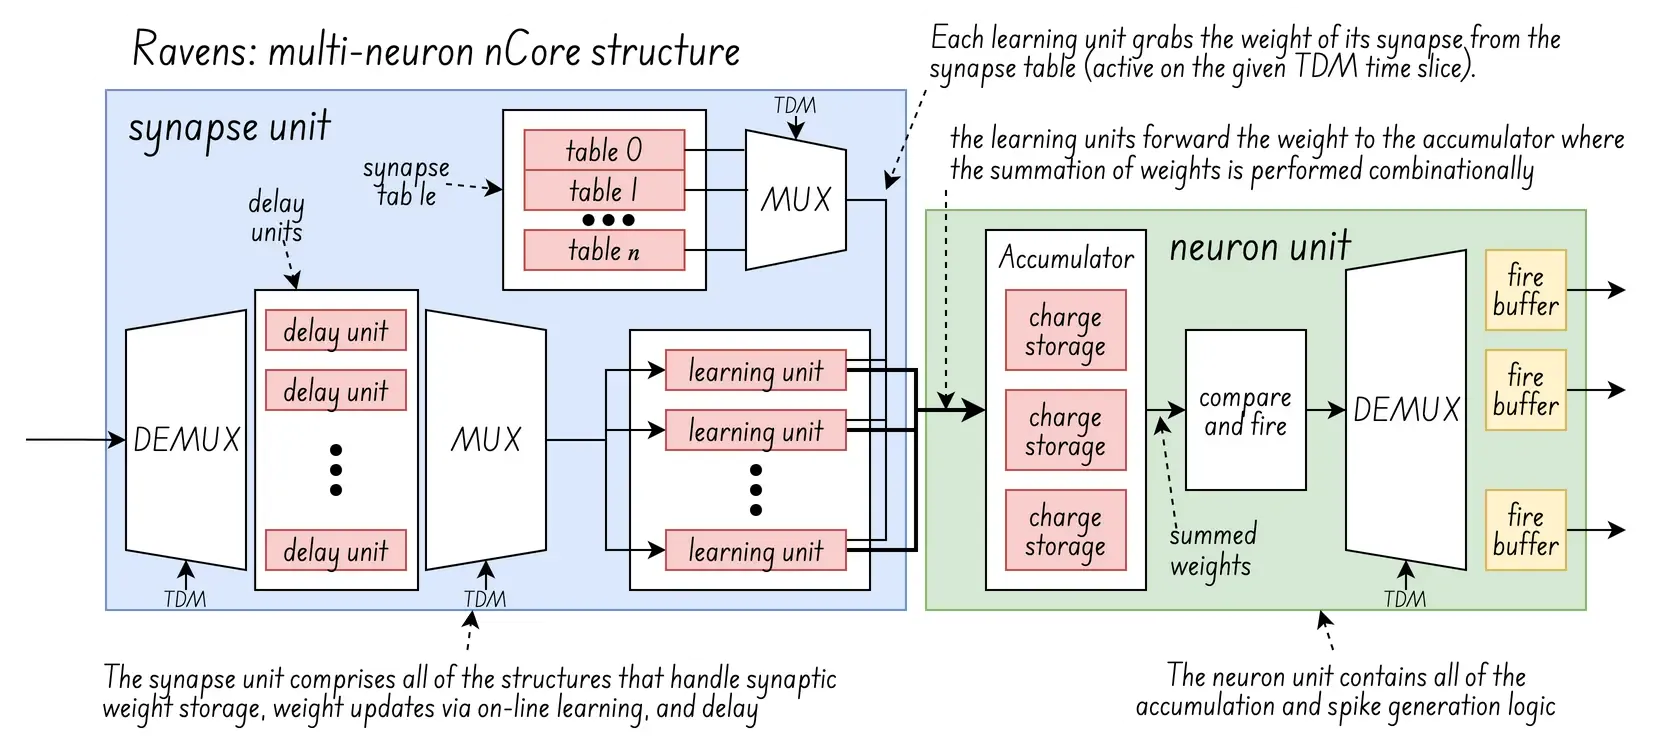 (원본 이미지에서 업데이트된 다이어그램:
RAVENS의 핵심 아이디어는 시분할 다중화(TDM)를 사용하여 여러 “가상 뉴런"을 누적 및 업데이트의 2단계 프로세스로 파이프라인화하는 것입니다.
축적 단계: 뉴런은 연결된 입력 시냅스로부터 전하를 축적하고, 프로그램된 임계값과 불응기 상태를 기반으로 발화 이벤트가 발생할지 여부를 결정합니다.
업데이트 단계: 시냅스 가중치의 온라인 학습 변화, 누출 전하, 불응기 카운터 증가, 불응기 종료로 인한 누적 전하 변화 등을 포함합니다.
여기서 흥미로운 부분은 온라인 학습입니다. 뉴로모픽 IC에서 온라인 학습은 헤비안 학습이나 강화 학습과 같은 알고리즘을 사용하여 시냅스 가중치를 변경하고, 시냅스 전후 뉴런의 입력에 따라 실시간으로 시냅스 강도를 조절합니다.
아날로그 코어의 경우, 이러한 조정은 멤리스터나 자기 터널 접합(MTJ)과 같은 소자를 통해 물리적으로 구현됩니다. 이러한 소자의 저항 또는 전도도 상태는 신경 활동에 의해 변조되어 시냅스 가중치를 직접적으로 표현하고 저장합니다. 디지털 코어의 경우, 적어도 RAVENS의 경우에는 시냅스 테이블을 통해 이러한 조정이 이루어집니다.
소프트웨어 스택: TALAMO Link to heading
상위 레벨 스택 Link to heading
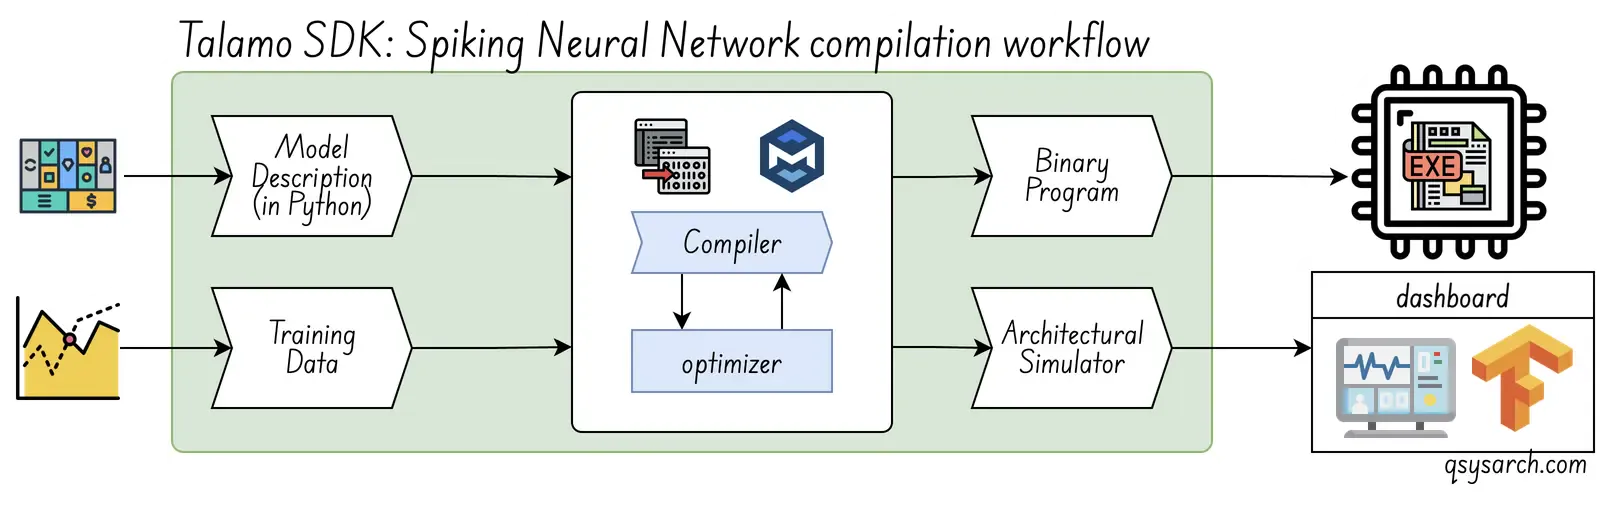
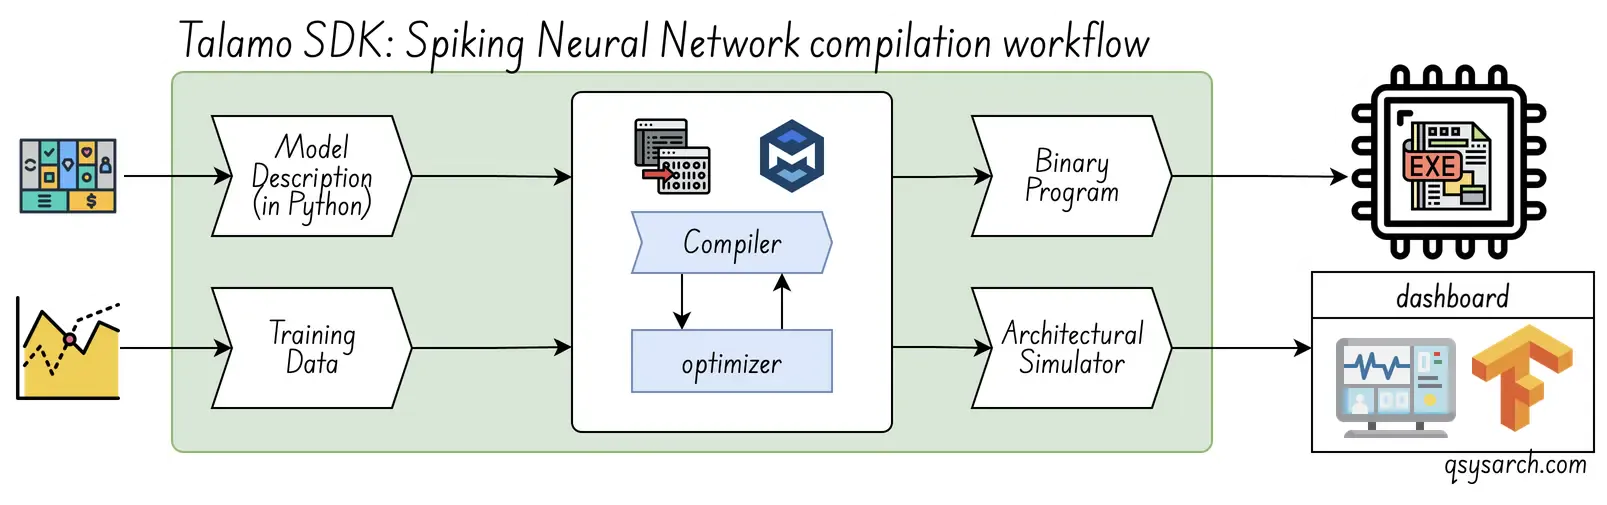
Innatera의 제품에는 SNN 전문 지식이 필요 없고, 엔드투엔드 애플리케이션을 지원하며, 표준 딥러닝 워크플로를 사용하는 Talamo SDK가 포함되어 있습니다. Talamo 키트를 사용하면 개발자는 PyTorch 기반 환경에서 스파이킹 모델을 처음부터 구축할 수 있습니다. 마치 배터리가 포함된 것처럼 모든 기능이 제공됩니다.
컴파일 워크플로는 매우 표준적입니다. 아래 다이어그램은 Innatera의 원본 자료를 약간 업데이트한 버전으로, 워크플로의 핵심 부분이 컴파일러라고 가정합니다. 시뮬레이터가 바이너리 실행 파일을 입력으로 받는지 궁금합니다. 만약 그렇다면 에뮬레이터라고 부를 수 있을 것입니다. 최적화 프로세스와 사용자가 조정할 수 있는 매개변수(예: 가중치를 1.58 비트로 줄이는 것)에 대한 자세한 정보가 있으면 좋을 것 같습니다.
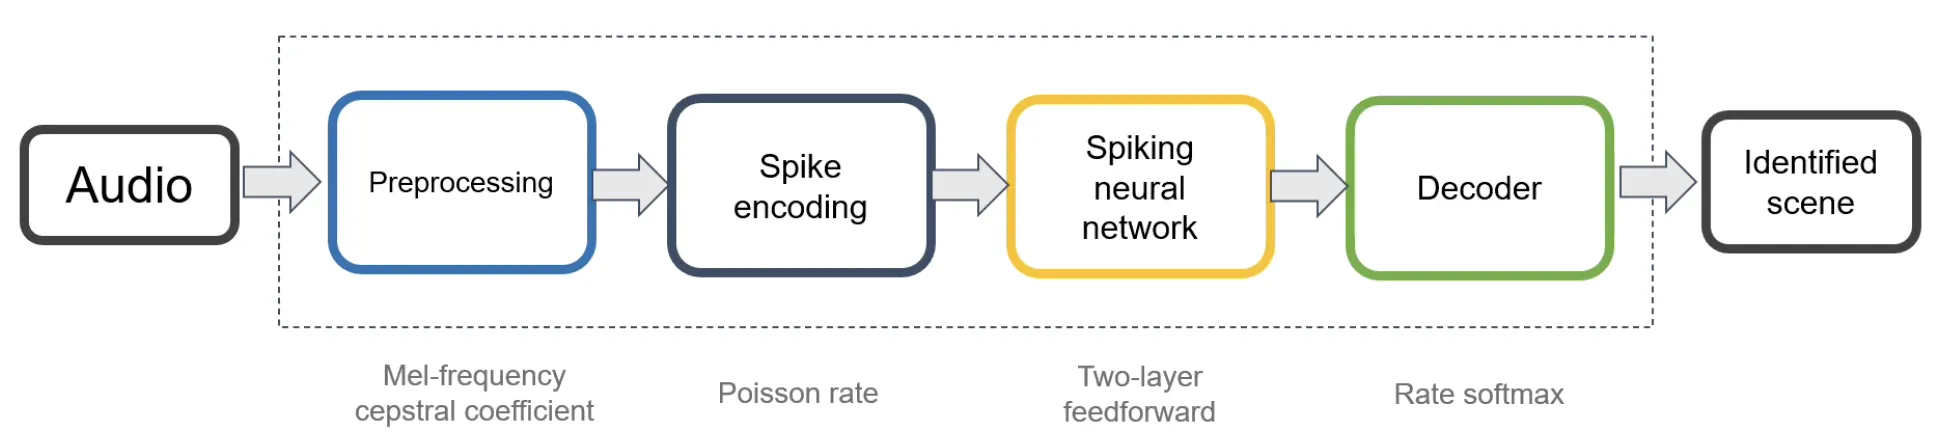
바이너리 프로그램이 생성되면 이 실행 워크플로가 사용되며, 이는 특허 WO2023242374A1에 정의된 프로세스를 거의 따릅니다.
저수준 스택 Link to heading
Innatera의 하드웨어에는 강력한 RISC-V, 뛰어난 GEM, 그리고 SFU 컴퓨팅 가속기가 포함되어 있습니다. 일부 고급 사용자는 Innatera 아키텍처에 맞춰 C 라이브러리에 가중치를 로드하는 것보다 이러한 하드웨어에 직접 접근하는 것이 더 매력적이라고 생각할 수 있습니다.
오픈소스 펌웨어 SDK 형태를 제공하는 것이 도움이 될 수도 있습니다. 또는 양자 컴퓨팅 산업에서 Cuda-Q가 존재하는 것처럼, 범용 신경 처리 장치(GPNPU) 경험을 제공하는 _CudaNN_을 생각해 볼 수도 있습니다. 또한 대규모 NPU 네트워크 및 하이브리드 아키텍처를 지원하는 NVQLink와 유사한 NVNLink를 개발하는 것도 고려해 볼 만합니다.
아마도 이것이 네이처(Nature)의 “뉴로모픽 기술의 상업적 성공으로 가는 길”[https://www.nature.com/articles/s41467-025-57352-1]에서 말하는 의미일 것입니다. “간단한 프로그래밍 모델과 도구가 등장하고 하드웨어에 대한 직관적인 API 접근이 가능해지면서 비로소 텐서 프로세서가 널리 보급될 수 있었습니다.” 여기서 텐서 프로세서를 뉴로모픽 처리 장치(NPU)로 바꾸면 되는 것일까요?
제 생각에 이는 사용자 경험(UX)과 개발자 경험(DX)으로 귀결됩니다. 저는 사용 편의성과 개발자 경험이 진정으로 뛰어난 제품 경험을 창출하는 데 있어 핵심적인 요소, 즉 전략적 기둥이라고 굳게 믿습니다.
 (이미지 출처: archi monarch)
결론 Link to heading
이것으로 뉴로모픽 IC의 고수준 아키텍처에 대한 간략한 설명을 마치겠습니다. 이 하드웨어 아키텍처는 의심할 여지 없이 상당한 잠재력을 지닌 강력한 대안 기술입니다. 하지만 뉴로모픽 IC에는 아직 킬러 애플리케이션이 없다는 의견도 있을 수 있습니다. 그러나 바로 그 점이 뉴로모픽 IC의 흥미로운 부분이 아닐까요? 그렇다면 앞으로 펼쳐질 새로운 세상은 아직 만들어지지 않은 것일까요?
저는 이네테라 팀이 “세상을 다르게 보는 사람들” 중 하나라고 생각합니다. AI 데이터 센터의 엄청난 전력 소비에 대한 우려가 커지는 가운데, 뉴로모픽 IC는 “어떻게 하면 적은 에너지로 더 많은 가치를 얻을 수 있을까?“라는 근본적인 질문에 대한 해답이 될 수 있지 않을까요? 만약 그렇다면, AI 데이터 센터에 필요한 수준의 연산 능력을 갖추도록 뉴로모픽 IC를 확장하려면 무엇이 필요할까요?
또한, SNN에 실리콘 포토닉스(https://prucnal.princeton.edu/research/photonic-spiking-neural-networks)를 조금 추가하는 것이 도움이 될지 궁금합니다. 신경 연산 자체를 위해서도, SNN IC들 간의 대규모 상호 연결 네트워크를 구축하는 데에도 도움이 될 수 있을 것 같습니다.
References Link to heading
- A Multi-Context Neural Core Design for Reconfigurable Neuromorphic Arrays
- Low-latency hierarchical routing of reconfigurable neuromorphic systems
- Mosaic: in-memory computing and routing for small-world spike-based neuromorphic systems
- Neuromorphic Computing in the Netherlands
- Neuromorphic Computing: Energy-efficient smart chip design
- Development of a Neuromorphic Computing System
- TrueNorth: A Deep Dive Into IBM’s Neuromorphic Chip Design
- The road to commercial success for neuromorphic technologies
- A system design perspective on neuromorphic computer processors
- Rapidly develop and deploy next-generation neuromorphic AI
- Integrated platforms and techniques for photonic neural networks
- Photonic Spiking Neural Networks
- Matrix Core Programming on AMD architecture
- Neuromorphic Computing Group; Brain-Inspired Systems at UC Santa Cruz
DrawIO diagrams used in this memo: