이 메모는 RDMA의 내부 작동 방식, 특히 DGX Spark에 통합된 200Gb connectX-7(오른쪽 그림 참조)과 같은 PCIe 서브시스템과 상호 연결되는 “RDMA 호환 NIC"를 만드는 데 필요한 사항을 이해하는 것을 목표로 합니다.
RDMA는 “클라이언트 서버” 프로토콜입니다. Link to heading
이 메모는 RDMA 프로토콜에 대한 개요부터 시작하겠습니다.
RDMA 설정 Link to heading
RDMA 데이터 채널을 설정할 때 메모리 버퍼를 사용하기 전에 네트워크 카드에 등록해야 합니다. 등록 과정은 다음과 같은 단계로 구성됩니다.
운영체제에 의해 메모리가 교체되지 않도록 고정합니다.
주소 변환 정보를 NIC에 저장합니다.
메모리 영역에 대한 권한을 설정합니다.
NIC가 RDMA 명령어를 실행할 때 사용하는 원격 키와 로컬 키를 생성합니다.
RDMA 큐 쌍 Link to heading
RDMA 통신은 세 개의 큐를 기반으로 합니다.
SQ: 전송 대기열RQ: 수신 큐CQ: 완료 대기열
RDMA 큐 쌍, 또는 ‘QP’는 송신 큐와 수신 큐를 의미합니다.
RDMA 작업 큐 요소 Link to heading
애플리케이션은 작업 요청(작업 큐 요소, WQE라고도 함)을 사용하여 작업을 발행합니다. 작업 요청은 버퍼에 대한 포인터를 포함하는 작은 구조체입니다.
전송 큐에서 – 전송될 메시지를 가리키는 포인터입니다.
수신 대기열 – 수신 메시지가 배치될 위치를 나타냅니다.
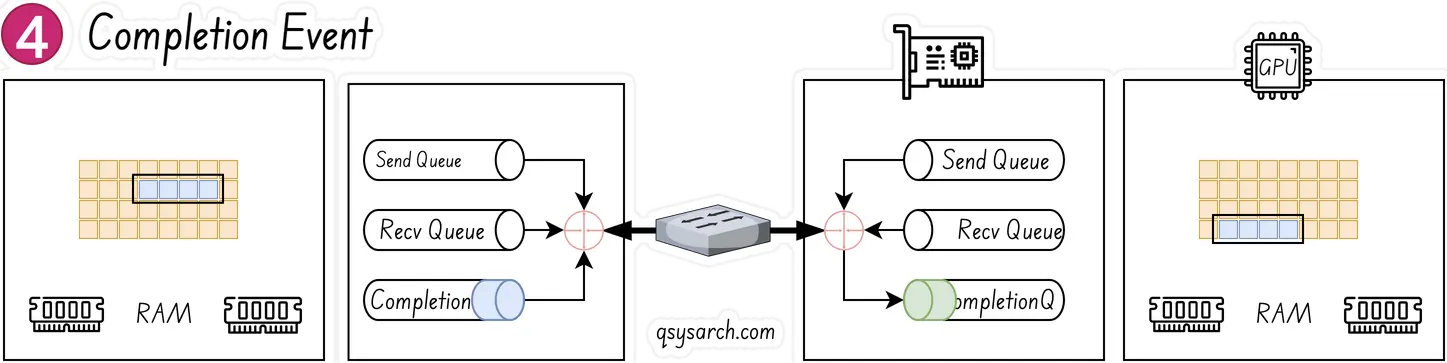
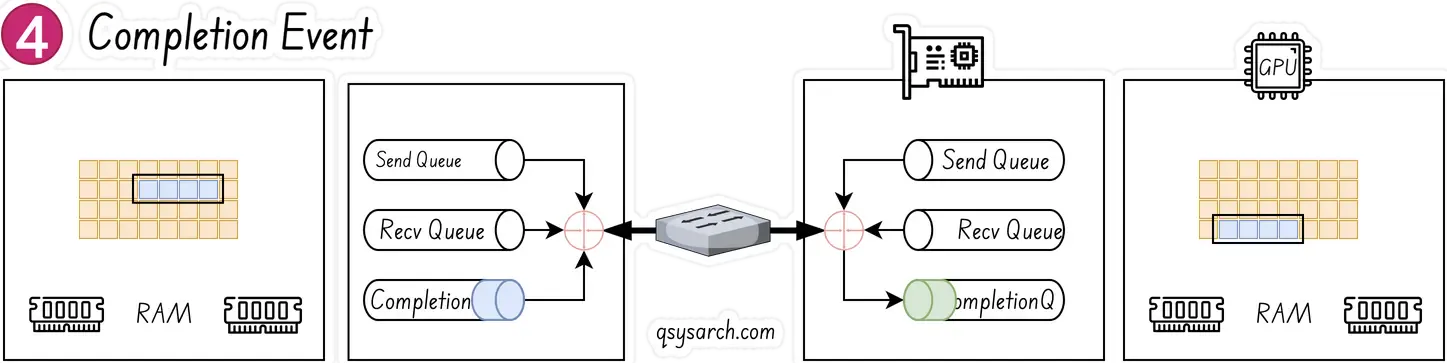
작업 요청이 완료되면 어댑터는 완료 큐 요소를 생성하고 이를 완료 큐에 추가합니다.
간단한 RDMA 쓰기 예제 Link to heading
송신자(왼쪽)와 수신자(오른쪽)는 큐 쌍과 완료 큐를 생성하고 RDMA 전송을 위해 메모리 영역을 등록했습니다. 송신자는 수신자에게 전송할 버퍼를 지정합니다. 수신자는 데이터를 저장할 빈 버퍼를 할당받습니다.
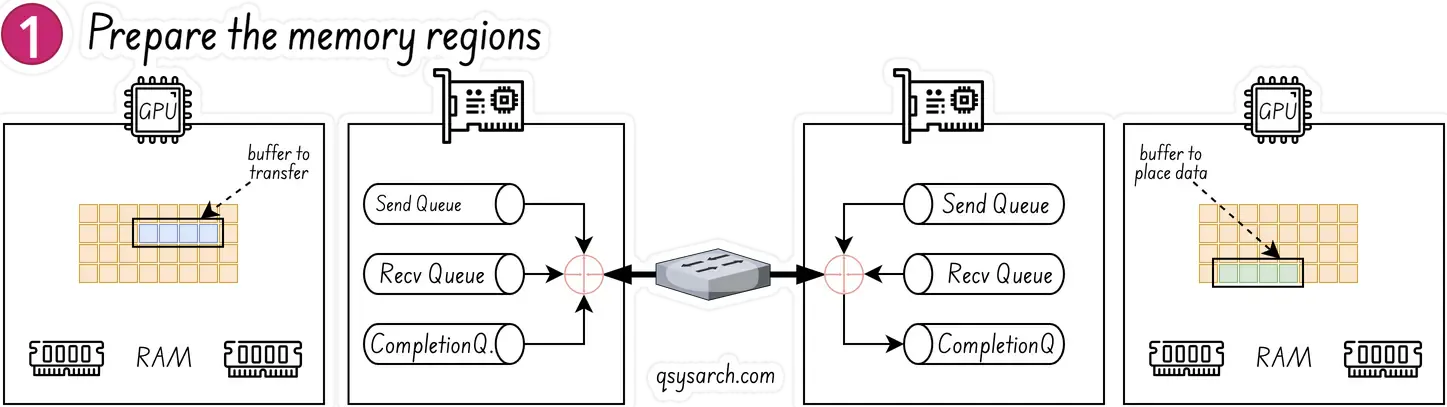
오른쪽에 있는 수신 측은 작업 큐 요소 WQE _WOOKIE_를 생성하여 수신 큐에 추가합니다. 이 WQE에는 데이터가 저장될 메모리 버퍼에 대한 포인터가 포함되어 있습니다. 왼쪽에 있는 송신 측도 전송할 데이터가 저장될 메모리 버퍼를 가리키는 WQE를 생성합니다.
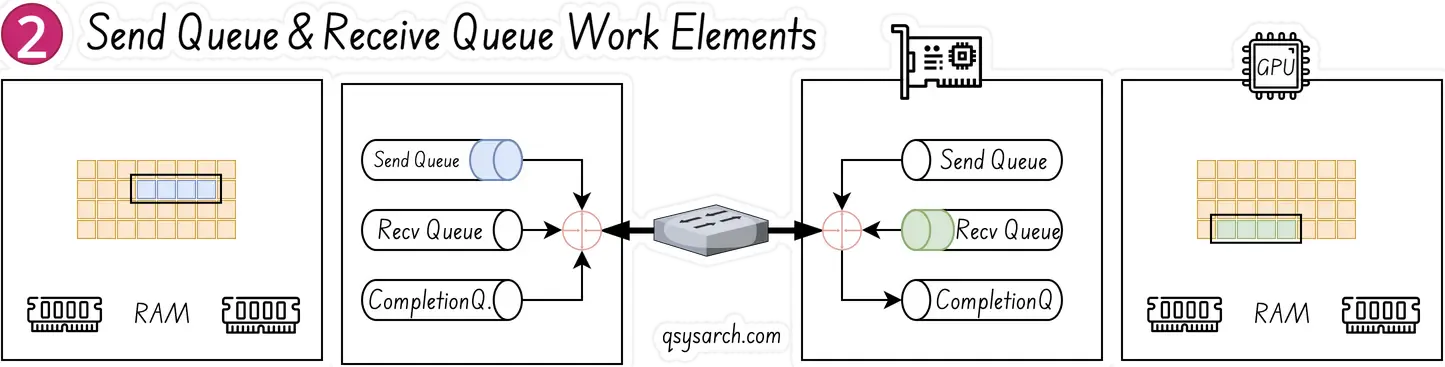
NIC(RDMA 호환 하드웨어 NIC, 즉 RNIC)는 송신 큐에서 WQE(Working Quality Enhancement)를 지속적으로 폴링하고 찾습니다. 이 과정은 GPU와 CPU의 개입 없이 RNIC에서만 수행됩니다. CPU에서 WQE가 전송되면 RNIC는 송신 측에서 이를 처리하고 메모리 영역에서 수신 측으로 데이터를 스트리밍하기 시작합니다. 수신 측에 데이터가 도착하기 시작하면 RNIC는 수신 큐의 WQE를 처리하여 데이터를 어디에 배치해야 하는지 파악합니다.
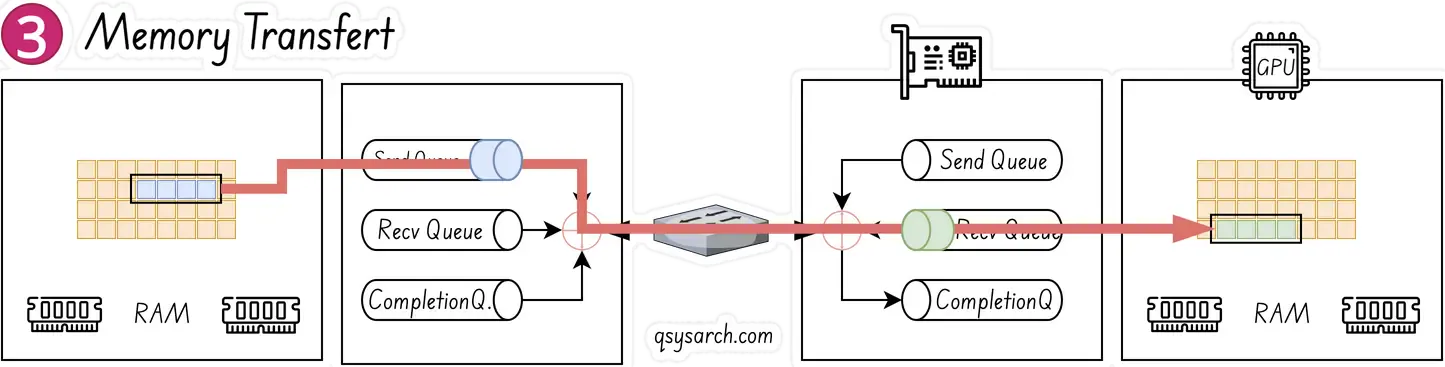
마지막 단계로, 데이터 이동이 완료되면 RNIC는 완료 이벤트 CQE “COOKIE"를 생성하여 완료 큐에 추가합니다. 이 이벤트는 트랜잭션이 완료되었음을 나타냅니다. WQE가 소비될 때마다 CQE가 하나씩 생성됩니다.
RDMA 읽기 및 쓰기 Link to heading
송신측만 능동적이고 수신측은 수동적이라는 점에 유의해야 합니다. 수동측은 아무런 작업도 수행하지 않고, CPU 사이클을 사용하지 않으며, “읽기” 또는 “쓰기"가 발생했다는 표시도 받지 못합니다.
RDMA 읽기 또는 쓰기 작업을 실행하려면 작업 요청에 다음 사항이 포함되어야 합니다.
원격 측의 가상 메모리 주소
원격 측 메모리 등록 키
즉, 능동측은 수동측의 주소와 키를 사전에 확보해야 한다는 의미입니다.
네트워크 패킷 관점에서 본 RDMA Link to heading
이 부분은 Toni Pasanen의 Network Times에 실린 훌륭한 자료를 바탕으로 작성되었습니다.
RDMA 세션 설정 Link to heading
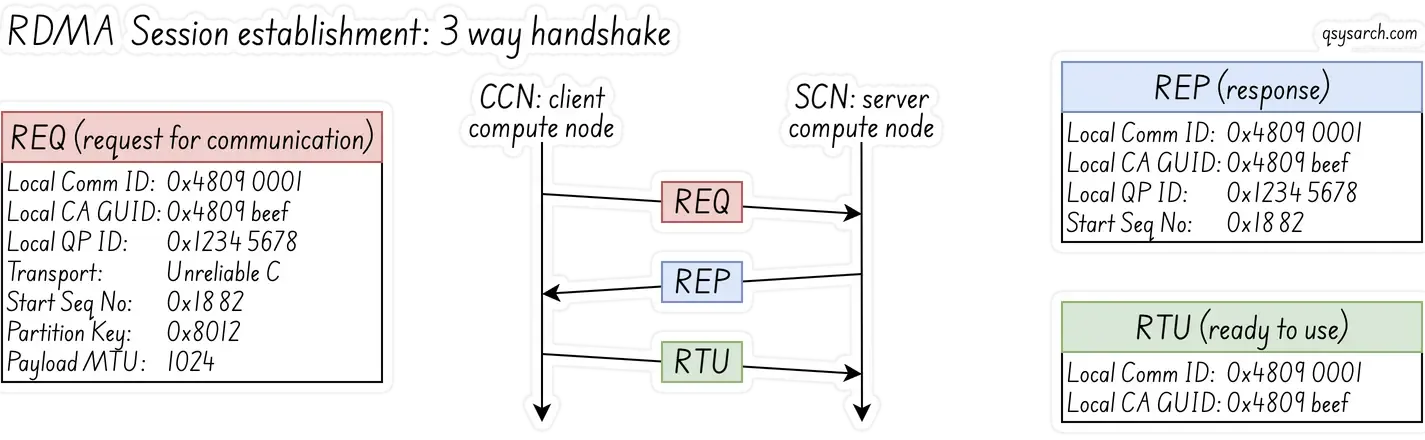
클라이언트 컴퓨팅 노드(일명 ‘CCN’)의 애플리케이션은 서버 컴퓨팅 노드(‘SCN’)의 애플리케이션에 통신 요청(REQ) 메시지를 전송하여 연결 설정을 시작합니다.
REQ 메시지에는 물리적 RNIC와 포트를 식별하는 방법이 포함되어 있습니다.
- 채널 어댑터의 로컬 통신 식별자(LID) 및 글로벌 고유 식별자(로컬 CA GUID). 로컬 CA GUID는 RNIC를 식별하고, 로컬 통신 ID는 NIC의 포트를 식별합니다.
REQ 메시지에는 큐 쌍에 대한 모든 메타 정보도 포함되어 있습니다.
로컬 QP 번호 (0x1234 5678)
QP 서비스 유형(신뢰할 수 없는 연결)
시작 패킷 시퀀스 번호(PSN: 0x1882)
파티션 키 값(0x8012)
페이로드 크기(1024).
REP 메시지는 QP 메타데이터를 확인합니다. 마지막으로 클라이언트는 서버에 QP 연결이 설정되었음을 알리는 RTU(Ready to Use) 메시지를 보냅니다. 세션이 설정되면 CCN의 애플리케이션은 RDMA 쓰기 프로세스를 시작할 수 있습니다.

술어:
CCN: 클라이언트 컴퓨팅 노드
SCN: 서버 컴퓨팅 노드
PD: 보호 영역
L_Key, R_Key: 로컬 키 및 원격 키
QP: 큐 쌍(QP) = 송신 큐 + 수신 큐.
CQ: 완료 대기열
RC: 안정적인 연결
UD: 신뢰할 수 없는 데이터그램
요청사항: CCN은 로컬 ID, QP 번호, P_Key 및 PSN을 전송합니다.
응답: SCN은 ID, QP 정보 및 PSN을 제공합니다.
RTU: 사용 준비 완료: CCN이 연결을 확인합니다.
WR: 작업 요청
RDMA 작업 요청 메시지 Link to heading
추후에 완료될 예정입니다. WR 메시지와 관련하여 여기서 언급할 만한 특별한 사항은 없습니다. 더 자세한 내용을 원하시면 Toni Pasanen의 Network Times 및 InfiniBand 전송 프로토콜을 참조하십시오.
네트워크 전송 관점에서 본 RDMA Link to heading
RDMA 불안정한 연결 Link to heading
RDMA UC(Unreliable Connected)는 재전송을 수행하지 않습니다. 대신, UC는 연결이 필요 없는 비신뢰성 데이터그램 서비스이므로 애플리케이션이 신뢰성을 관리하고 손실된 패킷을 처리해야 합니다. 네트워크 인터페이스 카드(NIC)는 재전송을 시도하지 않고 패킷을 폐기하며, 애플리케이션은 손실된 데이터를 추적하고 재요청해야 합니다. 이는 네트워크 하드웨어가 재전송을 처리하는 신뢰성 연결(RC) QP와는 대조적입니다. 그렇다면 RDMA UC 애플리케이션은 패킷 손실 여부를 어떻게 알 수 있을까요?
- 애플리케이션 수준 패킷 손실 감지
패킷 순서 번호(PSN): 애플리케이션은 전송하는 각 패킷에 고유한 순차 번호를 할당합니다. 수신자는 이러한 순서 번호를 추적합니다. 순서 번호에 공백이 있으면 하나 이상의 패킷이 손실되었음을 나타냅니다.
타임아웃: 애플리케이션 레벨 프로토콜은 타임아웃 메커니즘을 구현할 수 있습니다. 특정 기간 내에 응답이나 확인 응답을 받지 못하면 애플리케이션은 패킷이 손실된 것으로 간주하고 재전송을 시작합니다.
- 애플리케이션 레벨 패킷 손실 복구

수신자가 전송 과정에서 패킷 손실을 감지하면 송신자에게 해당 패킷을 재전송하도록 알려야 합니다. 그리고 송신자에게 알리는 데 사용된 패킷마저 손실되면 상당히 복잡한 상황이 발생할 수 있습니다.
타임아웃: 송신자는 수신자가 패킷 수신을 확인하는 응답을 보낼 것으로 예상합니다. 만약 수신자가 응답하지 않으면, 송신자는 아직 확인 응답을 받지 못한 패킷을 재전송합니다.
RDMA QP 위에 별도의 신뢰성 모듈(https://www.usenix.org/system/files/osdi23-li-qiang.pdf)을 항상 구축해야 할까요? 꼭 그렇지는 않습니다. 어떤 상황에서는 손실된 패킷을 재전송하는 대신 전체 세션을 실패로 표시하는 것이 허용될 수 있습니다. 이러한 접근 방식이 효과적인 이유는 기본 네트워크가 일반적으로 매우 높은 신뢰성을 제공할 만큼 충분히 안정적이기 때문입니다. 예를 들어, 1조 개의 패킷 중 단 하나의 오류만 발생합니다.
우선순위 흐름 제어(PFC) 및 명시적 혼잡 알림(ECN) Link to heading
RDMA UC는 신뢰성이 떨어지는 프로토콜이기 때문에 패킷 손실 여부를 본질적으로 알 수 없습니다. 따라서 패킷 손실은 애플리케이션 또는 상위 계층에서 처리합니다. RDMA의 “무손실” 보장은 우선순위 흐름 제어(PFC) 및 명시적 혼잡 알림(ECN)과 같은 기본 네트워크 기술을 통해 패킷 손실을 애초에 방지함으로써 달성됩니다.
이 프로토콜은 RDMA 데이터 세그먼트를 UDP 데이터 세그먼트로 캡슐화하고, UDP 헤더, IP 헤더, 그리고 마지막으로 이더넷 헤더를 추가하여 3계층 데이터 패킷을 구성합니다. 이 패킷은 이더넷 VLAN의 PCP 필드 또는 IP 헤더의 DSCP 필드를 사용하여 분류할 수 있습니다.
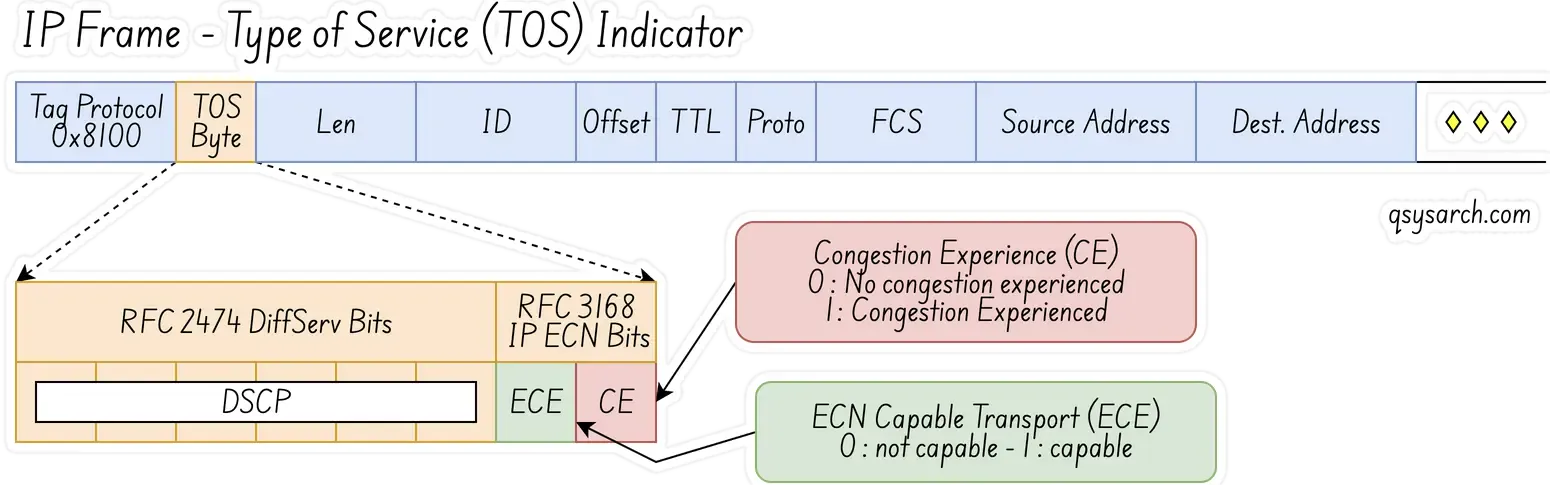
간단히 말해, 레이어 2 네트워크에서 PFC는 VLAN의 PCP 비트를 사용하여 데이터 흐름을 구분합니다. 레이어 3 네트워크에서는 PFC가 PCP와 DSCP를 모두 사용할 수 있으므로 서로 다른 데이터 흐름이 독립적인 흐름 제어를 누릴 수 있습니다. 현재 대부분의 데이터 센터는 레이어 3 네트워크를 사용하므로 PCP보다 DSCP를 사용하는 것이 더 유리합니다.
PCIe 관점에서 본 RDMA Link to heading
 PCIe 분석은 Dolphin의 SmartIO: Zero-overhead Device Sharing through PCIe Networking이라는 훌륭한 논문을 기반으로 합니다.
PCIe 기본 주소 레지스터 Link to heading
PCIe의 가장 큰 특징은 그림과 같이 장치가 CPU 및 시스템 메모리와 동일한 주소 공간에 매핑된다는 점입니다. 이러한 매핑 덕분에 CPU는 시스템 메모리에 접근하는 것과 같은 방식으로 장치 메모리에 읽고 쓸 수 있습니다. 이를 메모리 매핑 I/O(MMIO)라고도 합니다.
시스템이 PCIe 트리를 확인하는 초기화 시점에 BIOS 또는 커널에 의해 각 장치의 메모리 영역에 대한 메모리 주소 범위가 예약됩니다. 예약된 주소는 장치의 기본 주소 레지스터(BAR)에 기록됩니다. 장치는 최대 6개의 BAR를 가질 수 있습니다.
PCIe 인터럽트(MSI) Link to heading
PCIe는 물리적 인터럽트 라인 대신 메시지 신호 인터럽트(MSI)를 사용합니다. MSI를 지원하는 장치는 시스템에서 제공하는 특정 주소와 페이로드를 사용하여 CPU에 메모리 쓰기 명령을 보냅니다. CPU는 이 메모리 쓰기 명령을 읽고 해당 정보를 사용하여 인터럽트를 발생시킵니다.
MSI-X는 최대 2048개의 서로 다른 인터럽트 벡터를 허용하는 MSI의 확장 버전입니다. MSI-X 인터럽트의 장점 중 하나는 멀티코어 시스템에서 특정 CPU 코어를 대상으로 인터럽트를 발생시킬 수 있다는 것입니다. 또한, 서로 다른 MSI-X 벡터는 서로 다른 유형의 이벤트를 신호화할 수 있습니다.
ConnectX-8 최적화 설계 Link to heading
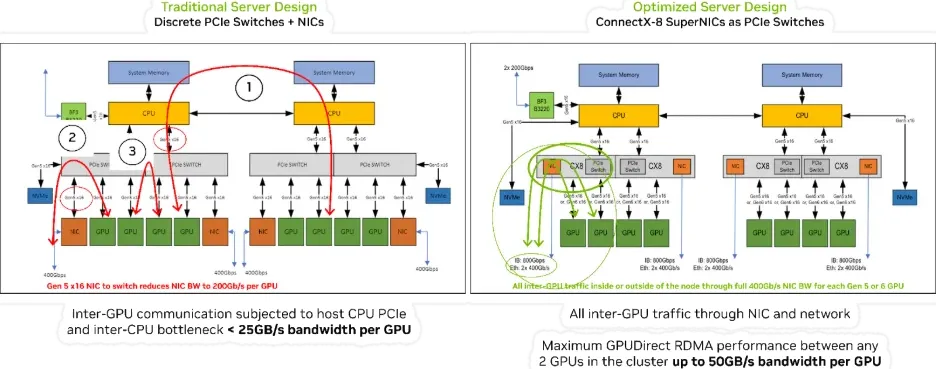
[1] 두 개의 CPU 소켓을 통한 GPU-to-GPU: 기존 설계에서는 이 경로가 호스트 CPU 및 소켓 간 병목 현상을 겪을 수 있으며 CPU 간 링크 사용률에 따라 25GB/s 이하로 제한됩니다. 이와 대조적으로 최적화된 CX8 기반 설계는 NCCL이 모든 트래픽을 네트워크를 통해 직접 라우팅하므로 클러스터 내 모든 GPU 간 통신에 대해 GPU당 최대 50GB/s의 IO 대역폭을 제공합니다.
[2] GPU-NIC 통신: 최적화된 아키텍처는 GPU 또는 호스트 시스템이 PCIe Gen5 또는 Gen6을 지원하는지 여부에 관계없이 2:1 GPU-NIC 구성에서 각 GPU에 50GB/s의 대역폭을 제공합니다.
[3] 동일한 PCIe 스위치를 통한 GPU-to-GPU: PCIe Gen6이 장착된 시스템은 Gen5에 비해 대역폭이 두 배로 증가하여 동일한 PCIe 스위치를 통한 피어 투 피어 GPU 전송이 크게 가속화됩니다.
ConnectX-8 SuperNIC을 사용한 기존(왼쪽) 및 최적화된(오른쪽) 서버 설계 비교, 주요 GPU 통신 경로 3가지 강조
참고: NVIDIA ConnectX-8 SuperNIC 플랫폼 아키텍처
프로그래밍 방식 API 관점에서 본 RDMA Link to heading
이 섹션은 Netdev 0x16 RDMA 튜토리얼을 기반으로 합니다.
설정 Link to heading
PD 및 CQ를 포함한 필수 객체를 생성합니다.
struct ibv_pd *pd = ibv_alloc_pd(verbs_context);
if (!pd) { /* error handling… */ }

struct ibv_cq_init_attr_ex cq_attr = {
    .cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
레지스터 메모리 Link to heading
데이터를 저장할 버퍼를 할당하고 libibverbs에 등록합니다.
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
librdmacm과의 연결 설정 Link to heading
소켓과 유사한 비동기 이벤트 기반 인터페이스를 제공합니다. (필수 사항은 아니지만, 여러 전송 방식을 포괄하는 추상화를 제공합니다.) 먼저 “이벤트 채널"을 생성합니다.
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
양측 모두 서버 주소를 확인합니다.
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
수동 측(SCN)은 수신 “ID"를 생성하고 바인딩한 후 수신 대기합니다.
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
활성 측에서 ID를 생성하고 서버 주소를 확인합니다.
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
연결 이벤트를 처리하는 이벤트 루프:
struct rdma_cm_event *event;
while (true) {
    err = rdma_get_cm_event(test.channel, &event);
    switch (event->event) {
        case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
    }
    rdma_ack_cm_event(event);
}
처리해야 할 주요 이벤트:
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
작업 요청 접수 게시 Link to heading
분산 목록을 작성하고 작업 요청을 접수 대기열에 추가하세요.
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
수집 목록을 작성하고 작업 요청을 대기열에 추가하세요.
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
설문조사 완료 Link to heading
완료 큐 항목에 대한 비차단 검사
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
    end_flag = true;
    /* consume cq->status, cq->wr_id, etc */
    err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
GPU 직접 관점에서 본 RDMA Link to heading
여기서부터 상황이 매우 혼란스러워집니다. “GPUDirect RDMA"와 RDMA는 어떤 관계가 있을까요? 이전 게시물에서 언급했듯이, 엔비디아의 공식 문서에는 둘 사이에 아무런 관계가 없다고 명시되어 있습니다! 그 이유를 이해하려면 이 기술이 멜라녹스(Mellanox)에서 개발되던 2016년경으로 돌아가야 합니다. 당시 사양에는 다음과 같이 나와 있었습니다.
최신 GPU-GPU 통신 기술은 GPUDirect RDMA입니다. 이 새로운 기술은 GPU 메모리와 NVIDIA HCA/NIC 장치 간에 직접적인 P2P(Peer-to-Peer) 데이터 경로를 제공합니다. 이를 통해 GPU-GPU 통신 지연 시간이 크게 줄어들고, CPU의 부하를 완전히 제거하여 네트워크를 통한 모든 GPU-GPU 통신에서 CPU를 배제합니다.
GPUNetIO Link to heading
GPUNetIO 사양에 따르면 NIC-GPU 메모리 상호 작용을 활성화하려면 다음 단계를 수행해야 합니다.
NIC가 GPU 메모리를 사용하여 패킷을 송수신할 수 있도록 하려면 일반적으로 CUDA 툴킷 설치에 포함된 NVIDIA 커널 모듈 nvidia-peermem을 로드하십시오.
GPU 패킷 처리 네트워크 애플리케이션은 크게 두 가지 기본 단계로 나눌 수 있습니다.
CPU 설정 단계 (장치 설정, 메모리 할당, CUDA 커널 실행 등)
GPU와 NIC가 상호 작용하여 기능을 수행하는 데이터 경로 단계
CPU 설정 단계에서 애플리케이션은 다음을 수행해야 합니다.
CPU에 필요한 모든 객체를 준비합니다.
해당 기능에 대한 GPU 핸들러를 내보내세요.
데이터 경로 중에 객체와 상호 작용할 수 있도록 객체의 GPU 핸들러를 전달하여 CUDA 커널을 실행합니다.
이러한 이유로 DOCA GPUNetIO는 두 개의 라이브러리로 구성됩니다.
libdoca_gpunetio는 CPU에서 호출되는 함수를 사용하여 GPU를 준비하고 메모리와 객체를 할당합니다.
libdoca_gpunetio_device는 데이터 경로 중에 CUDA 커널 내에서 GPU가 호출하는 함수를 포함합니다.
예시: UDP 네트워크 트래픽 Link to heading
이는 패킷 헤더를 수신하고 분석하는 가장 일반적인 사용 사례입니다. 100Gb/s의 수신 네트워크 트래픽을 처리하도록 설계된 UDP 트래픽 담당 CUDA 커널은 512개의 CUDA 스레드로 구성된 하나의 CUDA 블록(파일 gpu_kernels/receive_udp.cu)을 다른 이더넷 UDP 수신 큐에 할당합니다.
데이터 경로 루프는 다음과 같습니다.
doca_gpu_dev_eth_rxq_receive_block이라는 GPUNetIO 함수를 사용하여 패킷을 수신합니다.각 CUDA 스레드는 수신된 패킷의 일부를 처리합니다.
패킷이 포함된 DOCA 버퍼를 검색합니다.
패킷 페이로드를 분석하여 DNS 패킷을 다른 일반 UDP 패킷과 구분합니다.
이전 패킷이 다시 분석되지 않도록 패킷 페이로드를 삭제합니다.
각 CUDA 블록은 DOCA GPUNetIO 세마포어를 사용하여 CPU 스레드에 통계를 전송합니다.
CPU 스레드는 세마포어를 확인하여 통계를 얻고 이를 콘솔에 출력합니다.
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
          struct doca_gpu_eth_rxq *rxq0,
          struct doca_gpu_eth_rxq *rxq1,
          struct doca_gpu_eth_rxq *rxq2,
          struct doca_gpu_eth_rxq *rxq3,
          int sem_num,
          struct doca_gpu_semaphore_gpu *sem0,
          struct doca_gpu_semaphore_gpu *sem1,
          struct doca_gpu_semaphore_gpu *sem2,
          struct doca_gpu_semaphore_gpu *sem3)
{
  __shared__ uint32_t rx_pkt_num;
  __shared__ uint64_t rx_buf_idx;
  __shared__ struct stats_udp stats_sh;

  doca_error_t ret;
  struct doca_gpu_eth_rxq *rxq = NULL;
  struct doca_gpu_semaphore_gpu *sem = NULL;
  struct doca_gpu_buf *buf_ptr;
  struct stats_udp stats_thread;
  struct stats_udp *stats_global;
  struct eth_ip_udp_hdr *hdr;
  uintptr_t buf_addr;
  uint64_t buf_idx = 0;
  uint32_t lane_id = threadIdx.x % WARP_SIZE;
  uint8_t *payload;
  uint32_t sem_idx = 0;

  if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
  else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
  else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
  else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

  if (threadIdx.x == 0) {
    DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
  }
  __syncthreads();

  while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
    stats_thread.dns = 0;

    /* No need to impose packet limit here as we want the max number of packets every time */
    ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
    /* If any thread returns receive error, the whole execution stops */
    if (ret != DOCA_SUCCESS) { ... }

    if (rx_pkt_num == 0) continue;

    buf_idx = threadIdx.x;
    while (buf_idx < rx_pkt_num) {
      doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
      doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
      raw_to_udp(buf_addr, &hdr, &payload);

      if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

      /* Double-proof it's not reading old packets */
      wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
      buf_idx += blockDim.x;
    }
    __syncthreads();

    for (int offset = 16; offset > 0; offset /= 2) {
      stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
      __syncwarp();
    }

    if (lane_id == 0) {
      atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
    }

    __syncthreads();

    if (threadIdx.x == 0 && rx_pkt_num > 0) {
      ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
      if (ret != DOCA_SUCCESS) { ... }

      DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
      DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
      doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
      __threadfence_system();

      sem_idx = (sem_idx + 1) % sem_num;

      DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
    }

    __syncthreads();
  }
}
RDMA는 어디에 있나요? Link to heading
위 예시에서 RDMA는 실제로 사용되지 않습니다. GPUNetIO는 단순히 GPU가 패킷 데이터를 직접 처리할 수 있도록 해줍니다. RDMA와 유사한 부분은 패킷이 NIC에서 CPU 메모리를 거치지 않고 직접 DMA 전송 방식으로 GPU로 이동한다는 점뿐입니다.
결론을 내리기 전에 한 가지 혼란스러운 점이 남아 있습니다. 바로 DOCA RDMA입니다. 이전 섹션에서 DOCA GPUNetIO를 살펴보았는데, DOCA RDMA는 무엇이며 이전에 살펴본 “ibv” API와는 어떻게 다른 것일까요?
답은 간단합니다. DOCA RDMA는 NVIDIA에서 CPU 또는 GPU를 사용하여 RDMA 작업을 수행하기 위한 소프트웨어 프레임워크입니다. IBV는 InfiniBand 및 RoCE 하드웨어 프로그래밍을 위한 표준 API의 일부인 기존의 저수준 InfiniBand Verbs 라이브러리입니다. 핵심적인 차이점은 DOCA RDMA가 Verbs 인터페이스의 기본 기능을 기반으로 구축된 더 높은 수준의 포괄적인 SDK라는 점입니다. 이를 통해 GPU 가속을 지원하고 RDMA 작업을 CPU에서 GPU로 오프로드할 수 있습니다.
예를 들어, 다음은 RDMA 패킷을 전송하는 코드입니다.
doca_error_t rdma_send(struct rdma_config *cfg)
{
	struct rdma_resources resources = {0};
	union doca_data ctx_user_data = {0};
	const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
	const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
	struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
	doca_error_t result, tmp_result;

	/* Allocating resources */
	result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
					 doca_rdma_cap_task_send_is_supported,  &resources);

	result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
					rdma_send_error_callback, NUM_RDMA_TASKS);

	result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

	/* Include the program's resources in user data of context to be used in callbacks */
	ctx_user_data.ptr = &(resources);
	result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

	/* Create DOCA buffer inventory */
	result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

	/* Start DOCA buffer inventory */
	result = doca_buf_inventory_start(resources.buf_inventory);

	/* Start RDMA context */
	result = doca_ctx_start(resources.rdma_ctx);

	/*
	 * Run the progress engine which will run the state machine defined in
	 * rdma_send_state_change_callback(). When the context moves to idle, the context change
	 * callback call will signal to stop running the progress engine. */
	while (resources.run_pe_progress) {
		if (doca_pe_progress(resources.pe) == 0)
			nanosleep(&ts, &ts);
	}

	// ... cleanup
}
고정관념을 깨고 생각해 보세요: RDMA가 아니라면 어떨까요? Link to heading
이전 섹션에서 RDMA의 다양한 측면을 살펴보았습니다. RDMA의 궁극적인 목표는 CPU, GPU 및 양자 제어 스택 간에 데이터를 수 마이크로초의 지연 시간으로 주고받는 것입니다. 전송해야 할 정보는 I/Q 소프트 판독 데이터, 제어 펄스 샘플(“웨이브”), 또는 일반적으로 신경망 환경에서 사용되는 펄스의 파라미터 구성과 같은 매우 다양합니다. 또한 논리 큐비트의 신드롬과 같은 간단한 정보를 전송하거나 컴퓨팅 장치의 QEC 디코더를 원격으로 호출해야 할 필요도 있습니다. 후자의 경우, 이를 “원격 프로시저 호출(RPC)“이라고 부르는 것이 적절합니다.
다행히 RDMA 기반 RPC에 대한 자료는 많이 있습니다. 예를 들어, mRPC 논문에서는 100Gbps Mellanox Connect-X5 RoCE NIC를 기반으로 매우 흥미로운 지연 시간 수치를 제시합니다. 논문 자체에는 “RDMA 환경에서 mRPC는 중앙값 지연 시간과 꼬리 지연 시간 측면에서 eRPC보다 각각 1.3배와 1.4배 빠르다"라고 명시되어 있지만, 표에서는 eRPC가 mRPC보다 빠르다고 나와 있어 혼란스럽습니다. 하지만 현재로서는 이러한 지연 시간 수치가 실험적으로 가능한 결과라고 가정할 수 있습니다.
더 흥미로운 점은 mRPC 후속 연구 논문(https://www.usenix.org/system/files/atc24-ma.pdf)에서 CXL(Compute Express Link)을 사용하여 “HydraRPC"라는 훨씬 빠른 RPC를 구현했다는 것입니다. 오른쪽 표에서 볼 수 있듯이 수치가 모든 것을 말해줍니다. 여기서 제기되는 질문은 5년 후에는 어떻게 될 것인가 하는 것입니다. 제 생각에는 NVLink 또한 매우 매력적인 기회로 보입니다.
결론 Link to heading
자, 이 메모를 작성하는 데 시간이 좀 더 걸렸지만, 덕분에 좀 더 잘 이해할 수 있었던 것 같습니다. RDMA와 GPUDirect 간의 혼동은 RDMA가 원래 Mellanox에서 순수한 네트워크 개선을 위해 개발되었다는 사실에서 비롯된 것으로 생각합니다. Mellanox가 Nvidia에 인수된 후 GPU와 “연결"되도록 확장되었지만, 이 확장 기능은 처음부터 설계된 개념이 아니었고 결국 DOCA 생태계에 추가된 기능으로 남게 되었습니다.

References:
- Mellanox - WinOF VPI Documentation v5.50.52000
- Nvidia - RDMA over Converged Ethernet
- Aruba - Remote Direct Memory Access (RDMA) Solution
- CERN - Implementing RoCEv2 in Verilog for FPGA
- Network Times - Remote Direct Memory Access - RDMA Basics
- High-Throughput, Resource-Efficient Implementation of the RoCEv2
- A Remote Direct Memory Access Protocol Specification
- Imperial College London - RDMA Tutoral
- InfiniBand: An Introduction + Simple IB verbs program with RDMA Write
- Netdev 0x16 - RDMA Tutorial
- Microsoft - Understanding RDMA Microarchitecture Resources for Performance Isolation
- RoGUE: RDMA over Generic Unconverged Ethernet
- DatenLord - RDMA blue design
- Using RDMA Efficiently for Key-Value Services
- An Extensible Software Transport Layer for GPU Networking
- Alibaba - Flor: An Open High Performance RDMA Framework Over Heterogeneous RNICs
- ConnectX comparison
- RR-Compound
- gRPC meets RDMA
- Accelerating TensorFlow with Adaptive RDMA-based gRPC
- Toward GPU-centric Networking on Commodity Hardware
DrawIO diagrams used in this memo: