이 메모는 GPU 기본 사항으로 돌아갑니다. 특히 딥러닝의 핵심 연산인 행렬 곱셈에 초점을 맞춥니다. 먼저 기본적인 학술적 구현 방식을 설명하고, 그 다음 GPU를 효율적으로 사용하기 위해 필요한 최적화 기법을 살펴보겠습니다.
단순 행렬 곱셈법 이해하기 Link to heading
교과서에서 흔히 볼 수 있는 기본적인 예시부터 시작해 보겠습니다.
/**
 * Kernel to perform matrix multiplication C = A × B
 * A is of size N x M, B is M x N, and C is N x N
 * Each thread computes one element of matrix C.
 */

__global__ void naive_matrix_multiply(float* A, float* B, float* C) {

    // Calculate global row and column for this thread
    int row = blockIdx.y /* 0...16 */ * blockDim.y + threadIdx.y;
    int col = blockIdx.x /* 0...16 */ * blockDim.x + threadIdx.x;

    if (row < N && col < N) {
        float sum = 0.0f;
        for (int k = 0; k < M; k++) {
            // C[row][col] = sum(A[row][i] * B[i][col])
            sum += A[row * N + k] * B[k * N + col];
        }
        C[row * N + col] = sum;
    }

}
언뜻 보면 쉬워 보입니다. 출력 행렬 C의 각 셀을 계산하기만 하면 되니까요. 이 커널 코드는 제대로 작동하는 것처럼 보입니다. 다음은 커널을 시각적으로 더 잘 나타낸 그림입니다.
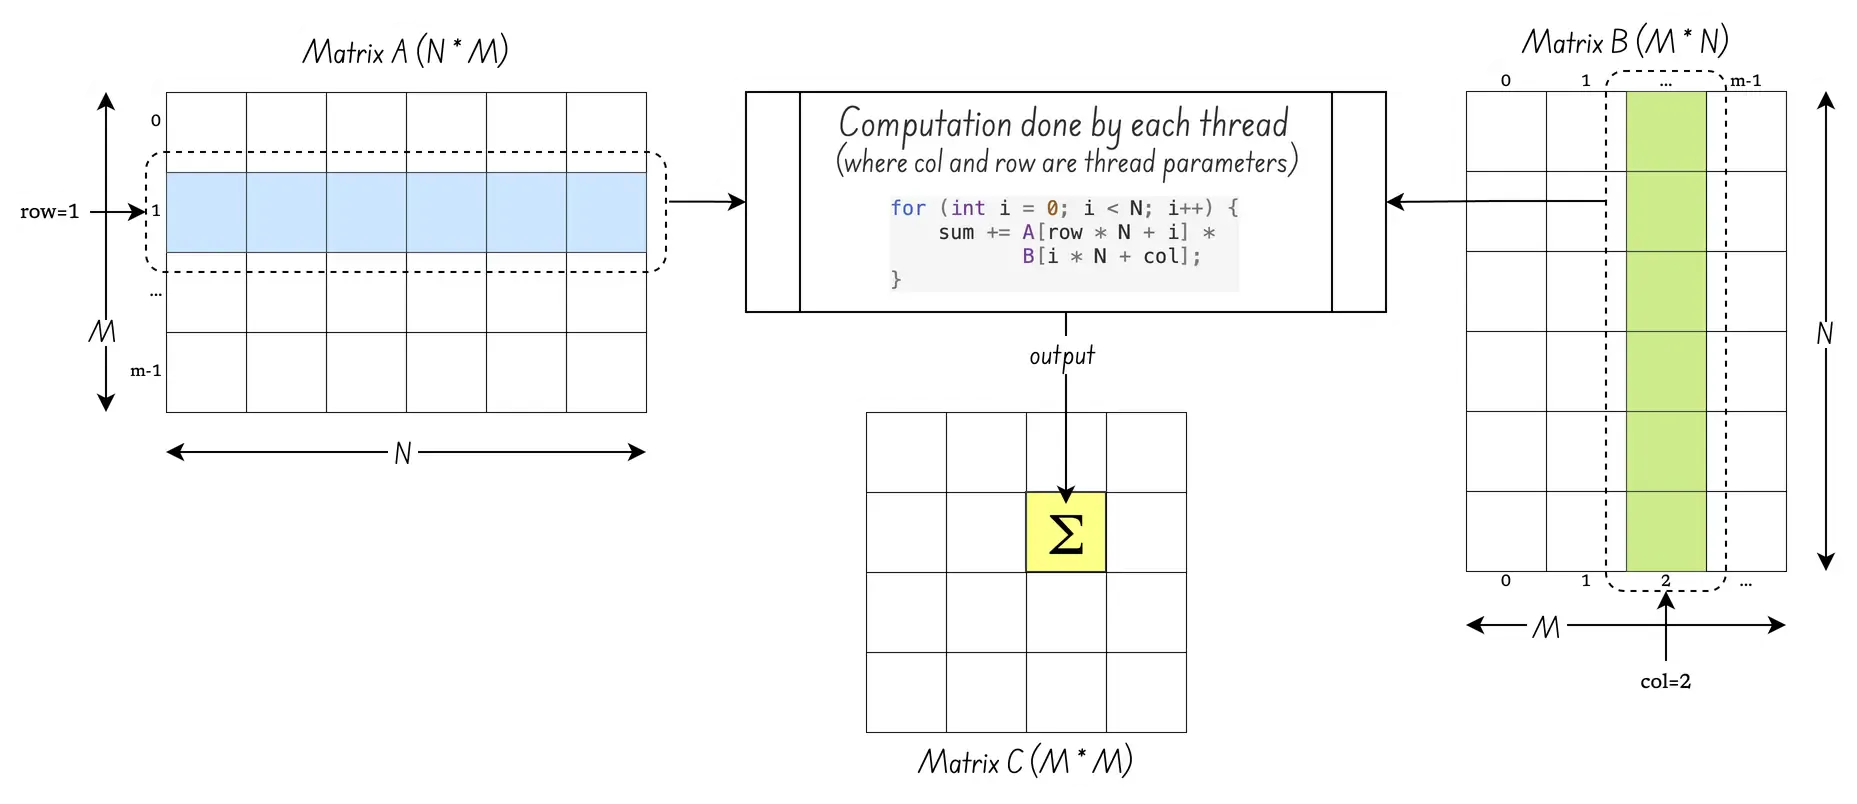
실제로는 조금 더 복잡합니다. blockIdx, blockDim, threadIdx를 어떻게 이해해야 할까요? 이를 이해하려면 GPU가 스레드, 워프, 스트리밍 멀티프로세서를 중심으로 어떻게 구성되어 있는지 다시 살펴보세요. 다음은 엔비디아의 H100 “호퍼” GPU 마이크로아키텍처에 대한 제 의견을 담은 설명입니다.
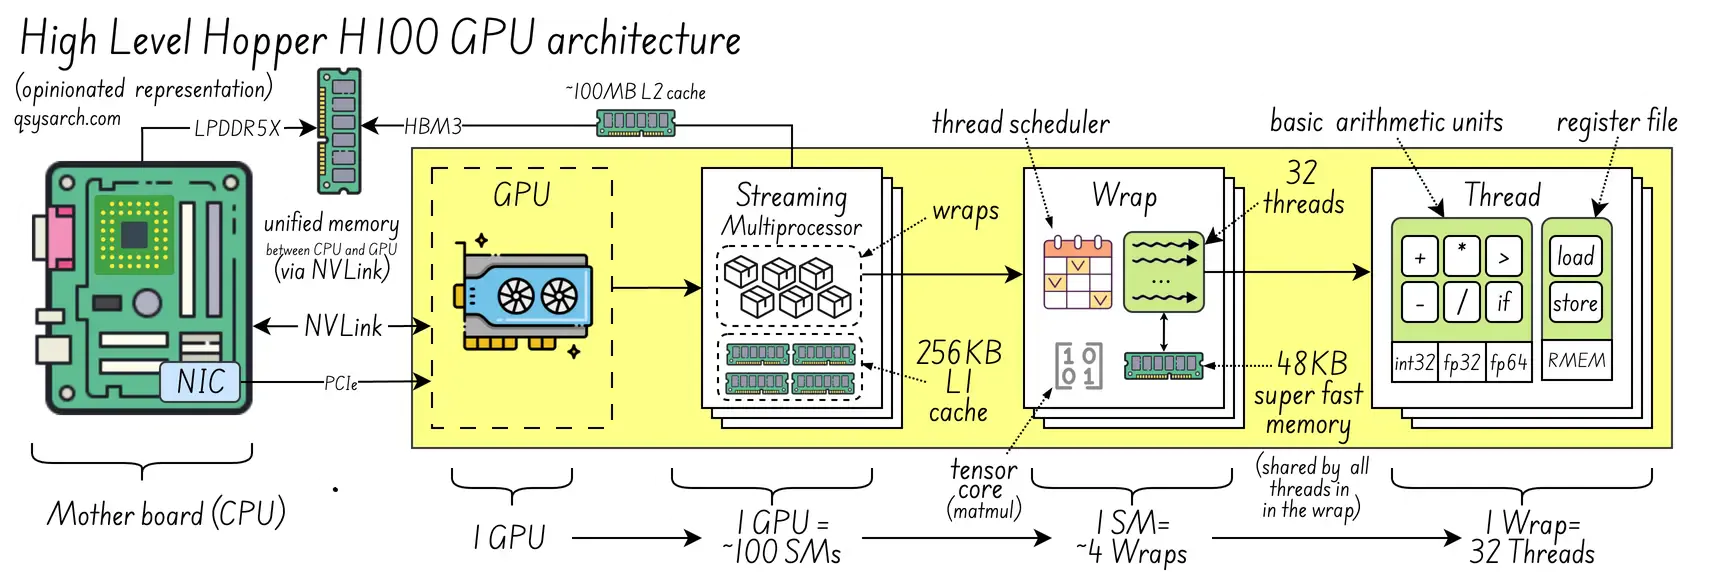
간략히 요약하면 다음과 같습니다.
1 스트리밍 멀티프로세서 = 4 ~ 64 랩
1바퀴 = 32~64개의 실
그렇다면 sum을 계산하는 코드 조각은 어떻게 스레드, 워프, 심지어 스트리밍 멀티프로세서와 연결되는 걸까요? 할당 및 매핑 결정은 어디에서 이루어지는 걸까요? 먼저 커널이 어떻게 구성되어 있는지 이해해야 합니다.
int launch_kernel(float *d_A, *d_B, *d_C) {

    dim3 block_size(16, 16);  // 16x16 threads per block -> 256 threads
    dim3 grid_size(4, 4);     // 4x4 blocks per grid = 64 blocks

    // 2. Launch the kernel with the specified dimensions
    naive_matrix_multiply<<<grid_size, block_size>>>(d_A, d_B, d_C);
}
이 계층적 구성은 다음과 같이 GPU 하드웨어에 매핑됩니다.

이 설정에서는 크기가 N인 행렬(16*4 = 64)을 곱할 수 있습니다. 만약 N이 1000이라면 어떻게 될까요? 이 경우에는 그리드 크기를 (1000+15)/16으로 설정하기만 하면 됩니다.
실제 하드웨어와의 매핑은 어떻게 이루어지나요? 블록이 워프에 할당된다는 뜻인가요? 블록에 포함된 스레드 수가 하드웨어 스레드 수보다 많으면 어떻게 되나요?
자, 바로 이 부분에서 GPU 스케줄링이 필요합니다. 간단히 말해, 필요한 스레드 수가 물리적 하드웨어에 있는 스레드 수보다 많으면 GPU는 여러 개의 워프를 할당합니다.
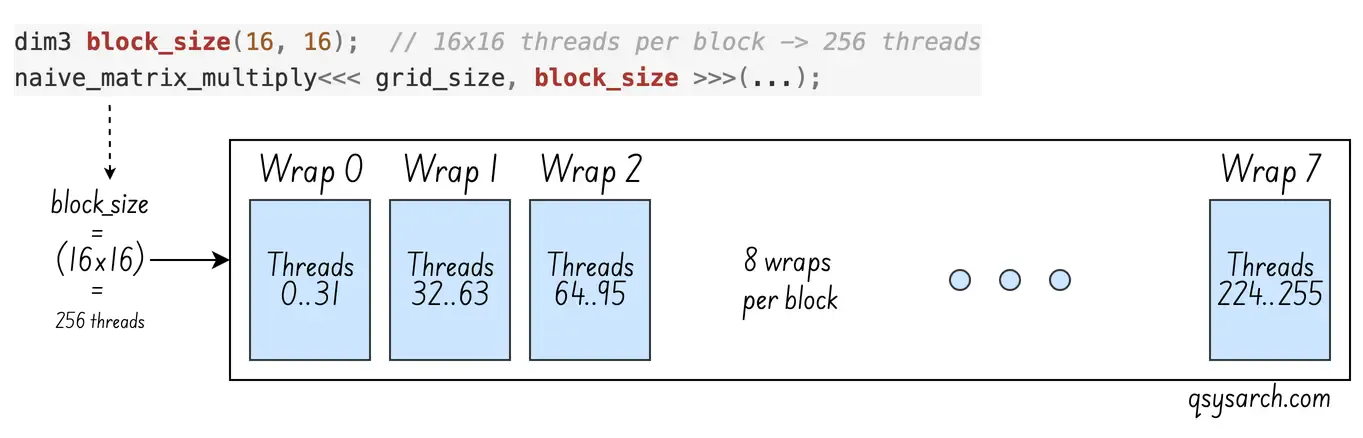
다음 질문은 블록당 필요한 8개의 워프가 스트리밍 멀티프로세서와 어떻게 연결되는가 하는 것입니다. 특히 스트리밍 멀티프로세서가 블록에 필요한 워프 수보다 적은 워프를 가지고 있을 경우 더욱 그렇습니다. 답은 아주 간단합니다. 스트리밍 멀티프로세서는 4개 이상의 워프를 가질 수 있으며, 이 워프들을 교대로 스케줄링합니다. 메모리 접근으로 인해 특정 워프가 지연될 경우, 스트리밍 멀티프로세서는 즉시 다른 워프로 전환합니다. 이를 **지연 시간 숨기기(latency hiding)**라고 하며, GPU 성능 향상을 위한 핵심 전략입니다. 이 전략이 없었다면 효율성이 이렇게 높지 않았을 것입니다.
이제 grid_size를 생각해 봅시다. grid_size가 하드웨어 리소스에 직접적으로 매핑되는 것일까요? 그렇지 않습니다. 그리드는 단지 논리적인 개념일 뿐입니다. 그리드는 매트릭스를 구성하는 데 필요한 충분한 블록이 확보되도록 합니다. grid_size는 하드웨어에 대응하지 않습니다. 블록은 런타임에 큐에서 각 SM(스마트 메모리)에 할당됩니다.
할당은 블록에 필요한 리소스를 기반으로 합니다(각 래퍼는 제한된 수의 레지스터를 가지고 있으며, 각 블록이 자체적으로 정적으로 할당된 레지스터 세트를 갖도록 해야 합니다).
블록이 계산을 완료하면 스케줄러(SM)는 스케줄러 큐에서 새 블록을 가져와 완료된 블록을 대체합니다. 블록이 할당되면 해당 SM에 고정되고 실행을 위해 레지스터가 할당됩니다.
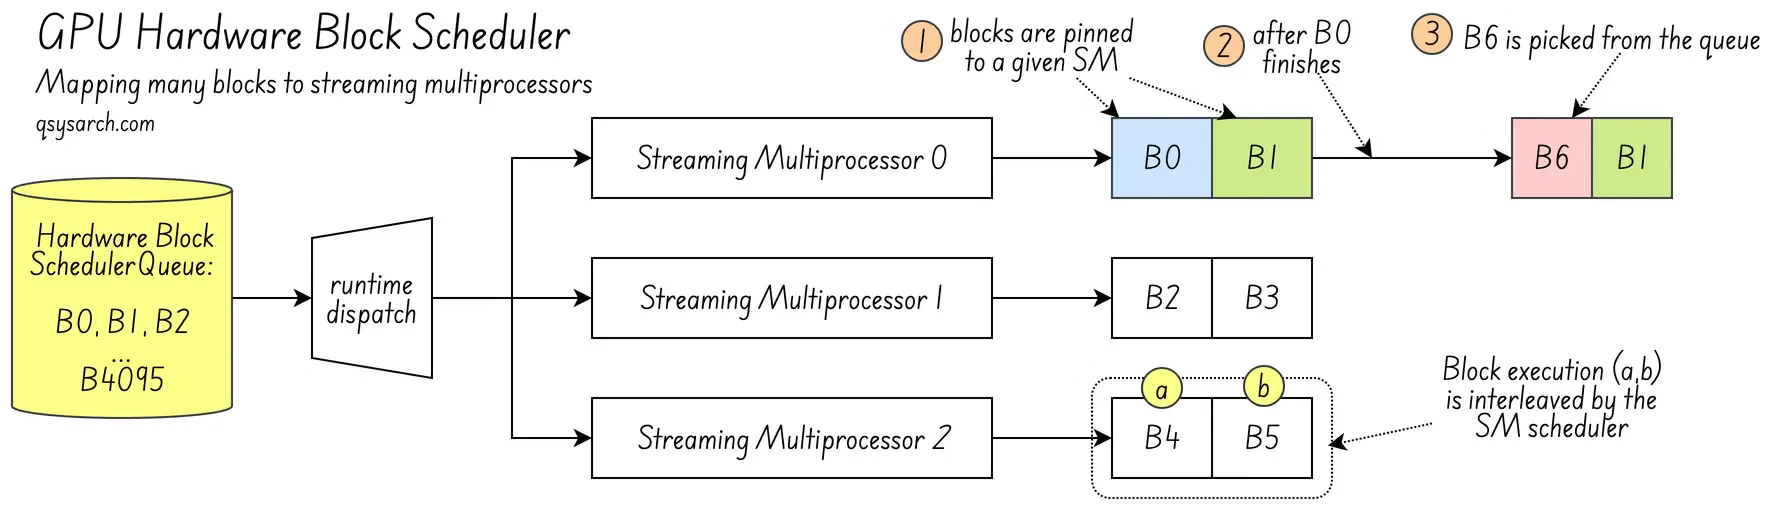
마지막 질문입니다. 블록은 SM에 고정되나요, 아니면 워프에 고정되나요? 블록 내 스레드에서 사용하는 메모리는 워프에 할당된 것인가요? 그렇지 않다면 SM이 워프 간에 메모리를 이동해야 할 텐데요. 네, SM 내에서는 블록의 워프가 고정됩니다. 블록 0이 워프 0에, 블록 1이 워프 1에 할당되었다면 항상 그렇게 유지됩니다.
단순 행렬 곱셈기 개선 Link to heading
이제 동시 스레드 실행을 이해했으니, 단순한 행렬 곱셈 커널을 생각해 보겠습니다. 모든 스레드는 행렬 A와 B에 대한 메모리 접근을 놓고 경쟁합니다. 각 스레드는 전역 메모리에서 A의 한 행 전체와 B의 한 열을 스트리밍 방식으로 가져옵니다. 재사용은 없습니다. B는 열 단위로 접근되므로(B[i * N + col]), 버스트 접근과 메모리 캐싱을 효과적으로 사용할 수 없습니다.
가장 간단한 해결책은 공유 메모리를 사용하는 것입니다. 먼저 행렬의 일부를 T*T 크기의 타일 형태로 워프 메모리에 로드합니다. 그런 다음 스레드가 이 로컬 메모리에서만 읽도록 합니다. 이렇게 하면 스레드 간 메모리 접근 경쟁이 발생하지 않습니다. 워프 인터리빙을 사용하면 공유 메모리는 한 워프가 캐시에 메모리를 로드하는 동안 다른 워프가 합계를 계산하도록 합니다. 다음은 개선된 커널입니다.
__global__ void matmul_tiled(float* A, float* B, float* C) {

    __shared__ float A_shared[T][T];
    __shared__ float B_shared[T][T];

    int tx = threadIdx.x,  ty = threadIdx.y;
    int row = blockIdx.y * T + ty;   // global row in C
    int col = blockIdx.x * T + tx;   // global col in C

    float accumulator = 0.0f;
    for (int t = 0; t < M; t += T) {

        // Read [T,T] subtile from matrix A and B.
        // Assume that M and N are multiples of T (no bound check)
        A_shared[ty][tx] = A[row * M + t + tx];
        B_shared[tx][ty] = B[(t + ty) * N + col];

        __syncthreads();   // wait all threads to finish loading

        for (int k = 0; k < TILE; ++k)
            accumulator += A_shared[ty][k] * B_shared[k][tx];

        __syncthreads();   // all threads are ready to load again
    }
    C[row * N + col] = accumulator;
}
단순화를 위해 M과 N은 T의 배수라고 가정하므로, 전역 행렬을 A_shared와 B_shared에 로드할 때 경계 검사를 수행하지 않습니다.
이 코드에는 약간의 마법이 숨어 있습니다. 블록 내의 모든 스레드는 동일한 메모리 읽기 작업인 A[row * M + t + tx]를 실행합니다. t는 연속된 메모리 영역이므로 스레드는 동일한 메모리 영역에서 읽습니다. 이는 메모리 버스트와 캐싱을 가능하게 합니다. 첫 번째 스레드가 버스트 읽기를 시작하면 다른 스레드는 해당 버스트로 채워진 캐시를 사용합니다. B는 전치되지 않으므로 이 방법은 B에는 적용되지 않습니다. 또한 __syncthreads()는 블록 내의 스레드를 동기화하여 동일한 메모리 모듈(SM)에서 실행되도록 합니다.
이전의 단순한 곱셈 방식에서는 블록 크기가 임의적이었습니다. 하지만 타일 방식에서는 그림에서처럼 블록 크기가 타일 크기 T*T에 맞아야 합니다.
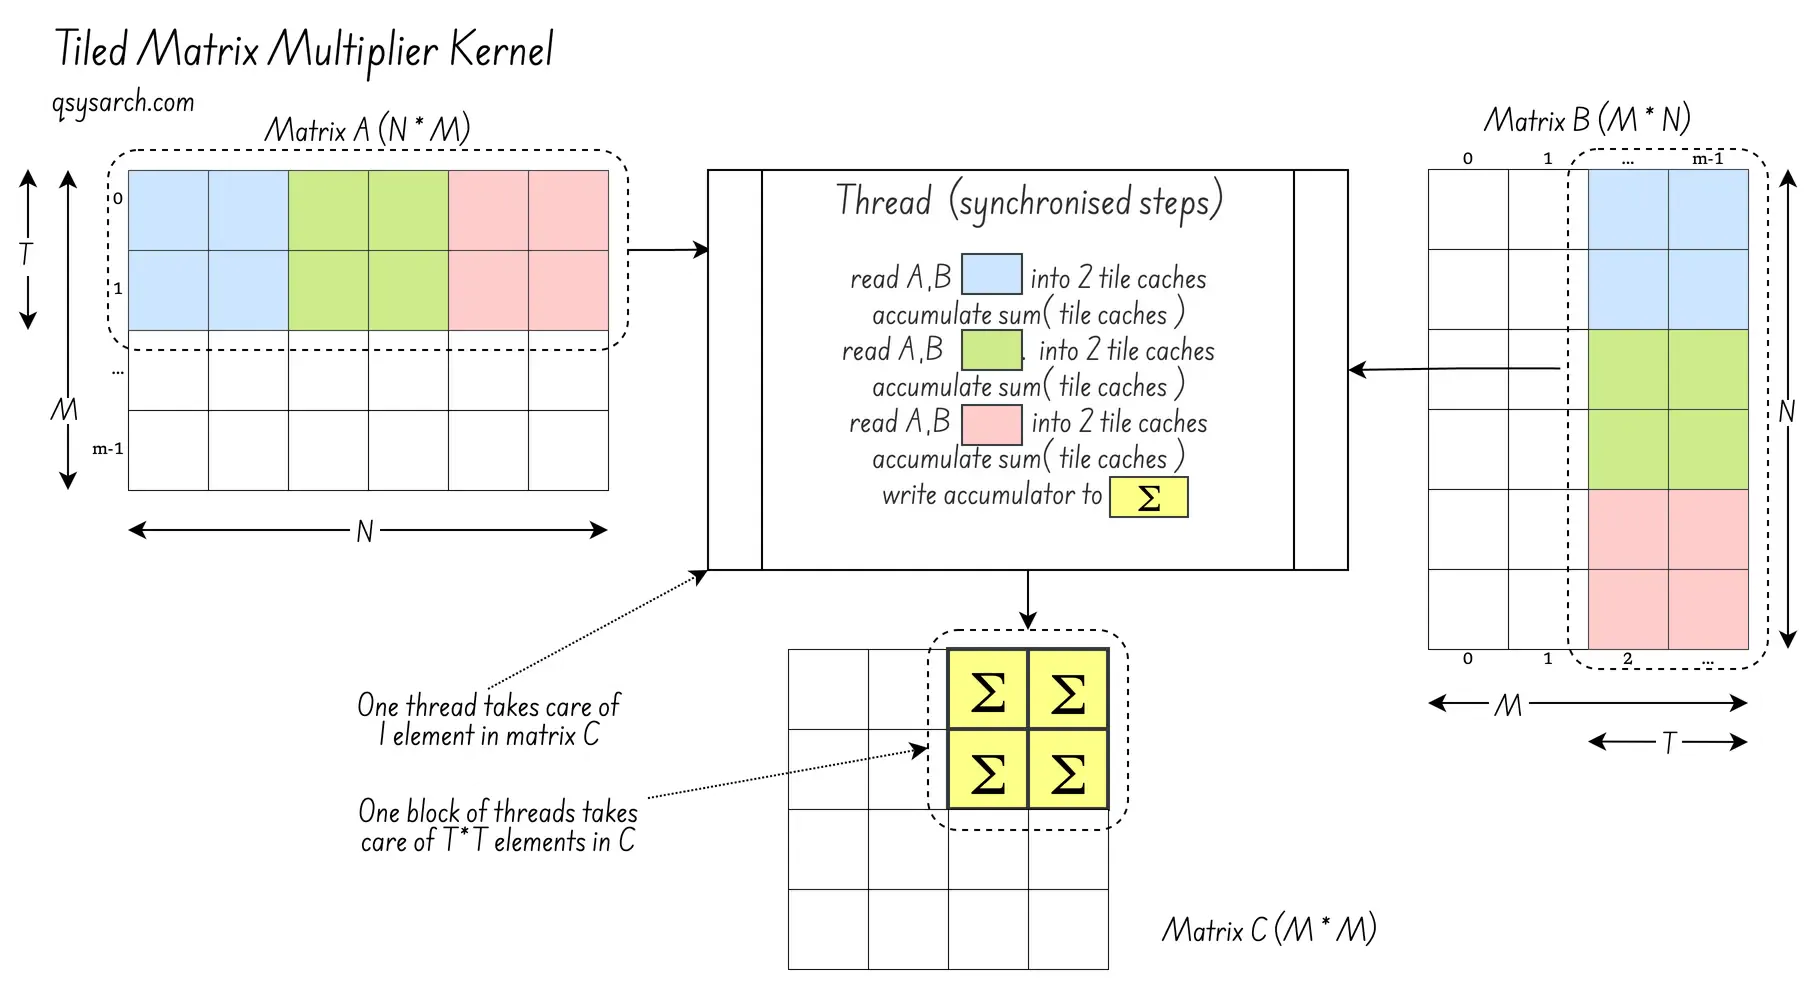
타일링 방식은 블록이 로드되는 동안 다른 블록이 계산을 수행할 수 있도록 합니다. 이 경우 계산은 가볍기 때문에 메모리 로딩보다 시간이 적게 걸릴 수 있습니다. 이 문제를 해결하려면 계산 중에 스레드당 처리량을 늘려야 합니다. 각 스레드는 하나의 요소 대신 2x2 요소 집합을 계산할 수 있습니다. K=2이고 T가 K의 배수이면 이것이 가능합니다.
_global__ void matmul_tiled_and_coarsened(float* A, float* B, float* C) {

    __shared__ float A_shared[T][T];
    __shared__ float B_shared[T][T];

    int tx = threadIdx.x, ty = threadIdx.y;
    int rowBase = blockIdx.y * T * K + ty;
    int colBase = blockIdx.x * T * K + tx;

    float accumulators[K][K]; // That's register memory

    for (int t = 0; t < M; t += TILE) {

        A_shared[ty][tx] = A[row * M + t + tx];
        B_shared[tx][ty] = B[(t + ty) * N + col];

        __syncthreads();

        for (int k = 0; k < TILE; ++k)
            for (int wr = 0; wr < K; ++wr)
                for (int wc = 0; wc < K; ++wc)
                    acc[wr][wc] += A_shared[ty + wr * (T/K)][k] * B_shared[k][tx + wc * (T/K)];

        __syncthreads();
    }

    // Write out the T×T accumulated result
    for (int wr = 0; wr < T; ++wr)
        for (int wc = 0; wc < T; ++wc) {
            int r = rowBase + wr * (T/K);
            int c = colBase + wc * (T/K);
            C[r * N + c] = acc[wr][wc];
        }
}
결론 Link to heading
자, 이게 바로 GEMM(일반 행렬 곱셈) 장치의 기본 작동 방식입니다!
다음으로, 텐서 코어(NVIDIA)나 매트릭스 융합 곱셈-덧셈(AMD)과 같은 특수 하드웨어를 소개해야겠습니다. 이들은 스트리밍 멀티프로세서에서 T*T*K 누적 곱셈을 계산하는 특수 장치입니다. 이 부분은 나중에 자세히 다루도록 하겠습니다!
References:
- The icons used in this memo are from Icons8
- eunomia.dev: cuda tutorial
- Inside NVIDIA GPUs: Anatomy of high performance matmul kernels
- CUDA – Threads, Blocks, Grids and Synchronization
DrawIO diagrams used in this memo:


