NVIDIA GPU용 컴파일을 할 때 CUDA는 흔히 참조 컴파일 프레임워크로 여겨집니다. 하지만 컴파일러는 실제로 어떻게 작동할까요? GPU용 “실행 파일"을 생성할 때 컴파일러는 어떤 종류의 명령어 세트 아키텍처(ISA)를 생성해야 할까요? 그리고 컴파일러는 실제로 어떻게 작동할까요? CPU에서 실행되어 GPU에서 실행될 수 있는 코드를 생성하는 데 어떤 아키텍처가 사용될까요?
이번 일요일 아침 메모는 NVIDIA GPU 컴파일러 아키텍처에 대한 개괄적인 내용을 다룹니다. GPU 명령어 세트, CUDA 프레임워크의 NVCC 컴파일러, 그리고 마지막으로 GPU 명령어 세트를 대상으로 하는 다른 아키텍처에 대해 설명합니다.
저수준 GPU 아키텍처 Link to heading
GPU와 같은 장치를 대상으로 프로그래밍할 때는 해당 장치를 위한 명령어 세트가 필요합니다. NVIDIA의 경우, 이 장치는 오른쪽 다이어그램에 나타낸 스트리밍 멀티프로세서(SM)입니다. 이 다이어그램에서 흥미로운 점은 IN32 가산기, 특수 기능 장치, GEMM+++ 텐서 코어와 같은 여러 병렬 처리 장치가 있으며, 컴파일러는 이러한 장치들이 가장 효율적인 방식으로(파이프라인 방식으로) 사용되도록 해야 한다는 것입니다(여기서 효율성은 유휴 시간을 최소화하는 것으로 정의됨).
현재 사용되는 용어는 다음과 같습니다.
ISA(명령어 집합 아키텍처): 명령어 집합.
기계어 코드: 명령어를 간결하고 이진수로 표현한 것
어셈블리 언어: 명령어를 좀 더 간결한 텍스트 형식으로 표현한 것
NVIDIA GPU에는 두 가지 ISA가 있습니다.
이 커널을 컴파일한다고 가정해 봅시다.
__global__ void normalizeVector(float* x, float* y, float* z, int n)
{
    int i = blockIdx.x * blockDim.x + threadIdx.x;

    float vx = x[i], vy = y[i];
    float len2 = vx*vx + vy*vy;
    float invLen = rsqrtf(len2);  // Use SFU fast reciprocal square root
    z[i] = invLen; // Normalized length
}
여기서 핵심은 rsqrtf가 SFU 파이프라인으로 전달되어야 한다는 점입니다. 어떻게 작동하는 걸까요? _float invLen = rsqrtf(len2);_라는 코드는 아래 godbolt의 그림에서 볼 수 있듯이 PTX 형식으로 rsqrt.approx.ftz.f32로 변환된 다음 SASS 형식으로 MUFU.RSQ로 변환됩니다.
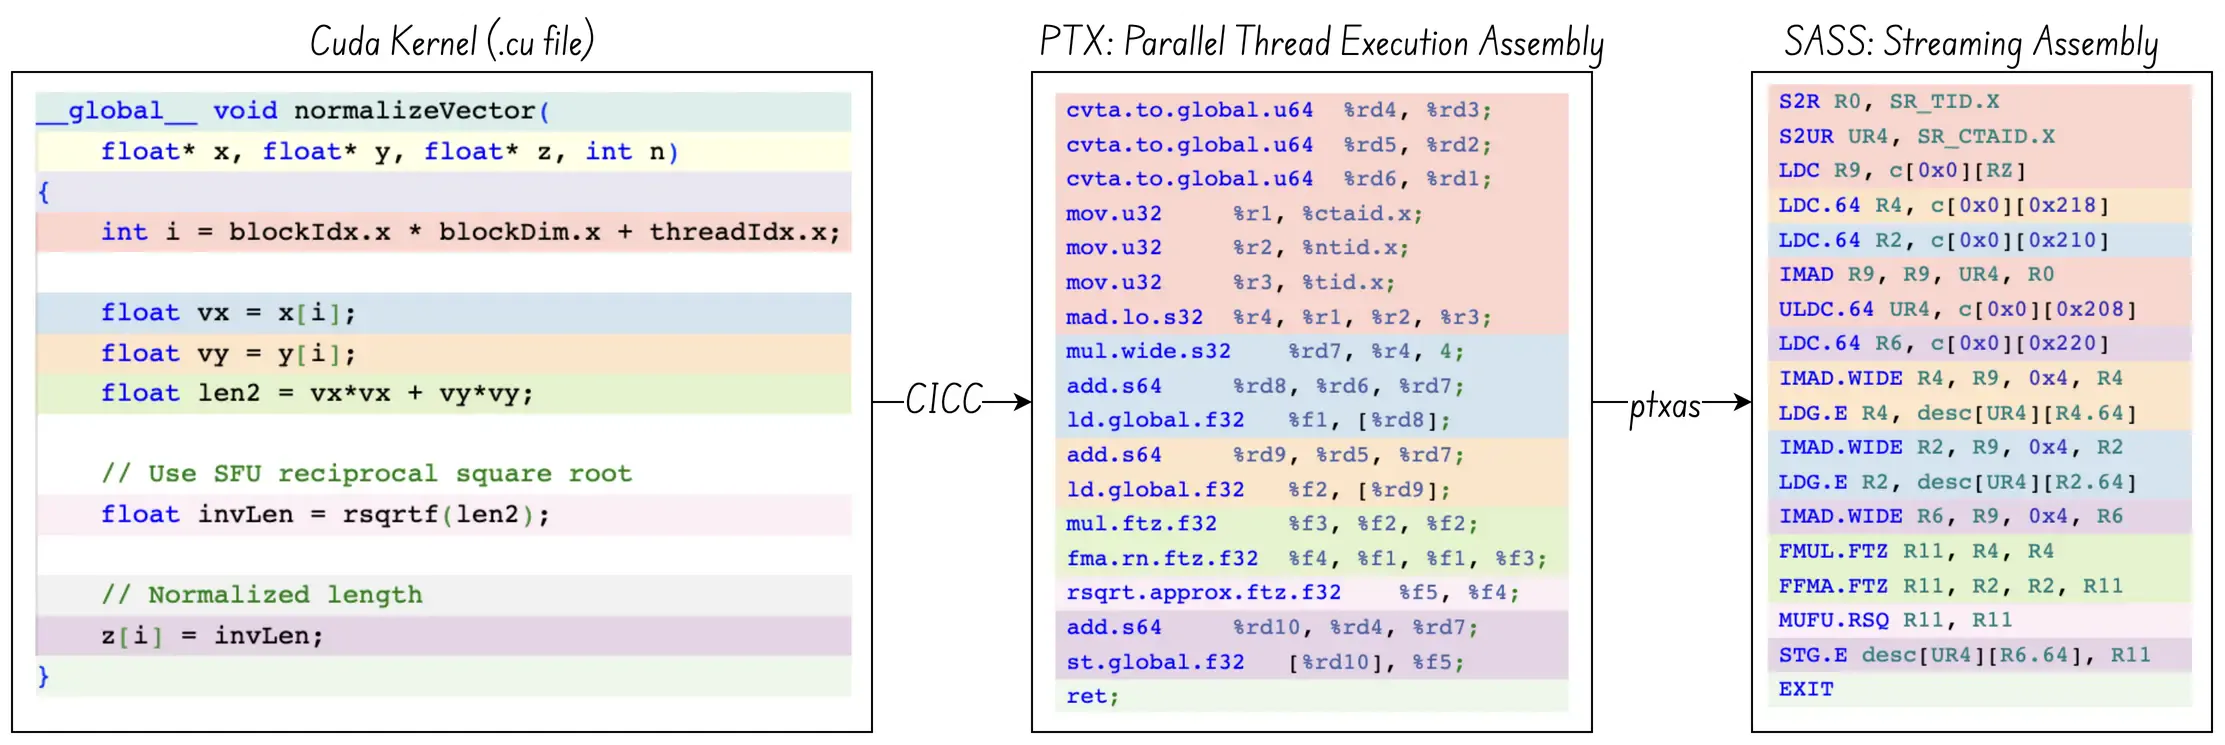
MUFU는 다기능 장치(multi-function unit)의 약자로, 특수 기능 장치(special function unit, SFU)라고도 합니다. MUFU.RSQ 명령어는 레지스터 값을 SFU 장치의 루트 제곱(Root Square) “파이프라인"을 통해 전달합니다. SASS 어셈블리에는 FMUL(Fused Multiply)이나 FFMA(Fused Multiply and Accumulate)와 같이 텐서 코어 장치로 전달되는 다른 많은 명령어들이 있습니다. 디스패치 장치는 명령어를 올바른 파이프라인 장치로 전달하는 역할을 합니다.
주목할 만한 세 가지 사항이 있습니다:
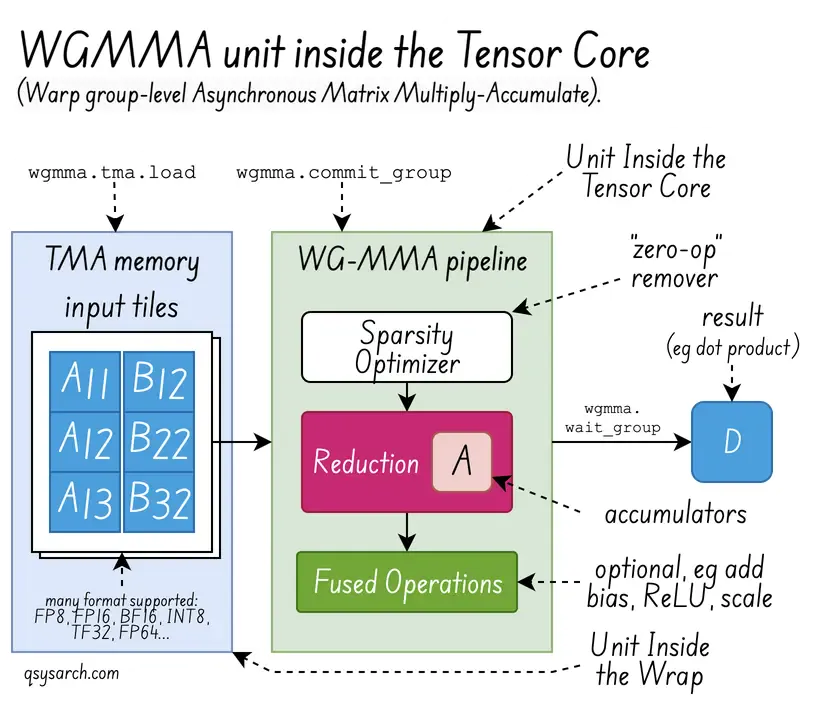
텐서는 일반 행렬 곱셈기(GEMM)보다 훨씬 더 많은 기능을 제공합니다. 예를 들어, 텐서 코어 내부에 있는 MMA (행렬 곱셈-누적) 유닛을 통해 축소 연산(합계, 최소/최대, 내적)을 수행할 수 있습니다.
INT32유닛과 레지스터의 차이점:INT32유닛은 연산(예: ADD, SHIFT, XOR 등 또는 더 일반적으로 산술 연산, 즉 ALU)을 담당하는 반면, 레지스터는 값을 저장하는 역할을 합니다.INT32유닛은 16개뿐이지만 스레드는 32개입니다. 이는 오류가 아닙니다. 워프 스케줄러가 매 사이클마다 두 개의 스레드 세트를 번갈아 사용하기 때문입니다. 따라서 0번째 사이클에는 유닛이 스레드 015에 대해 ALU 연산을 수행하고, 1번째 사이클에는 스레드 1631에 대해 ALU 연산을 수행합니다.
비동기 워프그룹 레벨 행렬 곱셈-누적 명령어(WGMMA)는 매우 강력합니다. NVIDIA 문서와 Aleksa Gordić의 훌륭한 블로그에서 더 자세한 내용을 확인할 수 있습니다.
NVIDIA CUDA 컴파일러 아키텍처 Link to heading
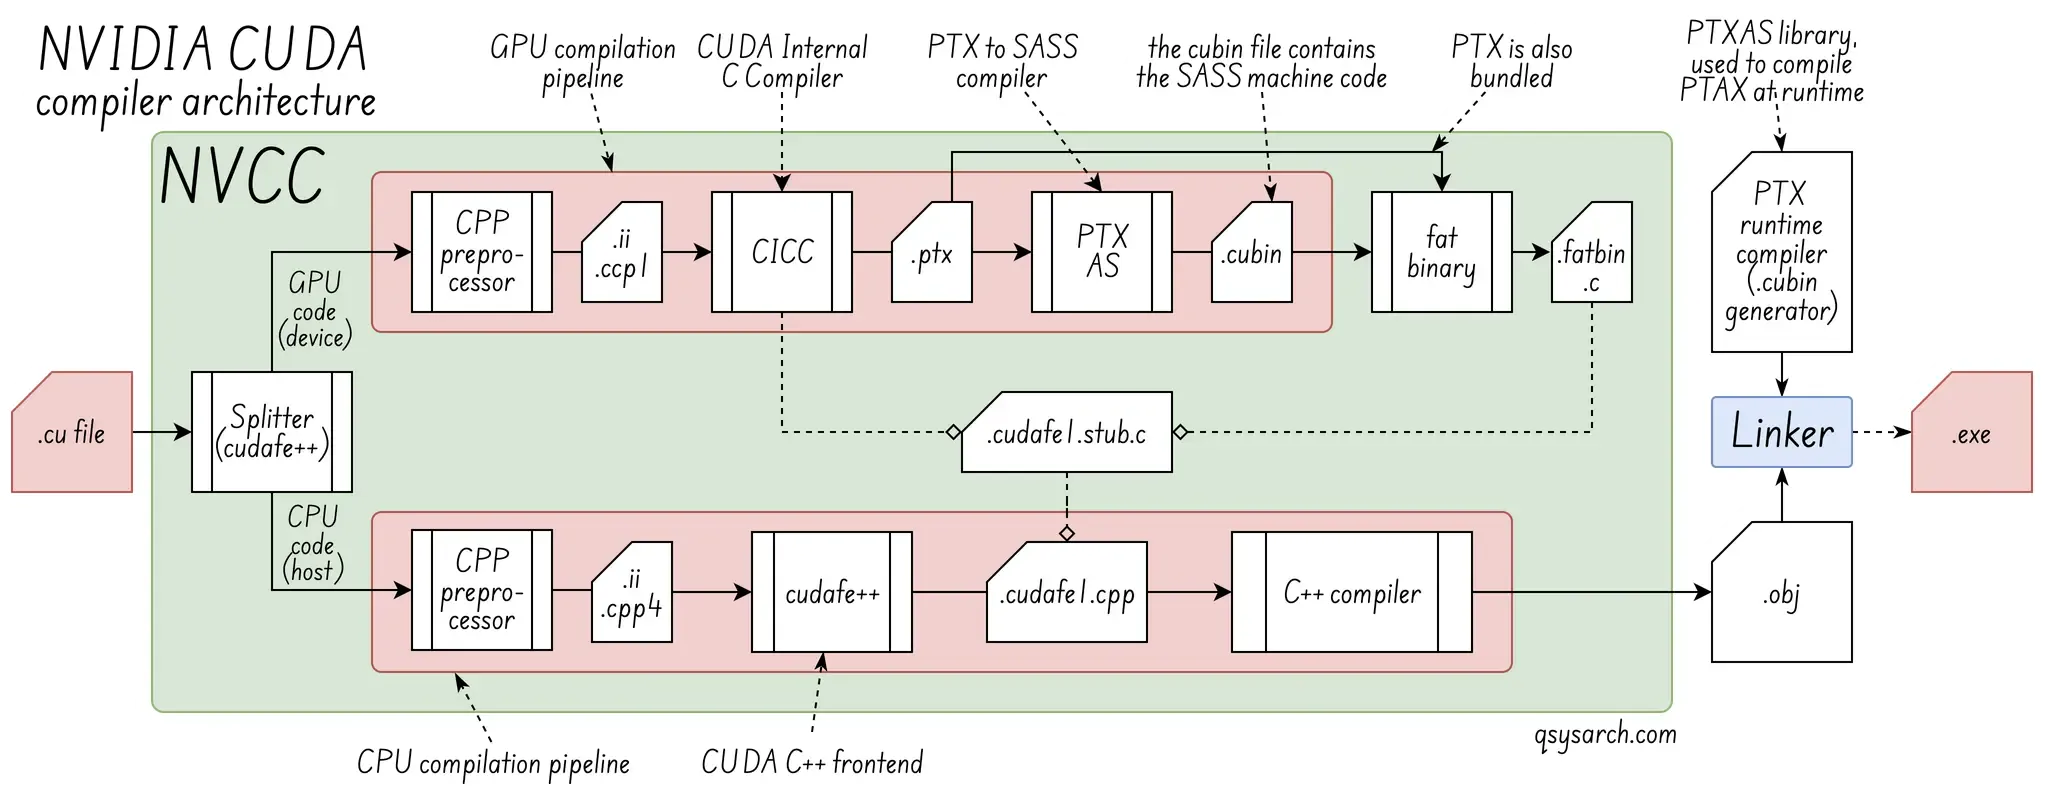
이제 GPU 스트리밍 멀티프로세서를 프로그래밍하기 위한 GPU의 저수준 ISA에 대해 조금 더 이해했으니, 고수준 C++ 커널이 SASS로 컴파일되는 방식을 알아보겠습니다. CUDA 커널(.cu 파일)을 PTX로 변환하는 데 사용되는 컴파일러는 NVCC라는 것을 알고 있습니다.
그렇다면 NVCC와 LLVM의 차이점은 무엇일까요? NVCC는 오픈소스 LLVM 컴파일러 인프라를 백엔드로 사용하는 특수 컴파일러 드라이버입니다. 반면 LLVM은 NVCC처럼 바로 사용할 수 있는 컴파일러가 아니라 유연한 컴파일러 프레임워크입니다.
CUDA 컴파일러(NVCC) Link to heading
드라이버 프로그램: NVCC는 CUDA C/C++ 코드 컴파일 프로세스를 관리하는 드라이버입니다. 호스트(CPU) 코드와 장치(GPU) 코드를 분리합니다.
툴체인: NVCC는 CPU 코드 처리를 위해 호스트 C++ 컴파일러(예: Linux의 GCC/Clang)를 사용하고, GPU 코드(PTX 및 SASS) 처리를 위해 NVIDIA 전용 내부 컴파일러(예: CICC)를 사용하는 툴체인입니다.
대용량 바이너리: NVCC는 일반적으로 호스트 실행 파일과 컴파일된 GPU 코드를 모두 포함하는 “대용량 바이너리"를 생성하며, 종종 다양한 GPU 아키텍처용 여러 버전을 제공합니다.
LLVM Link to heading
프레임워크: LLVM은 다양한 컴파일러 및 언어 툴체인을 구축하도록 설계된 무료, 오픈 소스, 모듈식 및 재사용 가능한 컴파일러 기술, 라이브러리 및 도구 모음입니다.
중간 표현(IR): LLVM IR은 프런트엔드(C++, Go 등)와 ISA 백엔드(x86, ARM 등) 사이의 범용 연결 고리 역할을 하는 머신에 구애받지 않는 “중간 계층"입니다.
최적화: LLVM 최적화 프로그램은 소스 언어나 대상 아키텍처와 관계없이 IR에 다양한 성능 향상(예: 루프 언롤링 및 데드 코드 제거)을 적용합니다.
LLVM이 CUDA를 컴파일할 수 있다는 점은 주목할 만합니다. LLVM 프로젝트의 일부인 Clang 프런트엔드는 nvcc 드라이버 없이도 LLVM PTX 백엔드를 사용하여 CUDA 코드를 처리할 수 있습니다.
Triton 컴파일러 아키텍처 Link to heading
Triton 언어는 강력한 Python 기반 도메인 특화 언어(DSL)로, GPU 타겟용으로 효율적인 병렬화 코드로 컴파일될 수 있는 고수준 벡터화 알고리즘을 생성하는 데 도움을 주기 위해 설계되었습니다.
이것은 메모리 블록에서 데이터를 로드하여 다른 블록에 쓰는 가장 간단한 커널의 예입니다. offsets 값은 _[pid*BLOCK_SIZE….(pid+1)*BLOCK_SIZE-1]_입니다. 이 코드 조각에는 나와 있지 않지만, Triton은 math 연산과 같은 작업을 통해 벡터 _v_에 효율적으로 접근할 수 있습니다.
import triton.language as tl

@triton.jit
def move_kernel(in_ptr, out_ptr, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(axis=0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    v = tl.load(x_ptr + offsets)
    tl.store(output_ptr + offsets, v)
Triton은 1차원 벡터에만 국한되지 않고 텐서를 사용하여 더 많은 차원을 처리할 수 있습니다. 예를 들면 다음과 같습니다.
import triton.language as tl

@triton.jit
def load_2d_tensor( input_ptr, output_ptr,
    stride_row, stride_col,  # Stride of the input tensor (elements per row, elements per column)
    M , N , # Number of rows and columns
    BLOCK_SIZE_M,BLOCK_SIZE_N, # Block size for rows and columns
):
    # X and Y tile position
    pid_m, pid_n = tl.program_id(axis=0), tl.program_id(axis=1)
    # Ptr in memory based on the stride
    base_ptr = input_ptr + (pid_m * BLOCK_SIZE_M * stride_row) + (pid_n * BLOCK_SIZE_N * stride_col)
    # Offsets for X and Y indices
    offs_m, offs_n = tl.arange(0, BLOCK_SIZE_M), tl.arange(0, BLOCK_SIZE_N)
    offsets_2d = (offs_m[:, None] * stride_row) + (offs_n[None, :] * stride_col)
    # 2D loading ...that's magic!
    loaded_2d_tensor = tl.load(base_ptr + offsets_2d)
    return loaded_2d_tensor
CUDA와 비교했을 때, Triton은 신경망 커널 구축에 특화된(텐서 블록 방식 덕분) 고수준 추상화 계층으로 볼 수 있으며, 효율적인 벡터화된 병렬 GPU 코드를 생성할 수 있습니다. 또한 Triton은 여러 백엔드 GPU를 지원합니다.
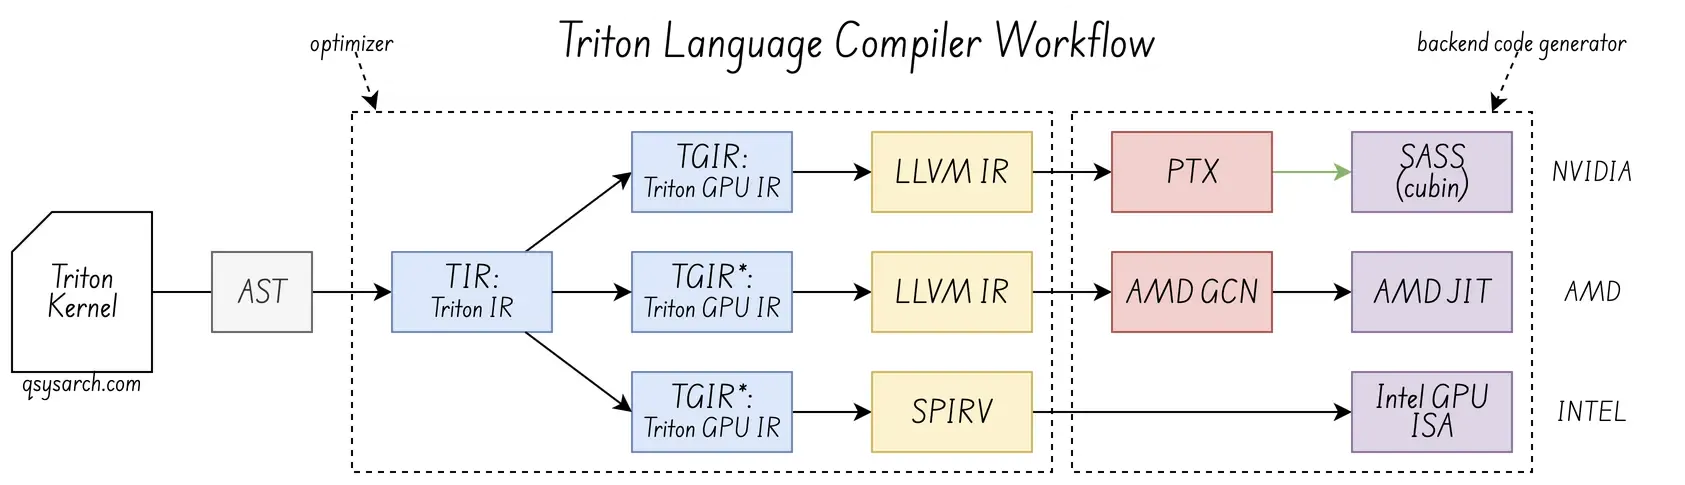
Triton은 자체 언어 파서를 사용하지 않습니다. 대신 Python의 런타임과 AST(추상 구문 트리)를 활용하여 해당 AST를 TIR 및 TGIR이라는 자체 중간 표현으로 변환한 후 GPU 코드를 생성합니다. CUDA 백엔드 컴파일러와 Triton 프런트엔드 컴파일러 간의 연결은 범용 LLVMIR을 기반으로 하며, Intel GPU의 경우 SPIRV을 기반으로 합니다. (다만 TGIR이 중간 LLVMIR을 거치지 않고 SPIRV로 직접 변환되는지는 확실하지 않습니다.)
타일링 Link to heading
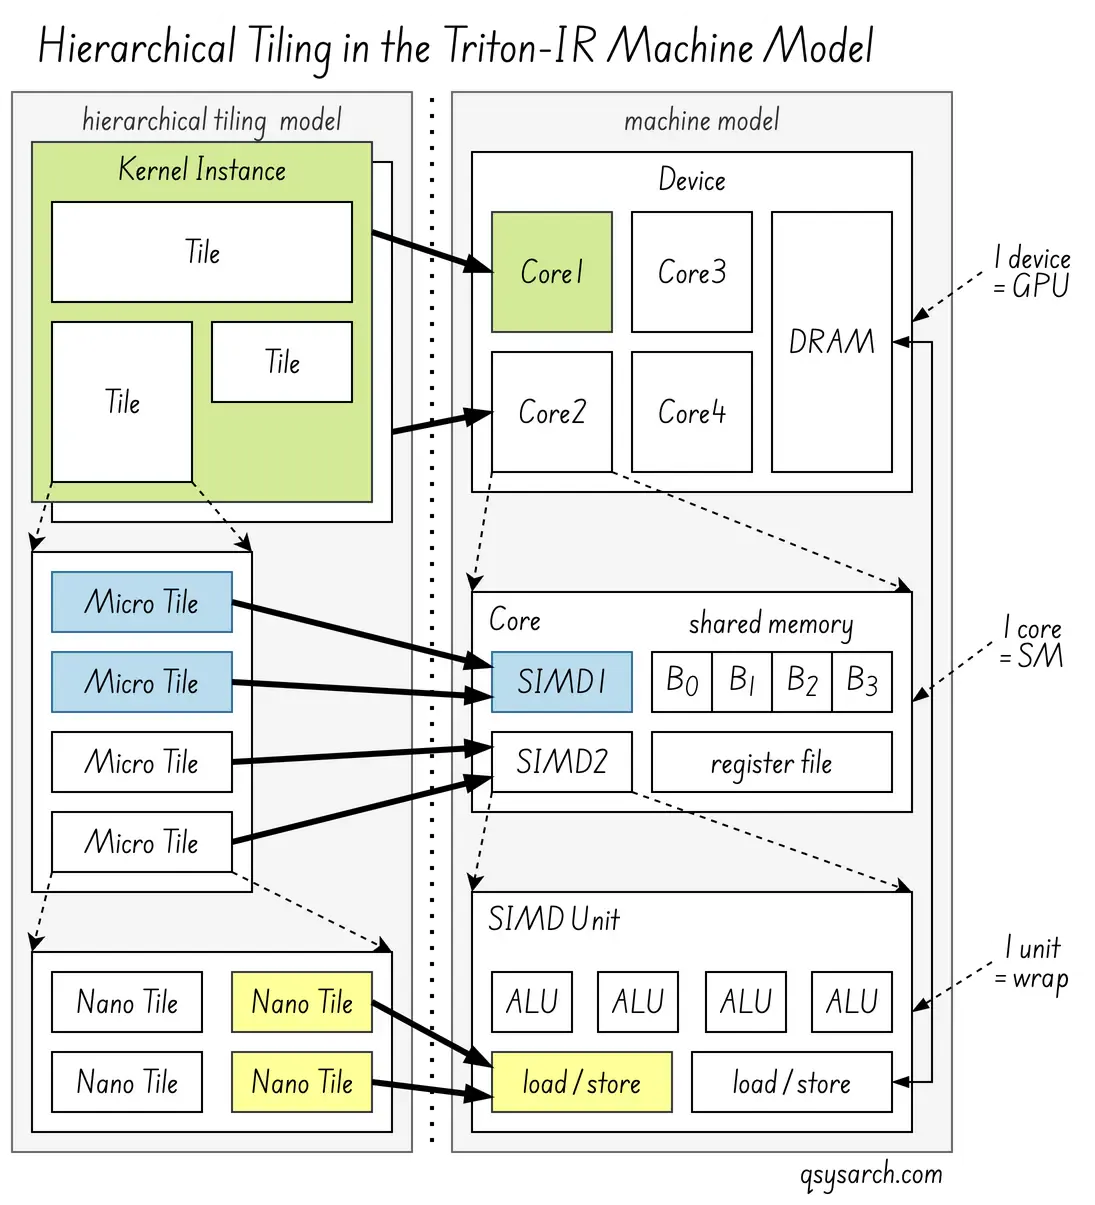
“벡터화된 알고리즘"이라고 썼지만, 핵심 개념은 타일형 블록 수준 모델에 더 초점을 맞추고 있습니다. 타일링이 주요 메커니즘입니다. Triton의 사고방식은 작고 정적인 형태의 다차원 부분 배열, 즉 “타일"에 대한 연산을 프로그래밍하는 것을 중심으로 하며, 컴파일러는 이를 GPU 코어 전체에 걸쳐 자동으로 병렬화합니다.
벡터화는 여러 데이터 요소를 단일 명령어로 로드/저장하는 것으로, 최적화 기법입니다. 컴파일러는 이를 핵심적인 내부 최적화 전략으로 활용하여 하드웨어에서 타일을 효율적으로 구현합니다. 이러한 개념은 중첩 타일링 전략(오른쪽 그림 참조)과 일맥상통하는데, 이 전략은 타일을 마이크로 타일, 나아가 나노 타일로 분해하여 컴퓨터의 연산 능력과 메모리 계층 구조에 최대한 효율적으로 맞추는 것을 목표로 합니다.
Triton 언어 단계 낮추기(스트리밍 어셈블리로) Link to heading
트라이톤 언어의 고급 명령어인 tt.load가 SASS로 어떻게 낮춰지는지 살펴보겠습니다. (참고: 아래 코드는 의사 코드이며, 실제 작동하는 코드는 아닙니다.)
트리톤 IR(TIR) Link to heading
파이썬 AST를 파싱한 후 초기 단계는 기계 독립적인 Triton IR(TIR, MLIR의 한 방언)입니다. 이 단계에서 타일에 대한 tt.load 연산이 정의되며, tt.load 연산은 전체 타일의 메모리 로드를 표현하는 고수준의 최적화되지 않은 명령어입니다. 타일은 단일 배열일 수도 있고, 2차원 배열이거나 임의의 차원을 가진 배열일 수도 있습니다.
// simplified, illustrative TTIR fragment for 2 dimensionnal array
// load of 32 bits floating point values (without masks)
%ptrs = ...              : tt.tensor<MxN, ptr<global f32>>
%vals = "tt.load"(%ptrs) : (tt.tensor<MxN, ptr<global f32>>) -> tt.tensor<MxN, f32>
텐서 포인터와 데이터 블록(타일)에 대한 상위 수준 tt.load 연산입니다. 첫 번째 입력 매개변수 %ptrs는 tensor로 표현되는 _n_차원 배열인 _tensor_입니다. <MxN, ptr>는 동일한 차원의 텐서를 반환하지만, 값에 대한 포인터 대신 값을 포함합니다.
실제로 tt.load 함수는 마스크와 기본값 매개변수를 받는데, 이는 메모리 경계에서 데이터를 읽을 때 필요합니다(벡터 크기가 스트라이드에 맞춰 정렬되지 않은 경우).
%ptrs = ... : tensor<MxN, ptr<global f32>>
%mask = ... : tensor<MxN, i1>         // in-bounds mask (optional)
%fallback = constant 0.0 : f32
%vals = "tt.load"(%ptrs, %mask, %fallback) : (tensor<MxN, ptr<global f32>>, tensor<MxN, i1>, f32) -> tensor<MxN, f32>
Triton-GPU IR (TTGIR / TGIT) Link to heading
다음 단계에서는 Triton-GPU IR을 사용하여 일반적인 텐서 레이아웃을 하드웨어별 레이아웃, 특히 스레드와 워프에 걸친 메모리 레이아웃 및 분산과 관련된 레이아웃으로 변환합니다. 다시 말해, TGIT는 n 차원의 로드 작업을 LLVM에서 처리하기 쉬운 스레드별 벡터 로드 연산으로 확장합니다.
// TGIR (illustrative)
%vec_ptr = tt.get_contiguous_vector_ptr %ptrs, vec_len=4
%vec_vals = ttg.load.global.v4f32 %vec_ptr  // a vectorized 4-wide global load
%vec_vals_cast = f32x4 -> f32  // unpack to tensor<MxN, f32> shape
LLVM IR (LLIR) Link to heading
Triton-GPU IR은 LLVM IR로 표현되는 스레드별 명령어로 변환됩니다. 이 저수준 IR은 최종 머신 명령어를 거의 그대로 나타내며 포인터 연산, 메모리 로드, 동기화 기본 요소와 같은 표준 LLVM 연산을 사용합니다. 텐서 추상화는 대부분 사라지고 각 스레드에 대한 개별 메모리 접근 연산으로 대체됩니다.
// Example LLVM IR snippet (conceptual)
%thread_ptr = getelementptr inbounds float, ptr %base_ptr, i64 %thread_offset
%value = load float, ptr %thread_ptr, align 4
표현 방식: 타일 로드는 각 스레드의 특정 데이터 요소에 대한 포인터 연산을 포함하는 일련의 개별 로드 명령으로 분할되며, 공유 메모리가 스테이징 영역으로 사용된 경우 공유 메모리 연산이 포함될 수도 있습니다.
PTX 어셈블리 Link to heading
LLVM 백엔드가 NVIDIA GPU를 대상으로 할 때, 다음 단계는 PTX로 다운그레이드하는 것입니다. LLVM 로드 명령어는 해당 PTX 로드 명령어에 직접 매핑됩니다.
// Example PTX snippet
ld.global.f32 %r1, [%thread_ptr]; // Load from global memory
// Or if staged via shared memory:
ld.shared.f32 %r1, [%shared_ptr];
SASS Link to heading
마지막으로 NVIDIA 드라이버 컴파일러(ptxas)는 PTX 어셈블리 코드를 SASS(스트리밍 어셈블리)로 변환하는데, 이는 GPU 코어에서 실행되는 실제 네이티브 머신 코드입니다. 앞서 살펴본 바와 같이, 이 단계는 일반적으로 JIT(Just-In-Time) 방식으로 수행됩니다.
// Example SASS snippet (conceptual, might involve specific opcodes)
MOV R1, ...
LDG.E.32 R1, [R0]; // Load from global memory
DeepSeek의 접근 방식 Link to heading
주목할 만한 점은 CUDA가 NVIDIA GPU용 머신 코드를 생성하는 매우 편리한 방법이라는 것입니다. Triton은 PTX를 SASS로 변환할 때 CUDA를 사용합니다. PTX로의 변환은 LLVM IR에서 수행되지만, CUDA 툴킷에 포함된 라이브러리(예: libdevice.bc)가 필요합니다.
 DeepSeek는 다른 접근 방식을 택하여 수동 PTX 최적화를 선택했습니다. PTX를 GPU용 어셈블리 언어로 취급하여 사용자 지정 PTX 커널 헬퍼를 수동으로 작성했습니다. DeepSeek는 이러한 특수하고 매우 비표준적인 코드를 생성하기 위해 범용 컴파일러에 의존하지 않았습니다. 반면에 Triton은 범용 언어이므로 표준 LLVM 컴파일러 백엔드와 NVPTX 타겟을 사용하여 중간 표현(Triton-IR/MLIR)을 최적화된 PTX 어셈블리 코드로 자동 변환합니다.
 DeepSeek 래퍼는 csrc/kernels/utils.cuh에서 mbarrier.try_wait 명령어를 사용합니다.
왜 이것이 중요할까요? DeepSeek 기술 보고서(https://arxiv.org/html/2412.19437v1)에서 인용한 내용입니다. “구체적으로, DeepSeek은 맞춤형 PTX(병렬 스레드 실행) 명령어를 사용하고 통신 청크 크기를 자동 조정하여 L2 캐시 사용량과 다른 SM(서비스 모듈)과의 간섭을 크게 줄입니다.” 그렇다면 LLVM NVPTX 백엔드는 최적의 효율을 내지 못하는 것일까요? 제 생각에는 이는 LLVM 수준뿐만 아니라 더 나은 베어메탈 ISA(국제화 정보 시스템)(https://medium.com/prompt-engineering/deepseek-and-deepep-understanding-deep-seeks-custom-cuda-ptx-instruction-214d5408de6a)를 노출하는 측면에서도 추가적인 최적화의 여지가 있음을 의미합니다! 이는 모두에게 이익이 되는 상황입니다!
결론 Link to heading
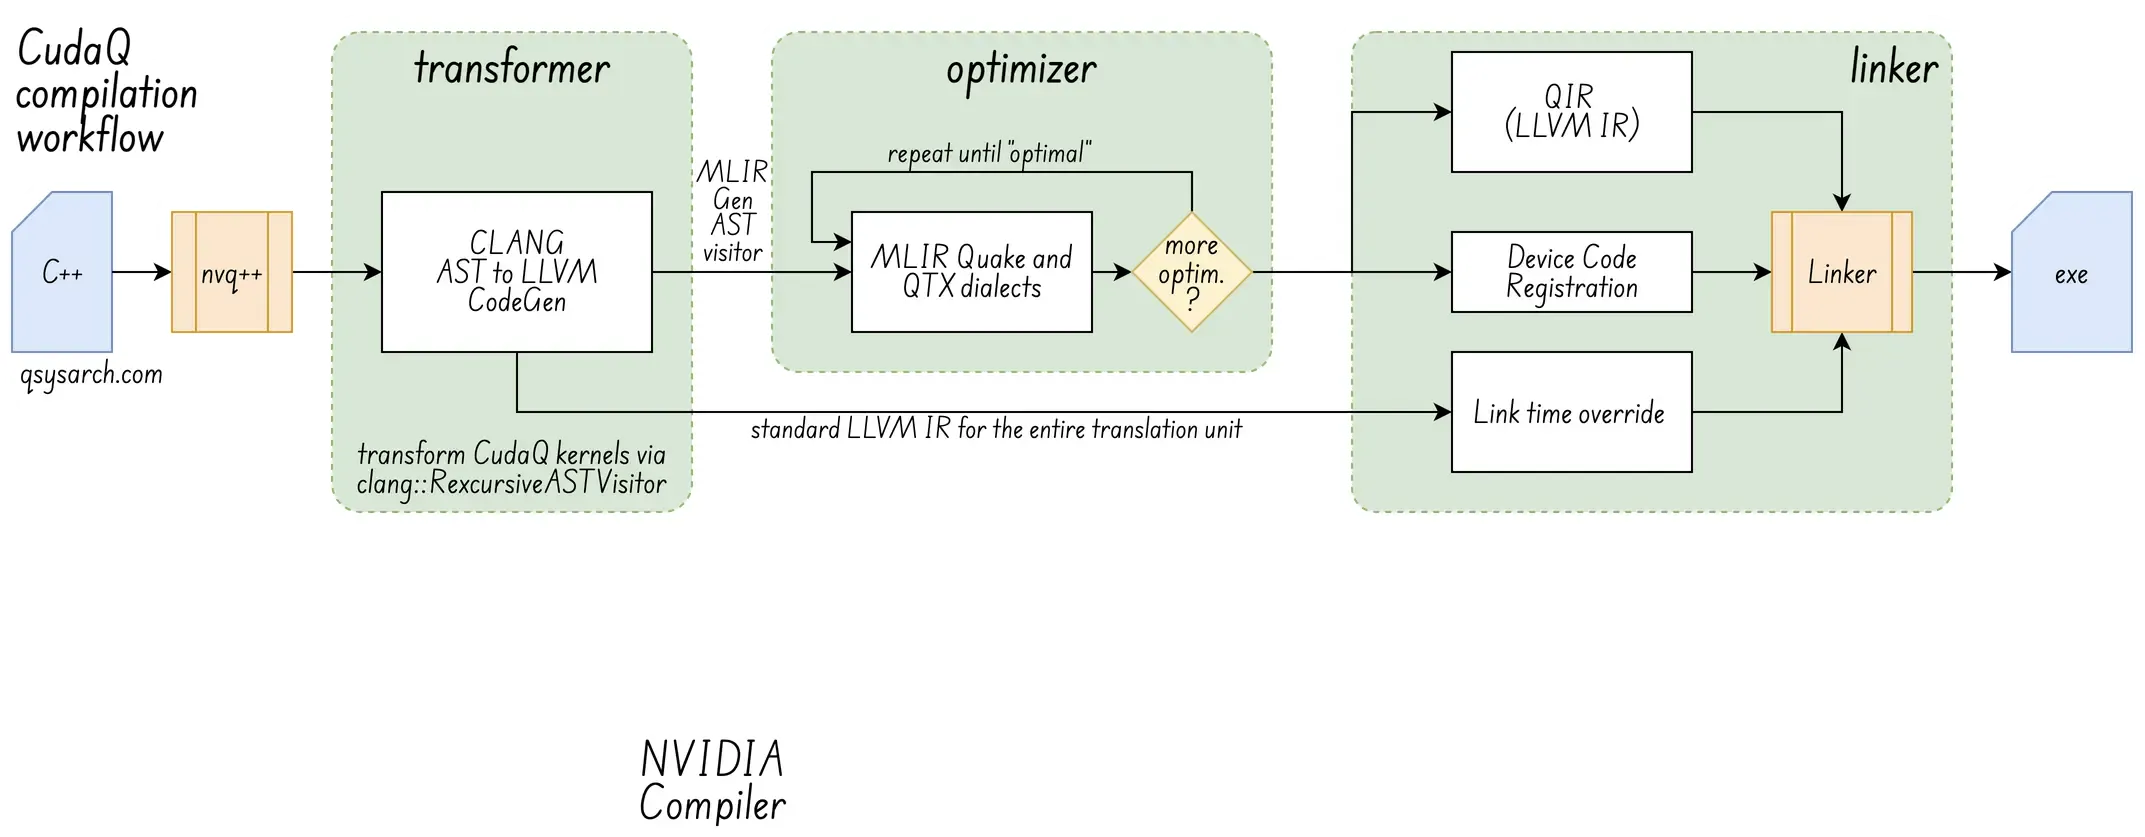
자, 이 메모를 작성하는 데 또 예상보다 시간이 오래 걸렸습니다. 하지만 이는 Cuda-Q 아키텍처를 소개하기 전에 반드시 필요한 사전 연구 작업입니다. 준비가 완료되면 이 게시물을 업데이트하겠습니다.
 (이미지 출처: LLVM MOS)
References Link to heading
- Deep Seek using baremetal PTX
- Usable assembly language for GPUs : a success story
- Debugging Your CUDA Applications With CUDA-GDB
- What is Streaming Assembler? SASS
- NVIDIA H100 Tensor Core GPU Architecture
- Inside NVIDIA GPUs: Anatomy of high performance matmul kernels
- The process of a CUDA program compilation using the NVCC toolchain
- Deep Dive into Triton Internals
- A Deep Dive Into AMD Triton Compilation
- Triton Kernel Compilation Stages
- Textual Alignment in SPMD Programs
- Compilers and IRs: LLVM IR, SPIR-V, and MLIR
DrawIO diagrams used in this memo: