최근에 용량 및 효율성 엔지니어링이라는 개념을 접하게 되었습니다. 이는 시스템을 최적의 방식으로 설계하고 운영하는 분야입니다. 시스템 아키텍처의 핵심 요소이며, 특히 양자 컴퓨팅 시스템처럼 규모가 중요한 경우에 매우 중요합니다.
간단히 말해, 용량 및 효율성 엔지니어링은 생산을 최적화하는 과학 또는 학문 분야입니다. 이는 최대 생산량(용량)과 자원 소비(효율성) 사이의 균형을 맞춤으로써 달성됩니다.
용량 및 효율성 엔지니어링(CEE)의 장점은 잘 정의된 영역이며, 관련 문헌이 풍부하고, 체계적인 엔지니어링 실무가 뒷받침된다는 점입니다. 이 메모에서는 CEE에서 사용되는 몇 가지 핵심 개념을 살펴보겠습니다.
용량 및 효율성 엔지니어링 핵심 요소 Link to heading
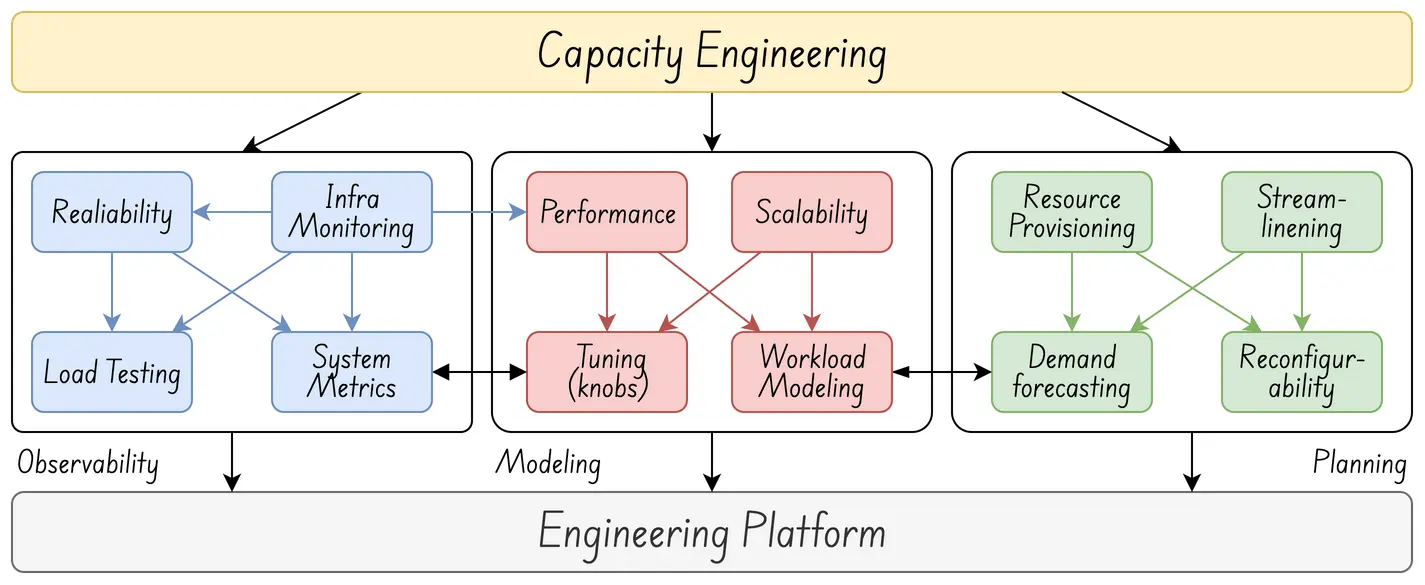
용량 및 효율성 엔지니어링은 관측 가능성, 모델링, 계획이라는 세 가지 핵심 기둥을 기반으로 합니다.
관측 가능성
모델링
계획
궁극적인 목표는 모델을 사용하여 효과적으로 시뮬레이션할 수 있는 계획을 수립하는 것입니다. 이 모델은 실제 관찰 결과와 비교하여 검증되어야 합니다. 성장 모델링, 병목 현상 파악, 그리고 자원의 전략적 배분을 통해 계획은 과부하 또는 자원 활용 부족을 방지하고 최적의 시스템 운영을 보장합니다.
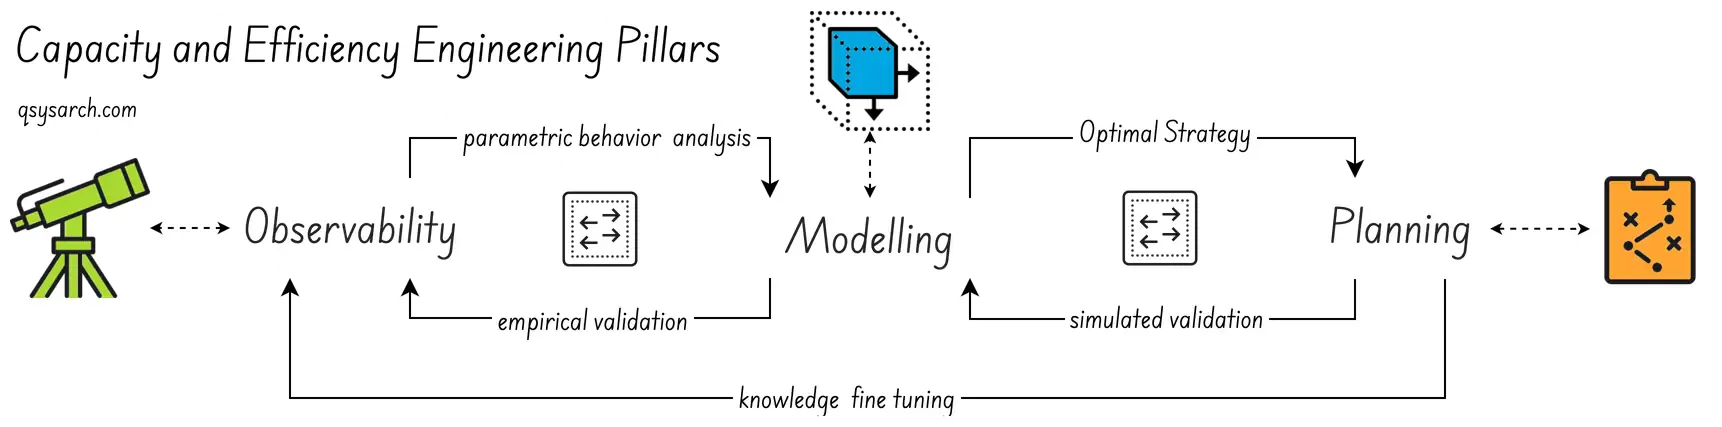
여기서 시스템 리소스는 무엇이든 될 수 있다는 점에 유의해야 합니다. CPU나 메모리와 같은 IT 리소스부터 직원이나 장비에 이르기까지 다양할 수 있습니다. 실제로 CEE는 다양한 분야에 적용될 수 있습니다. 예를 들어 프로젝트 관리에서 인력 배치를 최적화하거나 인프라 관리에서 클라우드 호스팅 비용을 절감하는 데 도움이 될 수 있습니다.
관찰 가능성
 Link to heading
관찰 가능성은 시스템에 대한 _경험적 분석_입니다. 컴퓨팅 시스템에서 로그는 종종 관찰 가능성과 혼동되지만, 로그는 전체 그림의 일부일 뿐입니다. 예를 들어, OpenTelemetry 표준은 로그, 메트릭, 트레이스, 그리고 부가 데이터(baggage)와 같은 여러 가지 관찰 가능한 _신호_를 포괄합니다. CEE(컴퓨터, 엔지니어링 및 엔지니어링) 분야에서 효과적인 관찰 가능성은 다음과 같은 사항을 제공해야 합니다.
자원 사용량: 자원 소비를 관찰하고 추적합니다. 관찰 결과에는 자원이 언제, 어떻게, 누구에 의해 사용되었는지, 그리고 오류 발생 여부가 명시되어야 합니다.
성능 지표: 지연 시간 및 처리량과 같은 주요 성능 지표(KPI)를 추적합니다. 수율, 낭비율 또는 오류율도 포함됩니다.
병목 현상 식별: 시스템 처리량을 저하시키는 제약 요소를 정확히 파악합니다.
핵심은 시스템에 대한 사후 분석을 모든 조건, 즉 부하가 높은 시기, 유지보수 기간, 유휴 기간 등에서 수행할 수 있어야 한다는 것입니다. 무엇이, 언제, 왜 발생했는지 자세히 이해하는 것이 중요합니다. 이러한 관찰 가능한 데이터가 없다면 시스템 장애의 근본 원인을 파악하는 것은 불가능합니다.
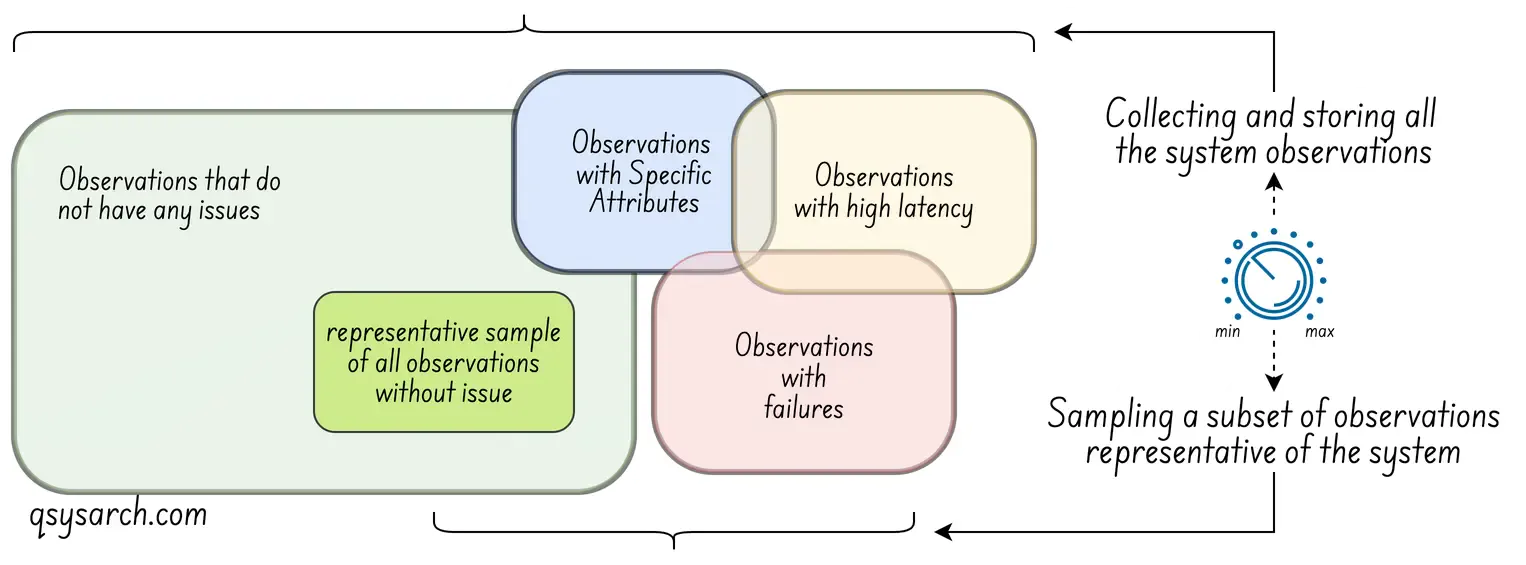
물론, 전체 시스템에 대한 모든 관측 데이터를 수집하는 데에는 어려움이 있습니다. 관측은 매우 비용이 많이 들거나 심지어 시스템을 파괴할 수도 있습니다(양자 컴퓨팅의 경우처럼 시스템을 측정하는 것만으로도 시스템의 상태가 변할 수 있는데, 이를 관측자 효과라고 합니다). 즉, 단순히 시스템을 관측하는 행위만으로도 시스템의 동작이 바뀌고 성능이 저하될 수 있다는 뜻입니다. 이러한 문제를 해결하기 위한 방법이 바로 샘플링(모든 이벤트가 아닌 일부 이벤트에서만 데이터를 수집)입니다. 샘플링 속도(데이터 수집 빈도)를 조정 가능한 시스템 매개변수로 만드는 것이 핵심이며, 아래 그림에서 확인할 수 있습니다(출처: OpenTelemetry(https://opentelemetry.io/docs/concepts/sampling/)).

컴퓨팅 시스템이 아닌 경우, 효과적인 관찰 가능성은 예를 들어 프로젝트가 지연되는 이유를 설명하는 데 도움이 될 수 있습니다. 관찰 가능한 데이터는 각 프로젝트 단계에서 이루어진 추적 가능한 결정을 설명하는 ISO9001에서 요구하는 기술 및 비기술 문서일 가능성이 높습니다.
모델링
 Link to heading
관측 가능성이 확보되면 시스템의 분석적 매개변수 동작을 이해하기 시작할 수 있습니다. 이 동작은 다음 단계의 토대가 됩니다. 즉, 이 동작을 설명하고 매개변수 모델로 변환할 수 있습니다. 다음 단계는 주어진 매개변수 또는 조건에 따라 이러한 모델이 무엇을 제공해야 하는지 명확히 하는 것입니다.
성능: 시스템이 제공할 수 있는 최대 처리량과 지연 시간은 얼마입니까?
운영 비용: 할당된 자원 수를 기준으로 시스템을 운영하는 데 드는 비용은 얼마입니까? 이 비용은 시간대에 따라 달라질 수 있습니다.
재구성: 시스템 매개변수를 업데이트할 때 발생하는 일시적인 영향(단기적 효과)은 무엇입니까? 예를 들어, 새 서버 또는 QPU를 할당하고 올바르게 구성할 때 발생하는 영향은 무엇입니까?
핵심은 시스템 동작을 시뮬레이션하고 다양한 운영 조건에서 성능을 관찰하는 것입니다. 모델에는 자원 비용이 포함되어 있으므로 이러한 조건에서 비용 상충 관계를 보여줄 수 있습니다. 이 정보는 계획 단계에서 중요합니다.
여기서 시뮬레이션과 에뮬레이션의 차이점을 언급할 필요가 있습니다. 간단히 말해, 에뮬레이션은 시스템의 모의 버전을 생성하는 반면, 시뮬레이션은 시스템의 추상적인 모델을 기반으로 작동합니다. 에뮬레이션을 사용하면 입력값이 동일하기 때문에 에뮬레이션된 성능과 실제 성능을 비교할 수 있습니다. CEE(컴퓨터공학 및 엔지니어링) 분야에서 여기서 모델은 주로 시뮬레이터를 의미한다고 가정합니다.
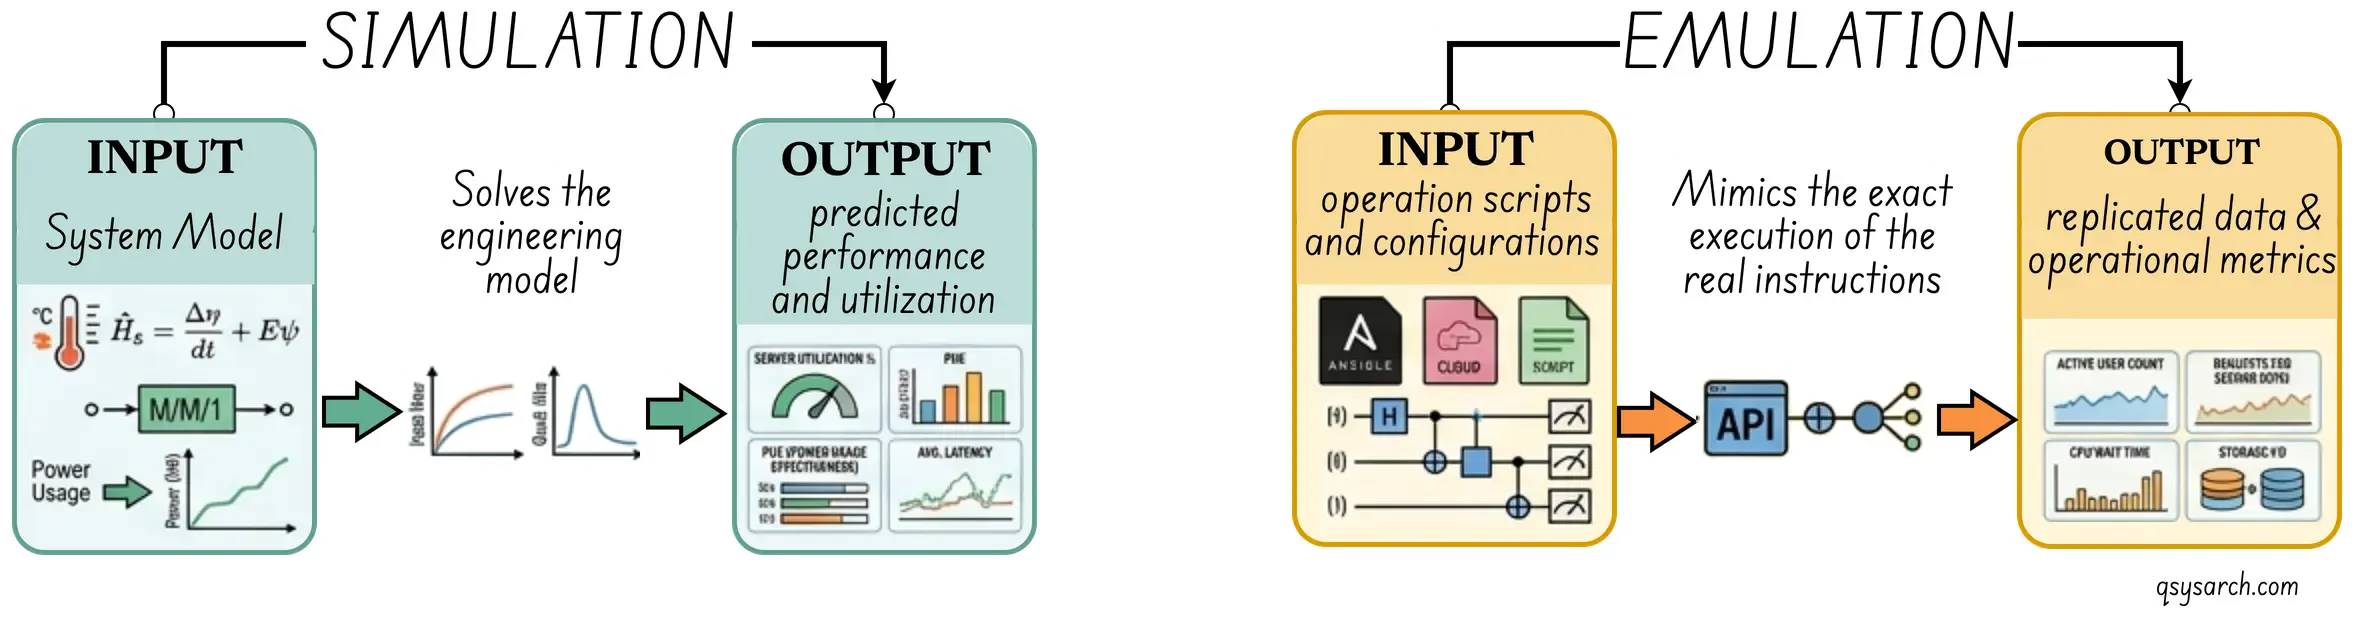
컴퓨팅 시스템이 아닌 경우, 좋은 모델은 프로젝트에 자원을 추가했을 때의 영향을 예측할 수 있습니다. 실제로 자원을 추가하면 시스템 성능이 저하되는 경우가 있습니다. 이러한 직관에 반하는 결과는 브룩스의 법칙(Brooks’s Law)으로 알려져 있습니다.
계획 수립
 Link to heading
모델을 활용하면 시스템 운영 계획을 수립할 수 있습니다. 모델을 사용하여 다양한 조건을 시뮬레이션하고 최적의 조건을 찾으세요. 이러한 결과를 바탕으로 수요에 맞춰 자원을 전략적으로 배분하십시오. 효과적인 계획에는 수요 예측, 비용 관리, 그리고 장애 조치가 포함되어야 합니다. 예측은 미래의 사용량, 트래픽 또는 필요량을 예측하는 것입니다. 비용 관리는 과잉 공급을 방지하면서 피크 시간대의 용량을 유지하는 것을 목표로 합니다. 장애 조치는 예상치 못한 수요에 대응할 수 있는 완충 장치를 제공합니다.
핵심은 시스템을 효율적이고 안정적으로 운영하는 것입니다. 최대 부하를 오류 없이 처리하고, 비용 효율성을 보장해야 합니다. 예측된 용량을 통해 사전 재구성이 가능하며, 예상치 못한 상황에 대비할 수 있는 충분한 여유 용량을 확보해야 합니다.
이 계획은 수요가 예상대로 발생하는 최상의 시나리오와 수요가 예상보다 높거나 낮은 최악의 시나리오를 모두 고려합니다. 이러한 접근 방식을 통해 비용 효율적인 생산 능력 배분을 달성할 수 있습니다.
모델 미세 조정 Link to heading
닭과 달걀의 딜레마 Link to heading
좋은 모델을 설계하는 것은 닭과 달걀의 문제와 같습니다. 시스템에서 무엇을 관찰해야 하고 어떻게 관찰해야 하는지 알지 못하면 효율적이고 정확한 모델을 구축하기 어렵습니다. 정확한 모델이 없으면 계획이 좋은 결과를 내기 어렵습니다.
시뮬레이션 계획과 실제 동작 사이에 불일치가 발생하면 누락된 매개변수를 찾으려고 합니다. 이는 일반적으로 사후에 관찰 대상 시스템의 로그를 분석하여 수행됩니다. 목표는 관찰할 새로운 매개변수를 식별하는 것입니다.
위 그림에서 이 학습 과정은 ‘지식 미세 조정’으로 표현됩니다.
엔지니어링 플랫폼 Link to heading
CEE 자체만으로는 전체 워크플로우를 지원하는 자동화 플랫폼이 없으면 충분하지 않습니다. 이 엔지니어링 플랫폼은 아래 다이어그램에 나타나 있습니다.
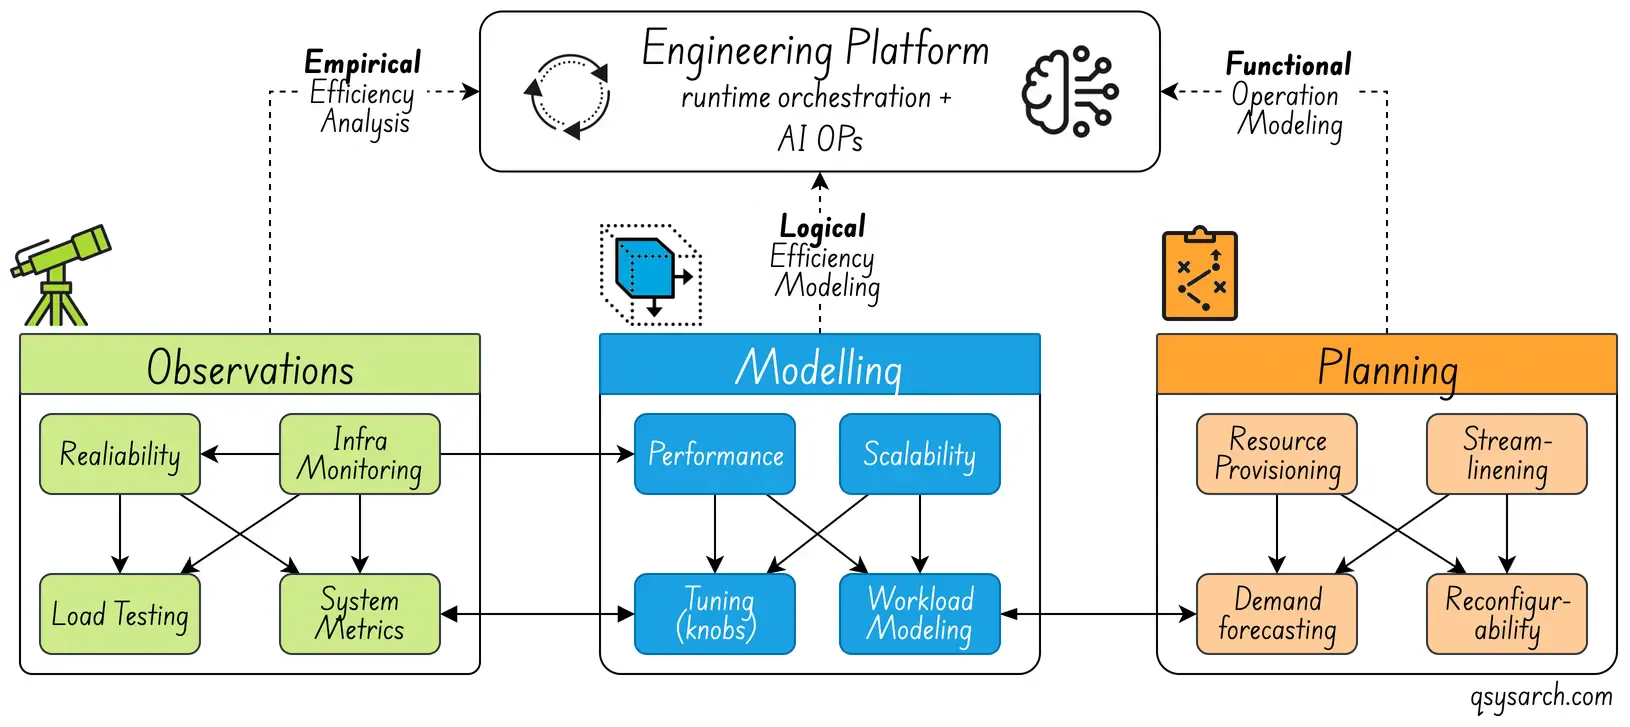
엔지니어링 플랫폼의 핵심 아이디어는 시스템 확장 및 축소 프로세스를 자동화하는 것뿐만 아니라(이 작업은 AI 운영(AI Ops) 에이전트에 위임할 수 있습니다), 시뮬레이션 모델의 적합성을 실제 관찰 결과와 지속적으로 비교 검증하고, 그 차이점을 머신러닝(ML) 에이전트에 피드백하여 모델을 미세 조정하는 것입니다. 이 에이전트는 강화 학습 기반 에이전트일 가능성이 높으며, 실시간으로 사용될 경우 거버넌스(GOvernance)가 필수적입니다.
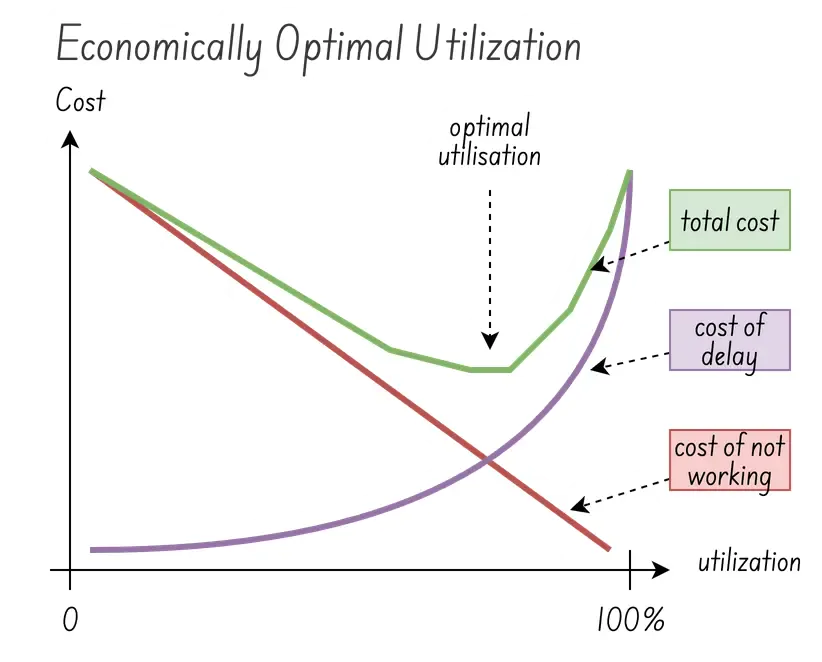
확장 속도가 충분히 빠르지 못할 때 발생하는 비용, 즉 지연 비용. Link to heading
시스템이 안정적이고 견고하려면 성능을 최대치가 아닌 안정적인 수준으로 제한해야 합니다. 일반적으로 안정적인 성능은 최대 성능의 약 3분의 2 정도입니다. 이 임계값을 넘어서면 시스템 성능이 저하됩니다. 그러면 시스템 다운타임으로 인한 비용이 과잉 공급으로 인한 비용을 빠르게, 때로는 기하급수적으로 초과할 수 있습니다.
오른쪽 이미지에서 지연 비용은 시스템 확장(실시간) 중에 수요를 충족하지 못함으로써 발생하는 재정적 영향으로 볼 수 있습니다. 이는 일시적인 비용입니다. 시스템 활용률이 낮을 때는 지연이 몇몇 수요에만 영향을 미치지만, 활용률이 높을 때는 지연이 많은 수요에 영향을 미치고 지연 비용이 기하급수적으로 증가합니다.
최적 활용률이란 지연 비용과 작동하지 않을 때 발생하는 비용(과잉 프로비저닝)을 모두 최소화하는 지점입니다. 녹색 곡선은 이 두 가지 요소의 합인 총비용을 나타냅니다. 이 곡선의 최저점(일반적으로 최대 성능의 약 2/3)이 최적 활용률을 나타냅니다. 최적 활용률에 대해서는 더 자세히 설명할 부분이 많으며, 어떤 사람들은 약 80%라고 주장할 수도 있습니다. 핵심은 시스템 최적화를 통해 지연 비용을 줄이면 최적 활용률을 높일 수 있다는 점입니다(이미지 출처: show me the data).
시스템 최적화 Link to heading
개선 비용 Link to heading
시스템의 실패 비용을 낮추는 것이 확장에 걸리는 시간을 최소화하는 것을 의미한다면, 수요에 맞춰 밀리초, 심지어 마이크로초 단위로 스스로 조정하여 확장할 수 있는 시스템을 상상해 보세요. 물론, 그런 시스템을 개발하는 데는 막대한 비용이 들 수 있습니다(고빈도 거래(HFT)를 생각해 보세요). 하지만 시스템 개발 비용이 시스템 활용도를 높여 얻는 이점보다 낮다면 어떨까요?
이러한 과제 또한 CEE의 일부입니다. 시스템 개선 비용을 모델링함으로써 개선 비용과 이익의 균형을 맞춘 계획을 수립할 수 있습니다. 이는 운영상의 과제라기보다는 전략적 투자에 가깝습니다. 하지만 여전히 CEE의 원칙을 기업의 운영 전략에 적용하는 것이며, 이 전략은 시스템적인 관점에서 접근해야 합니다.
가치 흐름 매핑 Link to heading
용량 및 효율성 엔지니어링 맥락에서 가치 흐름 맵핑(VSM)은 용량이 소비되는 지점을 파악하고 낭비 및 병목 현상의 근본 원인을 식별하는 데 사용되는 진단 도구입니다.
가치 흐름(Value Stream, VSM)은 시스템이 서비스를 제공하기 위해 사용하는 워크플로의 모든 단계 또는 활동을 의미하며, VSM 맵은 이러한 전체 흐름을 시각적으로 표현한 것입니다. VSM은 세 가지 유형의 활동을 구분합니다.
부가가치(VA): 고객이 원하는 결과물에 직접적으로 기여하는 단계(예: 실제 계산).
부가가치는 없지만 필수적인 단계(NNVA): 시스템에 필요하지만 고객에게 직접적인 가치를 제공하지 않는 단계(예: 악수).
낭비(무다, 또는 無駄, 일본어로 “낭비"를 의미): 아무런 가치를 더하지 않고 용량을 소모하는 단계.
목표는 무다(비효율적인) 단계를 제거하는 것이며, VSM은 이러한 단계를 식별하는 데 탁월합니다. VSM의 강점은 진행 중인 작업(WIP)을 줄일 수 있는 적절한 최적화 방안을 찾아내는 능력에 있습니다. 이는 평균 리드 타임(또는 사이클 타임)이 평균 진행 중인 작업(WIP)을 평균 처리량으로 나눈 값과 같다는 리틀의 법칙 때문에 중요합니다.
즉, 처리량이 동일하게 유지되더라도 WIP가 두 배로 늘어나면 리드 타임도 두 배로 늘어난다는 의미입니다. 따라서 WIP를 관리하는 것은 납품 지연 시간(일명 “딜리버리”)을 줄이고 시스템 효율성을 높이는 가장 직접적인 방법 중 하나입니다.
결론 Link to heading
자, 이렇게 짧은 일요일 아침 메모로 용량 및 효율성 엔지니어링(CEE)에 대해 알아봤더니 이 주제를 더 잘 이해하게 되었습니다. 지금 기억해야 할 것은 시스템 효율성이 매우 낮을 때는 시스템이나 워크플로가 무다(비효율적 작업)로 과부하 상태에 빠졌을 가능성이 높다는 것입니다. 이 문제에 대한 해결책은 과잉 공급보다는 지연 비용을 줄이는 데 투자하는 것입니다.
References:
- What Is Engineering Capacity Planning? (And why Most Teams Get it Wrong)
- Engineering Fundamentals Playbook
- Engineering Capacity Planning: Processes, Strategies, and Tools
- https://www.cloudbees.com/blog/measuring-engineering-efficiency
- The Capacity Utilization Myth – Why 100% Kills Efficiency
- Engineering — Efficiency vs Effectiveness vs Productivity
- How a Director of Engineering Measure Engineering Efficiency?
- The Capacity Utilization Myth – Why 100% Kills Efficiency
- OpenTelemetry
- Simulation vs Emulation
DrawIO diagrams used in this memo:


Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|---|---|---|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
| Key methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
| Unique angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
| Metrics emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |