xPU: 특정 작업 부하에 맞게 맞춤화된 컴퓨팅 아키텍처를 나타내는 “x"를 포함하는 특수 처리 장치(PU)를 총칭하는 용어입니다. 일반적인 변형으로는 GPU(그래픽), TPU(텐서/AI), NPU(신경망), DPU(데이터) 또는 PPU(펄스, 주로 양자 제어 스택에 사용) 등이 있습니다.
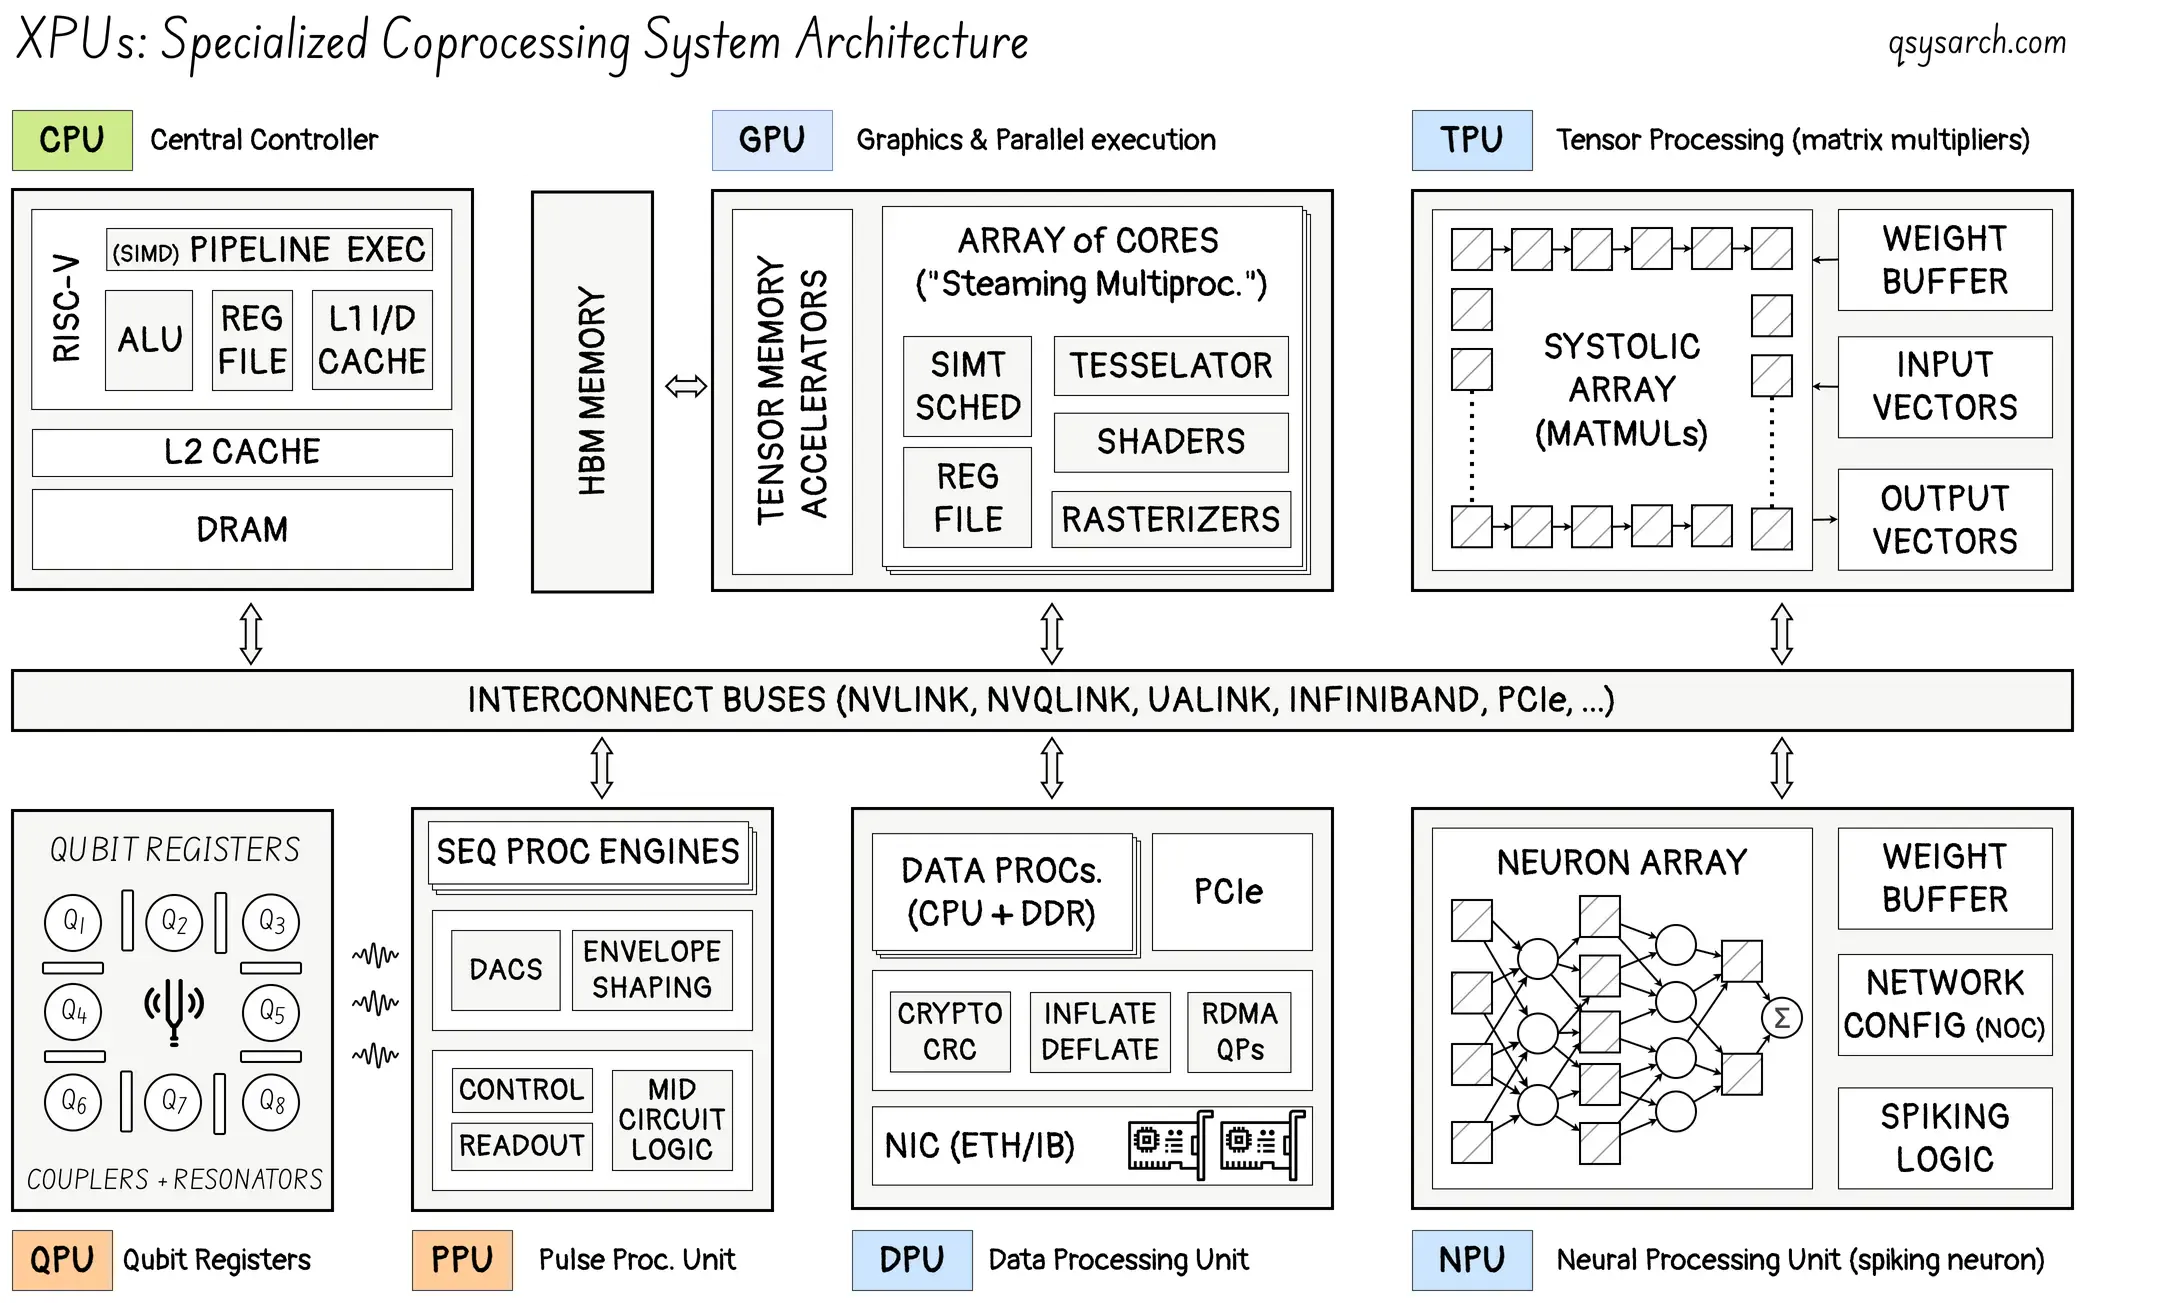
이 초간단 메모는 AI 추론에 적용되는 xPU 시장 환경에 대한 통찰력을 제공하는 것을 목표로 합니다.
시장 현황 Link to heading
AI 추론 ASIC 시장을 살펴볼 때 가장 유용한 기준은 단순히 성능만이 아니라, 벤더의 차별화 전략이 향후 3~5년 동안 시장에서 경쟁력을 유지할 수 있는지 여부일 수 있습니다. 이러한 관점에서 보면 세 가지 그룹이 나타납니다.
범용 플랫폼: NVIDIA 및 수직 통합업체: AMD, Google
현재 도전자 Groq, Cerebras, FuriosaAI, Positron, SambaNova, Axelera AI.
미래의 과제: 엑스트로픽, 노멀 컴퓨팅, 언컨벤셔널, 모트로닉스, 아크헤토닉스
유니버설 플랫폼 Link to heading
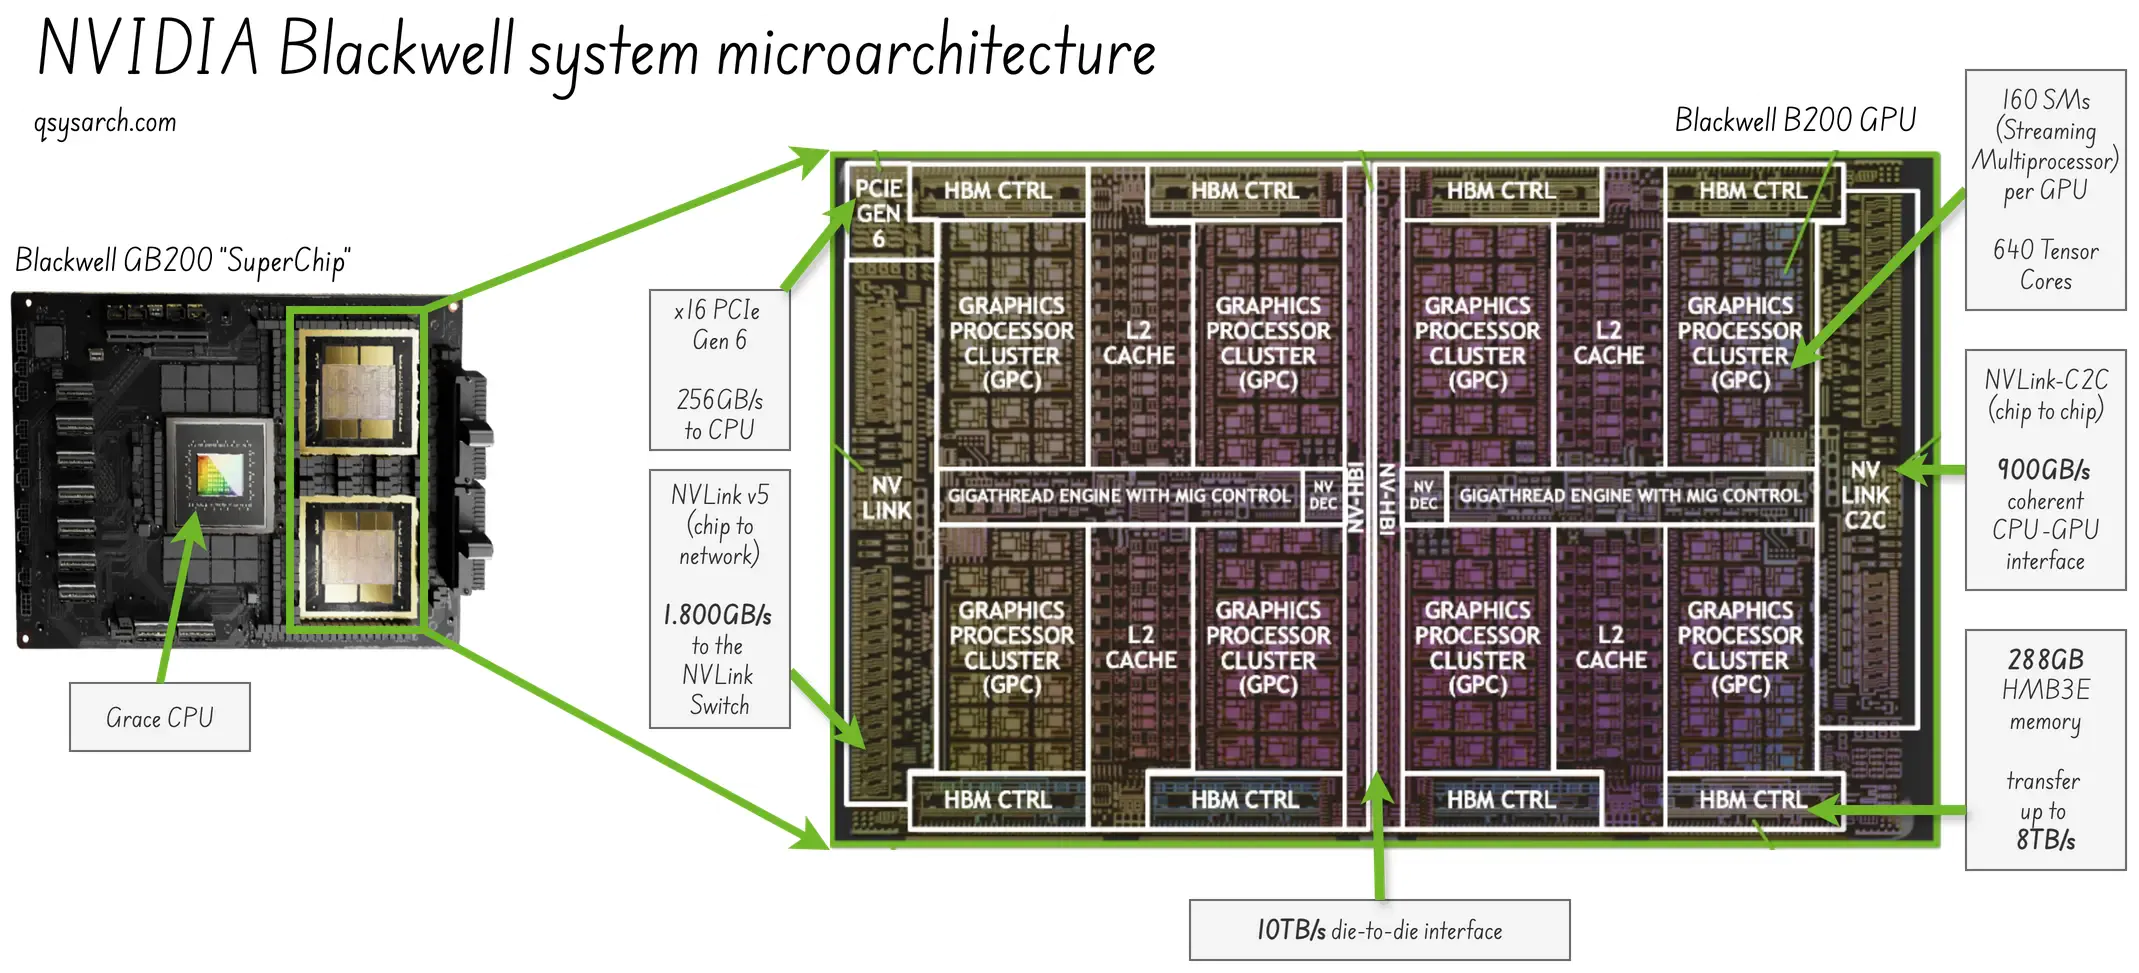
아키텍처: GPU (2024년 블랙웰 아키텍처)
핵심 강점: 생태계 종속성, 심도 있는 소프트웨어 스택, 완벽한 시스템 통합
목표 워크로드: 범용 — 대규모 LLM 학습 및 추론 - 그래픽 셰이더
취약점: 높은 비용, 높은 전력 소모; 희소 컴퓨팅에 최적화되어 있지 않음
수직 통합업체 Link to heading
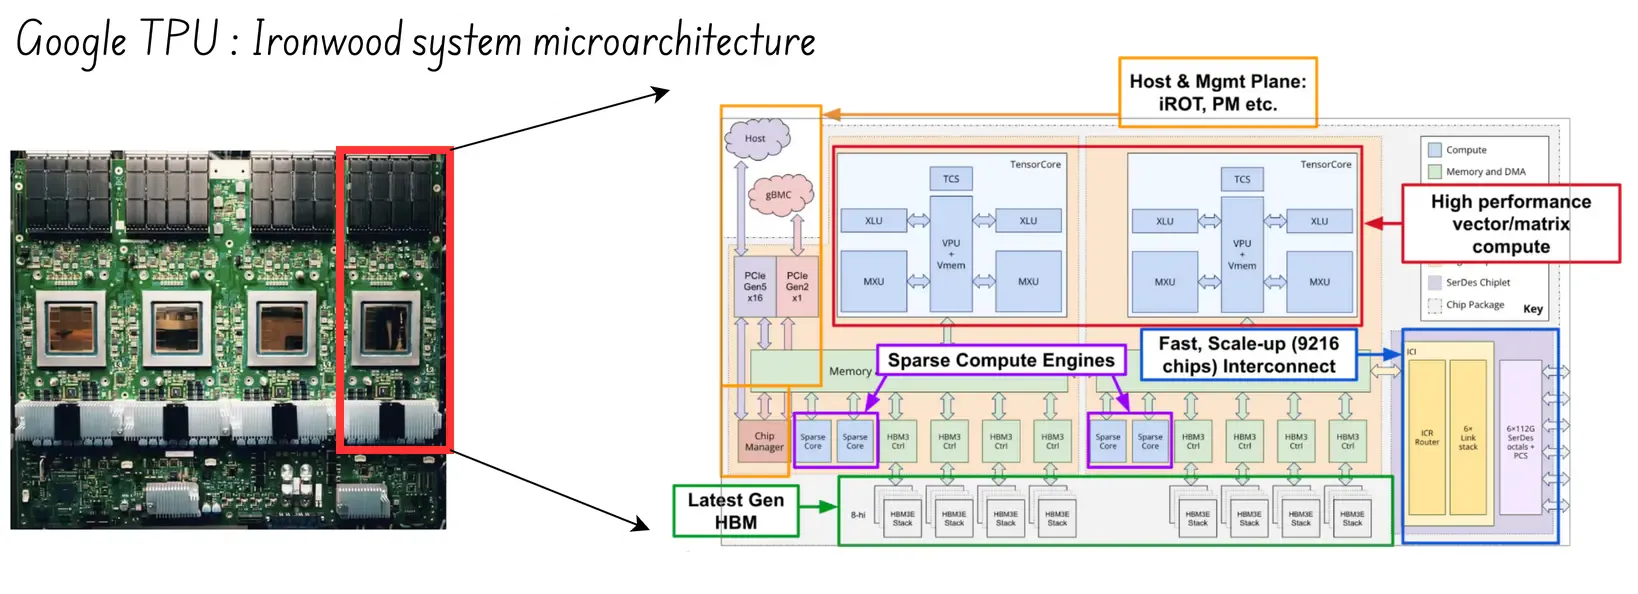
아키텍처: TPU, 맞춤형 ASIC(수축기)
핵심 강점: 수직적 통합; 구글 규모에서 최저 비용
대상 워크로드: Google Cloud 워크로드, Gemini 추론
취약점: 구글 클라우드에서만 사용 가능하며, 구글에서 TPU 코어를 구매할 수 없습니다.
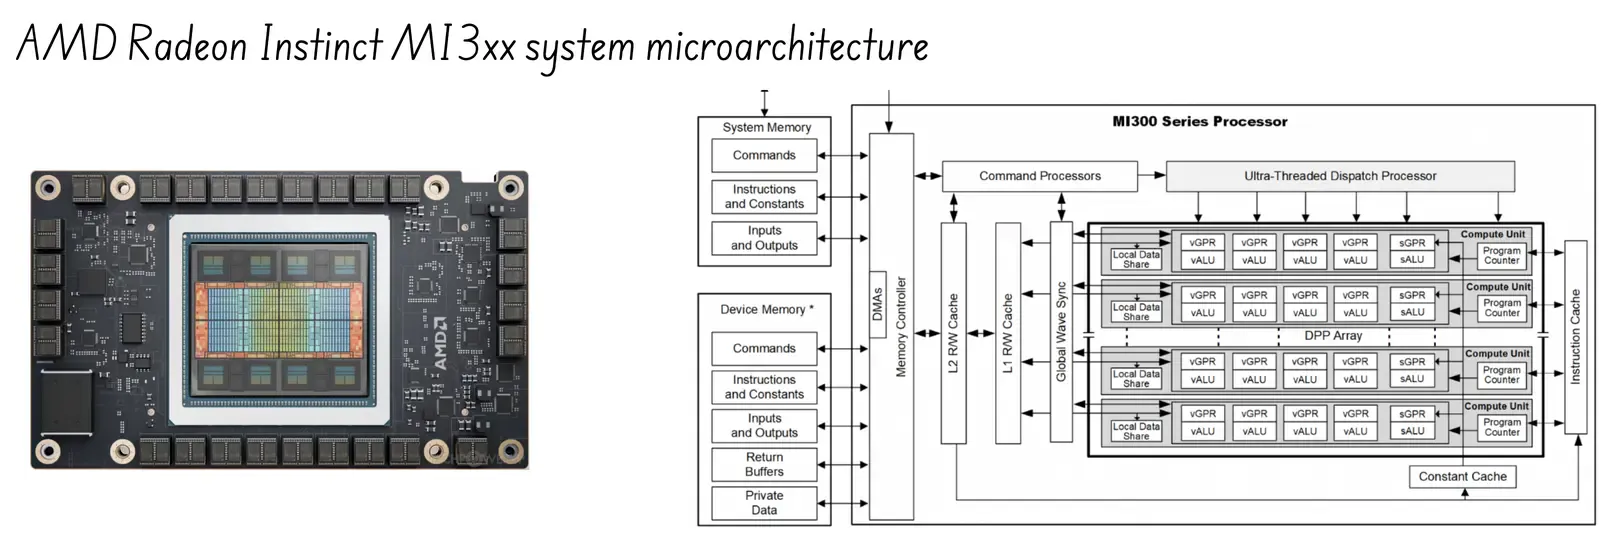
아키텍처: MI300 Instinct + ROCm (AMD 자체 CUDA)
핵심 강점: CUDA 가격 책정 대안; 친숙한 GPU 모델;
목표 워크로드: 클라우드 비용에 민감한 고성능 컴퓨팅(HPC) 및 추론
취약점: CUDA 대비 소프트웨어 격차; 최첨단 생태계(예: NVQLINK)에 뒤처짐
이미 확보한 챌린저스 Link to heading
Groq (NVIDIA에 인수됨)
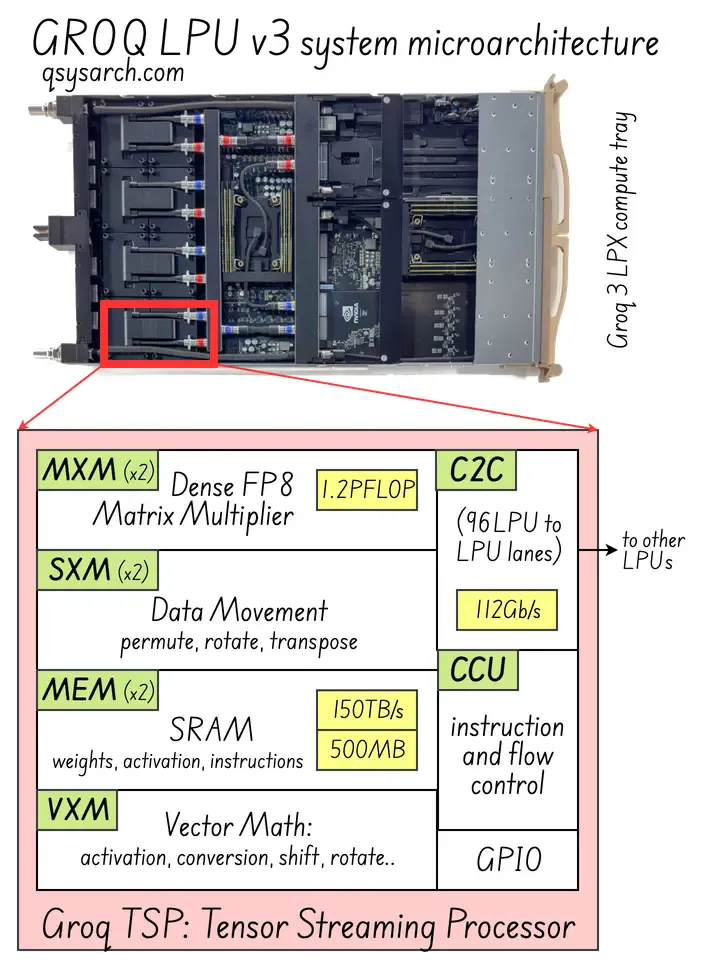
아키텍처: LPU(언어 처리 장치)
작동 원리: 핵심 Tensor Streaming Processor(TSP) 아키텍처를 기반으로 구축되어 실행 시간이 클록 사이클 단위까지 완벽하게 예측 가능합니다.
핵심 강점: 결정론적 초저지연; 메모리 병목 현상 없음; 모든 것이 컴파일러에 의해 사전에 “정리"됨.
목표 작업 부하: 실시간 추론
취약점: 속도를 희생하고 공간을 확보함: 대용량 HBM(고대역폭 메모리) 대신 소형 내장형 초고속 SRAM만 사용함 (하지만 이는 NVIDIA에 인수된 현재 NVIDIA Blackwell 생태계를 보완하는 좋은 요소가 될 수 있습니다!)
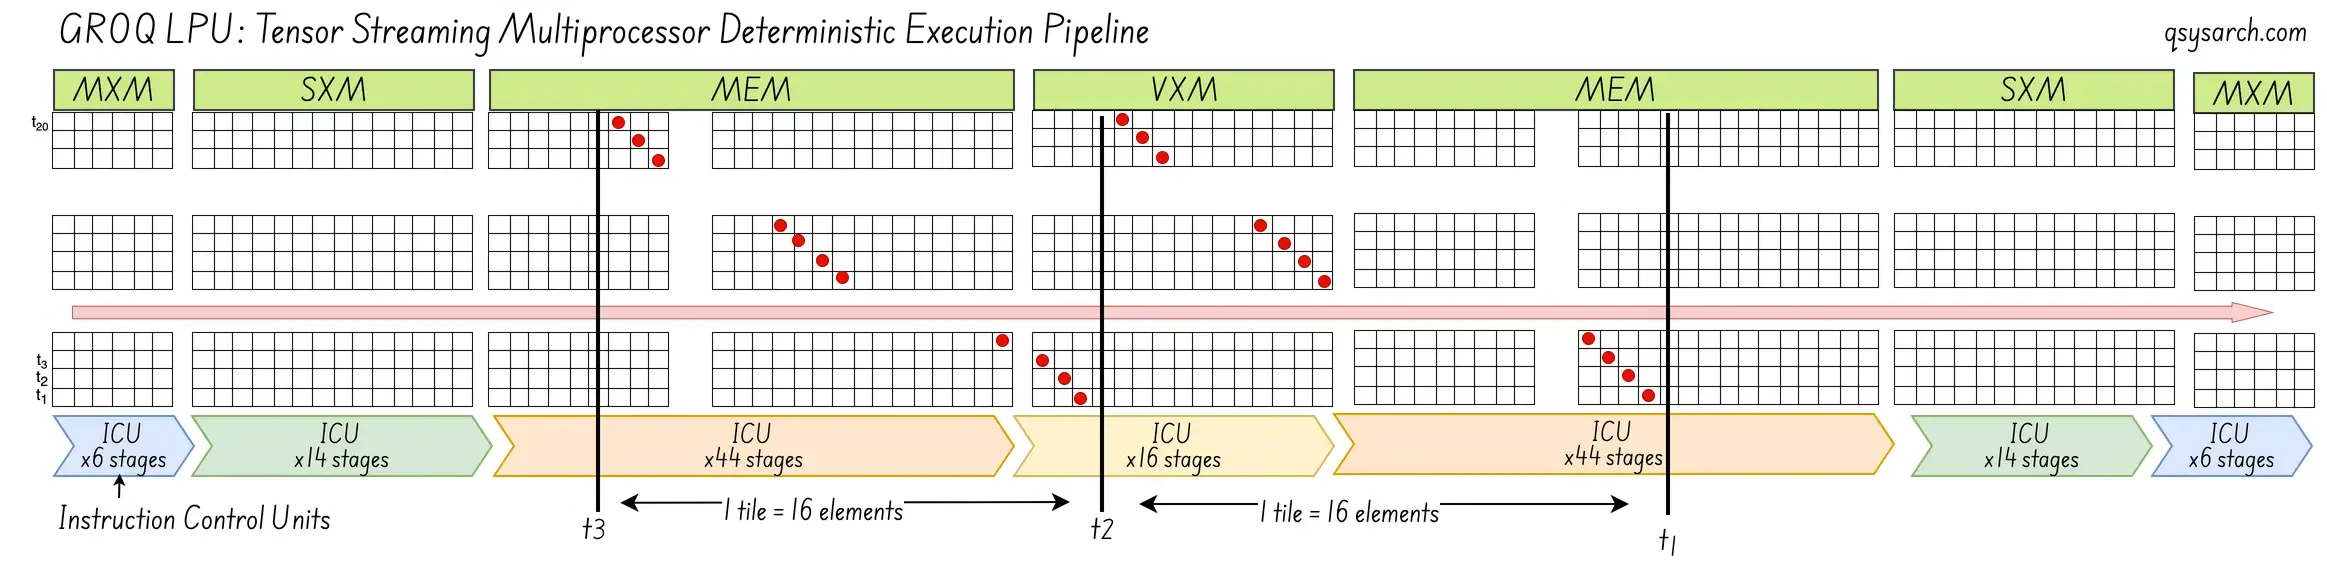
Groq LPU 아키텍처는 2020년에 발표되어 2024년에 상용 출시되었고 2026년에 인수되었다는 점에 주목하세요. 이는 유니콘 기업을 꿈꾸는 기업들에게 좋은 타임라인을 제시합니다. 개발에 4년, 시장 반응 확인에 2년, 그리고 더 큰 기업이 경쟁의 압박을 느낄 때 대박을 터뜨릴 수 있는 기간입니다!
현재의 도전자들 Link to heading
아래 제시된 해결책들을 제대로 검토하려면 각 업체별로 며칠씩 소요될 수 있습니다. 저는 이 메모를 작성하는 데 그럴 시간이 없었으므로, 아래 설명은 불완전하거나 주관적일 수 있다는 점을 유념해 주시기 바랍니다.
SambaNova [인텔에 거의 인수됨]
- 아키텍처: RDU(재구성 가능한 데이터 흐름 장치); 전체 연산 그래프에 대한 맞춤형 통합 데이터+처리 파이프라인을 구현하여 데이터 이동을 최소화하고 하드웨어 활용률을 높입니다. 아래 다이어그램은 SN40L에 사용된 PCU(패턴 연산 장치) 및 PMU(패턴 메모리 장치)의 상세 아키텍처를 보여줍니다.
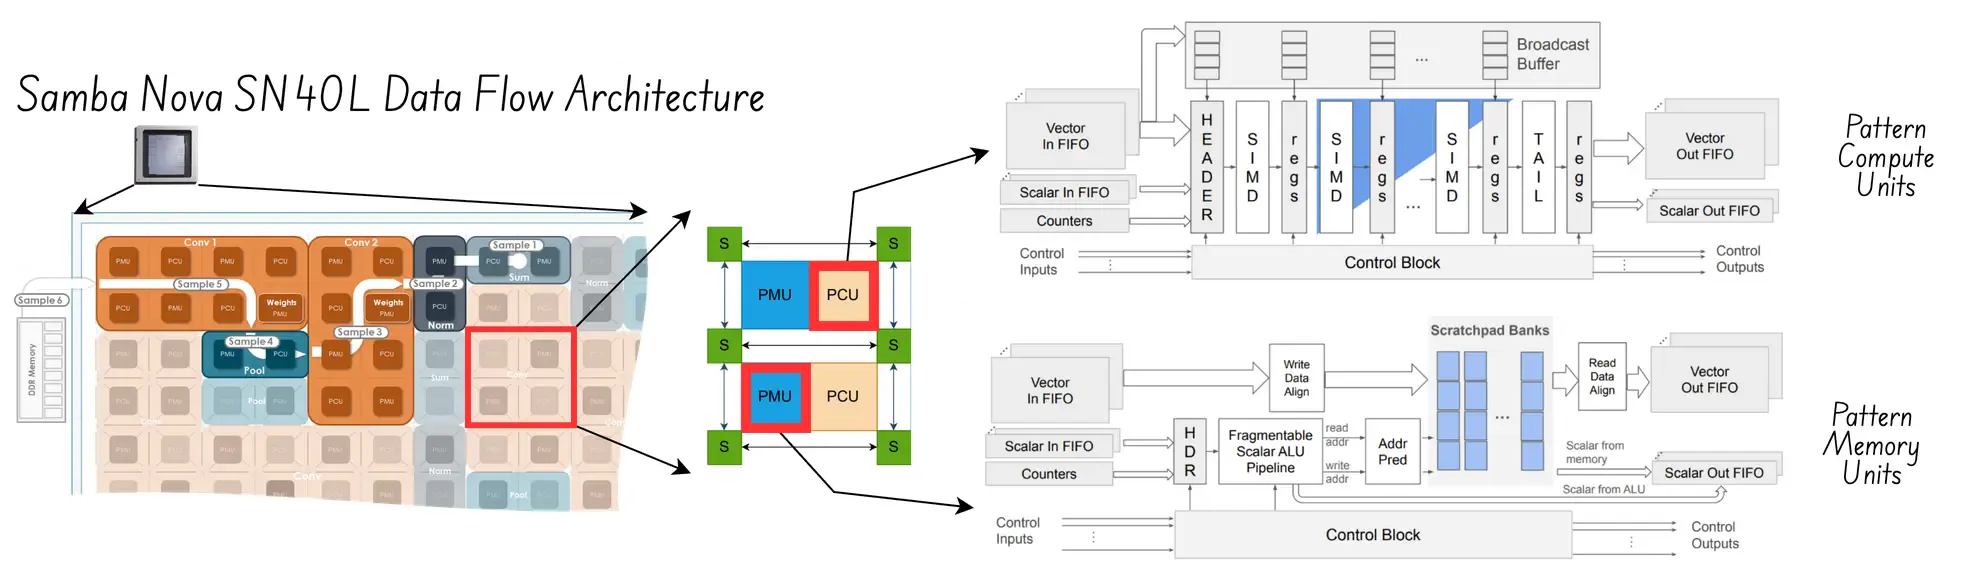
핵심 강점: 동시 추론 파이프라인에 시스템 흐름을 신중하게 분할하여 하드웨어 활용률을 극대화할 수 있습니다. 고수준의 Kubernetes 통합, PyTorch 및 TensorFlow 컴파일러, DataFlow 분석기를 포함한 완벽한 소프트웨어 스택이 함께 제공됩니다.
목표 워크로드: 엔터프라이즈, 온프레미스 규제 대상 산업 분야.
취약점: 하드웨어에 대한 초기 시스템 비용이 매우 높아 총소유비용(TCO) 측면에서 수익성이 있으려면 장기간에 걸쳐 비용을 상각해야 합니다.
아키텍처: 웨이퍼 스케일 엔진(WSE)은 거대한 파이프라인 행렬 곱셈기 역할을 합니다.
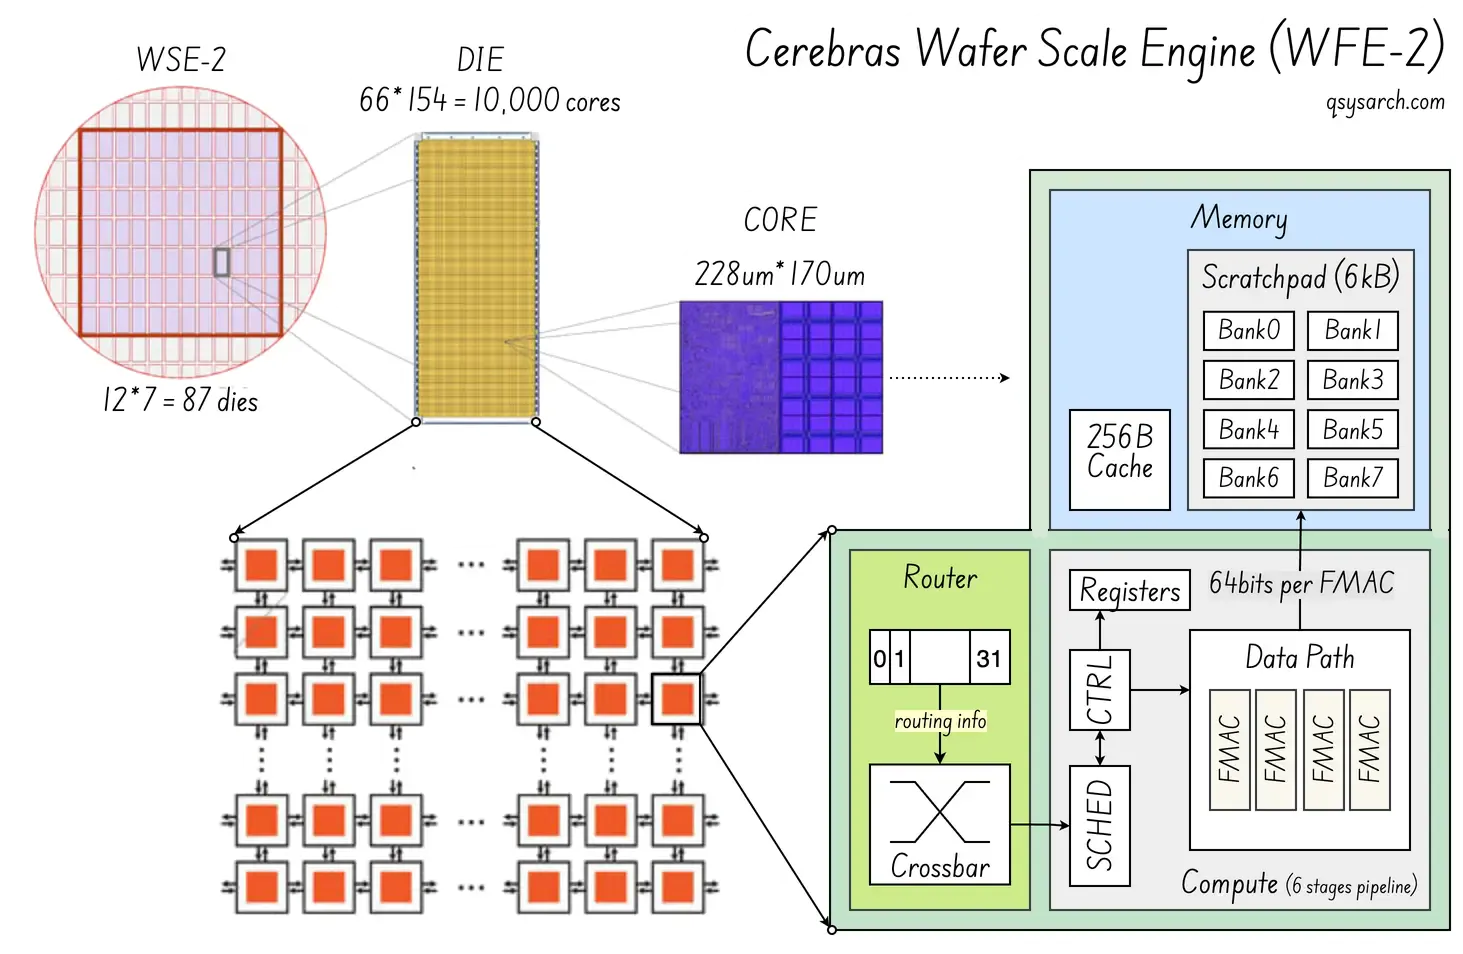
핵심 강점: HBM 병목 현상을 해소하는 대용량 온칩 SRAM. 메모리 내 텐서 연산이 가능한 고밀도 독립 코어(WSE-2의 경우 최대 85만 개). 웨이퍼 상의 노드 간 단일 클럭 지연 시간 패브릭 라우터.
목표 작업 부하: 대규모 LLM 추론, 특히 희소 모델.
취약점: 대규모 확장성을 최대한 활용하려면 (모든 “PIM” 또는 메모리 내 처리 마이크로아키텍처와 마찬가지로) 최고 수준의 소프트웨어 스택이 필요합니다.
- 아키텍처: 텐서 수축 프로세서(TCP, Renegade(RGND) ASIC으로 판매됨). 고정된 그리드를 사용하는 TPU 시스톨릭 어레이와 비교하여, Furuisa의 TCP 아키텍처는 동적으로 재배열할 수 있는 작고 구성 가능한 컴퓨팅 유닛을 사용합니다(마치 매우 스마트한 NOC처럼).
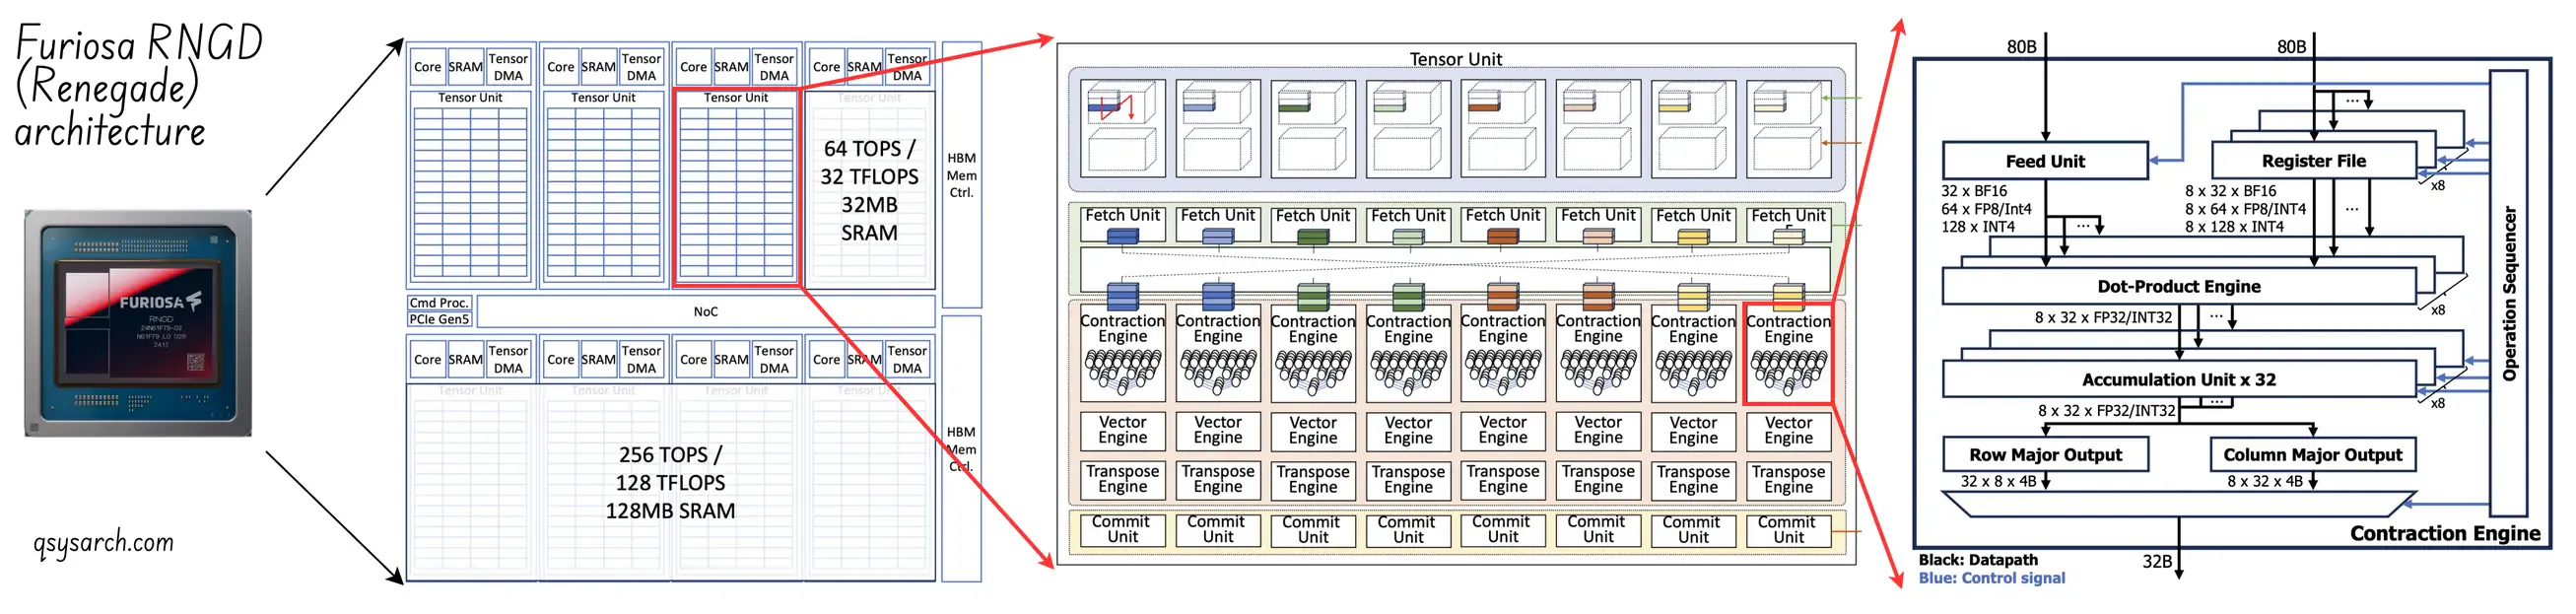
핵심 강점: Furiosa는 “fetch” NOC를 도입하여 TPU 텐서 네트워크의 시공간 프로그래밍 기능을 구현함으로써 컴퓨팅 워크로드와 텐서 축소 프로세서에 완벽하게 맞춰 효율성을 한 단계 끌어올렸습니다.
목표 업무량: LLM, VLMS 등
취약점: 제한적인 생태계; 지리적 집중 위험 (단, 아시아 시장의 일부를 점유한다면 오히려 유리하게 작용할 수 있음 - 예를 들어 시장 점유율 확대를 노리는 인텔에게는 좋은 인수 대상이 될 수 있음)
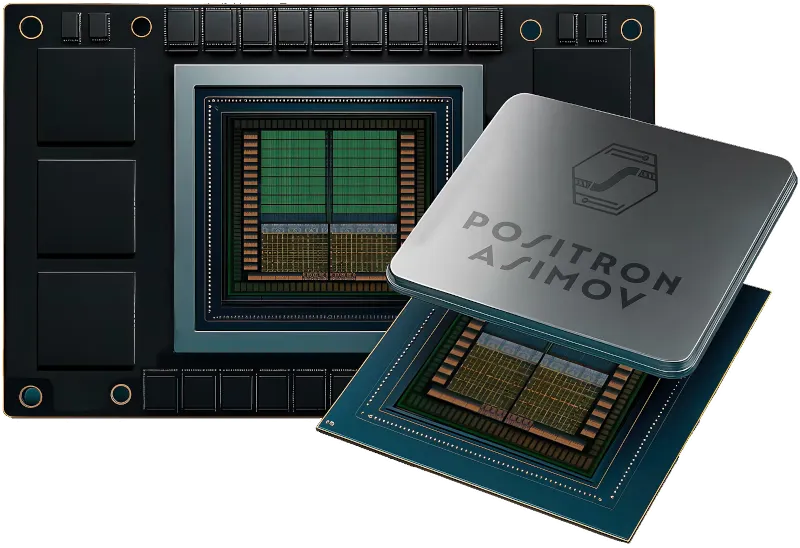
아키텍처: Asimov ASIC - 관련 정보가 많지는 않지만, Positron이 전달하는 핵심 메시지는 메모리가 핵심이라는 것입니다. 따라서 칩렛 스태킹 기술을 사용하여 표준 DDR5 메모리를 ASIC에 훨씬 더 많이 내장할 수 있다면, 메모리 용량이 더 작은 NVIDIA Blackwell에 비해 매력적인 제품을 제공할 수 있을 것입니다.
핵심 강점: 표준 고대역폭 메모리(HBM)가 아닌 고대역폭 메모리 활용률(MBU)에 집중한다는 점입니다. 즉, 메모리 버스의 듀티 사이클 또는 활용률을 높여 동등하거나 더 나은 메모리 성능(대역폭 * 듀티 사이클, 예를 들어 전력의 경우 V*I = 와트)을 제공할 수 있으므로, 고가의 메모리로 고전하는 경쟁사들을 앞지를 수 있습니다.
목표 작업량: 첫 번째 ASIC이 출시되면 알 수 있겠지만, 표준 LLM을 목표로 할 것으로 예상됩니다.
취약점: 매우 초기 단계이며 적합한 파운드리 파트너를 찾아야 합니다. 일반적인 출시 및 상용 솔루션까지는 2~4년이 걸릴 것으로 예상되며, 그때까지도 메모리가 병목 현상을 일으킬까요?
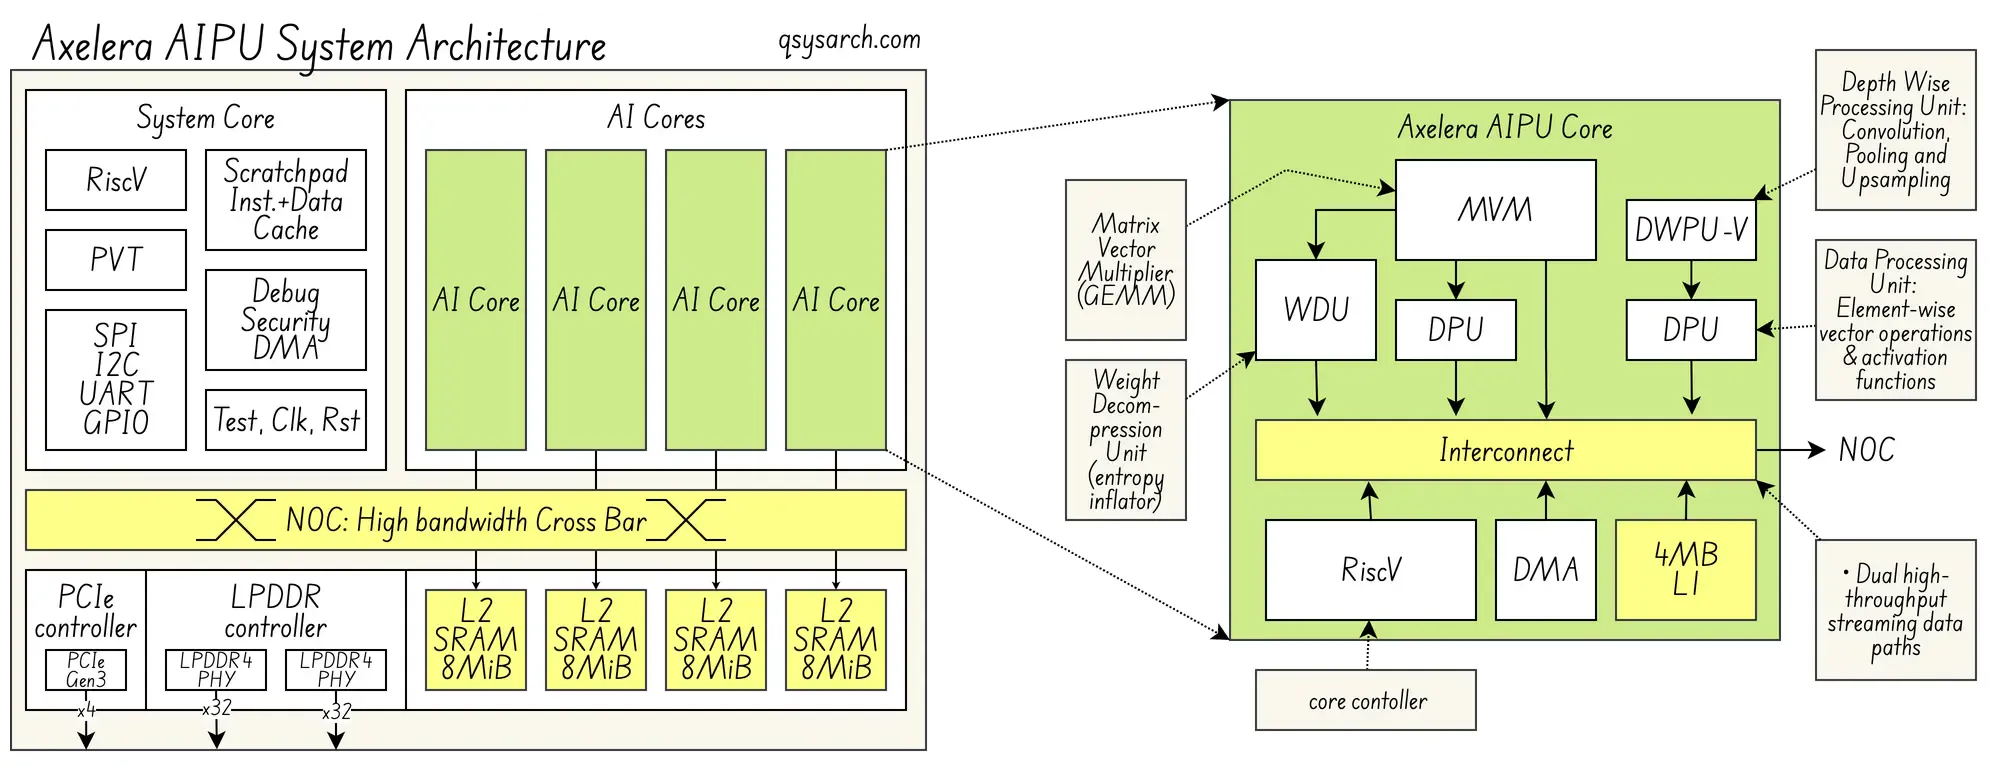
핵심 강점: 인메모리 컴퓨팅을 사용하여 디지털 메모리 셀 내부에서 직접 복잡한 연산을 수행할 수 있으므로 데이터 이동이 필요 없습니다. 이를 통해 15 TOPS/Watt의 성능(NVIDIA Blackwell의 경우 약 3 TOPS/Watt 대비)을 달성할 수 있습니다. 또한 모든 IP가 유럽에서 설계되어 자립적인 솔루션입니다.
목표 워크로드: 1세대 제품은 컴퓨터 비전/멀티스트림 비디오 분석에 초점을 맞추었으며, 최신 세대(M2 통합)는 엣지 LLM 및 vLM 워크로드에도 사용할 수 있습니다.
취약성: 악셀레라의 취약점은 엔지니어링 자체에 있는 것이 아닙니다. 그들의 기술력은 세계 최고 수준입니다. 진정한 취약점은 시장 마찰에 있습니다. 과연 그들은 핵심 사업에 집중하면서 시장에 성공적으로 진출할 수 있을까요?
미래의 도전자들 Link to heading
위 기업들에 대한 정보를 찾던 중, 향후 몇 년 동안 중요한 역할을 할 수 있는 몇몇 제조 분야의 경쟁사 및 혁신 기업들을 더 발견했습니다. 그중 마지막 기업인 언컨벤셔널 AI는 대표의 과거 성공과 비전 덕분에 결코 무시할 수 없는 기업입니다.

- 아키텍처: TSU(열역학적 샘플링 장치) / SPU(확률적 처리 장치), “p-비트”(일명 확률 비트)를 처리하는 데 사용
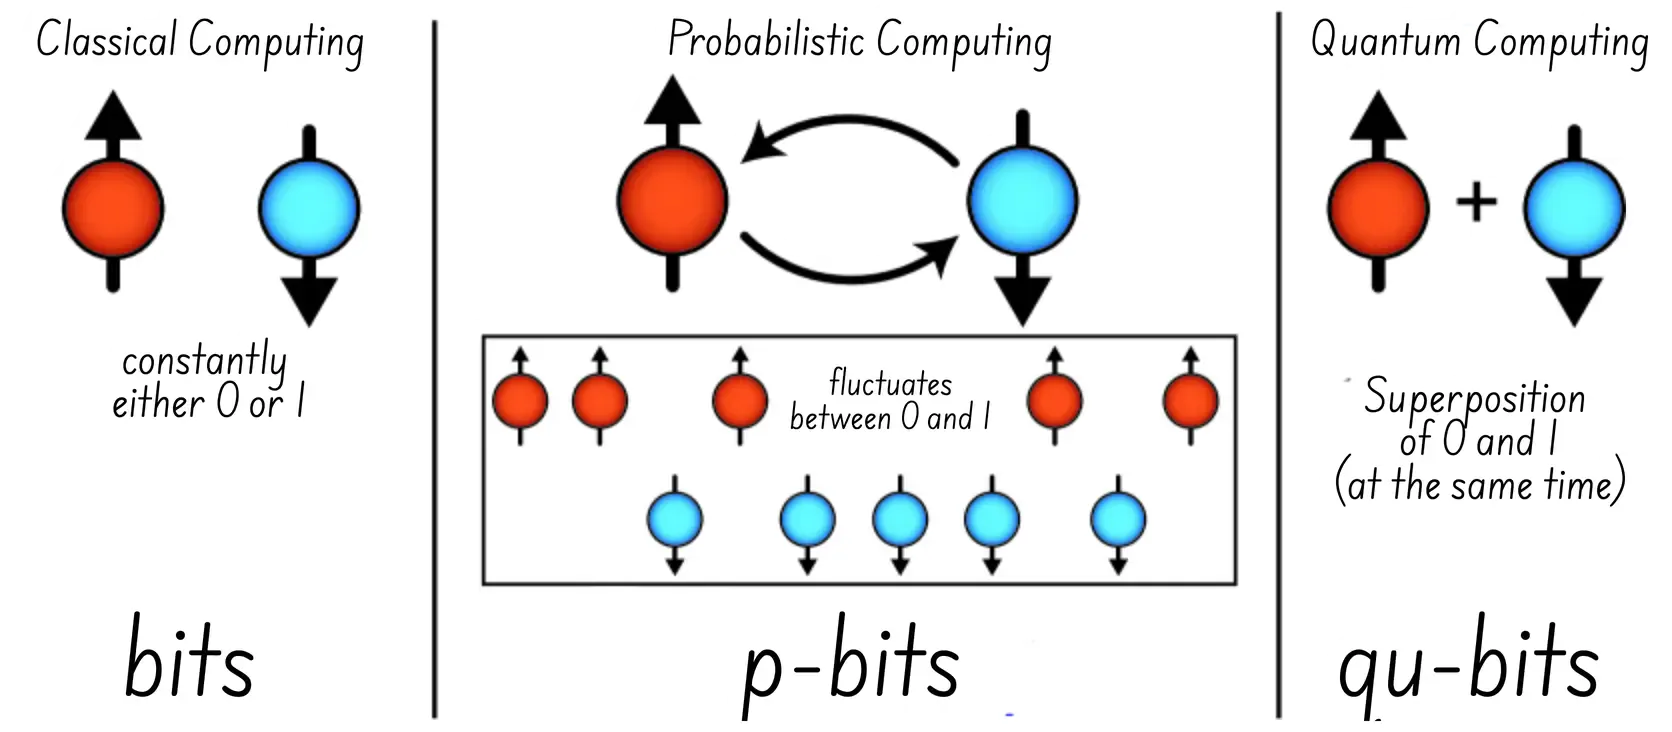
이것이 중요한 이유: 그들은 어닐링과 같은 특정 작업 부하에서 GPU보다 10,000배 더 효율적이라고 주장합니다. 이는 양자 컴퓨팅에 상당한 어려움을 초래할 수 있습니다.
취약점: 대규모 사용 가능 여부는 아직 상당한 연구가 필요합니다.
아키텍처: Mott 메모리(Mott-RAM)를 사용하는 SPU(스파이킹 신경망).
이것이 중요한 이유: 우리는 저항성 메모리(ReRAM) 또는 Mottronix의 Mott RAM과 같은 대안 메모리를 살펴볼 미래지향적인 사람들이 필요합니다.
취약성: 연구 단계에서 제품화된 IC로 전환할 수 있음을 입증해야 합니다.
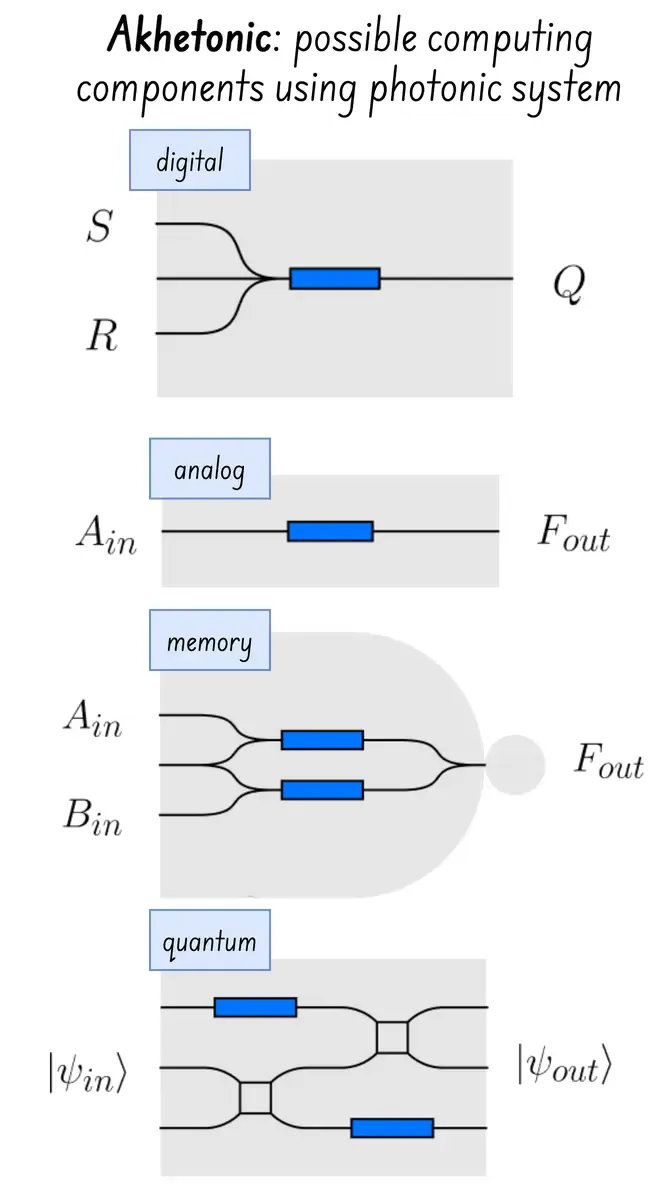
아키텍처: 전광 디지털 프로세서를 사용하는 RPU(추론 처리 장치)
이것이 중요한 이유: 포토닉스 IC는 지난 10년간 수율이 엄청나게 향상되었습니다. 예를 들어 NVIDIA는 이제 실리콘 포토닉스 네트워크 스위치를 상용화할 수 있게 되었으며, 이를 컴퓨팅 워크로드에 적용하는 것은 자연스러운 다음 단계입니다! (이를 통해 광학적으로 주소 지정되는 양자 컴퓨팅도 가능해집니다!)
취약점: OAQ 양자 컴퓨팅과 RPU 추론 컴퓨팅의 차이점이 명확하지 않으며, 두 경우 모두 상용 솔루션으로 확장하기 전에 신중한 조정 및 최적화가 필요합니다.
- 아키텍처: “JEF"는 광자 AI 가속기로, 에너지 소비를 10~30배 절감할 수 있습니다. Arago에 대한 공개 정보는 매우 제한적이지만, 풀스택 및 PyTorch 호환 소프트웨어 SDK와 결합된 하이브리드 결정론적/고전적 가속기 + 광자 가속기 통합 솔루션인 것으로 보입니다.

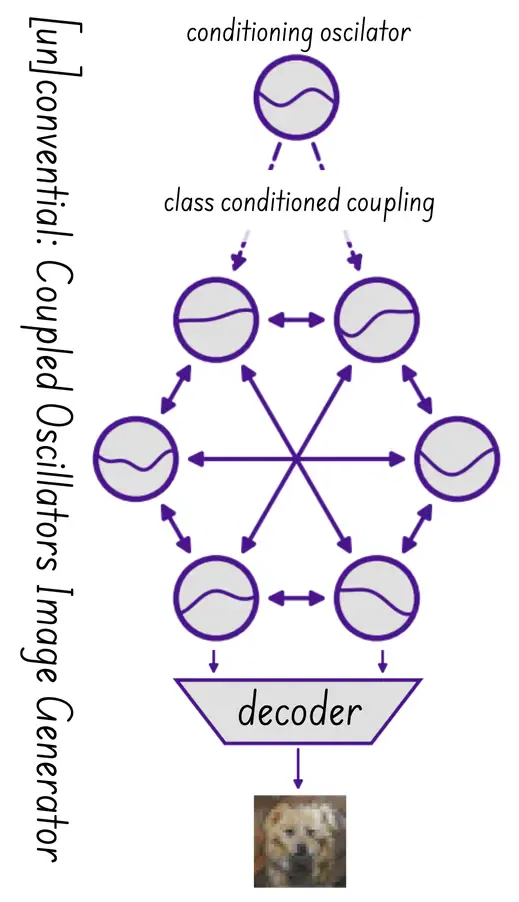
아키텍처: 쿠라모토 발진기를 사용하는 [UN]CPU([비]기존 처리 장치)
왜 이것이 중요한가: 저는 이 아이디어가 정말 마음에 들고, 실현되려면 실행이 핵심입니다. 남들과 다르게 생각할 용기를 갖는 것은 절반의 성공일 뿐입니다. 진정한 세상을 바꾸는 사람들은 매일 실천에 옮깁니다. 그리고 이를 위해 그들에게는 풍부한 경험을 가진 리더가 있습니다.
취약점: 아직 초기 단계이므로 실행력이 핵심입니다.
2026년 6월 시장 회고 Link to heading
현재 시장 판도를 바꿀 수 있는 실질적인 전선은 어디에 있을까요?
생태계: NVIDIA vs AMD Link to heading
NVIDIA의 구조적 우위는 GPU 자체에 있는 것이 아니라 지난 10년간 구축해 온 CUDA 생태계에 있습니다. 이 경쟁에서 승리하려면 단순히 하드웨어만이 아니라 소프트웨어에서도 우위를 점해야 하는데, 바로 이 부분에서 하드웨어 중심의 혁신적인 기업들이 실패하는 경우가 많습니다.
- AMD는 NVIDIA에게 가장 저평가된 단기적 위협입니다. CUDA를 능가할 필요가 없고, 자체 툴을 보유하고 있으며, 비용에 민감한 클라우드 구매자에게 “충분히 좋은” 제품이면 충분합니다. ROCm 6.x는 예상보다 빠르게 격차를 좁히고 있습니다.
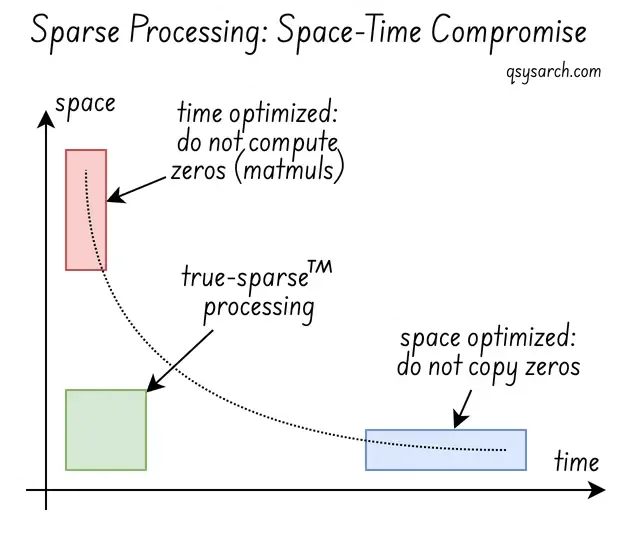
혁신가들: 시공간 타협
 Link to heading
대부분의 혁신가들은 시간과 공간의 제약을 극복하기 위한 다양한 방법을 시도하고 있습니다. 초고속 로컬 메모리를 더 많이 활용하거나, 동적으로 구성 가능한 데이터 흐름(파이프라인)을 허용하는 방식 등이 있습니다. 현재로서는 RAM이 병목 현상을 일으키고 있습니다.
어쩌면 이 승자는 두 가지 문제를 동시에 해결할 수 있는 사람일지도 모릅니다. 이는 특히 “0"이 많은 희소 행렬 계산에서 더욱 중요할 것입니다. 희소 행렬 계산에서는 0의 메모리 전송을 피해야 하지만, 동시에 0을 계산하는 것도 가능해야 하기 때문입니다! Renegade가 이러한 차이를 만들어낼 수 있을까요?
디스럽터스: 명령형 컴퓨팅 vs 동적 컴퓨팅 Link to heading
차세대 칩 제조업체들은 컴퓨팅 문제를 다른 관점에서 바라봅니다. 어쩌면 핵심은 숫자를 하나씩 순차적으로 곱하는 것이 아니라 동적 시스템을 모델링하고 입력하는 데 있을지도 모릅니다.
- 양자 컴퓨팅과 동적 컴퓨팅 사이의 경계선이 민감한 부분일까요? 큐비트 결맞음 상실 없이 기하급수적인 연산을 가능하게 하는 중간 시스템을 도입함으로써 양자 극저온 문제와 큐비트 결맞음 상실 문제를 모두 해결할 수 있을까요?
기술 및 시장 전망 (2026~2029) Link to heading
아래 요약은 1단계부터 3단계까지의 전망에 대한 주관적인 견해입니다. 다음 주기는 세 가지 주요 변화로 특징지어질 것이며, 그 영향 순서대로 나열되어 있습니다.
메모리 파워™: 연산 능력보다는 메모리가 진정한 성능 향상의 핵심 요소입니다. Link to heading
LLM(Long-Term Modeling)은 점점 더 연산 능력보다는 메모리 대역폭에 제약을 받고 있습니다. 모델 규모가 커지고 컨텍스트 윈도우가 100만 개 이상의 토큰으로 확장됨에 따라, 가중치를 HBM(Harmonized Memory Memory)으로/에서 이동하는 데 드는 비용과 지연 시간이 지배적인 요소가 됩니다. 따라서 온칩 SRAM을 사용한 근접 메모리 연산 능력과 충분한 대역폭을 갖춘 대용량 메모리 사이에서 균형을 맞춰야 합니다. 핵심 KPI는 대역폭 * 듀티 사이클로 정의되는 메모리 성능이 될 수 있습니다.
토큰당 일부 매개변수만 활성화하는 혼합 전문가 모델(희소 행렬 사용) 또한 이 범주에 속합니다. 대부분의 가속기는 아직 희소 활성화 패턴에 최적화되어 있지 않으며, 이것이 NVIDIA가 텐서 코어를 도입한 이유입니다. 이것이 최종 해결책은 아닐지라도, 보다 일관적이고 안정적인 해결책이 나올 때까지의 “하드웨어 패치” 역할을 할 수 있습니다.
특수 보조 프로세서: LLM 파이프라인의 일부를 효율적으로 처리해야 합니다. Link to heading
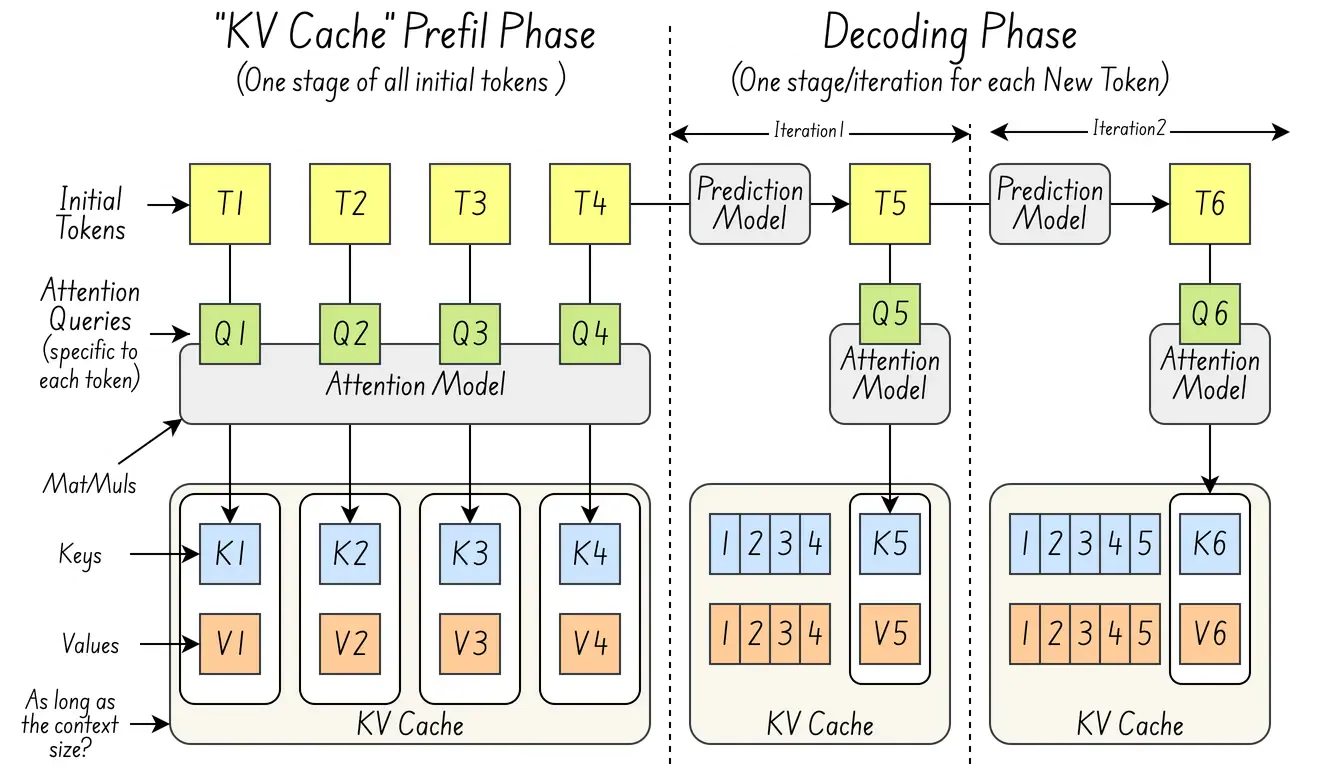
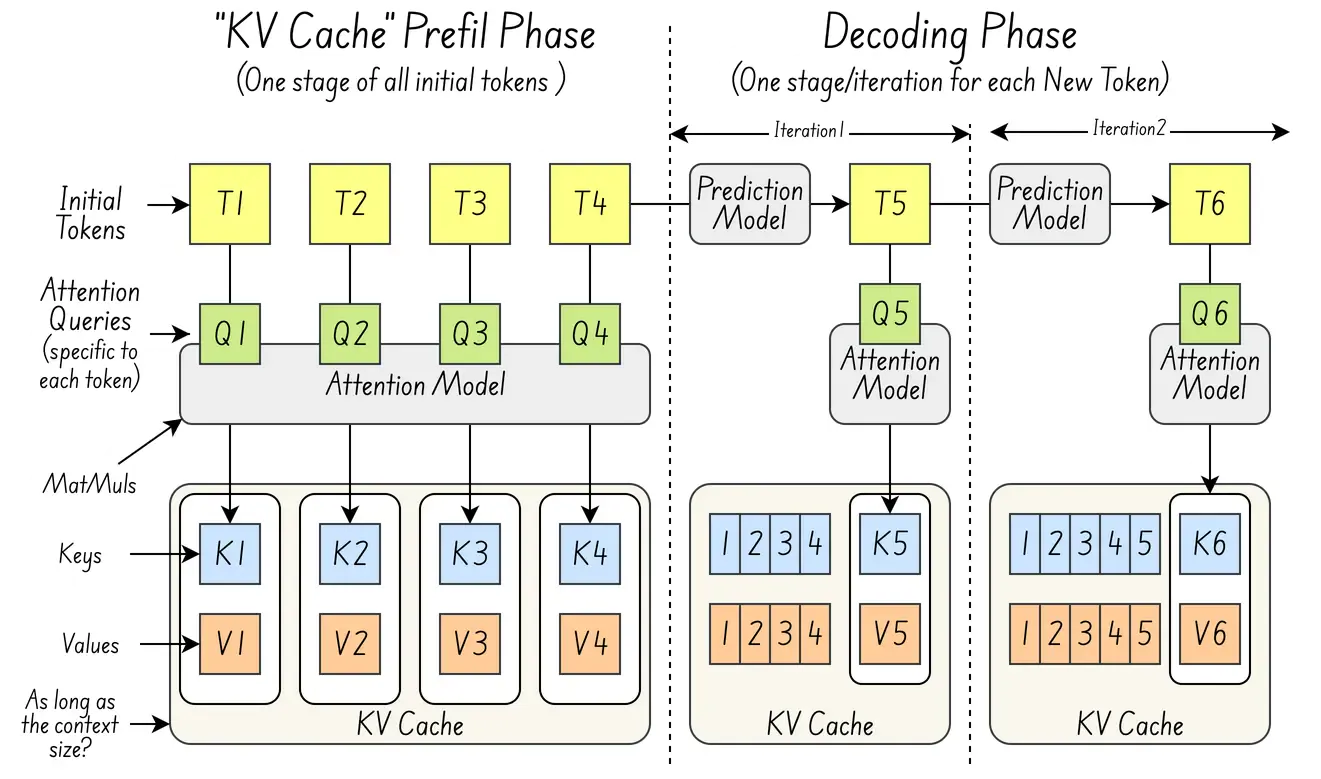 예를 들어, LLM(로컬 라이프사이클)에서 사전 채우기(많은 토큰으로부터 초기 키-값 캐시 구축)와 디코딩(토큰 하나씩 생성) 단계를 분리하기 위해 사전 채우기/디코드(PD) 분리 기법을 사용하는 것이 일반적입니다. 이는 사전 채우기에는 더 나은 컴퓨팅 성능이 필요하고 디코딩에는 더 나은 메모리 성능(각 토큰마다 새로운 키-값 캐시를 로드해야 함)이 필요하기 때문에, 추론 전용 코프로세서를 활용할 수 있는 가능성을 열어줍니다.
NVIDIA의 희소 혼합 전문가 모델용 텐서 코어도 이 범주에 속합니다.
하드웨어 상품화: 인텔리전스 지수 압력이 하드웨어의 상품화를 촉진합니다. Link to heading
추론 비용이 2년 만에 약 10배 하락했습니다. 기업의 AI 도입은 모델 품질이 아닌 추론 비용에 의해 제한되고 있습니다. 이는 곧 표준 LLM(Long-Term Modeling) 서비스를 위한 고성능 하드웨어(NVIDIA H100/B200)보다 낮은 가격대의 범용 추론 하드웨어가 등장하고 있음을 의미합니다. 바로 이 지점에서 새로운 경쟁자들이 두각을 나타낼 수 있습니다. Positron Asimov 프로세서를 사용하여 범용 하드웨어에서 GLM5.2를 실행할 수 있다고 상상해 보세요!
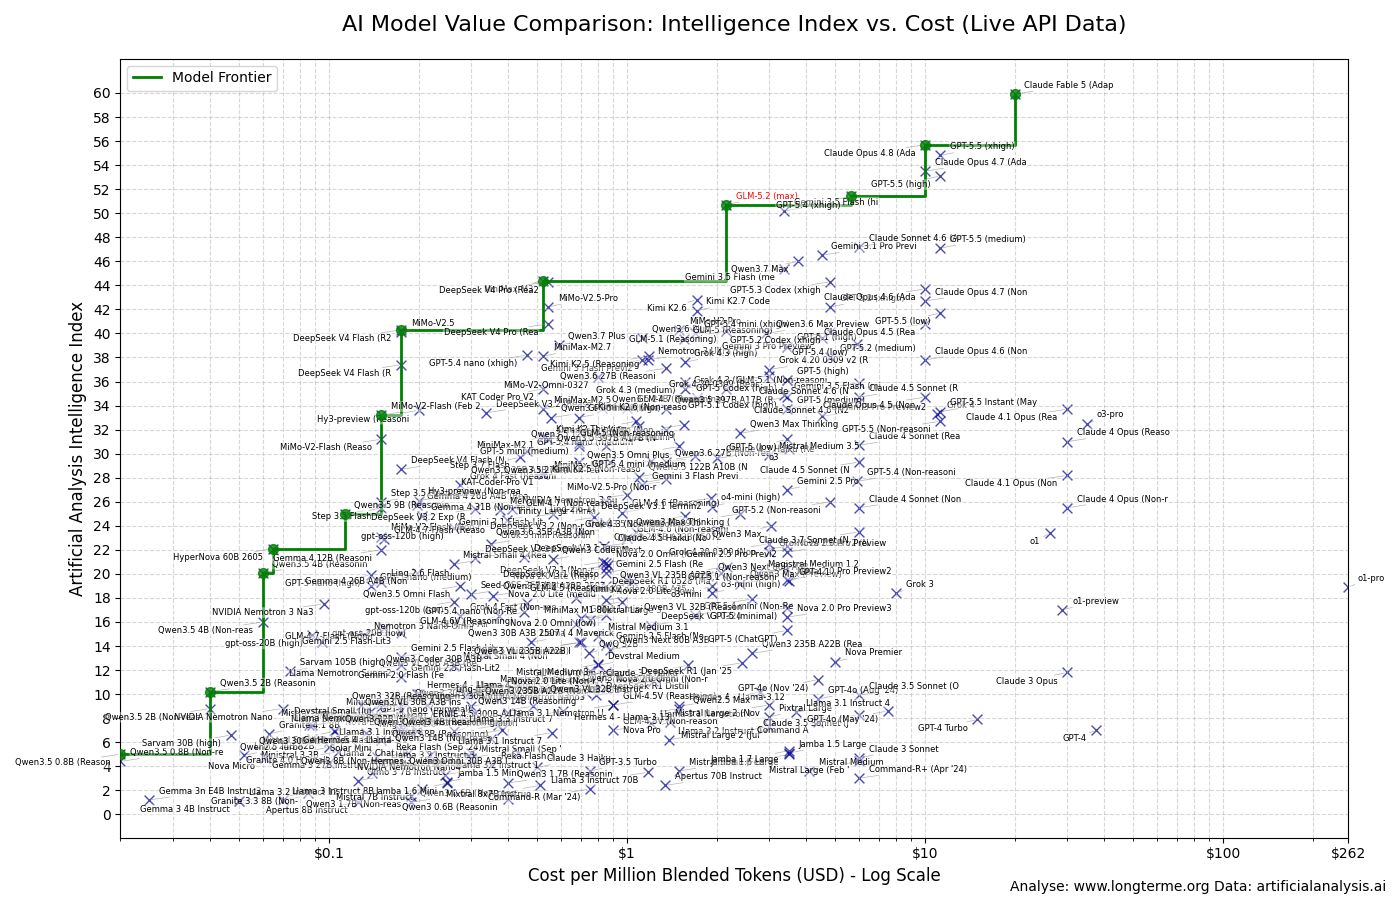 (이미지 출처: L’Observatoire du Long Terme - Z AI GLM5.2는 인텔리전스/비용 측면에서 확실히 아웃사이더이지만 200GB에 가까운 메모리가 필요합니다.)
배포 간편성: 마지막으로 가장 중요한 것은 하드웨어부터 소프트웨어, UI 및 도구에 이르기까지 사용 편의성입니다. Link to heading
기업들은 운영 복잡성을 지속적으로 과소평가합니다. 단순히 칩만이 아닌, 설정이 필요 없는 런타임 환경을 제공하는 “추론 기능 일체"를 선보이는 업체들이 기업 시장에서 상당한 점유율을 차지하게 될 것입니다.
이는 EU 및 APAC 지역의 규제 압력으로 인해 온프레미스 추론의 필요성이 더욱 커짐에 따라 더욱 심화될 것입니다. 왜냐하면 많은 기업들이 자사의 독점적 지식을 해외 시스템에 추론하는 것을 원하지 않기 때문입니다.
결론 Link to heading
20242026년 추론 시장은 20002003년 네트워킹 시장과 유사해 보입니다. NVIDIA는 당시의 Cisco와 마찬가지로 시장을 지배하고 있으며, 많은 사용 사례에 비해 과도하게 설계되었고, 가격 또한 프리미엄급입니다. 핵심은 NVIDIA의 주력 워크로드에서 NVIDIA에 도전할 수 있는지 여부가 아닙니다. NVIDIA가 시장을 과도하게 공략하는 영역과, 특정 용도에 맞춰 설계된 대안이 40%의 비용으로 80%의 성능을 제공할 수 있는 영역이 어디인지 파악하는 것입니다.
동시에 NVIDIA는 생태계에 막대한 투자를 하고 있으며, NVIDIA가 커뮤니티에 무료로 제공하는 CudaQ 및 NVQLink와 같은 훌륭한 완전 오픈소스 기여는 NVIDIA의 경쟁사가 해당 커뮤니티를 장악하기 더욱 어렵게 만들 것입니다.
자, 이렇게 짧고 피상적인 일요일 아침 메모를 마쳤습니다. 앞으로 등장할 경쟁 기술들에 대한 더 자세한 아키텍처 분석을 해야겠지만, 다행히 올여름 안에 최소 두 가지 기술에 대한 메모는 작성할 수 있을 것 같습니다. 다음 메모에서는 많은 독자분들이 요청하셨던 주제, 바로 양자 오류 수정에 대한 간략한 설명을 다루겠습니다!
References Link to heading
- Benchmarking the Cerebras Wafer Scale Engine-2 Architecture
- Cerebras Architecture Deep Dive
- Groq LPU design
- A Thorough Investigation of Groq https://api-docs.deepseek.com/news/news260424
- MegaTrain: Full Precision Training of 100B+ Parameter Large Language Models on a Single GPU
- Think Fast: A Tensor Streaming Processor (TSP) for Accelerating Deep Learning Workloads
- Evolution Strategies at the Hyperscale
- HiSparse: Turbocharging Sparse Attention with Hierarchical Memory
- AscendNPU-IR
- AscendCraft: Automatic Ascend NPU Kernel Generation via DSL-Guided Transcompilation
- Fast Switching Serial and Parallel Paradigms of SNN Inference on Multi-core Heterogeneous Neuromorphic Platform SpiNNaker2
- Neuromorphic hardware for sustainable AI data centres
- A Framework for Benchmarking Neuromorphic Computing Algorithms and Systems
- Fast Switching Serial and Parallel Paradigms of SNN Inference on Multi-core Heterogeneous Neuromorphic Platform SpiNNaker2
- Revolutionizing AI Workloads with Digital In-Memor y C omputing and RISC-V technology
- Computation as a Universal and Fundamental Concept
DrawIO diagrams used in this memo: