AI、より正確にはニューラルネットワーク(NN)の利用は、2025年のあらゆるシステムにおいて、当然のことながらほぼ必須の要素となるでしょう。当然ながら、このテーマに関する研究論文は数多く発表されています。しかし、最新の研究では、量子制御システムへのニューラルネットワークの高性能な統合を可能にすることで、その限界をさらに押し広げています。
この記事は、シンガポール量子技術センターCQT/NUSの研究、特にアーサー・ストラウス氏の研究に基づいています。私は前回のSQAイベントで、ストラウス氏と意見交換をする機会に恵まれました。
彼らのアイデアは実に興味深いものです。強化学習のアプローチを用いて、量子制御システムが量子ビット制御(ゲートとも呼ばれる)を調整できるようにし、制御効率を最大化することを目的とした報酬システムに基づいて制御を行うというものです。なぜこれが重要なのか疑問に思うかもしれません。前の記事(link)で説明したように、量子ビットは非常に繊細な「実体」であり、細心の注意が必要です。そして、ここでニューラルネットワークが登場し、この注意の質(忠実度とも呼ばれる)を定量化するのに役立ちます。
これはどのように機能するのでしょうか?強化学習は、反復的な環境→エージェント報酬システム(下の図の「a」)を介して学習される観察/行動のサイクルに基づいており、通常はGPUで実行され、学習後は量子制御システム(下の図の「b」)上の密結合行列乗算器(またはしない!)で実行されます。
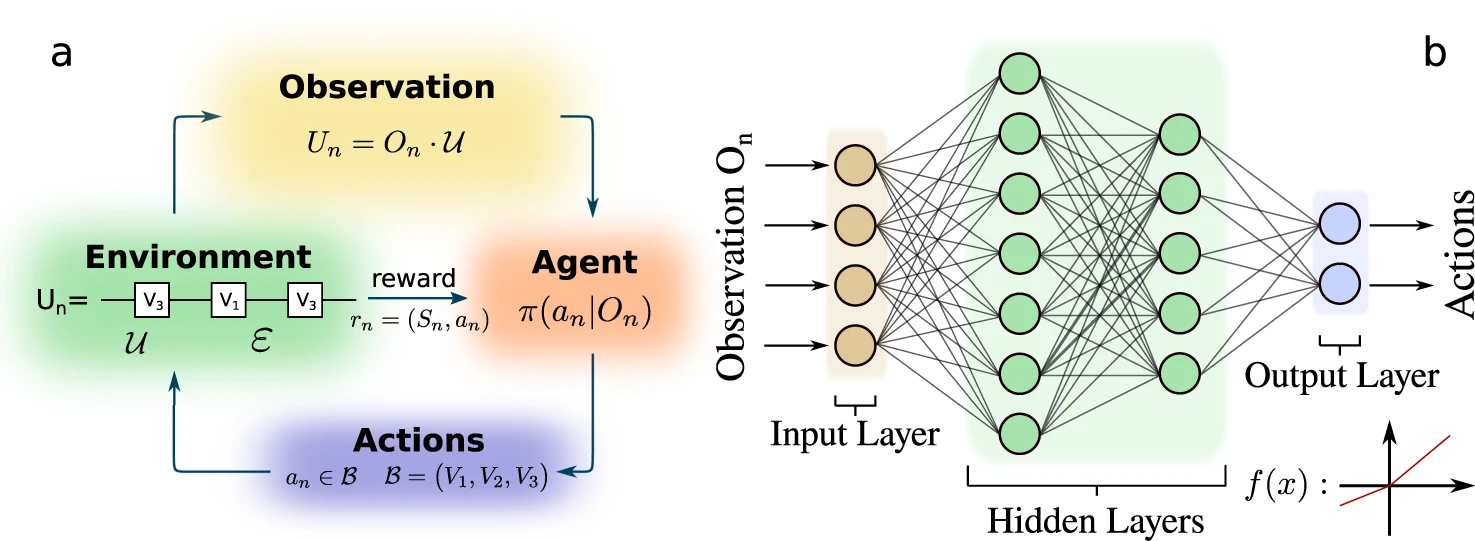 クレジット: Nature
観測(キュービット読み出しとも呼ばれる)によって量子状態が破壊されるため、学習サイクルではまずキュービットの状態をリセットし、制御ゲートを実行し、キュービットの状態を読み出し、その情報をエージェントに供給します。
RLシステム:主要コンポーネント
見出しへのリンク
強化学習の4つの構成要素を詳しく見ていきましょう。
*観測とは、環境によって操作された後の量子ビットの特性のことです。
- エージェントは、観測された量子ビットの特性に反応し、それに応じてパルスパラメータを調整するポリシーを学習します。
強化学習の手法は、大きく分けて価値ベース型と方策勾配ベース型の2つのカテゴリーに分類できる。
価値ベース手法は、価値関数を推定し、そこからポリシーを導出することに重点を置いています。ポリシー勾配手法は、勾配上昇法によって期待累積報酬を最大化することで、ポリシーを直接最適化します。
ポリシー反復の利点は、計算コストは高くなりますが、価値ベースの方法よりもはるかに速く収束することです。そこで、計算複雑度を低減するポリシー勾配アルゴリズムが登場します。reinforce アルゴリズムを含むポリシー勾配アルゴリズムの例を以下に示します。
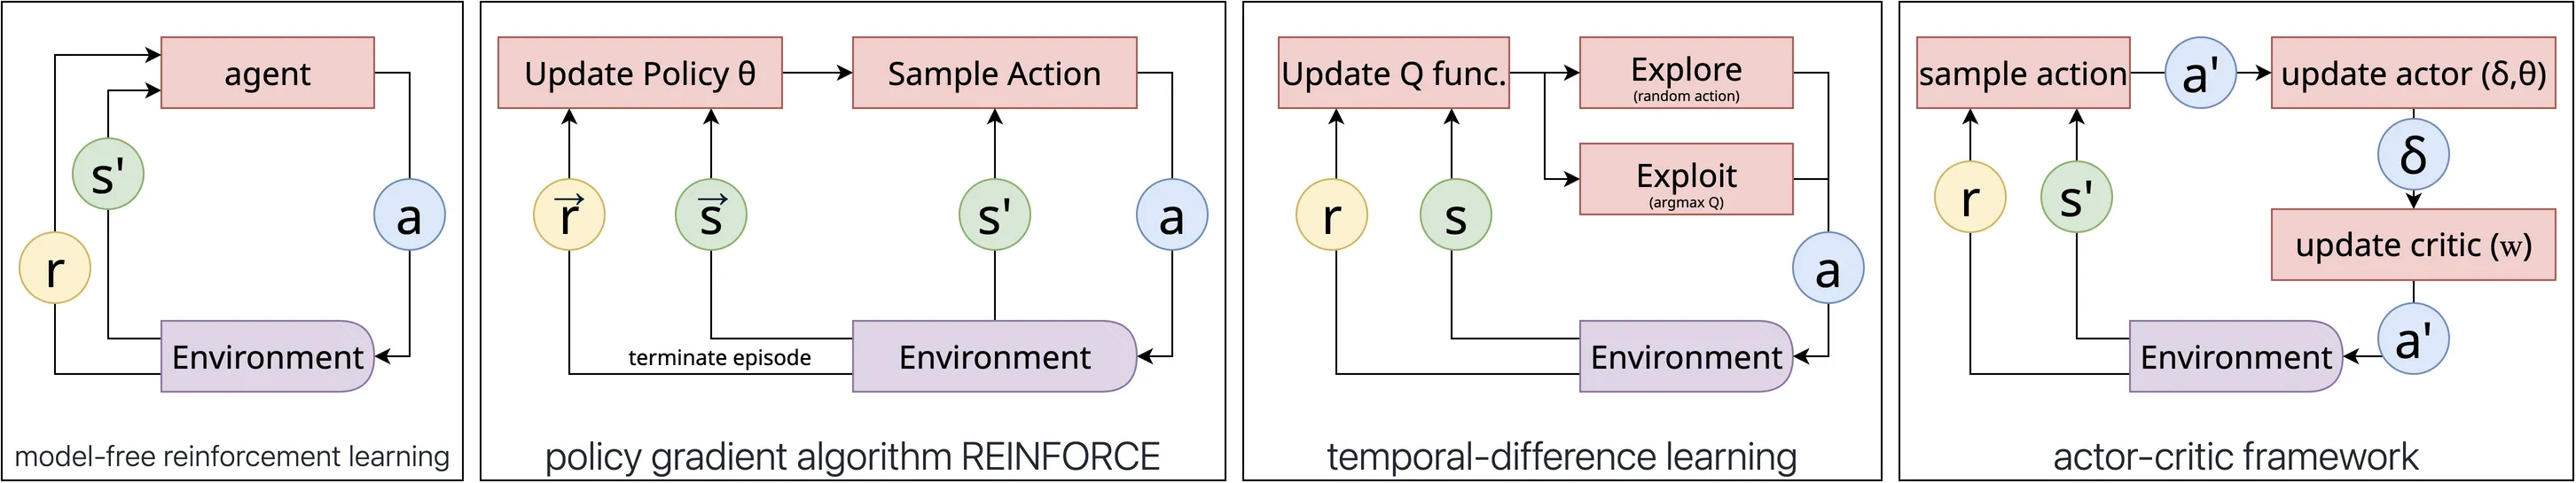
上記の図において、「s」は状態、「a」は行動、「r」は報酬を表します。
強化学習システム:反復とエピソード
見出しへのリンク
強化学習において、エピソードとイテレーションは異なる概念である。
エピソード:
エピソードとは、エージェントと環境との間の一連の完全な相互作用であり、初期状態から始まり、終端状態(または最大時間範囲)で終了します。
例: チェスのゲームでは、1エピソードは完全なゲーム、つまり開始盤面からチェックメイト、引き分け、または投了までを指します。
反復:
一部の論文やコードでは、1回の反復はエージェントと環境の相互作用の1つの時間ステップ(状態→行動→報酬→次の状態)を意味する場合があります。
最適化の文脈では、1回の反復とは、学習アルゴリズムの1回の更新ステップ(例えば、複数のエピソードや遷移に基づく勾配降下法の1ステップ)を意味する場合があります。
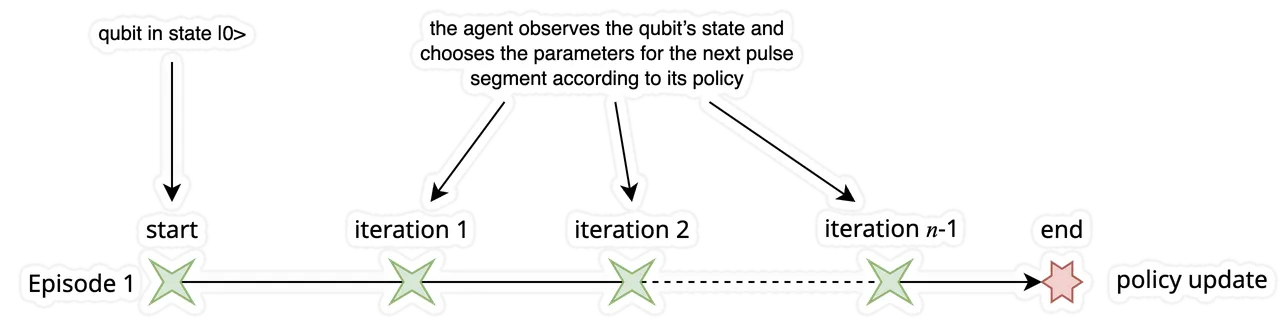
それでは、エピソードのサンプリングから始めて、これらのアイデアを一つずつ実行に移していきましょう。
エージェントは量子ビットの状態を観測する
そして、そのポリシーに従って次のパルスセグメントのパラメータを選択します。
実際に動作を体験して探求する:
決定論的に「最善の」行動(例えば、最も確率の高い行動)を選択する代わりに、サンプリングとは、エージェントが確率に従って、その分布からランダムに1つの行動を選択することを意味します。
このサンプリングは、reinforce メソッドにおいて不可欠です。
スコア関数を計算します。
ネットワークパラメータを特定の方向に微調整した場合に、選択された行動が発生する可能性がどれだけ高くなる(または低くなる)かを測定する。
つまり、サンプリングされた動作に対して∇(𝜃)を評価します。
パルスプログラムの終了時に報酬を計算します。
方策勾配強化学習では、スコアと報酬が共に学習の更新を促進する。
実践的な徹底解説:フラックスとジャックス
見出しへのリンク
完成予定
# 結論
すみません、軽い内容のブログにするつもりだったのですが、実際はもっと複雑になってしまいました。もしかしたら、まだ「方程式を単純化する」必要があるのかもしれません。いずれにせよ、ここで何を学んだのでしょうか?量子ビットの品質を最適に定量化するための最適化プロセスは次元が多すぎます。そして、当然のことながら、ニューラルネットワークはこの課題を解決するのに非常に優れています。このブログでは、単一量子ビットの忠実度最適化に焦点を当ててきました。しかし、2つ以上の量子ビットを考えてみてください。その場合、クロストークの影響を学ぶ必要があります。特に、多量子ビットレベルでグローバルに学ぶか、局所的に、そして量子ビットペアレベルで学ぶか、あるいは論理量子ビットレベルで階層的に学ぶかなど、学習方法に関して多くの疑問と課題があります。これらの多くの疑問については、次の量子誤り訂正に関するブログで取り上げます。
さらに詳しく知りたい方はこちら: