AIが膨大なエネルギーを消費する世界において、テンソル処理ユニット(TPU)はまさにゲームチェンジャーと言えるでしょう。これは、Googleが機械学習タスク専用に設計したカスタムチップです。
この簡単なメモは、TPUのアーキテクチャの概要と、2016年の登場以来どのように進化してきたかについて、システムレベルで概説することを目的としています。
また、この重要な疑問にも答えていきたいと思います。GPUがあるのに、なぜTPUが必要なのでしょうか?GPUにはないどのような利点があるのでしょうか?ニューロモルフィックICと比較するとどうでしょうか?そして、TPUやGPUに代わるアーキテクチャは存在するのでしょうか?
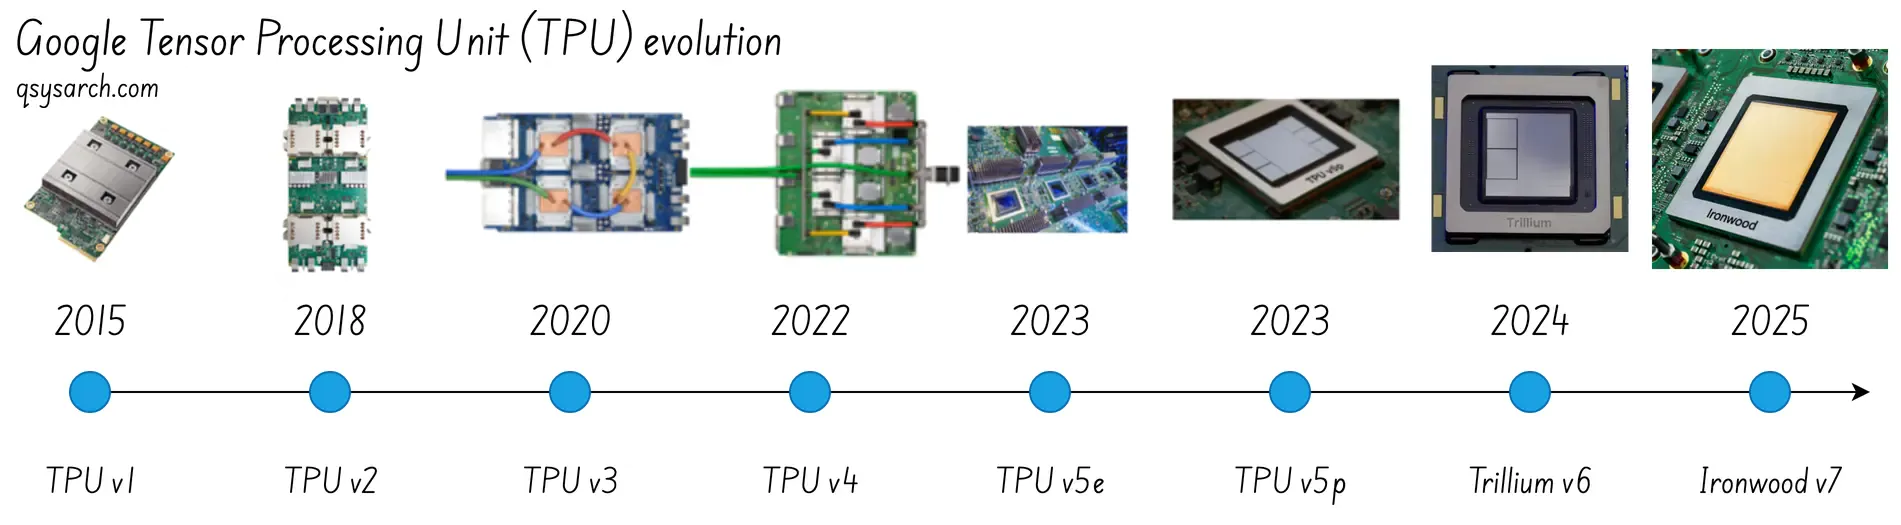 (出典: Google Cloud)
TPUが存在する理由、そしてそれが解決する問題とは
見出しへのリンク
TPUはGPUと同じ目標を共有しています。それは、大規模な並列処理を可能にすることで、ムーアの法則の減速によって生じた制限を克服することです。一般的な計算を処理するために使用できる従来のCPUとは異なり、マルチコアの概念によってある程度の並列処理が可能になっています(デナードのスケーリング法則のおかげです)。TPUとGPUは、単純で特定のタスクを処理するように設計された専用ハードウェアですが、どのCPUよりもはるかに効率的な方法で処理できます。
大まかに言えば、汎用CPUやGPUよりもはるかに優れた性能と効率性を実現するには、「汎用性を犠牲にして性能を高める」必要があると言えるでしょう。
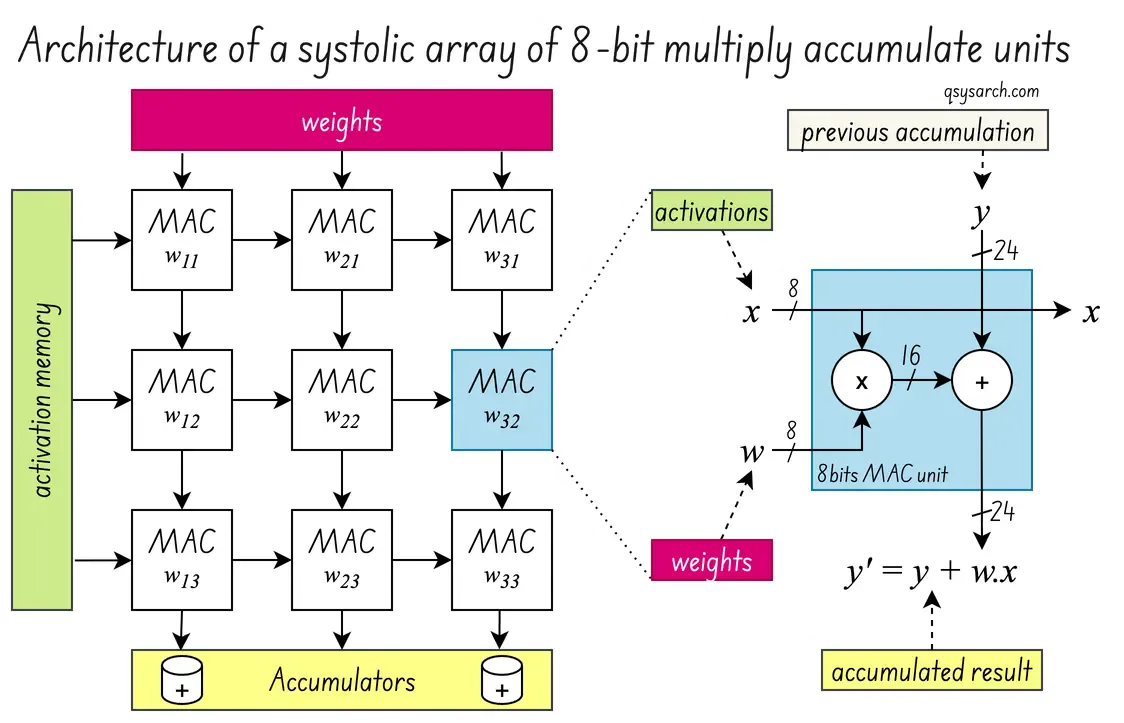
TPUは、ニューラルネットワークが使用する行列乗算やテンソル演算といった、負荷の高い線形代数処理のために根本的に設計されています。
TPUの中核を成すのはシストリックアレイと呼ばれるもので、並列計算を実行できる処理要素のマトリックス(通常は_PE_と呼ばれ、右の図では_MAC_と表記されている)である。
TPUの場合、この処理ユニット(MAC)は、活性化値(埋め込み)とニューラルネットワークの重みを乗算して累積する単純な8ビット乗算器です。この演算を大規模並列処理で実行することによってのみ、TPUはCPUよりもはるかに高いスループットを実現できます。GPUも同様です。しかし、まずはTPUの進化の歴史を見ていきましょう。
TPUv1はわずか15ヶ月で開発され、主な目標はニューラルネットワークの推論性能の向上(学習性能ではなく、推論性能のみ)でした。そのため、Googleは行列乗算器を必要とし、高速化だけでなく消費電力の削減にも制約がありました。消費電力削減の鍵は、メモリ局所性の向上、つまり外部メモリとTPUメモリ間の不要なデータ移動の削減でした。これにより、制御単位あたりの演算強度を高め、TPUがデータを待つアイドル時間を短縮することが可能になります。
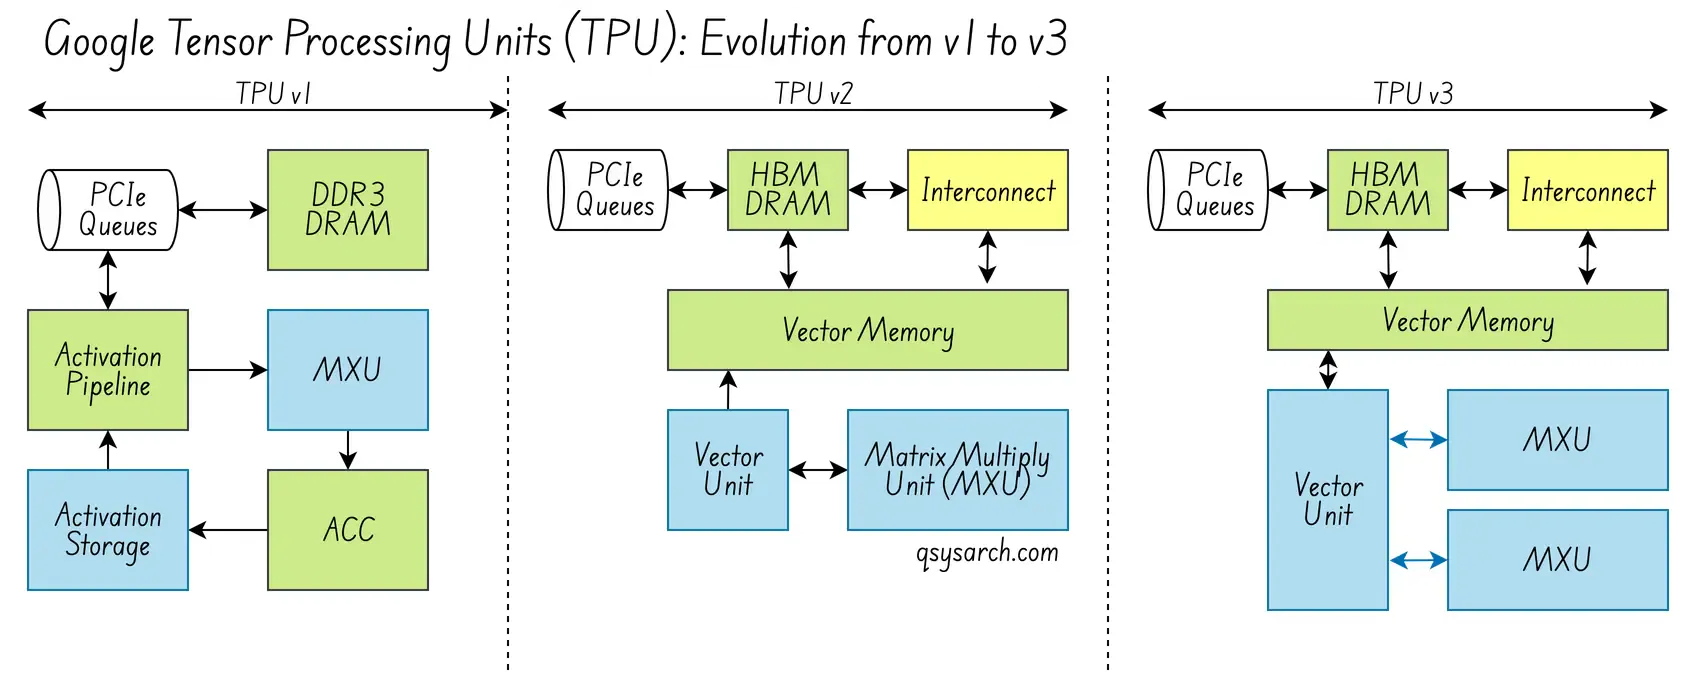
ハードウェアの観点から見ると、TPU v1の設計はシンプルでありながら、洗練された効果を発揮していた。
標準的なPCIeカードに搭載されたシングルスレッドのコプロセッサ。
マルチレベルキャッシュ、マルチスレッド、分岐予測は利用できません。
MXU(行列乗算ユニット)による8ビット整数に対する高速な決定論的演算。
シストリックアレイは256 * 256 * MXUで構成されます
複雑な処理はソフトウェアスケジューラに移管され、その主な役割は2つある。
- MXUがアイドル状態にならないように操作スケジュールを組むことで、パイプを常に稼働状態に保つ。
メモリアクセスの遅延を隠蔽する手段として、メモリをダブルバッファリングする。
TPUv2とv3:メモリとインターコネクトの改善
見出しへのリンク
v2とv3の重要な概念は、バックプロパゲーション、より高い精度、そしてより多くの分散型で相互接続されたTPUを必要とする次世代モデルのトレーニングです。
ハードウェアコア処理の観点から見ると、彼らは実に多くの優れた概念を導入した。
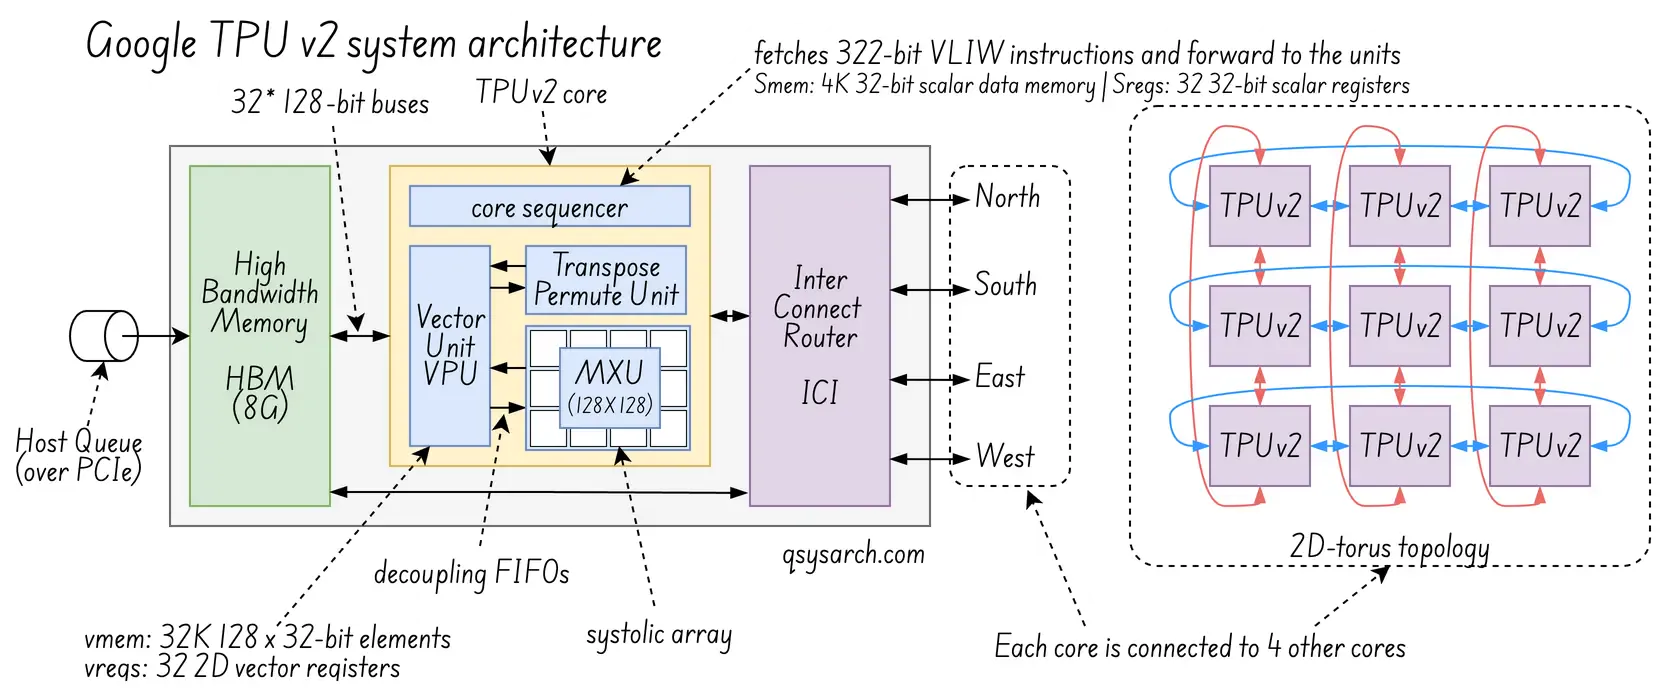
デュアルコアチップ、例えば1つの__TPUv2__は2つのTPUで構成されています
各TPUは、__128*128 MXU__で構成される4倍の規模のシストリックアレイを備えていました。
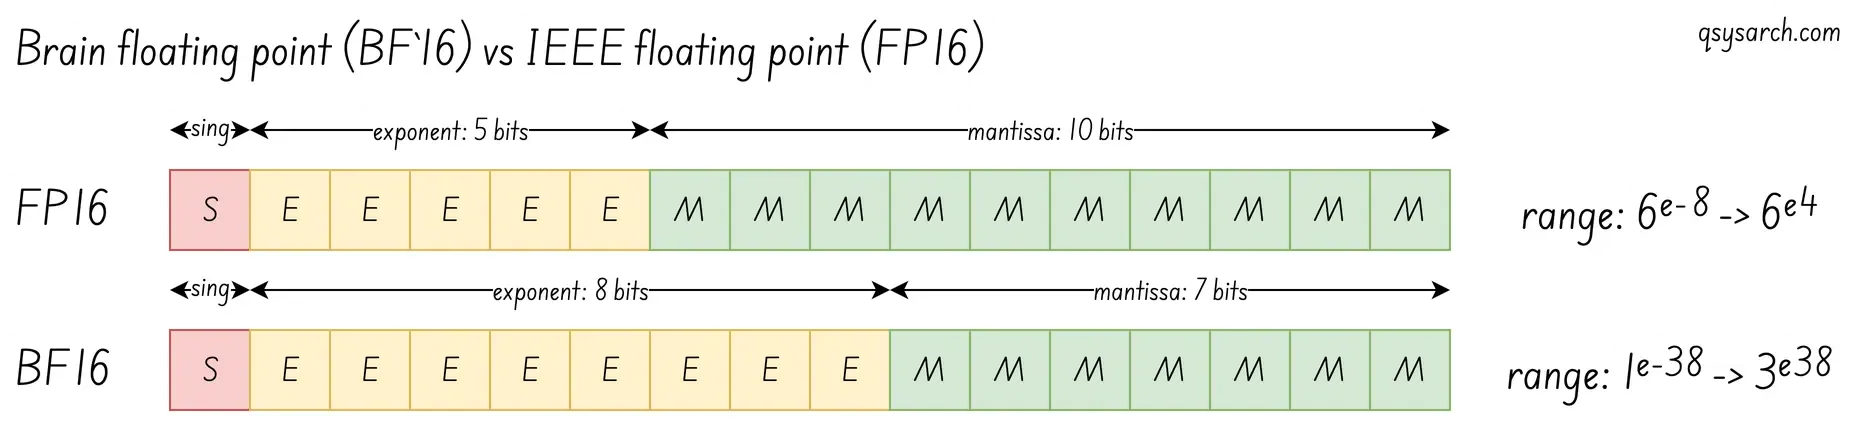
標準のIEEE 754 FP16浮動小数点フォーマットの拡張版であるBrain浮動小数点フォーマット(BF16)を使用して、浮動小数点値を処理する機能。
TPU内部に新しい高帯域幅メモリ(HBM)を搭載し、メモリへのアクセス遅延を低減。(TPUv1は基本的なDRAMのみを搭載しており、アクセス時間が遅いのに対し、HBMははるかに高速です。)
ハードウェア接続性の観点から、
- 16x16 2D トーラス ネットワーク (リング ネットワーク) を介した、拡張性を可能にする高帯域幅ファブリックであるインターコア相互接続 (ICI) - 256 個のチップからなるスーパーコンピュータ ポッド。
ソフトウェアの観点から見ると、強力なコンパイラとは:
- XLAコンパイラ: コアシーケンサ(TCS)で使用されるVLIW命令を生成する頭脳。
TPUv4: ハイパースケールAI
見出しへのリンク
v4の重要なコンセプトは、AIモデルを超大規模に実行できる能力でした。つまり、主要な推進指標は総所有コスト(TCO)でした。
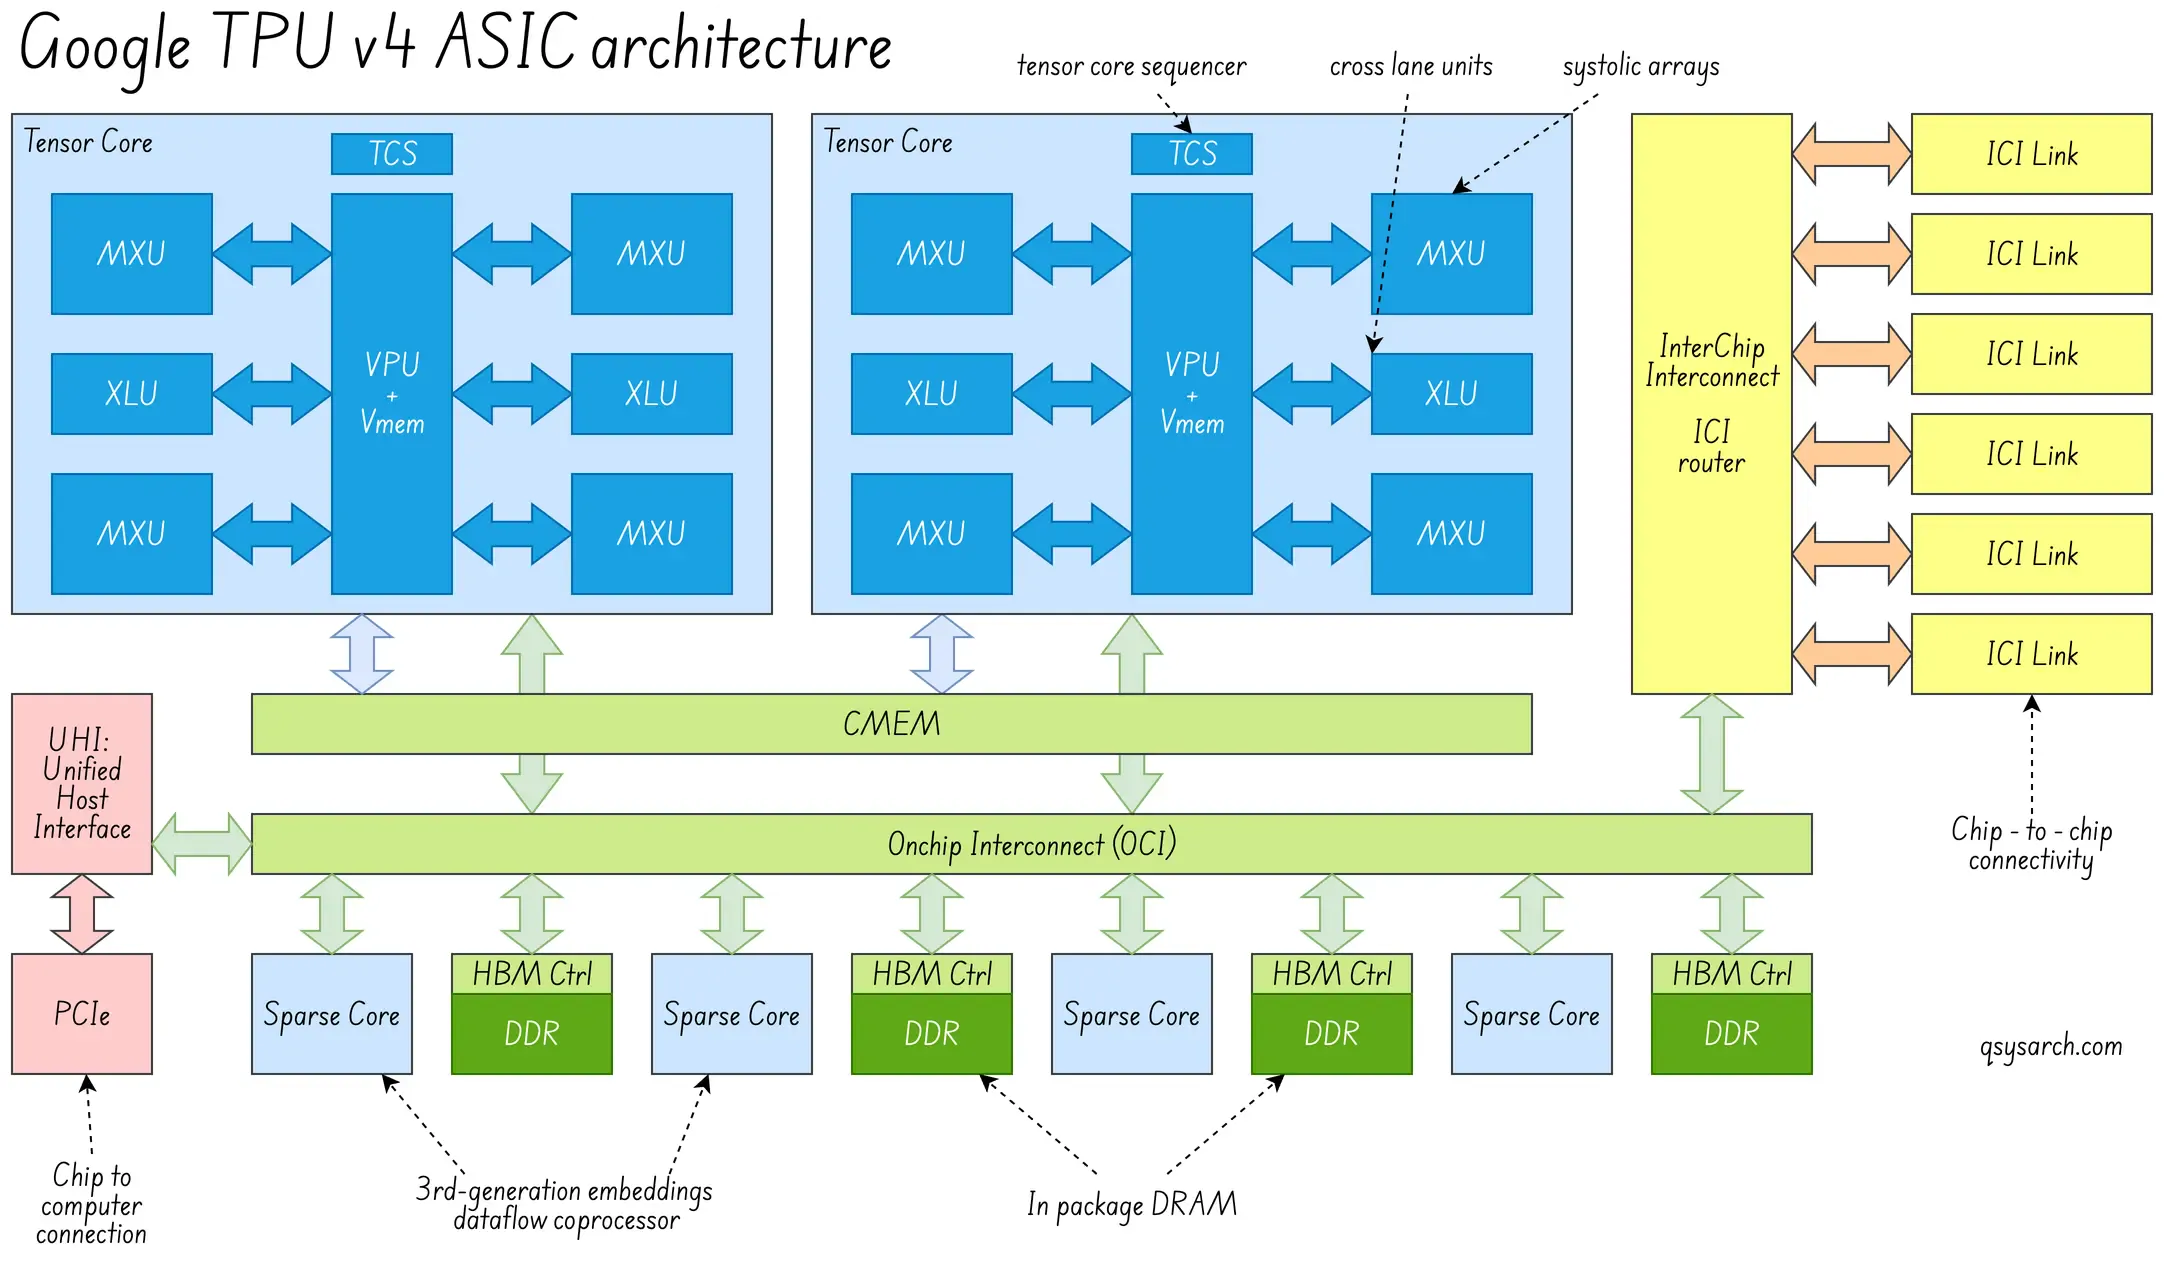
最新世代のチップは、大規模なトレーニング向けに設計されています。チップはラックまたはポッドに接続され、高度なメモリシステムと相互接続を備えています。これらは、大規模なテンソル演算、分散トレーニング、同期、および多数のチップ間での効率的なデータ共有をサポートします。
ハードウェアコア処理の観点から見ると、彼らは実に多くの優れた概念を導入した。
ハードウェア接続性の観点から、
TPUv4は、TPUv2およびv3と同様に、同一ラック内のTPU間の高速電気リンクとして実装されたインターコネクトルータ(ICI)を引き続き使用しています。
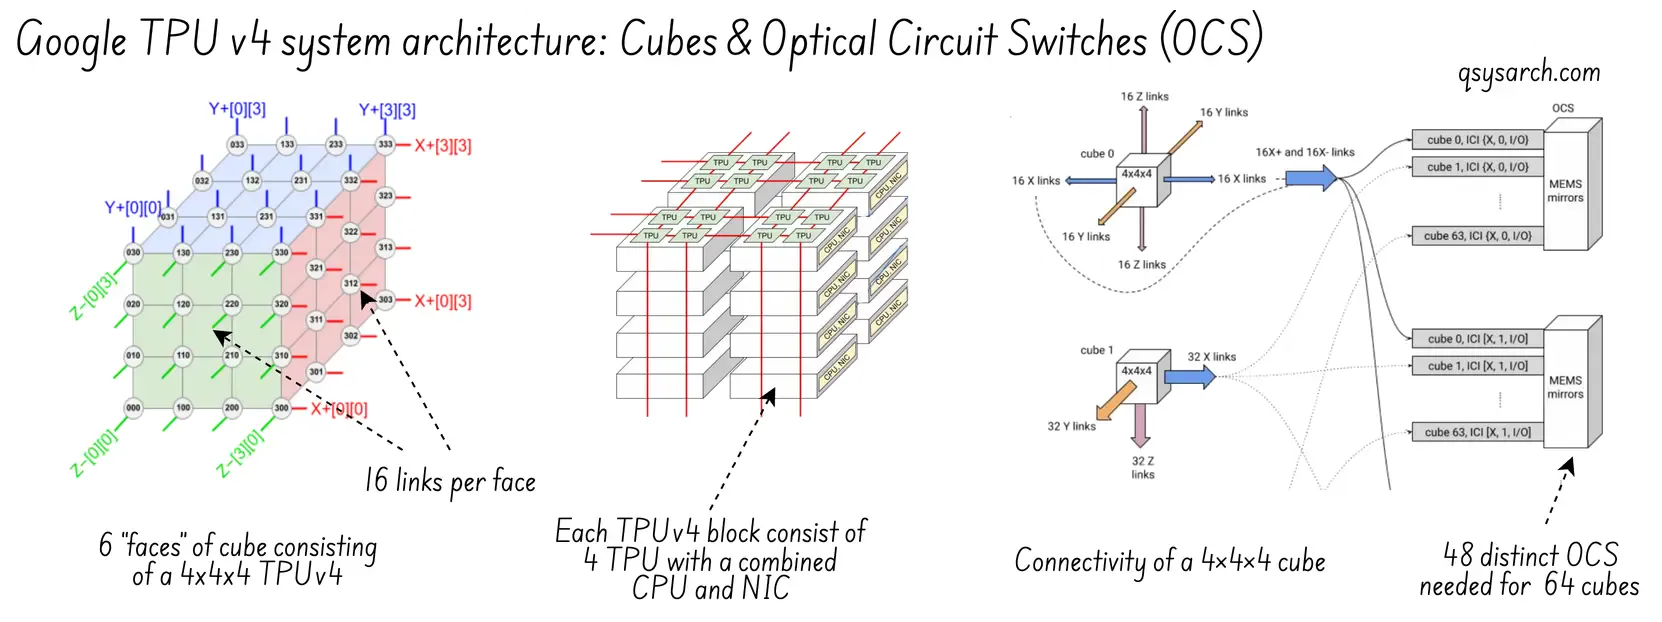
ただし、TPUv4ではラック間に光リンクが追加され、光回路スイッチング(OCS)と呼ばれる機能が備わっています。これにより、1つのポッド内のTPU数を4K(1つのラックでは64個)に増やすことができ、OCSルーティングを再構成することで障害を軽減できます。
最後になりましたが、ルーティングは3次元になり、3Dトーラスが実装されました。これは、2Dトーラスよりも通信効率を大幅に向上させるという無視できない利点があります。
ソフトウェアの観点から:
新しいツールの導入: クラスターマネージャとして Borg、OCS を構成するポッドマネージャ、ICI ルーティング テーブルをセットアップしてフォールトトレランスに対応する Libpunet。
高度なシングルプログラムマルチデータ(SPMD)コンパイラ:これは、各スレッドが同じラック内またはラック外の異なるTPU上で実行されるプログラムである複数のスレッドを生成するコンパイラと考えることができます。これは、コンパイラがGPUワープ内のスレッド用のコードを生成するGPUのSIMTコンセプトにいくらか似ています。
多くの TPU が同じプログラムを実行しているため、Borg オーケストレータはすべての TPU が同期していることを確認する必要があります。これが Gang Scheduler の役割です。
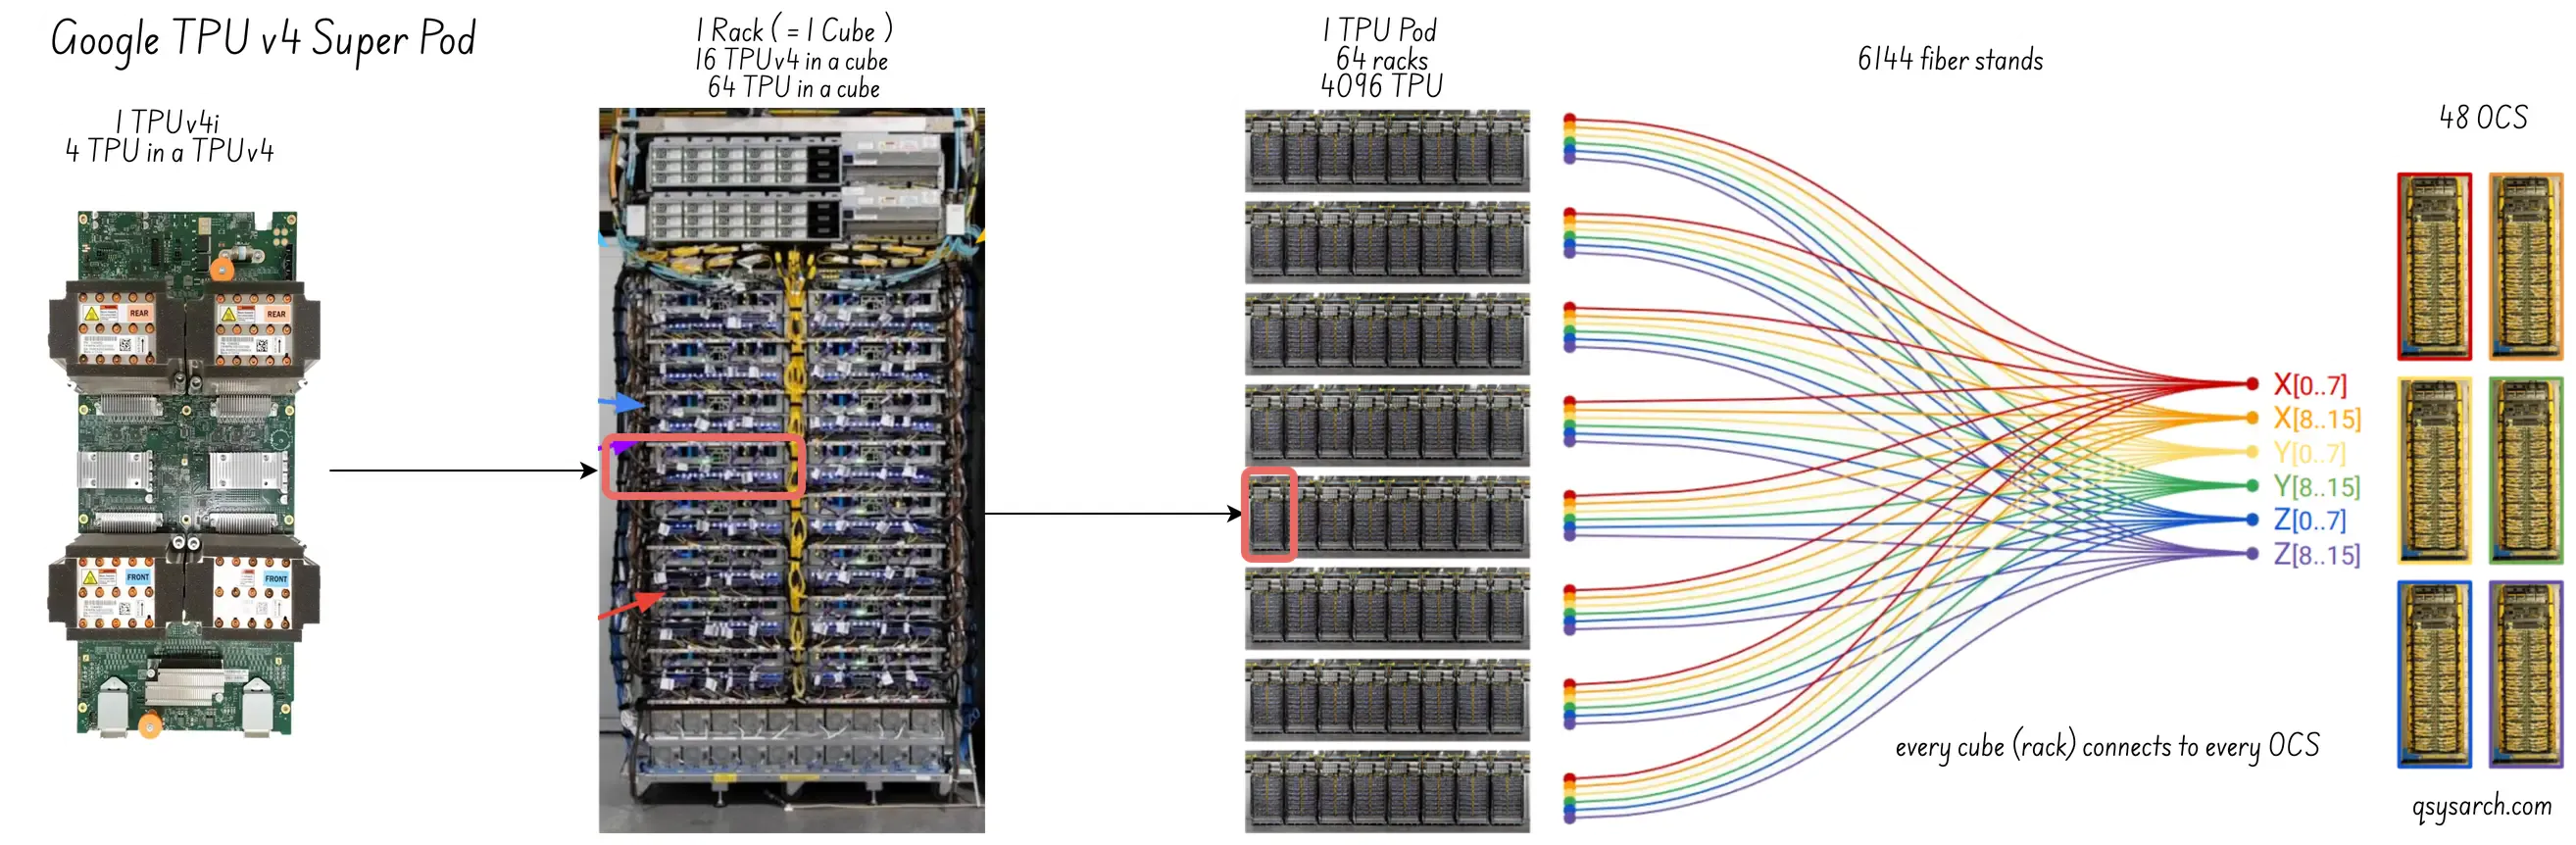
- MoEにおける非同期データフローを処理するために必要な「パスウェイ」の概念について説明します。
TPUv4 の SparseCore (別名 SC) は、疎行列を用いたワークロードの高速化を担当します。疎行列では、ほとんどの値がゼロまたは冗長です (これは LLM に含まれる埋め込みの場合に該当します)。これは「埋め込みルックアップ」オプティマイザとして説明されており、各 TPUv4 には 4 つの SparseCore プロセッサが含まれています。
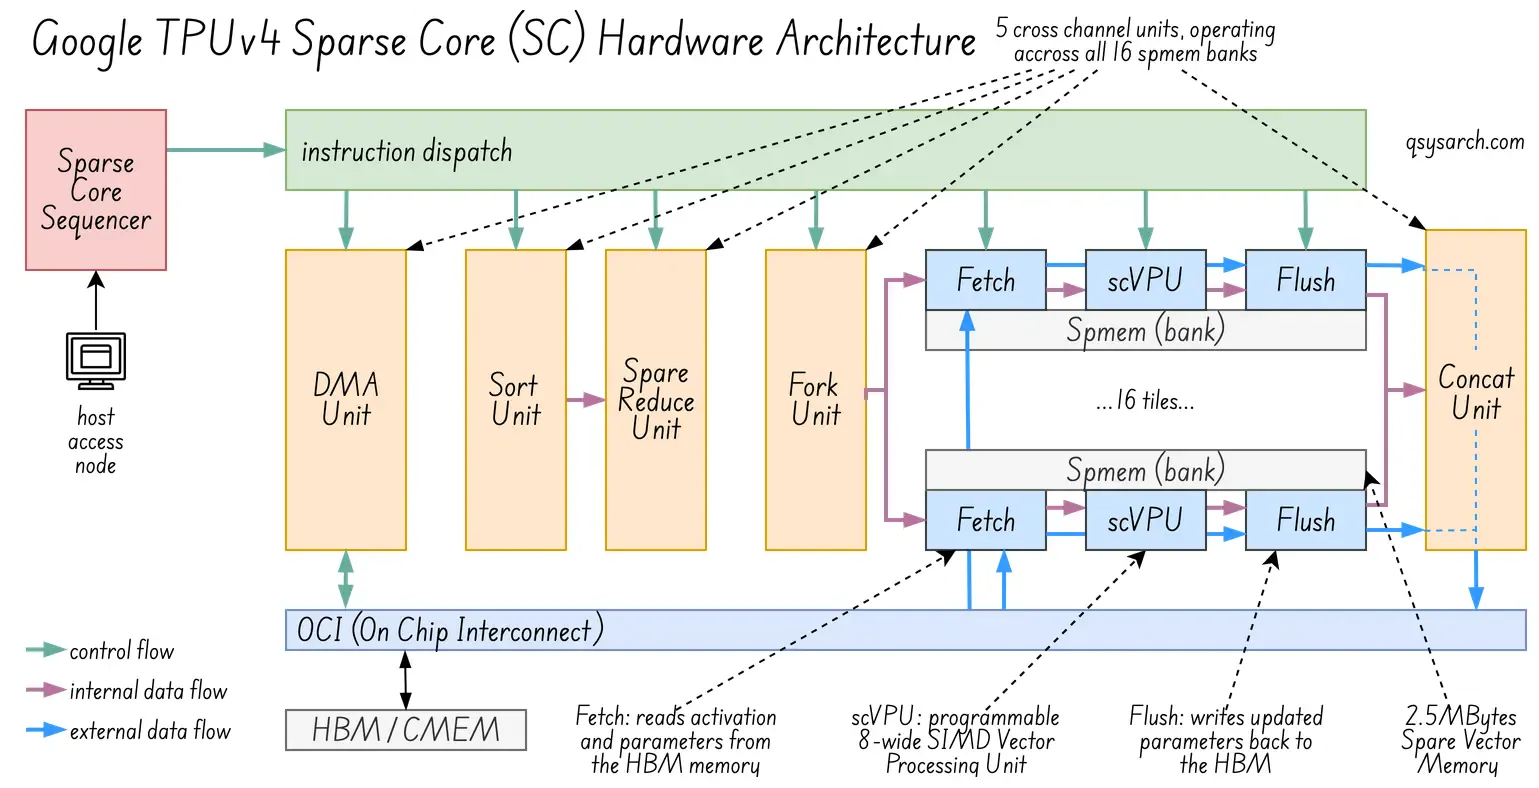 (画像は元の画像ソースから改変)
SparseCoreシーケンサー(左上隅の赤色部分)は、5つのクロスチャネルユニット(オレンジ色部分)と3つの「フェッチ/処理/フラッシュ」SIMDユニット(青色部分)に命令をディスパッチする役割を担うオーケストレーターです。各SIMDユニットは、それぞれ専用の2.5MBの密結合メモリスクラッチパッド(灰色部分)上で動作します。
各フェッチ/処理/フラッシュSIMDユニットは一度に8つのデータレーンを動作させ(SIMD=8)、スパースコアプロセッサにはそのようなSIMDユニットが16個搭載されているため、非常に強力な処理ユニットとなっています。まるでGPUの中に小さなGPUが1つあるようなものです!正確には、TPUの中に4つの小さなGPUがあると言えるでしょう!
この強力な SparseCore 処理ユニットをプログラミングするために使用されている ISA を見てみたいのですが、オンラインで情報が見つかりませんでした。おそらく、非常に特殊な命令を持つ強力な「同期 SIMD ALU 対応 DMA コンピュータ」のようなものなので、JAX ライブラリのような高レベルの抽象化を提供する方が理にかなっているのでしょう。
実際には、ユーザーが高レベルの機能コードを記述し、XLA(加速線形代数)コンパイラがSparseCoreのハードウェア機能に合致するパターンを識別する。
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
@nn.compact
def __call__(self, indices):
embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
内部では何が起こっているのでしょうか?model.apply メソッドは XLA コンパイラを呼び出し、コードを SparseCore にダウングレードします。この際、nn.Embed (gather 操作) に一致させ、以下の「擬似命令」を生成します。
Dedup: XLAは入力データに42と105が2回出現していることを検出しました。フェッチの前にこれらの重複を排除するためにSparseCore命令を生成します。
DMA: ID 105、42、および 28 のメモリオフセットを計算する SC スカラー命令を生成します。
Push: 結果として得られた 5*128 テンソルを共通メモリ (CMEM) に戻します。
XLAコンパイラは、データの配置についても考慮する必要があります。特に、スパースコアはnn.Embedインデックスにアクセスする必要があるため、これらのインデックスはスパースコアからアクセス可能なメモリに配置する必要があります。CMEMに配置することもできますが、CMEMは非常に小さい(128MB)ため、通常は埋め込みデータを大容量のHBM(TPUv4の場合は32GB)に配置します。ただし、スパースコア処理の出力はデータの一部に過ぎないため、CMEMに戻されます。
また、SparseCoreアーキテクチャは、v6以降の世代で進化を遂げていることにも注目すべきである。
教育省の専門家混合型プログラムと進路選択
見出しへのリンク
専門家混合モデル(MoE)は、従来のモデルとは異なり、…
pathways という概念は、トークンが異なる TPU チップ上に存在するエキスパート間でシャーディングされる際にたどる物理的および論理的な経路を指します。
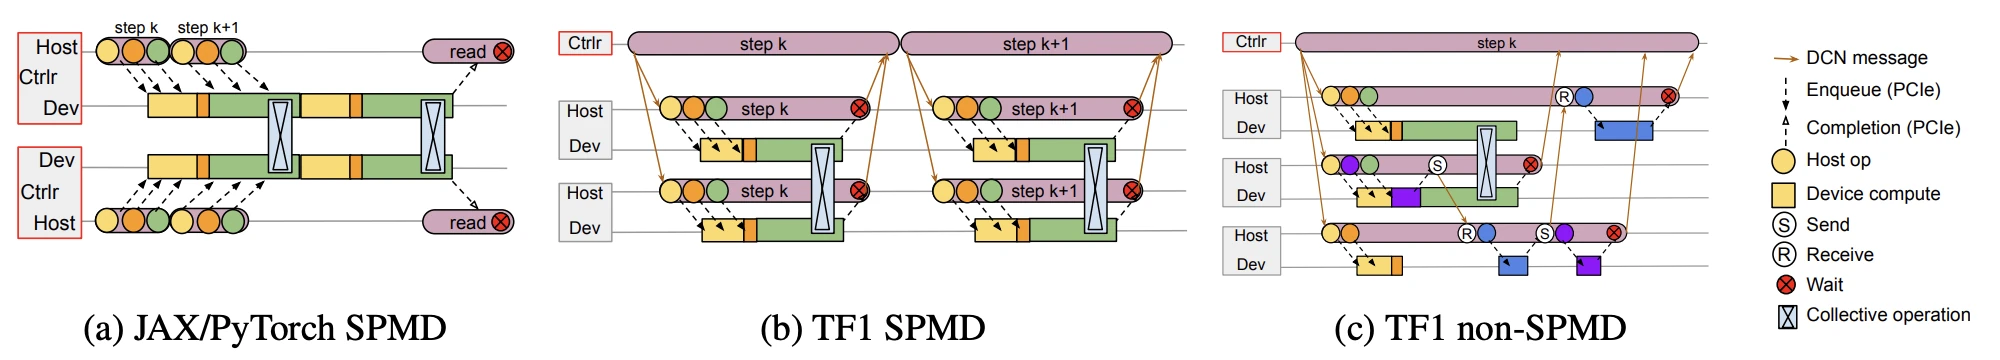 (画像ソース)
2023年以降:v5、v6(トリラム)、v7(アイアンウッド)
見出しへのリンク
新型モデルに関する情報はあまり多くないので、主な情報は以下のとおりです。
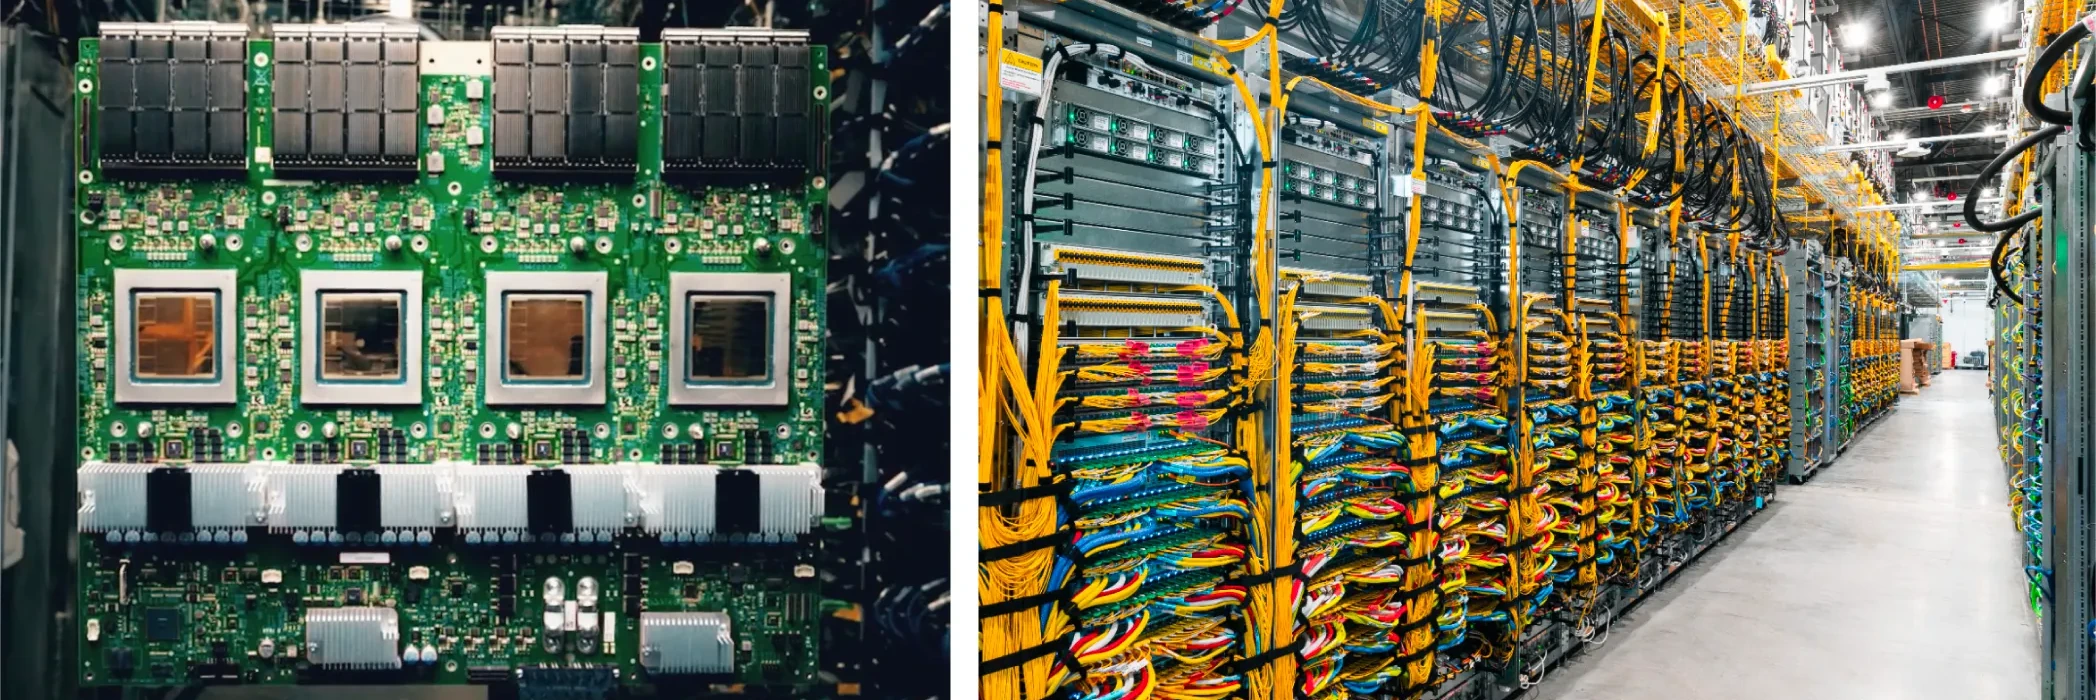
Ironwood v7では、スーパーポッドは約9,000個のTPUで構成されます。
TPUがあるのに、なぜまだGPUが必要なのでしょうか?
見出しへのリンク
メモリ、演算能力、エネルギー消費、データ通信のバランスをとったTPUの設計は、高性能なAIシステムを大規模に構築するには、単に高速なチップを用意するだけでは不十分であることを示している。ハードウェア、ソフトウェア、システム、ネットワーク接続間の連携も不可欠である。
推論、トレーニング、スパースモデル、レコメンデーションシステムなど、AIワークロードは今日ではより多様化していますが、TPUはピクセル処理用に設計されていません。しかし、GPUは今日では人気がありません。これは、NVIDIAがGPUをTPUのように動作させるプログラムモデルと開発者エクスペリエンスを公開したためです。
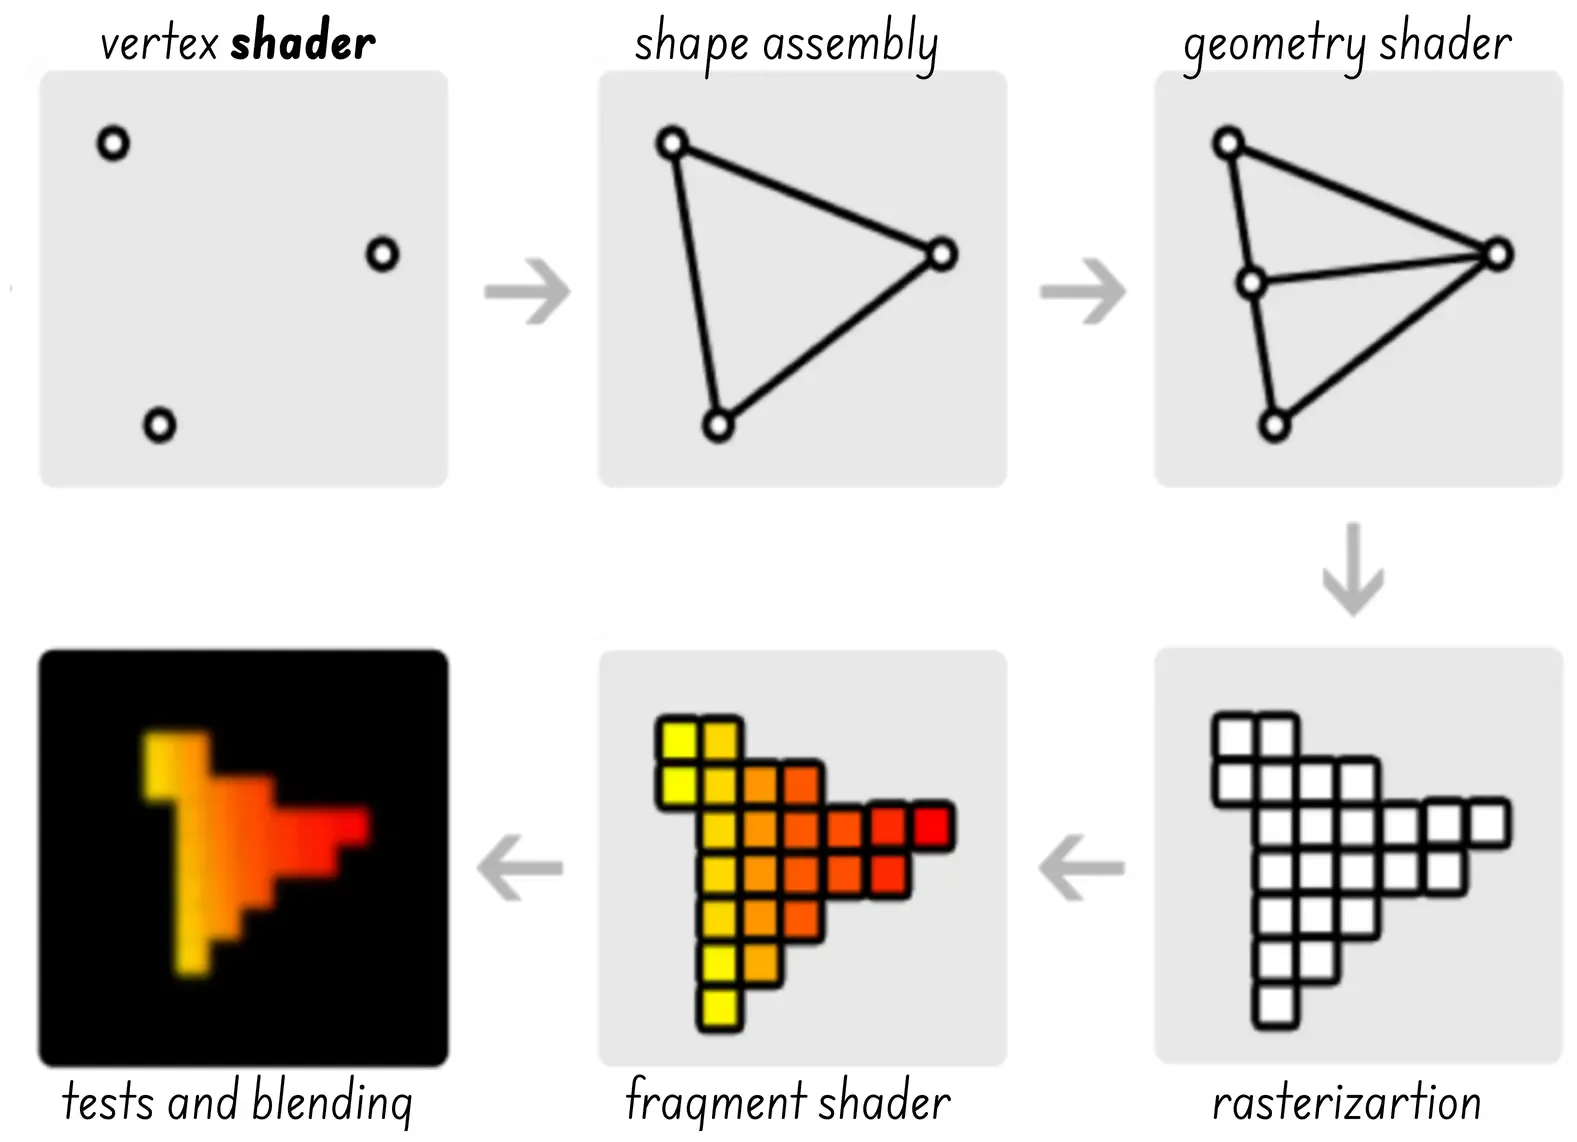
これはGPUが優れているという意味でしょうか?必ずしもそうではありません。特定のワークロードにおいては、TPUはGPUよりも効率的になる場合があり、特に消費電力とワットあたりのパフォーマンスにおいて顕著です。そして、AIデータセンターがますます多くのエネルギーを消費する現代社会において、TPUは大きな違いを生み出す可能性を秘めています。
アナログニューロモルフィックICについてはどうでしょうか?
見出しへのリンク
ニューロモルフィックICはどうでしょうか?TPUと比較して、アナログコンピューティングと低周波イベント駆動処理を用いることで、さらに低消費電力を目指しています。ニューロモルフィックICが主流となり、TPUv7スーパーポッドと同じ規模に達するには、何が必要でしょうか?
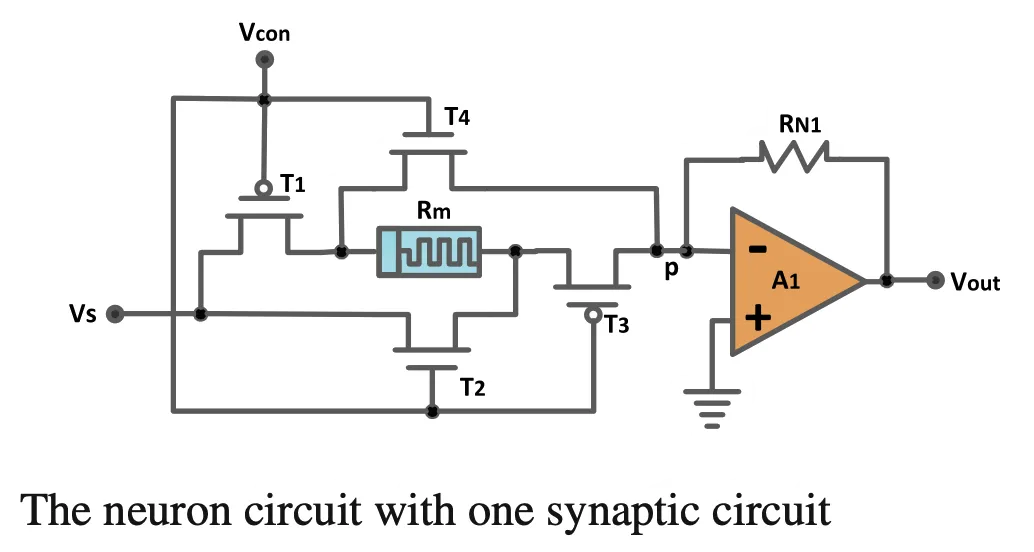
私がまだ抱えている課題の一つは、シストリックアレイ(MXU + スペアコア)とTPUの残りの部分(ICI、OCI、TCSを含む)の相対的な消費電力をよりよく理解すること、そしてこの比率がニューロモルフィックスパイクニューラルネットワーク(SNN)と制御ロジック(RiscVとSpike copro)の比率とどのように比較されるかを理解することである。
また、ニューロモルフィックICがTPUv7と同等の規模に達するとすれば、ソフトウェア、システム、ネットワーク接続にも同様の投資が必要になるだろう。そうでなければ、SNNをTPUに接続し、TPUの「制御ロジック」を使ってSNNとTPU/ラック/パッドの残りの部分との通信を処理することも考えられる。しかし、本当にそのような必要性があるのだろうか?一体どんな問題を解決しようとしているのだろうか?もしかしたら、考え方を変える必要があるのかもしれない。
バック・トゥ・ザ・フューチャー:言語処理ユニット
見出しへのリンク
このメモは、大規模な言語モデルの推論を最適化するために設計された新しいタイプのプロセッサである言語処理ユニットについて言及せずには完成しません。
このトピック専用のメモを作成する必要があるので、今のところは、LPUが推論のみに焦点を当て、トレーニングには焦点を当てていなかったTPUv1の再発明以上のものなのかどうかを理解しようとする、高レベルの比較にとどめます。
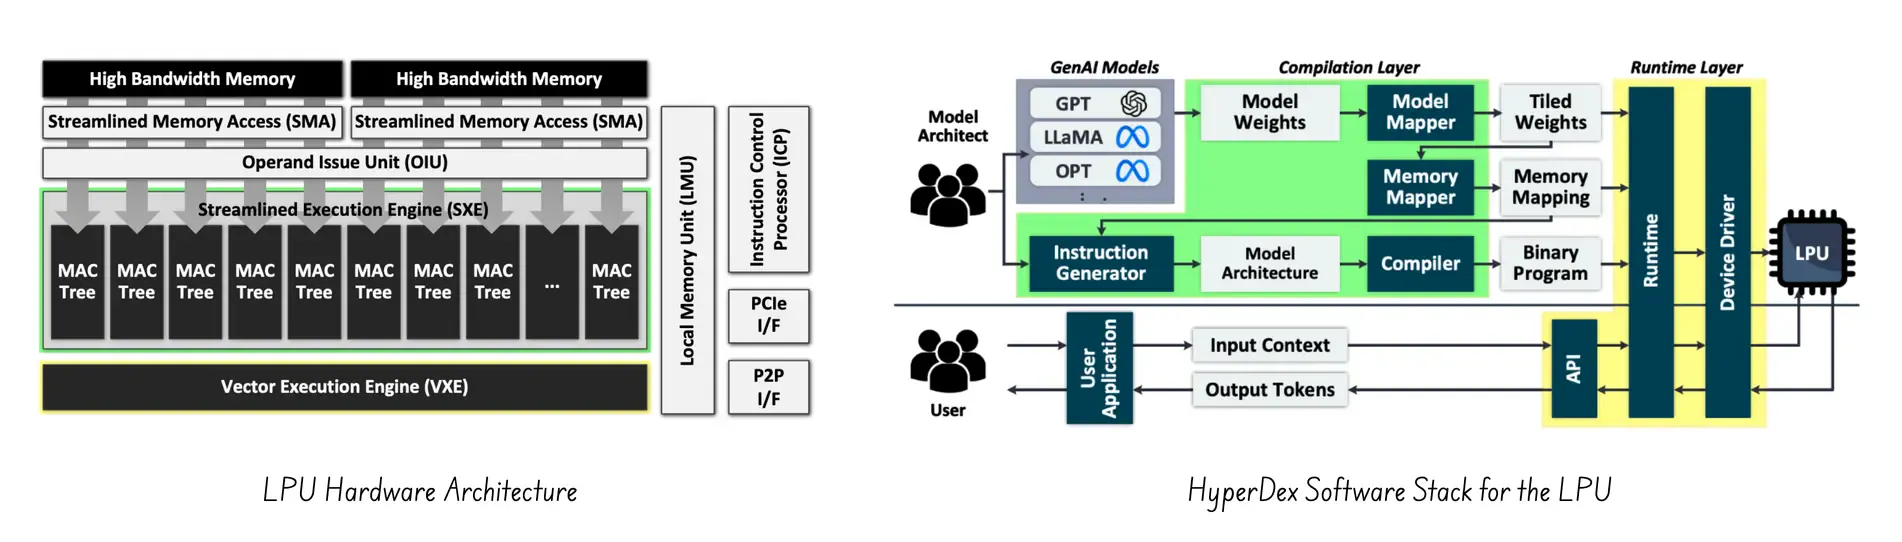
大まかに言えば、TPUとLPUは、ドメイン固有アーキテクチャ(DSA)を使用して、いくつかの処理を非常に効率的に、かつ大規模に実行する必要があるという点で共通しています。しかし、具体的な実装と最適化に関しては、LPUは全く異なるものであり、焦点も異なります。
主な違いは、TPUv1はLLMが存在する以前に設計されたものであり(ChatGPTの最初のリリースは2022年だったことを思い出してください)、一般的な深層ニューラルネットワーク(DNN)推論に重点を置いていた点です。つまり、基盤となるMXUシストリックアレイによって実現される、大規模かつ高負荷な処理におけるスループットとワットあたりの性能を確保する必要がありました。
一方、LPUは大規模言語モデル(LLM)の推論を最適化するように設計されています。LPUはトークンあたりのレイテンシの改善に重点を置いており、そのためには、完全に決定論的で静的にスケジューリングされたVLIWベースのマルチパイプラインアーキテクチャをサポートするISAが必要です。もちろん、TPUv4がTCS向けに同様のVLIW ISAを導入していると主張する人もいるかもしれません。しかし、主な違いは、LPU ISAは完全に決定論的なVLIWマシンであり、すべてのロード、計算、およびストアがサイクルごとにスケジューリングされるのに対し、TPUではMXUは「自己駆動型」のシストリックアレイであるという点です。
# 結論
というわけで、今回も予想以上に時間がかかってしまった短いメモです。今回の詳細な分析から明らかになったのは、TPUアーキテクチャの進化は、AIアクセラレータの設計が多くの要素のバランスを取る必要のある複雑な作業であることを示しているということです。
メモリ、演算能力、エネルギー消費、データ通信のバランスをとったTPUの設計は、高性能なAIシステムを大規模に構築するには、単に高速なチップを用意するだけでは不十分であることを示している。ハードウェア、ソフトウェア、システム、ネットワーク接続間の連携も不可欠である。
これはどこか既視感を覚える。量子処理ユニット(QPU)は、AIアクセラレータの進化における次の段階なのだろうか?
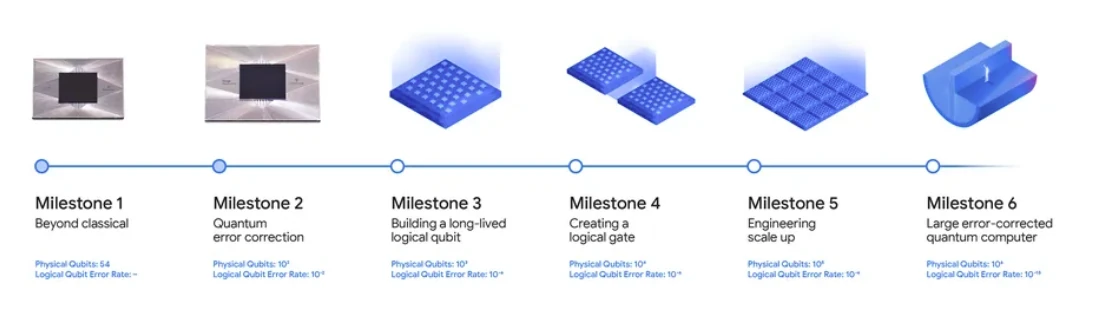 (画像出典: Google Willow)
このメモで使用されているDrawIO図: