
GPUの文脈におけるRDMAに関連するバズワードは数多く存在します。GPUダイレクト、NVLink、NVLink Fusion、InfiniBand、Quantum InfiniBand、GPUNetIO、DOCAなどです。これらは紛らわしいものですが、必ずしもそうである必要はないのかもしれません。
この記事は個人的なメモ形式で書かれており、様々な技術について説明し、いくつかの図を用いて視覚化することを試みています。
GPU DirectとRDMA:マーケティングとテクノロジー。
見出しへのリンク
では、まずはNVIDIA公式ドキュメントの紛らわしいGPUNetIOページから始めましょう。
RDMAという略語は、一方のコンピュータのオペレーティングシステムを介さずに、もう一方のコンピュータのメモリへリモートで直接メモリアクセスを可能にするプロトコルを表しています。…これは、RDMAプロトコルとは無関係なGPUDirect RDMAと混同してはいけません。
なるほど、つまりGPUDirect RDMAはRDMAプロトコルとは異なるんですね!でも、GPUDirect RDMAは少なくともRDMAプロトコルを使用しているのでしょうか?そうだといいのですが。そうでなければ、本当に混乱してしまいます。
GPUDirect RDMAは、NVIDIAが提供するGPUDirectテクノロジーファミリーに含まれる技術の一つです。これにより、ネットワークカードはCPUメモリのコピーやオペレーティングシステムのルーチンを介さずに、GPUメモリに直接アクセスしてデータを送受信できます。GPUDirect RDMAは、イーサネット、InfiniBand、またはRoCEに対応したあらゆるネットワークフレームワークで有効化できます。
さて、少なくともGPUDirect RDMAはイーサネット(ETH)でもInfiniBand(IB)でも、どのトランスポート層でも実装できることは明らかです。では、GPUNetIOとは何でしょうか?そして、RDMAとどのように関係しているのでしょうか?答えは簡単です。GPUNetIOは、その名前が示すように、ネットワークカード上でGPU Direct RDMAを実装するネットワークベースのものです。これは、GPU Directがネットワークカードから駆動される必要があるという意味ではなく、GPUNetIOがネットワークカードの種類に特化したバージョンであるという意味です。
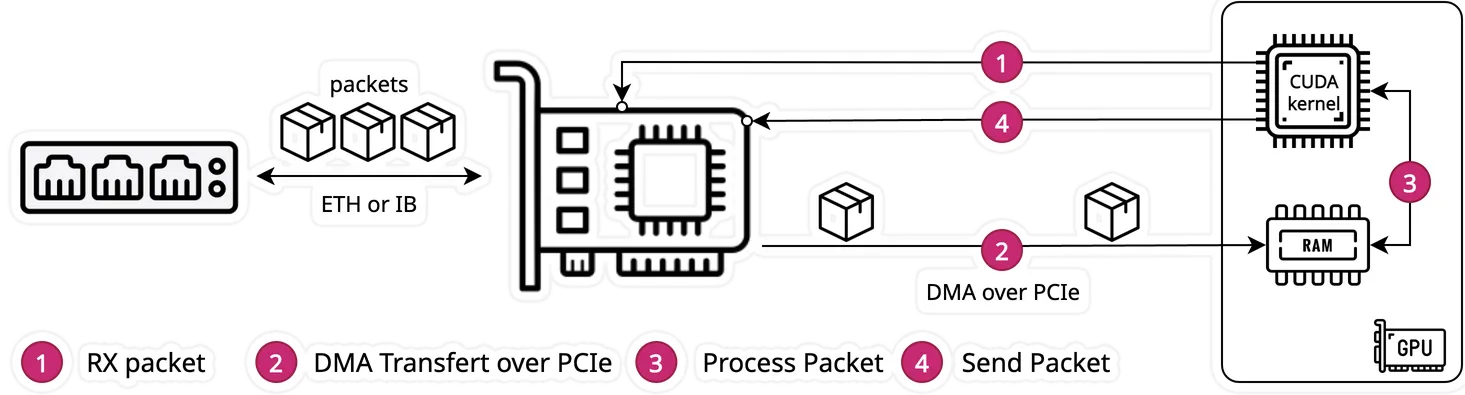
上記の図の GPUNetIO ドキュメント にある「CUDA」ボックスは少し分かりにくいです。これは GPU 上で実行されるカーネルだと推測されますが、ドキュメントに何が書かれているか確認してみましょう。
従来のアプローチでは、CPU 中心のモデルに依存することが多く、CPU は NIC と連携して GPUDirect RDMA を使用して GPU メモリにパケットを受信します。その後、CPU は GPU 上の CUDA カーネルにパケットの処理を通知します。… DOCA GPUNetIO は、CPU をクリティカル パスから排除する GPU 中心のソリューションを提供することで、この課題に対処します。
私にはまだ完全には理解できていません。クリティカルパスは「GPU中心」とありますが、クリティカルパスとは何でしょうか?図に示されているステップ(1)から(4)のことでしょうか?そして、CPUは依然として何のために必要なのでしょうか?答えを見つけるには、「非同期カーネル開始」モードを確認する必要があります。これは、「GPU CUDAカーネルがネットワーク通信を制御してデータを送受信する」可能性として説明されています。GPUDirect IKAは以下を可能にします。
GPUはイーサネット通信(イーサネット/IP/UDP/TCP/ICMP)を制御できます。
GPUはRDMA通信を制御できます(InfiniBandまたはRoCEをサポート)。
アプリケーションのクリティカルパスではCPUの介入は不要です
つまり、これは100%明確です。
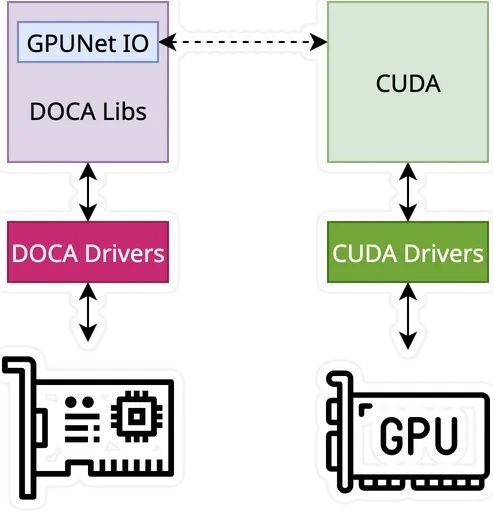
GPU Direct RDMAは、CPUによるステージングコピーなしで、GPUメモリとの間で直接データ転送を可能にします。
GPU Direct AKIは、GPUがネットワークカードを「制御」することを可能にします。
GPUNetIOは、GPUダイレクトRDMAとAKIの両方のテクノロジーを処理するソフトウェアコンポーネントです。
DOCAは、NVIDIAがGPUNetIO対応ハードウェア(その他)をプログラミングするために提供するSDKです。
混乱の原因は、「AKI」を「GPU Direct RDMA + AKI」と表記すべきであるという事実にあると思われます。なぜなら、AKIはCPUをバイパスできるRDMA機能を補完するものだからです。
NVIDIAがGPUNetIOという名称で販売しているGPU Direct RDMAは、ネットワークカード(NIC)ベースのソリューションであり、PCIe接続を介してGPUとNICを接続するものであることが分かりました。このPCIe接続について詳しく見ていき、GPUNetIOの部分は抽象化し、RDMAの部分に焦点を当て直してみましょう。
CUDA GPUDirect RDMAの公式ドキュメント(https://docs.nvidia.com/cuda/gpudirect-rdma/index.html)には、必要なのはPCIeルートコンプレックスだけだと記載されています。
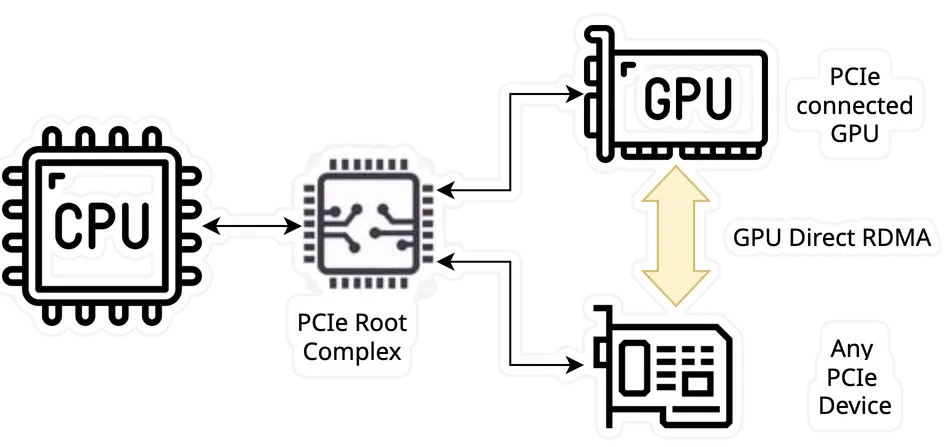
GPUDirect RDMAは、KeplerクラスのGPUとCUDA 5.0で導入された技術で、PCI Expressの標準機能を使用してGPUとサードパーティのピアデバイス間で直接データ交換を行うためのパスを可能にします。… いくつかの制限が適用される可能性があり、最も重要なのは、2つのデバイスが同じアップストリームのPCI Expressルートコンプレックスを共有する必要があることです。
GPUDirect RDMAは、同じルートコンプレックス内にあるPCIeデバイスであれば、GPUと直接通信できるようにするソリューションです。NVIDIAは主にネットワークカードがPCIeデバイスとなるソリューションとして「宣伝・販売」していますが、高速カメラ用PCIeカードなど、あらゆるPCIeカードが対象となります。これは素晴らしい機能ですが、その仕組みを理解してみましょう。
2 つのピア間で GPUDirect RDMA 通信を設定する場合、PCI Express デバイスの観点からは、すべての物理アドレスは同じです。この物理アドレス空間内には、PCI BAR と呼ばれる線形ウィンドウがあります。各デバイスは最大 6 つの BAR レジスタを持つため、最大 6 つのアクティブな 32 ビット BAR 領域を持つことができます。64 ビット BAR は 2 つの BAR レジスタを消費します。PCI Express デバイスは、システム メモリに対して発行されるのと同じ方法で、ピア デバイスの BAR アドレスに対して読み取りと書き込みを発行します。
従来、BARウィンドウなどのリソースは、CPUのMMUをメモリマップドI/O(MMIO)アドレスとして使用して、ユーザーアドレス空間またはカーネルアドレス空間にマッピングされていました。しかし、現在のオペレーティングシステムには、ドライバ間でMMIO領域を交換するための十分なメカニズムがないため、NVIDIAカーネルドライバは、必要なアドレス変換とマッピングを実行する関数をエクスポートしています。
ここで紛らわしいのは、異種デバイスを接続するPCIe内システムを考えるとき、「DMA」という言葉が「RDMA」よりも適切に思えるかもしれない点です。しかし、それが重要な点なのです。DMAはデータを転送するためのソリューションであり、その上位にあるRDMAは、動詞を用いて転送されるデータに意味を与えるためのプロトコルです。つまり、DMAは下の図のステップ(4)と(5)のみであり、受信側のハードウェアにおけるRDMAプロトコルは(3)のみなのです。
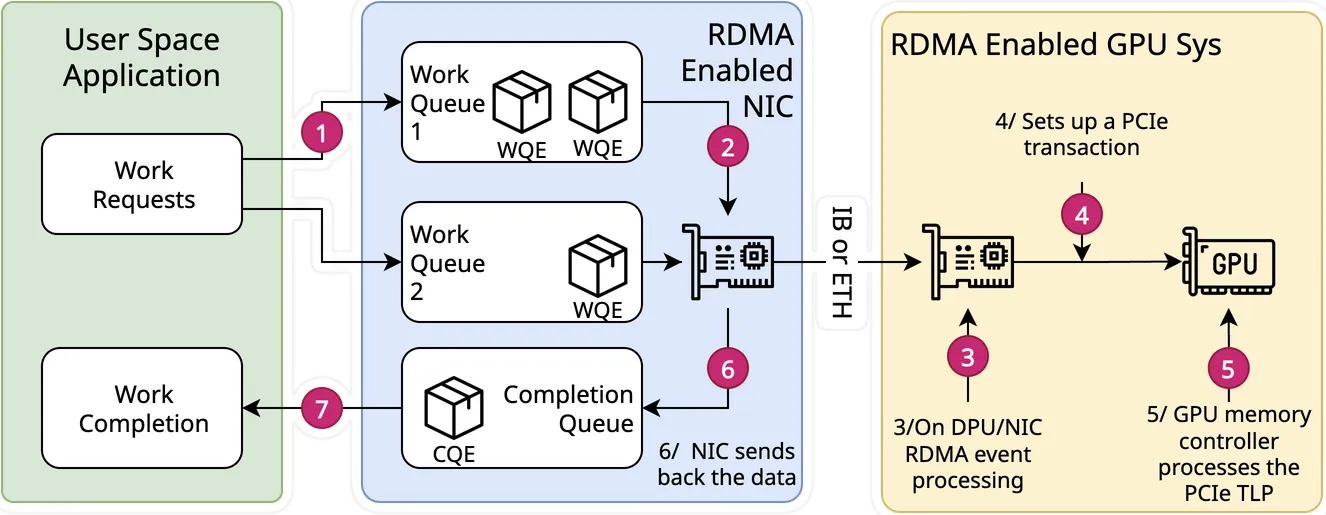
注目すべき点として、Nvidiaはこれが簡単なことではないと明言しており、最高のパフォーマンスを実現するには、実績のあるテスト環境を使用するのがおそらく最善策でしょう。
サードパーティ製デバイスとNVIDIA GPU間でGPUDirect RDMAが動作するための理論上の唯一の要件は、両者が同じルートコンプレックスを共有していることですが、特定の構成では、パフォーマンスが低下したり、まったく動作しなくなったりするバグ(主にチップセット)が存在します。
イーサネット、インフィニバンド、RoCE の用語には依然として明らかな混乱が見られます。RoCE はイーサネットをベースにしているという事実です。

InfiniBand業界団体は、上記の図で示されているように、これを進化形として簡潔に説明しています。ここで、元の「DCB」(別名 データセンターブリッジング)ではなく、「100G + PFC」という名称を意図的に使用しました。私の理解が正しければ、DCBはPFC(別名 優先フロー制御)の上位概念であり、DCB/PFCを機能させるには、スイッチを含むネットワークインフラストラクチャがこれらの技術を実装する必要があるということです。そうでない場合は、イーサネットカテゴリに戻ることになります。
NVLinkについてはどうでしょうか?
見出しへのリンク
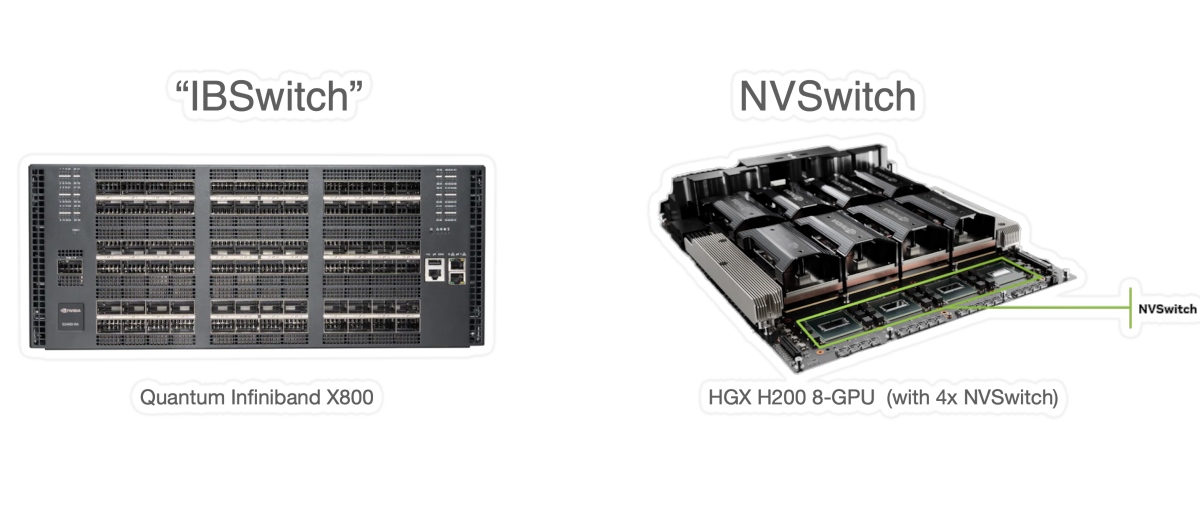
このメモはNVLinkに触れずには完成しないだろう。まず最初に問われるのは、NVLinkとInfiniBandが同一のものなのか、あるいは何らかの関連性があるのかということだ。端的に言えば、両者は競合するものではなく、相互補完的な関係にある。

右側の図を見ると、緑色の矢印はGPU同士を相互接続するために使用されていることがわかります。一方、NIC間の接続にはInfiniBandが使用されています。
注目すべき興味深い点は、NVLink は Nvidia ハードウェア内部にあり、下の図に示すように InfiniBand コネクタとは異なり、外部に露出していないことです。Quantum InfiniBand X800 は、800Gb/s リンクと シリコン フォトニクス を内蔵した強力な製品ですが、量子コンピューティングとは何の関係もありません。
最後に、もう一つ言及しておきたい点があります。NvidiaはNVLink規格をオープンにする方法としてNVlink fusionを導入しました。そのため、明日にはカスタム統合が登場するでしょう。おそらく「スイッチ」として(ケーブルではなく)PCBが必要になるかもしれませんが、Nvidia製ではないSoCが使用されるでしょう。また、AMDがNvidiaの規格に対応してUALinkを導入したことも言及しておく価値があります。
# まとめ
要するに、RDMAはそれほど複雑ではない。
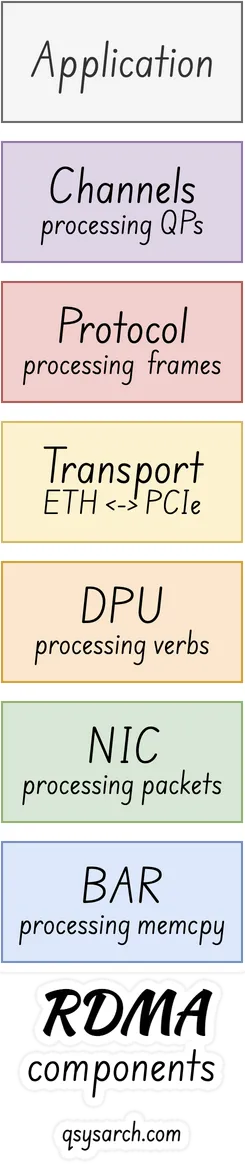
RDMA BAR: PCIe BAR マッピングとして: 物理層では、同じ PCIe ルート コンプレックスを介して GPU に接続され、すべてのデバイスのメモリ BAR をマッピングする PCIe デバイスがあります。
RDMA NIC: ハードウェアネットワークカード (NIC) として: この PCIe カードは通常ネットワークカードですが、必ずしもそうである必要はありません。ただし、RDMA 機能を備えたネットワークカードは、現在市場には 1 つしかないようです。
RMDA DPU: ハードウェア内動詞プロセッサとして: PCIe カードを RDMA 準拠にするには、ハードウェアが RDMA 動詞をハードウェアに直接処理できる必要があり、通常は DPU と呼ばれるプロセッサを使用します。
RDMAトランスポート: ネットワークリンクのトランスポート層として: PCIeデバイスは、ネットワーク側でイーサネット、より優れたイーサネット(RoCev2)、およびInfinibandのトランスポートとして公開されます。
RDMAプロトコル:フレームフォーマットとして:ネットワークリンクを介して通信するために使用されるプロトコルはRDMAとも呼ばれます。フレームフォーマットの詳細は調べていませんが、RFC5040に記載されています。
RDMAチャネル: QPを介して通信する方法: ホスト上でRDMAデバイスと通信するために使用されるSW / ドライバ / SDKもRDMAと呼ばれますが、キューパリとチャネルとして定義されています。
ほら。これでRDMAについて少し理解できたと思う。
# 結論
量子コンピューティングの課題に戻りましょう。そもそもなぜRDMAにこだわる必要があるのでしょうか?それは、NVIDIAが自社のInfiniBandスイッチを「Quantum InfiniBand」と名付けたからです!
しかし、最新のQuantum-X800は驚異的な性能を誇るにもかかわらず、量子コンピューティングとは何の関係もありません。しかし、強化学習チャレンジにおいて、量子制御とGPUを相互接続する上で重要な役割を果たす可能性はあるかもしれません。