一見すると、量子誤り訂正は単純なように思える。物理的な量子ビットを論理量子ビットにまとめ、それらの間の一貫性を維持する方法を適用し、これらの論理量子ビットを使用して量子回路を動作させる、という手順である。
しかし実際には、この最初のステップは決して自明ではありません。論理量子ビットはどのように作成され、維持されるのでしょうか?例えば、量子制御システム(QCS)の観点から(QM OPX1000、ZIのZQCS、Qblox Q1 Clusterなど)、論理量子ビットを「操作」または「オーケストレーション」するには何が必要なのでしょうか?そして、この論理量子ビットが操作可能な状態になったら、1量子ビットゲートと2量子ビットゲートで構成される量子回路を介して量子計算を実行するために、それを使用するには何が必要なのでしょうか?この単純な疑問は、ハードウェア制御システムだけでなく、ソフトウェアスタック、特にコンパイラにも関係しています。物理量子ビット用と論理量子ビット用で、複数のコンパイラが存在するのでしょうか?また、スケーラビリティに関しては、ハイブリッドGPU/QPUとQCSで構成される異種環境で10,000個の物理量子ビットを扱う場合、コンパイラはスケーリングの複雑さに対処するために何が必要なのでしょうか?これらは単純な疑問ですが、その答えは決して容易ではありません。
本稿は、量子制御システムの観点から量子誤り訂正について論じる一連の文書の第一弾です。この最初の短い文書では、物理層において一貫性のある論理量子ビットを「生成」するために必要な基本概念を紹介します。
「論理量子ビット」とは何でしょうか?論理量子ビットの作成は、物理量子ビットをグループ化することから始まります。各量子ビットには特定の役割が割り当てられます。補助量子ビットまたはヘルパー量子ビットとして機能するものもあれば、データ量子ビットまたは主量子ビットとして機能するものもあります。
このグループ分けは、右側の図でよく表されます。この図は、「距離3に基づく表面コード17」を示しています(画像提供:Irréversible Inc)。
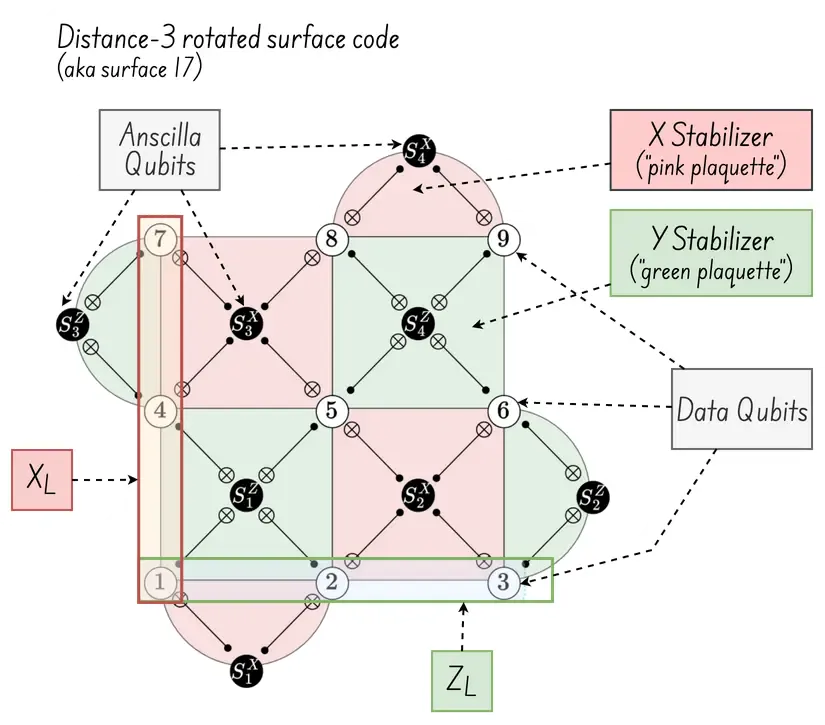
表面コードに適用できる基本的な構造は以下のとおりです。
データと補助量子ビット間の相互作用は、それぞれの「プラケット」に固有のものである。
プラケット(緑とピンクの面)は、中央の補助量子ビットとその隣接するデータ量子ビット間のエラーチェックの類型的な関係を定義します。
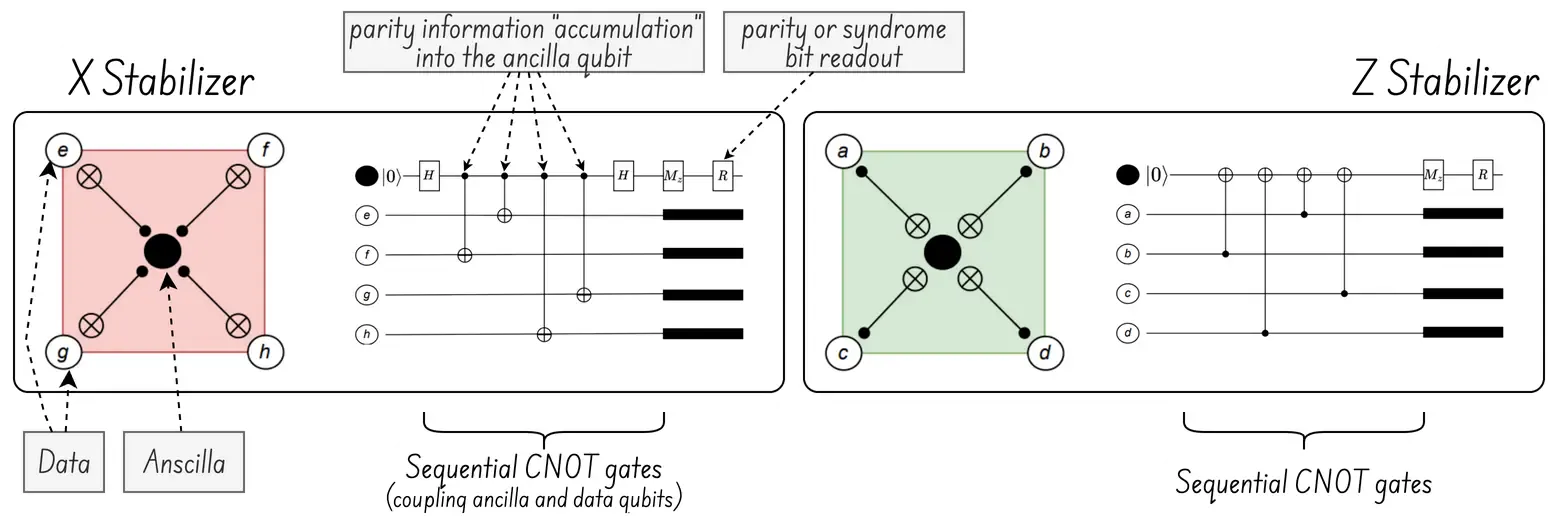
スタビライザー: 各補助量子ビットは、1 つのパウリ演算子、つまりスタビライザーを測定するために使用されます。表面コードには 2 つのスタビライザーがあります。Z タイプはビット反転 (X) エラーを検出し、X タイプは位相反転 (Z) エラーを検出します。
スタビライザー測定は、単一のスタビライザーの測定であり、補助量子ビットを隣接するデータ量子ビットに順次結合し、その後補助量子ビットを測定することによって実現されます。
ちょっとしたクイズ:キュービットの犯人は誰でしょう?
見出しへのリンク
この文脈で、以下の図(出典:Alice & BobよりLaurent Prost)を検討してください。Z 1 Z 2と Z 2 Z 3 は、それぞれ Qubit 1 と Qubit 2 の間、および Qubit 2 と Qubit 3 の間の共同パリティチェック(安定化)測定を表します。これまでの 2 次元プラケットとは異なり、この図では各物理量子ビットが他の 1 つの量子ビットのみにリンクされていると想定しており、1 次元の繰り返しコードを示しています。
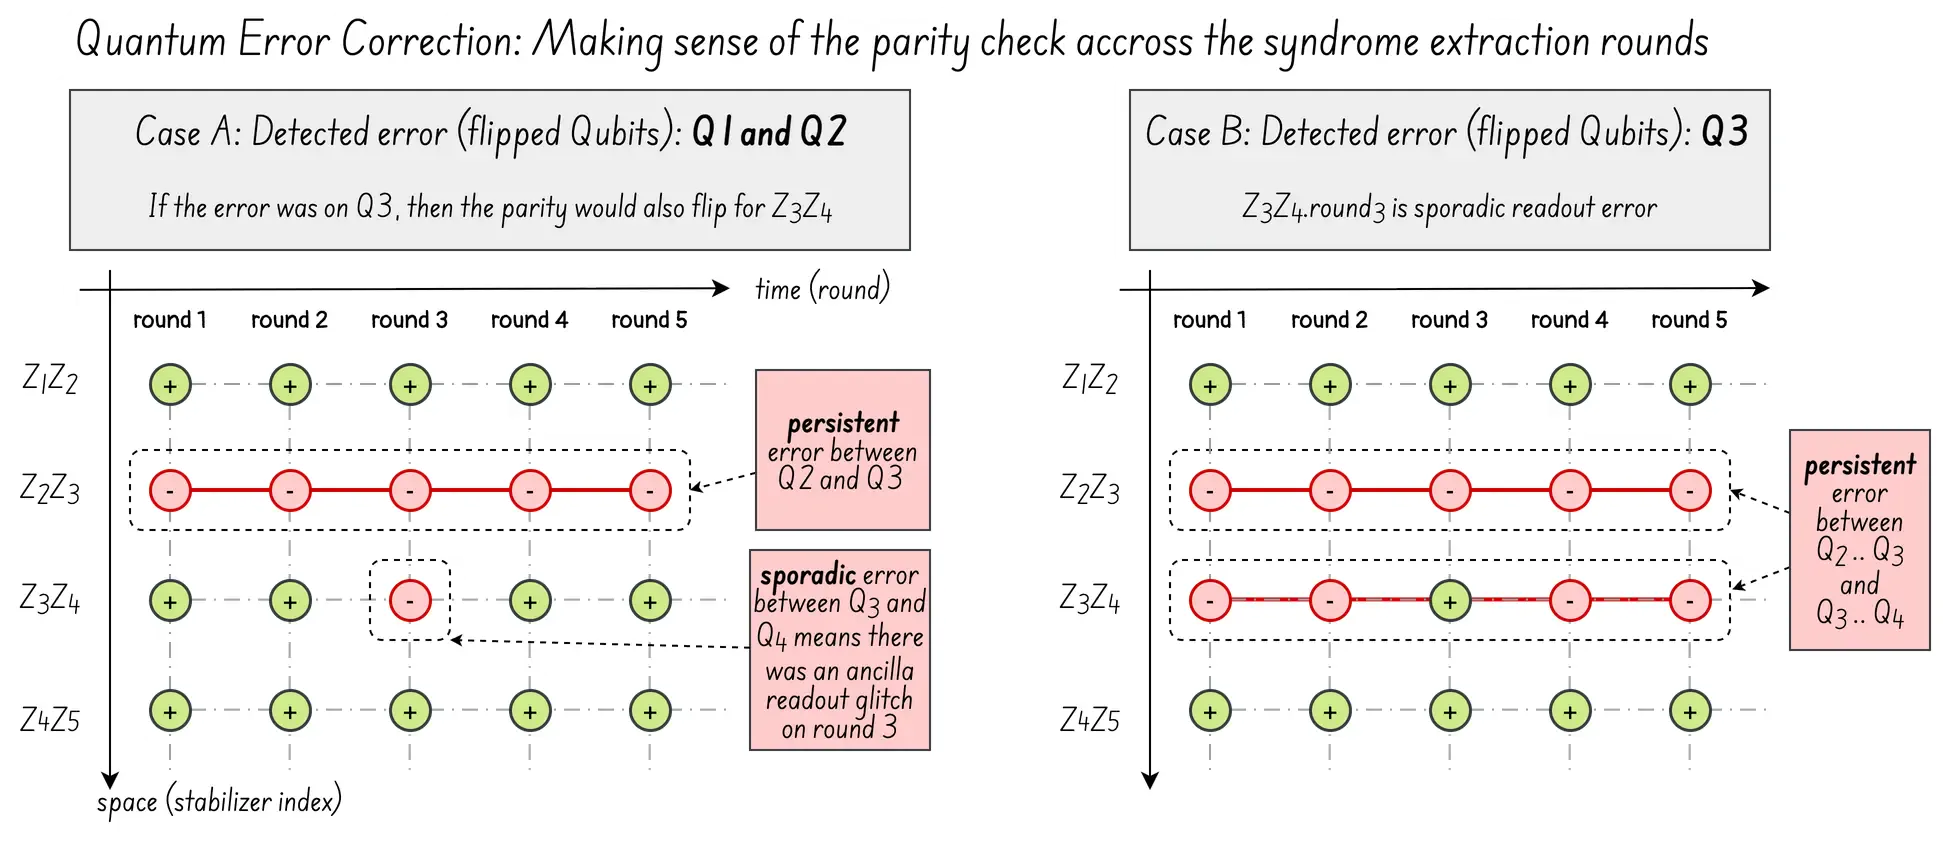
左側の図(ケース A)では、エラーがデータ キュービット 3 にあるように見えますが、実際にはデータ キュービット 1 と 2 の両方でエラーが発生しています。赤い水平線は、エラーが Z 2 Z 3でのみ発生していることを示しています。エラーがキュービット 3 にあった場合、Z 3 Z 4も反転します。したがって、Z 1 Z 2は ビザンチン エラーを表しており、Q1 と Q2 の両方が反転しています。右側の図(ケース B)は、エラーがキュービット 3 にあった場合の予想される結果を示しています。
この第2部は少し難解ですが、論理グループ内での物理量子ビットのオーケストレーションに関する後続のメモを理解する上で重要です。できるだけ分かりやすく説明するよう努め、量子エネルギー制御(QEC)の同僚たちがより詳しく説明できるような、難解な数学的な詳細には触れないようにしました。
Q1 + Q2ビザンチンエラーは、実際には「退化エラー」と呼ばれる一般的な課題です。具体的には、物理的に異なる 2 つ以上のエラーがまったく同じシンドロームビットを生成する状況を指し、その場合、エラーを区別することが不可能になります。
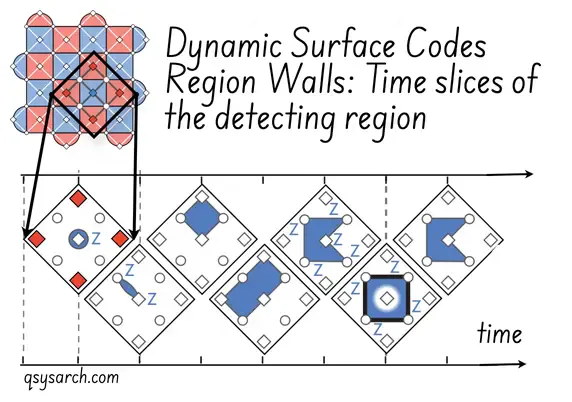 しかし、これは QEC では問題になりません。安定化器はエラーを直接検出するために使用されません。代わりに、安定化器はエラー症候群が反応する物理的な量子ビット境界 (別名 ドメイン壁) を特定するために使用されます。次に、冗長性を高めて境界を重ね合わせることで、個々のエラーを特定できます (または、右の図に示すように、GoogleAI の time-dynamic 表面符号を使用することもできます)。
量子システムにおけるこの冗長性の設計は根本的に複雑であり、高度な数学的知識を必要とします。その概念を理解するためには、基本に立ち返る必要があります。パリティチェックは実際にはどのように機能しているのでしょうか?
パリティチェックは実際にはどのように機能するのですか?
見出しへのリンク
パリティチェックがどのように機能するのか、最初は分かりにくいかもしれません。パリティの判定には、データ量子ビットの状態に依存する期待されるシンドロームビットの知識が必要だからです。しかし、データ量子ビットの状態を事前に知ってしまうと、量子計算の目的が損なわれてしまいます。言い換えれば、次のようになります。
「量子状態が分からなければ、それが変化したかどうかをどうやって判断できるのでしょうか?」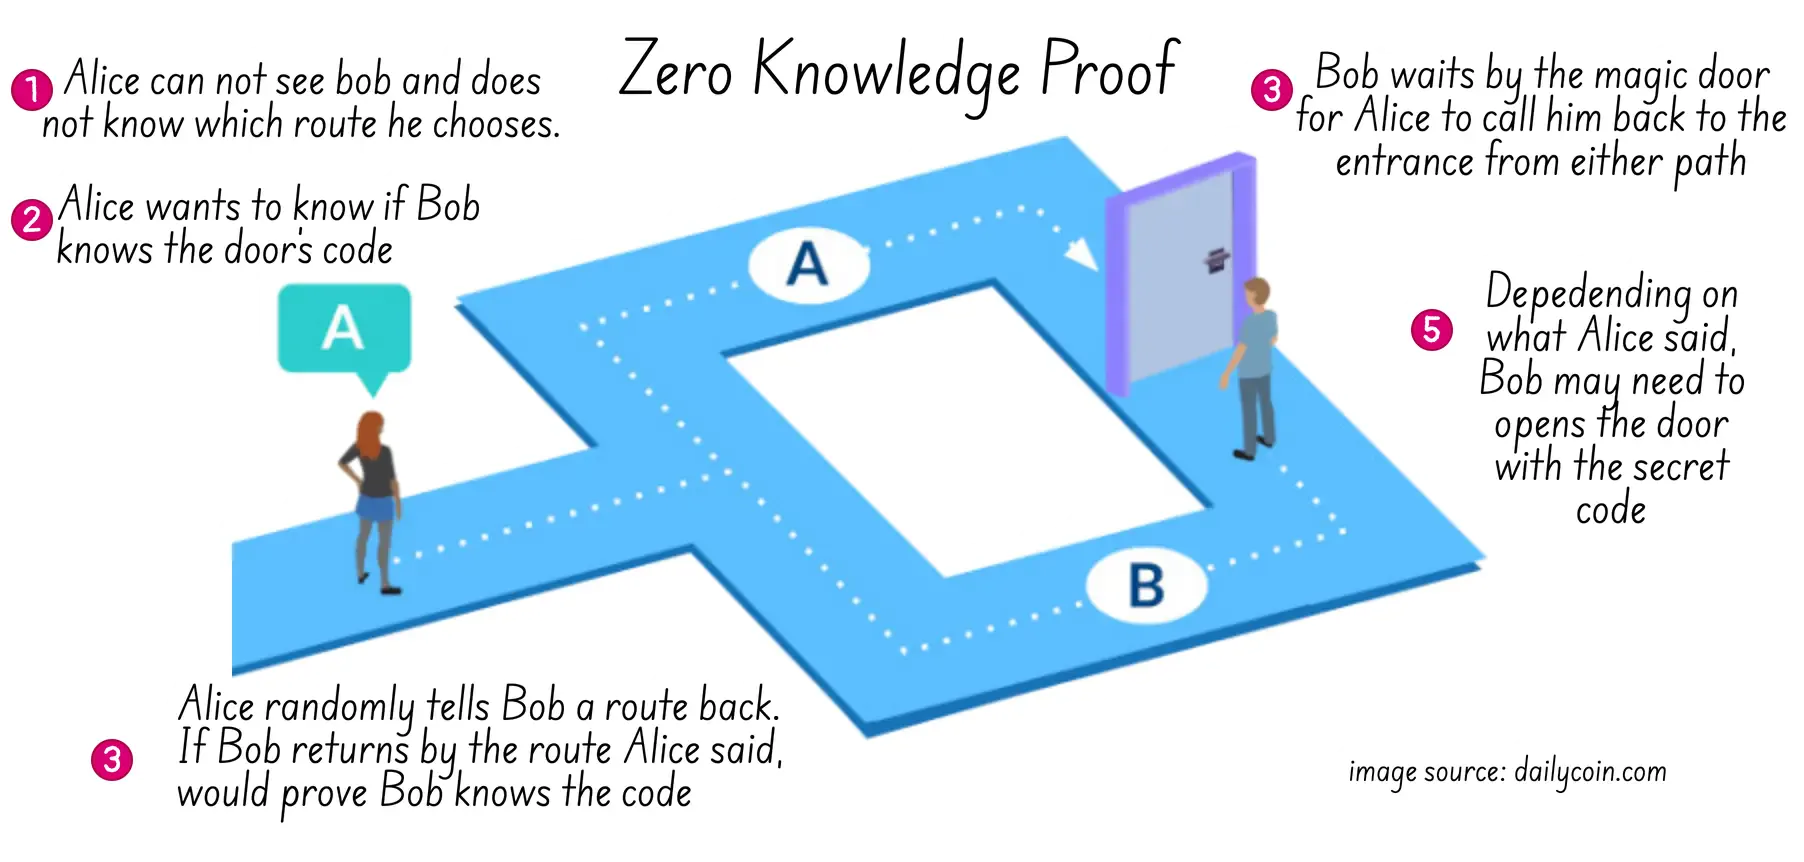 この課題を解決する鍵は、アリババの洞窟実験で使用された「ゼロ知識証明」で使用されたのと同じトリックを参照することです。エンコードされた量子情報が何であるかに関係なく、答えがわかっている特定の質問をするだけでよいのです (画像クレジット: dailycoin)
これらの具体的な質問は、パウリ安定化演算子に対応します。シンドロームビット、つまり測定結果は、パスAまたはパスBと見なすことができます。QECでは、パスAは有効な状態を表し、パスBはエラーを示します。QEC「エンジン」に必要なのは、この制約(「保護状態」とも呼ばれる)を維持する方法で、論理量子ビットに作用する量子回路を構築することです。
ここでエンジニアリングが重要になります。シンドローム測定がエラーがない場合は必ずパスAを返し、エラーがある場合はパスBを返すようにするには、マルチキュービットパリティ情報を、有効なエンコード状態ごとにキュービット間の関係が固定されるようにエンコードする必要があります。
これは符号化回路の機能です。その目的は、単純な、破損していない入力状態(例えば、単一の物理量子ビット\(|ψ> = α|0> + β|1>\)とブランク補助量子ビット\(|00...0>\))を、量子誤り訂正によって保護された高度にエンタングルした論理量子ビット状態\(|ψ_L>\)にマッピングすることです。
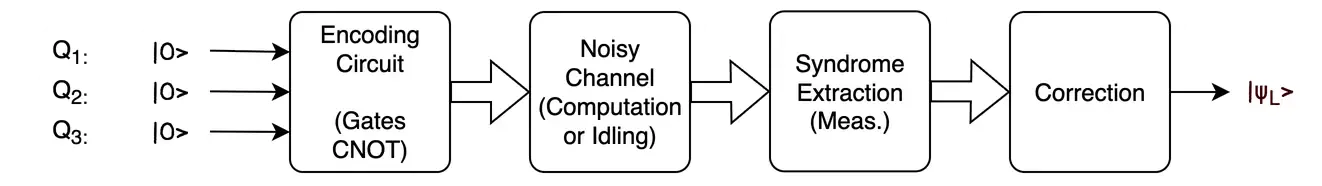
符号化回路については、後日別のメモでより詳しく説明します。ここでは、符号化回路は、保護状態にある論理量子ビットを初期化(ブートストラップ)するために使用される、設計された特殊な量子回路であると考えてください。
退化エラー(つまり「ビザンチン」Q 1 + Q 2症候群)を修正するには、コード距離 \( d \) と呼ばれるものを大きくすることで冗長性を高めることができます。一見すると、コード距離 \( d \) はエラー保護の堅牢性を定義するものと言えるでしょう。
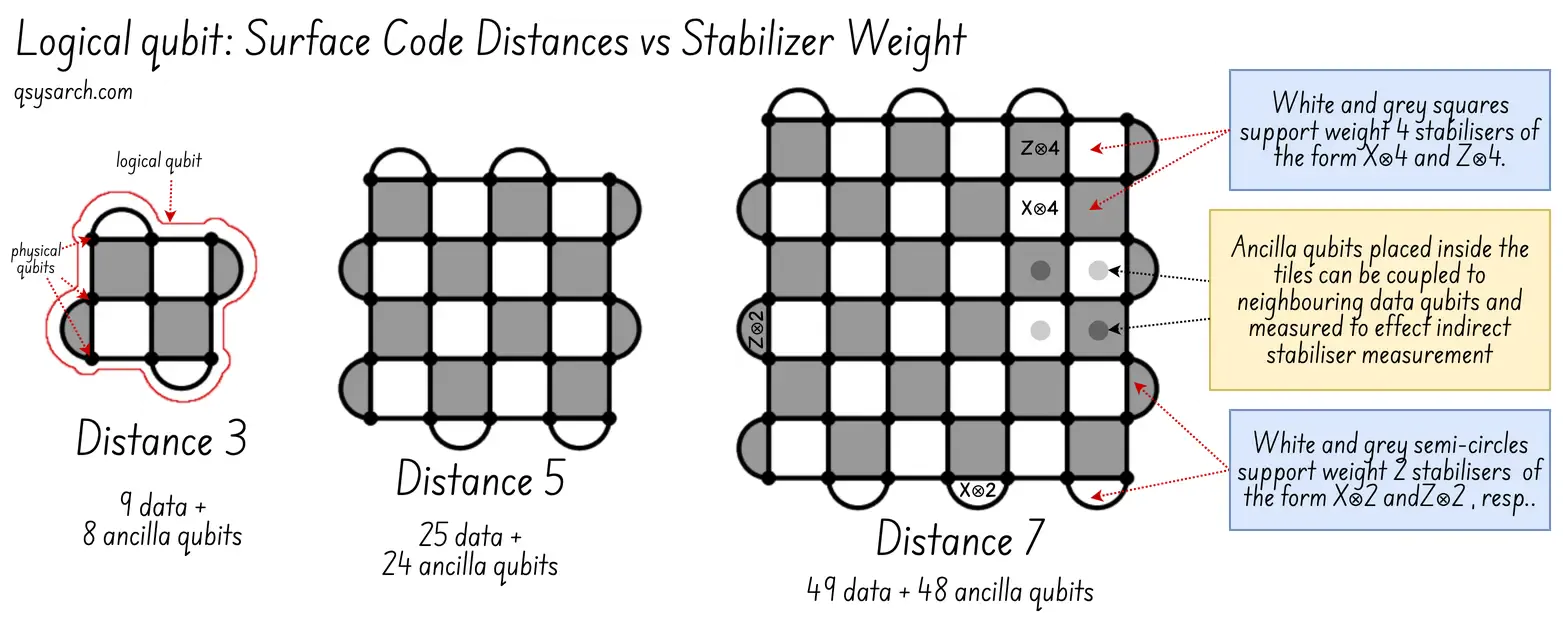
コード距離が \( d=3 \) の場合、隣接する 2 つの量子ビットを反転させると情報が破壊され、QEC は論理量子ビットを訂正できず、つまり論理量子ビットを保護状態に維持できません。コード距離が大きくなると、例えば \( d=5 \) の場合、QEC デコーダは、Q 1と Q 2 が反転して Z 1 Z 2チェックから互いをマスクした場合でも、増加スタビライザー測定によってデコーダが Q 1と Q 2を二重障害として識別するのに十分なコンテキストが得られることを保証できます。数学的な観点からは、これは次のように記述できます。
距離 \( d \) のコードは、最大 \( (d-1) \) 個のエラーを検出でき、最大 \( \lfloor (d - 1)/2 \rfloor \) 個のエラーを訂正できます。
冗長性によって問題が解決するなら、より大きな次元の表面コードを使えばいいのではないか?問題は、冗長性を高めるために物理的な量子ビットを1つ増やすごとに、より多くの安定化器を測定する必要があることだ。そして、測定回数が増えるということは、物理的なエラーが発生する危険性も増えるということだ。
これは、いわゆる**閾値定理**につながります。
サイズ \(N\) の量子回路は、ノイズのある量子回路でも高精度で実装できます。ただし、ノイズのある回路の各位置におけるエラー確率が、固定の閾値 \(p_{th}>0\) を下回る場合に限ります。ノイズのある回路のサイズは、正の定数 \(c\) に対して \( O(N.log^c(N)) \) のように変化します。
簡単に言うと、閾値定理は、物理量子ビットのエラー率 \(p\) が閾値 \(p_{th}\) を下回っている限り、エラー訂正を改善するために物理量子ビットを追加することが可能であり、追加された量子ビットの数は \(N.log(N)\) の複雑さであることを意味します。
なぜこれが重要なのでしょうか?それは、たとえ量子ビットが常に「正しく動作しない」場合でも、それが頻繁に起こらなければ、個々の量子ビットの合計よりも優れた動作をする量子ビットのセットを得ることが可能であり、それによってポストNISQ、すなわちFTQC(フォールトトレラント量子コンピューティング)時代への道が開かれるからです。
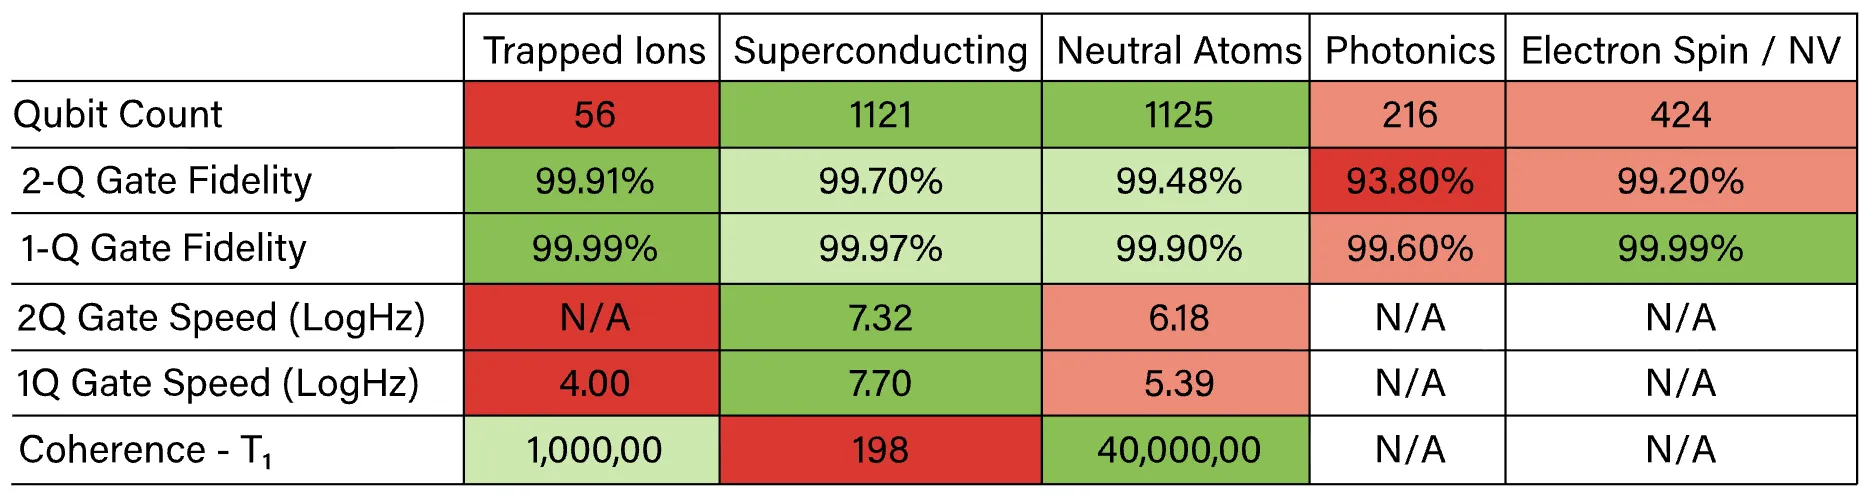
もちろん、ここで重要なのは、この閾値 \ (p _ {th} ) が何であるかということです。これは 0.1% から 1% のオーダーであり、低いように見えるかもしれませんが、現代の量子ビットはすでに 99.9% の忠実度を達成できるため (1 量子ビットゲートの場合)、問題にはなりません。
# 結論
さあ、この短いメモは、量子誤り訂正で使用される概念の基礎を築くものです。
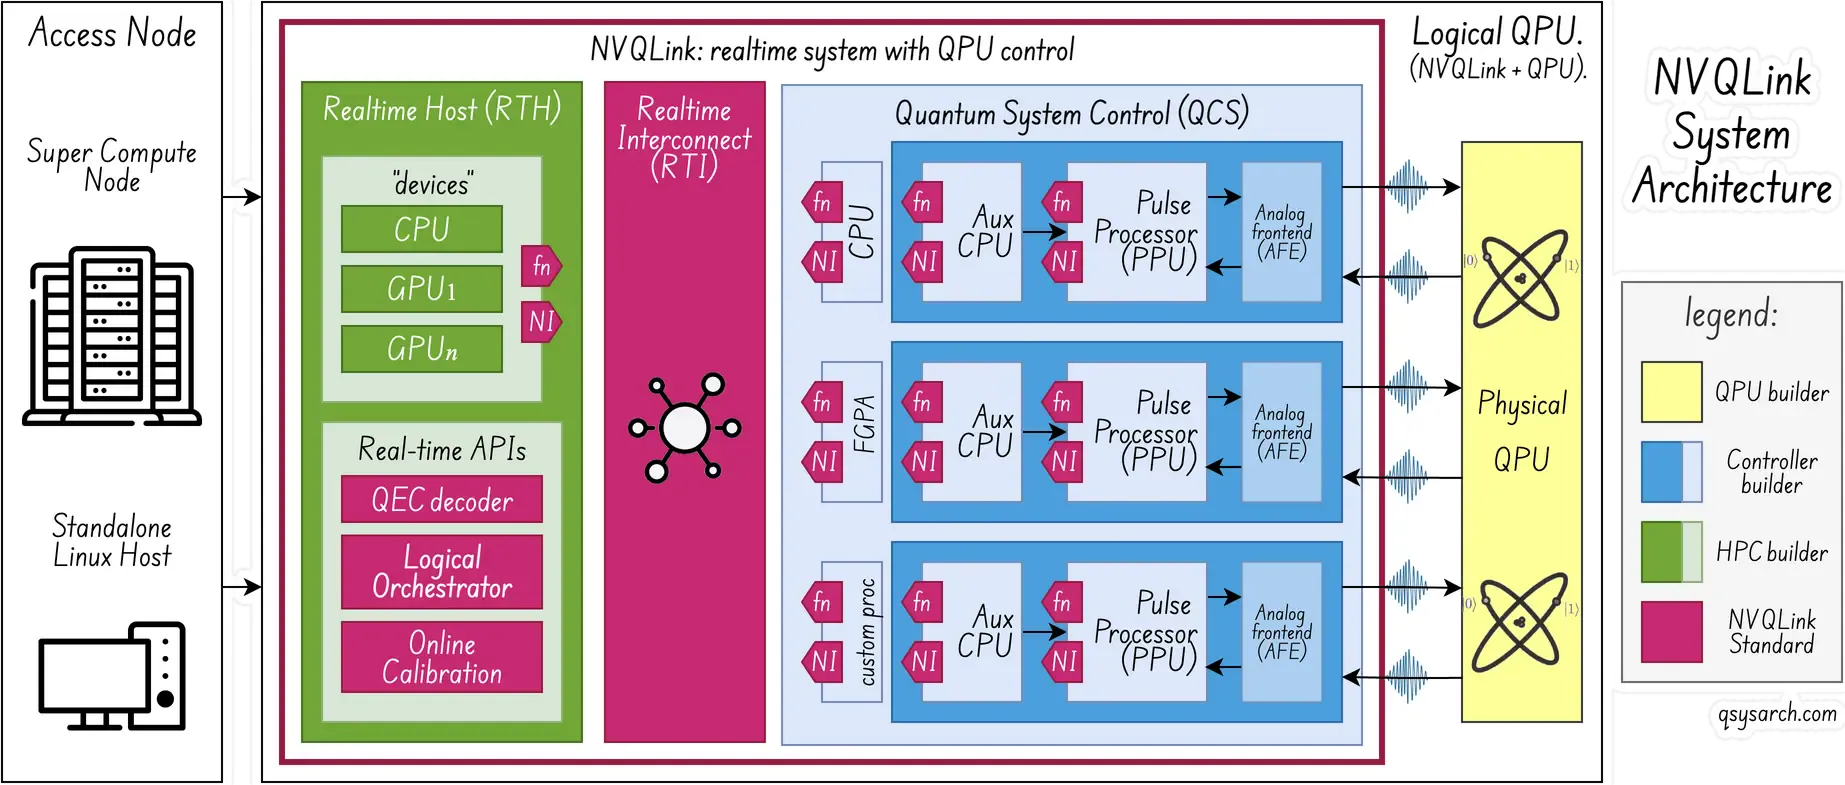
次の 2 つのメモは、より実践的な内容になります。2 番目のメモでは、量子制御システム (およびエラーデコーダ) が物理量子ビットを論理量子ビットに変換することが、制御、読み出し、シーケンスの観点から具体的に何を意味するのかを分析します。3 番目のメモでは、デコーダシステム、およびデコーダと制御システム間の低遅延とリアルタイム “link” に焦点を当てます。
このメモは実は一連のメモの第一弾です。今後のQECメモでは、以下のトピックに焦点を当てていきます。
量子制御システムの観点から症候群抽出をオーケストレーションする
リアルタイムエラーデコード:超低遅延のASIC、GPU、およびニューラルネットワーク。
共同設計型スマート量子ビット:アリスとボブのエラー保護量子ビットの事例
大規模なコードコンパイラの表面化:数十億の物理操作に対する耐障害性を最大化する
階層型デコードアーキテクチャ:局所性の原理と多層処理
論理キュービットオーケストレーション:格子手術と編み込み
表面符号を超えて:qLDPC符号への移行
マジックステート蒸留とアナログ回転
これから6ヶ月間は忙しくなりそうだ!
References:
DrawIO diagrams used in this memo: