私は、Qblox のチームの一員になれたことを大変嬉しく思っています。このチームは、Nvidia と積極的に協力し、NVQLink 標準を推進しています。これは、GPU、CPU、および QPU (量子プロセッサ、Qblox が開発している最前線の量子コントローラを含む) 上で計算される異種システムを相互接続する方法です。
NVQLinkは、GPUと量子プロセッサを接続するための単なる「ケーブル」ではなく、ネットワークからソフトウェアスタックまで、異種デバイスを相互接続できる包括的なフレームワークです。
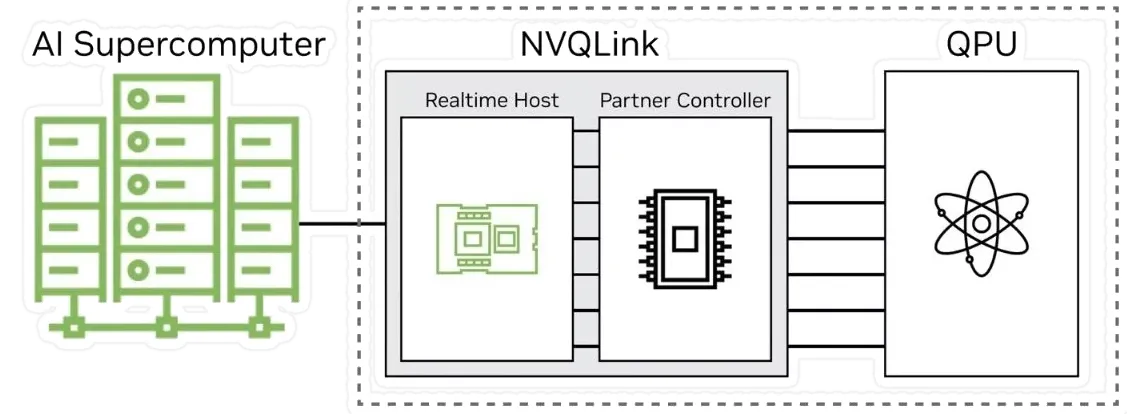 画像提供: Nannod
主要な「ハードウェア」仕様では、ネットワークおよびコンピューティングリソースの性能が重視されます。
ネットワークスループット:GPUからQPUまで最大400Gb/s。
ネットワーク遅延:往復遅延(FPGA → GPU → FPGA)が4.0マイクロ秒未満。
GPUハードウェア:NVIDIA GB200 Grace Blackwellスーパーチップをベースに構築されたリアルタイムホストで、非常に高いTFLOPS性能を備えています。
あなたは「なぜこれが重要なのか?」と疑問に思うかもしれません。
量子ハードウェアと高速化されたGPUコンピューティングを緊密に統合するためのオープンスタンダードを作成します。
ハイブリッドワークフローを可能にします:ニューラルネットワークのキャリブレーション、量子誤り訂正(QEC)など。
これは、ソフトウェアとハードウェアを1つに統合したオープンなプラットフォームを提供し、CUDA-Qのおかげで、誰もが知識の海に溺れることなく量子コンピュータとやり取りできるようにします。
NVQLink仕様:アーキテクチャ設計
見出しへのリンク
NVQLinkのホワイトペーパーがhttps://arxiv.org/abs/2510.25213から入手可能になったので、提案されているアーキテクチャの詳細を詳しく見ていきましょう。
システムアーキテクチャ
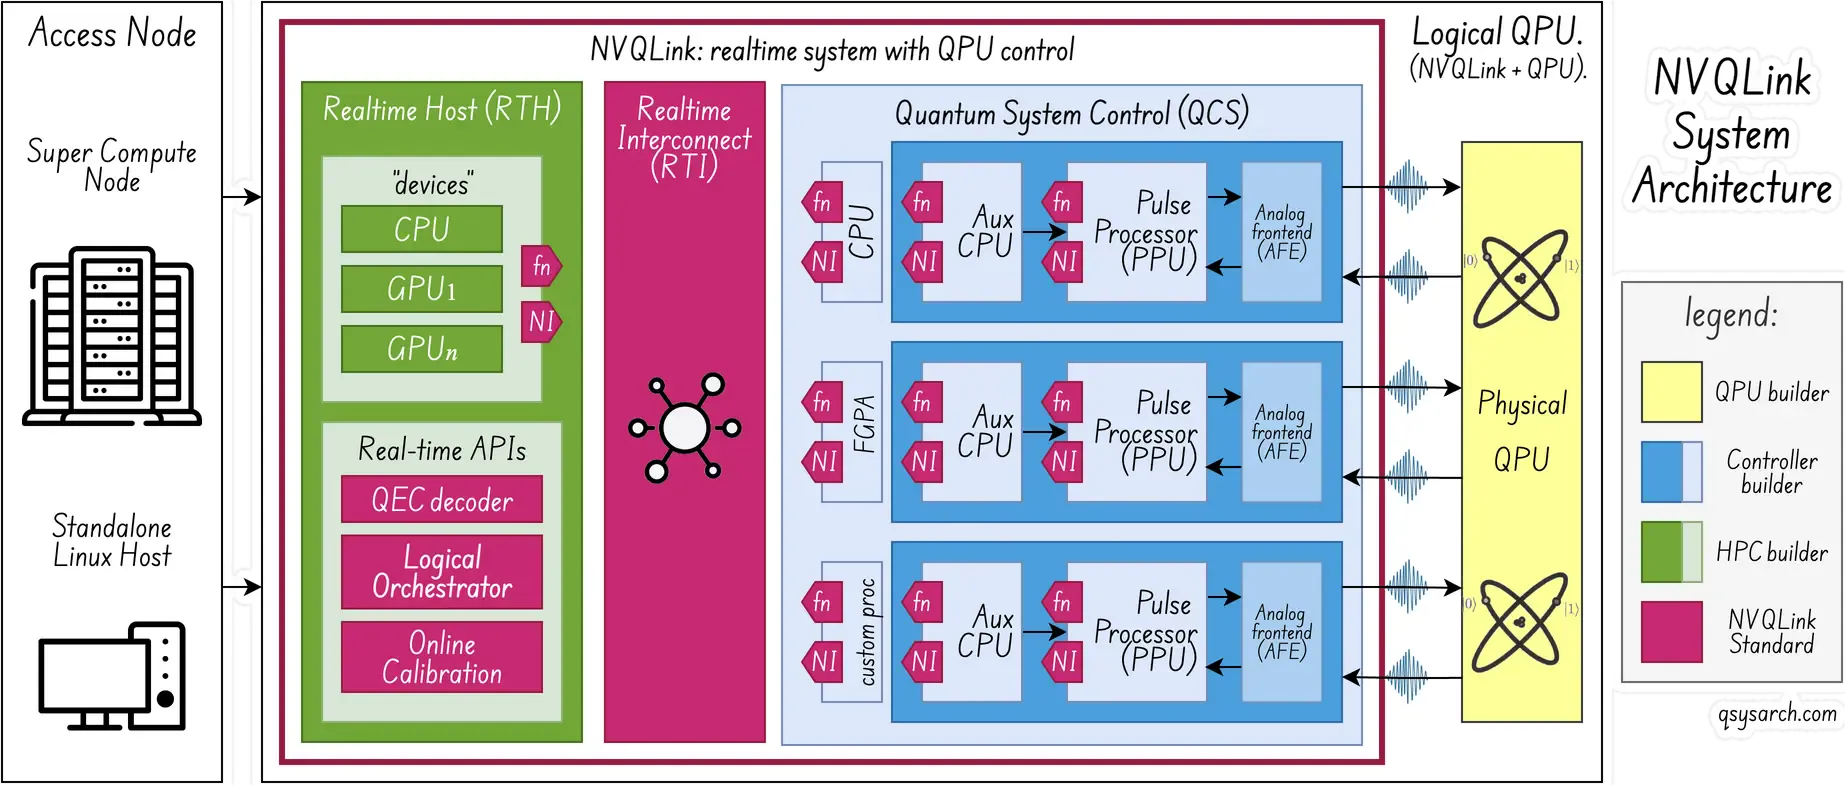 (ホワイトペーパーに掲載されている元の画像を基に作成したシステム図)
予想通り、詳細はNannodによる概要と一致しています。コンポーネントの観点から見ると、NVQLinkアーキテクチャはリアルタイムホスト(RTH)とQPU制御システム(QSC)で構成されています。これら2つのコンポーネントは、低遅延でスケーラブルなリアルタイムインターコネクト(RTI)で接続されています。RTHには、CPUやGPUといった従来のHPCコンピューティングリソースが搭載されています。QSCには、通常、QPUを制御するパルス処理ユニット(PPU)が含まれています。
この図では、重要なキーワードである「fn」と「NI」を紹介します。NVQLinkのメンタルモデル(「プログラミングモデル」)では、CPU、GPU、PPU(またはその他の専用IC/FPGA)はそれぞれ「デバイス」と呼ばれ、NVQLinkはこれらのデバイスのいずれに対してもリモートプロシージャコール(「コールバック」または「fn」)を実行できるようにします。これは非常に強力なソリューションであり、NVQLinkは異種システムを繋ぐ接着剤として機能します。「fn」ランタイムの実際の実装は高度に最適化されており、マーシャリングも自動的に処理されます。これにより、数マイクロ秒のレイテンシを実現できます。「NI」はネットワークインターフェースの略で、すべての関係者が統一された相互接続システムを構築するために使用できる、小型でオプションのネットワークカード/インターフェース/ケーブルとして概念化されています。
NVQLinkでは、時間領域という非常に重要な概念も導入されています。これは、システムに関わるすべての「処理ユニット」が「同じクロック」に従うとは限らないため必要となります。
クロック、つまり時間ドメインには、速いものから遅いものまで4つのカテゴリがあります。

物理時間領域 (PTD): 通常は QPU クロック。
決定論的時間領域 (DTD): 通常は QSC/FPGA のクロックであり、量子コヒーレントな時間スケールで動作できる。
リアルタイム領域 (RTD): 通常は従来の CPU または GPU 内。量子コヒーレント時間内、または 2 つの量子コヒーレント実験間の時間である。
アプリケーション時間領域 (ATD): 通常は、Jupyter Notebook が実行されているラップトップです。
当然のことながら、NVQLinkはRDMAとGPUDirectを利用して、不要なCPU処理を回避し、最適なレイテンシを実現しています。仕様書にも記載されているように、「これら2つの技術を活用することで、ホストの関与なしに、QSCとの間で送受信されるパケットの処理にはNICとGPUのみが関与します」。
また、仕様書では「信頼性の低い接続」RDMAモードの使用を推奨しています。これは、RC(信頼性の高い接続)を使用する際に発生する遅延は、適切に設計されたネットワークと比較すると過剰になる可能性があるためです。
この仕様書は、ネットワークアーキテクチャの「概念実証」を提供し、実現可能なレイテンシを検証する手段としています。Holoscan Sensor Bridgeモジュールが使用され、FPGAとNIC間でRDMA over Converged Ethernet(RoCE)プロトコルを使用してデータを送信する手段を提供するとともに、列挙ステップと制御信号を処理します。このアーキテクチャを使用することで、仕様書では、92バイトのイーサネットフレームに相当する32バイトのRDMAペイロードに対して、4マイクロ秒未満の往復レイテンシを実現できることを示しています。
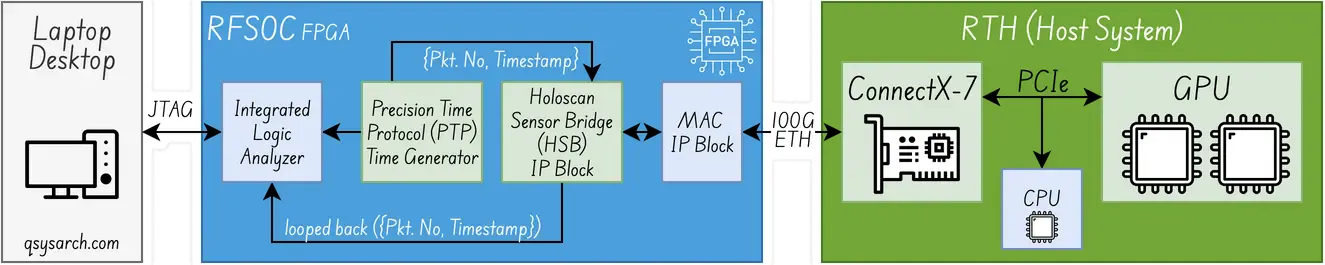 (ホワイトペーパーに掲載されている元の画像を基に作成した図)
コンパイルアーキテクチャ(別名:CUDAQ+NVQLinkプログラミングモデル)
見出しへのリンク
NVQLinkは低速モードと高速モードを区別しており、本節では高速モードアーキテクチャの影響(いわゆる「高レイテンシ感度」)について具体的に検証します。低速モードとの主な違いは、高速モードのアーキテクチャでは、実行中にジャストインタイムコンパイル(JIT)とRTH仲介が可能な点です。
CudaQ + NVQLink を高速モードで使用するには、仕様では、_完全な ISA プログラムを事前に FPGA にアップロードし、実行中にリアルタイム ホストとの対話的な通信を最小限に抑えながらアトミックにトリガーする必要がある_と規定されています。JIT は本当に優れた技術なので、高速モードに使用できないのは残念です。ただし、仕様では、プログラムが終了するまで命令キューが空にならない限り、FPGA は RTH から動的な更新を「受信」できることが明確にされています (「_命令キュー_を介して」)。これは「ジャストインタイム」スケジューリングのようです。
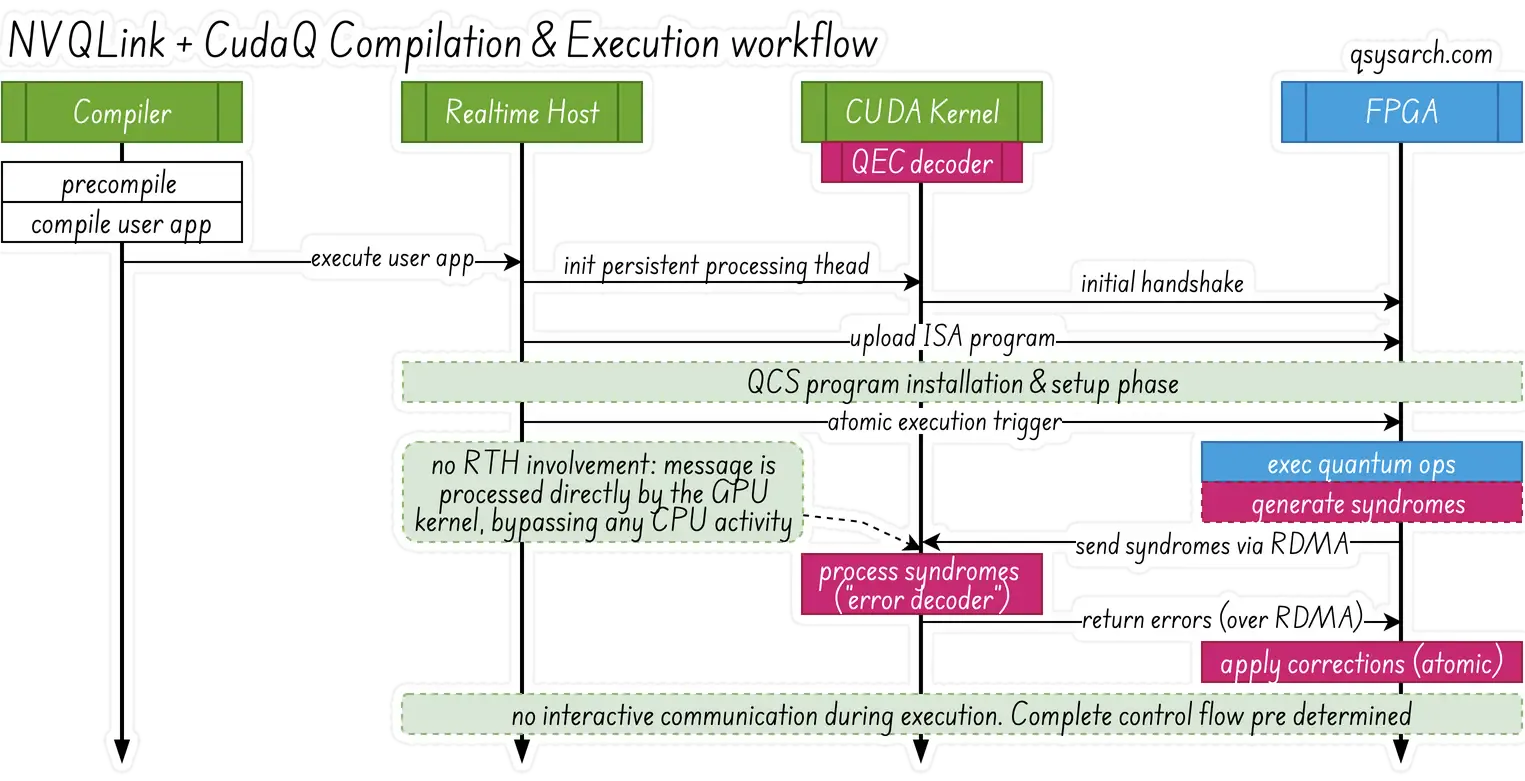
当然のことながら、仕様ではコンパイル時に積極的な事前最適化を実行する必要があることが明記されています。これは、量子制御スタックベンダーが常に重視している点です。また、GPU でコールバックを実行する必要がある場合は、GPU 内の CUDA カーネルを事前に初期化し、イベントをアクティブに待機する必要があることも記載されています。これは特に特別なことではなく、標準的な DOCA GPUNetIO ワークフロー です。
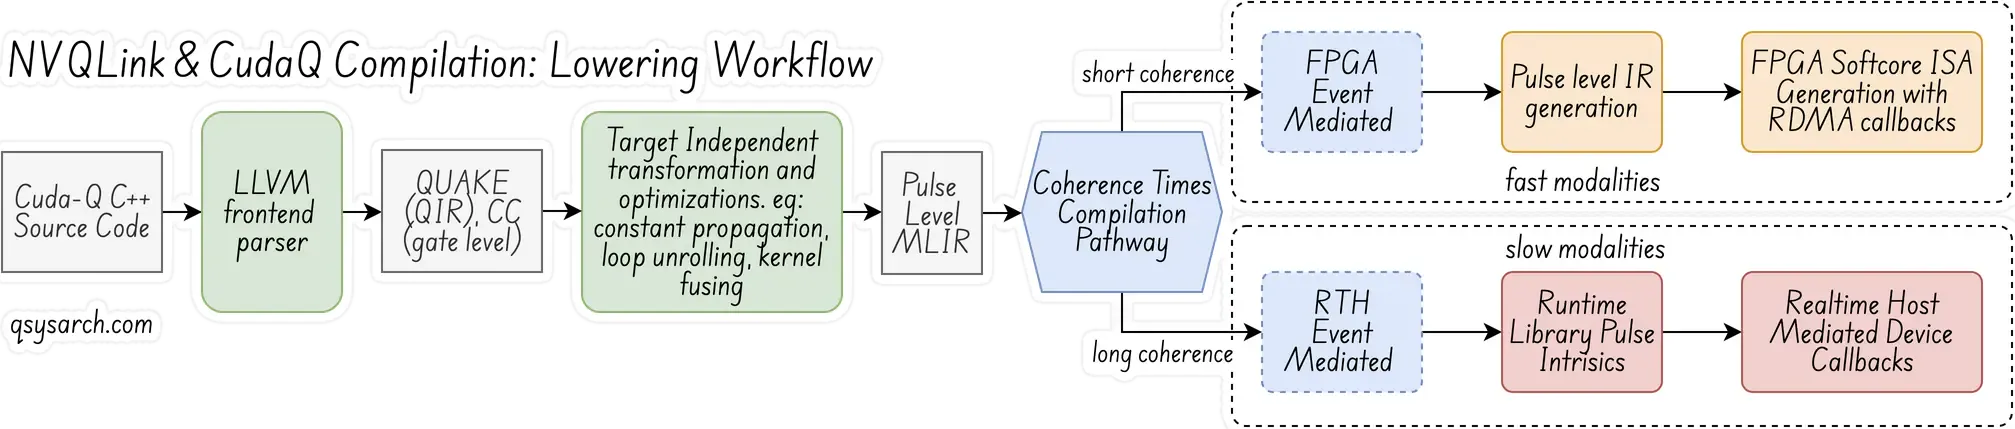
CUDA=Q のコンパイルと NVQLink アーキテクチャへのダウンローディング ワークフローは、標準の LLVM MLIR アーキテクチャに基づいています (上の図を参照)。最初のステップは、CUDA カーネルを解析し、ゲート レベルで抽象化された Quantum IR (QIR または QUAKE と CC (クラシック コンピュート) 中間 IR を生成することです。後のフェーズでは、必要な最適化とカーネル融合が導入され、パルス レベルのダイアレクトが生成されます。次に、モダリティ タイプに応じて、次のダウンローディング フェーズでは RTH または FPGA による仲介が使用されます。
「量子カーネル」は、__qpu__という接頭辞で識別されます。
int gpu_adder(int, int);  // This function is executed on GPU
__qpu__ int simple_quantum_kernel(int i) { // This function (kernel) is executed on the QCU
cudaq::qubit q;
h(q); // Operate an H gate on qubit q
auto readout = mz(q); // Read the Z axis of qubit q
return cudaq::device_call(2, gpu_adder, i, readout); // This is tail function call
}
コンパイル段階では、まずQUAKE(量子方言)とCC(古典計算方言)の中間表現(IR)、つまり方言の混合形式に変換(「ダウングレード」)されます。
func.func @simple_quantum_kernel(%arg0: i32) -> i32 {
%0 = quake.null_wire
%1 = quake.h %0 : (!quake.wire) -> !quake.wire
%measOut, %wires = quake.mz %1 : (!quake.wire) -> (!quake.measure, !quake.wire)
%2 = quake.discriminate %measOut : (!quake.measure) -> i1
%3 = cc.cast unsigned %2 : (i1) -> i32
%4 = cc.device_call @gpu_adder on 2 (%arg0, %3) : (i32, i32) -> i32
return %4 : i32
}
ランタイムアーキテクチャ:特性を用いたメタプログラミング
見出しへのリンク
RDMAに深く根ざしたゼロコピーの概念に沿って、NVQLINKランタイムは、2つの重要な概念によって実現される高性能かつオーバーヘッドゼロの抽象化も促進します。
重要な特性は4つあります。
explicit_data_marshalling_trait: システム間でデータを割り当て、転送することを意味します。
device_callback_trait: デバイス関数(「RPC」)を呼び出すことを意味します
quantum_control_trait: QCSにプログラムをアップロードして起動することを意味します
rdma_trait: 生のメモリバッファから構造体を効率的に初期化することを意味します。
実際には、これらの特性はC++言語を非常に高度なレベルで活用しています。例えば、データマーシャリング特性がこれに該当します。
template <typename Derived> class explicit_data_marshaling_trait {
public:
void *resolve_pointer(device_ptr &devPtr);
device_ptr malloc(size_t size) const;

template <typename... Sizes, enable_if_t<(conjunction_v<is_integral<Sizes>...>),int> = 0>
auto malloc(Sizes... szs) { return make_tuple(static_cast<Derived *>(this)->malloc(szs)...); }

void free(device_ptr &d);

template <typename... Ptrs, typename = enable_if_t<(conjunction_v<is_same< remove_cv_t<remove_reference_t<Ptrs>>, device_ptr>...>)>>
void free(Ptrs &&...d) { (free(d), ...);
}
void send(device_ptr &dest, const void *src);
void recv(void *dest, const device_ptr &src);
};
この構文には多くの要素が含まれており、私の意見ではRustの構文(例:cow)よりも強力です。この構文は_メタプログラミング_とも呼ばれ、NVQLINQの文脈ではコンパイル時、つまり静的なポリモーフィズムを指します。templateという行を見てみましょう。 <typename… Sizes, enable_if_t<(conjunction_v<is_integral …>),int> = 0> より詳細に:
is_integral<Sizes> as α: Sizes が 整数型 、つまり int、float、bool などである場合、true とします。
conjunction_v<α...> を β として指定: α... のすべての値が真の場合、true とします。
enable_if_t<(β),int> を δ として定義: β が false の場合に失敗する グループ 2 条件式。
テンプレート<typename... Sizes, δ = 0>: δ が失敗しないようにする SFINAE 構造。
この構文を用いることで、複数のブロックを一度に確保する特殊なmalloc操作が可能になります。
class gemm_device : public explicit_data_marshalling_trait {  ... }
gemm_device gpu_gemm; // "gemm" stands for general matrix multiply
auto [column, row, matrix] = device.malloc(1024, 1024, 1024*1024);
なぜこれが重要なのか疑問に思うかもしれません。それは、コンパイル時に最適な特殊化を実現できる可能性を与えるという単純な理由からです。この場合、mallocの実装はメモリバッファを連続的にバンドルできるため、RDMA交換や複数のデータのアトミックなマーシャリングに適しています。素晴らしいと思いませんか?
ランタイムアーキテクチャ:カーネル
見出しへのリンク
NVQLinkは、量子カーネルのコンパイル、アップロード、実行(トリガー)のための標準インターフェースを提供します。百聞は一見にしかずということで、このセクションの要点を以下の図でまとめます。
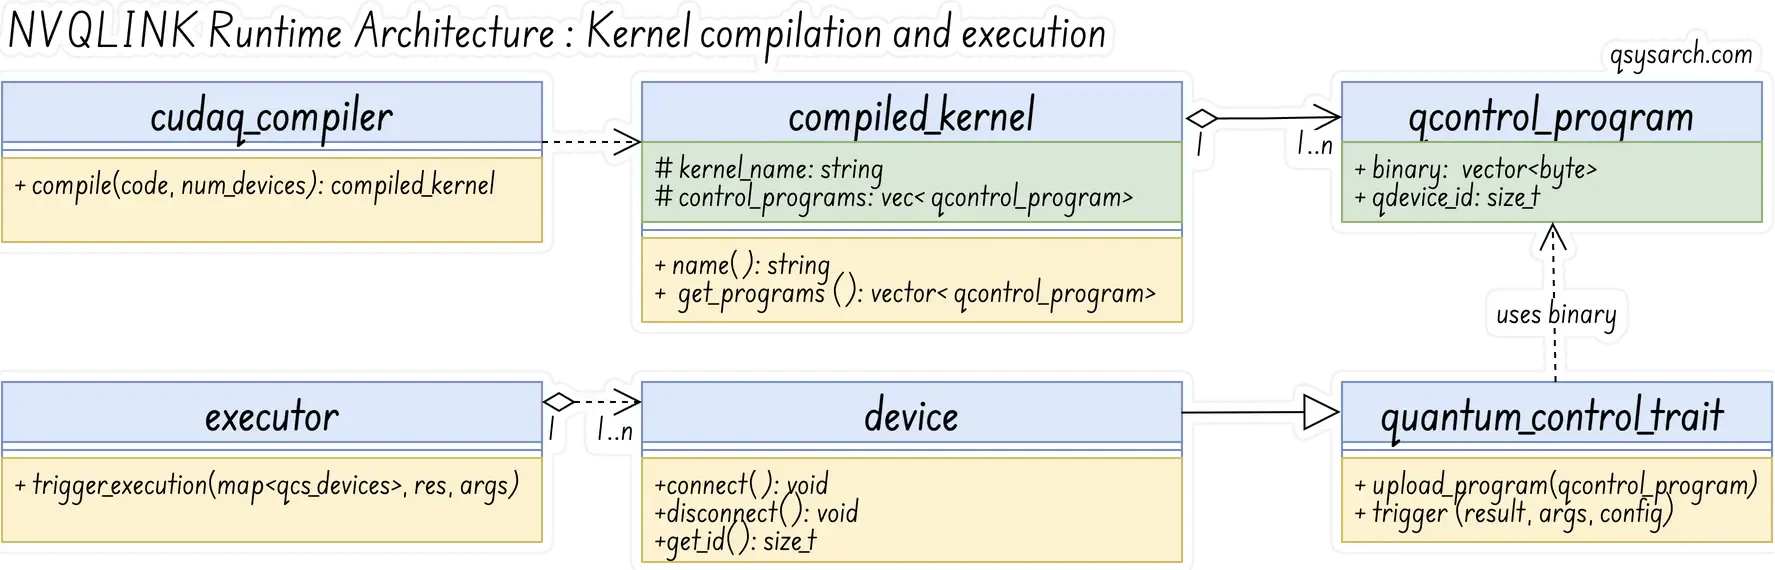
注目すべき点の1つは、QCS(量子制御システム)が複数のPPU(パルスプロセッサユニット)で構成されていることです。そのため、カーネルをコンパイルする際には、複数のPPU上で同期的に実行する必要がある場合があります。(NVQLinkは同期性には依存しませんが、各QCSベンダーは、QbloxのSYNQのように、独自のソリューションを提供しています。)
NVQLINKインターフェースにおいては、PPUの概念は抽象化され、汎用量子デバイスを表すQCSに置き換えられます。そのため、カーネルをコンパイルする際に、NVQLINKは各QCSに対して複数のプログラムを生成します。
ランタイムアーキテクチャ:より高レベルの抽象化「ライブラリ」
見出しへのリンク
前のセクションで説明したコードは理解や拡張が非常に複雑な場合があるため、NVQLINKは関数という形で一連の高レベルAPIを提供します。
このライブラリには、基本的な初期化およびシャットダウン機能、memcpyなどのデバイス固有のデータ変更APIへの対応、論理QPUとの間でのデータ転送、アップロードおよび実行への対応を行う関数が含まれています。以下に、これらの関数の簡略版を示します。
void initialize(DeviceTypes &&...in_devices);
void shutdown();

device_ptr malloc(size_t size, size_t devId);
void free(device_ptr &d);

void memcpy_to_qpu(device_ptr &arg, const void *src);
void memcpy_from_qpu(void *dest, const device_ptr &src);

handle load_kernel(const string &code, const string &kernel_name);
void launch_kernel(handle kernelHandle, device_ptr &result, const vector<device_ptr> &args);
アプリケーション例:テレポートしてみましょう
見出しへのリンク
完成予定
# 結論
NVQLINKは、非常に効率的で最適化されたランタイムにより、異種システム間の相互接続を可能にする強力なシステムレベルの抽象化です。他のフレームワークよりも魅力的な点は、NVQLinkシステムが、ネットワーク用のRDMA、コンパイラ用のLLVM、ランタイム用のトレイトと標準化されたAPIなど、標準的なスタックで構成されていることです。
NVQLINKを使用すれば、開発者やインテグレーターは相互接続について心配する必要がなくなります。代わりに、異種混在システムの構成に集中し、単一のフレームワーク内でマルチデバイスカーネルをコンパイルできます。NVQLINKランタイムが、まるで単一のシステムであるかのように、さまざまな「デバイス」の実行をオーケストレーションします。NVQLinkランタイムは、ネットワーク、マーシャリング、デバイス間呼び出しを処理するため、ユーザーは何もする必要はありません。
これは大きな飛躍です。CUDAQと組み合わせることで、量子エンジニアは強力なアプリケーションを開発できるようになります。これは、NVIDIA CUDAが強力なニューラルネットワークアプリケーションを可能にしたのと同様です。量子力学の要素を少し加えたLLMを想像してみてください。
プロンプト: NVQLINKシステムを介して接続された隣接するGPU上で計算される「大規模量子ビットモデル」の画像を描画してください。 ChatGPTはNVLINKがNVQLINKではないことを理解していませんでした。
課題:隣接するGPUに接続された「大規模量子ビットモデル」を相互接続するNVQLINKシステムの漫画風イラストを描いてください。 ChatGPTは、NVQLINKが「ケーブル」ではなく、複数の異種デバイス上で実行されるカーネルを構成できるようにするシステムレベルのフレームワークであることをまだ理解していない。そして、ケーブルは今のところRDMA(標準規格であるため)であると予想されているが、5年後にはNVLinkになる可能性も十分にある。
References
DrawIO diagrams used in this memo:
Control Stack vendors
見出しへのリンク
The un-mentionned
見出しへのリンク