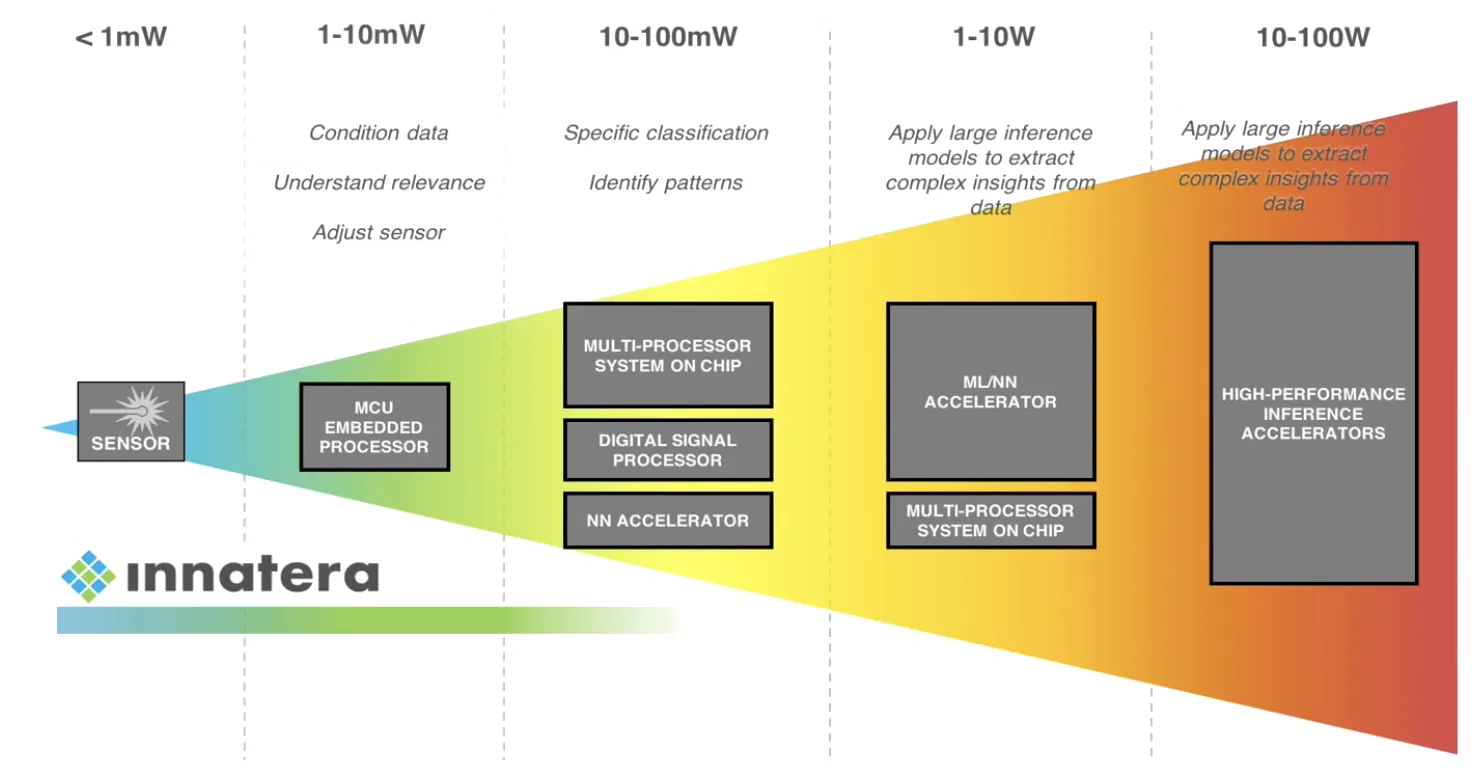
最近、Neuralink について話していたときに、ニューロモルフィック処理ユニット、または NPU について耳にしました。
 これらの NPU は量子コンピューティングとは何の関係もありませんが、新しい処理アーキテクチャからインスピレーションを得るのに少し時間を費やすのは面白いと思いました。実際、この分野の主要な IC ベンダーの 1 つは、Innatera というオランダの会社です。Innatera の最新の IC、Pulsar は、低消費電力のスパイクニューラルネットワークに基づいています (右の画像を参照)。
このメモでは、ニューロモルフィックICのアーキテクチャ、スパイクニューラルネットワークの設計、そしてこれらのデバイスをプログラムするために公開されているソフトウェアスタックについて、可能な限り多くの情報をリバースエンジニアリングして明らかにしようと思います。
これは、Pulsar IC のアーキテクチャ図を再描画する試みです (元の 画像、ホワイトペーパー からの知見を補足しています)。
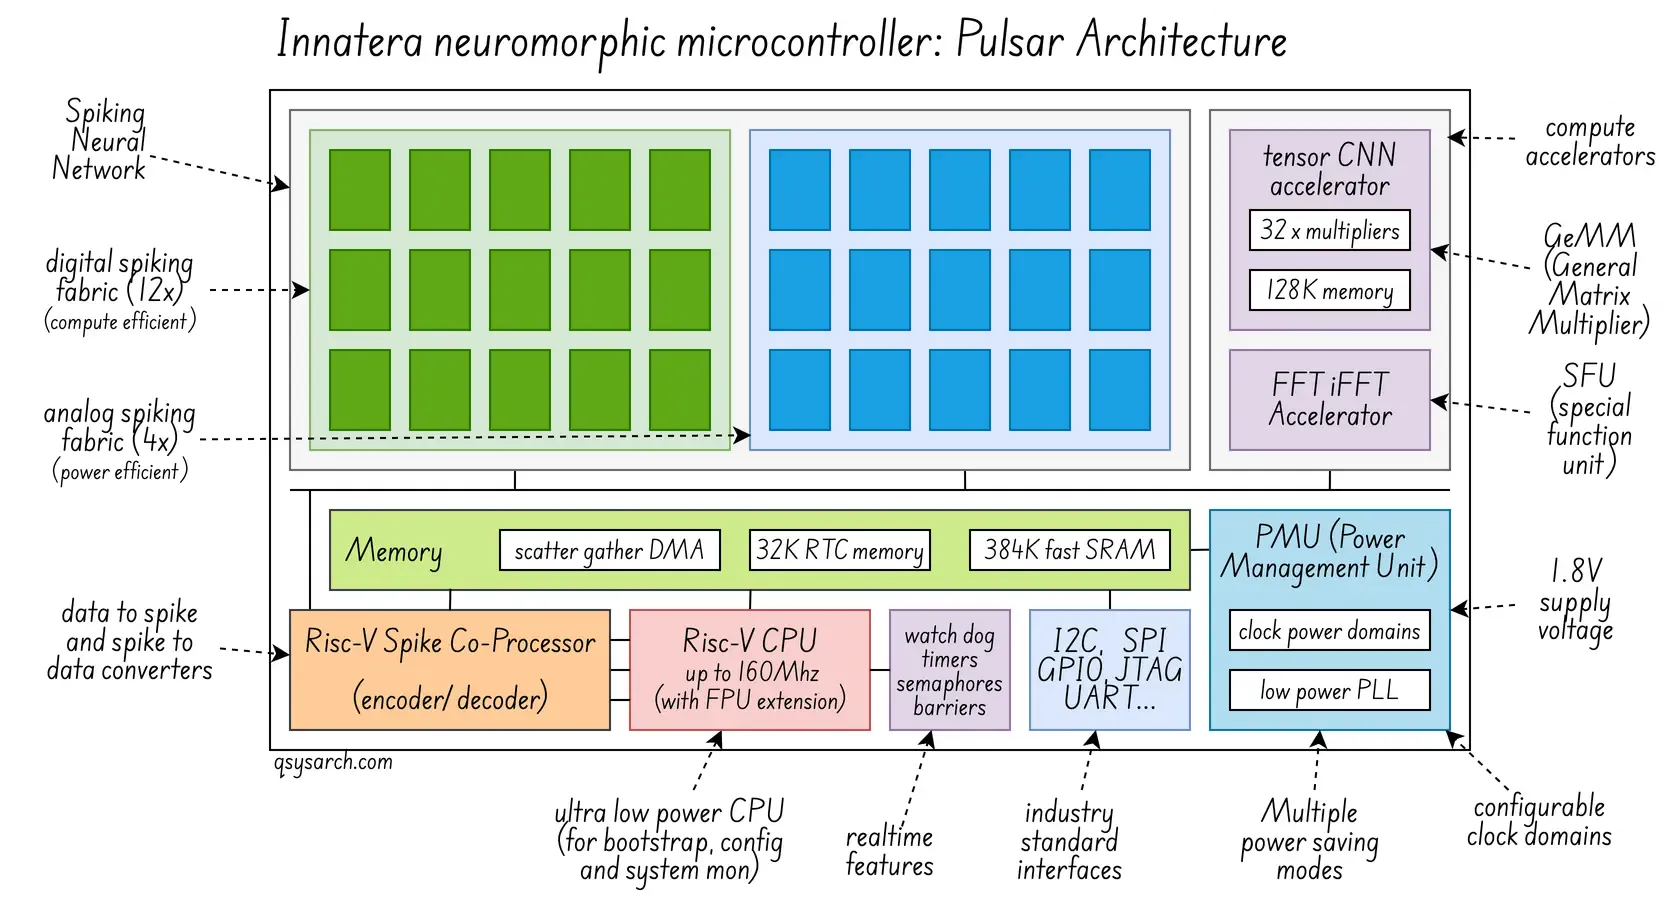
RISC-V CPU を使用するというアイデアは気に入っています。これは、Innatera のチームが初日から正しいアーキテクチャ決定を下している明確な証拠です。Innatera の以前の T1 チップの図の 1 つでは、RISC-V CPU に F 拡張機能 (浮動小数点演算サポート) がバンドルされています。
ICには多くの標準インターフェース(SPI、I2Cなど)と、スリープモードまたは省電力モードに入るときにICの一部をオン/オフする電源管理ユニット(PMU)が統合されています。残念ながら、実際の消費電力に関するデータは、_「1mW未満」_というボールパックの情報以外には見つかりませんでした。1.8Vの電源電圧を想定すると、これは500µA未満になります(I=W/V)。また、「サイクルあたり」の電力指標が関係するかどうかも疑問です。この場合、100Hzの周波数(シナプス更新周期)を想定すると、平均してシナプス更新あたり5µAになります。
Pulsarの最新の図には、CNNとFFTという2つのアクセラレータが示されています。これらは、GEMM(汎用行列乗算器、ニューラルネットワーク計算の鍵となるもの)とSFU(特殊機能ユニット、FFT計算を高速化するために使用されるもの)とより広義に表現できると思います。詳細については、GPUアーキテクチャに関するpostを参照してください。また、RISC-Vのコプロセッサとして開発されたと思われるスパイクエンコーダ/デコーダもありますが、それ以上の詳細は見つかりませんでした。
スパイクニューラルネットワークアーキテクチャ
見出しへのリンク
残る疑問は、スパイクニューラルネットワーク、またはSNNについてです。これはどのように機能するのでしょうか?
私はGeminiに、スパイクニューラルネットワークについて8歳児にもわかるような比喩表現を考えてもらうよう頼みました。以下が私が得た話です。
脳を巨大な郵便局だと想像してみてください。「ニューロン」は、メモを運ぶ小さなメッセンジャーのようなものです。
- メッセンジャーとメモ:
通常のコンピュータプログラムでは、すべてのメッセンジャーが常に数字をやり取りしています。一方、スパイクニューラルネットワークでは、メッセンジャーは非常に静かでエネルギー効率が良く、何か重要なこと(例えば、小さな電気的なスパイク)が発生したときにのみ、短い「やあ!」というメッセージを送信します。
- スパークメーター:
各メッセンジャーには、他のメッセンジャーから「ヘイ!」という声を聞くと溜まるメーターがあります。メーターが十分に溜まると(閾値に達すると)、そのメッセンジャーも興奮して「ヘイ!」と叫びます。叫んだ直後、メーターはリセットされるため、すぐに再び叫ぶことはできません(不応期)。
3.タイミングがすべて:
伝令が立て続けに「ヘイ!」という声を聞いたら、それは非常に重要なメッセージ(例えば「火事だ!」)であることを意味します。もし伝令が他の誰よりも少し早く「ヘイ!」と叫んだら、それは何か特別なことが起こっているという秘密の合図かもしれません(例えば「虎が来るぞ!」)。ですから、伝令は時間感覚を磨く必要があるのです。
4.学ぶことが鍵となる:
メッセンジャーはあなたと同じように学習します。例えば、メッセンジャーAが「ヘイ!」と叫んだ直後にメッセンジャーBが「ヘイ!」と叫んだ場合(何かが二人を興奮させたため)、二人の友情はより強固になり、メッセンジャーAのメッセージは次回メッセンジャーBがメーターをより早く満たすのに役立ちます。
SNN(スパイクニューラルネットワーク)は、非常に高速かつ効率的に動作するように設計されているため、特別な存在です。常に通信してエネルギーを浪費するのではなく、共有すべき情報が急増した時だけ活性化します。コンピュータがタイミングを理解し、パターンを認識するのに役立ち、消費電力も非常に少ないのです。
ボンネットの下に隠された真のデザイン
見出しへのリンク
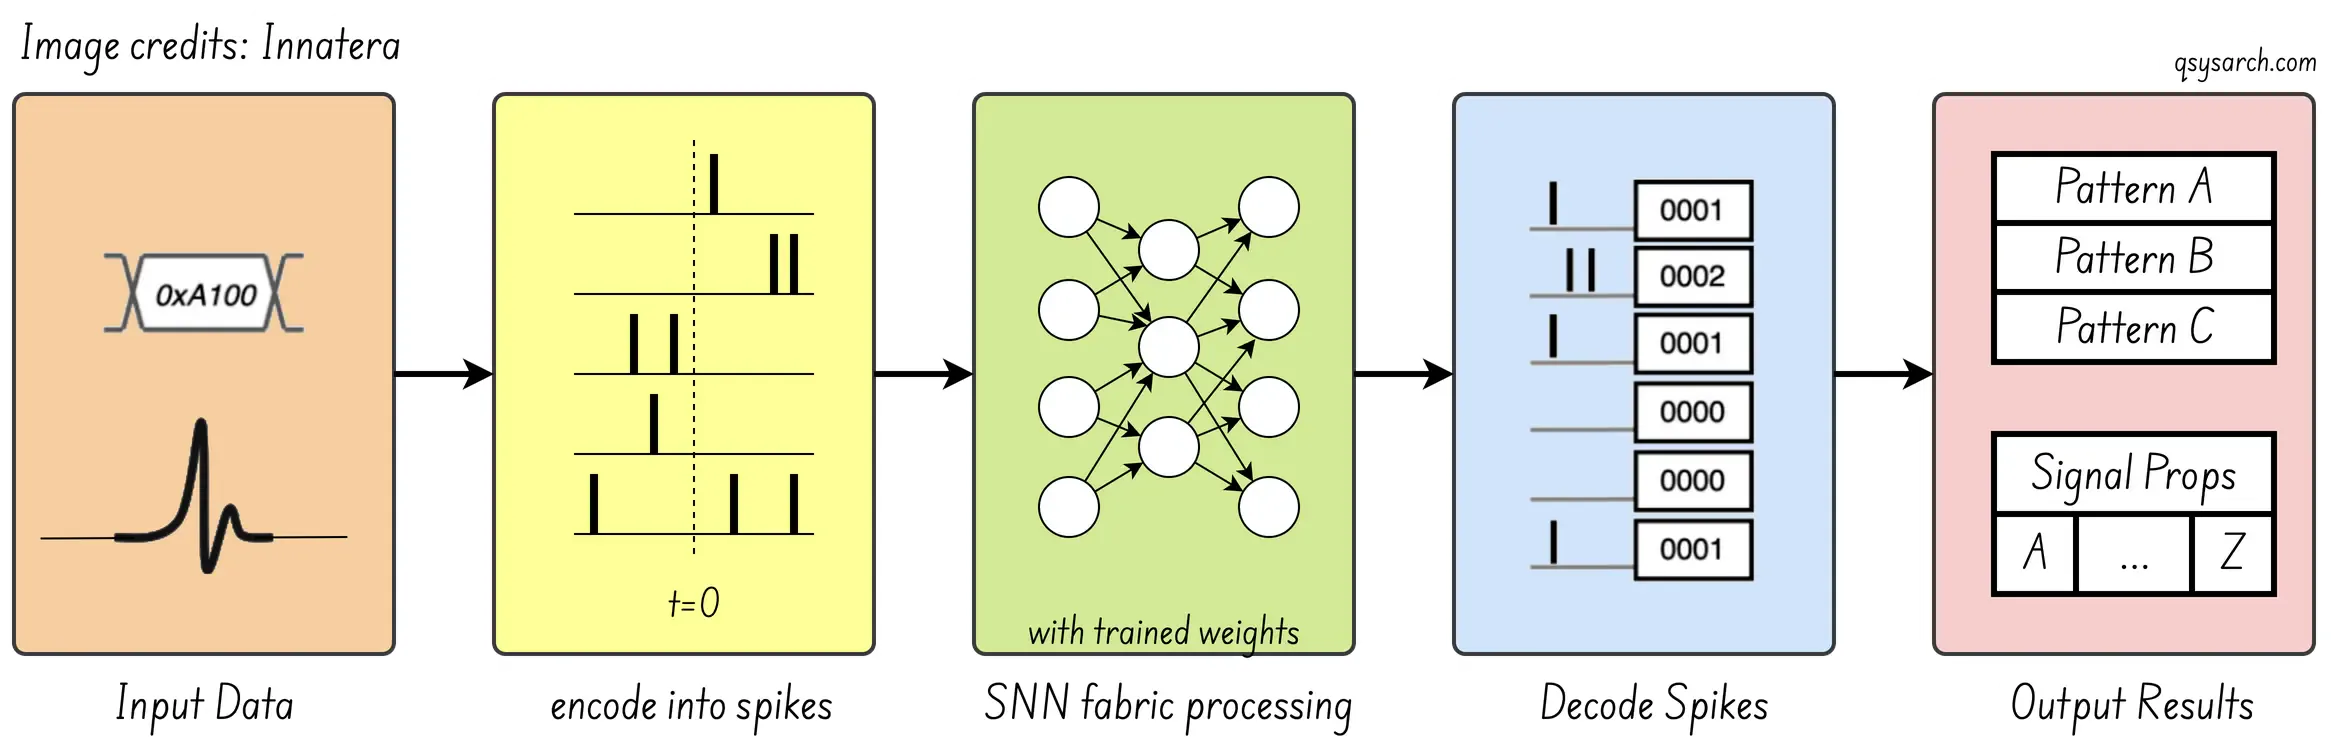
Innateraのブログ「Thinking in Pulses」(https://innatera.com/blog/thinking-in-spikes)では、これをハードウェアでどのように実装するかについて良い概要が提供されています。「hey」をバイナリ値にエンコードし、ニューラルネットワークを通して特徴を抽出します。ここまでは特に変わったことはなく、これは標準的なニューラルネットワークの処理です。
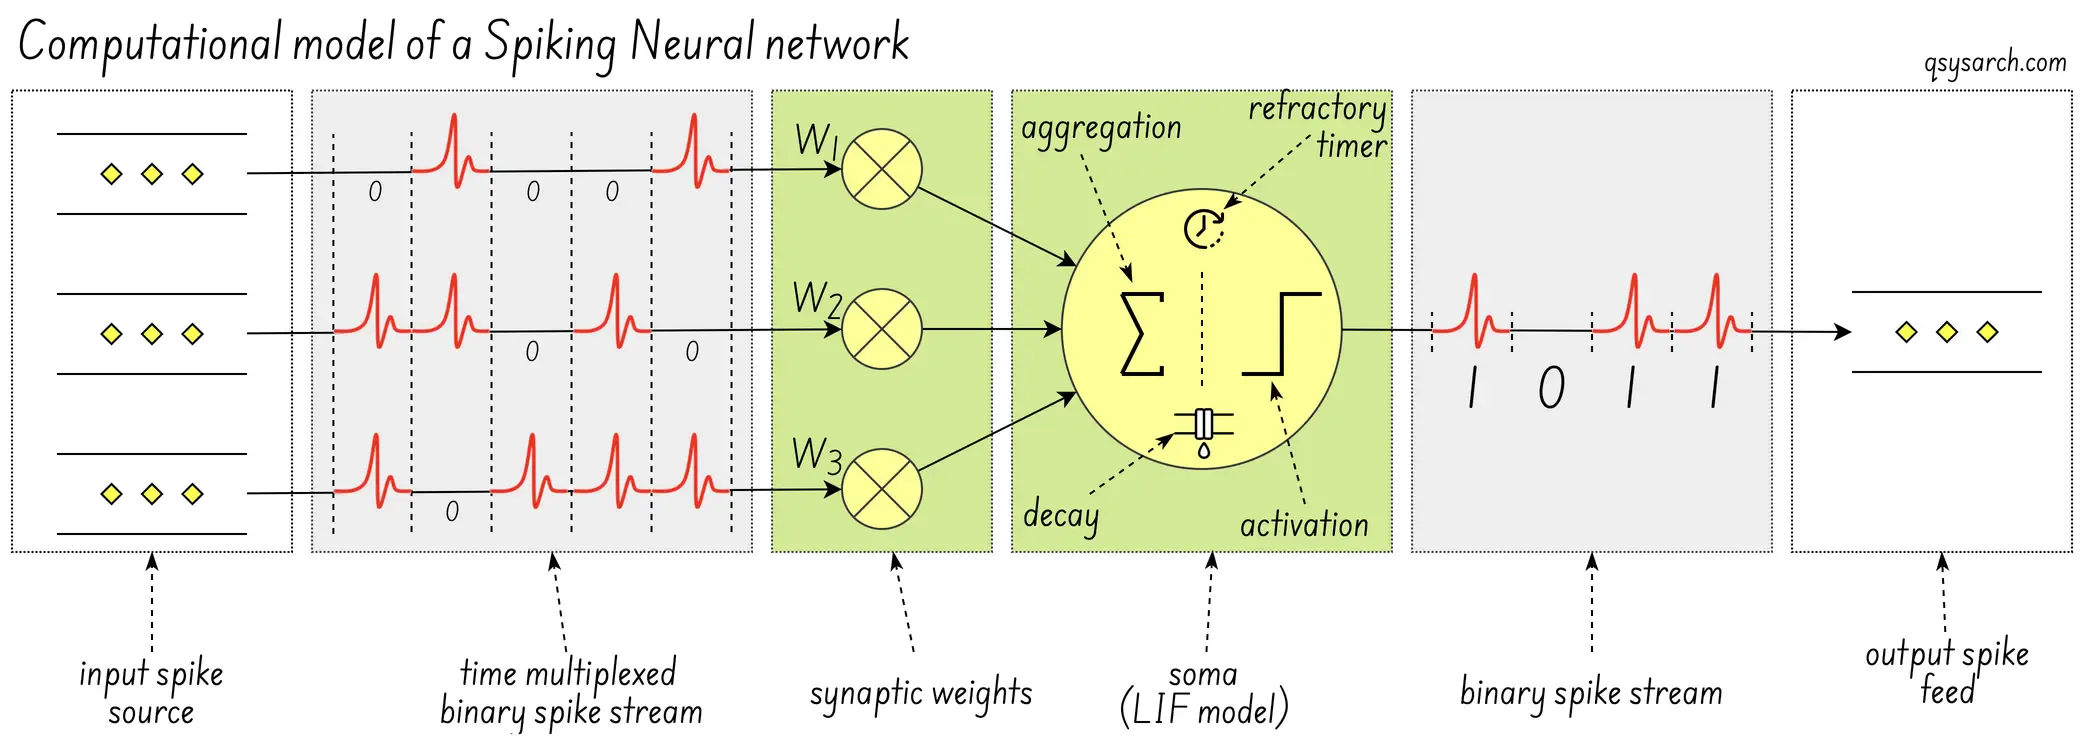
より興味深いのは、このSNNがどのように実装されているかという点です。下の画像は、デジタルニューロンの従来の「計算モデル」のようです(画像ソース)。この図では、SOMA内に「リーキー積分発火」(LIF)という概念を明示的に追加しました。
ハードウェア実装の低消費電力化の要因
見出しへのリンク
_完了予定:
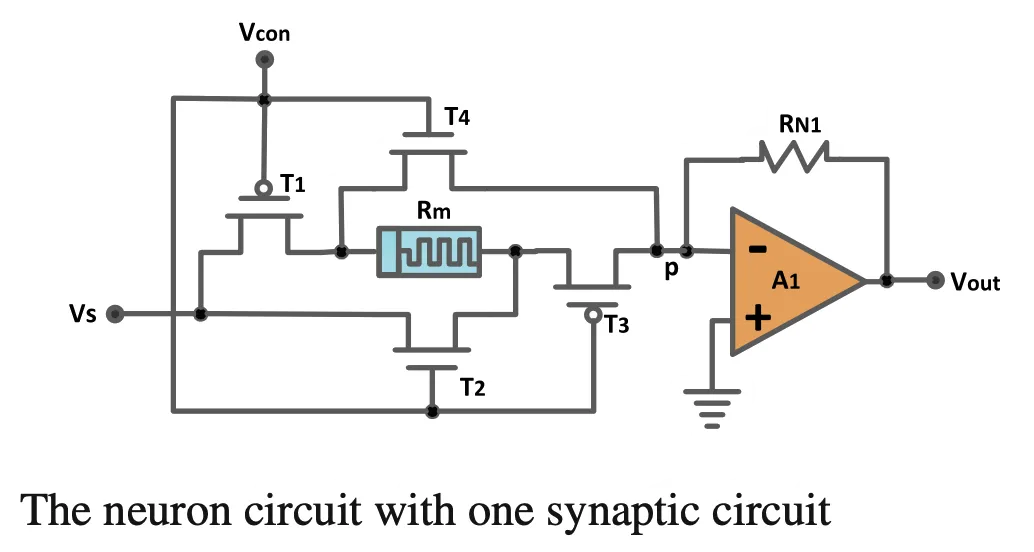 の説明が必要です
Pulsarの設計に関する疑問の一つは、なぜSNNが2つあるのかということです。その答えは、Innateraのアナログ(独自のアナログ・ミックスドシグナル)SNNファブリックは、最大限のエネルギー効率と非常に高速で超低消費電力のイベント処理に最適化されているからです。一方、デジタルSNNファブリックは、よりプログラマブルで柔軟な設計であり、わずかに高い消費電力でより多くの構成可能なネットワークをサポートします。(出典)
Innateraのウェブサイトには、スパイクニューラルネットワークの内部アーキテクチャに関する情報はあまりありませんが、幸いなことに、リバースエンジニアリングを試みることのできる特許がいくつかあります。
スタートアップ企業にしては、かなりの数の特許ですね!時間の都合上、今回はリストの最初と最後の特許のみを確認しました。
まず、SNNの実際のハードウェア実装を説明するのに最も近いと思われる最初の特許US20220230051A1から始めましょう。この特許は、「独自の応答」原理を使用して、特別に事前学習されたサブネットワーク(「セル」)からSNNを構築するための構成方法論を中心としています。
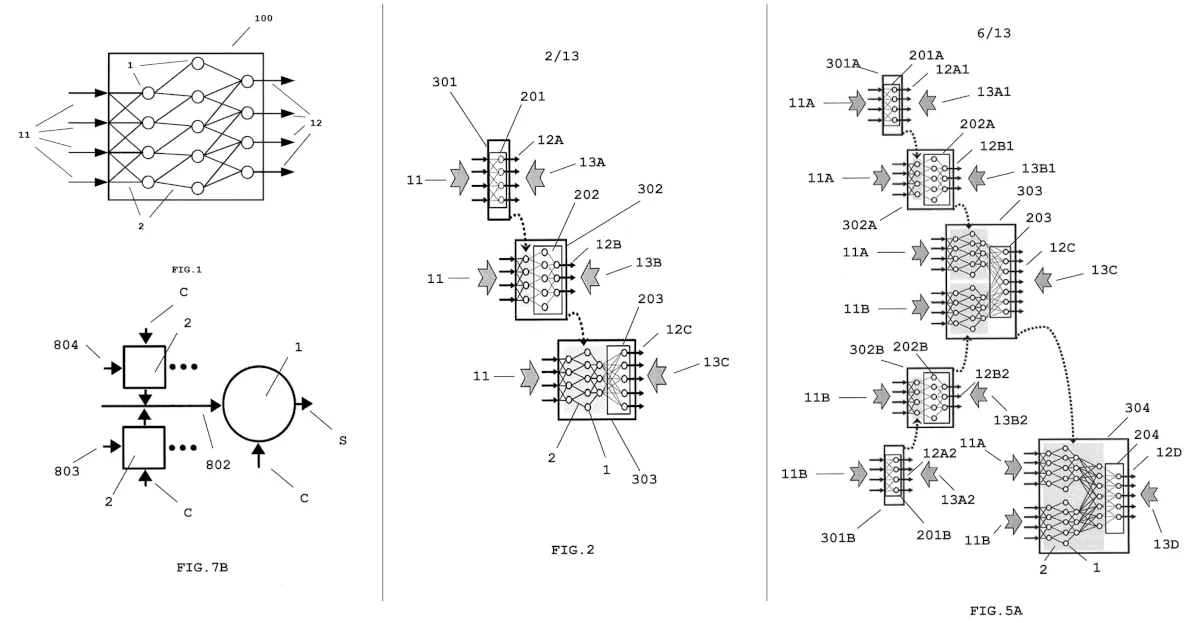
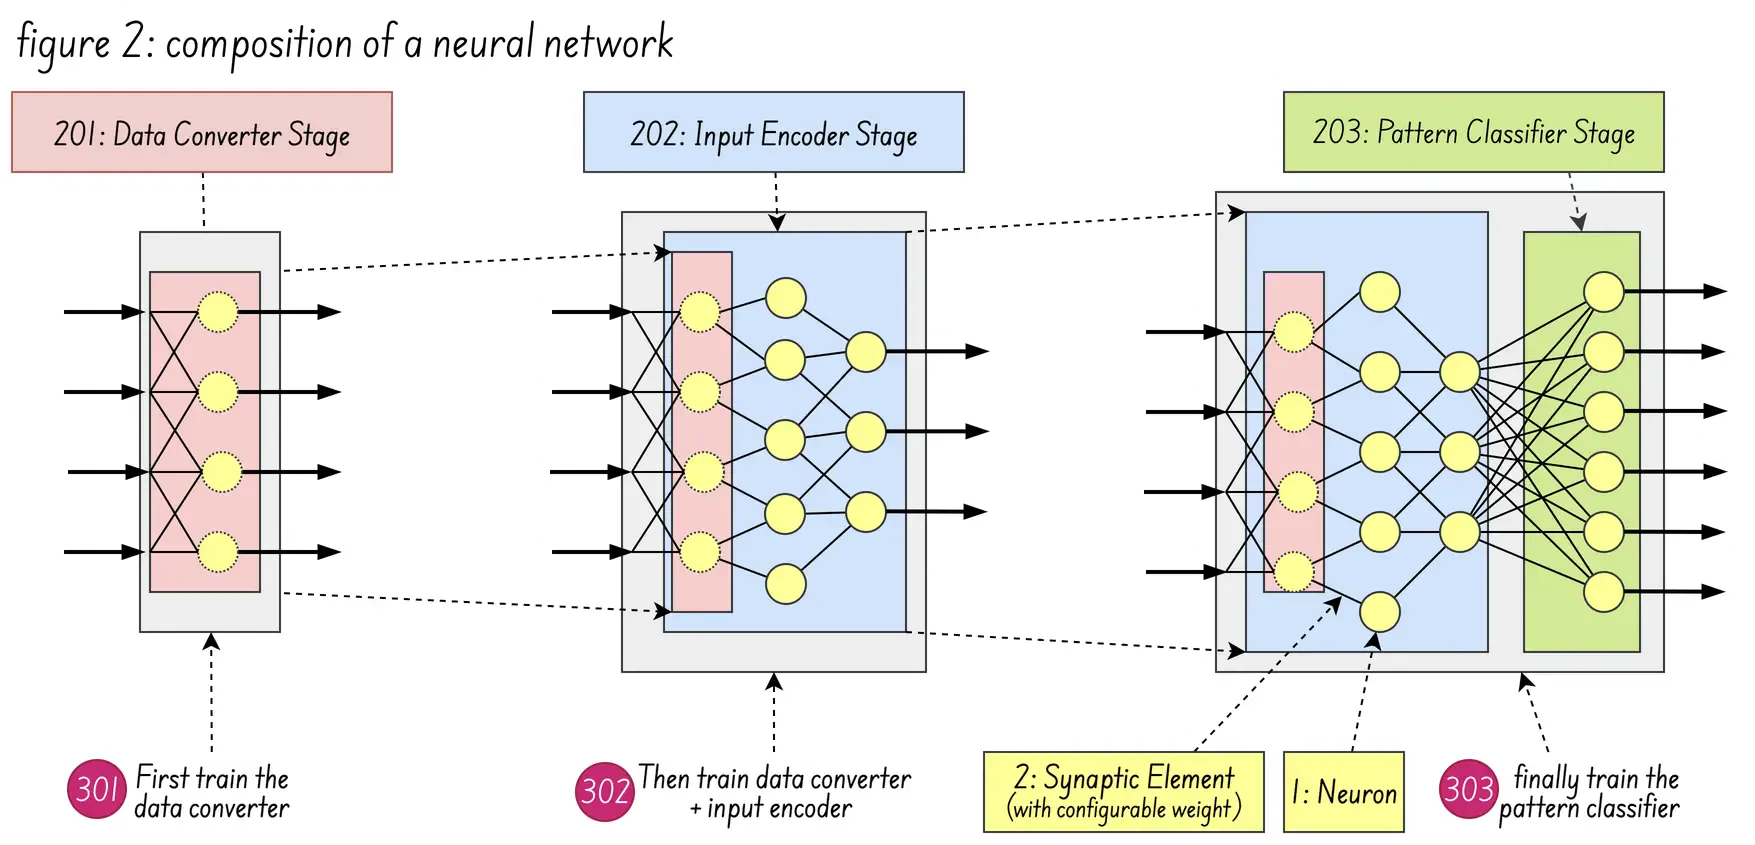
図2(下)は、データ変換器ステージ201、入力エンコーダステージ202、およびパターン分類ステージ203を統合して形成されたニューラルネットワークの構成を示しています。図5B(上)は、複数の時間的スパイク列が単一の融合スパイク列にどのように融合されるかを示しています。
最新の特許WO2023242374A1では、ネットワーク・オン・チップ・ネットワークを用いてシングルパケットマルチキャストを効率的に実装するために使用される、Innatera社の「スパイクニューラルネットワークアーキテクチャ」が開示されています。その目的は、マルチキャスト通信におけるマルチコア/メニーコアシステムでの重複、遅延、およびオーバーヘッドを削減することです。
下の図(特許の図5)は、NOCアービトレーションの仕組みを示しています。この仕組みの目的は、2つ(またはそれ以上)のスパイクが同時に同じ出力ポートに送られるのを防ぐことです。これは、各サイクルでスパイクをルーティングする効率的な方法です。ただし、実際のハードウェアではFIFOがどの程度深いのか気になります。
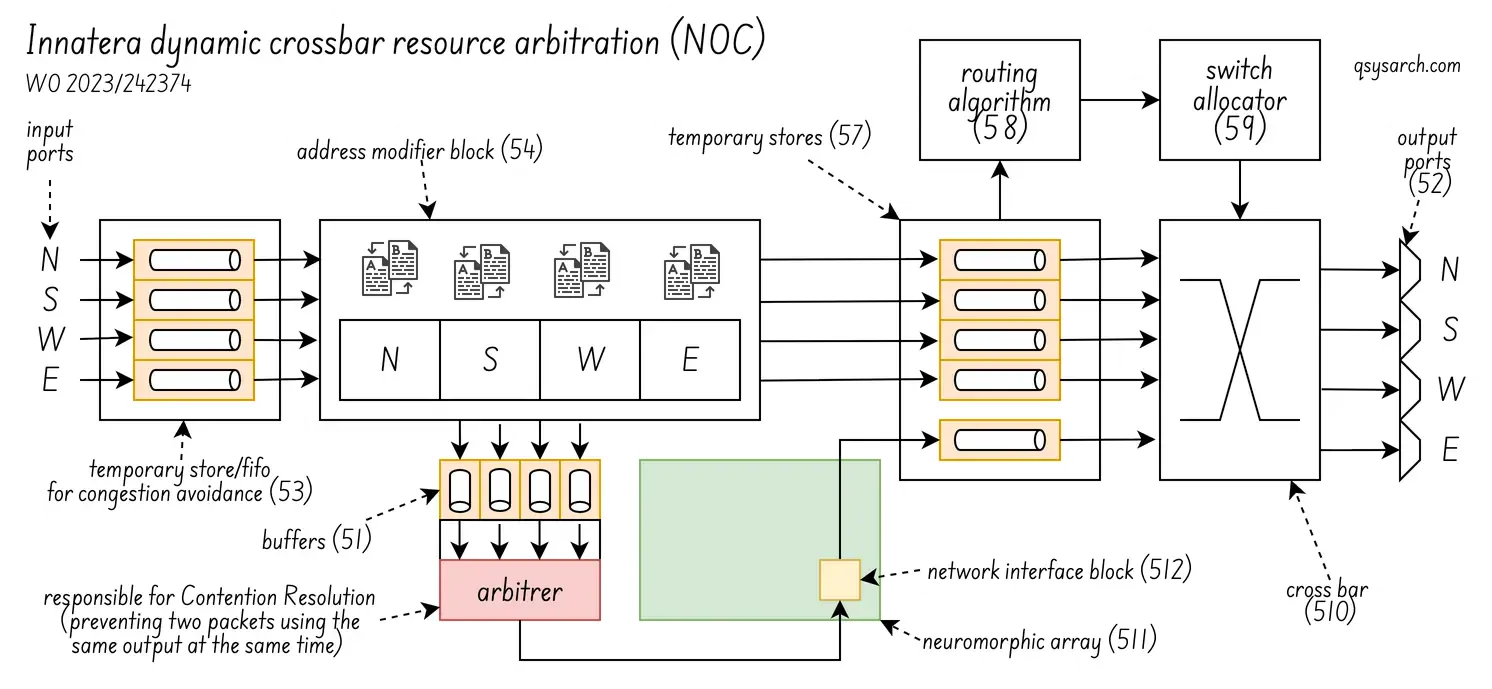
私にとって不明瞭なのは、コアとスパイクネットワークがどのように連携しているかということです。コアにはいくつのニューロンが含まれているのでしょうか?コアは相互に接続されているのでしょうか、それとも連携して機能しているのでしょうか?あるいは、それぞれ独立したユニットとして、独立した分類処理を並列に行うことができるのでしょうか?
Inneraのコアアーキテクチャの正確な仕様についてはお答えできませんが、実装方法の詳細を解説した研究論文は多数存在します。特に興味深いのは、複数のアーキテクチャを比較している論文「ニューロモルフィックコンピュータプロセッサのシステム設計に関する考察」です。
そうしたアーキテクチャの一つが、「再構成可能で非常に効率的なニューロモルフィックシステム」、略してRAVENSであり、下の図に示されている。
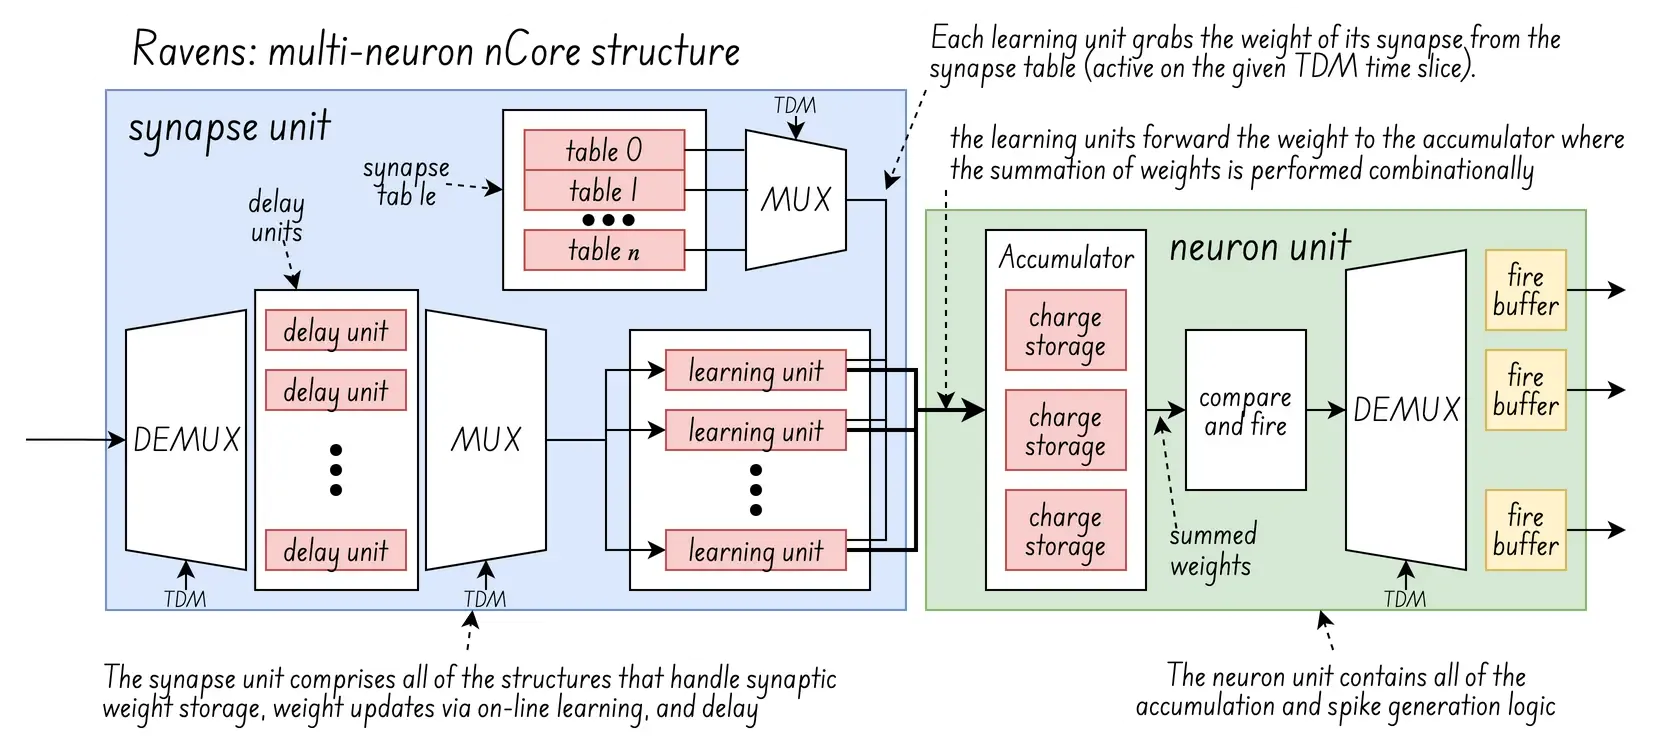 (図は元の画像から更新されました: )
RAVENSの基本的な考え方は、時分割多重(TDM)を用いて複数の「仮想ニューロン」をパイプライン化し、蓄積と更新からなる2段階のプロセスを実行することです。
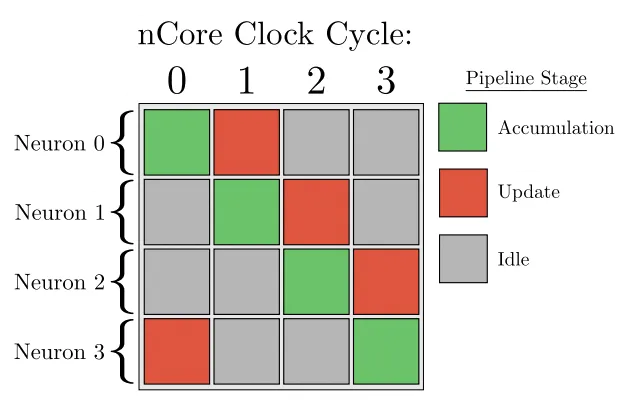
蓄積段階:ニューロンは、接続されている入力シナプスから電荷を蓄積し、プログラムされた閾値と不応期に基づいて発火イベントが発生するかどうかを決定します。
更新段階:シナプス重みのオンライン学習による変化、漏洩電荷、不応期カウンターの増加、不応期からの移行による蓄積電荷の変化を含める
ここで興味深いのはオンライン学習です。ニューロモルフィックICでは、オンライン学習は、ヘッブ学習などのアルゴリズムを使用してシナプス重みを変更し、シナプス前ニューロンとシナプス後ニューロンからの入力に基づいてシナプス強度をリアルタイムで調整します。
アナログコアの場合、この調整は、神経活動によって抵抗値や導電率が変化するメモリスタや磁気トンネル接合(MTJ)などのデバイスを介して物理的に実現され、シナプス結合重みを直接表現・保存します。一方、デジタルコアの場合は、少なくともRAVENSにおいては、シナプステーブルを介して行われます。
ソフトウェアスタック: TALAMO
見出しへのリンク
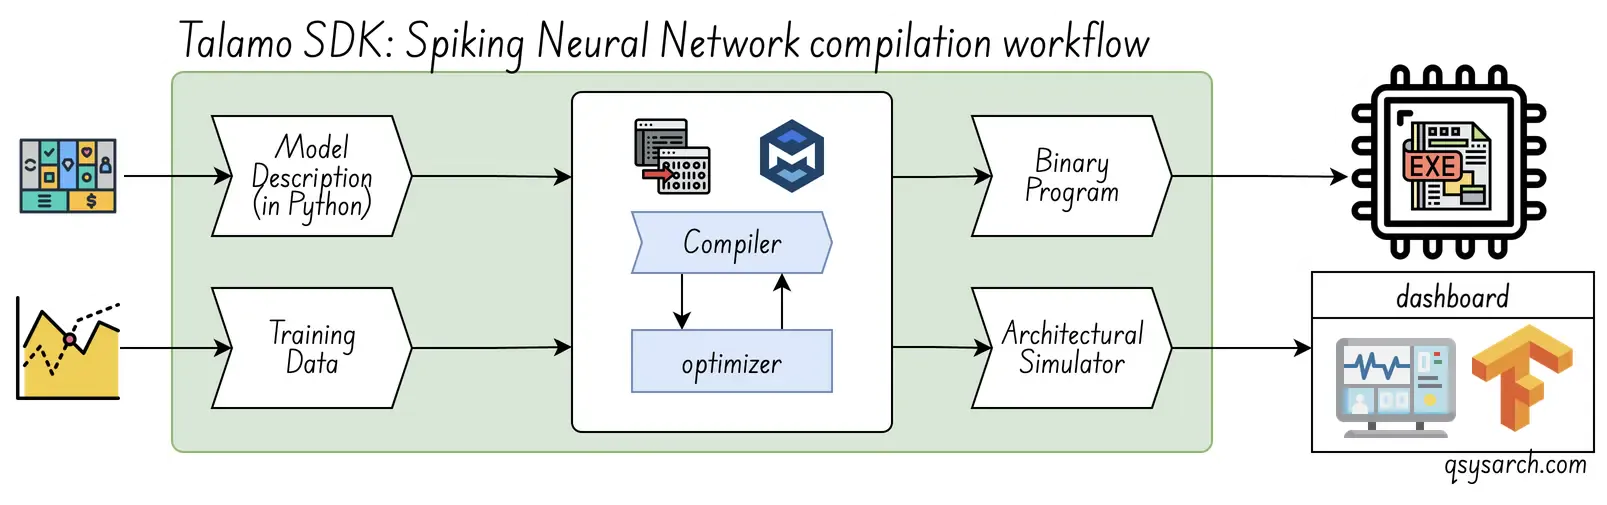
Innatera の製品には、SNN の専門知識を必要とせず、エンドツーエンドのアプリケーションをサポートし、標準的なディープラーニング ワークフローを使用する Talamo SDK がバンドルされています。Talamo キットは、開発者が PyTorch ベースの環境でスパイク モデルをゼロから構築するのに役立ちます。これは バッテリー付属 です。
コンパイルのワークフローは非常に標準的です。以下の図は、Innatera の オリジナル 資料を少し更新したもので、ワークフローの中核部分がコンパイラであると想定しています。また、シミュレータがバイナリ実行可能ファイルを入力として受け取るかどうかも気になります。その場合、エミュレータ と呼ばれます。最適化プロセスについてもっと情報が欲しいのですが、ユーザーが調整できるパラメータがあるかどうか (重みを 1.58 ビットに減らすなど)。
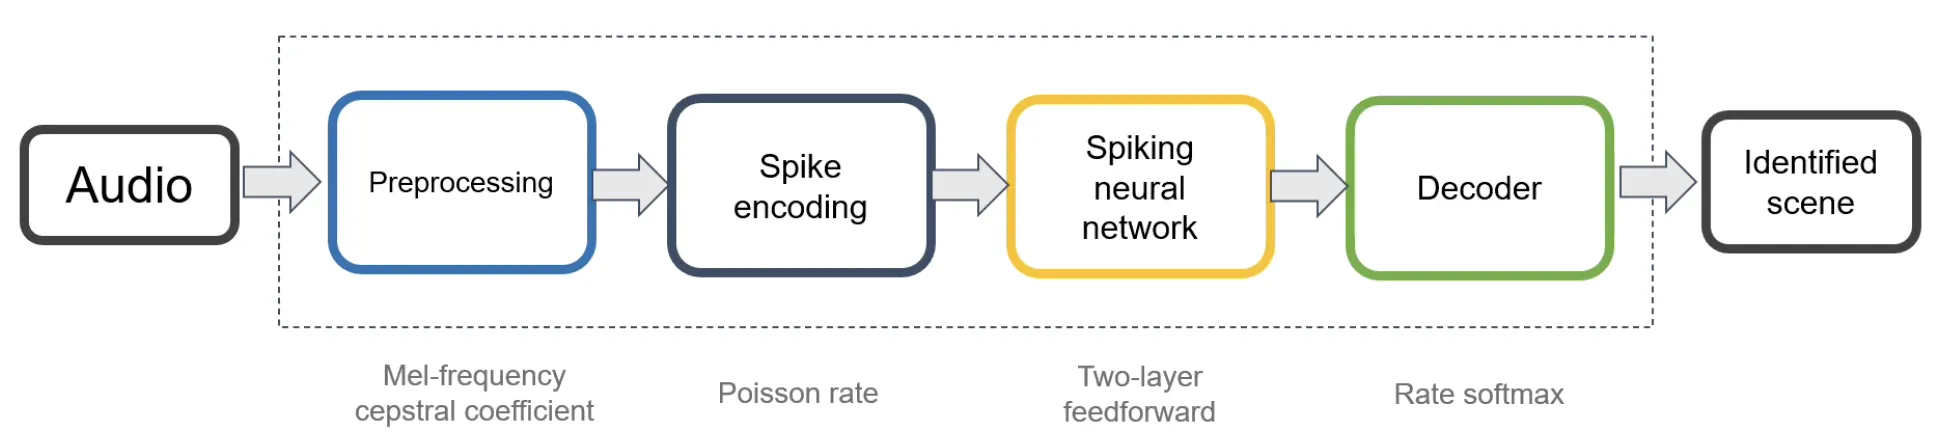
バイナリプログラムが生成されると、この実行ワークフローが使用され、特許WO2023242374A1で定義されているプロセスとほぼ同様に従います。
Innateraのハードウェアには、高性能なRISC-V、優れたGEM、そしてSFU演算アクセラレータが搭載されています。パワーユーザーの中には、Innateraのアーキテクチャに対応したCライブラリに重みをロードするよりも、このハードウェアに直接アクセスできる方が魅力的だと感じる人もいるでしょう。
オープンソースのファームウェアSDKを提供することが有益かもしれません。あるいは、量子コンピューティング業界におけるCUDA-Qのように、汎用ニューラルプロセッサユニット(GPNPU)エクスペリエンスを提供する_CUDANN_を検討することもできます。また、NVQLinkに似たNVNLinkによって、大規模なNPUネットワークやハイブリッドアーキテクチャを実現することも考えられます。
おそらく、これは「ニューロモルフィック技術の商業的成功への道」で言及されている意味でしょう。「シンプルなプログラミングモデルとツールの登場、そしてハードウェアへの直接的なAPIアクセスが同時に実現するまで、テンソルプロセッサは広く普及しなかった」。単にテンソルプロセッサをニューロモルフィック処理ユニット(NPU)に置き換えればよいのでしょうか?
私にとって、これはユーザーエクスペリエンス(UX)と開発者エクスペリエンス(DX)に集約されます。そして、使いやすさと開発者エクスペリエンスは、真に優れた製品体験を生み出すための重要な要素、あるいは戦略の柱の一つであると確信しています。
 (画像提供: archi monarch)
# 結論
これで、ニューロモルフィックICのハイレベルアーキテクチャに関する簡単なメモを終わりにします。このハードウェアアーキテクチャは、間違いなく大きな可能性を秘めた、強力な代替技術です。しかし、ニューロモルフィックICにはキラーアプリケーションがないという意見もあるでしょう。しかし、それこそがニューロモルフィックICの魅力的な点ではないでしょうか?つまり、それに伴う世界を創造する必要があるということでしょうか?
Inneteraのチームはまさに「世界を違った視点で見ている人々」だと私は確信しています。AIデータセンターの電力消費量の多さが懸念される中、ニューロモルフィックICは「より少ないエネルギーでより多くの価値を得る方法」という根本的な問いに対する一つの答えとなるのではないでしょうか?もしそうだとすれば、AIデータセンターが必要とするレベルの演算能力にニューロモルフィックICを拡張するには、何が必要なのでしょうか?
また、SNNにシリコンフォトニクス(https://prucnal.princeton.edu/research/photonic-spiking-neural-networks)を少し加えることが何か役に立つかどうか疑問に思っています。ニューラル計算のためだけでなく、SNN IC間の大規模な相互接続ネットワークを作成するためにも役立つかもしれません。
このメモで使用されているDrawIO図: